---
title: "Cómo extraer datos de Alibaba con Python en 2026"
slug: how-to-scrape-alibaba
date: 2026-02-23T09:52:54+00:00
modified: 2026-02-23T09:52:56+00:00
permalink: https://brightdata.es/blog/datos-web/how-to-scrape-alibaba
type: blog
---
[ Blog ](https://brightdata.es/blog "Blog") / [Datos web](https://brightdata.es/blog/datos-web)
[Datos web](https://brightdata.es/blog/datos-web)
# Cómo extraer datos de Alibaba con Python en 2026
Aprenda a crear un Scraper de Alibaba basado en Python para extraer detalles de productos, precios y mucho más. Perfecto para automatizar la recopilación de datos de forma eficiente.
11 min de lectura
[  ](https://brightdata.com/blog/authors/antonello-zanini)
[Antonello Zanini
Technical Writer
](https://brightdata.com/blog/authors/antonello-zanini)
En esta guía aprenderás:
- Qué es un Scraper de Alibaba y cómo funciona
- Los tipos de datos que puede recuperar automáticamente de Alibaba
- Cómo crear un script de scraping de Alibaba utilizando Python
¡Empecemos!
## ¿Qué es un Scraper de Alibaba?
[Un scraper de Alibaba](/products/web-scraper/alibaba) es un[bot de Scraping web](/blog/how-tos/what-is-a-scraping-bot)diseñado para extraer automáticamente datos de las páginas de Alibaba. Funciona simulando el comportamiento de navegación de un usuario para navegar por las páginas de Alibaba. Gestiona interacciones como la paginación y recupera información estructurada, como detalles de productos, precios y datos de empresas.
## Datos que se pueden extraer de Alibaba
Alibaba es un tesoro de información valiosa, como por ejemplo:
- **Detalles del producto**: nombres, descripciones, imágenes, rangos de precios, información del vendedor y más.
- **Información de la empresa**: nombres de empresas, detalles del fabricante, información de contacto y valoraciones.
- **Comentarios de los clientes**: valoraciones, reseñas de productos y mucho más.
- **Logística y disponibilidad**: estado de las existencias, cantidades mínimas de pedido, opciones de envío y mucho más.
- **Categorías y etiquetas**: categorías de productos, etiquetas relevantes o rótulos.
¡Descubre cómo extraerlos!
## Extracción de datos de Alibaba en Python: guía paso a paso
En esta sección, aprenderá a crear un Scraper de Alibaba en un tutorial guiado.
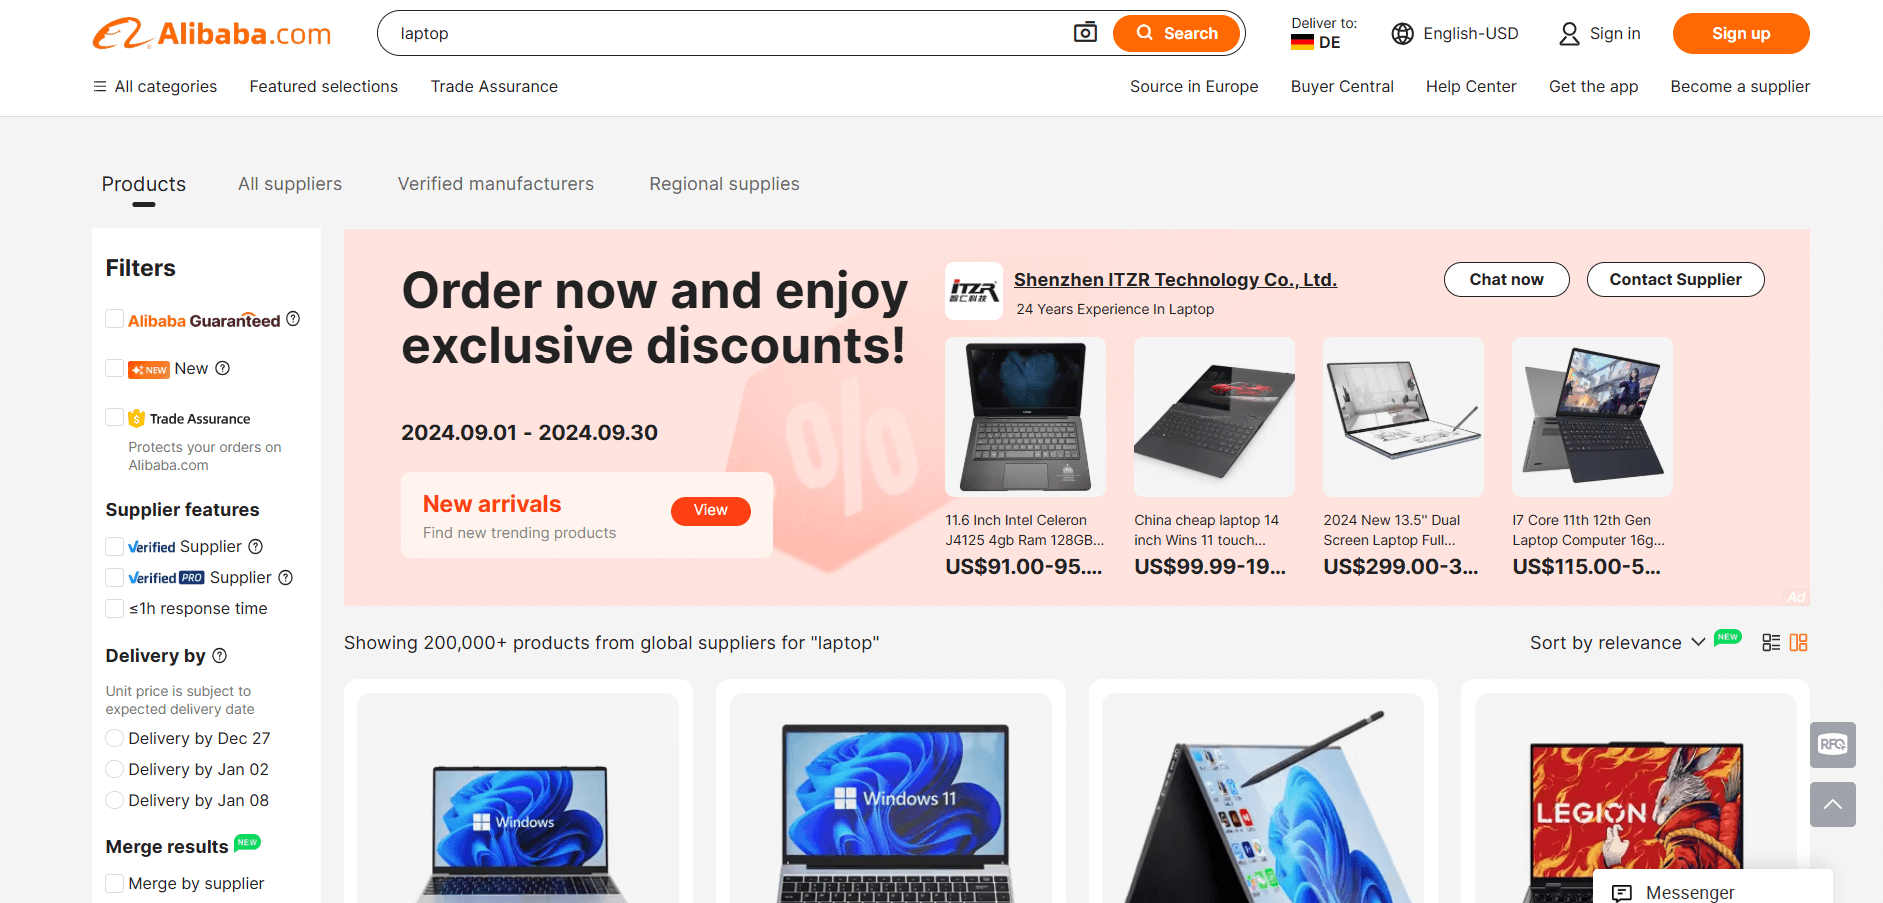
El objetivo es guiarte en la creación de un script de Python que extraiga automáticamente datos de la página «laptop» de Alibaba:
¿Listo? ¡Siga los pasos que se indican a continuación!
### Paso n.º 1: Configuración del proyecto
En primer lugar, comprueba que tienes Python 3 instalado en tu equipo. Si no es así, [descárgalo](https://www.python.org/downloads/) y sigue el asistente de instalación.
Ahora, utiliza el siguiente comando para crear un directorio para tu proyecto:
```none
mkdir alibaba-scraper
```
La carpeta `alibaba-scraper` es donde colocarás el Scraper Python Alibaba.
Introdúzcalo en el terminal y cree un [entorno virtual](https://docs.python.org/3/library/venv.html) dentro de él:
```none
cd alibaba-Scraper
python -m venv env
```
Cargue la carpeta del proyecto en su IDE de Python favorito, como [Visual Studio Code con la extensión Python](https://code.visualstudio.com/docs/languages/python) o [PyCharm Community Edition](https://www.jetbrains.com/pycharm/download/#section=windows).
Crea un archivo `scraper.py` en el directorio del proyecto, que ahora debería contener esta estructura de archivos:
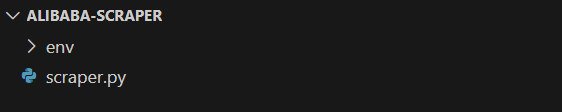`scraper.py` es actualmente un script Python en blanco, pero pronto contendrá la lógica de scraping deseada.
En la terminal del IDE, activa el entorno virtual. En Linux o macOS, ejecuta este comando:
```none
./env/bin/activate
```
De forma equivalente, en Windows, ejecute:
```none
env/Scripts/activate
```
¡Genial, tu entorno Python para el Scraping web de Alibaba ya está listo!
### Paso n.º 2: selecciona la biblioteca de scraping
El objetivo ahora es determinar si Alibaba utiliza páginas dinámicas o estáticas. Para ello, abra la [página de destino de Alibaba](https://www.alibaba.com/trade/search?spm=a2700.product_home_newuser.home_new_user_first_screen_fy23_pc_search_bar.keydown__Enter&tab=all&SearchText=laptop) en su navegador en modo incógnito. A continuación, haga clic con el botón derecho del ratón en el fondo, seleccione «Inspeccionar», vaya a la pestaña «Red», filtre por «Fetch/XHR» y vuelva a cargar la página:
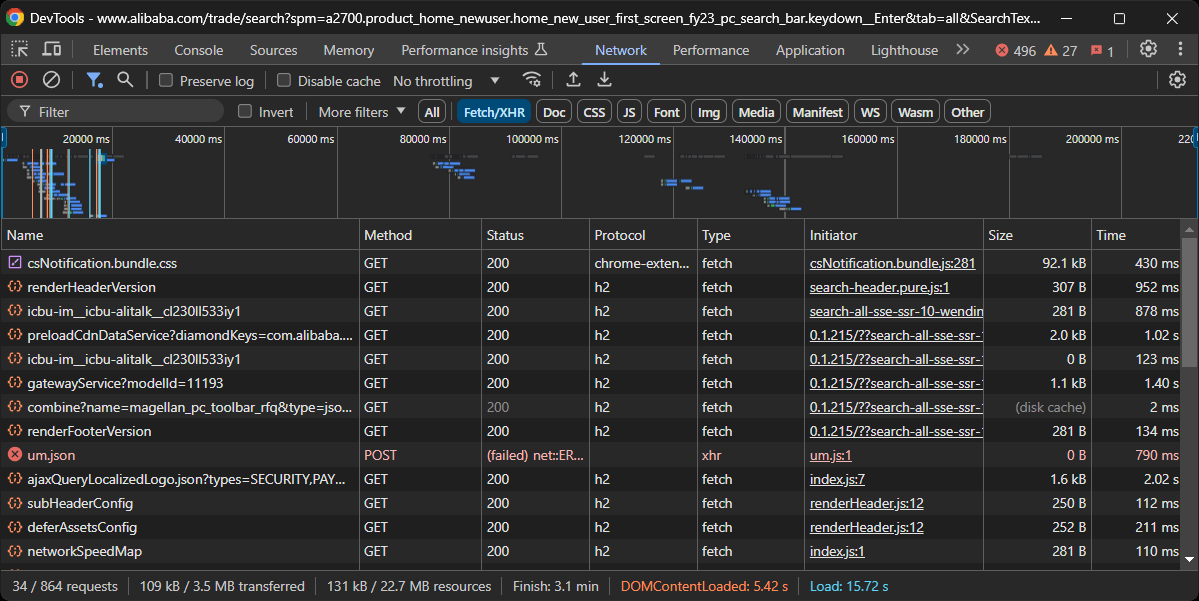En esta sección de DevTools, observe si la página realiza alguna solicitud dinámica significativa. En este caso, sí lo hace, lo que indica que la página es dinámica. Un análisis más detallado revela que la página utiliza JavaScript para la renderización.
En otras palabras, necesitas una herramienta de automatización del navegador como [Selenium](https://www.selenium.dev/) para extraer datos de Alibaba de forma eficaz. Obtén más información en nuestro tutorial sobre [el Scraping web con Selenium](/blog/how-tos/using-selenium-for-web-scraping).
Selenium le permite controlar mediante programación un navegador web, simulando las interacciones del usuario y permitiéndole extraer contenido renderizado por JavaScript. ¡Es hora de instalarlo y empezar a utilizarlo!
### Paso n.º 3: Instalar y configurar Selenium
En un entorno virtual activado, instala Selenium con este comando:
```none
pip install -U selenium
```
Importe Selenium en `scraper.py` y cree un objeto `WebDriver`:
```none
from selenium import webdriver
from selenium.webdriver.chrome.service import Service
# inicializar una instancia del controlador web Chrome
driver = webdriver.Chrome(service=Service())
```
El código anterior inicializa una instancia [`de WebDriver`](https://selenium-python.readthedocs.io/api.html#module-selenium.webdriver.chrome.webdriver) para controlar una instancia de Chrome. Tenga en cuenta que Alibaba tiene algunas medidas antiscraping que pueden bloquear los navegadores sin interfaz gráfica.
Por lo tanto, no debe establecer el indicador [`--headless`](https://developer.chrome.com/docs/chromium/headless). Como solución alternativa, considere explorar [Playwright Stealth](/blog/how-tos/avoid-bot-detection-with-playwright-stealth).
Como última línea de su Scraper, recuerde cerrar el controlador web:
```none
driver.quit()
```
¡Genial! Ya tiene todo configurado para empezar a scrapear Alibaba.
### Paso n.º 4: Conéctese a la página de destino
Utilice el método [`get()`](https://selenium-python.readthedocs.io/api.html#selenium.webdriver.remote.webdriver.WebDriver.get) expuesto por el objeto Selenium `WebDriver` para visitar la página deseada:
```none
url = "https://www.alibaba.com/trade/search?spm=a2700.product_home_newuser.home_new_user_first_screen_fy23_pc_search_bar.keydown__Enter&tab=all&SearchText=laptop"
driver.get(url)
```
El archivo `scraper.py` ahora contendrá estas líneas de código:
```none
from selenium import webdriver
from selenium.webdriver.chrome.service import Service
# inicializar una instancia del controlador web Chrome
driver = webdriver.Chrome(service=Service())
# la url de la página de destino
url = "https://www.alibaba.com/trade/search?spm=a2700.product_home_newuser.home_new_user_first_screen_fy23_pc_search_bar.keydown__Enter&tab=all&SearchText=laptop"
# conectarse a la página de destino
driver.get(url)
# lógica de scraping...
# cerrar el navegador
driver.quit()
```
Coloca un punto de interrupción de depuración en la última línea e inicia el script con el depurador. Esto es lo que deberías ver:
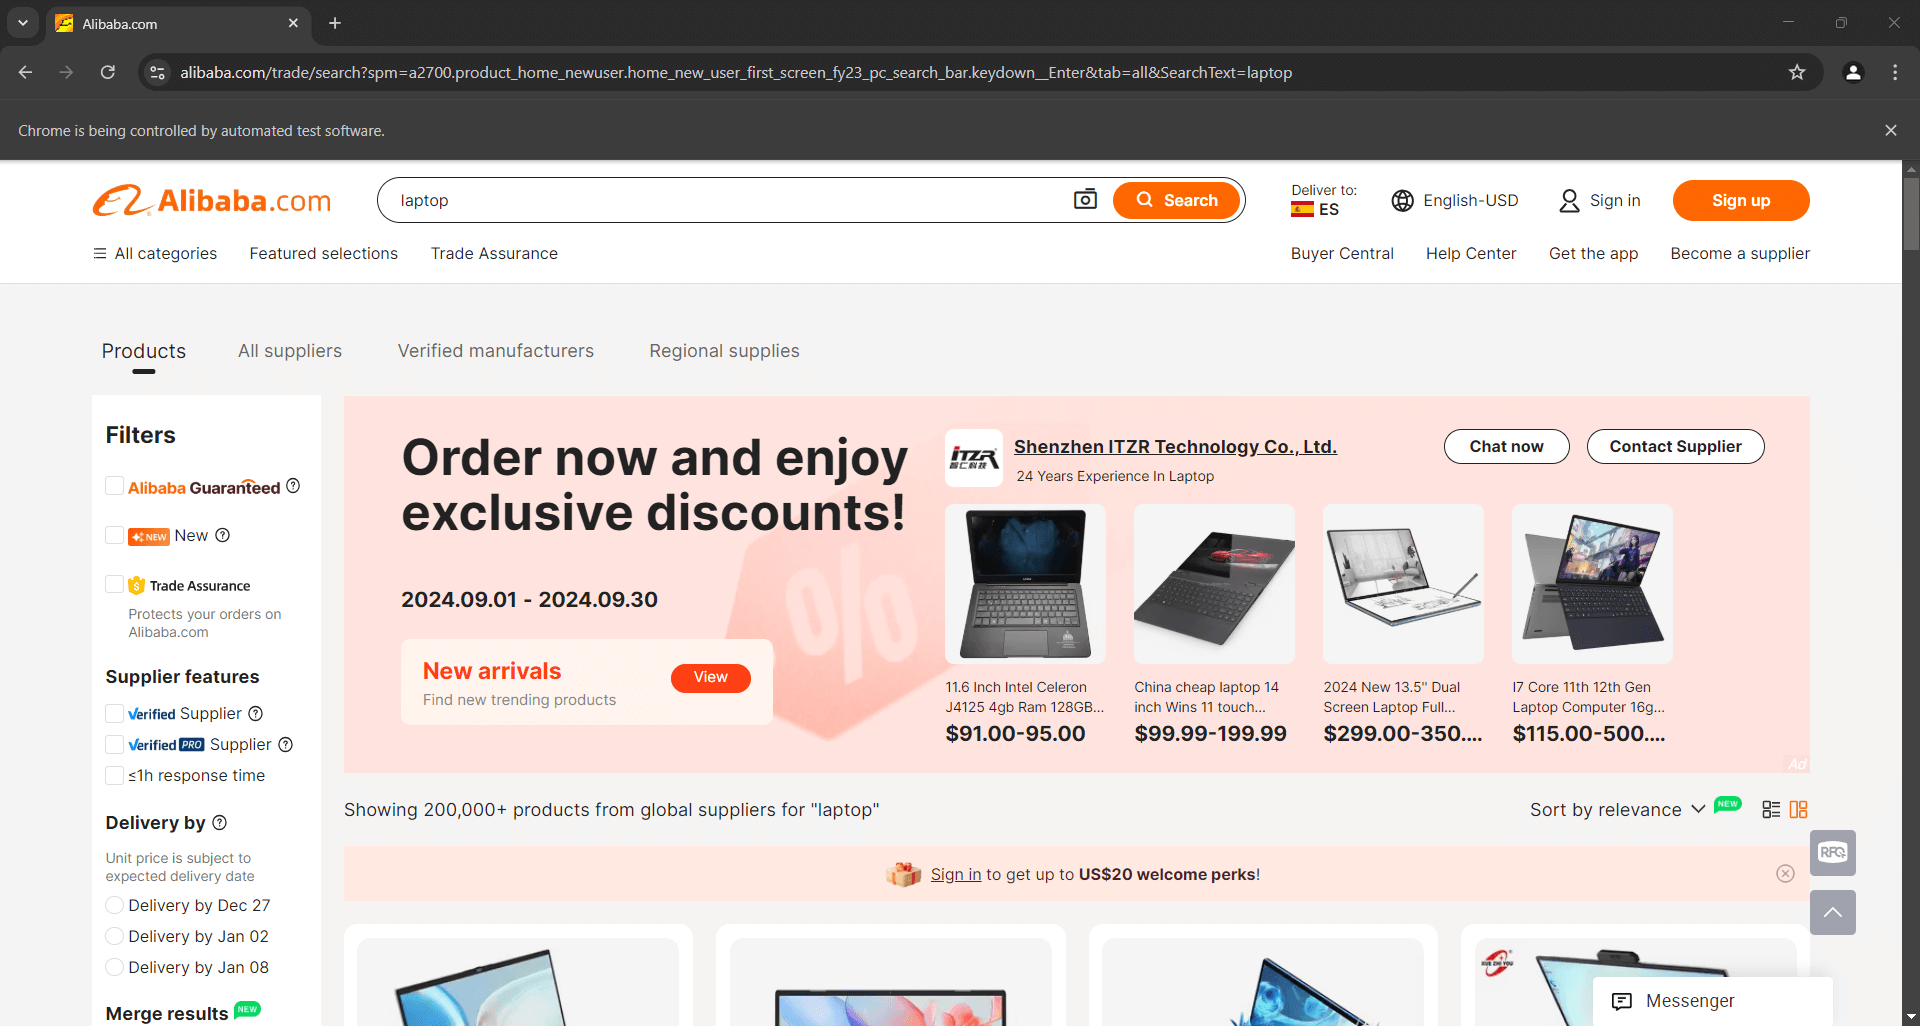El mensaje «Chrome está siendo controlado por un software de pruebas automatizado» certifica que Selenium está controlando Chrome como se esperaba. ¡Bien hecho!
### Paso n.º 5: Seleccionar los elementos del producto
Dado que la página de productos de Alibaba contiene varios productos, primero debe inicializar una estructura de datos para almacenar los datos extraídos. Una matriz funcionará perfectamente para este propósito:
```none
productos = []
```
A continuación, inspeccione los elementos HTML de los productos de la página para comprender:
1. Cómo seleccionarlos
2. Qué datos contienen
3. Cómo extraer esos datos
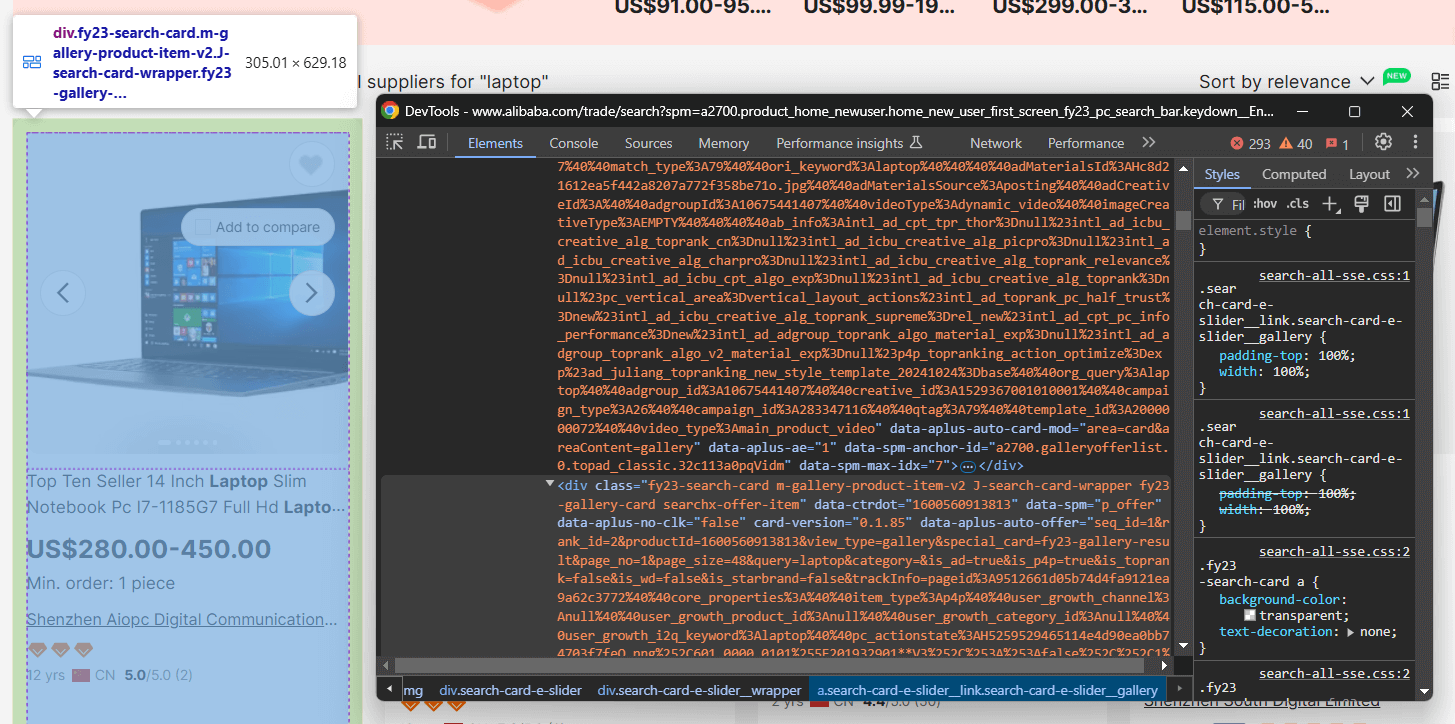Aquí puede ver que cada elemento de producto es un nodo `.m-gallery-product-item-v2`.
Utilice Selenium para seleccionar todos los elementos de producto:
```none
product_elements = driver.find_elements(By.CSS_SELECTOR, ".m-gallery-product-item-v2")
```
`find_elements()` aplica la estrategia de selección dada para recuperar elementos de la página. En el caso anterior, la estrategia de selección es un [selector CSS](https://developer.mozilla.org/en-US/docs/Web/CSS/CSS_selectors).
No olvide importar `By`:
```none
from selenium.webdriver.common.by import By
```
Itera sobre los elementos seleccionados y prepárate para extraer datos de cada uno de ellos:
```none
for product_element in product_elements:
# extrae datos de cada elemento de producto
```
¡Genial! Estás un paso más cerca de extraer con éxito los datos de Alibaba.
### Paso n.º 6: extraer los elementos del producto
Inspecciona un elemento del producto para comprender su estructura HTML:
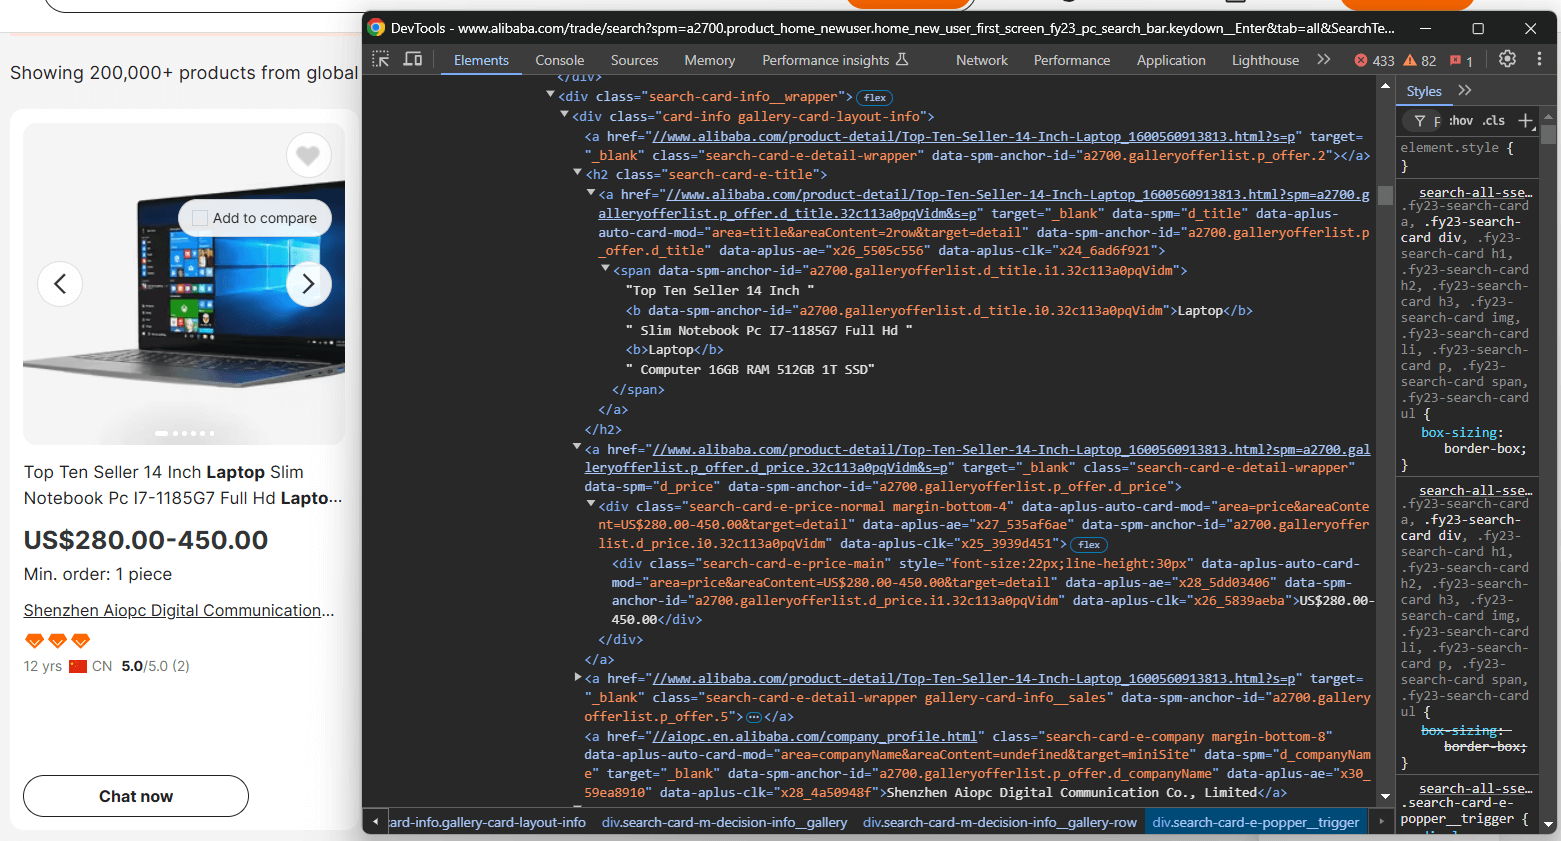Aquí puede ver que puede extraer:
- La imagen del producto desde `.search-card-e-slider__img`
- La descripción del producto de `.search-card-e-title`
- El rango de precios del producto de `.search-card-e-price-main`
- La empresa/fabricante de `.search-card-e-company`
En el bucle `«for»`, traduce esa información a lógica de rastreo:
```none
img_element = product_element.find_element(By.CSS_SELECTOR,".search-card-e-slider__img")
img = img_element.get_attribute("src")
description_element = product_element.find_element(By.CSS_SELECTOR,".search-card-e-title")
description = description_element.text.strip()
price_element = product_element.find_element(By.CSS_SELECTOR,".search-card-e-price-main")
price = price_element.text.strip()
company_element = product_element.find_element(By.CSS_SELECTOR,".search-card-e-company")
company = company_element.text.strip()
```
`find_element()` recupera el único elemento que coincide con el selector CSS dado. A continuación, puede acceder a su contenido de texto con el atributo `text`. Para obtener el valor del atributo HTML de un nodo, utilice el método `get_attribute()`.
Utilice los datos extraídos para rellenar un diccionario de productos y añádalo a la matriz `de productos`:
```none
product = {
"img": img,
"description": description,
"price": price,
"company": company
}
products.append(product)
```
¡Fantástico! La lógica de extracción de datos de Alibaba está completa.
### Paso n.º 7: Exportar los datos extraídos a CSV
Actualmente, los datos extraídos se almacenan en la matriz `de productos`. Para que sean accesibles y se puedan compartir con otras personas, es necesario exportarlos a un formato legible para los humanos, como un archivo CSV.
Utilice el siguiente código para crear y rellenar un archivo CSV con los datos extraídos:
```none
csv_file_name = "products.csv"
with open(csv_file_name, mode="w", newline="", encoding="utf-8") as csv_file:
writer = csv.DictWriter(csv_file, fieldnames=["image", "description", "price", "company"])
# escribir la fila del encabezado
writer.writeheader()
# escribir las filas de datos del producto
for product in products:
writer.writerow(product)
```
No olvides importar [`csv`](https://docs.python.org/3/library/csv.html) desde la biblioteca estándar de Python:
```none
import csv
```
¡Vaya! Tu Scraper Aliaba está completo.
### Paso n.º 8: Ponlo todo junto
A continuación se muestra el código final de tu script de scraping de Alibaba:
```none
from selenium import webdriver
from selenium.webdriver.chrome.service import Service
from selenium.webdriver.common.by import By
import csv
# inicializar una instancia del controlador web Chrome
driver = webdriver.Chrome(service=Service())
# la URL de la página de destino
url = "https://www.alibaba.com/trade/search?spm=a2700.product_home_newuser.home_new_user_first_screen_fy23_pc_search_bar.keydown__Enter&tab=all&SearchText=laptop"
# conectar a la página de destino
driver.get(url)
# dónde almacenar los datos extraídos
products = []
# seleccionar todos los elementos de producto de la página
product_elements = driver.find_elements(By.CSS_SELECTOR, ".m-gallery-product-item-v2")
# iterar sobre los nodos de producto y extraer datos de ellos
for product_element in product_elements:
# extraer los detalles del producto
img_element = product_element.find_element(By.CSS_SELECTOR,".search-card-e-slider__img")
img = img_element.get_attribute("src")
description_element = product_element.find_element(By.CSS_SELECTOR,".search-card-e-title")
description = description_element.text.strip()
price_element = product_element.find_element(By.CSS_SELECTOR,".search-card-e-price-main")
price = price_element.text.strip()
company_element = product_element.find_element(By.CSS_SELECTOR,".search-card-e-company")
company = company_element.text.strip()
# crear un diccionario de productos con los
# datos extraídos
product = {
"img": img,
"description": description,
"price": price,
"company": company
}
# añadir los datos del producto a la matriz
products.append(product)
# definir el nombre del archivo CSV de salida
csv_file_name = "products.csv"
# abrir el archivo en modo escritura y crear un escritor CSV
with open(csv_file_name, mode="w", newline="", encoding="utf-8") as csv_file:
writer = csv.DictWriter(csv_file, fieldnames=["img", "description", "price", "company"])
# escribe la fila del encabezado
writer.writeheader()
# escribe las filas de datos del producto
for product in products:
writer.writerow(product)
# cierra el navegador
driver.quit()
```
¡Con poco más de 60 líneas de código, acabas de crear un Scraper de Alibaba en Python!
Inicia el Scraper con el siguiente comando:
```none
python3 script.py
```
O, en Windows:
```none
python script.py
```
Aparecerá un archivo `products.csv` en la carpeta de tu proyecto. Ábrelo y verás:
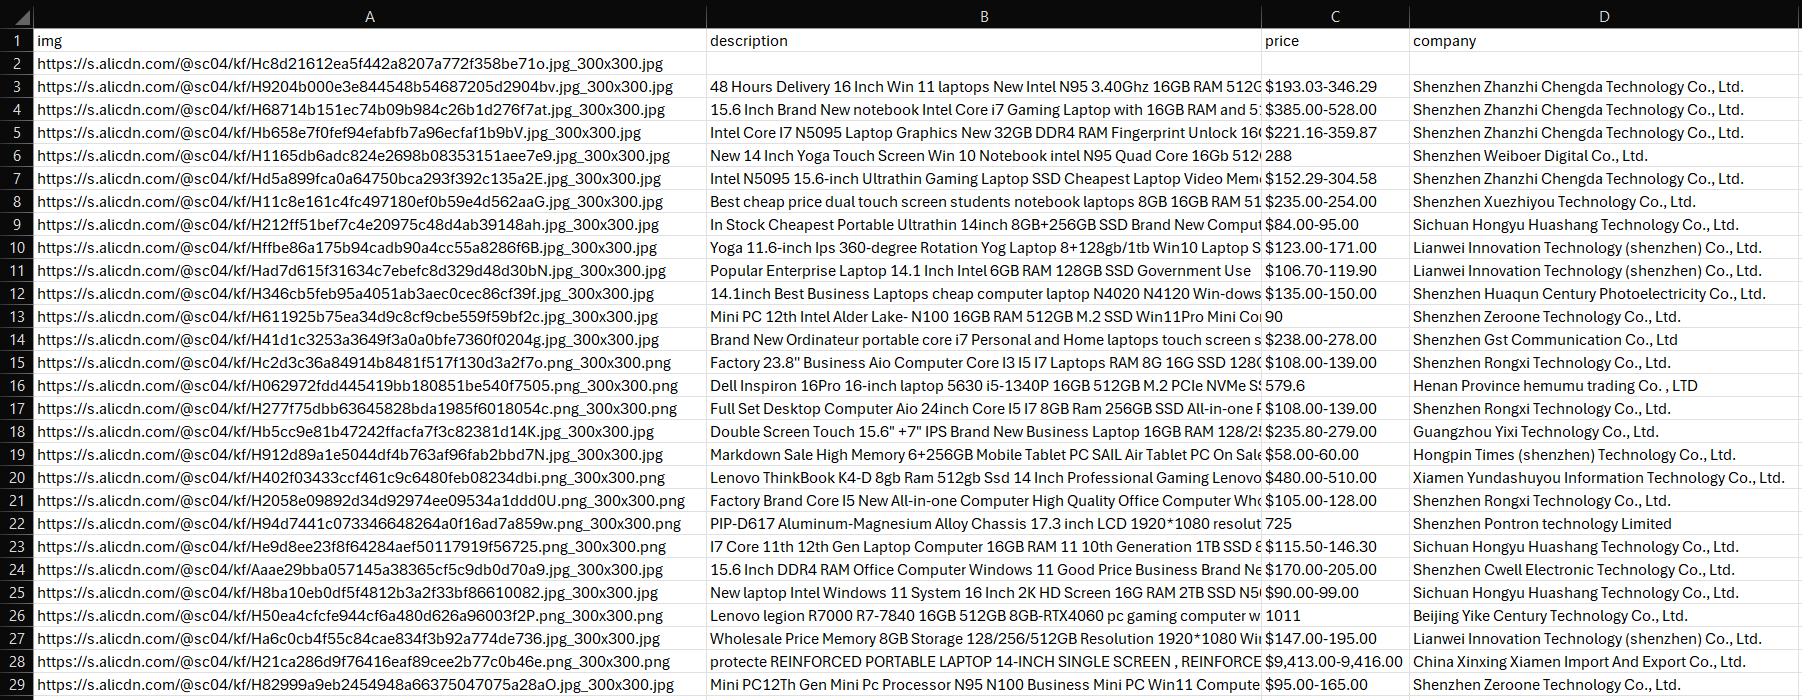¡Et voilà! Misión completada. ¿Los siguientes pasos? Gestiona la paginación, implementa tu script, automatiza su ejecución y perfecciónalo aún más para obtener un rendimiento óptimo.
## Conclusión
En este tutorial paso a paso, ha aprendido qué es un Scraper de Alibaba y los tipos de datos que puede recuperar. También ha visto cómo crear un script de Python para rastrear productos de Alibaba con menos de 100 líneas de código.
El problema es que el rastreo de Alibaba conlleva algunos retos. La plataforma emplea estrictas medidas anti-bot y adopta interacciones como la paginación que hacen que el proceso de rastreo sea más complejo. Crear una solución de rastreo de Alibaba escalable y eficaz puede ser bastante exigente.
¡Olvídate de esos retos con nuestra [API Alibaba Scraper](/products/web-scraper/alibaba)! Esta solución específica te permite recuperar datos del sitio de destino mediante simples llamadas a la API, sin riesgo de ser bloqueado.
Si el Scraping web no es su método preferido, pero sigue interesado en los datos de los productos, explore nuestros [Conjuntos de datos de Alibaba](/products/datasets/alibaba) listos para usar.
Cree hoy mismo una cuenta gratuita en Bright Data para probar nuestras API de Scraper o explorar nuestros Conjuntos de datos.
Contactar ventasPrueba gratuita
Tabla de Contenidos
[ ](https://news.ycombinator.com/submitlink?t=C%C3%B3mo+extraer+datos+de+Alibaba+con+Python+en+2026&u=https://brightdata.es/blog/datos-web/how-to-scrape-alibaba) [ ](https://www.linkedin.com/shareArticle?mini=true&title=C%C3%B3mo+extraer+datos+de+Alibaba+con+Python+en+2026&url=https://brightdata.es/blog/datos-web/how-to-scrape-alibaba) [ ](http://www.reddit.com/submit?title=C%C3%B3mo+extraer+datos+de+Alibaba+con+Python+en+2026&url=https://brightdata.es/blog/datos-web/how-to-scrape-alibaba)
## Usted también puede estar interesado en
[  ](https://brightdata.es/blog/ai/openhuman-with-bright-data "Acceso Web Listo para Producción en OpenHuman a Través de la CLI de Bright Data")
[AI

Antonello Zanini
Technical Writer
### Acceso Web Listo para Producción en OpenHuman a Través de la CLI de Bright Data
Integra la CLI de Bright Data con OpenHuman para habilitar acceso web listo para producción y recopilación de datos para agentes de IA.
09-Sep-2026
14 min de lectura
](https://brightdata.es/blog/ai/openhuman-with-bright-data)
[  ](https://brightdata.es/blog/datos-web/multimodal-web-scraping-with-minimax "Scraping Web Multimodal con MiniMax")
[Datos web

Antonello Zanini
Technical Writer
### Scraping Web Multimodal con MiniMax
Combina Bright Data Web Unlocker con la visión de MiniMax M3 para extraer datos estructurados de imágenes y capturas de pantalla de páginas web.
09-Sep-2026
5 min de lectura
](https://brightdata.es/blog/datos-web/multimodal-web-scraping-with-minimax)
[  ](https://brightdata.es/blog/ai/best-cli-tools-for-codex "Las 10 mejores herramientas CLI para Codex en 2026 – Probadas y clasificadas")
[AI

Daniel Shashko
Web Data & AI Expert
### Las 10 mejores herramientas CLI para Codex en 2026 – Probadas y clasificadas
Las 10 herramientas CLI que hacen a Codex más rápido y capaz, comenzando con la Bright Data CLI para acceso web real desde dentro del sandbox.
06-Sep-2026
24 min de lectura
](https://brightdata.es/blog/ai/best-cli-tools-for-codex)