


Los proxies son direcciones IP de un servidor que se conectan a internet en tu nombre. En lugar de transmitir tus solicitudes directamente a los sitios web, los proxies las enrutan a través de un servidor, ocultando tu dirección IP y ubicación originales. Esto protege tu privacidad, evita el rastreo y previene bloqueos. Los proxies también cifran tus datos para mayor seguridad.
En este artículo, aprenderás a usar proxies con Python requests, particularmente para scraping web. El scraping web consiste en extraer datos de sitios web, pero muchos sitios tienen restricciones. Los proxies ayudan a evitar esto cambiando tu IP y ubicación, dificultando que los sitios web te detecten y bloqueen. También puedes usar varios proxies para distribuir solicitudes y acelerar el proceso.
A continuación, aprenderás a implementar un proxy en tu proyecto usando el paquete Requests de Python.
Cómo usar un Proxy con una solicitud Python
Para usar un proxy con una solicitud de Python, necesitas establecer un nuevo proyecto de Python en tu computadora para escribir y ejecutar los scripts de Python para scraping web. Crea un directorio (por ejemplo web_scrape_project) donde almacenarás tus archivos de código fuente.
Todos los códigos de este tutorial están disponibles en este repositorio de GitHub.
Instalar paquetes
Después de crear tu directorio, necesitas instalar los siguientes paquetes de Python para enviar solicitudes a la página web y recopilar los enlaces:
- Página web de Bright Data
Componentes de una dirección IP de Proxy
Antes de usar un proxy, es mejor entender sus componentes. Los siguientes son los tres componentes principales de un servidor proxy:
- Protocolo muestra el tipo de contenido al que puedes acceder en internet. Los protocolos más comunes son HTTP y HTTPS.
- Dirección muestra dónde está ubicado el servidor proxy. La dirección puede ser una IP (por ejemplo
192.167.0.1) o un nombre de host DNS (por ejemploproxyprovider.com). - Puerto usado para dirigir el tráfico al proceso de servidor correcto cuando se ejecutan varios servicios en una sola máquina (por ejemplo número de puerto
2000).
Usando estos tres componentes, una dirección IP de proxy se vería así: 192.167.0.1:2000 o proxyprovider.com:2000.
Cómo configurar Proxies directamente en Requests
Hay varias formas de configurar proxies en solicitudes de Python, y en este artículo verás tres escenarios diferentes. En este primer ejemplo, aprenderás a configurar proxies directamente en el módulo requests.
Para empezar, necesitas importar los paquetes Requests y Beautiful Soup en tu archivo Python para scraping web. Luego crea un diccionario llamado proxies que contenga la información del servidor proxy para ocultar tu dirección IP al hacer scraping de la página web. Aquí debes definir las conexiones HTTP y HTTPS a la URL del proxy.
También necesitas definir la variable de Python para establecer la URL de la página web de la que quieres extraer los datos. Para este tutorial, la URL es https://brightdata.com/
A continuación, necesitas enviar una solicitud GET a la página web usando el método request.get(). El método toma dos argumentos: la URL del sitio web y los proxies. Luego la respuesta de la página web se almacena en la variable response.
Para recopilar los enlaces, usa el paquete Beautiful Soup para analizar el contenido HTML de la página web pasando response.content y html.parser como argumentos al método BeautifulSoup().
Luego usa el método find_all() con a como argumento para encontrar todos los enlaces en la página web. Finalmente, extrae el atributo href de cada enlace usando el método get().
A continuación está el código fuente completo para configurar proxies directamente en requests:
# import packages.
import requests
from bs4 import BeautifulSoup

# Define proxies to use.
proxies = {
    'http': 'http://proxyprovider.com:2000',
    'https': 'http://proxyprovider.com:2000',
}

# Define a link to the web page.
url = "https://brightdata.com/"

# Send a GET request to the website.
response = requests.get(url, proxies=proxies)

# Use BeautifulSoup to parse the HTML content of the website.
soup = BeautifulSoup(response.content, "html.parser")

# Find all the links on the website.
links = soup.find_all("a")

# Print all the links.
for link in links:
    print(link.get("href"))
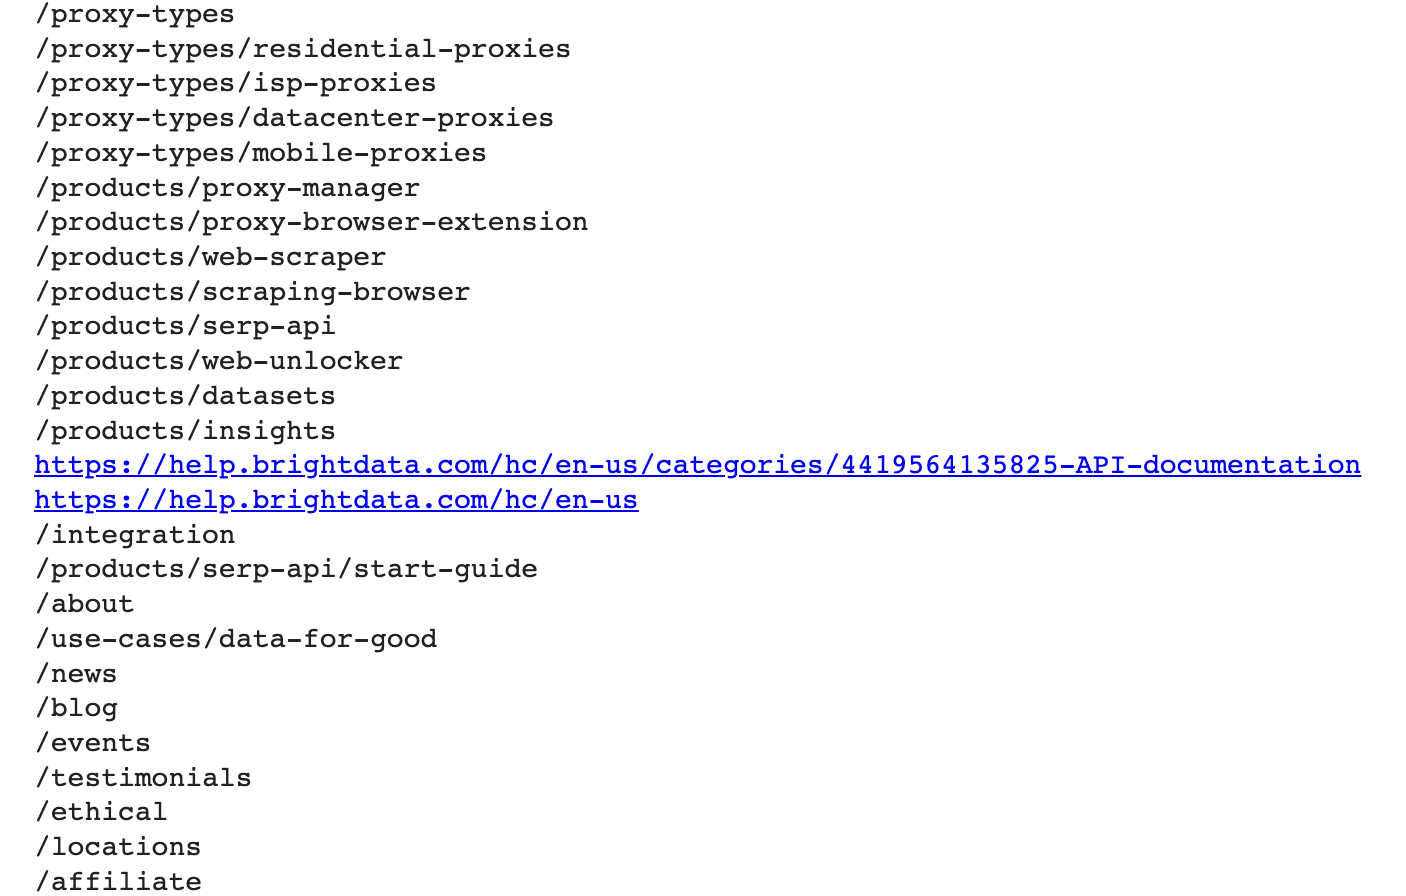
Cuando ejecutas este bloque de código, envía una solicitud a la página web definida usando la dirección IP del proxy y luego devuelve la respuesta que contiene todos los enlaces a esa página web:
Cómo configurar Proxies mediante variables de entorno
A veces, debes usar el mismo proxy para todas tus solicitudes a diferentes páginas web. En este caso, tiene sentido configurar variables de entorno para tu proxy.
Para que las variables de entorno del proxy estén disponibles cada vez que ejecutes scripts en la shell, ejecuta el siguiente comando en tu terminal:
export HTTP_PROXY='http://proxyprovider.com:2000'
export HTTPS_PROXY='https://proxyprovider.com:2000'
Aquí, la variable HTTP_PROXY configura el servidor proxy para solicitudes HTTP, y la variable HTTPS_PROXY configura el servidor proxy para solicitudes HTTPS.
En este punto, tu código Python tiene pocas líneas y usa las variables de entorno cada vez que haces una solicitud a la página web:
# import packages.
import requests
from bs4 import BeautifulSoup

# Define a link to the web page.
url = "https://brightdata.com/"

# Send a GET request to the website.
response = requests.get(url)

# Use BeautifulSoup to parse the HTML content of the website.
soup = BeautifulSoup(response.content, "html.parser")

# Find all the links on the website.
links = soup.find_all("a")

# Print all the links.
for link in links:
    print(link.get("href"))
Cómo rotar Proxies usando un método personalizado y un array de Proxies
Rotar proxies es crucial porque los sitios web a menudo bloquean o restringen el acceso a bots y scrapers cuando reciben una gran cantidad de solicitudes desde la misma dirección IP. Cuando esto sucede, los sitios web pueden sospechar actividad de scraping malicioso y, en consecuencia, implementar medidas para bloquear o limitar el acceso.
Al rotar entre diferentes direcciones IP de proxy, puedes evitar ser detectado, aparecer como múltiples usuarios orgánicos y eludir la mayoría de las medidas anti-scraping implementadas en el sitio web.
Para rotar proxies, necesitas importar algunas bibliotecas de Python: Requests, Beautiful Soup y Random.
Luego crea una lista de proxies para usar durante el proceso de rotación. Esta lista debe contener las URL de los servidores proxy en este formato: http://proxyserver.com:port:
# List of proxies
proxies = [
    "http://proxyprovider1.com:2010", "http://proxyprovider1.com:2020",
    "http://proxyprovider1.com:2030", "http://proxyprovider2.com:2040",
    "http://proxyprovider2.com:2050", "http://proxyprovider2.com:2060",
    "http://proxyprovider3.com:2070", "http://proxyprovider3.com:2080",
    "http://proxyprovider3.com:2090"
]
Luego crea un método personalizado llamado get_proxy(). Este método selecciona aleatoriamente un proxy de la lista de proxies usando el método random.choice() y devuelve el proxy seleccionado en formato de diccionario (claves HTTP y HTTPS). Usarás este método cada vez que envíes una nueva solicitud:
# Custom method to rotate proxies
def get_proxy():
    # Choose a random proxy from the list
    proxy = random.choice(proxies)
    # Return a dictionary with the proxy for both http and https protocols
    return {'http': proxy, 'https': proxy}
Una vez que hayas creado el método get_proxy(), necesitas crear un bucle que envíe un cierto número de solicitudes GET usando los proxies rotados. En cada solicitud, el método get() usa un proxy elegido aleatoriamente especificado por el método get_proxy().
Luego necesitas recopilar los enlaces del contenido HTML de la página web usando el paquete Beautiful Soup, como se explicó en el primer ejemplo.
Finalmente, el código Python captura cualquier excepción que ocurra durante el proceso de solicitud e imprime el mensaje de error en la consola.
Aquí está el código fuente completo para este ejemplo:
# import packages
import requests
from bs4 import BeautifulSoup
import random

# List of proxies
proxies = [
    "http://proxyprovider1.com:2010", "http://proxyprovider1.com:2020",
    "http://proxyprovider1.com:2030", "http://proxyprovider2.com:2040",
    "http://proxyprovider2.com:2050", "http://proxyprovider2.com:2060",
    "http://proxyprovider3.com:2070", "http://proxyprovider3.com:2080",
    "http://proxyprovider3.com:2090"
]


# Custom method to rotate proxies
def get_proxy():
    # Choose a random proxy from the list
    proxy = random.choice(proxies)
    # Return a dictionary with the proxy for both http and https protocols
    return {'http': proxy, 'https': proxy}


# Send requests using rotated proxies
for i in range(10):
    # Set the URL to scrape
    url = 'https://brightdata.com/'
    try:
        # Send a GET request with a randomly chosen proxy
        response = requests.get(url, proxies=get_proxy())

        # Use BeautifulSoup to parse the HTML content of the website.
        soup = BeautifulSoup(response.content, "html.parser")

        # Find all the links on the website.
        links = soup.find_all("a")

        # Print all the links.
        for link in links:
            print(link.get("href"))
    except requests.exceptions.RequestException as e:
        # Handle any exceptions that may occur during the request
        print(e)
Usando el servicio de Proxy de Bright Data con Python
Si buscas un proxy confiable, rápido y estable para tus tareas de scraping web, no busques más allá de Bright Data, una infraestructura de datos web que ofrece diferentes tipos de proxies para una amplia gama de casos de uso.
Bright Data tiene una gran red de más de 400M+ monthly IPs de proxy residencial y más de 770,000 proxies de centro de datos que les ayuda a ofrecer soluciones de proxy confiables y rápidas. Sus ofertas de proxy están diseñadas para ayudarte a superar los desafíos del scraping web, la verificación de anuncios y otras actividades en línea que requieren recopilación de datos web anónima y eficiente.
Integrar los proxies de Bright Data en tus solicitudes de Python es fácil. Por ejemplo, usa los proxies de centro de datos para enviar una solicitud a la URL usada en los ejemplos anteriores.
Si aún no tienes una cuenta, regístrate en Bright Data y luego agrega tus datos para registrar tu cuenta.
Una vez que hayas terminado, sigue estos pasos para crear tu primer proxy:
Haz clic en Ver producto de proxy en la página de bienvenida para ver los diferentes tipos de proxy que ofrece Bright Data:

Selecciona Proxies de centro de datos para crear un nuevo proxy, y en la página siguiente, agrega tus datos y guárdalo:

Una vez creado tu proxy, puedes ver los parámetros importantes (por ejemplo host, puerto, usuario y contraseña) para comenzar a acceder y usarlo:
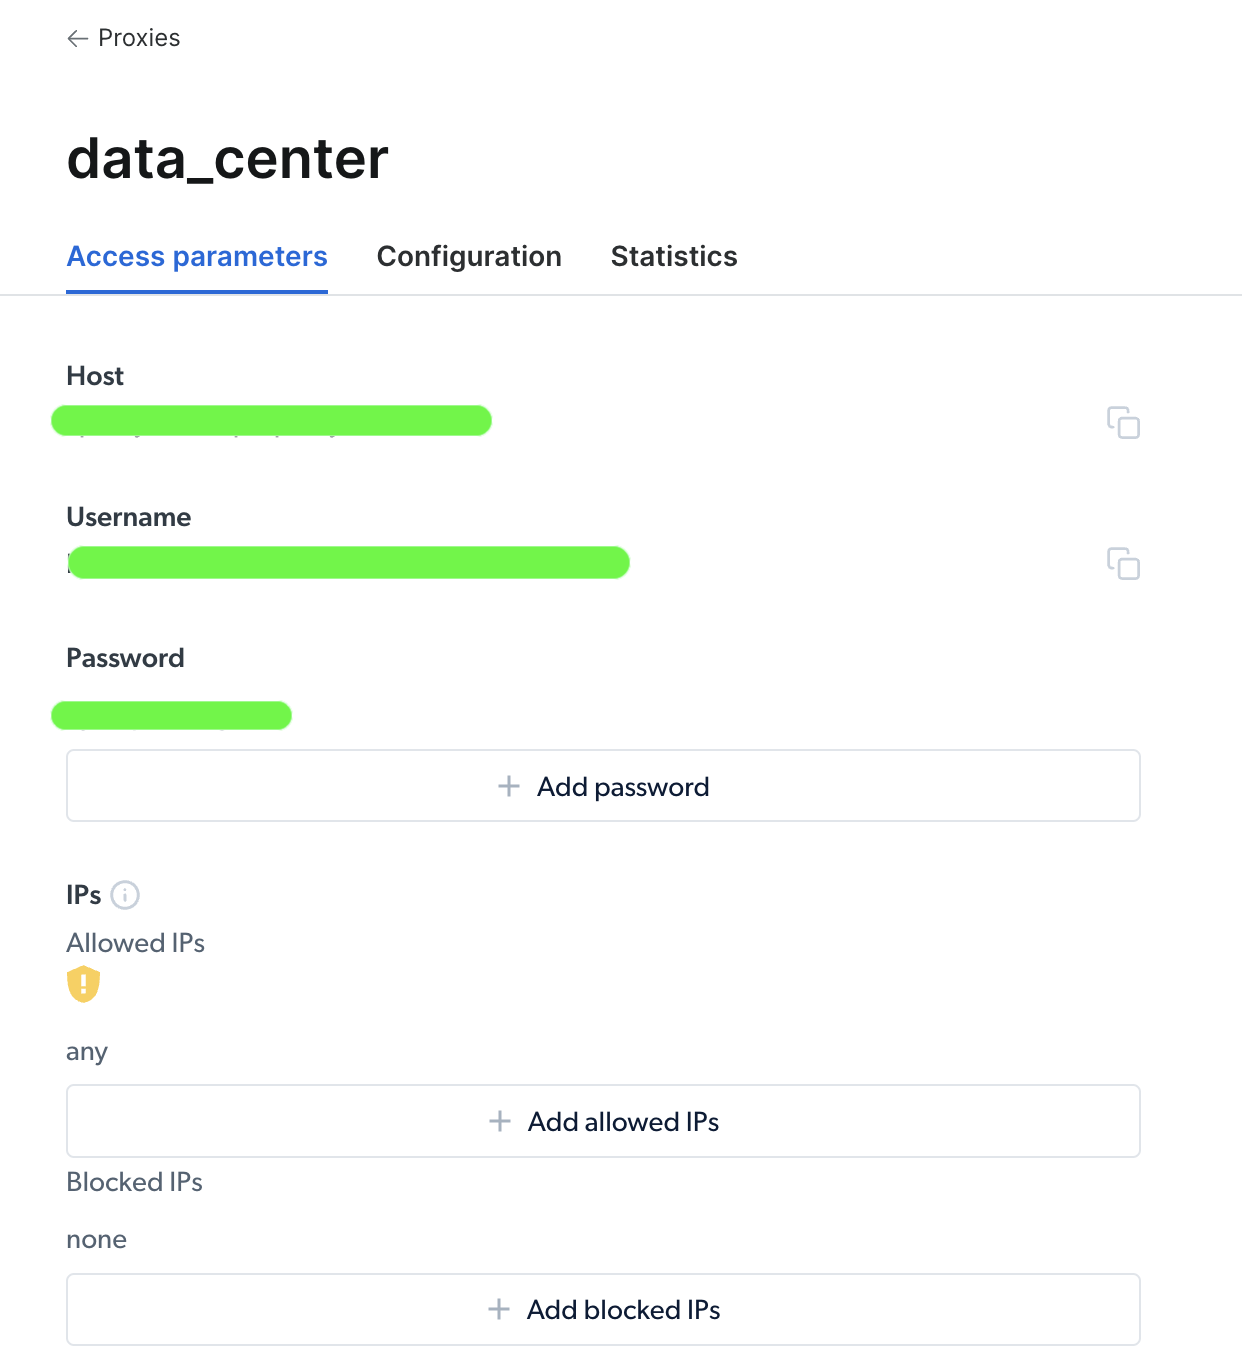
Una vez que hayas accedido a tu proxy, puedes usar la información de los parámetros para configurar tu URL de proxy y enviar una solicitud usando el paquete Requests de Python. El formato de la URL del proxy es username-(session-id)-password@host:port.
Nota: El
session-ides un número aleatorio creado usando un paquete de Python llamadorandom.
A continuación se muestra cómo se vería tu código de ejemplo para configurar tu proxy de Bright Data en una solicitud Python:
import requests
from bs4 import BeautifulSoup
import random

# Define parameters provided by Brightdata
host = 'brd.superproxy.io'
port = 33335
username = 'username'
password = 'password'
session_id = random.random()

# format your proxy
proxy_url = ('http://{}-session-{}:{}@{}:{}'.format(username, session_id,
                                                     password, host, port))

# define your proxies in dictionary
proxies = {'http': proxy_url, 'https': proxy_url}

# Send a GET request to the website
url = "https://brightdata.com/"
response = requests.get(url, proxies=proxies)

# Use BeautifulSoup to parse the HTML content of the website
soup = BeautifulSoup(response.content, "html.parser")

# Find all the links on the website
links = soup.find_all("a")

# Print all the links
for link in links:
    print(link.get("href"))
Aquí, importas los paquetes y defines las variables de host, puerto, usuario, contraseña y session_id del proxy. Luego creas un diccionario proxies con las claves http y https y las credenciales del proxy. Finalmente, pasas el parámetro proxies a la función requests.get() para hacer la solicitud HTTP y recopilar los enlaces de la URL.
¡Y eso es todo! Acabas de hacer una solicitud exitosa usando el servicio de proxy de Bright Data.
Conclusión
En este artículo, aprendiste por qué necesitas proxies, así como las diferentes formas en que puedes usarlos para enviar una solicitud a una página web usando el paquete Requests de Python.
Con la infraestructura web de Bright Data, puedes obtener proxies confiables para tu proyecto que cubran cualquier país o ciudad del mundo. Ofrecen múltiples formas de obtener los datos que necesitas a través de varios tipos de proxies y herramientas para scraping web que se adaptan a tus necesidades específicas.
Ya sea que busques recopilar datos de estudio de mercado, monitorear reseñas en línea o rastrear precios de la competencia, Bright Data tiene los recursos que necesitas para hacer el trabajo de forma rápida y eficiente.


