En esta publicación del blog, descubrirás:
- Qué es el scraping de audio y cómo realizarlo.
- Los principales desafíos al hacer scraping de audio web y prepararlo para su procesamiento.
- Cómo hacer scraping de audio a gran escala.
- Cómo convertir el audio extraído a formato WAV para procesamiento basado en IA.
- Cómo generar transcripciones con marcas de tiempo a partir de audio usando modelos de IA de voz a texto.
- Casos de uso relevantes para los datos de audio extraídos.
¡Vamos a profundizar!
Cómo Funciona el Scraping de Audio Web
El scraping de audio web se refiere a la descarga automática de contenido de audio desde sitios web. El audio puede provenir de un archivo independiente o estar incrustado dentro de un video.
Descargar el audio suele ser solo el primer paso. En aplicaciones del mundo real, el objetivo es usar el audio extraído para análisis automatizado, detección de texto, o entrenamiento de modelos de IA. Para realizar estas tareas, generalmente también necesitas el texto contenido en el audio.
Aquí es donde la transcripción de audio se vuelve importante. Al convertir el audio extraído en texto, puedes hacer que el contenido hablado sea buscable. Agregar marcas de tiempo a cada segmento de la transcripción también te permite vincular fragmentos específicos de texto con sus puntos correspondientes en la onda de audio original.
En otras palabras, el scraping te da acceso al audio crudo. Luego, la transcripción transforma ese audio en texto estructurado y legible por máquina, que puede emplearse en una amplia gama de tareas de IA y procesamiento de datos.
En este tutorial, se te guiará a través del proceso completo. Aprenderás a hacer scraping y descargar audio de la web, convertirlo a un formato adecuado, y procesarlo con modelos de IA para generar una transcripción.
Desafíos del Scraping de Audio y Soluciones
Hacer scraping de audio desde la web puede parecer sencillo, pero construir un pipeline de procesamiento de audio confiable implica muchos obstáculos.
Primero necesitas encontrar una fuente de audio accesible, luego superar posibles restricciones al recuperarla, y finalmente convertir el audio en texto utilizable. ¡Afortunadamente, cada uno de estos desafíos puede resolverse con las herramientas y el flujo de trabajo adecuados!
Encontrar Fuentes de Audio en la Web
El primer desafío es encontrar una fuente de audio adecuada para extraer. A diferencia de las páginas web, el audio no siempre está disponible a través de una URL de descarga directa y evidente.
Por ejemplo, el audio de interés podría provenir de un video alojado en plataformas como YouTube, Vimeo o Bilibili. Una solución es hacer scraping de estos videos y extraer sus pistas de audio, lo que te da acceso a un grupo mucho más amplio de contenido de audio.
Si quieres evitar por completo el scraping de audio web, considera usar los conjuntos de datos de audio listos para IA de Bright Data. Estos ya están recopilados y preparados para flujos de trabajo de IA y aprendizaje automático.
Superar los Desafíos de Acceso Web y Anti-Bot
Encontrar una fuente de audio es solo parte del problema. Una vez que identificas el contenido que deseas recopilar, el sitio web objetivo puede aplicar técnicas anti-scraping. Estas incluyen verificaciones de reputación de IP, límites de velocidad, CAPTCHAs, desafíos de JavaScript y otros mecanismos anti-bot.
Aquí es donde Bright Data puede ayudar. Bright Data ofrece infraestructura de acceso web diseñada para ayudarte a recopilar datos web públicamente disponibles a escala empresarial. Su portafolio de productos incluye soluciones como API Web Unlocker, Browser API y servicios de proxy.
La red de Bright Data incluye más de 400 millones de IPs en 195 países. Esta infraestructura admite concurrencia ilimitada, con una tasa de éxito del 99.95% y un tiempo de actividad del 99.99%.
Pronto verás cómo usar Web Unlocker API para acceder a recursos de audio de cualquier sitio. Esto nos permite enfocarnos en el flujo de procesamiento de audio en lugar de construir tu propia capa de acceso web.
Convertir Audio en Texto Utilizable
El problema final es convertir el audio extraído en texto. Esto no siempre es simple, especialmente cuando las grabaciones contienen ruido de fondo, múltiples hablantes o habla poco clara. Sin embargo, los modelos modernos de transcripción con IA pueden manejar la mayoría de estas situaciones. Agregar marcas de tiempo hace que la transcripción sea aún más útil al conectar cada sección de texto con su posición en la grabación.
Paso #1: Extraer el Recurso de Audio desde la Web
El scraping de audio web comienza con la construcción de un sistema automatizado para recopilar contenido de audio desde la web. Esto puede implicar apuntar directamente a archivos de audio, como archivos MP3, o, más comúnmente, descargar videos y extraer la pista de audio de ellos.
Para ayudar a superar las restricciones que los sitios web pueden aplicar a los bots de scraping, enrutarás tus solicitudes automatizadas a través de Web Unlocker API de Bright Data. De esta manera, puedes olvidarte de los CAPTCHAs, límites de velocidad y otras restricciones de acceso.
¡Sigue las instrucciones a continuación!
Requisitos Previos
Antes de comenzar, asegúrate de tener lo siguiente:
- Python 3.11+ instalado localmente.
- Un entorno de desarrollo Python, incluyendo un proyecto Python y un IDE de Python.
- Una cuenta de Bright Data con:
– Una clave API configurada.
– Un Web Unlocker API configurado.
Sigue los enlaces a continuación para obtener orientación adicional:
Asumiremos que tu Web Unlocker API se llama “web_unlocker”:
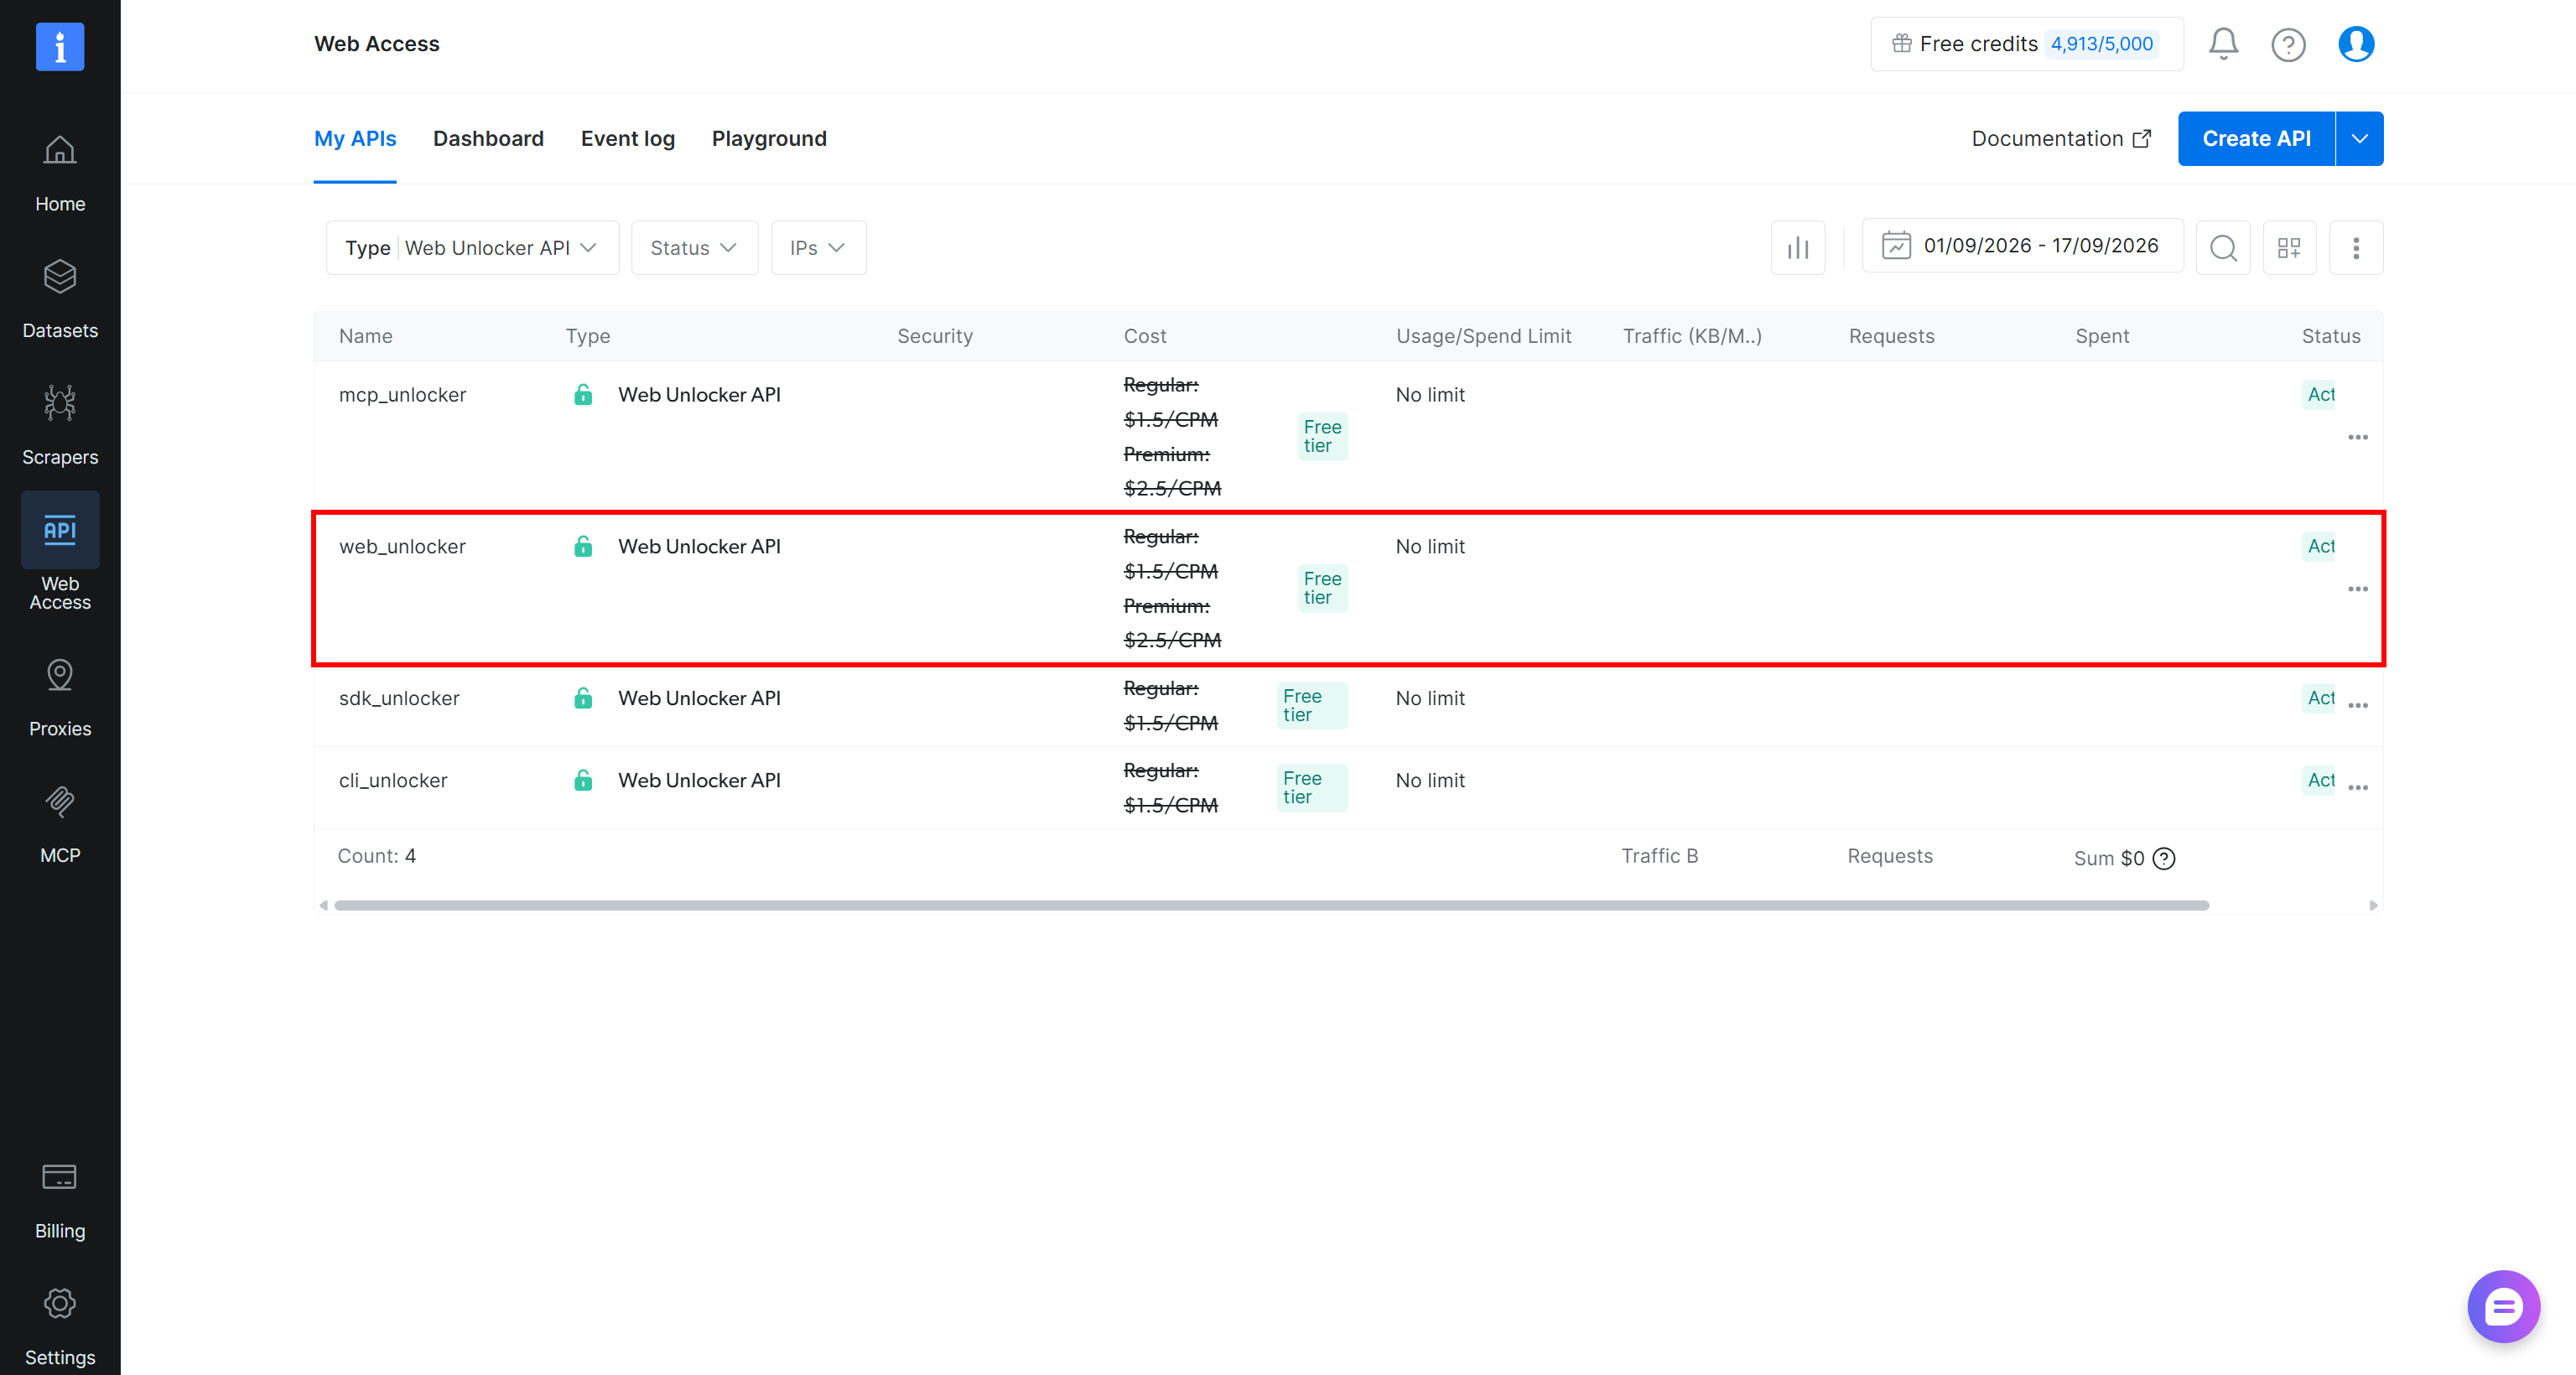
Importante: Asegúrate de adaptar los ejemplos de código en este paso para que coincidan con el nombre real de tu Web Unlocker API.
Además, puedes encontrar las credenciales para el modo proxy directamente en tu página de Web Unlocker API:
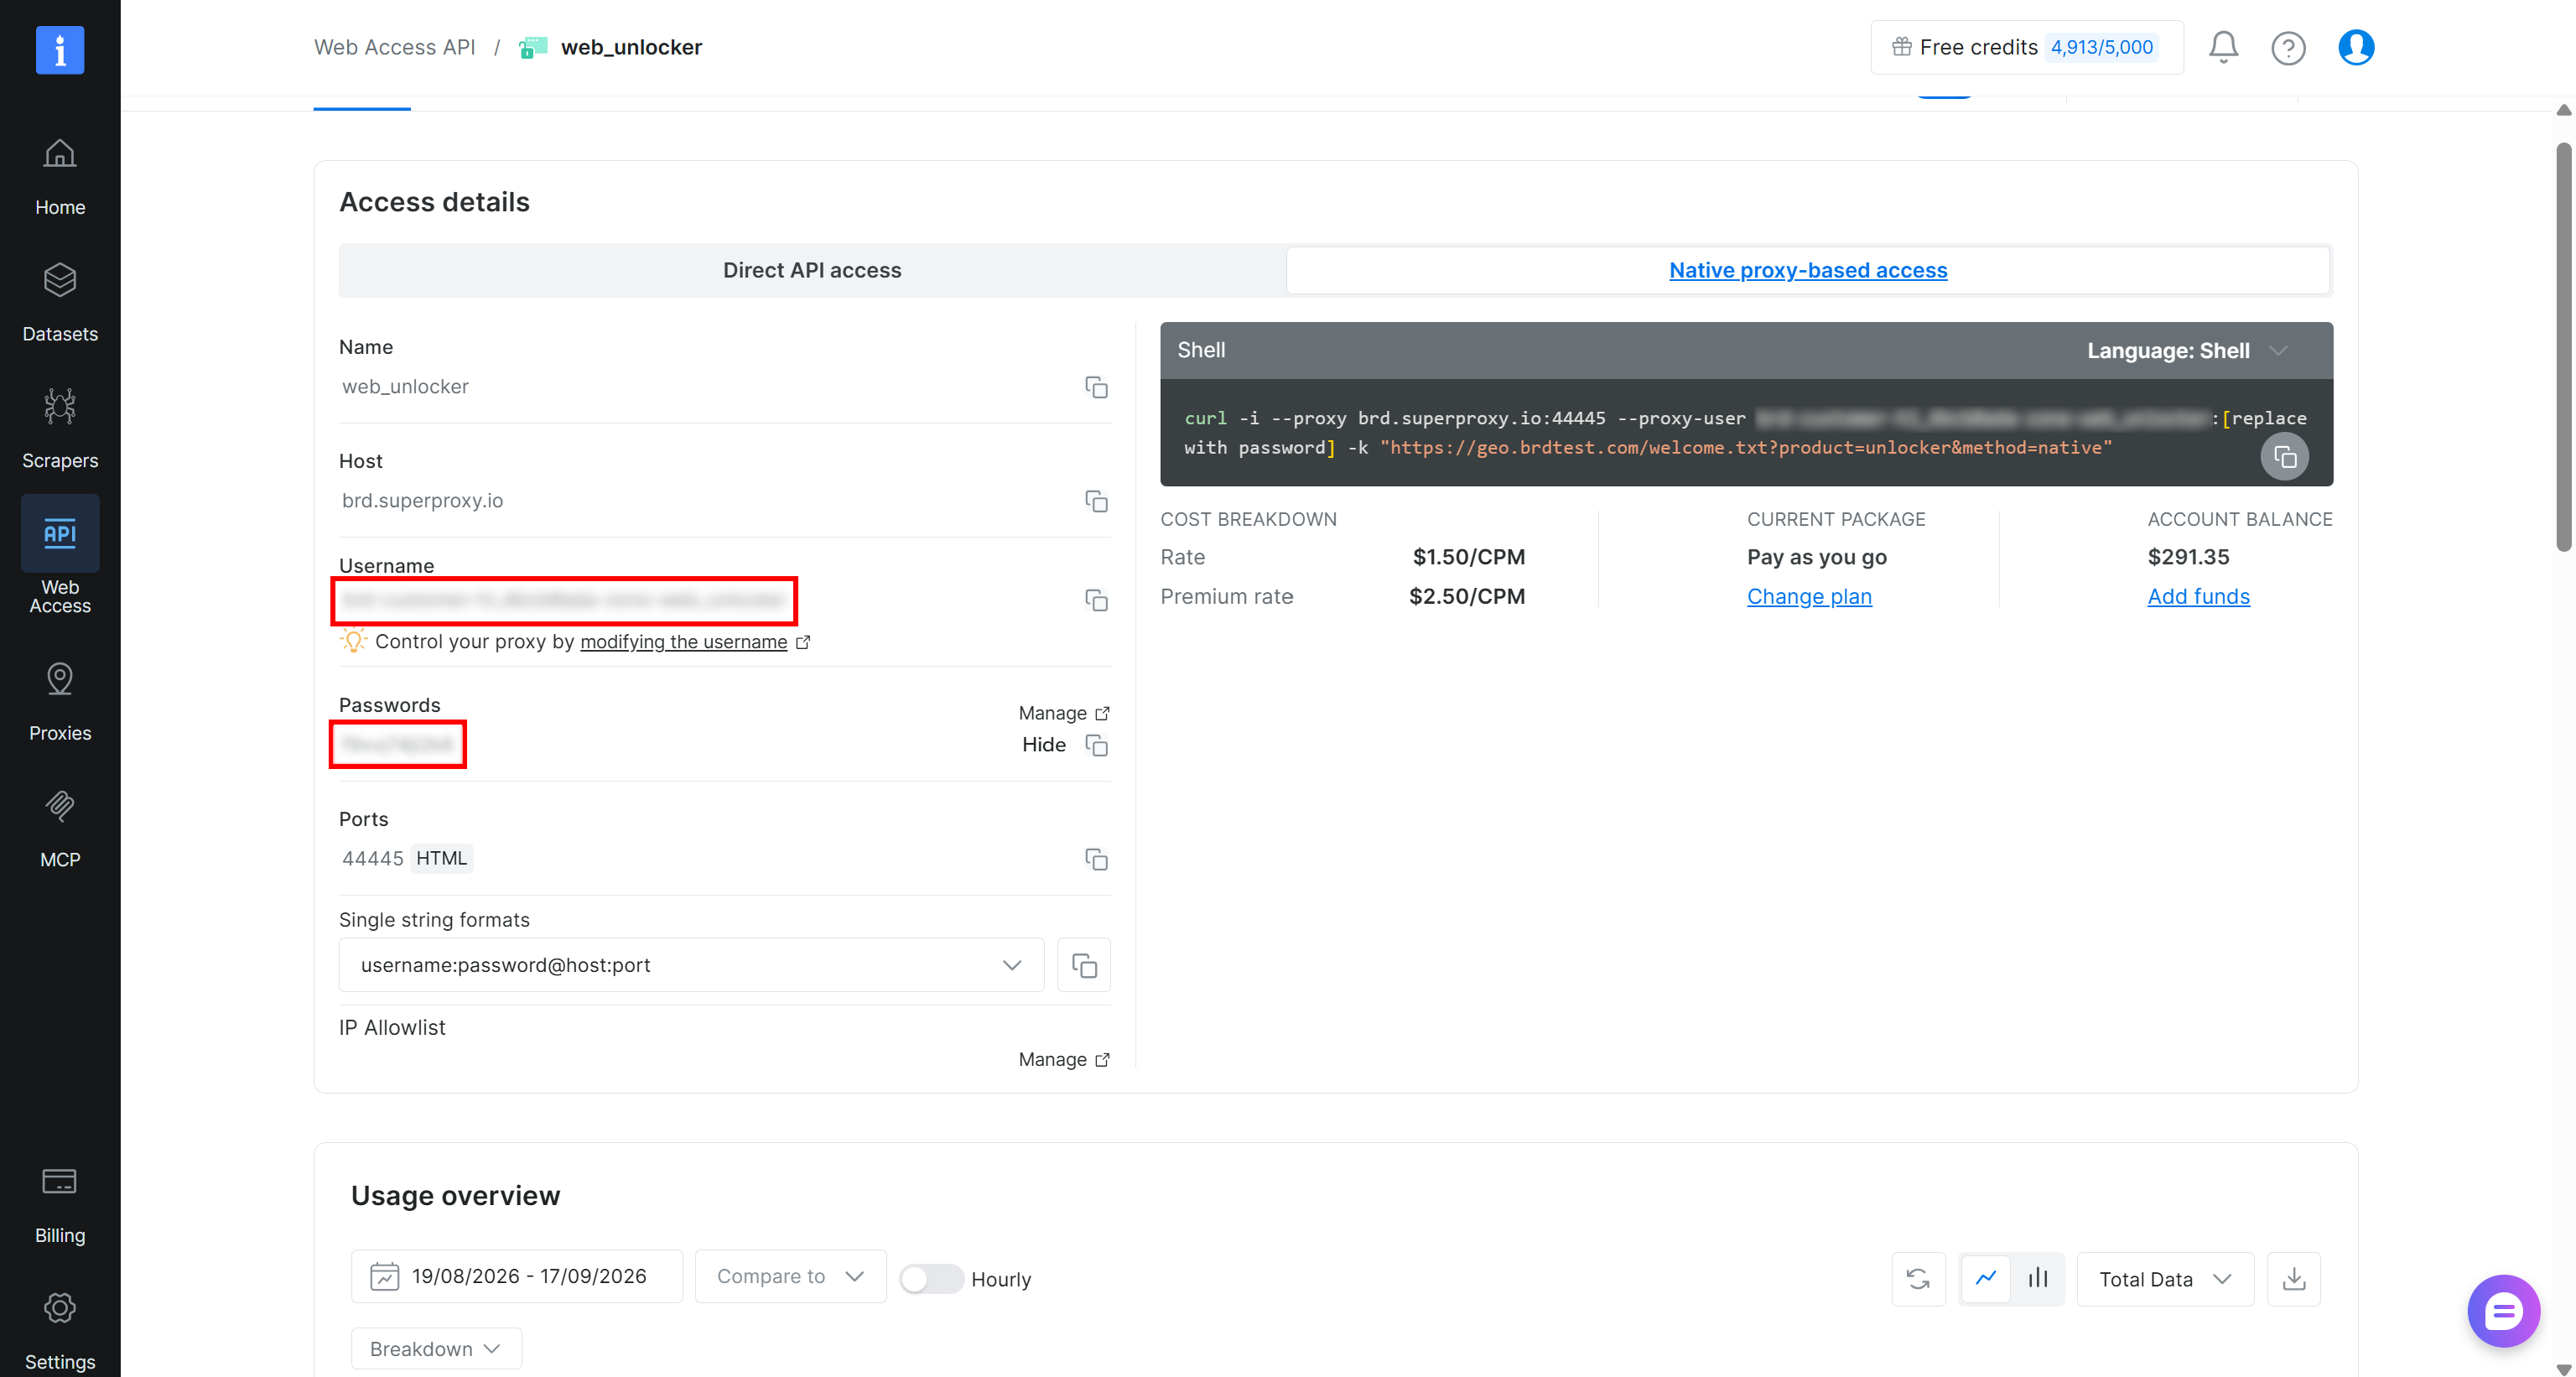
Ve a la pestaña “Acceso nativo basado en proxy” y haz clic en “Mostrar” junto a la contraseña. Ingresa el código de verificación enviado a tu correo electrónico.
Una vez que tengas tu usuario, contraseña y puerto de Web Unlocker API, puedes construir la URL del proxy usando el siguiente formato:
http://<WEB_UNLOCKER_API_USERNAME>:<WEB_UNLOCKER_API_PASSWORD>@brd.superproxy.io:<WEB_UNLOCKER_API_PORT>Al configurar este proxy en tu cliente HTTP de Python, sus solicitudes HTTP se enrutarán a través de tu Web Unlocker API para evitar bloqueos anti-bot.
Nota: Para evitar problemas de verificación de certificados SSL al usar Web Unlocker API en modo proxy, descarga e instala el certificado SSL de Bright Data en tu máquina local.
Descargar un Video en Línea
Supón que tu fuente de audio es un video de YouTube sin transcripción, como el siguiente:
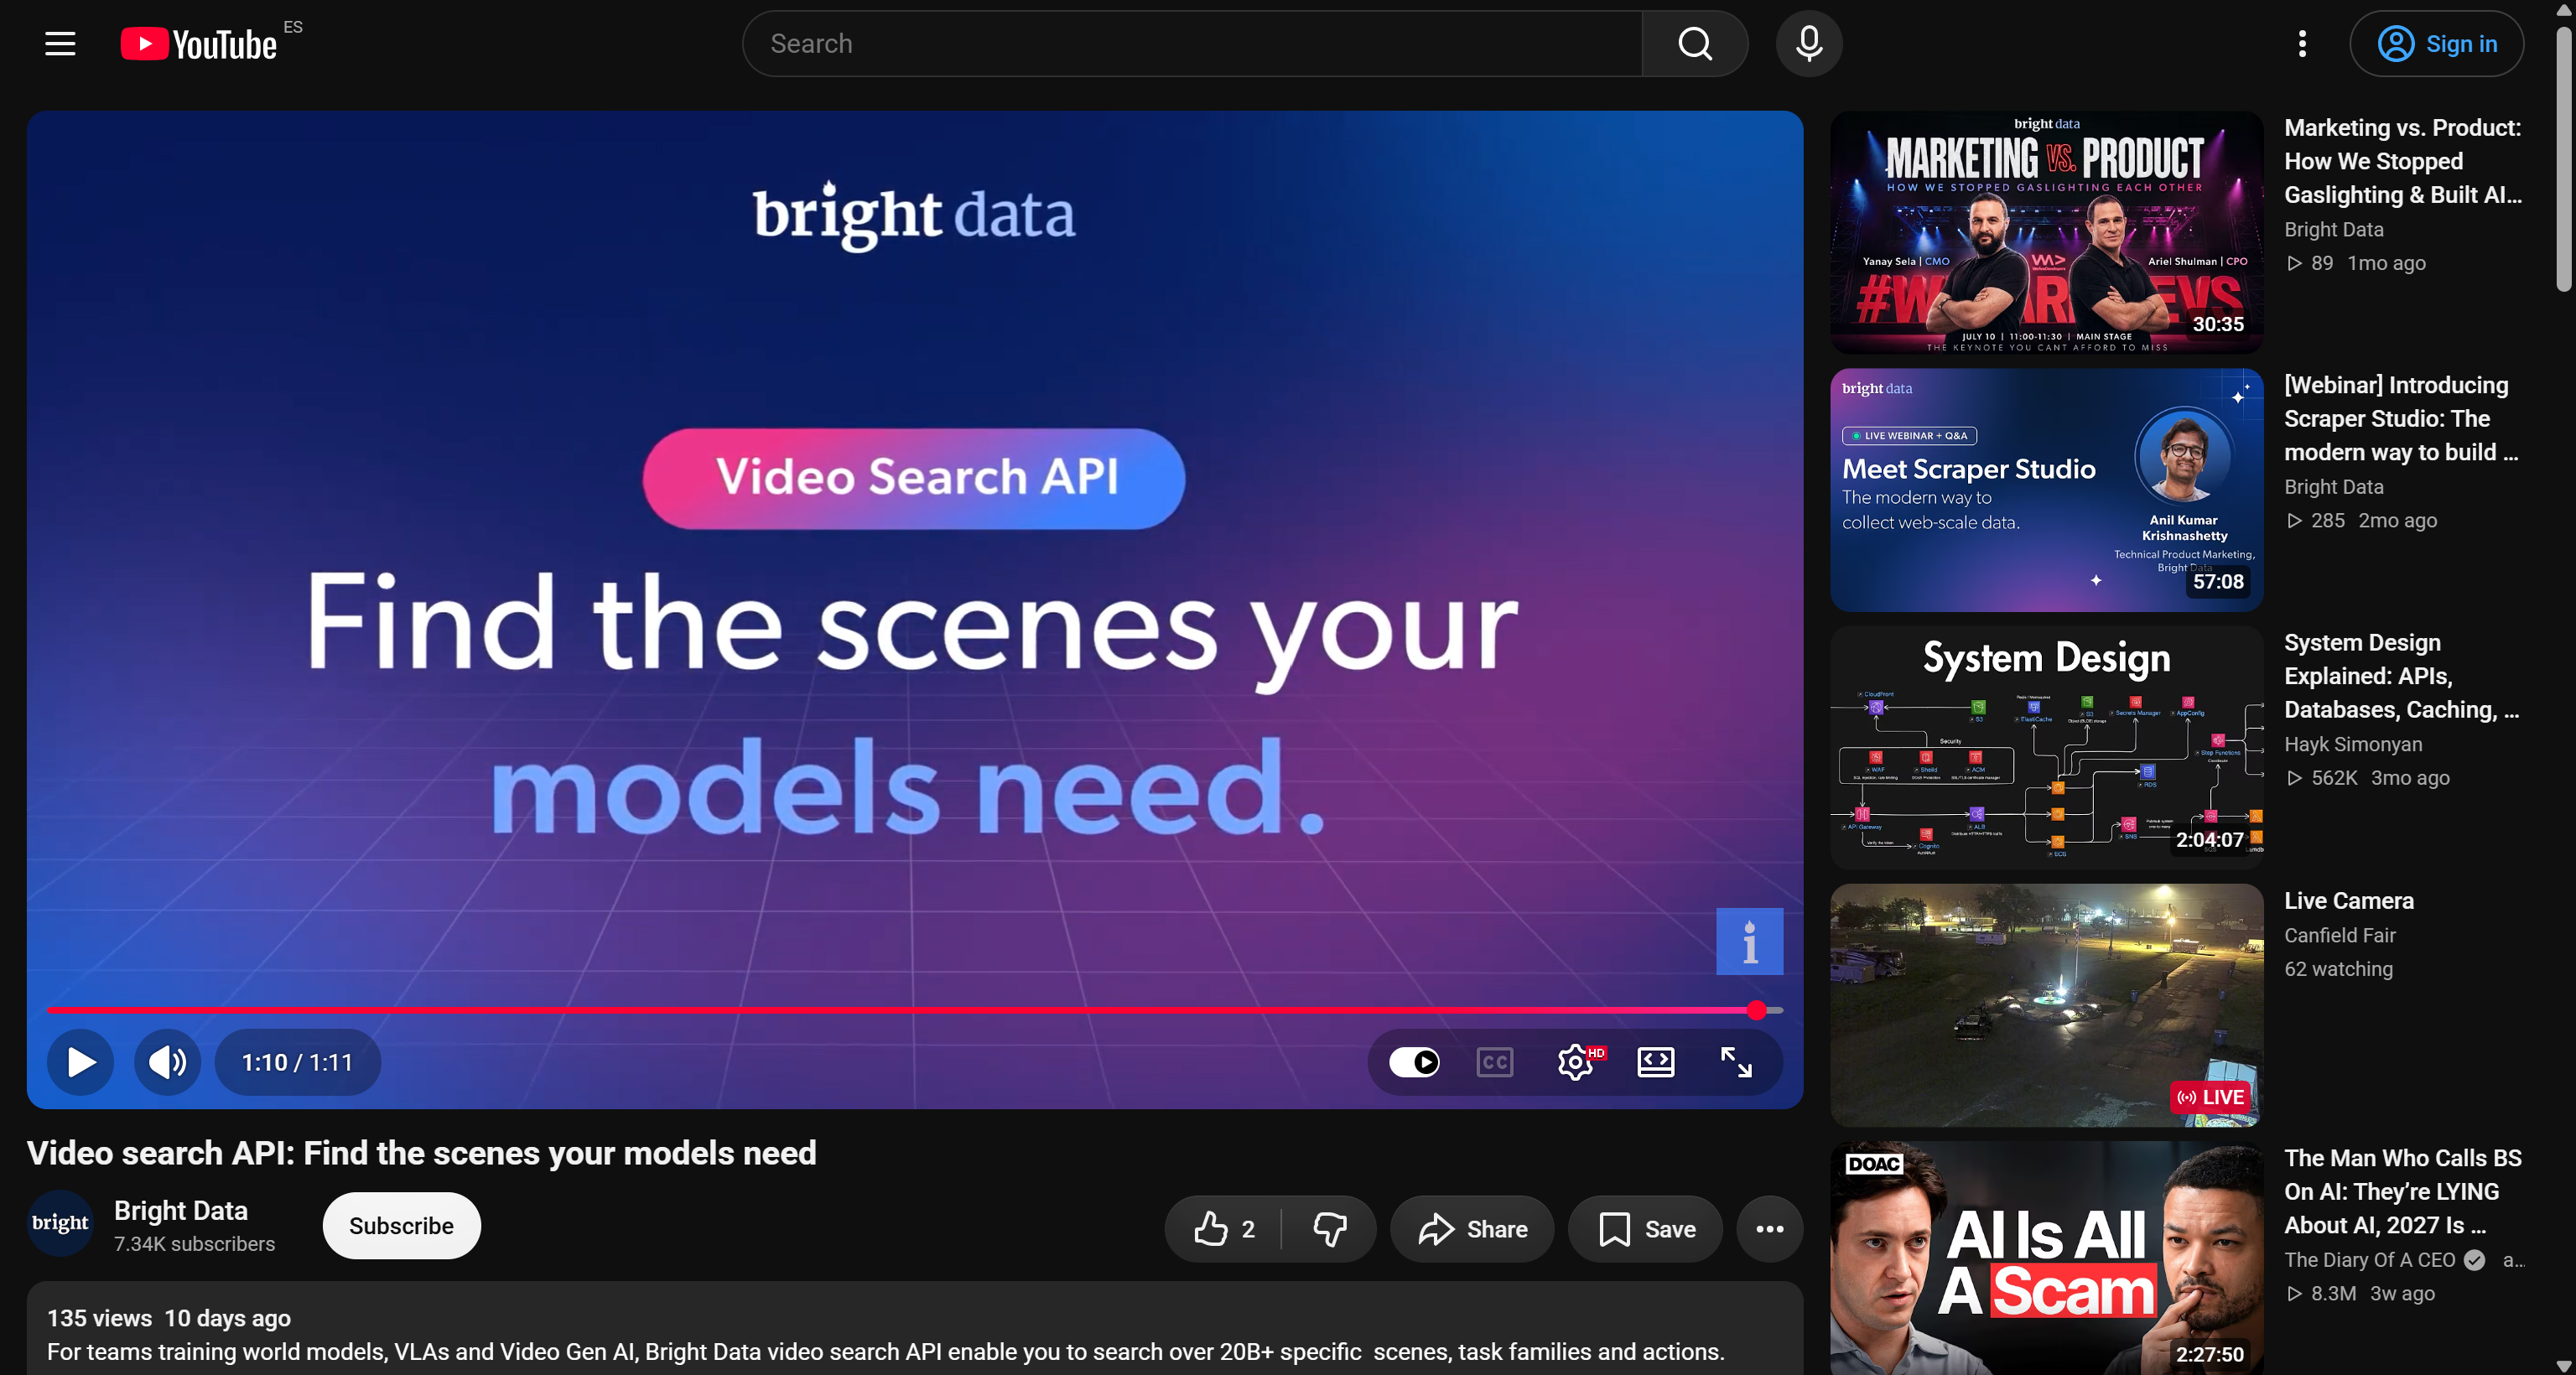
Como puedes ver, la opción “Subtítulos” está deshabilitada.
En este caso, el audio está contenido dentro de un video en lugar de proporcionarse como un archivo de audio independiente. Para descargar el video, puedes usar yt-dlp, una de las herramientas y bibliotecas de línea de comandos más populares para descargar contenido de video y audio.
Ten en cuenta que hacer scraping de videos de YouTube y plataformas similares puede rápidamente resultar en el bloqueo de tus solicitudes, especialmente al operar a gran escala. Para evitar estos problemas, necesitas rotación de IP confiable y mecanismos para manejar protecciones anti-bot.
Bright Data es compatible con yt-dlp, lo que te permite enrutar sus solicitudes a través de tu Web Unlocker API. El resultado es acceso ilimitado a datos de video.
Comienza instalando yt-dlp con pip:
python -m pip install -U "yt-dlp[default]"A continuación, ejecuta:
yt-dlp --proxy 'http://<WEB_UNLOCKER_API_USERNAME>:<WEB_UNLOCKER_API_PASSWORD>@brd.superproxy.io:<WEB_UNLOCKER_API_PORT>' '<YOUTUBE_VIDEO_URL>' --output output.mp4Recuerda reemplazar los marcadores de posición con tus credenciales de Web Unlocker API y la URL de tu video objetivo de YouTube.
El comando anterior descarga el video de YouTube especificado mientras enruta la solicitud a través de tu Web Unlocker API de Bright Data para evitar bloqueos. El video descargado se guarda luego como output.mp4 en el directorio de tu proyecto:
¡Genial! Ahora has extraído con éxito el video que contiene tu audio objetivo.
Si deseas hacer scraping de videos de otras fuentes, consulta las siguientes guías:
Descargar un Archivo de Audio Directamente
Considera un escenario donde el recurso de audio que te interesa ya está disponible en línea como un archivo independiente.
Por ejemplo, puede que quieras recuperar una grabación específica alojada en el Internet Archive u otro sitio web. Aquí, la página ya proporciona un enlace de descarga directa para el archivo de audio:
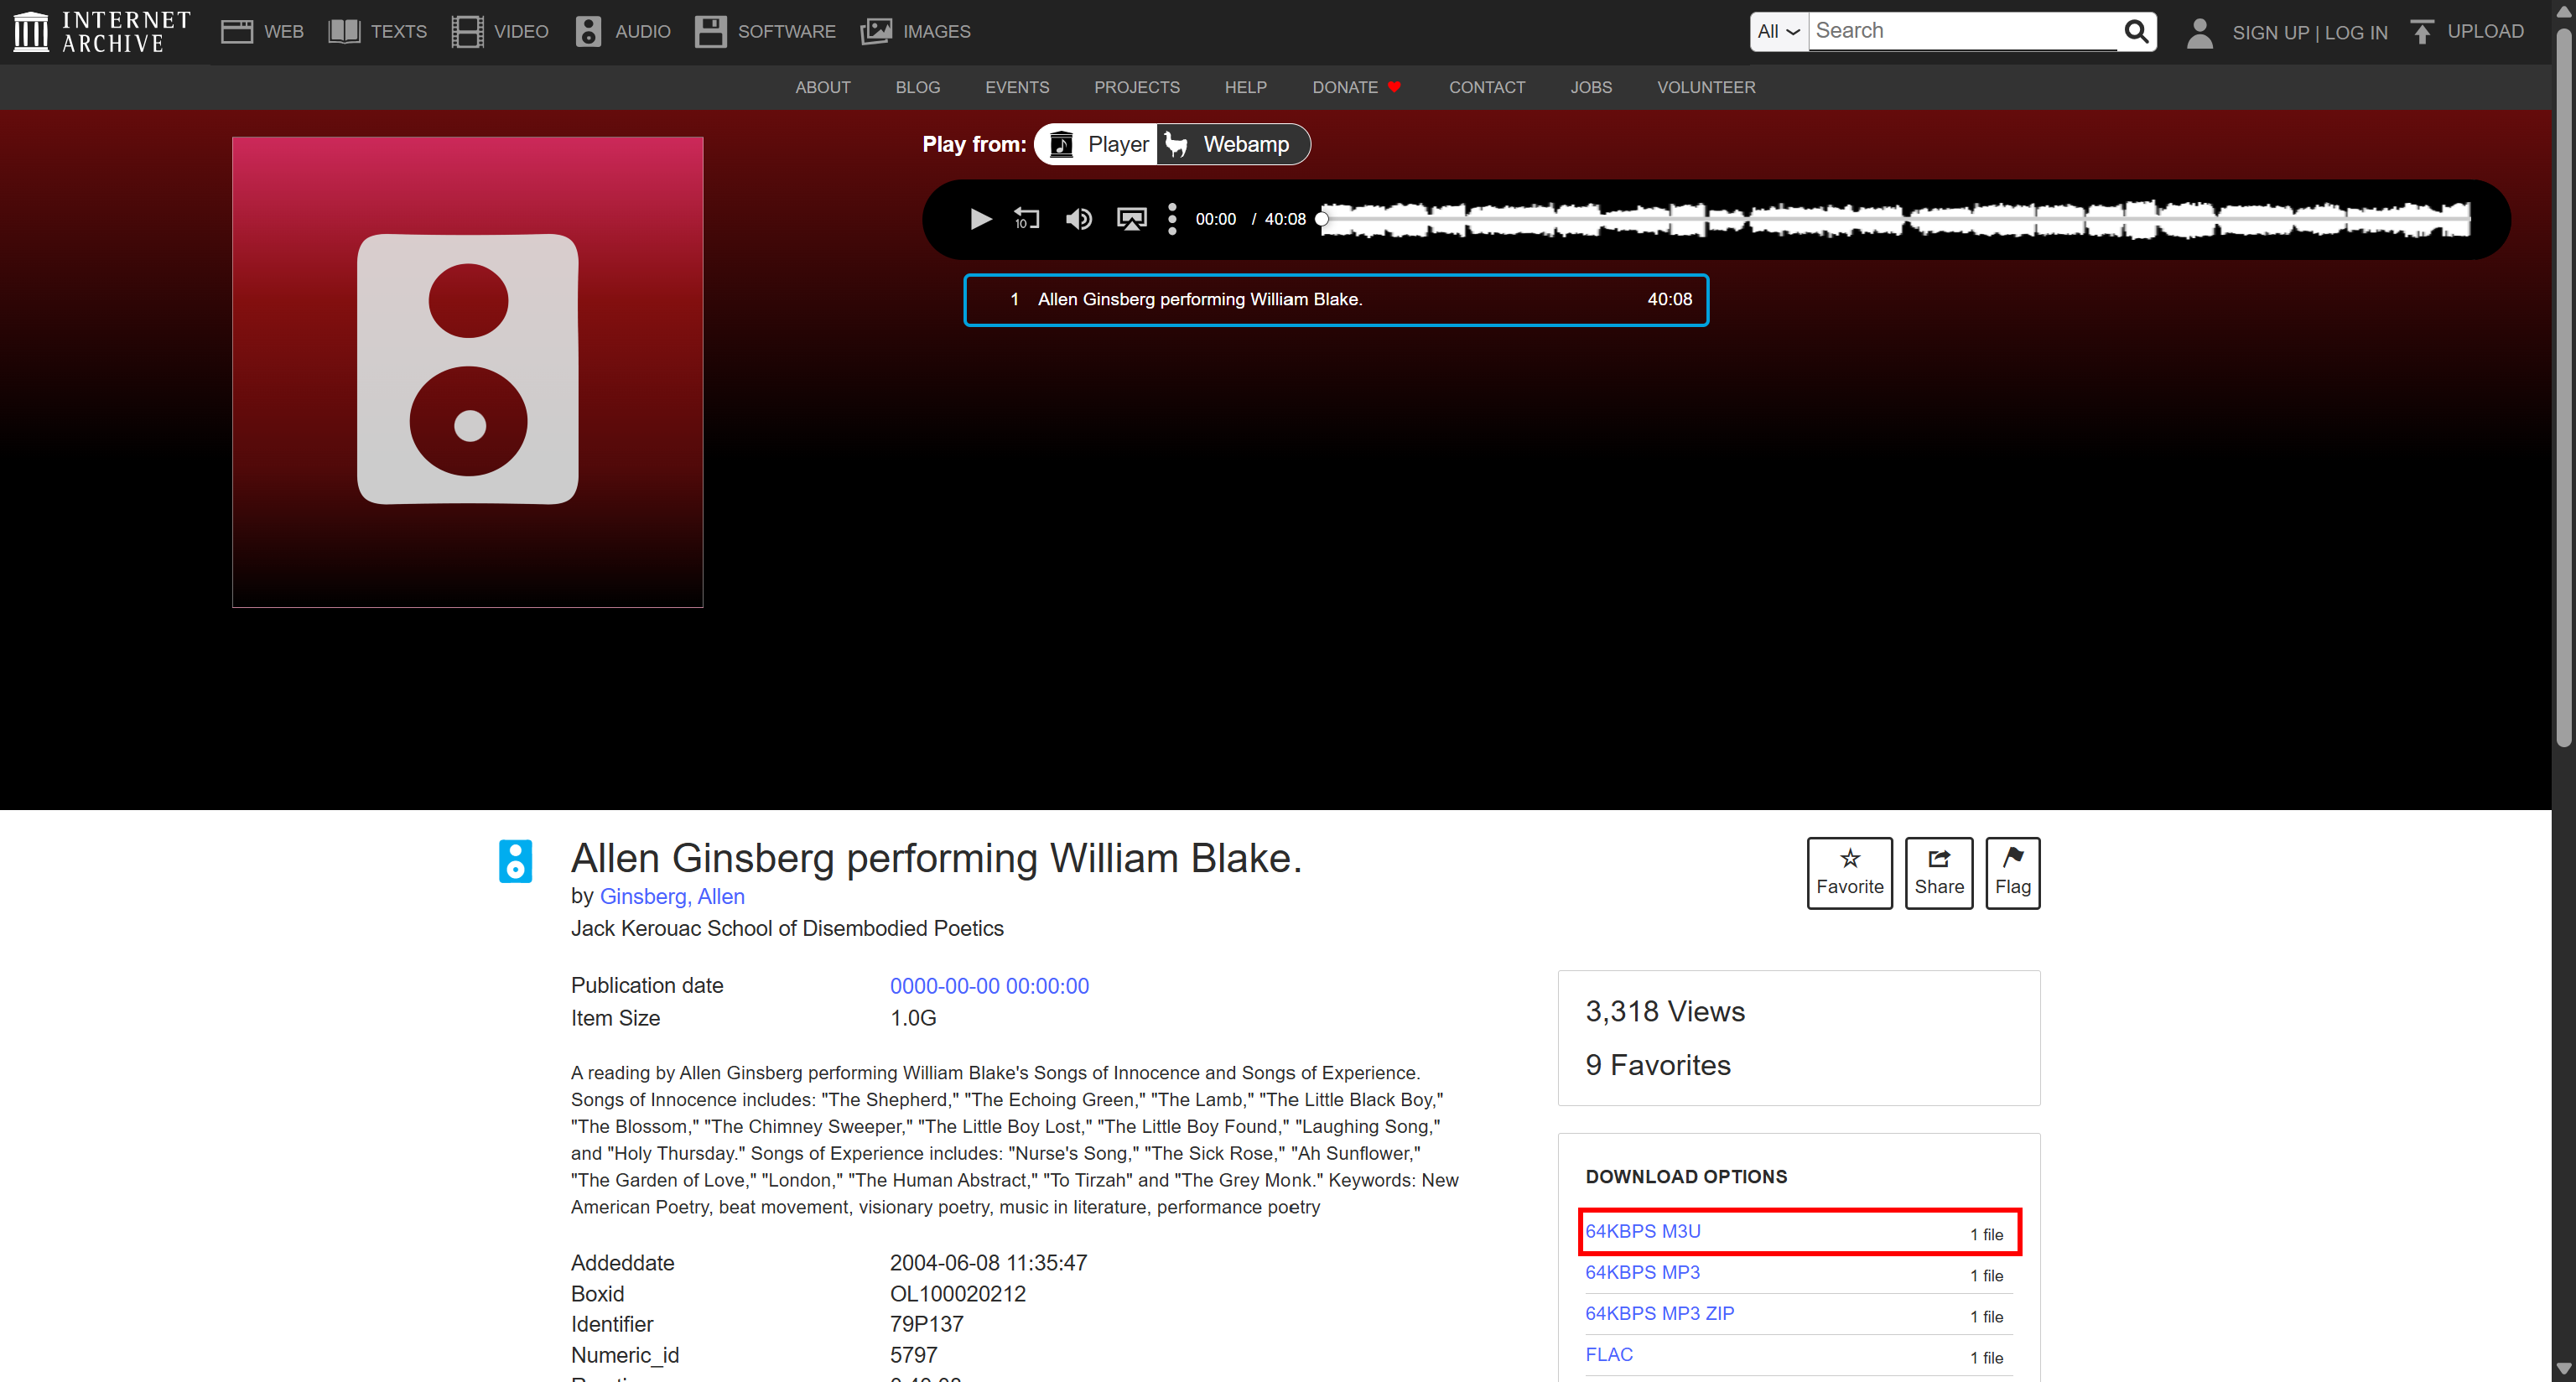
Para automatizar el proceso y ayudar a manejar posibles restricciones de acceso, puedes construir lógica de automatización de navegador para navegar a la página de interés y descubrir la URL del recurso de audio subyacente. Para eso, puedes usar Browser API de Bright Data.
Específicamente, esta vez, la URL directa del archivo MP3 es:
https://archive.org/download/79P137/79P137_64kb.mp3Una vez que tengas la URL objetivo, puedes enviarla al Web Unlocker API de Bright Data a través de una solicitud POST. Web Unlocker recuperará entonces el recurso por ti, mientras evita medidas anti-bot u otras restricciones de acceso.
Comienza instalando la biblioteca HTTP Requests:
pip install requestsLuego, crea un script de Python con el siguiente código:
import requests

# Reemplaza con tu clave API de Bright Data
BRIGHT_DATA_API_KEY = "<YOUR_BRIGHT_DATA_API_KEY>"

target_audio_source = "https://archive.org/download/79P137/79P137_64kb.mp3"

# Accede al recurso de audio a través del Web Unlocker API de Bright Data
response = requests.post(
    "https://api.brightdata.com/request",
    headers={
        "Authorization": f"Bearer {BRIGHT_DATA_API_KEY}",
        "Content-Type": "application/json",
    },
    json={
        "zone": "web_unlocker", # Reemplaza con el nombre real de tu Web Unlocker API
        "url": target_audio_source,
        "format": "raw",
        "country": "us"
    },
)
response.raise_for_status()

# Exporta el contenido de audio a un archivo MP3
with open("output.mp3", "wb") as f:
    f.write(response.content)
Este script envía la URL del archivo de audio al Web Unlocker API, recupera el recurso y guarda el contenido devuelto en tu máquina local como output.mp3.
Nota: En un script de producción, guarda tu clave API de Bright Data y el nombre de tu Web Unlocker API en variables de entorno en lugar de codificarlos directamente en tu código fuente.
Ejecuta el script de Python, y el archivo de audio recuperado aparecerá en el directorio de tu proyecto como output.mp3:
Paso #2: Convertir el Archivo de Audio Extraído a WAV
Cuando se trata de procesamiento de audio, muchos modelos de IA multimodales admiten archivos WAV como entrada. Incluso cuando se admiten varios formatos, es útil estandarizar tus datos de audio extraídos convirtiéndolos a un único formato.
En este capítulo, aprenderás cómo convertir tus archivos de audio y video de origen a WAV. De esta manera, se pueden usar de forma consistente en los pasos posteriores de procesamiento con IA.
Requisitos Previos
Antes de continuar, asegúrate de que FFmpeg esté instalado localmente. FFmpeg es una herramienta de línea de comandos utilizada para convertir y procesar archivos de audio y video.
Descarga FFmpeg desde el sitio web oficial y sigue las instrucciones de instalación para tu sistema operativo.
Del Archivo de Video/Audio de Entrada a WAV
Convierte el archivo de video de YouTube extraído en un archivo de audio WAV usando este comando:
ffmpeg -i output.mp4 -vn -acodec pcm_s16le -ar 16000 -ac 1 video_output.wavEsto es lo que hace cada argumento:
-i output.mp4: Especificaoutput.mp4como el archivo de entrada.-vn: Deshabilita el procesamiento de video, de modo que solo se extrae el flujo de audio.-acodec pcm_s16le: Convierte el audio a audio PCM sin comprimir usando codificación de 16 bits con signo little-endian, un formato común para archivos WAV.-ar 16000: Establece la frecuencia de muestreo del audio en 16,000 Hz (16 kHz).-ac 1: Convierte el audio a un solo canal (mono).video_output.wav: Especifica el nombre del archivo WAV de salida.
El mismo enfoque se puede usar para convertir un archivo de audio independiente de otro formato compatible a WAV:
ffmpeg -i output.mp3 -vn -acodec pcm_s16le -ar 16000 -ac 1 audio_output.wavObserva que el comando es esencialmente el mismo. Las principales diferencias son el archivo de entrada y el de salida.
¡Increíble! Ahora estás listo para transcribir el audio extraído con un modelo de IA.
Paso #3: Usar IA para Transcribir el Archivo WAV
El paso final es alimentar el audio en formato WAV a un modelo de transcripción de IA, ya sea a través de un LLM basado en la nube o un modelo que se ejecuta localmente.
Para esta tarea, puedes usar un modelo de IA diseñado para transcripción de voz a texto, u otro modelo de IA multimodal que acepte audio como entrada. La elección depende de tus requisitos, como precisión de transcripción, marcas de tiempo, identificación de hablantes, velocidad de procesamiento y costo.
Obtener la Transcripción con un Modelo de IA Multimodal Basado en la Nube
OpenAI proporciona varios modelos y APIs para transcripción de voz a texto. Utiliza el SDK de OpenAI para enviar tu archivo de audio WAV a un modelo de transcripción y recuperar la transcripción resultante con marcas de tiempo.
Comienza instalando el SDK de Python de OpenAI:
pip install openaiA continuación, logra el objetivo con:
from openai import OpenAI

# Reemplaza con tu clave API real de OpenAI
OPENAI_KEY = "<YOUR_OPENAI_API_KEY>"

client = OpenAI(api_key=OPENAI_KEY)

# Abre el archivo de audio y envíalo a OpenAI Whisper para transcripción
with open("video_output.wav", "rb") as f:
    transcription = client.audio.transcriptions.create(
        model="whisper-1",
        file=f,
        response_format="verbose_json",
        timestamp_granularities=["segment"],
    )

# Escribe la transcripción completa con marcas de tiempo en un archivo de texto
with open("video_transcript.txt", "w", encoding="utf-8") as f:
    for segment in transcription.segments:
        # Obtén el tiempo de inicio y fin del segmento
        start = segment.start
        end = segment.end

        # Obtén el texto transcrito
        text = segment.text.strip()

        # Formatea la marca de tiempo como HH:MM:SS
        start_time = f"{int(start // 3600):02d}:{int((start % 3600) // 60):02d}:{int(start % 60):02d}"
        end_time = f"{int(end // 3600):02d}:{int((end % 3600) // 60):02d}:{int(end % 60):02d}"

        # Crea una línea de transcripción con marca de tiempo
        line = f"[{start_time} - {end_time}] {text}"

        # Imprime la línea y guárdala en el archivo de transcripción
        print(line)
        f.write(line + "\n")
Este script primero inicializa el cliente de OpenAI usando tu clave API y abre el archivo WAV en modo binario. Luego envía el audio al modelo whisper-1 y solicita una respuesta JSON detallada que contenga marcas de tiempo a nivel de segmento.
Luego itera sobre los segmentos devueltos, extrae el tiempo de inicio, el tiempo de fin y el texto transcrito para cada segmento, y los formatea en líneas legibles con marcas de tiempo. Cada línea se imprime en la terminal y se escribe en video_transcript.txt.
Ejecuta el script de Python, y verás la salida de la transcripción en tu terminal:
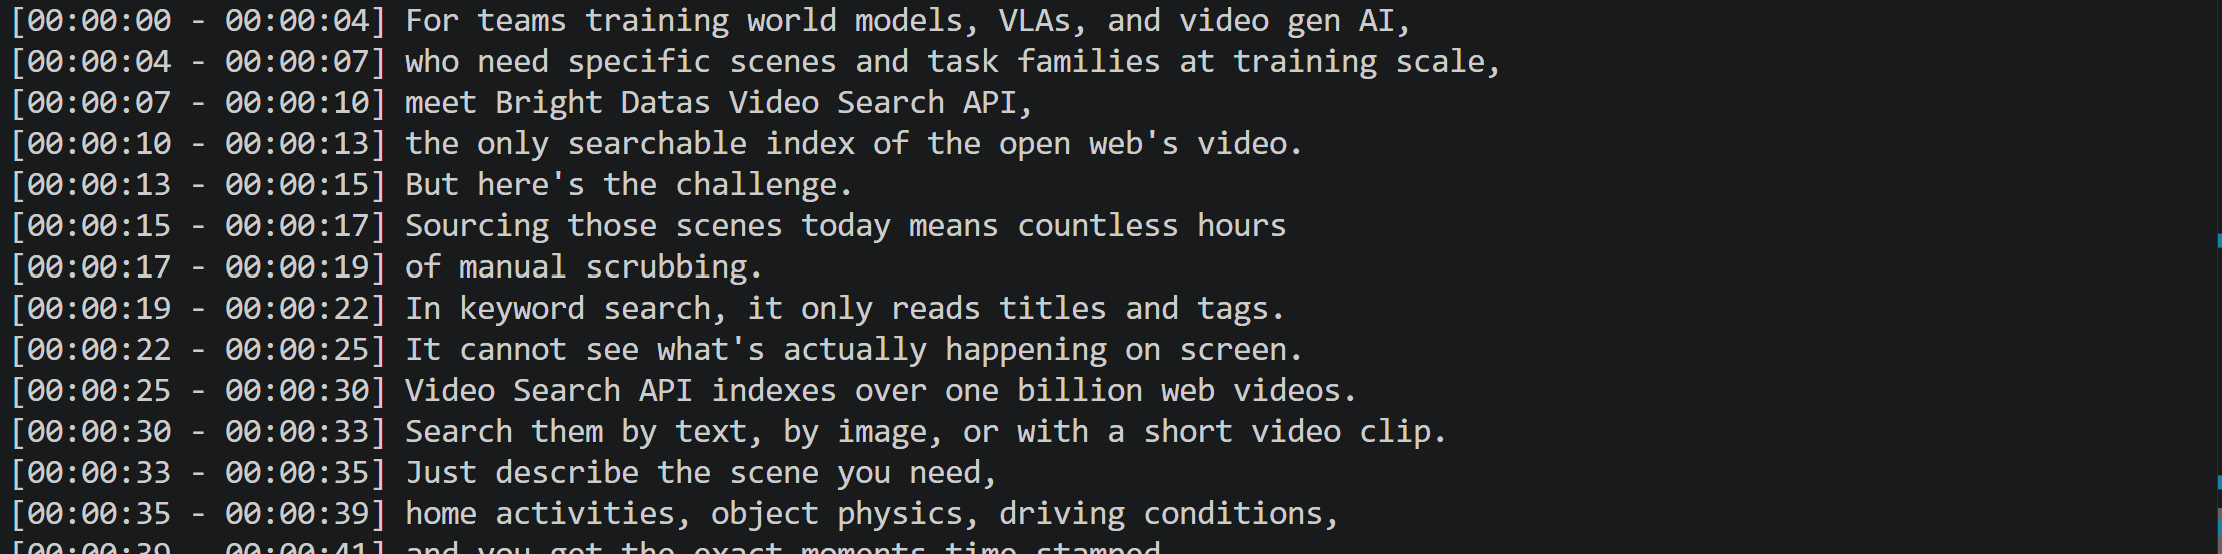
Una vez completado el procesamiento, el archivo video_transcript.txt contendrá la transcripción con marcas de tiempo:
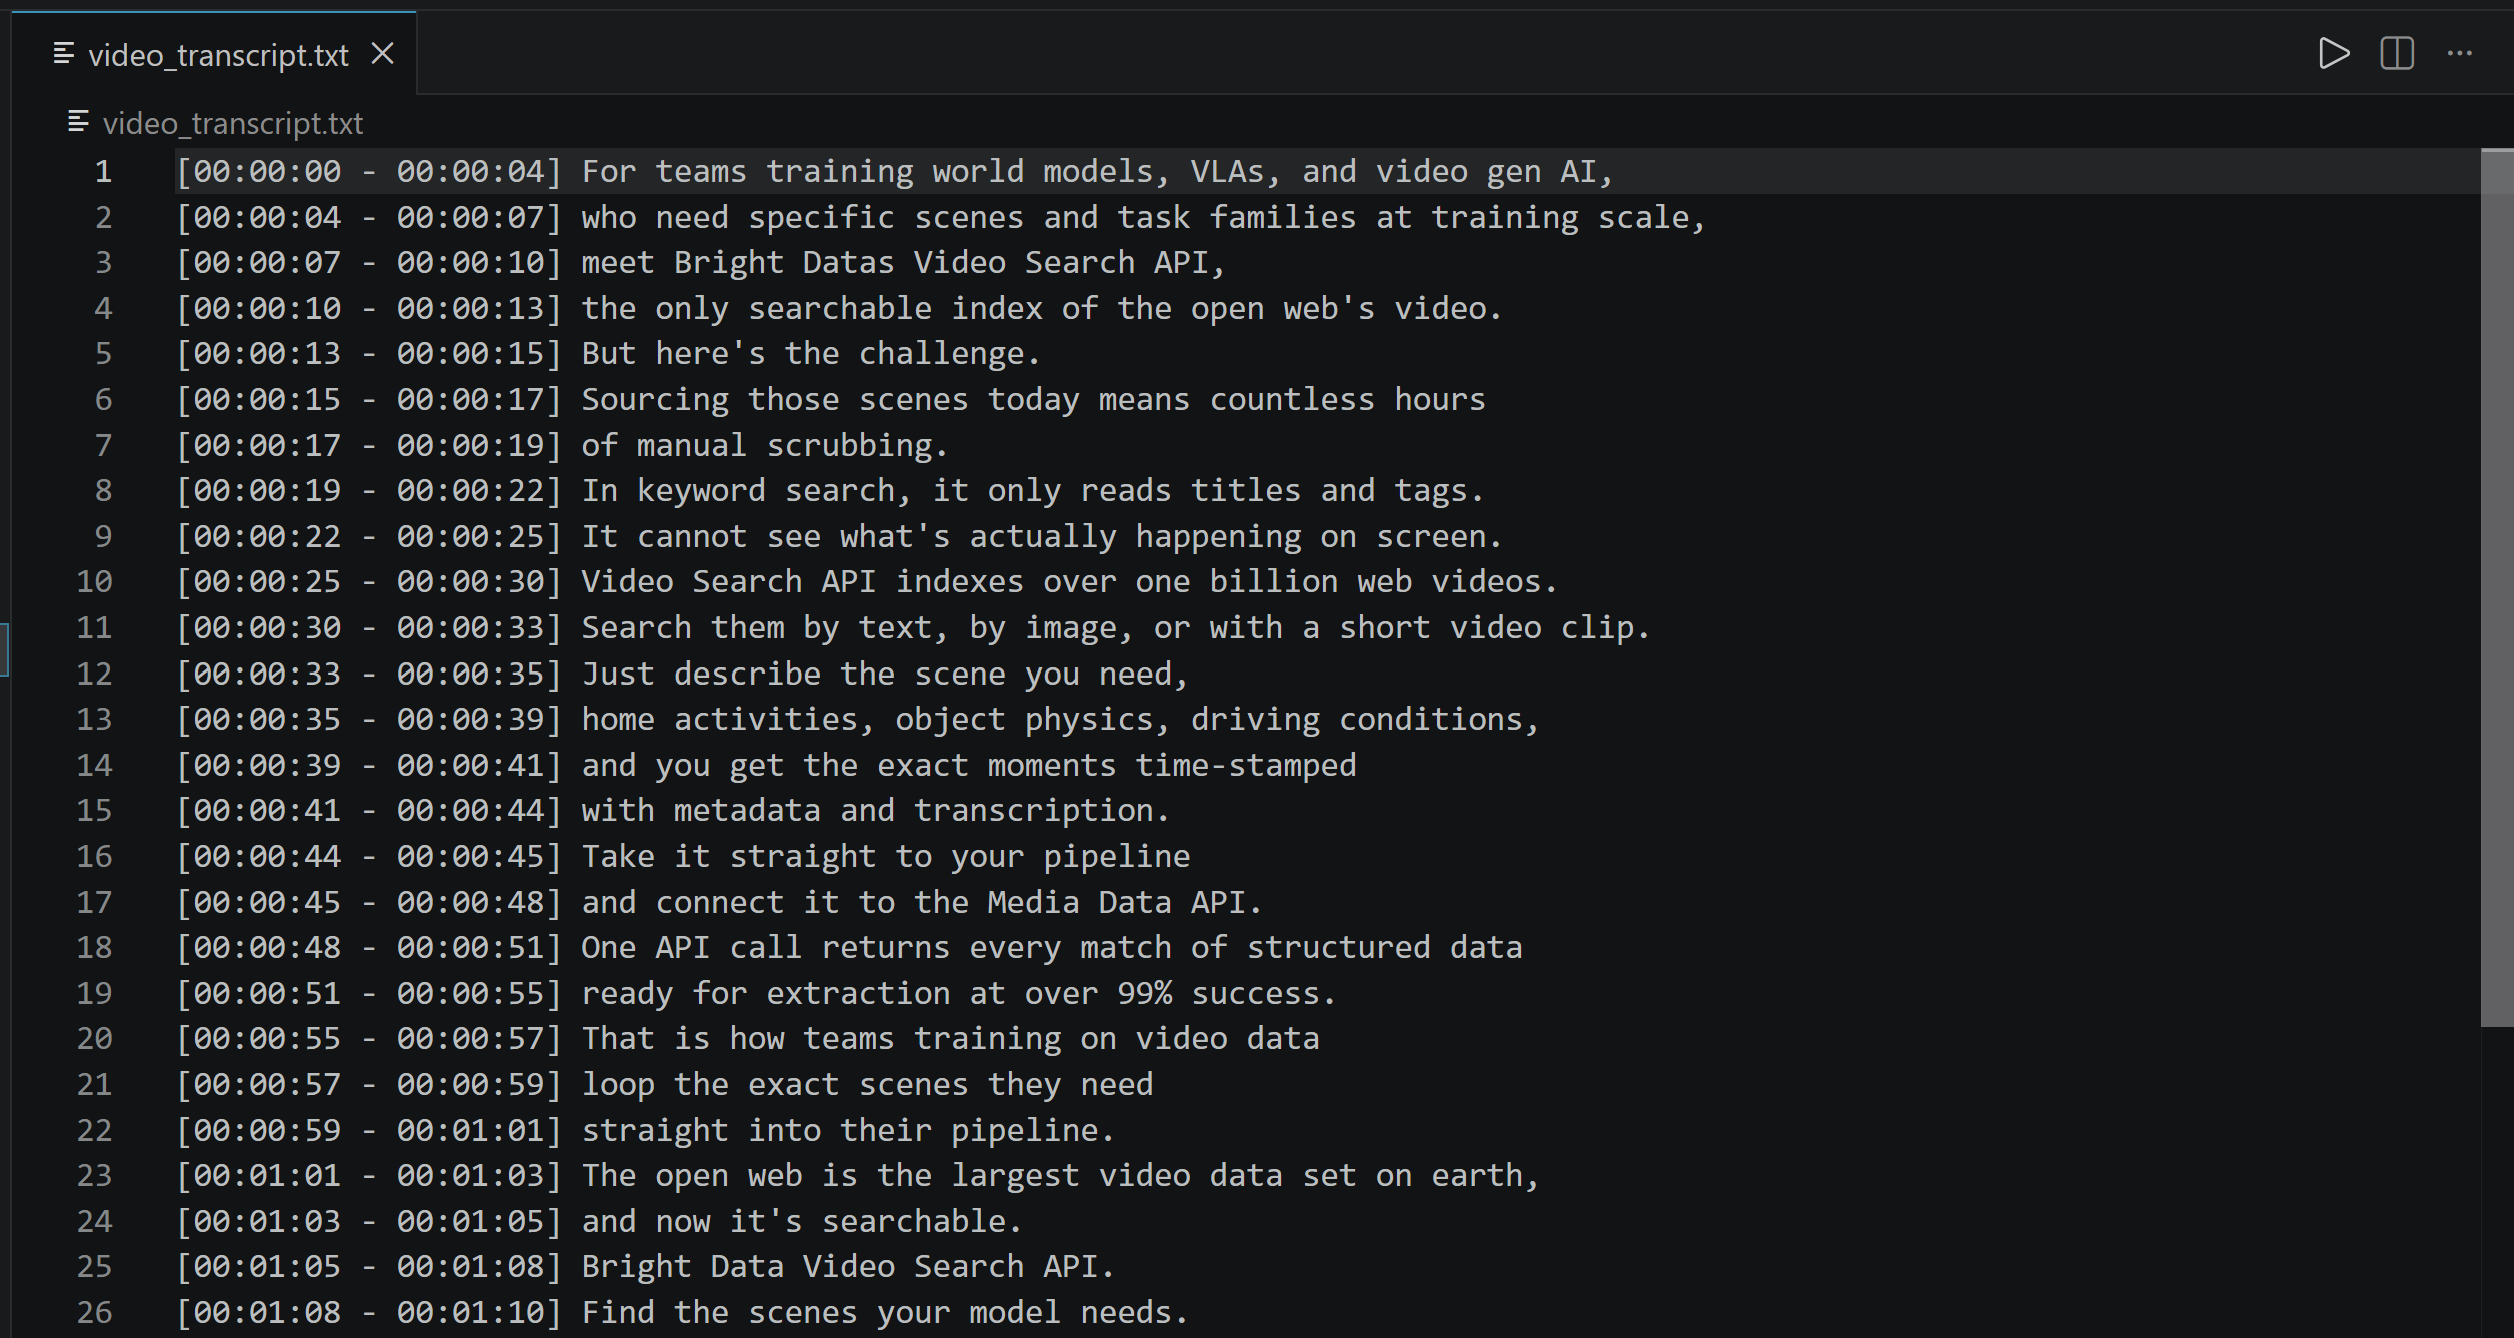
¡Misión cumplida! Empezaste con un video de YouTube, lo extrajiste, convertiste su audio a formato WAV y, finalmente, lo transcribiste a texto. Ahora tienes una transcripción limpia para análisis posteriores.
Las principales limitaciones de este enfoque son:
- Tamaño del archivo de entrada: Los archivos de audio enviados a través de la API de transcripción están limitados a 25 MB. Para grabaciones más grandes, necesitas comprimir el audio para reducir su tamaño de archivo o dividirlo en fragmentos más pequeños antes de la transcripción.
- Costo: Las grabaciones de audio largas pueden resultar en un uso significativo de la API. Cuanto más largo sea el audio, más tokens de entrada se requieren y más tokens de salida se producen.
Alternativamente, puedes ejecutar un modelo de voz a texto localmente, como se muestra en la siguiente sección.
Obtener la Transcripción con un Modelo de IA Local
Existen varios modelos y bibliotecas locales de voz a texto que puedes usar para generar transcripciones. faster-whisper es una opción popular. Esta es una reimplementación del modelo Whisper de OpenAI que utiliza CTranslate2, un motor de inferencia de alto rendimiento para modelos Transformer.
Instala faster-whisper con:
pip install faster-whisperLuego, úsalo para generar una transcripción a partir de tu archivo de audio local:
from faster_whisper import WhisperModel

# Carga el modelo Whisper local
model = WhisperModel(
    "small",
    device="cpu", # Ejecuta la tarea en la CPU
    compute_type="int8"
)

# Transcribe el archivo de audio de entrada y devuelve segmentos de transcripción con marcas de tiempo
segments, info = model.transcribe(
    "audio_output.wav",
    beam_size=5
)

# Imprime el idioma detectado por Whisper
print(f"Idioma detectado: {info.language}")

# Convierte segundos en una marca de tiempo legible HH:MM:SS
def format_timestamp(seconds):
    hours = int(seconds // 3600)
    minutes = int((seconds % 3600) // 60)
    seconds = int(seconds % 60)

    return f"{hours:02d}:{minutes:02d}:{seconds:02d}"

# Escribe cada segmento de transcripción con marca de tiempo en un archivo de salida
with open("audio_transcript.txt", "w", encoding="utf-8") as f:
    for segment in segments:
        # Obtén las marcas de tiempo de inicio y fin para este segmento
        start = format_timestamp(segment.start)
        end = format_timestamp(segment.end)

        # Elimina espacios en blanco innecesarios del texto transcrito
        text = segment.text.strip()

        # Combina las marcas de tiempo y la transcripción en una sola línea
        line = f"[{start} - {end}] {text}"

        # Imprime el segmento en la consola y guárdalo en el archivo
        print(line)
        f.write(line + "\n")
Este script carga el modelo Whisper small localmente y lo ejecuta en la CPU usando cuantización int8. Transcribe audio_output.wav en segmentos con marcas de tiempo, detecta el idioma del audio y formatea cada segmento con sus tiempos de inicio y fin. La transcripción resultante se imprime en la consola y se guarda en video_transcript.txt.
Ejecuta el script, y verás una salida similar a la siguiente:
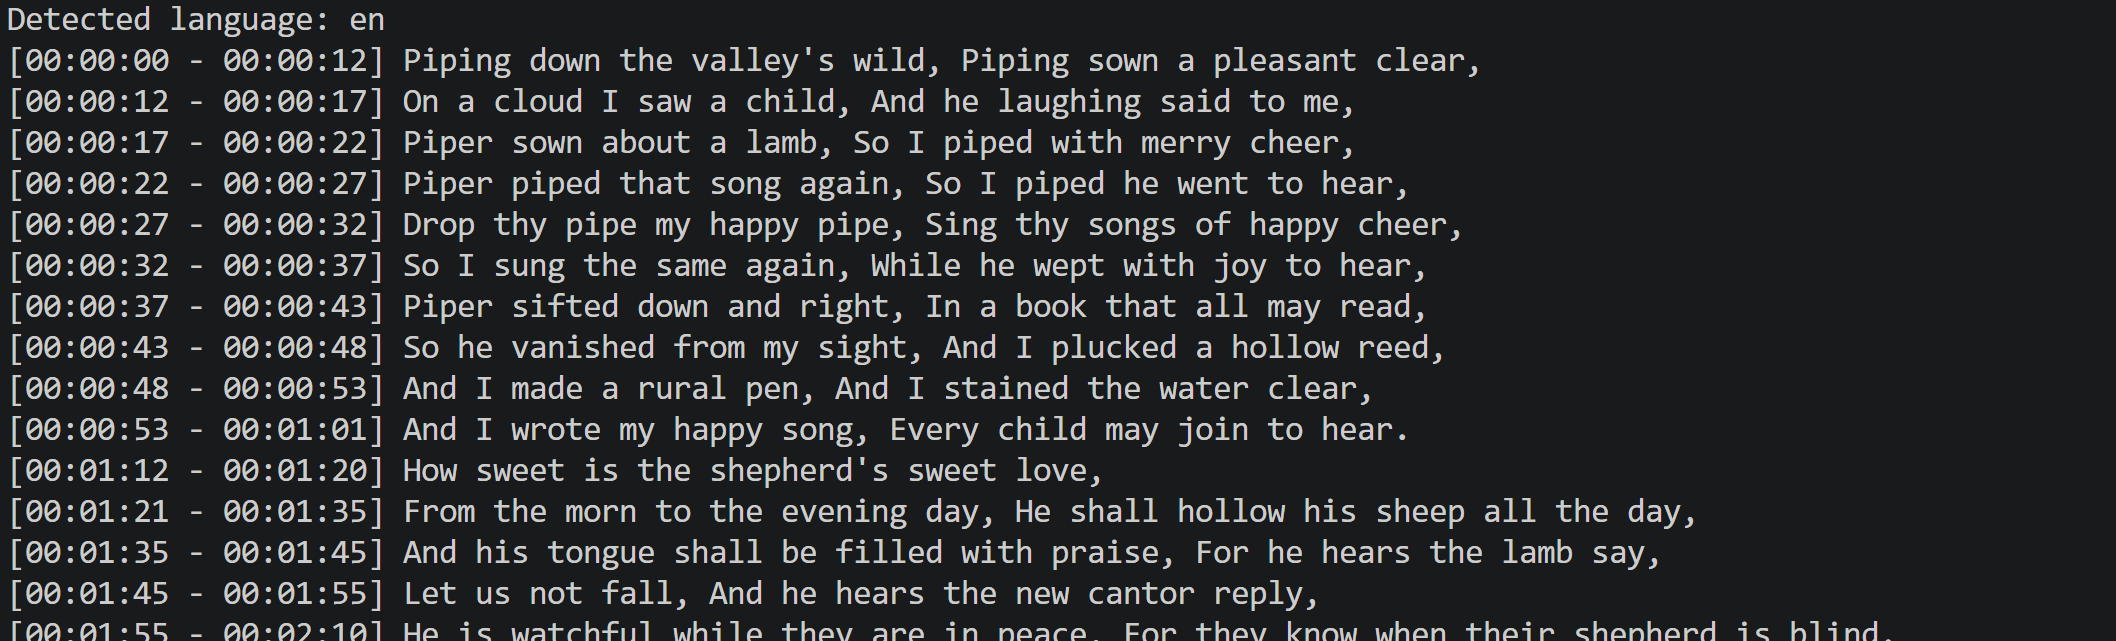
Ahora el modelo faster-whisper detectó con éxito el idioma del audio como inglés y generó una transcripción precisa.
El archivo video_transcript.txt resultante contendrá la transcripción con marcas de tiempo:
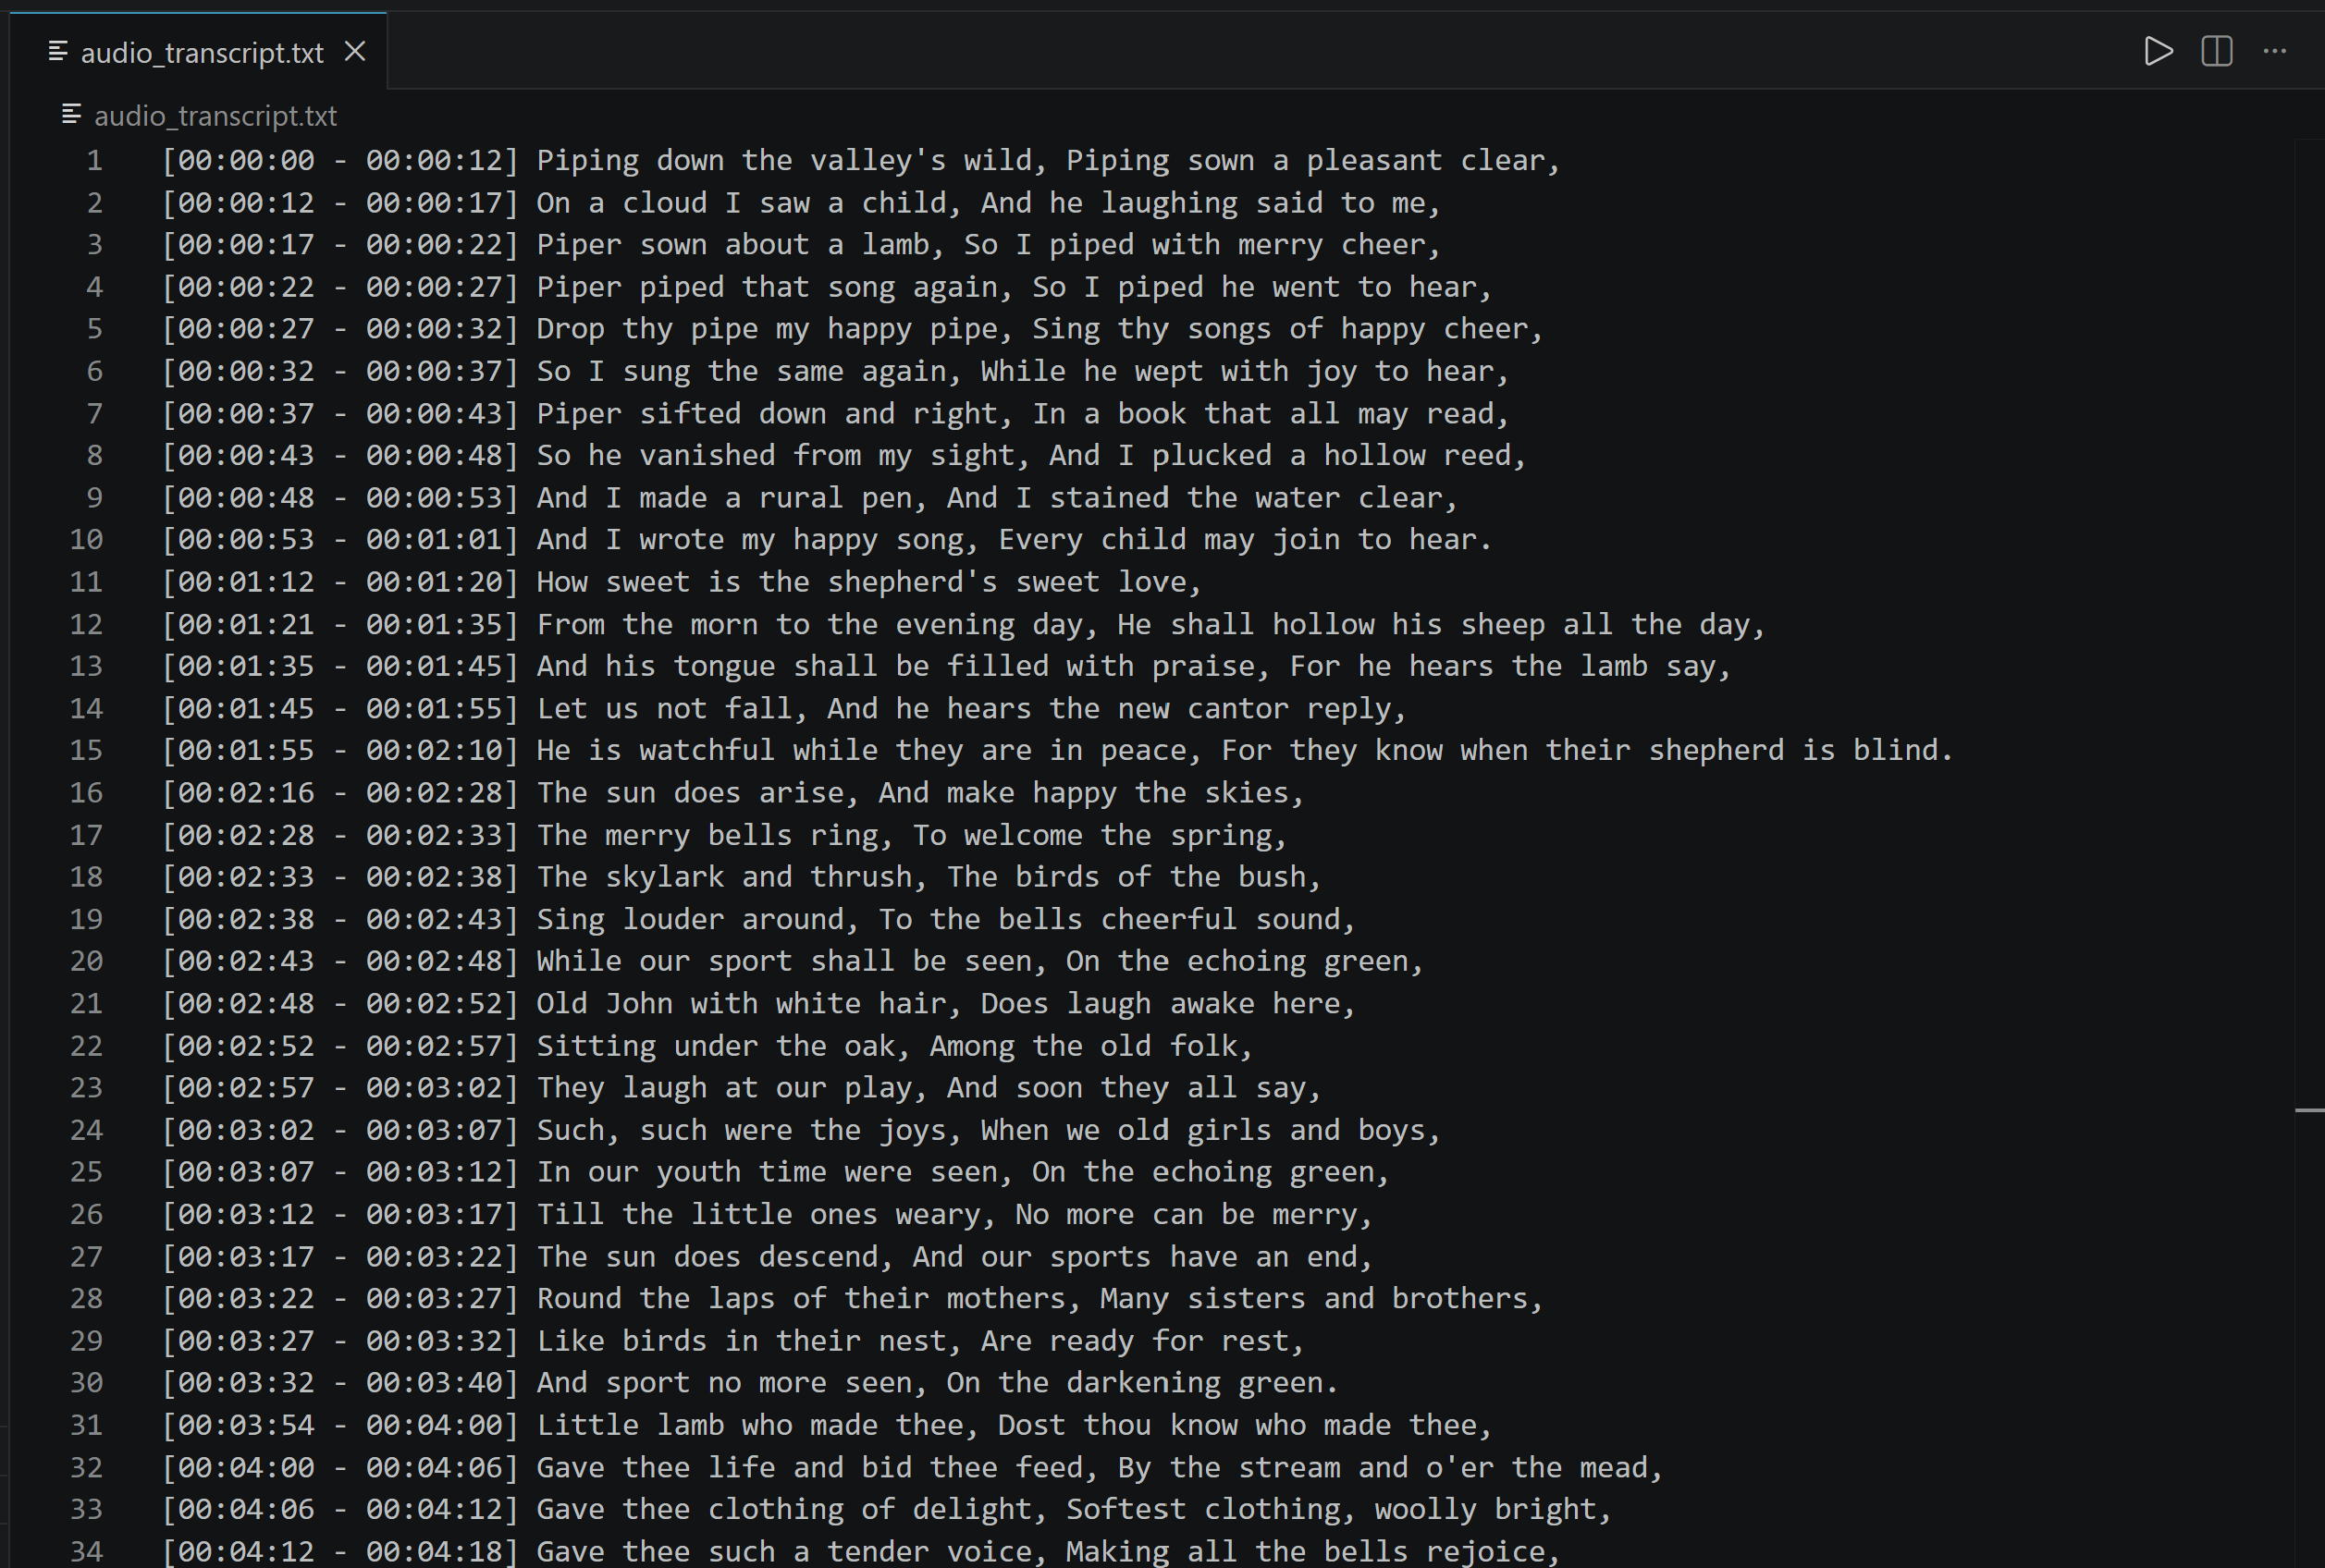
¡Et voilà! Has completado el pipeline completo de scraping de audio web al:
- Recuperar una grabación de audio desde la web.
- Convertirla a un archivo WAV estandarizado.
- Emplear un modelo de IA local para convertir el audio en una transcripción de texto con marcas de tiempo.
Scraping de Audio Web: Casos de Uso y Escenarios
Una vez que hayas extraído audio de la web y lo hayas convertido en texto, puedes usar el resultado para una amplia gama de aplicaciones de IA y procesamiento de datos.
La combinación de audio, transcripciones y marcas de tiempo permite tanto análisis a nivel de contenido como aplicaciones de audio-texto. Algunos casos de uso posibles incluyen:
- Monitoreo de medios: Rastrea podcasts, entrevistas y transmisiones para identificar menciones, temas, marcas o eventos.
- Análisis de contenido: Analiza grandes colecciones de contenido hablado para descubrir temas recurrentes, tendencias, opiniones y temas clave.
- Entrenamiento de modelos de IA: Construye conjuntos de datos de audio-texto para entrenar o ajustar modelos de reconocimiento de voz y otros modelos de IA.
- Archivos buscables: Transforma grandes colecciones de audio en línea en texto buscable, permitiendo a los usuarios localizar rápidamente información específica.
- Extracción de información: Extrae automáticamente nombres, organizaciones, ubicaciones, hechos u otra información estructurada del contenido hablado.
- Resumen de contenido: Genera resúmenes concisos de podcasts, entrevistas, conferencias, reuniones y otras grabaciones extensas.
- Alineación de audio-texto: Usa marcas de tiempo para conectar segmentos de transcripción con sus posiciones exactas en el audio original, permitiendo una recuperación y análisis de contenido precisos.
Conclusión
En este artículo, aprendiste cómo hacer scraping de audio desde la web y convertirlo en texto con marcas de tiempo para procesamiento con IA. En detalle, viste cómo recopilar audio de videos o archivos independientes, convertirlo a WAV y transcribirlo con modelos de IA en la nube o locales.
El resultado es un pipeline completo de procesamiento de audio que puede respaldar aplicaciones como análisis de contenido, extracción de información, archivos buscables y entrenamiento de modelos de IA.
Si deseas omitir el paso de scraping, explora los conjuntos de datos de audio listos para IA y los paquetes de datos de video de Bright Data. Para recopilación de audio personalizada, usa Web Unlocker de Bright Data para acceder a los recursos web que necesitas de manera confiable y a gran escala, sin ser bloqueado.
¡Crea una cuenta de Bright Data y comienza a construir tu pipeline de datos de audio hoy mismo!