Google cerró su Custom Search JSON API a nuevos clientes, y el acceso de los clientes existentes terminará el 1 de enero de 2027. Entonces, ¿hay una API de búsqueda de Google a la que aún puedas suscribirte? No para resultados de toda la web, porque las opciones públicas de Google buscan en sitios elegidos o devuelven respuestas de Gemini basadas en Google Search. La API SERP de Bright Data devuelve resultados de Google de toda la web como JSON.
Custom Search JSON API devuelve un 403 a los proyectos nuevos. Las solicitudes HTTP directas a google.com fallaron silenciosamente en las pruebas, con estado 200 y 0 resultados.
Esta guía compara las opciones de Google, explica por qué fallan las solicitudes directas y muestra cómo migrar.
Resumen
- Google no vende ninguna API de búsqueda de autoservicio de toda la web a nuevos desarrolladores. La fecha de finalización de Custom Search JSON API es el 1 de enero de 2027.
- Grounding con Google Search devuelve respuestas de Gemini, no listas de resultados. Sus términos prohíben almacenar en caché o analizar los resultados, o indexar sus enlaces.
- Las solicitudes HTTP directas a Google Search no obtuvieron resultados en las pruebas. Luego, los navegadores en la misma conexión recibieron un CAPTCHA.
- La API SERP de Bright Data devuelve la página de resultados de Google como JSON. 5K solicitudes al mes son gratuitas, luego $1.50 por cada 1,000 solicitudes exitosas. Un adaptador listo para usar convierte las llamadas a
cse.list().
Qué reemplazo de Custom Search API se adapta a tu código
Averigua qué necesita tu código:
| Si tu código necesita | Usa |
|---|---|
| Resultados de búsqueda de Google de toda la web | API SERP de Bright Data |
| Búsqueda limitada a una lista fija de sitios | API SERP de Bright Data con filtros site:, o Agent Search, de Google |
Mantener los parámetros existentes de cse.list() |
El adaptador del paso 3 |
| Resultados de Google Images | El adaptador del paso 3 con searchType="image" |
| Una herramienta de búsqueda MCP (Model Context Protocol), LangChain o n8n | Bright Data Web MCP, una herramienta de LangChain, o el nodo de n8n |
| Una respuesta de Gemini mostrada al usuario que preguntó | Grounding con Google Search |
| Una solución para un mensaje de error | La tabla de solución de problemas |
Qué pasó con la Google Custom Search JSON API
Google anunció el cierre el 20 de enero de 2026. Su resumen de Custom Search JSON API marca la API como “cerrada a nuevos clientes” y da a los clientes existentes hasta el 1 de enero de 2027.
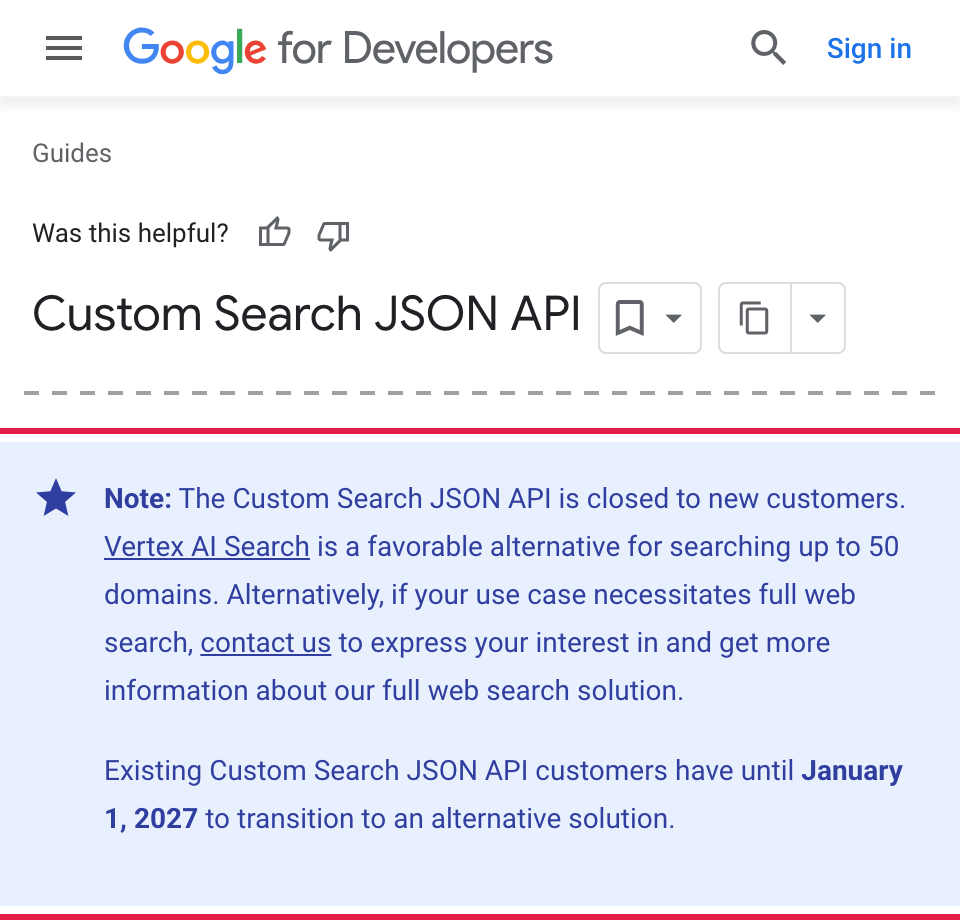
Los proyectos nuevos ya reciben un 403 de Custom Search JSON API, incluso antes de la fecha límite de 2027. Esta es la respuesta, acortada a sus campos principales.
{
  "error": {
    "code": 403,
    "message": "This project does not have the access to Custom Search JSON API.",
    "status": "PERMISSION_DENIED"
  }
}
En el foro de desarrolladores de Google, un desarrollador reporta este 403 en un proyecto existente después de un cambio de facturación.
La tabla pone los límites documentados de Google junto a la API SERP de Bright Data:
| Custom Search JSON API | API SERP de Bright Data | |
|---|---|---|
| Uso gratuito | 100 consultas al día, unas 3K al mes | 5K solicitudes al mes, sin tarjeta de crédito |
| Uso de pago | $5 por cada 1,000 consultas, hasta 10K al día | $1.50 por cada 1,000 solicitudes exitosas, concurrencia ilimitada |
| Resultados por solicitud | Hasta 10 | Una página completa de resultados de Google |
| Resultados por consulta | Hasta 100 | Pagina con start, u obtén las posiciones 1 a 100 en una sola llamada |
| Ubicación | gl favorece resultados de un país |
Resultados tal como los ve un usuario en el país que configures |
| Qué devuelve la API | Resultados de un Programmable Search Engine, que busca en un subconjunto del índice de Google | La página de resultados de Google, incluyendo anuncios y People Also Ask cuando Google los muestra. Un parámetro extra añade el AI Overview |
La migración es más fácil de lo que parece, porque los resultados de Custom Search ya diferían de los resultados de google.com. La página de ayuda de Google dice que un motor de toda la web busca solo en “un subconjunto del total del corpus de Google Web Search” y excluye resultados en tiempo real. Así que no necesitas reproducir los resultados antiguos exactamente. Comprueba los nuevos resultados contra google.com, y usa resultados guardados de Custom Search para encontrar errores en tu migración.
Las propias alternativas de Google a Custom Search API
Google dirige a los usuarios de Custom Search hacia Agent Search y un formulario de interés para toda la web. Grounding con Google Search, una función de la API de Gemini, también aparece cuando buscas un reemplazo:
| Producto y alcance | Qué devuelve | Precio de lista |
|---|---|---|
| Agent Search (también llamado Vertex AI Search), para hasta 50 dominios | Resultados y respuestas de esos sitios | $4 por cada 1,000 consultas de búsqueda en sitios web |
| Grounding con Google Search (API de Gemini), para Google Search | Una respuesta de Gemini con enlaces | $14 por cada 1,000 solicitudes de búsqueda |
| Solución de búsqueda de toda la web, para el índice completo de Google | No documentado públicamente | Solo formulario de interés |
Si tu motor buscaba en una lista fija de sitios, tienes 2 opciones. La API SERP de Bright Data acepta la misma lista como filtros site:, y Agent Search admite hasta 50 dominios.
Grounding es el producto más cercano a la búsqueda web, pero sus términos limitan lo que puedes construir. Los términos de la API de Gemini exigen que muestres los resultados fundamentados al usuario que preguntó. Prohíben “almacenar en caché, enmarcar, sindicar, revender, analizar, entrenar con, o aprender de otro modo” de esos resultados o indexar sus enlaces.
Microsoft también retiró sus APIs de Bing Search en agosto de 2025. Nuestras guías sobre alternativas a la API de Bing Search y las mejores APIs SERP comparan a los demás proveedores.
Ninguno de los productos de autoservicio de Google ofrece a los nuevos clientes resultados de búsqueda de toda la web. La API SERP de Bright Data sí.
Por qué fallan las solicitudes directas a Google Search
Con el cierre de Custom Search, la alternativa obvia es solicitar directamente la página de resultados de Google. Google Search requiere JavaScript desde enero de 2025. En pruebas desde 1 conexión de banda ancha doméstica, 10 solicitudes de clientes HTTP y luego varios navegadores reales no obtuvieron resultados de búsqueda:
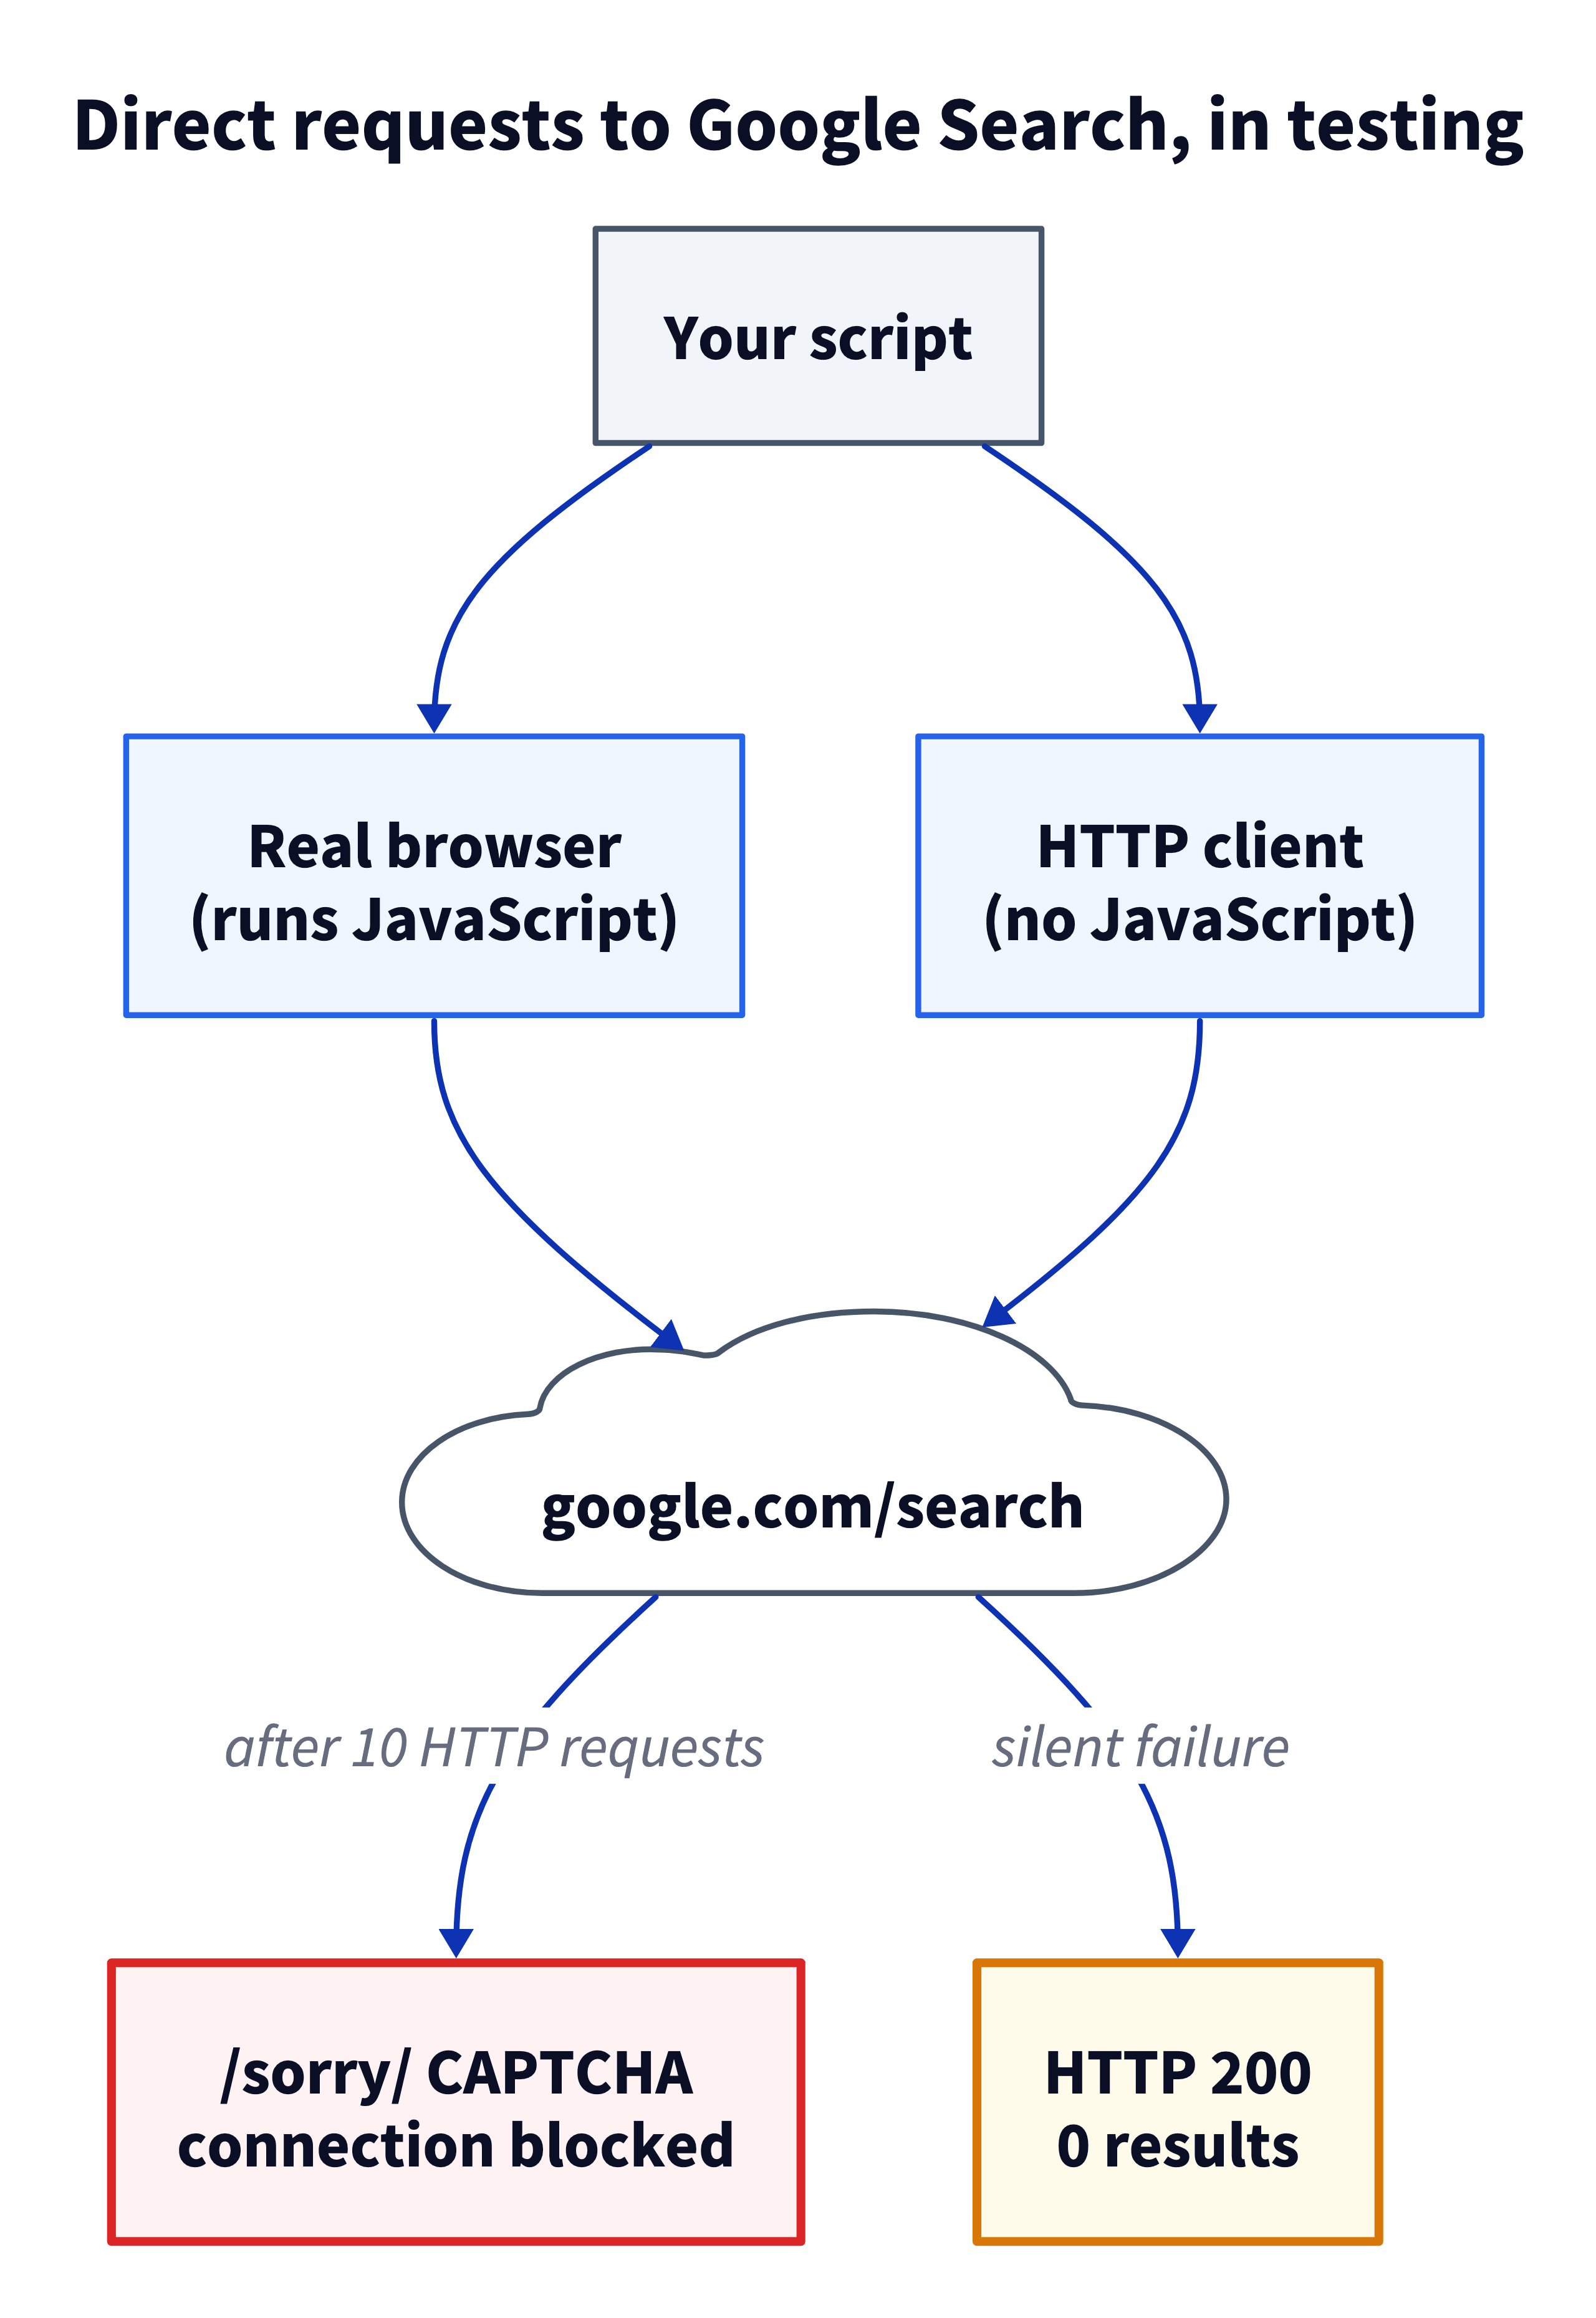
Los clientes HTTP fallan de la manera más difícil de detectar. Las 10 solicitudes provinieron de 5 configuraciones comunes de clientes HTTP, incluyendo curl y Python httpx. Las 10 obtuvieron el estado 200 y ningún resultado, por lo que un scraper que solo comprueba los códigos de estado registra un éxito y no almacena nada. La página contenía solo un script que tiene que ejecutarse en un motor de JavaScript antes de que aparezca algún resultado.
Comprueba cada respuesta en busca de resultados, no solo el código de estado.
Todos los navegadores probados, incluyendo Chromium y Chrome sin interfaz gráfica, ejecutaron el JavaScript pero recibieron la página CAPTCHA /sorry/ de Google en su primera consulta. Se ejecutaron después de esas 10 solicitudes HTTP, y el bloqueo se aplicó a toda la conexión durante 40 minutos o más.
Con un volumen de producción, tendrías que ejecutar el JavaScript de Google en cada búsqueda y mantener analizadores para un markup cambiante. La API SERP de Bright Data gestiona los navegadores y analizadores por ti y devuelve resultados ya procesados.
Cómo migrar el código de Custom Search JSON API a la API SERP de Bright Data
Envías una URL de búsqueda normal de Google, y la respuesta es esa página como JSON. Los pasos 1 a 3 son la migración principal.
Paso 1: Configura y envía una primera solicitud
Necesitas una cuenta gratuita de Bright Data, una clave API y una zona de API SERP. Una zona es un conjunto nombrado de configuraciones que usan tus solicitudes. Si tu equipo de seguridad revisa primero a los nuevos proveedores, envíale el enlace del Trust Center de Bright Data. Esa página enumera informes SOC 2 y SOC 3, certificados ISO 27701 y documentación de cumplimiento GDPR.
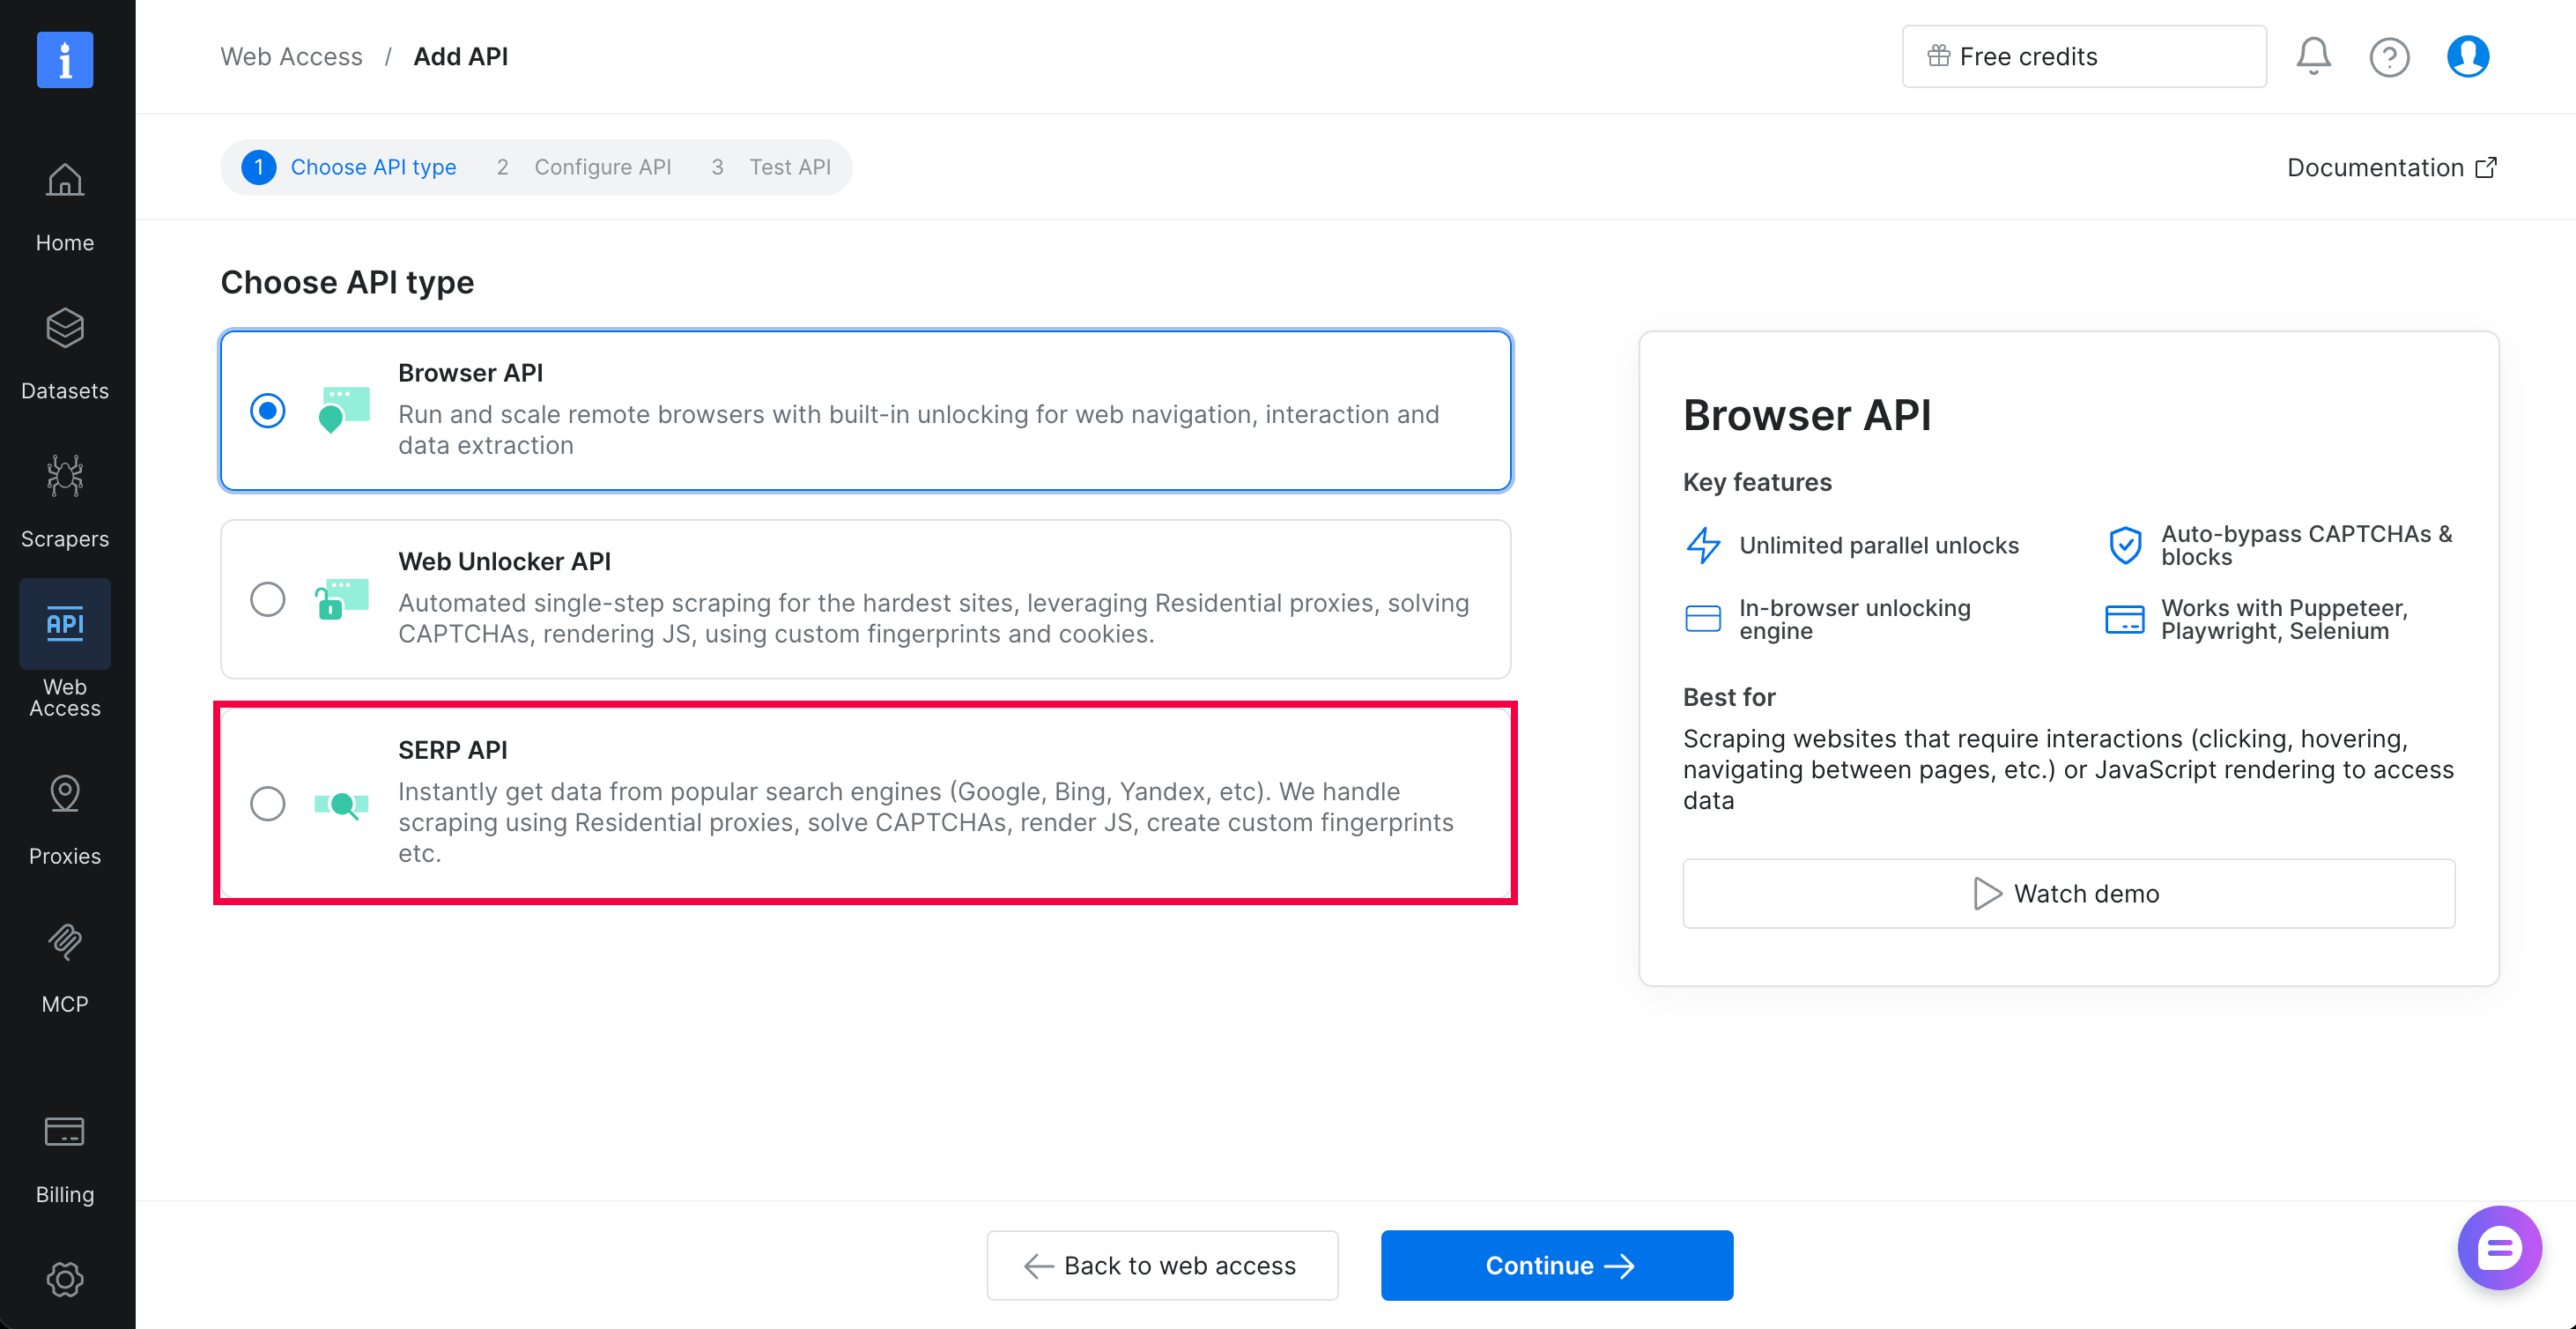
En el panel de control, una zona se llama API. Abre Web Access, selecciona Create API, elige SERP API, y selecciona Continue:
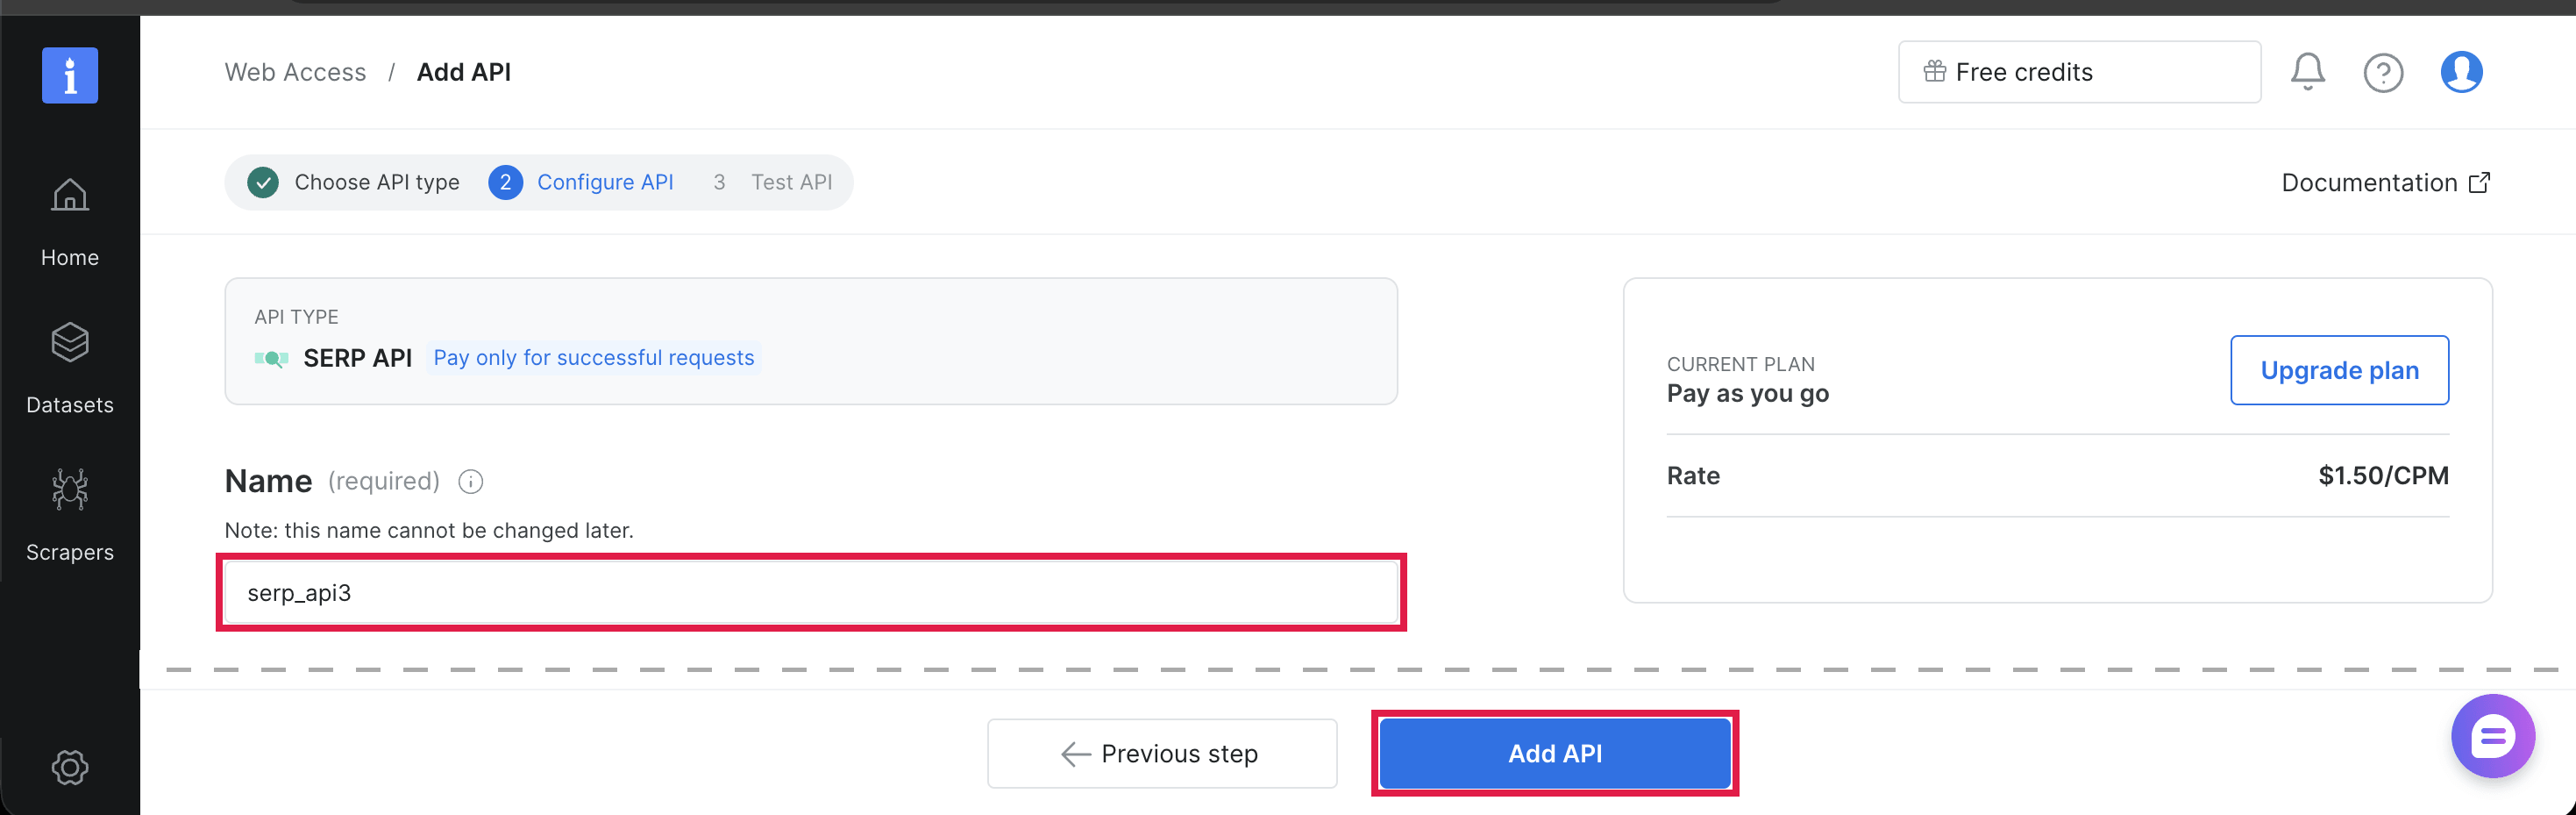
Dale un nombre a la API, asegúrate de que el formato de datos sea Raw HTML, y selecciona Add API. El JSON proviene de un parámetro en cada solicitud, no de este ajuste. El nombre de API que elegiste es el nombre de tu zona, que configuras en BRIGHTDATA_SERP_ZONE más abajo:
La clave API está en la barra de Quick start en la parte inferior de la página Home:
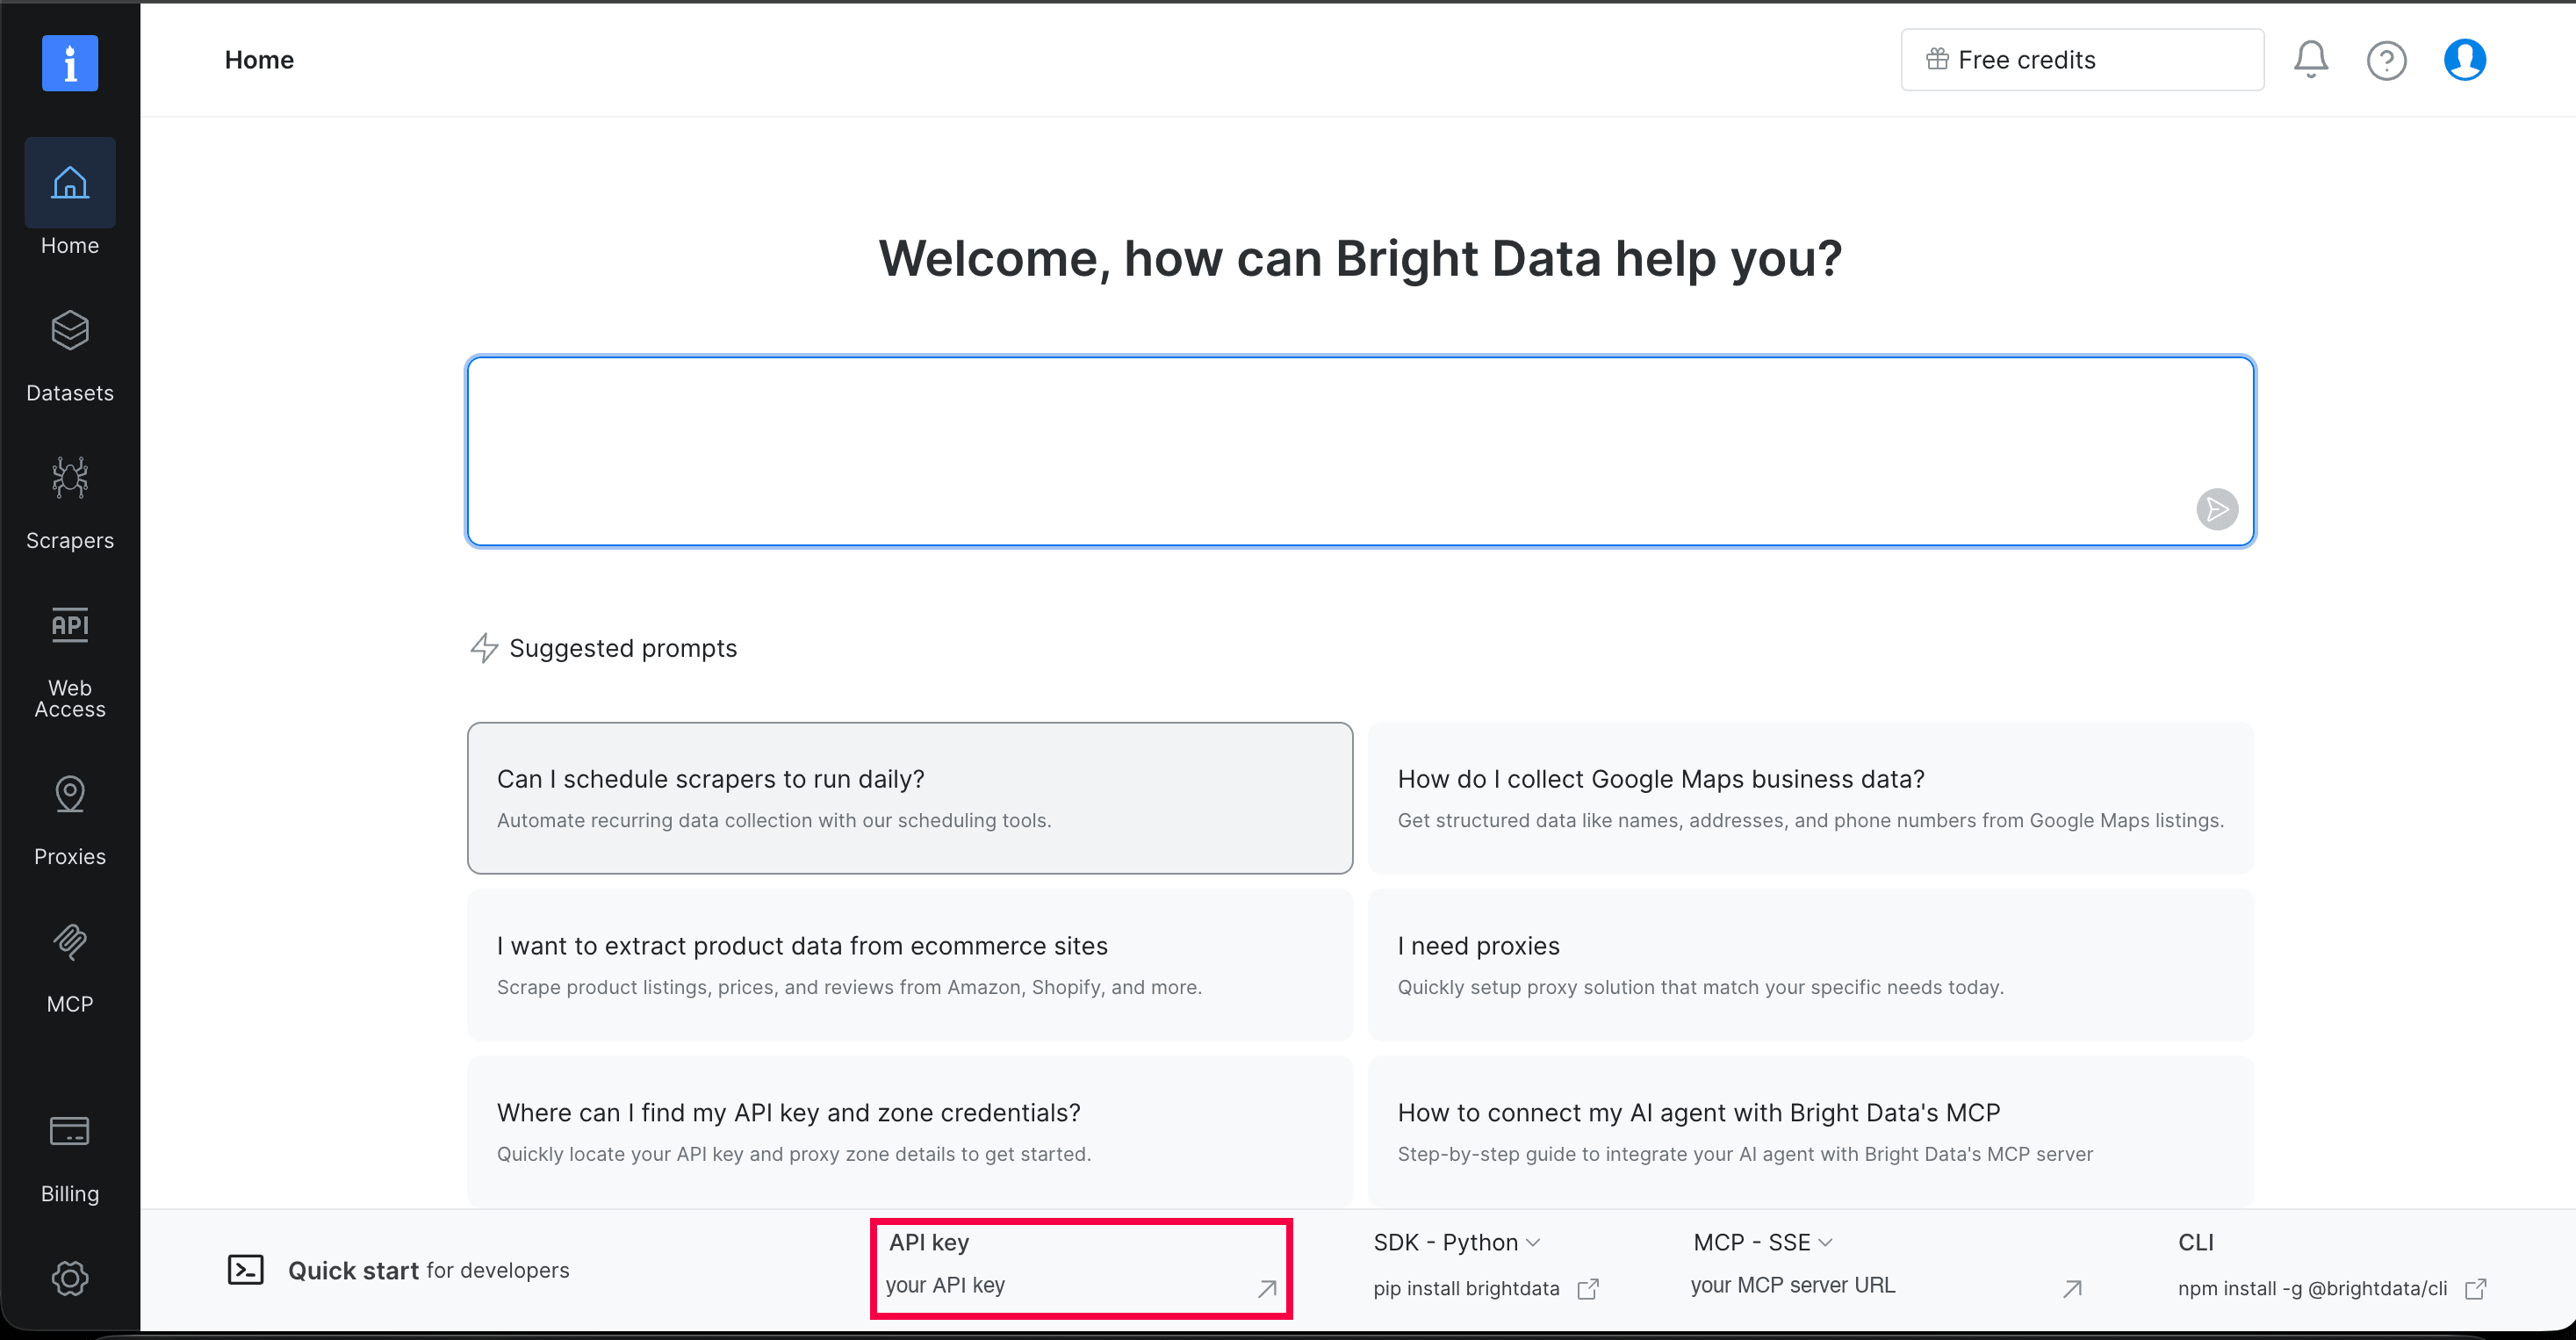
Crea un entorno virtual, configura la clave y el nombre de la zona, e instala la única dependencia de Python. Reemplaza ambos valores con tu propia clave y nombre de zona:
python3 -m venv .venv && source .venv/bin/activate
export BRIGHTDATA_API_KEY="your-api-key"
export BRIGHTDATA_SERP_ZONE="serp_api1"
python -m pip install "httpx>=0.27,<1"
En Windows PowerShell, usa este bloque en su lugar:
python -m venv .venv; .venv\Scripts\Activate.ps1
$env:BRIGHTDATA_API_KEY = "your-api-key"
$env:BRIGHTDATA_SERP_ZONE = "serp_api1"
python -m pip install "httpx>=0.27,<1"
Con uv, omite el entorno virtual e inicia cada script con uv run --with "httpx>=0.27,<1" python, seguido del nombre del script.
Un único POST al endpoint /request de Bright Data obtiene una URL de Google a través de tu zona y devuelve una página de resultados. Este comando curl envía esa solicitud e imprime la respuesta con formato legible:
curl https://api.brightdata.com/request \
  -H "Authorization: Bearer $BRIGHTDATA_API_KEY" \
  -H "Content-Type: application/json" \
  --data @- <<EOF | python -m json.tool
{
  "zone": "$BRIGHTDATA_SERP_ZONE",
  "url": "https://www.google.com/search?q=is+there+a+google+search+api&gl=us&hl=en&brd_json=1",
  "format": "raw"
}
EOF
El parámetro brd_json=1 convierte la página en JSON ya procesado, y "format": "raw" devuelve ese JSON sin cambios. La respuesta a continuación está acortada:
{
  "general": {
    "search_engine": "google",
    "query": "is there a google search api",
    "language": "en",
    "country_code": "US"
  },
  "organic": [
    {
      "link": "https://developers.google.com/custom-search/v1/overview",
      "title": "Custom Search JSON API | Google for Developers",
      "description": "The Custom Search JSON API lets you develop websites and applications to retrieve and display search results from Programmable Search Engine ...",
      "rank": 1
    }
  ],
  "pagination": {
    "current_page": 1,
    "next_page": 2,
    "next_page_start": 10
  }
}
Esa misma respuesta también contenía 8 búsquedas relacionadas y 4 preguntas de People Also Ask. La respuesta de Custom Search no tiene campos para ninguna de las dos cosas.
Paso 2: Mapea los parámetros de Custom Search a los parámetros de Google
La referencia de parámetros de consulta de Google de Bright Data y su lista de parámetros y operadores de URL de búsqueda de Google explican en detalle los parámetros de Google. Los campos de respuesta están en items[] en Custom Search y en organic[] en la respuesta de la API SERP:
| Custom Search JSON API | Google, a través de la API SERP |
|---|---|
q |
q |
num (máximo 10) |
Eliminado por Google. El adaptador solicita más páginas |
start (cuenta desde 1) |
start (cuenta desde 0, en pasos de 10) |
gl (favorece resultados de un país) |
gl (ejecuta la búsqueda como un usuario de ese país) |
hl (idioma de la interfaz) |
hl |
siteSearch=a.com |
site:a.com añadido a q |
siteSearchFilter=e |
-site:a.com añadido a q |
exactTerms=a b |
"a b" añadido a q |
excludeTerms=a |
-"a" añadido a q |
fileType=pdf |
filetype:pdf añadido a q |
dateRestrict=d7 |
tbs=qdr:d7, y lo mismo para w, m, y y |
safe=active |
safe=active |
searchType=image |
udm=2 (Google Images) |
title, link |
title, link |
snippet |
description |
displayLink |
Nombre de host de link |
queries.nextPage |
Calculado por el adaptador |
En Google, 3 parámetros funcionan de forma distinta:
Google cuenta los desplazamientos desde 0. Custom Search trata start=11 como la parte superior de la página 2, y Google trata start=10 como la página 2. Envía start en pasos de 10 y descarta en el código los resultados anteriores a tu posición inicial, tal como hace el adaptador.
Google eliminó num. La documentación de la API SERP indica que Google desaprobó num el 11 de septiembre de 2025. Cada página de Google contiene alrededor de 10 resultados, y el adaptador solicita tantas páginas como necesite num. Para más resultados por consulta, Bright Data puede devolver los 100 mejores resultados de Google, posiciones 1 a 100, en una sola llamada.
En Google, gl establece el país de búsqueda. La consulta “cloud hosting pricing” devolvió los mejores resultados del Reino Unido, Alemania e India sin compartir ninguna URL con los mejores resultados de EE. UU. Configura gl en cada solicitud según el país desde el que buscan tus usuarios.
Paso 3: Añade un adaptador listo para usar para cse.list()
El adaptador envía las llamadas cse.list() a la API SERP de Bright Data y funciona en Python 3.9 y versiones posteriores. Acepta los parámetros de Custom Search de la tabla y mantiene los campos title, link, snippet y displayLink en items. Ignora cx con una advertencia, porque la búsqueda de Google no tiene ID de motor, y añade ajustes de attempts y timeout.
En cada punto de llamada, el cambio se ve así:
# Antes, con el cliente de la API de Google
res = service.cse().list(q=query, cx=CX, num=10).execute()

# Después, con los mismos campos principales de items, sin ID de motor, y con gl y hl configurados
from cse_to_serp import cse_list

res = cse_list(q=query, num=10, gl="us", hl="en")
Comprueba 3 cosas más en cada punto de llamada:
- Si tu motor buscaba en una lista fija de sitios, inclúyelos en la consulta como
(site:a.com OR site:b.com). Una consulta restringida a 2 sitios de documentación de esta forma devolvió 10 resultados, todos de esos 2 hosts. - En un controlador de solicitudes web, pasa
attempts=1y untimeoutque se ajuste al presupuesto de tiempo del controlador. - Donde capturabas
HttpError, captura en su lugar(httpx.HTTPError, ValueError, RuntimeError).
Guarda el adaptador como cse_to_serp.py, o clona el repositorio complementario en GitHub, que también contiene los otros scripts a continuación y pruebas sin conexión. Aquí está el archivo completo:
"""Replace Google Custom Search JSON API calls with the Bright Data SERP API.

Same cse.list() parameters and core items fields.
"""

import math
import os
import time
import warnings
from urllib.parse import urlencode, urlparse

import httpx

API_URL = "https://api.brightdata.com/request"
API_KEY = os.environ.get("BRIGHTDATA_API_KEY")
if not API_KEY:
    raise RuntimeError("Set the BRIGHTDATA_API_KEY environment variable "
                       "to your Bright Data API key (step 1).")
ZONE = os.environ.get("BRIGHTDATA_SERP_ZONE", "serp_api1")
RETRY_STATUSES = {429, 500, 502, 503, 504}


def fetch_serp(params: dict, attempts: int = 4, timeout: float = 60) -> dict:
    """Fetch one Google results page as parsed JSON."""
    url = "https://www.google.com/search?" + urlencode(params)
    body = {"zone": ZONE, "url": url, "format": "raw"}
    headers = {"Authorization": f"Bearer {API_KEY}"}
    for attempt in range(attempts):
        try:
            resp = httpx.post(API_URL, json=body, headers=headers,
                              timeout=timeout)
        except httpx.TransportError:  # timeout or dropped connection
            if attempt == attempts - 1:
                raise
            time.sleep(16 + attempt * 10)
            continue
        error = (resp.headers.get("x-brd-error")  # API-level errors
                 or resp.headers.get("x-brd-err-msg"))  # proxy-level errors
        if resp.status_code == 200 and not error:
            page = resp.json()
            if "general" not in page:  # not a parsed results page
                raise ValueError("Unexpected response: " + resp.text[:200])
            return page
        if not error and resp.status_code not in RETRY_STATUSES:
            break  # wrong key, zone, or URL, so retrying will not help
        if attempt < attempts - 1:
            # Back off before resending the same query.
            time.sleep(16 + attempt * 10)
    resp.raise_for_status()
    code = (resp.headers.get("x-brd-error-code")  # maps to the error catalog
            or resp.headers.get("x-brd-err-code"))
    raise RuntimeError(f"SERP API error {code}: {error or resp.status_code}")


def cse_list(q, num=10, start=1, gl=None, hl=None, siteSearch=None,
             siteSearchFilter="i", exactTerms=None, excludeTerms=None,
             fileType=None, dateRestrict=None, safe="off", searchType=None,
             attempts=4, timeout=60, **extra):
    """Accept cse.list() parameters, return a dict in cse.list() format."""
    if extra.pop("cx", None):  # no engine ID, so every call searches Google
        warnings.warn("cx is ignored. Add (site:a.com OR site:b.com) to q "
                      "if your engine searched a fixed list of sites")
    if extra:  # fail loudly instead of ignoring a filter
        raise TypeError(f"No mapping for: {sorted(extra)}")
    if exactTerms:  # Custom Search filters become Google search operators
        q = f'{q} "{exactTerms}"'
    if excludeTerms:
        q = f'{q} -"{excludeTerms}"'
    if fileType:
        q = f"{q} filetype:{fileType}"
    if siteSearch:
        exclude = "-" if siteSearchFilter == "e" else ""
        q = f"{q} {exclude}site:{siteSearch}"
    params = {"q": q, "brd_json": 1}  # brd_json=1 returns parsed JSON
    if gl:
        params["gl"] = gl
    if hl:
        params["hl"] = hl
    if safe == "active":
        params["safe"] = "active"
    if dateRestrict:  # "d7" -> qdr:d7 (past 7 days), "m6" -> qdr:m6
        params["tbs"] = "qdr:" + dateRestrict
    if searchType == "image":
        return image_list(params, num, start, attempts, timeout)
    if searchType:
        raise ValueError(f"No mapping for: searchType={searchType}")

    # Custom Search counts from 1 (start=11 is page 2), Google from 0
    # (start=10 is page 2). Track each result's Google position.
    first = start - 1
    offset = first // 10 * 10  # the Google page that contains `start`
    items, next_start = [], None
    # Fetch the pages for positions first to first + num - 1, 1 request each
    for _ in range(math.ceil((num + first - offset) / 10)):
        params["start"] = offset
        page = fetch_serp(params, attempts, timeout)
        for i, result in enumerate(page.get("organic", [])):
            position = offset + i
            if position < first or not result.get("link"):
                continue
            if len(items) == num:
                next_start = position + 1  # convert to 1-based
                break
            items.append({
                "title": result.get("title", ""),
                "link": result["link"],
                "snippet": result.get("description", ""),
                "displayLink": urlparse(result["link"]).netloc,
            })
        if next_start:
            break
        offset = (page.get("pagination") or {}).get("next_page_start")
        if not offset:  # Google has no further pages for this query
            break
    else:
        next_start = offset + 1  # continue at the next Google page

    response = {"items": items, "queries": {}}
    if next_start:
        response["queries"]["nextPage"] = [{"startIndex": next_start}]
    return response


def image_list(params, num, start, attempts, timeout):
    """Google Images returns the whole image grid in one request."""
    params["udm"] = 2
    page = fetch_serp(params, attempts, timeout)
    images = [i for i in page.get("images") or [] if i.get("original_image")]
    items = [{
        "title": image.get("image_alt", ""),
        "link": image["original_image"],
        "snippet": image.get("image_alt", ""),
        "displayLink": urlparse(image["original_image"]).netloc,
    } for image in images[start - 1:start - 1 + num]]
    response = {"items": items, "queries": {}}
    if start - 1 + num < len(images):
        response["queries"]["nextPage"] = [{"startIndex": start + num}]
    return response


if __name__ == "__main__":
    res = cse_list("httpx timeout configuration", num=10,
                   gl="us", hl="en")
    for i, item in enumerate(res["items"], start=1):
        print(i, item["displayLink"], "|", item["title"][:60])
Al ejecutar python cse_to_serp.py se imprimieron estos como sus primeros 5 resultados. Los resultados provienen de la página en vivo de Google, así que los tuyos pueden variar.
1 www.python-httpx.org | Timeouts
2 github.com | Proposal: Add a Global Timeout Setting in httpx #3356
3 www.python-httpx.org | QuickStart
4 stackoverflow.com | python - Httpx requests timing out when it shouldn't
5 oneuptime.com | How to Use httpx for Async HTTP Requests
Con num=10, cada llamada a nextPage obtiene una sola página de Google, por lo que cuesta 1 solicitud.
Con searchType="image", 1 solicitud para “ergonomic office chair” devolvió 100 imágenes, mientras que Custom Search devolvía como máximo 10 por solicitud. Cada llamada del adaptador obtiene la cuadrícula completa de imágenes y devuelve num imágenes de ella.
Reemplaza la herramienta de búsqueda en agentes MCP, LangChain y n8n
Los agentes que se conectan a herramientas a través de MCP no necesitan adaptador. El servidor Bright Data Web MCP expone la búsqueda de Google como su herramienta search_engine, y el servidor alojado es una sola URL con un nivel gratuito. En Claude Code, lo añades con un solo comando:
claude mcp add --transport http brightdata https://mcp.brightdata.com/mcpLos clientes MCP que admiten OAuth, como Claude Code y Cursor, inician sesión a través de tu navegador, sin ninguna clave API en un archivo de configuración. Para trabajos de CI y scripts, usa en su lugar https://mcp.brightdata.com/mcp?token=YOUR_API_KEY. Añade &tools=search_engine,scrape_as_markdown a esa URL para darle al agente búsqueda más una herramienta que lee cada página de resultados como Markdown.
Los agentes de codificación también pueden usar la CLI de Bright Data. Instálala con npm install -g @brightdata/cli, luego ejecuta brightdata login para iniciar sesión a través de tu navegador. El agente obtiene un comando brightdata search.
Para código que ya llama a LangChain, el método GoogleSearchAPIWrapper.results() devuelve diccionarios con title, link y snippet. Los items del adaptador tienen las mismas claves. Instala el paquete core de LangChain, que necesita Python 3.10 o posterior, con python -m pip install "langchain-core>=1.0,<2". Guarda este archivo como langchain_tool.py junto al adaptador cse_to_serp.py, y pasa google_search en la lista de herramientas de tu agente.
"""LangChain tool that replaces GoogleSearchAPIWrapper.results()."""

from langchain_core.tools import ToolException, tool

from cse_to_serp import cse_list


@tool
def google_search(query: str) -> list[dict]:
    """Search Google and return the top results with title, link, snippet."""
    try:  # 2 attempts and a 20 s timeout limit each search
        return cse_list(q=query, num=10, gl="us", hl="en",
                        attempts=2, timeout=20)["items"]
    except Exception as exc:
        raise ToolException(f"Google search failed: {exc}") from exc


google_search.handle_tool_error = True  # the agent gets the error as text
Para ver un agente completo construido de esta forma, consulta Usar LangChain y Bright Data para la búsqueda web.
Los flujos de trabajo sin código que llaman a Custom Search reciben el mismo 403, y el foro de la comunidad de n8n tiene un hilo sobre ese error exacto. El nodo oficial de n8n de Bright Data se instala como el nodo comunitario @brightdata/n8n-nodes-brightdata. Tiene una operación Web Search que envía la consulta a Google a través de la zona que selecciones, como tu zona de API SERP. Reemplaza la solicitud de Custom Search del flujo de trabajo con esa operación.
Ejecuta búsquedas a volumen de producción
Los trabajos por lotes, y los agentes que envían muchas búsquedas en una sola tarea, necesitan ejecutar varias consultas al mismo tiempo. El módulo serp_batch.py del repositorio complementario ejecuta en paralelo una versión asíncrona del bucle de solicitud y reintento del adaptador. Por separado, la propia API SERP ofrece un modo asíncrono para lotes de 1K consultas o más.
El bloque principal del archivo envía las mismas 10 consultas dos veces, y la segunda ejecución se sirve desde su caché en memoria.
{'queries': 20, 'cache_hits': 10, 'empty': 0, 'failed': 0}Su función search_many() tiene 3 ajustes y un conjunto de contadores.
concurrencyestablece cuántas solicitudes se ejecutan a la vez. La API SERP no tiene límite de concurrencia, así que configúralo según la carga que tu propio sistema pueda manejar.deadlinelimita el tiempo total para una consulta, así que mantenlo corto para una herramienta de agente y más largo para un trabajo por lotes.ttlestablece cuánto tiempo permanece válida una página en caché.- Los contadores muestran aciertos de caché, resultados vacíos y fallos, así que un filtro
site:o un valorglincorrecto aparece temprano como resultados vacíos.
Una llamada devuelve un diccionario que asigna cada consulta a su página ya procesada, o a None si la consulta falló.
import asyncio

from serp_batch import search_many

pages = asyncio.run(search_many(["redis cache ttl", "nginx rate limiting"],
                                concurrency=20, gl="us", hl="en"))
Obtén el AI Overview y las preguntas de People Also Ask
Los agentes, las canalizaciones RAG, y los equipos de SEO pueden necesitar más que una lista de 10 enlaces. La página de Google para “what is retrieval augmented generation” muestra un AI Overview y preguntas de People Also Ask, que Custom Search nunca devolvía.
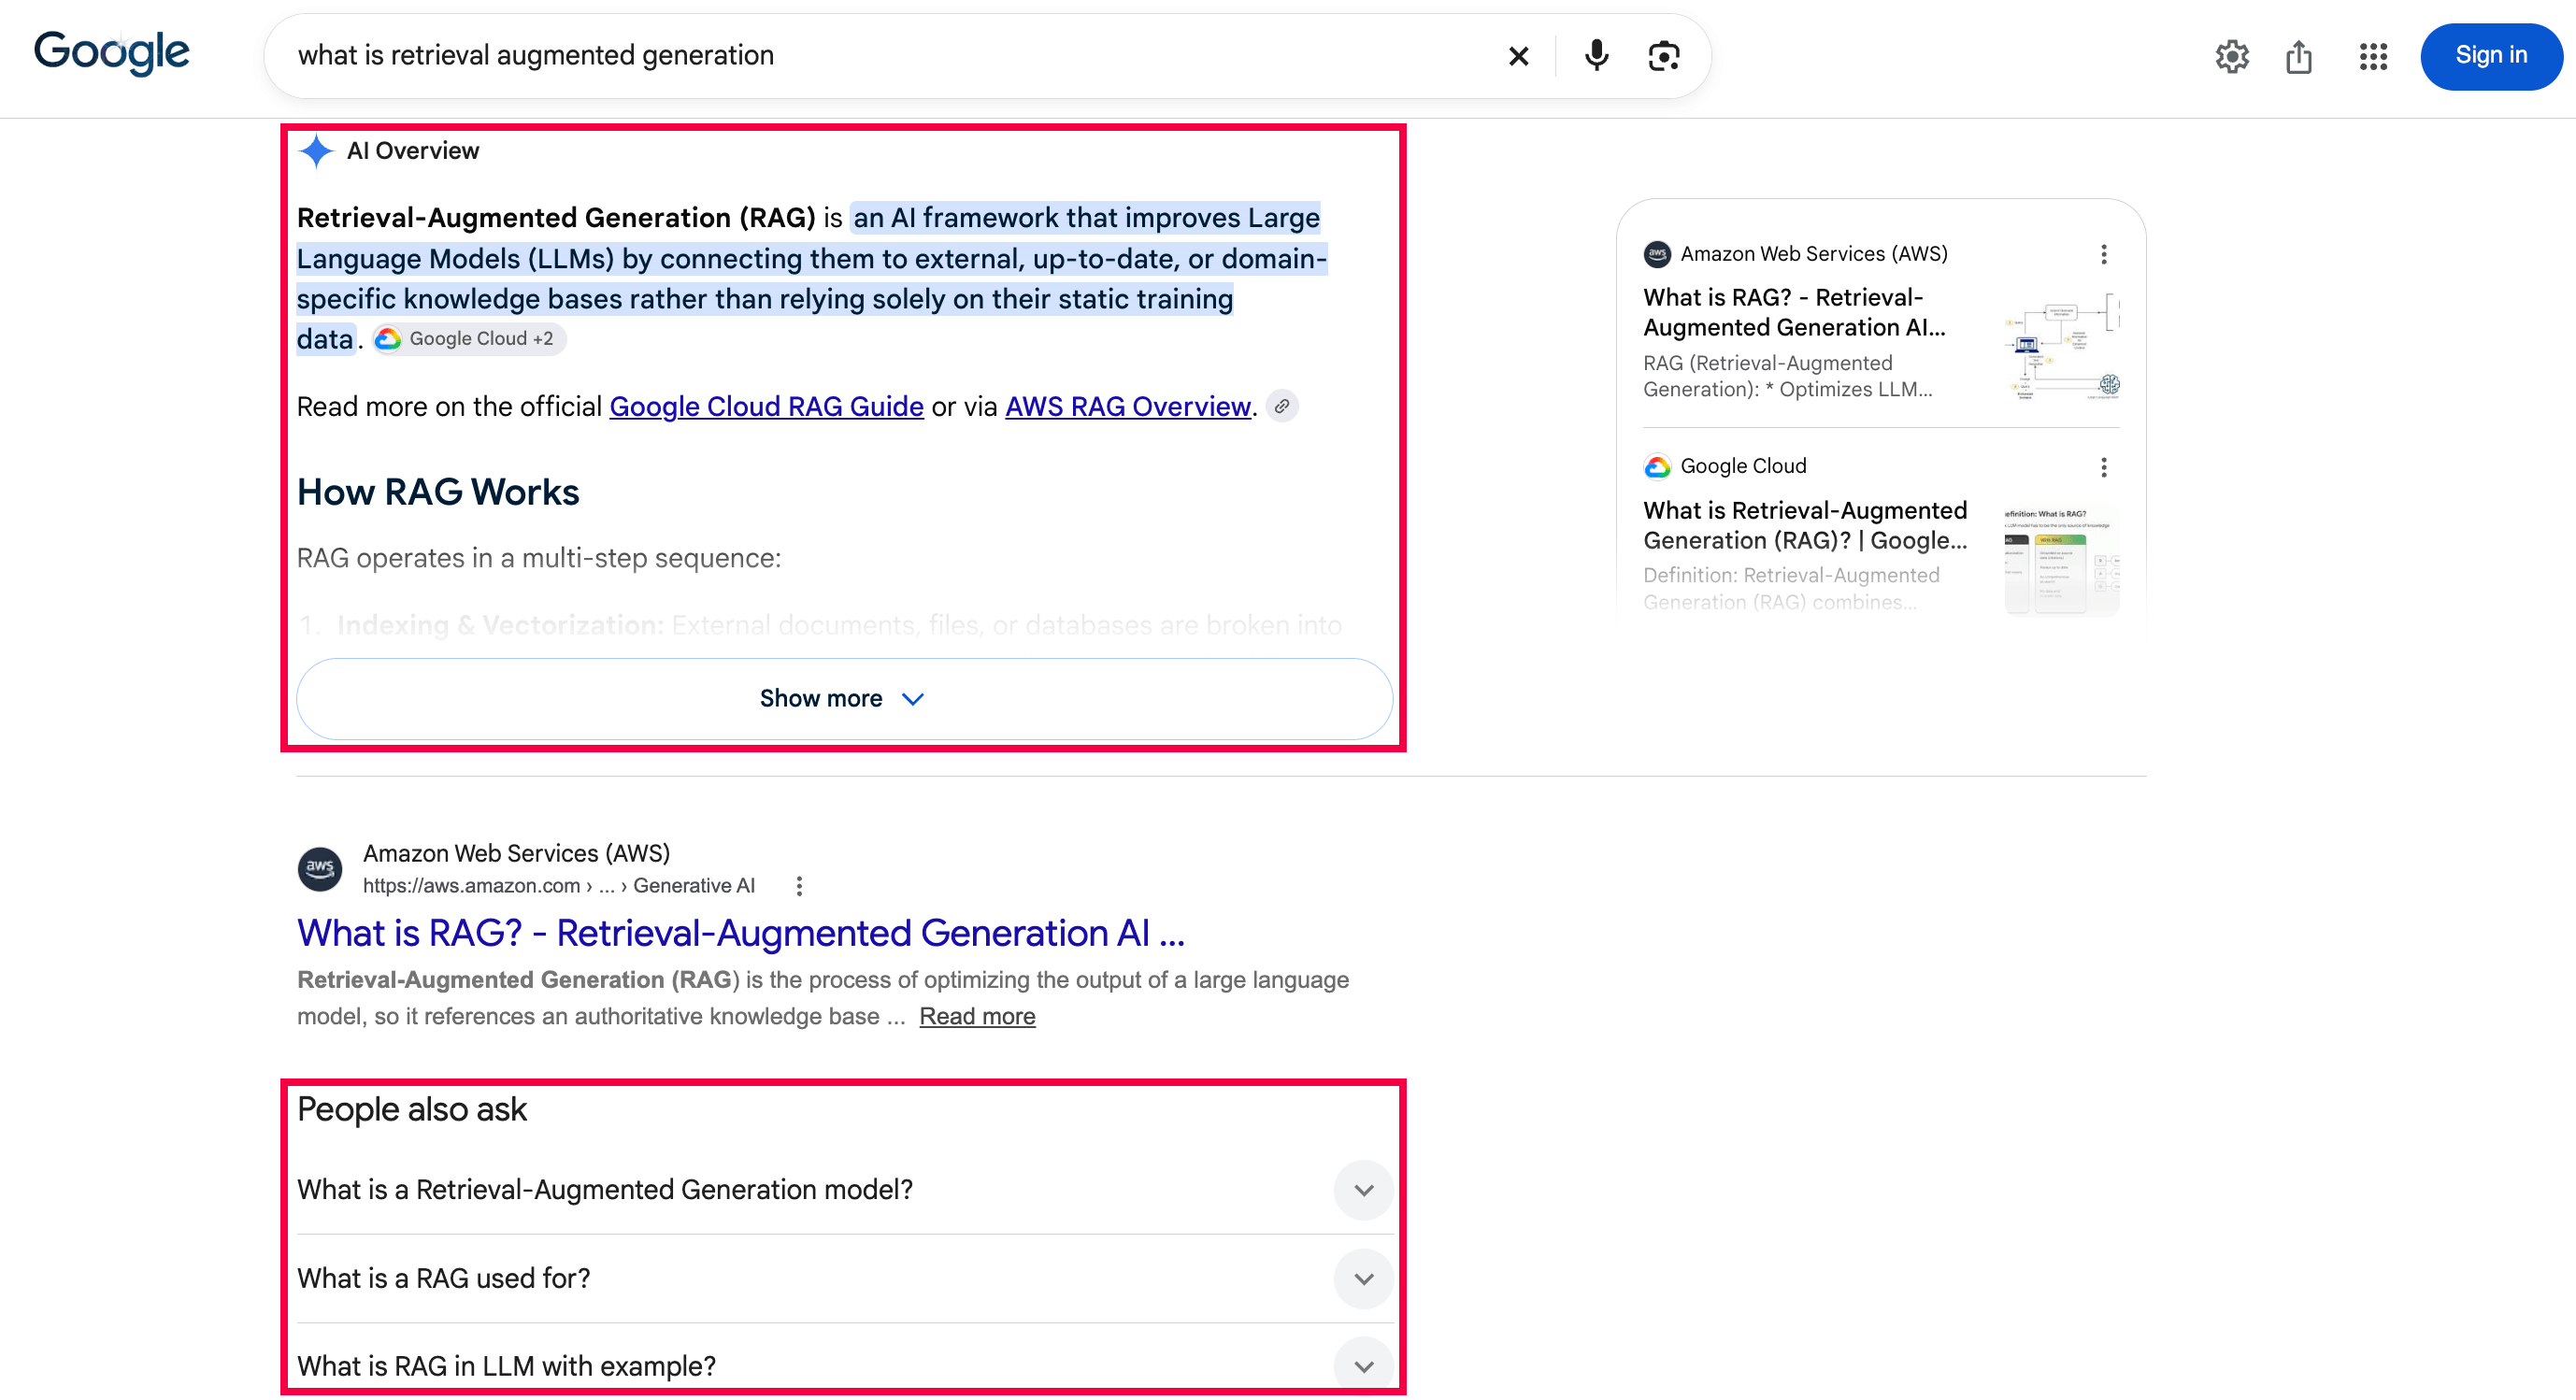
Un parámetro extra solicita el AI Overview, y la misma respuesta contiene cualquier pregunta de People Also Ask. Guarda este script junto al adaptador cse_to_serp.py del paso 3.
"""Read the AI Overview and People Also Ask questions from one Google query."""

from cse_to_serp import fetch_serp

page = fetch_serp({
    "q": "what is retrieval augmented generation",
    "gl": "us",
    "hl": "en",
    "brd_json": 1,
    "brd_ai_overview": 2,  # requests the AI Overview
})

overview = page.get("ai_overview") or {}
print("AI Overview text blocks:", len(overview.get("texts", [])))
print("AI Overview sources:", len(overview.get("references", [])))
questions = dict.fromkeys(  # keeps each question once, in order
    item["question"] for item in page.get("people_also_ask", [])
    if item.get("question")
)
for question in list(questions)[:2]:
    print("People also ask:", question)
El script imprimió esta salida. La página de Google está en vivo, así que tus preguntas pueden diferir de la captura de pantalla.
AI Overview text blocks: 3
AI Overview sources: 8
People also ask: Does ChatGPT use Retrieval-Augmented Generation?
People also ask: What is RAG in LLM with example?
Cada entrada de references contiene el href y el title de la página citada, así que los equipos de SEO pueden rastrear qué sitios cita el AI Overview. La página Google AI Overview API de Bright Data explica el parámetro en detalle. Para Google AI Mode, la Google Scraper API devuelve los resultados de AI Mode Search como JSON.
Una canalización RAG que lee las páginas de resultados puede obtenerlas a través del mismo endpoint /request. Usa una zona de Web Unlocker y la misma clave API.
Lista de verificación de migración antes del 1 de enero de 2027
Ejecuta estos pasos mientras tu clave de Custom Search todavía funcione, porque el punto 2 la necesita.
- Encuentra todos los puntos de llamada. Busca en tu código
customsearch/v1,cse().list, y envoltorios comoGoogleSearchAPIWrapper. En una base de código grande, un agente de codificación puede ejecutar esa búsqueda y hacer el cambio del paso 3 en cada punto de llamada. - Guarda los resultados de Custom Search para una muestra de consultas reales de producción, para así mantener una línea base después de que la clave deje de funcionar. Si la clave ya ha dejado de funcionar, guarda en su lugar resultados de google.com para los mismos
glyhl. - Empieza con el nivel gratuito, luego presupuesta 1 solicitud de API SERP por página de resultados.
- Deja que el adaptador convierta los valores de
startbasados en 1 a los valores basados en 0 de Google, o conviértelos tú mismo y solicita páginas completas. - Configura
glyhlen cada solicitud. - Compara los resultados antiguos y nuevos como conjuntos de URLs, no por posición exacta. Para los agentes, vuelve a ejecutar también tus evaluaciones de tareas y puntúa las respuestas finales. Espera algunas diferencias, porque los nuevos resultados provienen de la página completa de resultados de Google, no del subconjunto del índice de Custom Search.
- Cambia detrás de un feature flag, ejecuta ambas rutas en paralelo durante unos días, luego elimina la clave de Google.
Para el punto 6, el ayudante compare_baseline.py puntúa cada consulta de 0 a 1. La puntuación es la proporción de las 10 URLs principales guardadas que todavía aparecen en las nuevas 10 principales.
Primero, ejecuta cada consulta dos veces a través de la API SERP y puntúa las 2 ejecuciones entre sí. El ranking de Google puede cambiar entre llamadas, así que una puntuación justo por debajo de 1.0 puede ser normal. En las pruebas, 2 ejecuciones de una consulta con el mismo gl puntuaron 1.0, y una ejecución de EE. UU. frente a una del Reino Unido puntuó 0.0. Luego puntúa todas las consultas guardadas, revisa a mano las puntuaciones más bajas, y comprueba los filtros gl y site: para cualquier puntuación cercana a 0.
Soluciona errores de migración
Estos son problemas de configuración de la primera ejecución o comportamiento de Google.
| Síntoma | Causa | Solución |
|---|---|---|
| Google devuelve 403 en las llamadas a Custom Search | API cerrada a nuevos clientes | Una clave nueva no ayudará. Migra a la API SERP de Bright Data |
RuntimeError: Set the BRIGHTDATA_API_KEY environment variable… |
Variable no configurada en esta terminal | Configura BRIGHTDATA_API_KEY como en el paso 1 |
| 401 “Invalid token” | Clave API de Bright Data incorrecta | Copia la clave desde la barra Quick start en Home |
400 zone "..." not found |
Nombre de zona incorrecto | Usa el nombre que le diste a la API en el paso 1 |
UserWarning: cx is ignored… |
La búsqueda de Google no tiene ID de motor | Elimina cx. Si el motor buscaba en una lista fija de sitios, añade (site:a.com OR site:b.com) a q |
TypeError: No mapping for: [...] |
Un parámetro que no está en la tabla del paso 2 | Añade el equivalente de Google a q o a los params del adaptador, o elimina el parámetro |
KeyError en pagemap o searchInformation |
El adaptador devuelve 4 campos principales | Elimina el código que lee el campo, o mapéalo desde la respuesta de la API SERP |
items tiene menos de num resultados |
La página de Google contenía menos resultados orgánicos | Sigue queries.nextPage |
items está vacío |
Sin coincidencia, o un valor incorrecto de filtro site: o gl |
Prueba la consulta en google.com |
| Los resultados difieren de Custom Search | Custom Search buscaba en un subconjunto del índice de Google | Compara conjuntos de URLs. Ejecuta cada consulta dos veces primero para ver la variación normal |
Un mensaje RuntimeError: SERP API error… incluye el valor x-brd-error-code o x-brd-err-code. Busca el código en el catálogo de errores de la API SERP.
Reflexiones finales
El producto de búsqueda de toda la web de Google no es público, y la fecha de finalización de Custom Search JSON API es el 1 de enero de 2027. Las opciones públicas de Google buscan en una lista fija de dominios o devuelven respuestas de Gemini, y los términos de Gemini prohíben almacenar en caché o analizar los resultados. Las solicitudes HTTP directas no obtuvieron resultados en las pruebas, así que la API SERP de Bright Data es el reemplazo práctico cuando tu código necesita la página de resultados.
El adaptador del paso 3 gestiona el start basado en 0 de Google y el num eliminado, así que tu código principalmente necesita gl en cada llamada. Ejecuta tus consultas guardadas a través del nivel gratuito de la API SERP de Bright Data, sin tarjeta de crédito, y compáralas con tu línea base de Custom Search o con google.com.
Preguntas frecuentes
¿Está descontinuada la Google Custom Search API?
Sí, en 2 etapas. Google cerró Custom Search JSON API a nuevos clientes en enero de 2026, y el acceso de los clientes existentes terminará el 1 de enero de 2027. Google sugiere Agent Search para hasta 50 dominios. La API SERP de Bright Data devuelve resultados de Google de toda la web como JSON.
¿Tiene Google una API de búsqueda?
No una API de búsqueda de toda la web a la que los nuevos desarrolladores puedan suscribirse. Google ofrece Agent Search para hasta 50 dominios y Grounding con Google Search, que devuelve respuestas de Gemini con enlaces. El producto de búsqueda de toda la web de Google no es público. Para resultados de Google como JSON, usa la Google Search API de Bright Data, parte de su API SERP.
¿Es gratuita la API de búsqueda de Google?
No para los nuevos desarrolladores que necesitan resultados de toda la web. Custom Search JSON API da a los clientes existentes 100 consultas gratuitas al día, y luego cobra $5 por cada 1,000, hasta el 1 de enero de 2027. La API SERP de Bright Data devuelve resultados de Google como JSON, con 5K solicitudes gratuitas al mes.
¿Qué puede reemplazar a la Google Custom Search API?
La API SERP de Bright Data reemplaza directamente a Custom Search JSON API, porque devuelve la página completa de resultados de Google como JSON. Las propias opciones de Google devuelven respuestas de IA o buscan en una lista fija de dominios. Un adaptador de Python de código abierto y listo para usar convierte tus llamadas cse.list() en parámetros de Google.
¿Cómo puedo hacer scraping de los resultados de búsqueda de Google?
No solo con un cliente HTTP. Google Search requiere JavaScript, así que en las pruebas, los clientes HTTP obtuvieron una página 200 sin resultados. Luego, los navegadores en la misma conexión recibieron una página CAPTCHA. La API SERP de Bright Data devuelve la página de resultados de Google como JSON ya procesado, sin navegadores ni analizadores que tengas que mantener.
¿Por qué la Custom Search API devuelve 403?
Google cerró Custom Search JSON API a nuevos clientes en enero de 2026, así que una clave o proyecto nuevo no solucionará el error 403. En el foro de desarrolladores de Google, un desarrollador también reporta que un proyecto existente perdió el acceso tras un cambio de facturación. Mueve las llamadas a la API SERP de Bright Data, que devuelve resultados de Google como JSON.