Para el monitoreo de precios, hacer scraping de productos de Target a escala significa leer precios de tienda y stock desde APIs JSON internas en lugar del HTML de la página.
En nuestras pruebas, un paquete de 31 cápsulas Tide costaba $9.99 en Cedar Rapids y $12.69 en Chicago al mismo tiempo. Algunas respuestas parecían válidas pero contenían un precio online o el rango de precios de un producto padre. Desde IPs de EE. UU., solo 1 de 112 llamadas a la API de productos desde clientes curl y Python con configuración predeterminada tuvo éxito.
Esta guía te muestra cómo recopilar esos precios, detectar respuestas erróneas y decidir si construir un scraper o usar un Target Price Scraper.
Resumen
- Solicita precios por ID de tienda. Mapea códigos postales a IDs de tienda, luego llama a la API de productos de Target con su clave de API pública.
- Verifica la ubicación y variante de cada precio. La ubicación 3991 marca un precio online, y un producto padre puede devolver un rango, así que guarda 1 fila por variante.
- Encuentra bloqueos en los cuerpos de respuesta. Las llamadas bloqueadas devolvieron HTTP 435, a veces como JSON válido.
- Elige la herramienta según cómo rastrees ubicaciones. Para códigos postales, la Target Scraper API de Bright Data coincidió con nuestro scraper en 20 de 20 verificaciones. Para IDs de tienda o stock por canal, ejecuta tu código en la API Web Unlocker.
Cómo Target sirve los datos de productos
En nuestras pruebas, un scraper podía leer precios, stock y detalles de productos desde 3 hosts de Target. El HTML de la página de producto fue la única fuente sin precio. Target identifica cada producto con un TCIN (Target.com Item Number), el número después de A- en la URL de un producto.
Los 3 hosts estaban detrás del CDN Fastly de Target. En los hosts www y redsky, la verificación de bots de HUMAN Security podía bloquear una solicitud y devolver una respuesta de bloqueo en lugar de datos:
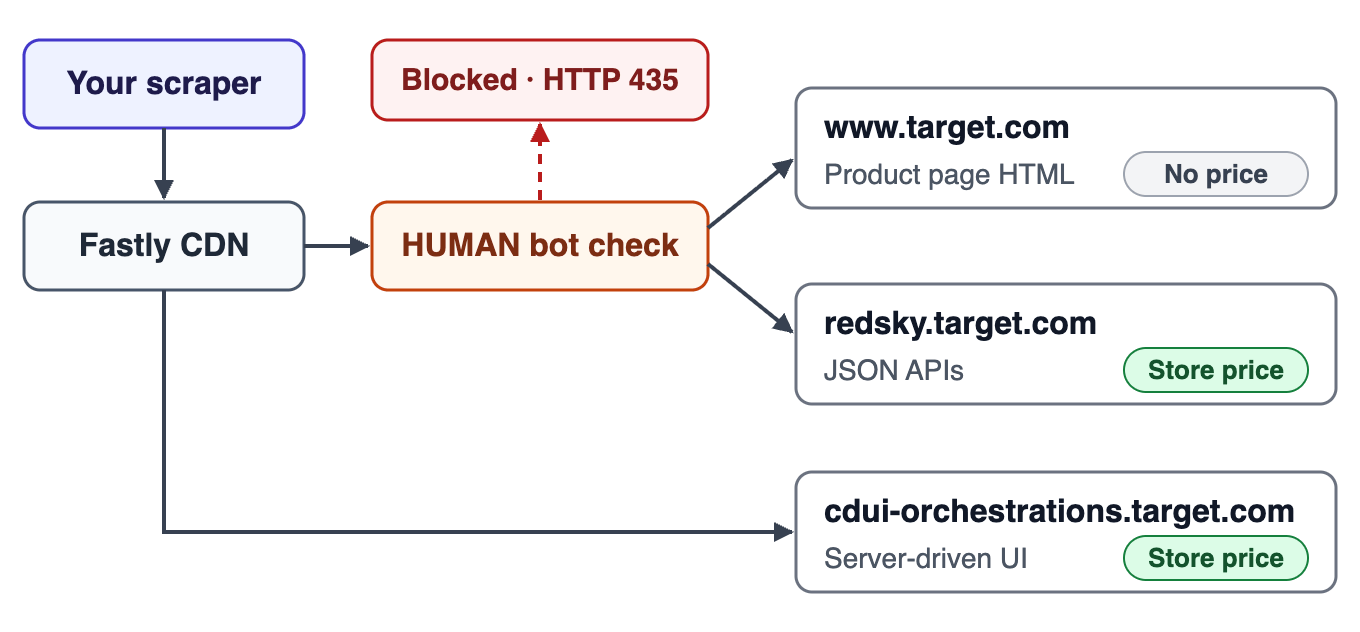
En nuestras pruebas, el HTML de la página no tenía precio, mientras que las APIs JSON y los módulos de UI dirigidos por servidor sí tenían el precio de tienda.
El HTML de la página no tenía precio
La página de producto era una aplicación Next.js. Su script __NEXT_DATA__ tenía el título, descripción, imágenes y un resumen de reseñas, pero sin precio. Las props de la página contenían isProductDetailServerSideRenderPriceEnabled: false en cada página que obtuvimos con curl, ya fuera el user agent curl, python-requests, Chrome o HeadlessChrome. Si esa bandera se vuelve true, el HTML puede incluir precios, así que verifica la bandera antes de parsear el HTML.
Las mismas props etiquetaban a cada visitante con banderas isBot, isAiAgent e isSeoPhantom. Las solicitudes que afirmaban ser un rastreador de motor de búsqueda, como Googlebot, obtuvieron una página diferente y en caché con JSON-LD de schema.org y un precio renderizado.
Ese precio pertenecía a una única ubicación predeterminada. Los motores de búsqueda publican cómo verificar sus rastreadores con DNS inverso, así un sitio puede detectar un rastreador falsificado. Para precios de tienda, usa las APIs JSON de abajo en lugar de esa página.
Los precios y el stock venían de APIs JSON
La API de agregación de Target en redsky.target.com devuelve precios por tienda. Cada endpoint que llamamos requería un parámetro key. Sin la clave, la API devolvía 401 con "no API key found in request".
La clave es una clave de API pública, no un secreto. Apareció 28 veces en cada página de producto que guardamos, excepto la página en caché que recibían los rastreadores. Léela de una página de Target, como la página de inicio, en lugar de codificarla directamente.
Cuando verificamos, el robots.txt del host de la API no permitía ningún rastreador, mientras que el robots.txt del sitio principal permitía páginas de producto.
Estos 4 endpoints fueron suficientes para cada tarea de datos de productos que probamos:
| Endpoint | Qué devuelve | Límites y errores en nuestras pruebas |
|---|---|---|
pdp_client_v1 |
Producto, precio en 1 store_id, y cada variante de la familia |
404 para un TCIN que ya no existe |
plp_search_v2 |
Resultados de búsqueda para una palabra clave o un número de código de barras UPC | count hasta 28, offset hasta 1,199 |
nearby_stores_v1 |
IDs de tienda cerca de un código postal | |
product_fulfillment_v1 |
Envío, recogida y stock en tienda en la tienda solicitada, a veces con una tienda cercana | Ninguno |
Esta solicitud obtiene el precio de un cartón de leche UHT Parmalat en la tienda Chelsea de Nueva York, tienda 3412, con curl y jq:
KEY=$(curl -s https://www.target.com/ \
  | grep -oE '[0-9a-f]{40}' | sort | uniq -c | sort -rn \
  | head -1 | awk '{print $2}')

REDSKY=https://redsky.target.com/redsky_aggregations/v1/web
Q="key=$KEY&tcin=15078349"
Q="$Q&store_id=3412&pricing_store_id=3412"
Q="$Q&channel=WEB&page=%2Fp%2FA-15078349"
curl -s "$REDSKY/pdp_client_v1?$Q" \
  | jq '.data.product.children[]
        | select(.tcin=="15078349") | .price'
El campo location_id en la respuesta muestra a qué tienda pertenece el precio:
{
  "current_retail": 3.89,
  "display_was_now": false,
  "formatted_current_price": "$3.89",
  "formatted_current_price_type": "reg",
  "formatted_unit_price": "$0.12",
  "formatted_unit_price_suffix": "/fluid ounce",
  "reg_retail": 3.89,
  "location_id": 3412,
  "external_system_id": "15078349-3412-3.89-2025080815"
}
El precio está bajo children porque este TCIN es una variante de un producto padre. Ambos comandos curl de arriba funcionaron desde nuestra conexión en India. Desde IPs de EE. UU., la verificación de bots de Target bloqueó casi todas esas solicitudes en nuestras pruebas. En ese caso, jq imprimió un error de parseo, porque la respuesta era una página de bloqueo HTML, no JSON.
La API Web Unlocker envía las mismas solicitudes a través de su capa de desbloqueo y devuelve el JSON de Target. Primero configura las variables de entorno BRIGHTDATA_API_KEY y UNLOCKER_ZONE, como muestra la guía rápida de la API Web Unlocker:
unlock() {
  curl -s https://api.brightdata.com/request \
    -H "Authorization: Bearer $BRIGHTDATA_API_KEY" \
    -H "Content-Type: application/json" \
    -d "{\"zone\": \"$UNLOCKER_ZONE\",
         \"url\": \"$1\", \"format\": \"raw\"}"
}

KEY=$(unlock https://www.target.com/ \
  | grep -oE '[0-9a-f]{40}' | sort | uniq -c | sort -rn \
  | head -1 | awk '{print $2}')

REDSKY=https://redsky.target.com/redsky_aggregations/v1/web
Q="key=$KEY&tcin=15078349"
Q="$Q&store_id=3412&pricing_store_id=3412"
Q="$Q&channel=WEB&page=%2Fp%2FA-15078349"
unlock "$REDSKY/pdp_client_v1?$Q" \
  | jq '.data.product.children[]
        | select(.tcin=="15078349") | .price'
La función unlock acepta cualquier URL de Target, incluyendo la solicitud de stock abajo.
La página en vivo cargaba módulos de UI dirigidos por servidor
En nuestras capturas de red de navegador, la página de producto no llamaba a pdp_client_v1. Su diseño venía de módulos de UI dirigidos por servidor, secciones de página que el servidor envía como datos, ya sea dentro de __NEXT_DATA__ o desde cdui-orchestrations.target.com. Una llamada deferred_enrichment en www.target.com agregaba los módulos específicos de ubicación.
La respuesta de cdui-orchestrations.target.com y los módulos deferred_enrichment contenían precios. Con include_data_source_modules=true, una solicitud a cdui-orchestrations.target.com para la tienda Chelsea devolvió el mismo precio e ID de ubicación que pdp_client_v1 en 16 de 16 productos de prueba. Un endpoint que la página de producto no llamaba, como pdp_client_v1, puede desaparecer sin aviso, y los precios cdui coincidentes te dan un respaldo probado.
Por qué los scrapers de Target fallan a escala
Algunos fallos ocurren en la primera solicitud, y otros aparecen solo cuando una tarea incluye muchas tiendas y productos.
Los bloqueos dependían de la IP y el cliente
En nuestras pruebas, Target usaba HUMAN Security, un servicio de detección de bots que se fusionó con PerimeterX en 2022. Cada página de producto que obtuvimos con un user agent de navegador o cliente HTTP cargaba el script sensor de HUMAN desde client.px-cloud.net.
En nuestra prueba de IP y cliente, enviamos las mismas 16 URLs pdp_client_v1 desde cada fuente de IP y cliente, en ejecuciones distribuidas en 3 horas. Una llamada pasaba si devolvía 200 o 206 sin bloqueo de HUMAN en el cuerpo:
| Fuente de IP | Cliente | Llamadas que pasaron |
|---|---|---|
| IPs en India | curl | 63 de 64 |
| IPs en EE. UU. | curl o requests de Python, user agent predeterminado |
1 de 112 |
| API Web Unlocker con IPs de salida de EE. UU. | Seleccionado por la API Web Unlocker | 32 de 32 |
Desde India, incluso curl pasó. Desde IPs de EE. UU., el resultado dependía del cliente, y los encabezados similares a navegador permitieron que pasaran más llamadas. La API Web Unlocker selecciona los encabezados y la huella digital del navegador por ti, y pasó todas las llamadas en esta prueba.
El host cdui-orchestrations.target.com se comportó de manera diferente cuando alternamos llamadas a él y a pdp_client_v1 con el user agent predeterminado de Python desde IPs de EE. UU. El host cdui respondió a las 8 llamadas, mientras que la verificación de bots bloqueó las 8 llamadas a pdp_client_v1. Desde nuestra conexión en India, las respuestas de cdui con precios tuvieron un tamaño de transferencia medio de 80 KB, y las respuestas de pdp_client_v1 tuvieron 9 KB. El host cdui evitó el bloqueo en nuestras pruebas, pero su formato de datos sigue el diseño de la página y puede cambiar con cualquier actualización de página.
En nuestras pruebas, cambiar un solo encabezado hizo fallar una configuración que funcionaba, y la respuesta de bloqueo de HUMAN no dio ninguna razón. Cambia una variable a la vez. Antes de confiar en una solución, alterna entre ella y la configuración anterior y ejecuta suficientes llamadas para ver una diferencia clara. Cuando compares huellas digitales TLS con un servicio de eco de huellas, usa JA4 y la huella digital HTTP/2, porque los handshakes estilo Chrome cambian JA3 entre conexiones.
HUMAN también establece sus propias cookies. Cuando verificamos, su documentación de cookies listaba una vida útil de 5.5 minutos para _px3 y 1 año para _pxvid. La misma página decía que estas cookies mantienen una sesión y ayudan a distinguir usuarios reales de bots. Para toda la sesión, usa cada conjunto de cookies con la IP y el cliente que las recibió, o deja que la API Web Unlocker gestione las cookies.
Las llamadas bloqueadas devolvieron HTTP 435 en 2 formatos
Cuando verificamos, la documentación de enforcer de HUMAN listaba 403 y 429 como estados de bloqueo y decía que cada sitio podía personalizar la respuesta. En Target, las llamadas de API bloqueadas devolvían HTTP 435 en su lugar, y la respuesta de bloqueo tenía 2 formatos.
Nuestras llamadas curl no solicitaban JSON y recibieron una página de desafío HTML. Renderizada en un navegador, esa página pedía al visitante presionar y mantener un botón:
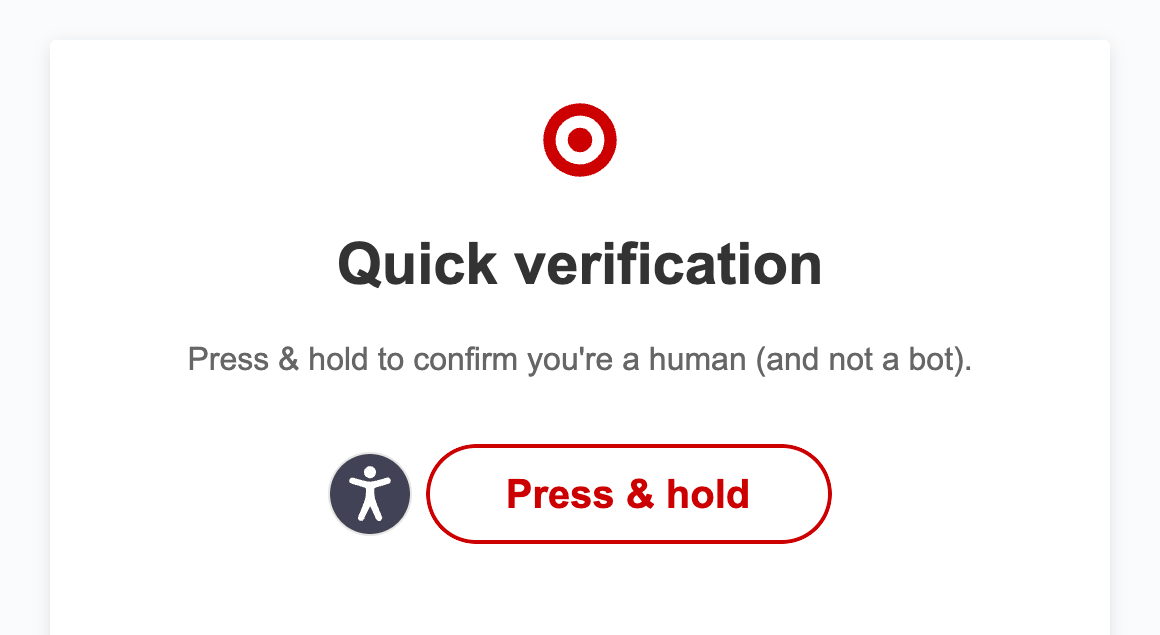
La página de desafío que recibieron nuestras llamadas curl con HTTP 435 en lugar de datos.
Nuestras llamadas requests de Python solicitaban JSON y recibieron un objeto JSON de 343 bytes que comienza con {"appId". Si solo verificas JSON válido, este bloqueo parece datos válidos. Ambos formatos contenían la URL del script de captcha de HUMAN, y ninguna respuesta normal en nuestras muestras la contenía:
def is_human_block(body):
    """HUMAN envía un bloqueo como una página HTML o un pequeño objeto JSON.

    Ambos formatos contienen la URL de su script de captcha. Las páginas
    normales de Target no lo hacen.
    """
    return "captcha.px-" in body
En un conjunto de 21 respuestas de Target, la verificación marcó los 4 bloqueos en ambos formatos y aprobó las 17 normales. Una verificación más simple en la cadena px-captcha habría marcado una página de producto renderizada y pasado por alto el bloqueo JSON.
Los precios diferían por tienda
En 8 tiendas, 12 de los 16 productos que verificamos tenían más de un precio. Target reportó más de 2,000 tiendas. El endpoint nearby_stores_v1 mapea un código postal a los IDs de tienda más cercanos. Para cada uno de 8 códigos postales, recopilamos precios para los 16 productos en la tienda más cercana en una sola ejecución de 2 minutos.
Un subconjunto de 6 productos en 5 de las 8 tiendas muestra las diferencias de precio en dólares estadounidenses. Estas 5 tiendas incluyen el precio más bajo y más alto de cada producto:
| Producto | Nueva York | Chicago | Cedar Rapids | Anchorage | Honolulu |
|---|---|---|---|---|---|
| Leche entera UHT Parmalat, 32 fl oz | 3.89 | 3.49 | 3.59 | 4.49 | 3.89 |
| Cápsulas Tide Original, 31 unidades | 11.19 | 12.69 | 9.99 | 10.59 | 10.59 |
| Cheerios, tamaño familiar 18 oz | 5.99 | 5.69 | 5.29 | 6.79 | 5.69 |
| Market Pantry Classic Roast, 25.9 oz | 14.69 | 14.19 | 12.89 | 16.99 | 17.59 |
| Starbucks Fall Blend, 10 oz | 14.39 | 13.59 | 12.79 | 14.29 | 13.59 |
| LEGO Creator Space Shuttle 31134 | 7.99 | 7.99 | 7.99 | 7.99 | 7.99 |
El café Market Pantry tuvo el rango más amplio: $17.59 en Honolulu fue 36% más alto que $12.89 en Cedar Rapids. Incluso sin Anchorage y Honolulu, 11 de los 16 productos tenían más de un precio, y las cápsulas Tide variaron más, en un 27%.
Los precios también pueden cambiar en un mismo día. Entre 2 de nuestras ejecuciones el mismo día, la tienda de Chicago bajó el precio de la leche de $3.49 a $2.97, y pdp_client_v1 lo etiquetó como sale. Establece la frecuencia de actualización según la frecuencia con que cambian los precios en tus categorías. Mantén el tipo de precio, como oferta o regular, con cada fila.
Los 4 productos con el mismo precio en todas las tiendas fueron 2 sets LEGO y 2 modelos de AirPods. Para los 4, la API devolvió un precio de la ubicación 3991, cualquiera que fuera la tienda que solicitáramos. La ubicación 3991 marca un precio online, no un precio de tienda.
Pasar 3991 como ID de tienda devolvió 206 con "Parameter store_id cannot be digital store 3991." en el array errors. Para nuestra conexión en India, la página de producto de Target también estableció la tienda en 3991 y el código postal en 52404.
Puedes usar la ubicación 3991 para ahorrar solicitudes. Primero, solicita cada producto en 2 tiendas. Si ambas respuestas muestran la ubicación 3991, recopila el producto una vez por actualización en lugar de una vez por tienda. Para 4 de nuestros 16 productos de prueba, esta regla redujo las solicitudes de 8 a 1 por actualización.
Para recopilar precios de tienda, envía la solicitud de producto con un ID de tienda a través de la API Web Unlocker. La Target Scraper API devuelve precios para el código postal que envíes.
Los productos padre devolvieron rangos de precio
Target lista cada variante, como un tamaño de paquete, como un TCIN hijo bajo un producto padre. Los resultados de búsqueda devolvieron el TCIN hijo, pero el endpoint de producto devolvió el padre. Las cápsulas Tide TCIN 87767249 devolvieron el padre 79394303 con el precio "$11.19 - $30.99", y su array children listaba los paquetes de 31, 42, 76 y 112. Si un scraper guarda solo el precio de nivel superior, registra un rango o su valor más bajo para un producto que tiene 4 precios.
El rango también puede ocultar diferencias entre tiendas. A nivel de padre, los Pampers Swaddlers mostraron "$9.99 - $59.99" en las 8 tiendas en una ejecución anterior. A nivel de variante, el paquete de talla 1 de 164 unidades costaba $47.99 en Nueva York y $44.99 en las otras 7 tiendas.
Una solicitud devuelve cada variante de la familia en la tienda solicitada. Si envías 1 TCIN por familia, pagas por 1 solicitud por familia en cada tienda.
La búsqueda se detuvo en un offset de 1,199
El endpoint de búsqueda rechazó cualquier count superior a 28 con "Parameter 'count' cannot be requested with more than 28". También rechazó cualquier offset superior a 1,199, así que 1 consulta podía devolver unos 1,227 resultados. Una búsqueda de “shirts” reportó 131,690 resultados en nuestra prueba, así que una sola palabra clave podía devolver cerca del 1% de ellos.
Cuando verificamos, el robots.txt de www.target.com no permitía páginas de búsqueda para ningún user agent y listaba 6 índices de sitemap. El índice de sitemap de productos apuntaba a 110 archivos, que listaban 2,504,600 URLs de productos cuando los descargamos. Descubre productos desde sitemaps y páginas de categoría, y usa la API de búsqueda para consultas ocasionales como la resolución de UPC a TCIN. Con el UPC como palabra clave, ambos UPCs que probamos devolvieron exactamente 1 producto con su TCIN.
Algunos códigos de estado eran engañosos
Target devuelve 3 tipos de respuestas que necesitan su propio manejo, y 2 de ellas tienen un código de estado engañoso:
| Respuesta | Qué significaba | Qué hacer |
|---|---|---|
206 con un array errors |
Parte de la consulta falló, y los datos del producto seguían presentes | Parsea los datos, registra el error |
404 con "No product found with tcin" |
El producto ya no existe | Marca la URL como muerta, omite reintentos |
435 con un cuerpo HTML o JSON |
Un bloqueo de HUMAN | Detéctalo desde el cuerpo, pausa ese cliente y espera antes de reintentar |
Los productos eliminados pueden aparecer en cualquier lista de entrada, así que planifica para ellos. Un producto en nuestra lista de prueba devolvió "No product found with tcin 1002219928".
El stock tenía 3 canales por tienda
En nuestras pruebas, el endpoint product_fulfillment_v1 reportaba envío, recogida en tienda y disponibilidad en tienda por separado y daba una cantidad por tienda. Esta solicitud reutiliza KEY y REDSKY de la solicitud de API de producto anterior y verifica la leche en la tienda Chelsea:
Q="key=$KEY&tcin=15078349&store_id=3412"
Q="$Q&channel=WEB&page=%2Fp%2FA-15078349"
curl -s "$REDSKY/product_fulfillment_v1?$Q" \
  | jq '.data.product.fulfillment | {
      shipping: .shipping_options.availability_status,
      stores: [.store_options[] | {
        store: .location_id,
        units: .location_available_to_promise_quantity,
        pickup: .order_pickup.availability_status,
        in_store: .in_store_only.availability_status
      }]
    }'
La tienda Chelsea no tenía unidades ni recogida, pero el envío mostraba la leche en stock, y una tienda cercana listaba 6 unidades:
{
  "shipping": "IN_STOCK",
  "stores": [
    {
      "store": "3412",
      "units": 0.0,
      "pickup": "UNAVAILABLE",
      "in_store": "OUT_OF_STOCK"
    },
    {
      "store": "1886",
      "units": 6.0,
      "pickup": "IN_STOCK",
      "in_store": "IN_STOCK"
    }
  ]
}
En otra solicitud, la tienda de Anchorage listó 2 unidades de la misma leche. Guarda el estado de envío, recogida y en tienda para cada tienda, porque una sola bandera is_available no puede contener 3 valores separados. Para el stock, usa endpoints de lectura como product_fulfillment_v1, que ya devuelven cantidades por tienda, en lugar de solicitudes de carrito. Los ingenieros que hacen ingeniería inversa de APIs minoristas también reportan que los endpoints de escritura están mejor protegidos.
Haz scraping de precios de tienda de Target con la API Web Unlocker
La API Web Unlocker enruta cada solicitud a través de IPs y huellas digitales de navegador que selecciona para cada sitio. También maneja encabezados, cookies, CAPTCHAs y reintentos, y devuelve la respuesta del sitio. Los proveedores de detección de bots actualizan sus verificaciones con frecuencia, y la API Web Unlocker se adapta a esas actualizaciones por ti. Mantienes el control total de tu parser y la lógica de endpoints.
Para empezar, crea una cuenta de Bright Data con una clave de API y una zona de la API Web Unlocker, una configuración nombrada para solicitudes y su facturación. También necesitas Python y la librería requests, y el script se ejecuta en Python 3.13. La API Web Unlocker es de autoservicio y factura solo las solicitudes exitosas. La página de precios de la API Web Unlocker lista las tarifas actuales, y el nivel gratuito incluye 5,000 solicitudes al mes sin necesidad de tarjeta de crédito.
El script lee la clave de API de Target desde su página de inicio y mapea cada código postal a una tienda. Luego obtiene el precio de cada variante y separa las filas válidas de las rechazadas:
"""Recopila precios de Target por tienda a través de la API Web Unlocker de Bright Data.

Uso:
    export BRIGHTDATA_API_KEY=...        # clave de API de la cuenta
    export UNLOCKER_ZONE=web_unlocker    # tu zona de la API Web Unlocker
    python target_store_prices.py 15078349,87767249 10001,99501
"""
import collections
import html
import json
import os
import re
import sys
import time
from concurrent.futures import ThreadPoolExecutor
from datetime import datetime, timezone
from urllib.parse import urlencode

import requests

API_KEY = os.environ["BRIGHTDATA_API_KEY"]
ZONE = os.environ.get("UNLOCKER_ZONE", "web_unlocker")
REDSKY = "https://redsky.target.com/redsky_aggregations/v1/web/"
ONLINE_STORE = "3991"  # la ubicación que la API de Target llama tienda digital


def is_human_block(body):
    """HUMAN envía un bloqueo como una página HTML o un pequeño objeto JSON.

    Ambos formatos contienen la URL de su script de captcha. Las páginas
    normales de Target no lo hacen.
    """
    return "captcha.px-" in body


def unlock(url, attempts=3):
    """Obtiene una URL a través de la API Web Unlocker y devuelve la respuesta de Target."""
    status = None
    for attempt in range(attempts):
        try:
            r = requests.post(
                "https://api.brightdata.com/request",
                headers={"Authorization": f"Bearer {API_KEY}"},
                json={"zone": ZONE, "url": url, "format": "raw"},
                timeout=120,
            )
        except requests.RequestException as error:
            status = type(error).__name__
            time.sleep(2 ** attempt)
            continue
        # La API Web Unlocker reporta el propio resultado de Target en los
        # encabezados x-brd-status-code y x-brd-error.
        status = int(r.headers.get("x-brd-status-code", r.status_code))
        if is_human_block(r.text):
            status = "blocked"  # un bloqueo puede llegar con cualquier código de estado
        elif status in (200, 206):
            return status, r.text
        elif "404" in r.headers.get("x-brd-error", ""):
            return 404, ""  # página de producto muerta: no reintentar
        time.sleep(2 ** attempt)
    return status, ""


def web_api_key():
    """Lee la clave de API web que Target incrusta en sus propias páginas."""
    status, page = unlock("https://www.target.com/")
    keys = re.findall(r'apiKey\\?"\s*:\s*\\?"([0-9a-f]{40})', page)
    if not keys:
        raise RuntimeError(f"no apiKey in the home page (status {status})")
    return collections.Counter(keys).most_common(1)[0][0]


def store_for_zip(key, zip_code):
    """Resuelve un código postal al ID de tienda de Target más cercano."""
    query = urlencode({"key": key, "place": zip_code, "limit": 1,
                       "within": 100, "channel": "WEB", "page": "/s"})
    status, body = unlock(f"{REDSKY}nearby_stores_v1?{query}")
    try:
        store = json.loads(body)["data"]["nearby_stores"]["stores"][0]
    except (ValueError, KeyError, IndexError) as error:
        raise RuntimeError(f"no store for {zip_code} ({status})") from error
    return store["store_id"], store["location_name"]


def price_rows(key, tcin, store_id, zip_code):
    """Devuelve una fila por cada variante vendible (TCIN hijo) en una tienda."""
    query = urlencode({"key": key, "tcin": tcin, "store_id": store_id,
                       "pricing_store_id": store_id,
                       "has_pricing_store_id": "true", "channel": "WEB",
                       "page": f"/p/A-{tcin}"})
    status, body = unlock(f"{REDSKY}pdp_client_v1?{query}")
    error = {"tcin": tcin, "store_id": store_id, "zip": zip_code}
    try:
        product = json.loads(body)["data"]["product"]
    except (ValueError, KeyError, TypeError):
        return [{**error, "error": status or "no_response"}]
    # Un TCIN hijo devuelve su padre. El precio del padre es un rango, así que
    # guarda el precio de cada hijo en su propia fila.
    items = product.get("children") or [product]
    now = datetime.now(timezone.utc).isoformat(timespec="seconds")
    rows = []
    for item in items:
        price = item.get("price", {})
        priced_at = str(price.get("location_id"))
        rows.append({
            "tcin": item["tcin"],
            "parent_tcin": product["tcin"],
            "title": html.unescape(
                item["item"]["product_description"]["title"]),
            "zip": zip_code,
            "store_id": store_id,
            "priced_at": priced_at,
            "scope": "online" if priced_at == ONLINE_STORE else "store",
            "price": price.get("current_retail"),
            "regular_price": price.get("reg_retail"),
            "price_type": price.get("formatted_current_price_type"),
            "collected_at": now,
        })
    return rows


def valid(row):
    """Mantiene filas con un precio de la tienda solicitada o la tienda online."""
    return (isinstance(row.get("price"), (int, float))
            and row["priced_at"] in (str(row["store_id"]), ONLINE_STORE))


if __name__ == "__main__":
    tcins = sys.argv[1].split(",")
    zips = sys.argv[2].split(",")
    key = web_api_key()
    stores = {z: store_for_zip(key, z) for z in zips}
    jobs = [(t, stores[z][0], z) for t in tcins for z in zips]
    with ThreadPoolExecutor(max_workers=8) as pool:
        results = list(pool.map(lambda job: price_rows(key, *job), jobs))
    # Los TCINs de una familia devuelven las mismas filas. Mantén una fila por
    # variante y tienda, y nunca dejes que un error reemplace una fila con precio.
    unique = {}
    for row in (r for batch in results for r in batch):
        slot = (row["tcin"], row["store_id"])
        if slot not in unique or "error" in unique[slot]:
            unique[slot] = row
    good = [r for r in unique.values() if valid(r)]
    bad = [r for r in unique.values() if not valid(r)]
    # Añade, así cada ejecución suma al historial de precios.
    for name, batch in (("target_prices", good), ("target_rejects", bad)):
        with open(f"{name}.jsonl", "a") as out:
            out.writelines(json.dumps(row) + "\n" for row in batch)
    print(f"{len(good)} válidas, {len(bad)} rechazadas, tiendas: {stores}")
Con 2 TCINs de entrada en 2 códigos postales, el script produjo 12 filas, porque cada solicitud devolvió toda la familia de variantes:
12 válidas, 0 rechazadas, tiendas: {'10001': ('3412', 'Chelsea 23rd and 8th'), '99501': ('2371', 'Anchorage NE')}Las primeras filas de target_prices.jsonl muestran la familia de leche en la tienda Chelsea:
{"tcin": "15078348", "parent_tcin": "94758333", "title": "Parmalat UHT 2% Reduced Fat Milk - 32 fl oz", "zip": "10001", "store_id": "3412", "priced_at": "3412", "scope": "store", "price": 3.89, "regular_price": 3.89, "price_type": "reg", "collected_at": "2026-09-27T05:34:07+00:00"}
{"tcin": "15078349", "parent_tcin": "94758333", "title": "Parmalat UHT Whole Milk - 32 fl oz", "zip": "10001", "store_id": "3412", "priced_at": "3412", "scope": "store", "price": 3.89, "regular_price": 3.89, "price_type": "reg", "collected_at": "2026-09-27T05:34:07+00:00"}
La ejecución que produjo la tabla de precios incluyó 128 pares de producto y tienda, 16 productos en 8 tiendas, y escribió 800 filas sin rechazos. Este script repitió la ejecución al día siguiente en 97 segundos con 8 workers, y los 800 precios coincidieron con la primera ejecución. El script también mantiene un archivo target_rejects.jsonl para cualquier par que necesite un reintento.
La API Web Unlocker reporta el propio resultado de Target en los encabezados x-brd-status-code y x-brd-error, así que el script lee ambos. Para un producto eliminado, x-brd-error muestra el 404 de Target, y el script lo registra sin reintentar.
Cada decisión de diseño maneja un fallo que puede ocurrir en un scraper de Target:
- Clave de la página: el scraper sigue funcionando después de una rotación de clave, siempre que la página siga incrustando la clave como
apiKey. - Una fila por hijo: tu tabla nunca almacena un rango de padre.
- Columna
scope: un precio online está etiquetado comoonline, así no puede confundirse con un precio de tienda. - Verificación de bloqueo: un bloqueo de HUMAN en HTML o JSON se registra como
blocked, sea cual sea el código de estado. - Sin sobrescrituras: un error de una variante nunca reemplaza la fila de otra variante que tiene precio.
- Archivo de rechazos: las filas sin un precio de tienda válido o precio online se guardan para un pase de reintento, y los productos eliminados mantienen su
404.
El código depende de pdp_client_v1 y nearby_stores_v1, así que envía una solicitud canario diaria a ambos y alerta cuando cambie el esquema de respuesta. Nuestra guía sobre reintentar solicitudes fallidas en Python explica el backoff con más profundidad.
Para ejecutar el mismo código en proxies residenciales, envía un requests.get() con proxy en unlock() y trata un 404 simple como un producto eliminado. El resto del script se mantiene igual. Con proxies residenciales, controlas el cliente y el user agent, así que pruébalos a ellos y cada endpoint contra Target antes de escalar.
Recopila productos de Target con la Target Scraper API
La Target Scraper API es el scraper para Target de la Web Scraper API. Envías URLs de productos y códigos postales, y devuelve registros estructurados con campos como precio, variantes, calificaciones, especificaciones y vendedor. Bright Data mantiene el parseo y los endpoints, así que tu código solo normaliza los registros. Bright Data también ofrece un Target Price Scraper, un Target Reviews Scraper, y un Target Image Scraper para tareas más específicas.
La consola muestra los campos de entrada del scraper sobre sus modos síncrono y asíncrono. Los campos son una URL, una bandera all_variations, y un código postal:
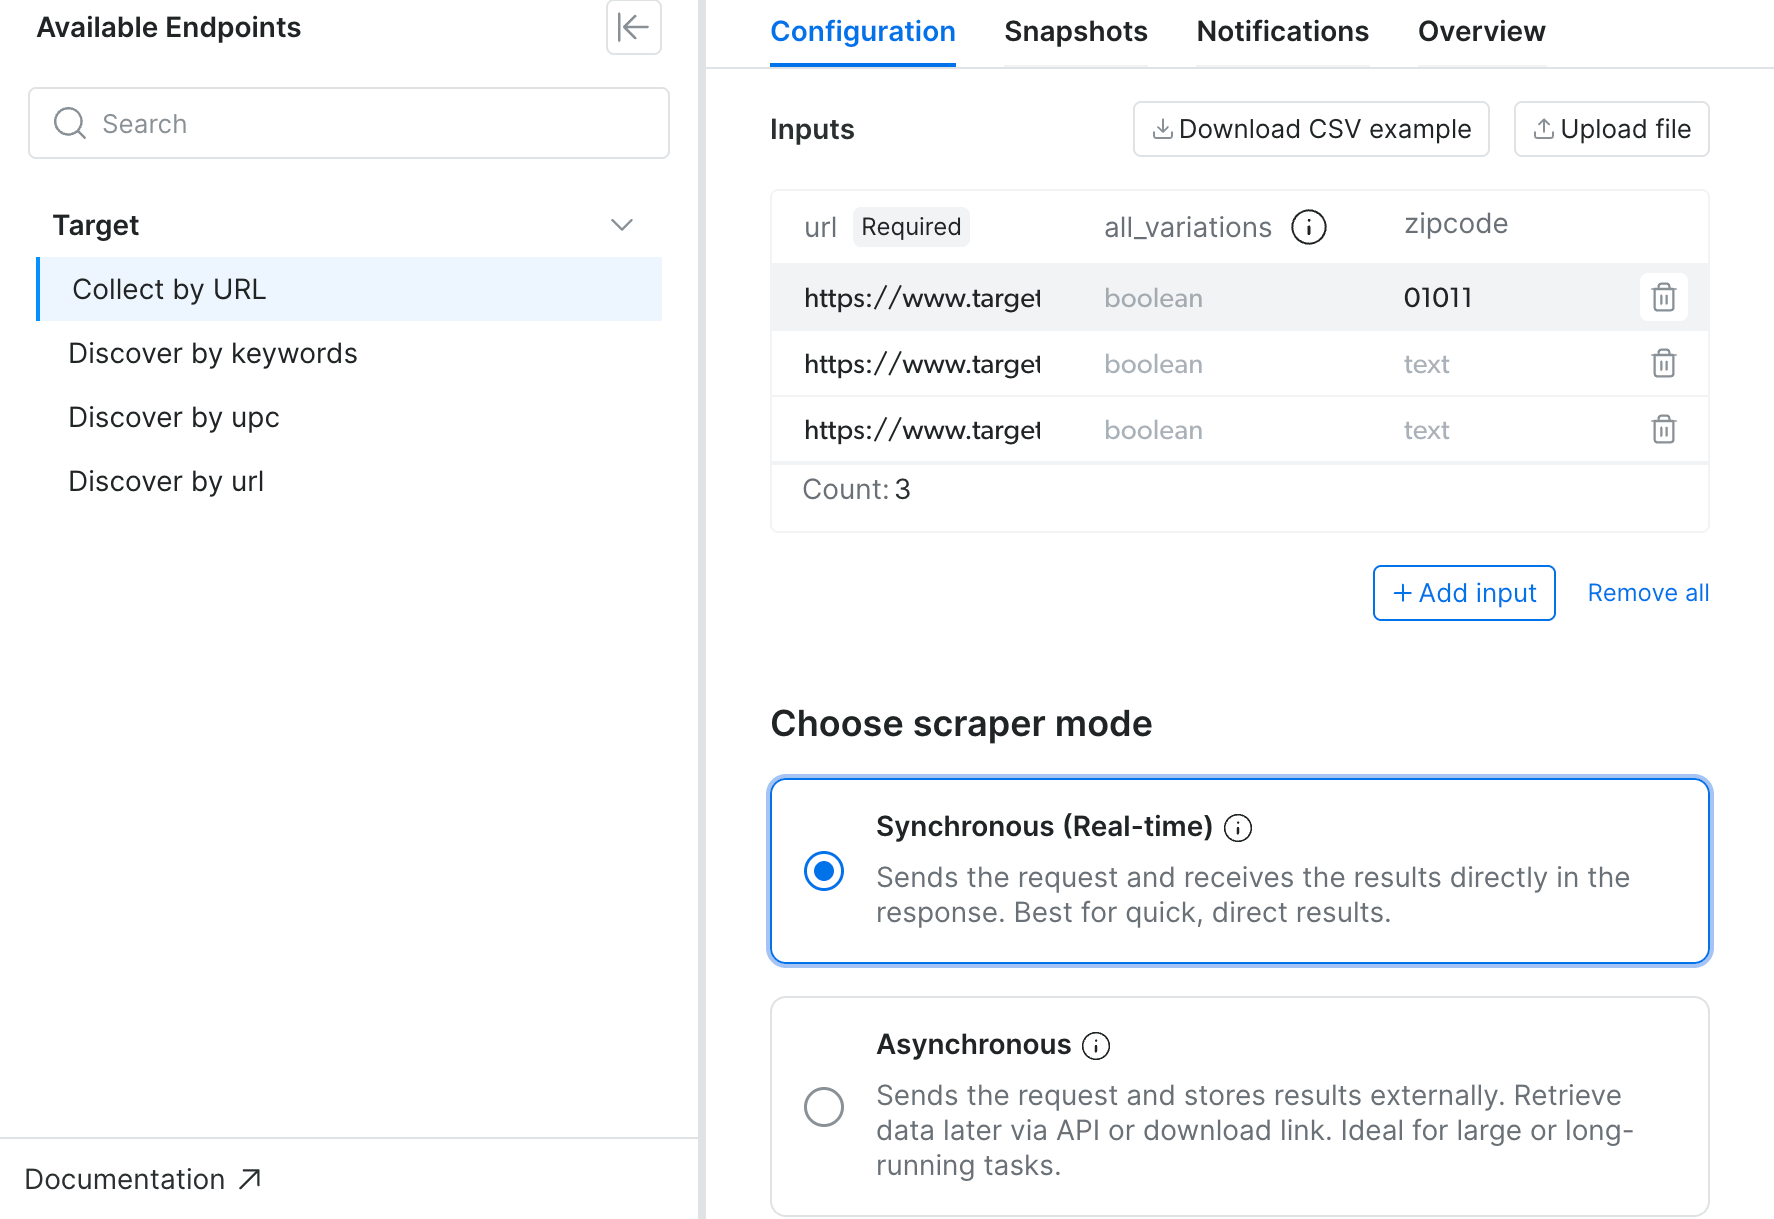
Cada fila de entrada lista un solo producto y puede añadir un código postal, que establece la ubicación para el precio del registro.
La Web Scraper API factura solo por registros entregados. La página de precios de la Web Scraper API lista las tarifas actuales, y el nivel gratuito incluye 5,000 solicitudes al mes sin necesidad de tarjeta de crédito. Para una librería cliente, instala el SDK de Python de Bright Data con pip install brightdata-sdk.
El script de abajo inicia una tarea asíncrona, espera a que termine, descarga los registros y los normaliza:
"""Recopila registros de productos de Target por URL y código postal con la Web Scraper API.

Uso:
    export BRIGHTDATA_API_KEY=...
    python target_scraper_api.py inputs.csv   # columnas: url,zipcode
"""
import csv
import json
import os
import re
import sys
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
DATASET_ID = "gd_ltppk5mx2lp0v1k0vo"  # Scraper de productos de Target
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}


def trigger(inputs):
    """Inicia una recopilación asíncrona y devuelve su ID de snapshot."""
    r = requests.post(
        f"{API}/trigger",
        headers=HEADERS,
        params={"dataset_id": DATASET_ID, "include_errors": "true"},
        json=inputs,
        timeout=60,
    )
    r.raise_for_status()
    return r.json()["snapshot_id"]


def wait(snapshot_id, poll_seconds=15, max_minutes=60):
    """Sondea el snapshot hasta que esté listo y devuelve su registro de progreso."""
    deadline = time.time() + max_minutes * 60
    while time.time() < deadline:
        progress = requests.get(f"{API}/progress/{snapshot_id}",
                                headers=HEADERS, timeout=30).json()
        if progress["status"] in ("ready", "failed"):
            return progress
        time.sleep(poll_seconds)
    raise TimeoutError(snapshot_id)


def download(snapshot_id):
    """Descarga todos los registros, incluidos los registros de error, como una lista."""
    r = requests.get(f"{API}/snapshot/{snapshot_id}",
                     headers=HEADERS, params={"format": "json"}, timeout=300)
    r.raise_for_status()
    return r.json()


def normalize(record):
    """Mapea un registro a una fila plana, o devuelve None para un registro de error."""
    if record.get("error_code"):
        return None
    price = record.get("final_price")
    if price is None and record.get("price_range"):
        # Un registro puede tener su precio en price_range, como "$24.99".
        match = re.fullmatch(r"\$([\d,]+\.\d{2})", record["price_range"])
        price = float(match.group(1).replace(",", "")) if match else None
    origin = record.get("discovery_input") or record.get("input") or {}
    reviewed = bool(record.get("reviews_count"))  # calificación 0 significa sin calificar
    url_tcin = re.search(r"/A-(\d+)", record.get("url") or "")
    return {
        "tcin": url_tcin.group(1) if url_tcin else record.get("tcin_id"),
        "parent_tcin": record.get("group_id"),
        "title": record.get("title"),
        "zipcode": origin.get("zipcode") or None,
        "price": price,
        "initial_price": record.get("initial_price"),
        "available": record.get("is_available"),
        "rating": record.get("rating") if reviewed else None,
        "reviews_count": record.get("reviews_count"),
        "collected_at": record.get("timestamp"),
    }


if __name__ == "__main__":
    with open(sys.argv[1], newline="") as f:
        inputs = [{"url": row["url"], "zipcode": row["zipcode"]}
                  for row in csv.DictReader(f)]
    snapshot_id = trigger(inputs)
    progress = wait(snapshot_id)
    records = download(snapshot_id)
    rows = [row for row in map(normalize, records) if row]
    with open("target_records.jsonl", "w") as out:
        out.writelines(json.dumps(row) + "\n" for row in rows)
    print(f"snapshot {snapshot_id}: {len(rows)} filas, "
          f"errores: {progress.get('error_codes', {})}")
El archivo de entrada tiene la leche en 2 códigos postales, más un set LEGO con precio nacional y un paquete Tide de 112 unidades, ambos en Anchorage. La última fila es un producto que Target ha eliminado:
url,zipcode
https://www.target.com/p/-/A-15078349,10001
https://www.target.com/p/-/A-15078349,60601
https://www.target.com/p/-/A-86216189,99501
https://www.target.com/p/-/A-84114518,99501
https://www.target.com/p/petal-and-pup-skarlett-top/-/A-1002219928,10001
La tarea devolvió 4 registros y marcó el producto eliminado como dead_page:
snapshot sd_muifuppi1d0g830zfd: 4 filas, errores: {'dead_page': 1}Los 4 precios coincidieron con nuestro scraper. El café Market Pantry y el paquete Tide de 31 unidades variaron en precio según la ubicación. Los comparamos con nuestro scraper en los 8 códigos postales, al mismo tiempo:
| Producto | Pares de producto y código postal | Precios distintos | Coincidió con nuestro scraper |
|---|---|---|---|
| Market Pantry Classic Roast, 25.9 oz | 8 | 7 | 8 de 8 |
| Cápsulas Tide Original, 31 unidades | 8 | 5 | 8 de 8 |
| Leche, set LEGO y Tide 112 unidades (archivo de entrada anterior) | 4 | No aplicable | 4 de 4 |
Los 20 pares de producto y código postal coincidieron con el precio de nuestro scraper en la tienda más cercana. Un día después, una repetición del archivo de entrada devolvió el nuevo precio de oferta de $2.97 de Chicago, que nuestro scraper confirmó.
Cada registro incluye el código postal usado para su precio y una bandera de disponibilidad para ese código postal. El normalizador mapea estos campos:
- ID del padre:
group_idtiene el TCIN del padre. - Origen:
inputtiene la URL y el código postal de un registro recopilado.discovery_inputtiene la palabra clave o URL de categoría, y cualquier código postal, cuando la Target Scraper API encontró el producto por sí misma. - Precio: el normalizador toma el precio de
final_priceoprice_range. - Productos sin calificar: una
ratingde 0 con 0 reseñas significa que el producto no tiene calificación.
Elige el modo síncrono o asíncrono
El endpoint síncrono /scrape devuelve resultados en la respuesta para tareas rápidas y devuelve un snapshot_id para sondear en tareas más largas. La documentación de solicitudes síncronas da el límite de tiempo actual. Usa /trigger para lotes programados. Sondeas un snapshot_id de cualquiera de los dos endpoints de la misma manera.
Para tareas recurrentes, configura la API para entregar los resultados. Las opciones de entrega incluyen webhooks y almacenamiento en la nube como Amazon S3, Google Cloud Storage y Microsoft Azure. En /scrape, establece limit_per_input en el cuerpo de la solicitud para limitar los registros por entrada, como muestra la documentación.
Descubre productos por palabra clave o categoría
La Target Scraper API también puede encontrar productos por ti:
- Palabra clave: “dog treats” y “shirts” con
limit_per_inputestablecido en 20 devolvieron 40 registros sin errores. - URL de categoría: 2 páginas de categoría, cada una con un código postal, devolvieron 40 registros.
El normalizador de arriba ya lee discovery_input, así que el mismo código procesa los registros descubiertos.
Usa la Browser API para sesiones y depuración
La Browser API ejecuta un Chrome remoto que controlas con Playwright o Puppeteer a través del Chrome DevTools Protocol (CDP), o con Selenium a través de WebDriver. En Target, cargaba la página de producto como una sesión completa de navegador, incluyendo el script de HUMAN. Como carga la página completa, la Browser API funciona bien para capturar el tráfico de red después de que Target cambia su frontend.
El Bright Data MCP Server ofrece herramientas a agentes de IA a través del Model Context Protocol (MCP). Sus herramientas de navegador dan a los agentes el mismo navegador remoto para flujos de trabajo que hacen clic o escriben en una página.
La Browser API factura por GB, como muestra la página de precios de la Browser API. Bloquear imágenes y rastreadores ayuda a mantener pequeña cada sesión. Una vez que una captura muestra las solicitudes que necesitas, la API Web Unlocker puede enviarlas directamente, sin cargar la página.
Sin una cookie de ubicación almacenada, Target asignó a cada una de nuestras sesiones de navegador en EE. UU. una tienda cerca de la IP de salida. El comando Proxy.setLocation de la Browser API, enviado a través de CDP, selecciona una IP de salida cerca de las coordenadas que elijas. Para ejecutar el script, instala playwright y establece la cadena de conexión de una zona de la Browser API en la variable de entorno BROWSER_API_WSS, como muestra la guía rápida de la Browser API:
import asyncio
import os

from playwright.async_api import async_playwright

# wss://brd-customer-<id>-zone-<zone>:<password>@brd.superproxy.io:9222
WSS = os.environ["BROWSER_API_WSS"]


async def main():
    async with async_playwright() as pw:
        browser = await pw.chromium.connect_over_cdp(WSS)
        page = await browser.contexts[0].new_page()
        cdp = await page.context.new_cdp_session(page)
        # Sale cerca de Manhattan, así Target geolocaliza la sesión allí.
        await cdp.send("Proxy.setLocation", {
            "lat": 40.7506, "lon": -73.9972, "distance": 10, "strict": True,
        })
        await page.goto("https://www.target.com/p/-/A-15078349",
                        wait_until="domcontentloaded", timeout=120_000)
        # La página renderiza el precio dos veces, y una copia permanece oculta.
        price = page.locator('[data-test="product-price"]').first
        await price.wait_for(state="attached", timeout=60_000)
        cookies = await page.context.cookies("https://www.target.com")
        store = {c["name"]: c["value"] for c in cookies}.get("fiatsCookie")
        print(store, await price.text_content())
        await browser.close()

asyncio.run(main())
En 3 ejecuciones con las mismas coordenadas, Target asignó 3 tiendas diferentes de Nueva York cerca de esas coordenadas. El valor de fiatsCookie listaba el ID de tienda (DSI), nombre (DSN), y código postal (DSZ):
DSI_2475|DSN_Bronx%20Terminal|DSZ_10451 $3.59
DSI_3284|DSN_Lower%20East%20Side%20Grand%20and%20Clinton|DSZ_10002 $3.99
DSI_3394|DSN_Upper%20West%20Side%2098th%20and%20Columbus|DSZ_10025 $3.99
Como cada sesión obtuvo una tienda cercana, esta configuración es útil para muestrear precios en un área metropolitana.
Compra el Target Dataset para relleno de catálogo
El Target Dataset ofrece registros de productos de Target ya recopilados que puedes filtrar y comprar sin ejecutar un scraper. Funciona bien para un relleno de catálogo que necesita muchas filas a la vez.
La página del dataset lista el conteo actual de registros, campos y precios. En el Dataset Marketplace, puedes filtrar registros y previsualizar una muestra antes de comprar:
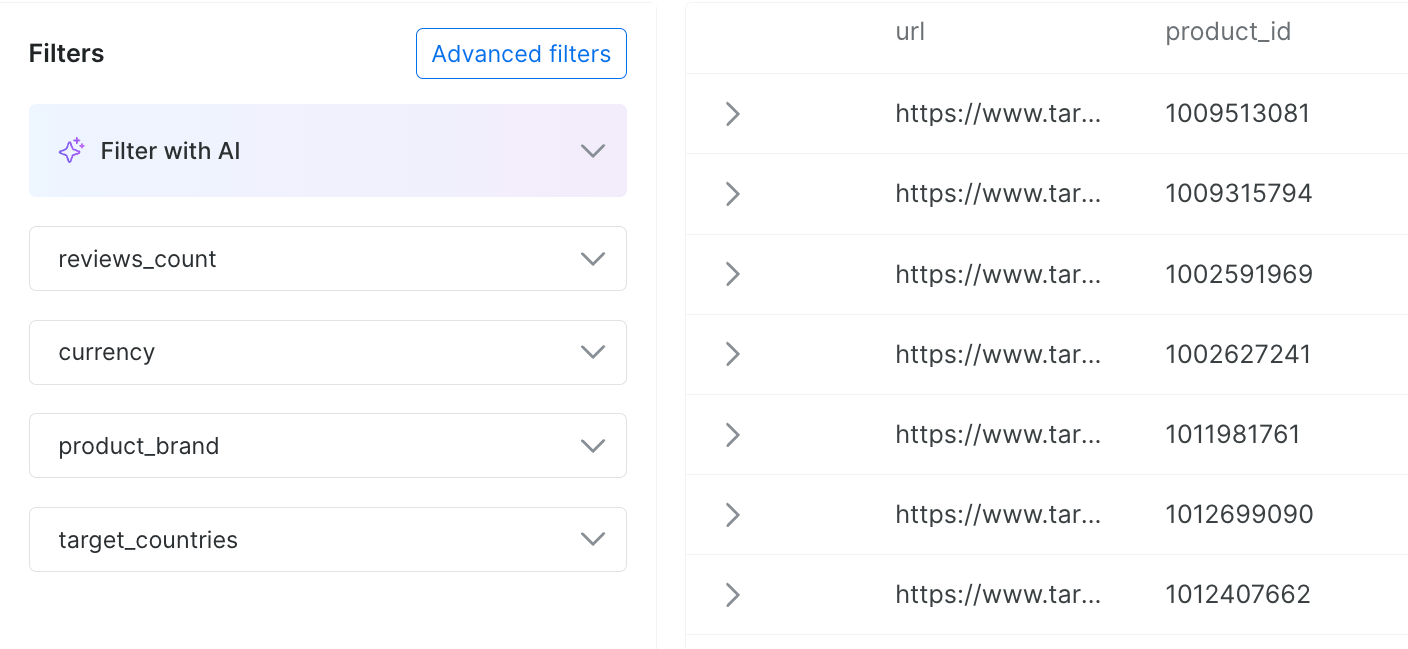
Los filtros de campo del dataset de Target y una muestra de sus registros.
Antes de cargar, mapea los registros a tu propio esquema:
- IDs de producto: usa el TCIN en la URL de cada registro como la clave de tu tabla, el mismo ID que usan los scrapers anteriores.
- Calificaciones: una
ratingde 0 con 0 reseñas significa que el producto aún no tiene calificación.
Elige el enfoque según ubicación, volumen y frecuencia de actualización
Las opciones con más control necesitan más mantenimiento, que crece con la frecuencia con que Target cambia sus páginas y endpoints. Los equipos que quieran dashboards de Target ya listos pueden usar el Target Price Tracker o el Target Inventory Tracker. Para otros minoristas, consulta nuestra guía de scraping web para ecommerce. Cada enfoque factura por su propia unidad, y la página de precios de cada producto lista las tarifas actuales:
| Enfoque | Facturado por | Alcance de 1 llamada o registro | Mejor para |
|---|---|---|---|
| Tu código con la API Web Unlocker | Solicitud exitosa | 1 familia de variantes en 1 ID de tienda | IDs de tienda y stock por canal |
| Tu código con proxies residenciales | GB de tráfico | 1 familia de variantes en 1 ID de tienda, unos 15 KB comprimidos en nuestras pruebas | Bajo costo por llamada, con control total del cliente |
| Target Scraper API | Registro entregado | 1 producto en 1 código postal | Recopilación recurrente con parseo y mantenimiento gestionados por ti |
| Browser API | GB de tráfico | 1 sesión completa de navegador | Sesiones y depuración |
| Target Dataset | Registro | 1 registro de producto ya recopilado | Relleno e investigación de catálogo |
Elige según cómo rastrees ubicaciones. Si rastreas por código postal, la Target Scraper API coincidió con el precio de la tienda más cercana en nuestras pruebas, y Bright Data la mantiene por ti. Si rastreas IDs de tienda y stock por canal, ejecuta tu propio código en la API Web Unlocker o proxies residenciales. Para un relleno, elige el dataset, como explica nuestra comparación de conjuntos de datos y APIs de scraping web.
Antes de elegir, estima el volumen mensual multiplicando productos por tiendas, por actualizaciones al día, y por 30. Rastrear 5K productos en 50 tiendas una vez al día significa 7.5M solicitudes o registros al mes. El stock por canal añade 1 solicitud product_fulfillment_v1 por TCIN y tienda. Multiplica el total por la tarifa por unidad en la página de precios, donde los planes mensuales reducen la tarifa.
Tu propio código puede enviar menos solicitudes que esta estimación, de 2 maneras. De nuestros 16 productos de prueba, 4 tenían el mismo precio en todas las tiendas y necesitaban solo 1 solicitud por actualización. Una solicitud de API de producto también devuelve toda una familia de variantes, así que 128 pares de producto y tienda produjeron 800 filas en nuestra ejecución.
En proxies residenciales, 7.5M llamadas pdp_client_v1 comprimidas con gzip transferirían unos 110 GB. Como señala la página de precios de proxy residencial, la facturación cuenta encabezados y cuerpos, que promediaron 15 KB por llamada para nosotros. Las preguntas frecuentes de facturación explican cómo se mide el tráfico. Solicita respuestas comprimidas, porque los mismos cuerpos de pdp_client_v1 promediaron 134 KB sin compresión y 14 KB con gzip.
La API Web Unlocker maneja el desbloqueo por ti y factura solo las solicitudes exitosas. En nuestra prueba de IP y cliente, pasó todas las llamadas en IPs de salida de EE. UU. sin ajustes de cliente. También puedes usar tanto la API Web Unlocker como proxies residenciales. Envía las solicitudes de cada endpoint a través de la opción que se ajuste a su volumen, y mueve un endpoint a la API Web Unlocker cuando cambie la verificación de bots de Target.
Valida y monitorea la recopilación de Target
Un bloqueo que detecta is_human_block() aparece como un error. Un precio de tienda incorrecto que parece válido aparece como dato, así que ningún error lo marca. Las verificaciones de abajo ayudan a detectar fallos que pueden parecer datos válidos o desperdiciar solicitudes:
| Verificación | Dónde buscar | Detecta |
|---|---|---|
| El precio es un número mayor que cero | price |
Precios faltantes y rangos |
| El precio vino de la tienda que solicitaste, o está etiquetado como online | location_id, scope |
Precios de tienda incorrectos |
| La fila es un TCIN hijo | tcin, children |
Rangos a nivel de padre |
| El cuerpo tiene el esquema JSON esperado y ningún bloqueo de HUMAN | Cuerpo de respuesta | Respuestas de bloqueo HTML y JSON (HTTP 435) |
| El producto todavía existe | 404, dead_page |
URLs muertas reintentadas en cada ejecución |
| El cambio de precio desde la última ejecución está dentro de tu umbral | Historial de precios | Precios mal parseados o incorrectos |
Ejecuta las verificaciones en cada lote, y guarda cada fila con su TCIN, ID de tienda y hora de recopilación, así el historial crece. Cuenta los fallos por razón, como un bloqueo, una tienda incorrecta, un producto eliminado o un tiempo de espera agotado. Una tasa de fallo general puede ocultar un aumento de fallos por una razón, así que alerta cuando la tasa por cualquier razón suba por encima de lo normal. Rastrea también el costo por registro exitoso, así puedes comparar enfoques con la misma medida.
Reflexiones finales
Target muestra sus datos de productos públicamente, pero un precio puede depender de la tienda, la variante y el momento en que lo recopilas. En nuestras pruebas, los precios online de la ubicación 3991, los rangos de precio del padre y las respuestas de bloqueo JSON parecían todos datos válidos. Mantén el ID de tienda, la variante y el estado de la solicitud con cada fila, y ejecuta un canario diario contra cada endpoint del que dependas.
La API Web Unlocker maneja el desbloqueo y tu código controla tiendas y canales, mientras que la Target Scraper API también maneja el parseo y el mantenimiento. Para elegir, ejecuta una muestra de tus productos y códigos postales en ambas a través del nivel gratuito, que incluye 5,000 solicitudes al mes sin necesidad de tarjeta de crédito, y compara los precios.
Preguntas frecuentes
¿Target tiene una API pública de productos?
No, el portal de desarrolladores de Target es solo para empleados de Target, vendedores de Target Plus y socios. El sitio web llama a APIs JSON internas en redsky.target.com con una clave de API de sus páginas, y esos endpoints pueden cambiar sin aviso. La Target Scraper API de Bright Data devuelve registros de productos a partir de una URL y un código postal.
¿Cómo obtienes los precios de productos de Target por tienda?
Llama a la API de productos de Target con un ID de tienda y su clave de API pública para obtener el precio de cada variante en esa tienda. Otro endpoint mapea un código postal al ID de tienda más cercano. Un ID de ubicación 3991 marca el precio online de Target, no un precio de tienda. La Target Scraper API de Bright Data devuelve precios para el código postal que envíes.
¿Puedes rastrear el inventario de Target por tienda?
Sí, en nuestras pruebas, el endpoint product_fulfillment_v1 de Target devolvió un conteo de unidades y el estado de envío, recogida y en tienda para la tienda solicitada. Una tienda de Nueva York tenía 0 unidades y una tienda cercana tenía 6, mientras que el envío mostraba el artículo en stock. Guarda el stock por tienda y por canal.
¿Cuánto cuesta hacer scraping de datos de Target?
El costo crece con el número de productos, tiendas y actualizaciones diarias. Rastrear 5K productos en 50 tiendas diariamente significa 7.5M solicitudes o registros al mes. Bright Data factura los registros de la Web Scraper API en la entrega, las solicitudes de la Web Unlocker API en el éxito, y los proxies residenciales por GB. Cada página de precios lista las tarifas actuales.
¿Cómo haces scraping de productos de Target gratis?
El nivel gratuito de Bright Data incluye 5,000 solicitudes al mes sin necesidad de tarjeta de crédito, y cubre tanto la Target Scraper API como la API Web Unlocker, así puedes probar precios en tus propios productos. Las solicitudes HTTP simples son gratis, pero la verificación de bots de Target bloqueó clientes con configuración predeterminada desde IPs de EE. UU. en nuestras pruebas.