


CALPAK Datasets
Use our CALPAK dataset to access product data from the travel bag and luggage brand, covering carry-on and checked luggage, backpacks, duffels, and travel accessories. Records include product titles, descriptions, brands, categories, prices and sale prices, availability, variants, star ratings, review counts, and reviews. Ideal for travel brands, retailers, and pricing analysts tracking luggage.


Available CALPAK Datasets
 218+
 1+
Confiado por 50,000+ clientes


Precios de Conjuntos de Datos de CALPAK
- Limpios y validados
- Actualizados mensualmente
- JSON/CSV/Parquet
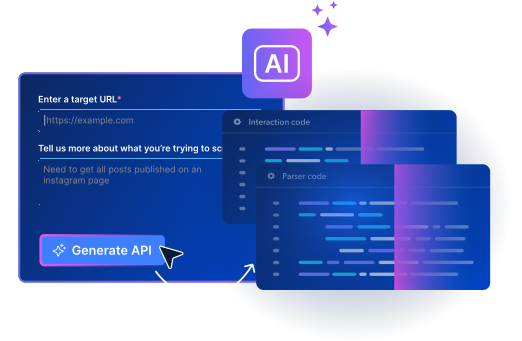
Filtra el conjunto de datos de CALPAK con un solo prompt
Describe exactamente lo que necesitas, y deja que la IA aplique los filtros perfectos en segundos.
- Describe tus necesidades de datos en lenguaje sencillo
- La IA aplica filtros precisos automáticamente
- Reduce enormes conjuntos de datos a solo lo que te importa
- Reduce costos omitiendo datos irrelevantes
- Exporta los datos filtrados en tu formato preferido

Maximiza el valor con ahorros estratégicos

Actualizaciones de datos inteligentes
Accede solo a "Registros Nuevos" o "Registros Actualizados", asegurando que pagues solo por lo que necesitas".

Paquetes de conjuntos de datos
Obtén mayor valor comprando dos o más conjuntos de datos juntos, con descuentos exclusivos.

Descuentos por volumen
Obtén más por menos con importantes ahorros al comprar grandes conjuntos de datos o suscripciones de actualizaciones.

Conjuntos de Datos Enriquecidos
Ahorra tiempo y recursos con conjuntos de datos preconstruidos que combinan múltiples fuentes en un conjunto de datos limpio.
CALPAK dataset sample
The dataset includes product URLs, item IDs, variant IDs, and comprehensive product titles. Each record contains detailed descriptions, product categories, and hierarchical category trees for easy navigation. Additionally, brand information is available for all items to support market analysis and competitive research.
Potencia Agentes de IA al Instante
Nuestros conjuntos de datos de CALPAK están optimizados para IA/LLM: claramente estructurados, bien documentados, con código y recetas para una fácil integración con LLM/chatbot.

Estructurado y Limpio
Datos preprocesados con esquemas consistentes, perfectos para el entrenamiento e inferencia de modelos de IA.

Ejemplos de Código
Fragmentos listos para usar en Python, Node.js, cURL, PHP, Go, Java y Ruby para una fácil integración con flujos de trabajo de IA.

Documentación
                              curl --request GET
--url https://api.brightdata.com/datasets/snapshots/{id}/download
--header 'Authorization: Bearer '
                              import requests
url = "https://api.brightdata.com/datasets/snapshots/{id}/download"
headers = {"Authorization": "Bearer "}
response = requests.get(url, headers=headers)
print(response.json())
                              const url = 'https://api.brightdata.com/datasets/snapshots/{id}/download';
const options = {method: 'GET', headers: {Authorization: 'Bearer '}, body: undefined};

try {
const response = await fetch(url, options);
const data = await response.json();
console.log(data);
} catch (error) {
console.error(error);
}
                              HttpResponse response = Unirest.get("https://api.brightdata.com/datasets/snapshots/{id}/download")
.header("Authorization", "Bearer ")
.asString();
                              require 'uri'
require 'net/http'

url = URI("https://api.brightdata.com/datasets/snapshots/{id}/download")

http = Net::HTTP.new(url.host, url.port)
http.use_ssl = true

request = Net::HTTP::Get.new(url)
request["Authorization"] = 'Bearer '

response = http.request(request)
puts response.read_body
CALPAK datasets tailored to your needs

Suscripción de datos
Suscríbase para acceder a los conjuntos de datos a un coste significativamente reducido.

Formatos de archivo
JSON, NDJSON, JSON Lines, CSV, Parquet. Compresión .gz opcional.

Entrega flexible
Snowflake, Amazon S3 bucket, Google Cloud, Azure y SFTP.

Datos escalables
Amplíe sin preocuparse por la infraestructura, los servidores proxy o los bloqueos.

Ahorro de costes
Personaliza cualquier conjunto de datos mediante filtros y opciones de formato.

Mantenimiento del código
Los conjuntos de datos se actualizan en función de los cambios en la estructura del sitio web.

Integraciones simplificadas
Benefíciese de las integraciones con Snowflake y AWS.

Asistencia 24/7
Un equipo especializado de profesionales de datos está aquí para ayudarte.

Líderes en cumplimiento
Los datos se obtienen de forma ética y cumplen todas las leyes de privacidad.
Get structured and reliable CALPAK data
Te facilitamos los datos mientras tú te centras en lo demás

Datos web de gran volumen
Con nuestras funciones de desbloqueo y de rotación de las direcciones IP las 24 horas del día, garantizamos el acceso a todos los puntos de datos de un sitio web.

Datos para uso inmediato
Todos los aspectos del proceso de recopilación de datos se validan a fondo como parte de nuestro potente proceso de validación de datos.

Flujo de datos automatizado
Crea cronogramas personalizados para automatizar la entrega de datos y comprueba cómo los datos fluyen sin problemas hacia su almacenamiento.
CALPAK dataset use cases
Price benchmarking
Product line analysis
Customer sentiment
Availability monitoring


Preguntas frecuentes sobre el conjunto de datos CALPAK
¿Puedo obtener actualizaciones para mi conjunto de datos CALPAK adquirido?
Sí, puede obtener actualizaciones de su conjunto de datos CALPAK de forma diaria, semanal, mensual o personalizada.
¿Puedo comprar un subconjunto del conjunto de datos CALPAK?
Sí, puede adquirir un subconjunto de CALPAK que incluirá solo los puntos de datos que necesite. Al adquirir un subconjunto, el coste se reduce considerablemente.
¿En qué formato recibiré el conjunto de datos CALPAK?
Los formatos de los conjuntos de datos son JSON, NDJSON, JSON Lines, CSV o Parquet. Opcionalmente, los archivos se pueden comprimir en .gz.
¿Puedo obtener una muestra de datos?
Sí, puede solicitar datos de muestra para evaluar la calidad y la relevancia de la información proporcionada. Es una forma estupenda de asegurarse de que se ajusta a sus necesidades antes de comprometerse con un Conjunto de datos completo.
¿Puedo solicitar puntos de datos específicos del conjunto de datos CALPAK?
Sí, puede solicitar puntos de datos específicos del conjunto de datos CALPAK adaptados a sus necesidades particulares, lo que le garantiza que recibirá exactamente la información que necesita para sus proyectos.
¿Es posible integrar el conjunto de datos CALPAK directamente en mis sistemas existentes?
Por supuesto, el conjunto de datos CALPAK ofrece una integración perfecta con la API, lo que le permite integrar sin esfuerzo los datos en su CRM, herramientas de análisis o cualquier otro sistema que utilice, agilizando sus operaciones.