


Conjuntos de datos de aprendizaje automático
Utilice nuestros conjuntos de datos de aprendizaje automático para mejorar sus algoritmos y descubrir nuevos conocimientos dentro de su sector.


Confiado por 50,000+ clientes


Conjuntos de datos preconstruidos populares
Garantice un acceso sin complicaciones a los datos utilizando Conjuntos de datos ya preparados.
- Datos de demostración en JSON/CSV
- Registros nuevos
- Personalice, enriquezca y formatee los datos.
 79.4K+

Precios de Conjuntos de Datos de Aprendizaje automático
- Limpios y validados
- Actualizados mensualmente
- JSON/CSV/Parquet
Filtra el conjunto de datos de Aprendizaje automático con un solo prompt
Describe exactamente lo que necesitas, y deja que la IA aplique los filtros perfectos en segundos.
- Describe tus necesidades de datos en lenguaje sencillo
- La IA aplica filtros precisos automáticamente
- Reduce enormes conjuntos de datos a solo lo que te importa
- Reduce costos omitiendo datos irrelevantes
- Exporta los datos filtrados en tu formato preferido


Maximiza el valor con ahorros estratégicos

Actualizaciones de datos inteligentes
Accede solo a "Registros Nuevos" o "Registros Actualizados", asegurando que pagues solo por lo que necesitas".

Paquetes de conjuntos de datos
Obtén mayor valor comprando dos o más conjuntos de datos juntos, con descuentos exclusivos.

Descuentos por volumen
Obtén más por menos con importantes ahorros al comprar grandes conjuntos de datos o suscripciones de actualizaciones.

Conjuntos de Datos Enriquecidos
Ahorra tiempo y recursos con conjuntos de datos preconstruidos que combinan múltiples fuentes en un conjunto de datos limpio.
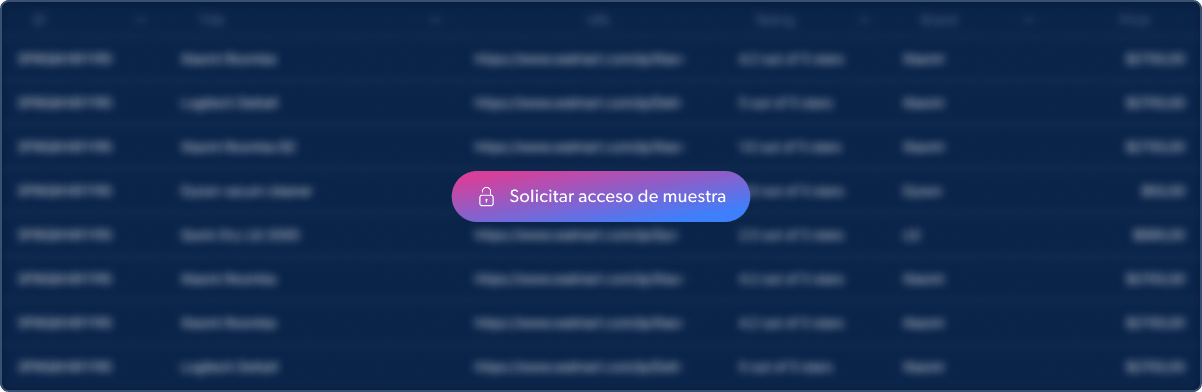
Dataset sample
Los conjuntos de datos de aprendizaje automático se pueden crear combinando diversas fuentes y sitios web, incluidos los que ya tenemos y los personalizados. Los puntos de datos pueden incluir detalles del producto, información sobre precios, datos de la empresa, tallas disponibles, opciones de color, artículos y otra información disponible públicamente.
Potencia Agentes de IA al Instante
Nuestros conjuntos de datos de Aprendizaje automático están optimizados para IA/LLM: claramente estructurados, bien documentados, con código y recetas para una fácil integración con LLM/chatbot.

Estructurado y Limpio
Datos preprocesados con esquemas consistentes, perfectos para el entrenamiento e inferencia de modelos de IA.

Ejemplos de Código
Fragmentos listos para usar en Python, Node.js, cURL, PHP, Go, Java y Ruby para una fácil integración con flujos de trabajo de IA.

Documentación
                              curl --request GET
--url https://api.brightdata.com/datasets/snapshots/{id}/download
--header 'Authorization: Bearer '
                              import requests
url = "https://api.brightdata.com/datasets/snapshots/{id}/download"
headers = {"Authorization": "Bearer "}
response = requests.get(url, headers=headers)
print(response.json())
                              const url = 'https://api.brightdata.com/datasets/snapshots/{id}/download';
const options = {method: 'GET', headers: {Authorization: 'Bearer '}, body: undefined};

try {
const response = await fetch(url, options);
const data = await response.json();
console.log(data);
} catch (error) {
console.error(error);
}
                              HttpResponse response = Unirest.get("https://api.brightdata.com/datasets/snapshots/{id}/download")
.header("Authorization", "Bearer ")
.asString();
                              require 'uri'
require 'net/http'

url = URI("https://api.brightdata.com/datasets/snapshots/{id}/download")

http = Net::HTTP.new(url.host, url.port)
http.use_ssl = true

request = Net::HTTP::Get.new(url)
request["Authorization"] = 'Bearer '

response = http.request(request)
puts response.read_body
Conjuntos de datos de aprendizaje automático adaptados a sus necesidades

Suscripción de datos
Suscríbase para acceder a los conjuntos de datos a un coste significativamente reducido.

Formatos de archivo
JSON, NDJSON, JSON Lines, CSV, Parquet. Compresión .gz opcional.

Entrega flexible
Snowflake, Amazon S3 bucket, Google Cloud, Azure y SFTP.

Datos escalables
Amplíe sin preocuparse por la infraestructura, los servidores proxy o los bloqueos.

Ahorro de costes
Personaliza cualquier conjunto de datos mediante filtros y opciones de formato.

Mantenimiento del código
Los conjuntos de datos se actualizan en función de los cambios en la estructura del sitio web.

Integraciones simplificadas
Benefíciese de las integraciones con Snowflake y AWS.

Asistencia 24/7
Un equipo especializado de profesionales de datos está aquí para ayudarte.

Líderes en cumplimiento
Los datos se obtienen de forma ética y cumplen todas las leyes de privacidad.
Obtenga datos de aprendizaje automático estructurados y fiables.
Nosotros proporcionamos los datos mientras tú te enfocas en lo demás
Datos web de alto volumen
Con nuestras capacidades de desbloqueo y rotación de IP las 24 horas, garantizamos acceso a todos los puntos de datos de un sitio web.
Datos listos para usar de inmediato
Cada aspecto del proceso de recopilación de datos se valida minuciosamente como parte de nuestro riguroso proceso de validación de datos.
Flujo de datos automatizado
Crea horarios personalizados para automatizar la entrega de datos y observa cómo fluyen sin interrupciones hacia tu almacenamiento.
Cómo utilizan las empresas los Conjuntos de datos de aprendizaje automático
Entrenamiento y validación de modelos

Evaluación comparativa de algoritmos

Ingeniería de características

Obtenga datos para el aprendizaje automático hoy mismo.
Preguntas frecuentes sobre conjuntos de datos de aprendizaje automático
¿Qué datos se incluyen en el conjunto de datos de aprendizaje automático?
Crearemos un conjunto de datos de aprendizaje automático personalizado que se adapte a sus requisitos específicos. Este conjunto de datos se puede crear combinando varias fuentes y sitios web, incluidos los que ya tenemos y los personalizados. Los puntos de datos pueden incluir detalles del producto, información sobre precios, tamaños disponibles, opciones de color, artículos y otra información disponible públicamente.
¿Puedo obtener actualizaciones para el conjunto de datos de aprendizaje automático que he comprado?
Sí, puede obtener actualizaciones de su conjunto de datos de aprendizaje automático de forma diaria, semanal, mensual o personalizada.
¿Puedo comprar un subconjunto del conjunto de datos de aprendizaje automático?
Sí, puede adquirir un subconjunto de aprendizaje automático que incluya solo los puntos de datos que necesite. Al adquirir un subconjunto, el coste se reduce considerablemente.
¿En qué formato recibiré el conjunto de datos de aprendizaje automático?
Puede elegir uno de los siguientes formatos: JSON, ndJSON, CSV o XLSX.
¿Puedo extraer datos públicos de aprendizaje automático por mi cuenta?
Si no desea comprar un conjunto de datos, puede empezar a extraer datos para el aprendizaje automático utilizando nuestras API de Scraping web.
¿Puedo obtener una muestra de datos?
Sí, puede solicitar datos de muestra para evaluar la calidad y la relevancia de la información proporcionada. Es una forma estupenda de asegurarse de que se ajusta a sus necesidades antes de comprometerse con un Conjunto de datos completo.
¿Puedo solicitar puntos de datos específicos del conjunto de datos de aprendizaje automático?
Sí, puede solicitar puntos de datos específicos del conjunto de datos de aprendizaje automático adaptados a sus necesidades particulares, lo que le garantiza que recibirá exactamente la información que necesita para sus proyectos.
¿Es posible integrar el conjunto de datos de aprendizaje automático directamente en mis sistemas existentes?
Por supuesto, el conjunto de datos de aprendizaje automático ofrece una integración perfecta con la API, lo que le permite integrar sin esfuerzo los datos en su CRM, herramientas de análisis o cualquier otro sistema que utilice, agilizando así sus operaciones.
¿Cómo pueden ayudarme los Conjuntos de datos de aprendizaje automático?
Utilice nuestros conjuntos de datos de aprendizaje automático para desarrollar y validar sus modelos. Nuestros conjuntos de datos están diseñados para admitir una variedad de aplicaciones de aprendizaje automático, desde el reconocimiento de imágenes hasta el procesamiento del lenguaje natural y los sistemas de recomendación. Puede acceder a un conjunto de datos completo o adaptar un subconjunto para que se ajuste a sus requisitos específicos, utilizando datos de una combinación de diversas fuentes y sitios web, incluidos los personalizados.
Entre los casos de uso más populares se incluyen el entrenamiento y la validación de modelos, donde el conjunto de datos se puede utilizar para garantizar un rendimiento sólido en diferentes aplicaciones. Además, los Conjuntos de datos ayudan en la evaluación comparativa de algoritmos, ya que proporcionan datos exhaustivos para probar y comparar diversos algoritmos de aprendizaje automático, identificando los más eficaces para tareas como la detección de fraudes, el análisis de opiniones y el mantenimiento predictivo. Además, son compatibles con la ingeniería de características, ya que le permiten descubrir atributos de datos significativos, lo que mejora la precisión predictiva de sus modelos de aprendizaje automático para aplicaciones como la segmentación de clientes, el marketing personalizado y las previsiones financieras.