


Threads Crawler
Rastrea Threads a gran escala en publicaciones y perfiles. Recopila datos públicos como URL de la publicación, ID de la publicación, contenido, fecha de publicación, nombre de usuario del autor, URL del perfil del autor, número de seguidores, número de respuestas, número de reposts, me gusta, publicaciones citadas, medios adjuntos, y mucho más.

- Scrape a demanda a través de API o scraper sin código
- Gerente de cuenta dedicado
- Gestión de solicitudes masivas, hasta 5K URLs
- Recuperar resultados en múltiples formatos
Confiado por 50,000+ clientes


Crawlers de Threads disponibles
 383+
 14+
¿Solo quieres datos de Threads? Olvídate del rastreo.
Compra un conjunto de datos de Threads
Precios del Crawler de Threads
Paga solo por lo que se entrega con éxito. Sin tarifas ocultas, sin cargos por entregas fallidas.

- Paga solo por el éxito, sin tarifas ocultas
- Comienza gratis con 5,000 créditos mensuales
- Sin compromiso inicial, cancela cuando quieras
- Soporte experto 24/7 y funciones empresariales

EJEMPLOS DE CÓDIGO
Rastrea fácilmente datos de Threads sin preocuparte por bloqueos.
curl -H "Authorization: Bearer API_TOKEN" -H "Content-Type: application/json" -d '[{"url":"https://www.threads.com/@dividendology_yt/post/DML_enxRaOq?hl=en"},{"url":"https://www.threads.com/@sanantoniozoo/post/DMLlEMux-wk?hl=en"}]' "https://api.brightdata.com/datasets/v3/trigger?dataset_id=gd_md75myxy14rihbjksa&format=json&uncompressed_webhook=true"[
{
"timestamp": "2026-10-22",
"post_id": "DewYeislPSJ",
"url": "https:\/\/www.threads.com\/@itsmenanaali\/post\/DewYeislPSJ",
"post_time": "2026-10-21T12:13:57.000Z",
"profile_name": "itsmenanaali",
"profile_url": "https:\/\/www.threads.com\/@itsmenanaali",
"post_content": null,
"number_of_likes": 0
},
{
"timestamp": "2026-10-22",
"post_id": "DexZ5RunNBP",
"url": "https:\/\/www.threads.com\/@repdeluzio\/post\/DexZ5RunNBP",
"post_time": "2026-10-21T21:45:35.000Z",
"profile_name": "repdeluzio",
"profile_url": "https:\/\/www.threads.com\/@repdeluzio",
"post_content": "The Iran War has cost the average American family more than $2,000. \n\nWe are ALL paying for this reckless war that Trump...",
"number_of_likes": 16
},
{
"timestamp": "2026-10-22",
"post_id": "DevYd84jNvX",
"url": "https:\/\/www.threads.com\/@borrisbrandonramirez\/post\/DevYd84jNvX",
"post_time": "2026-10-21T02:54:38.000Z",
"profile_name": "borrisbrandonramirez",
"profile_url": "https:\/\/www.threads.com\/@borrisbrandonramirez",
"post_content": "God sees beyond the walls of our church. \nGod delights in our discipline and obedience even in the marketplace. \n\nWe don...",
"number_of_likes": 4
},
{
"timestamp": "2026-10-22",
"post_id": "DewWpKsnHzd",
"url": "https:\/\/www.threads.com\/@gregsedwards\/post\/DewWpKsnHzd",
"post_time": "2026-10-21T11:57:55.000Z",
"profile_name": "gregsedwards",
"profile_url": "https:\/\/www.threads.com\/@gregsedwards",
"post_content": "\u0022Intentionally suffering is just another form of indulgence.\u0022 - @markmanson",
"number_of_likes": 0
},
{
"timestamp": "2026-10-22",
"post_id": "DexJsOIAJl1",
"url": "https:\/\/www.threads.com\/@anirban.mitra93\/post\/DexJsOIAJl1",
"post_time": "2026-10-21T19:23:59.000Z",
"profile_name": "anirban.mitra93",
"profile_url": "https:\/\/www.threads.com\/@anirban.mitra93",
"post_content": "Pujo ends. The longing stays.\nAnother Pujo in the archives, another piece of my heart left behind.",
"number_of_likes": 0
}
]curl -H "Authorization: Bearer API_TOKEN" -H "Content-Type: application/json" -d '[{"url":"https://www.threads.com/@abc7la"},{"url":"https://www.threads.com/@adriellereinaauthor"}]' "https://api.brightdata.com/datasets/v3/trigger?dataset_id=gd_mde7jg3ld2h3hnnf2&format=json&uncompressed_webhook=true"[
{
"timestamp": "2026-10-22",
"url": "https:\/\/www.threads.com\/@doctorkowj",
"profile_name": "柯文哲",
"profile_id": "63439331208",
"about_formatted": "心存善念,盡力而為",
"number_of_followers": 612514,
"website": "https:\/\/www.facebook.com\/DoctorKoWJ",
"instagram_profile_url": "https:\/\/www.instagram.com\/doctorkowj"
},
{
"timestamp": "2026-10-22",
"url": "https:\/\/www.threads.com\/@wen_shih_cheng",
"profile_name": "温世政 Wen Shih-Cheng",
"profile_id": "80177097255",
"about_formatted": "南投縣長候選人|牙醫師\n草屯囡仔|南投温顧|世代幸福",
"number_of_followers": 30237,
"website": "https:\/\/www.facebook.com\/wEnShihheng\/",
"instagram_profile_url": "https:\/\/www.instagram.com\/wen_shih_cheng"
},
{
"timestamp": "2026-10-22",
"url": "https:\/\/www.threads.com\/@huang.guochang",
"profile_name": "黃國昌",
"profile_id": "63274537854",
"about_formatted": "溫暖而富有人性的國蔥老師",
"number_of_followers": 75800,
"website": null,
"instagram_profile_url": "https:\/\/www.instagram.com\/huang.guochang"
},
{
"timestamp": "2026-10-22",
"url": "https:\/\/www.threads.com\/@su.chiaohui",
"profile_name": "蘇巧慧",
"profile_id": "63447798401",
"about_formatted": "2026新北市長候選人\n立法委員|樹林、鶯歌、新莊西盛\n主任委員|民主進步黨新北市黨部\n【Podcast節目】搜尋訂閱:水獺媽媽巧巧話\n#新時代 #新市長\n#溫暖 #創新 #會做事",
"number_of_followers": 190787,
"website": "https:\/\/donate.newebpay.com\/chiao\/huiwin2026",
"instagram_profile_url": "https:\/\/www.instagram.com\/su.chiaohui"
},
{
"timestamp": "2026-10-22",
"url": "https:\/\/www.threads.com\/@chiayionefish",
"profile_name": "蔡易餘",
"profile_id": "63097833574",
"about_formatted": "#蔡易餘家己人\n#靈活ㄉ胖子 #專業立委\n#重力嘉速度\n📩 陳情、服務案件請私訊「蔡易餘家己人」FB",
"number_of_followers": 61093,
"website": "https:\/\/portaly.cc\/chiayionefish",
"instagram_profile_url": "https:\/\/www.instagram.com\/chiayionefish"
}
]API para acceso fluido a datos de Threads
Extracción de datos web integral, escalable y compatible
API para acceso fluido a datos de Threads
Adaptado a tu flujo de trabajo
Obtén datos estructurados en archivos JSON, NDJSON o CSV mediante entrega por Webhook o API.
Infraestructura y desbloqueo integrados
Obtén el máximo control y flexibilidad sin mantener infraestructura de Proxy y desbloqueo. Extrae datos fácilmente desde cualquier ubicación geográfica evitando CAPTCHAs y bloqueos.
Infraestructura probada en batalla
La plataforma de Bright Data impulsa a más de 20.000 empresas en todo el mundo, ofreciendo tranquilidad con un tiempo de actividad del 99,99% y acceso a más de 150 millones de IPs reales de usuarios en 195 países.
Cumplimiento líder en la industria
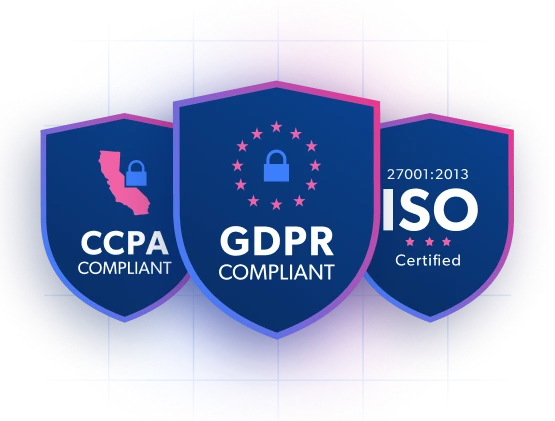
Nuestras prácticas de privacidad cumplen con las leyes de protección de datos, incluido el marco regulatorio de protección de datos de la UE, el GDPR y la CCPA.
API para acceso fluido a datos de Threads


Rastreo simplificado de Threads
Casos de uso de rastreo de Threads
Sentimiento del consumidor y monitoreo de marca
Seguimiento de tendencias y conversaciones
Inteligencia de creadores y competidores
Liderando el camino en la recopilación ética de datos web
Hemos establecido el estándar de oro para las prácticas éticas y conformes de datos web. Nuestra red de pares se basa en la confianza, con cada miembro inscribiéndose personalmente y la garantía de cero recopilación de datos personales. Defendemos la recopilación exclusiva de datos disponibles públicamente, respaldada por un proceso líder en la industria de Verificación KYC y una Política de Uso Aceptable transparente. Nuestro equipo global y multilingüe de Cumplimiento y Ética, el primero de su tipo, garantiza que nos mantengamos a la vanguardia de los cambios regulatorios y las mejores prácticas.
Por qué 50,000+ clientes eligen Bright Data

100% Cumplimiento

Soporte global 24/7

Cobertura de datos completa

Calidad de datos inigualable

Infraestructura potente

Soluciones personalizadas
Bright Data es utilizado por las mejores marcas del mundo




Preguntas frecuentes sobre el crawler de Threads
¿Qué es el crawler de Threads?
El crawler de Threads es una herramienta automatizada que descubre y recopila datos públicos de Threads a gran escala. No necesitas una lista completa de URLs. Puedes partir de una palabra clave, una categoría, una URL de búsqueda o una página específica. El crawler encuentra los registros coincidentes y envía los datos en un formato estructurado.
¿Cuál es la diferencia entre hacer crawling y scraping de Threads?
El crawling trata sobre descubrimiento: encontrar las páginas. El scraping trata sobre extracción: obtener campos específicos de una página que ya conoces. Un scraper necesita que le indiques qué URL visitar. Un crawler encuentra los registros por ti y luego extrae los datos. Usa el crawler cuando no tengas la lista completa de URLs, o cuando la lista cambie constantemente, como cada ítem de una categoría o cada resultado de una palabra clave. Si ya tienes las URLs exactas, recopilar por URL es la opción más directa.
¿En qué se diferencia el crawler de Threads de un dataset de Threads?
Un dataset son datos ya recopilados, que compras como un archivo listo para usar. El crawler recopila datos frescos cuando lo ejecutas, según tus propias entradas. Elige un dataset si quieres una cobertura amplia de inmediato sin configuración. Elige el crawler si necesitas un alcance específico, los datos más recientes o una recopilación con un horario que tú controlas.
¿En qué se diferencia el crawler de Threads de usar proxies?
Los proxies son infraestructura. Envían tus solicitudes a través de diferentes direcciones IP, pero igual tienes que construir y mantener el crawler, el parser y el desbloqueo. El crawler de Threads incluye todo eso: gestión de proxies, renderizado completo del navegador, resolución de CAPTCHA, parseo de datos y entrega. Elige proxies si quieres escribir y ser dueño del código. Elige el crawler si solo quieres los datos.
¿Es el crawler de Threads lo mismo que la Crawl API de Bright Data?
No. La Crawl API funciona en cualquier sitio web público. Le das una URL raíz y devuelve el contenido del sitio en Markdown, Texto, HTML o JSON. El crawler de Threads está diseñado solo para Threads. Devuelve campos listos para usar específicos de Threads, así que no tienes que escribir tu propia lógica de parseo.
¿Qué entradas puedo usar para iniciar un crawl?
Depende del crawler que elijas. Los puntos de partida comunes son una URL directa, una palabra clave, una URL de categoría, una URL de búsqueda, o una URL de perfil, vendedor o tienda. Puedes enviar hasta 5,000 URLs en una sola solicitud masiva.
¿Puedo programar crawls recurrentes de Threads?
Sí. El crawler admite recopilación por lotes y programada, para que puedas repetir el mismo crawl a intervalos regulares. Esto es útil para rastrear cambios a lo largo del tiempo, como precios, disponibilidad, posiciones o cifras de interacción, sin iniciar cada ejecución manualmente.
¿Necesito lidiar con bloqueos, CAPTCHAs o renderizado de JavaScript?
No. La gestión de proxies, la resolución de CAPTCHA y el renderizado completo del navegador están integrados. El crawler funciona en la red de Bright Data con más de 400 millones de IPs de usuarios reales en 195 países, así que puedes hacer crawling de Threads desde cualquier ubicación sin mantener tu propia configuración de desbloqueo.
¿Cómo se cobra el crawler de Threads?
Pagas solo por los registros entregados con éxito. Las entregas fallidas nunca se cobran. Puedes empezar con el nivel gratuito de 5,000 registros al mes sin tarjeta de crédito, y luego pasar a pago por uso o a un plan mensual a medida que creces. Los detalles de los planes están en la sección de precios de arriba.
¿Es legal hacer crawling de Threads?
El crawler solo recopila datos disponibles públicamente. Las prácticas de privacidad de Bright Data cumplen con las leyes de protección de datos, incluyendo GDPR y CCPA. También cuenta con un proceso de Verificación KYC y una Política de Uso Aceptable pública. Tú sigues siendo responsable de asegurarte de que tu propio uso de los datos cumpla con las leyes que te apliquen.
¿Quieres saber más?
Habla con un experto para analizar tus necesidades de crawling de Threads