La arquitectura de pipeline de datos es el diseño del sistema que mueve datos desde las fuentes hacia personas, modelos y agentes. Define cómo se recopilan, almacenan, verifican, transforman y entregan los datos.
Cuando los sitios web públicos son una fuente, un pipeline puede registrar un éxito mientras un minorista entrega una página de selección de país en vez de precios. Desde una conexión doméstica, cada uno de 4 clientes de código abierto consultó 13 páginas de búsqueda y listados 3 veces. De 88 respuestas exitosas, 39 no tenían datos utilizables.
Esta guía muestra cómo diseñar cada etapa, elegir un patrón, detectar estos fallos y decidir qué construir o comprar.
TL;DR
- Verifica los datos que esperas, no las páginas de bloqueo. Un detector de páginas de bloqueo marcó solo 8 de las 39 respuestas exitosas que no tenían datos.
- Modela cada campo según su propia granularidad. Amazon comparte un total de reseñas entre las variantes de un listado, así que sumar filas infló el conteo de reseñas de 20 productos en un 23%.
- Con alto volumen, deja que un LLM escriba el parser, no que lea cada página. El contenido principal de una página de Amazon usó 19 veces los tokens de su registro de 12 campos.
- Compara los recolectores por costo por registro aceptado. En la prueba de consulta, 39 de 88 respuestas exitosas no tenían datos, así que cuenta solo las filas que cumplan tu contrato de datos.
Diagrama y etapas de la arquitectura de pipeline de datos
Una arquitectura de pipeline de datos típica tiene 5 etapas. Cada etapa hace un trabajo, y la siguiente puede verificar su salida:
- Recolectar. Extrae datos de cada fuente, usando captura de datos de cambios para bases de datos, llamadas API para herramientas SaaS, y solicitudes HTTP o de navegador para sitios web.
- Almacenar en bruto. Escribe los datos en almacenamiento de objetos exactamente como llegaron, antes de cualquier parseo. En una arquitectura medallion, estos datos en bruto forman la capa bronze.
- Validar. Verifica cada registro contra un contrato de datos que lista campos requeridos, tipos y rangos. Envía los registros fallidos a cuarentena, con un código de razón.
- Transformar. Deduplica, une y modela los datos en un warehouse o lakehouse. Las tablas silver contienen filas validadas, y las tablas gold están listas para usar.
- Entregar. Entrega el resultado a dashboards, aplicaciones, modelos y agentes de IA.
Un orquestador como Airflow, Dagster o Prefect programa las etapas. El monitoreo rastrea frescura, volumen, tasas de llenado de campos y costo por registro aceptado a través de todas ellas.
El pipelining de datos es el término general para construir y ejecutar pipelines, y “data pipes” es un nombre informal para los pipelines mismos. ETL (extraer, transformar, cargar) es un patrón dentro de él, y ELT es otro, que carga los datos en bruto primero y los transforma en el warehouse.
Una arquitectura de pipeline de big data usa las mismas 5 etapas a un volumen donde el almacenamiento y el cómputo deben escalar por separado. Así que generalmente mantiene los datos en almacenamiento de objetos y formatos de tablas abiertos.
Los datos web públicos añaden un paso de descubrimiento que encuentra las URLs que vale la pena recolectar, y la API SERP puede ejecutarlo desde resultados de búsqueda. Para la recolección, el Web Scraper API de Bright Data devuelve registros estructurados de sitios web públicos. Web Unlocker gestiona las defensas anti-bots y devuelve la página en bruto para equipos que escriben sus propios parsers.
Este diagrama de arquitectura de pipeline de datos muestra cómo se conectan las etapas cuando los sitios web públicos son una de las fuentes:
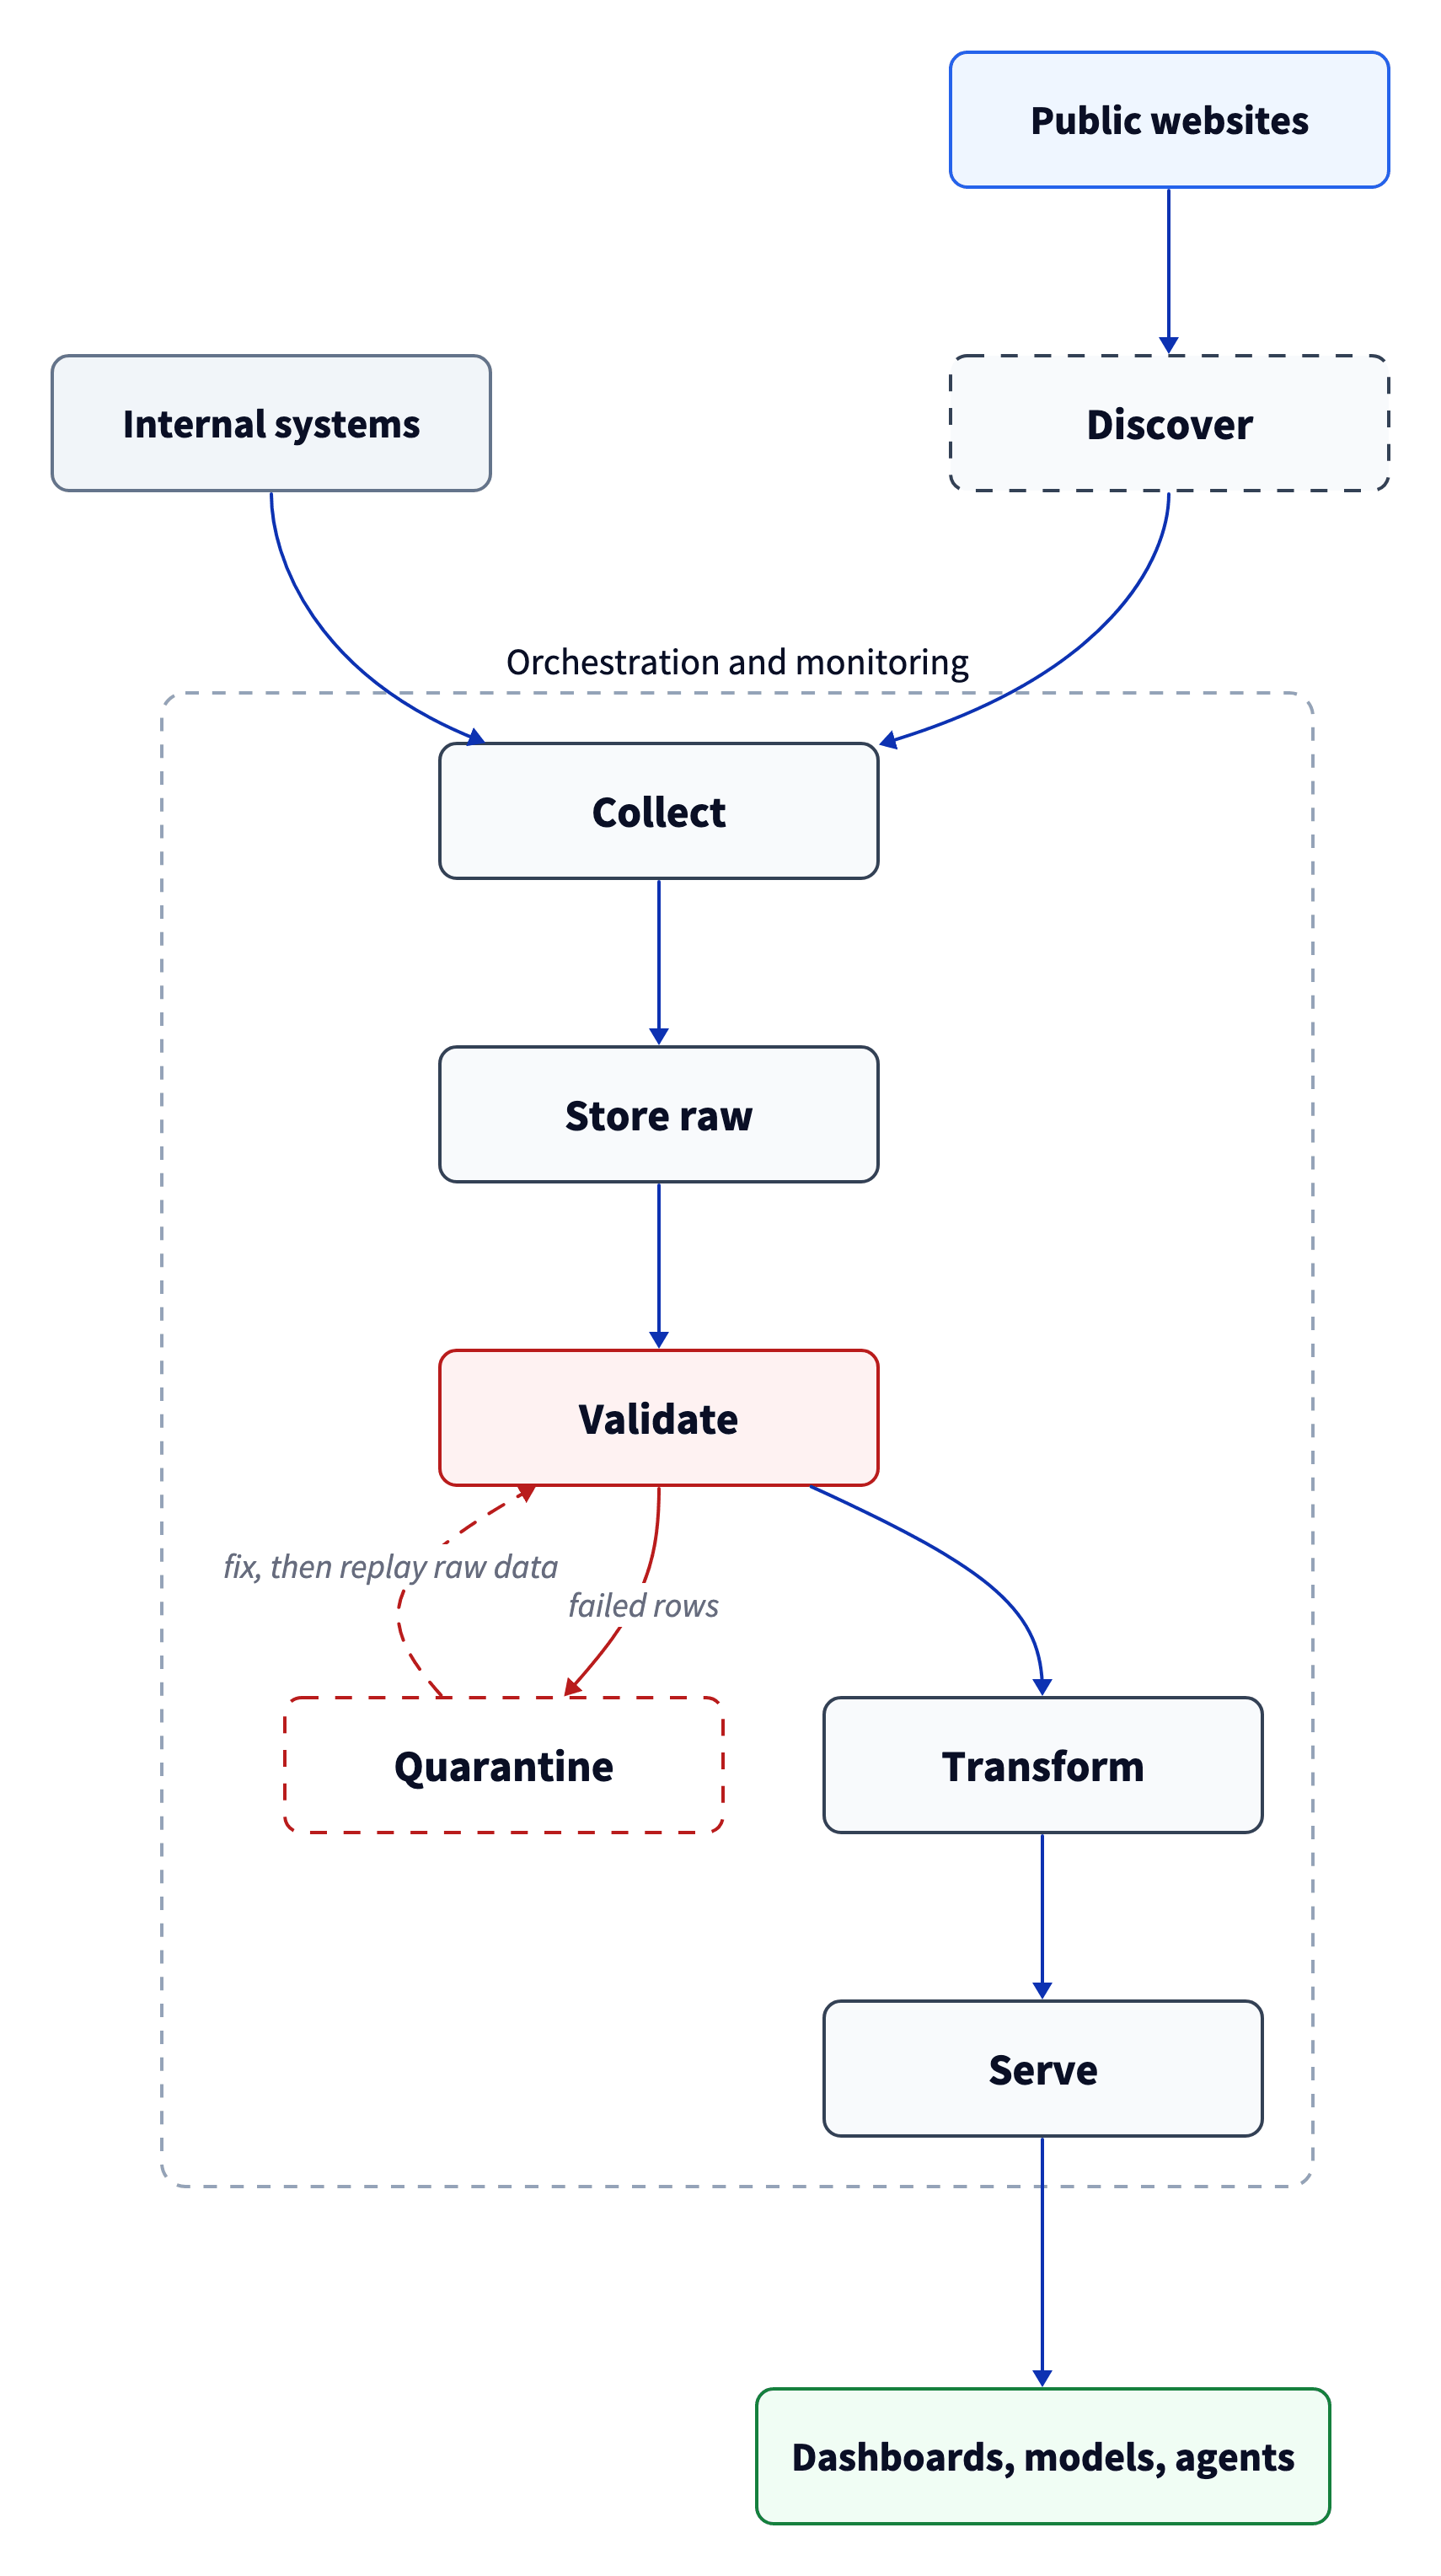
Las fuentes web añaden la mayor parte del trabajo en la etapa de validación y en el camino de cuarentena.
Ejemplos de arquitectura de pipeline de datos por lotes, streaming, híbrida y bajo demanda
El patrón correcto depende de qué tan rápido la decisión necesita datos nuevos.
Por lotes. Un minorista recolecta precios de competidores para 50K productos cada noche, y un agente de repricing los lee en la mañana. El Web Scraper API puede entregar cada ejecución directamente a destinos como Amazon S3, Google Cloud Storage o Snowflake.
Streaming. Un equipo de marca monitorea publicaciones sociales y noticias, porque una mención puede perder valor en horas. Kafka transporta los eventos, un procesador de streams como Flink calcula conteos en ventanas de tiempo, y un conector escribe los resultados en una tabla Iceberg. Para un ejemplo trabajado con Spark, consulta la guía de Spark Structured Streaming con datos web.
Híbrida. Un equipo de investigación de inversiones mantiene un lote diario de ofertas de empleo para historial y transmite cambios de precio para una lista corta de productos a vigilar. Los diseños más antiguos ejecutaban esto como 2 caminos separados, conocido como arquitectura Lambda. Muchos stacks más nuevos escriben el stream en una tabla Iceberg, así los trabajos por lotes y de streaming leen los mismos datos.
Bajo demanda. Un agente de compras verifica el precio y stock en vivo de un producto cuando un usuario pregunta. El pipeline entrega la última fila validada a menos que sea más antigua de lo que la decisión permite. Si lo es, una solicitud síncrona de Web Scraper API devuelve un registro actualizado en una llamada, y el pipeline lo verifica contra el mismo contrato. Dale a la consulta en vivo un tiempo límite que el usuario pueda aceptar, y si expira, responde con la fila almacenada y su antigüedad.
Valores predeterminados para una arquitectura de pipeline de datos moderna
Inicia un nuevo diseño de pipeline de datos desde estos valores predeterminados para cada capa:
| Capa | Predeterminado | Por qué |
|---|---|---|
| Almacenamiento y tablas | Archivos en bruto en almacenamiento de objetos, tablas en un formato abierto como Apache Iceberg | Snowflake, Databricks y motores de código abierto leen las mismas tablas Iceberg, así una copia de los datos puede servir a todos |
| Transformación | Modelos SQL en control de versiones, construidos con una herramienta como dbt | Los modelos obtienen revisión de código y pruebas como cualquier otro código |
| Orquestación | Una versión compatible de Airflow, Dagster o Prefect | Verifica la ventana de soporte antes de empezar. Airflow 2 alcanzó su fin de vida en abril de 2026 |
| Contratos de datos | Un archivo de contrato por cada tabla, en un formato como el Open Data Contract Standard (ODCS) | ODCS también puede indicar cómo los agentes de IA pueden usar los datos, así las reglas de uso se almacenan junto con tipos y propietarios |
| Acceso de agentes | Una interfaz de Model Context Protocol (MCP) sobre tablas gobernadas | La mayoría de los frameworks de agentes soportan MCP, y un proyecto de la Linux Foundation lo mantiene |
Si aún ejecutas AWS Data Pipeline, planifica una migración, porque AWS lo cerró a nuevos clientes en 2024.
Por qué los datos web públicos necesitan un pipeline de ingesta de datos diferente
A diferencia de las fuentes internas, los sitios web públicos no coordinan sus cambios con tu equipo. Pueden cambiar el markup y las defensas anti-bots sin aviso, variar el contenido según ubicación o cliente, y devolver un estado de éxito sin datos. Las fuentes internas generalmente cambian de formas planificadas, como una migración de esquema o una nueva versión de API.
Un estado de éxito no garantiza que los datos llegaron
Un estado 2xx solo muestra que un servidor respondió. Una prueba de consulta en 13 páginas de búsqueda y listados muestra lo que un estado 2xx puede ocultar. Las páginas provenían de sitios de retail, viajes, empleos, bienes raíces, reseñas y búsqueda.
Cada uno de 4 clientes de código abierto comunes consultó cada página 3 veces, desde una conexión de internet doméstica en India, sin proxies. Una respuesta se contó como datos solo si contenía los patrones HTML que marcan los listados de ese sitio. Tu porción de respuestas exitosas vacías variará según cliente y red, así que mídela con una verificación de contenido como la de abajo.
| Cliente | Respuestas 2xx | Respuestas 2xx sin datos | Sitios con datos en cualquiera de las 3 consultas (de 13) |
|---|---|---|---|
Python requests, encabezados predeterminados |
15 | 9 | 2 |
Python requests, encabezados de Chrome |
24 | 10 | 5 |
curl_cffi imitando a Chrome |
29 | 9 | 7 |
| Chrome headless (Playwright) | 20 | 11 | 3 (8 en una repetición con un User-Agent normal) |
En todos los clientes, 39 de las 88 respuestas exitosas no tenían datos utilizables, 27 con HTTP 200 y 12 con HTTP 202. Un código de estado podía marcar una consulta fallida pero no podía confirmar una buena.
Una de las 39 fue esta página, que un minorista entregó con HTTP 200 a la conexión doméstica en India en lugar de resultados de búsqueda:
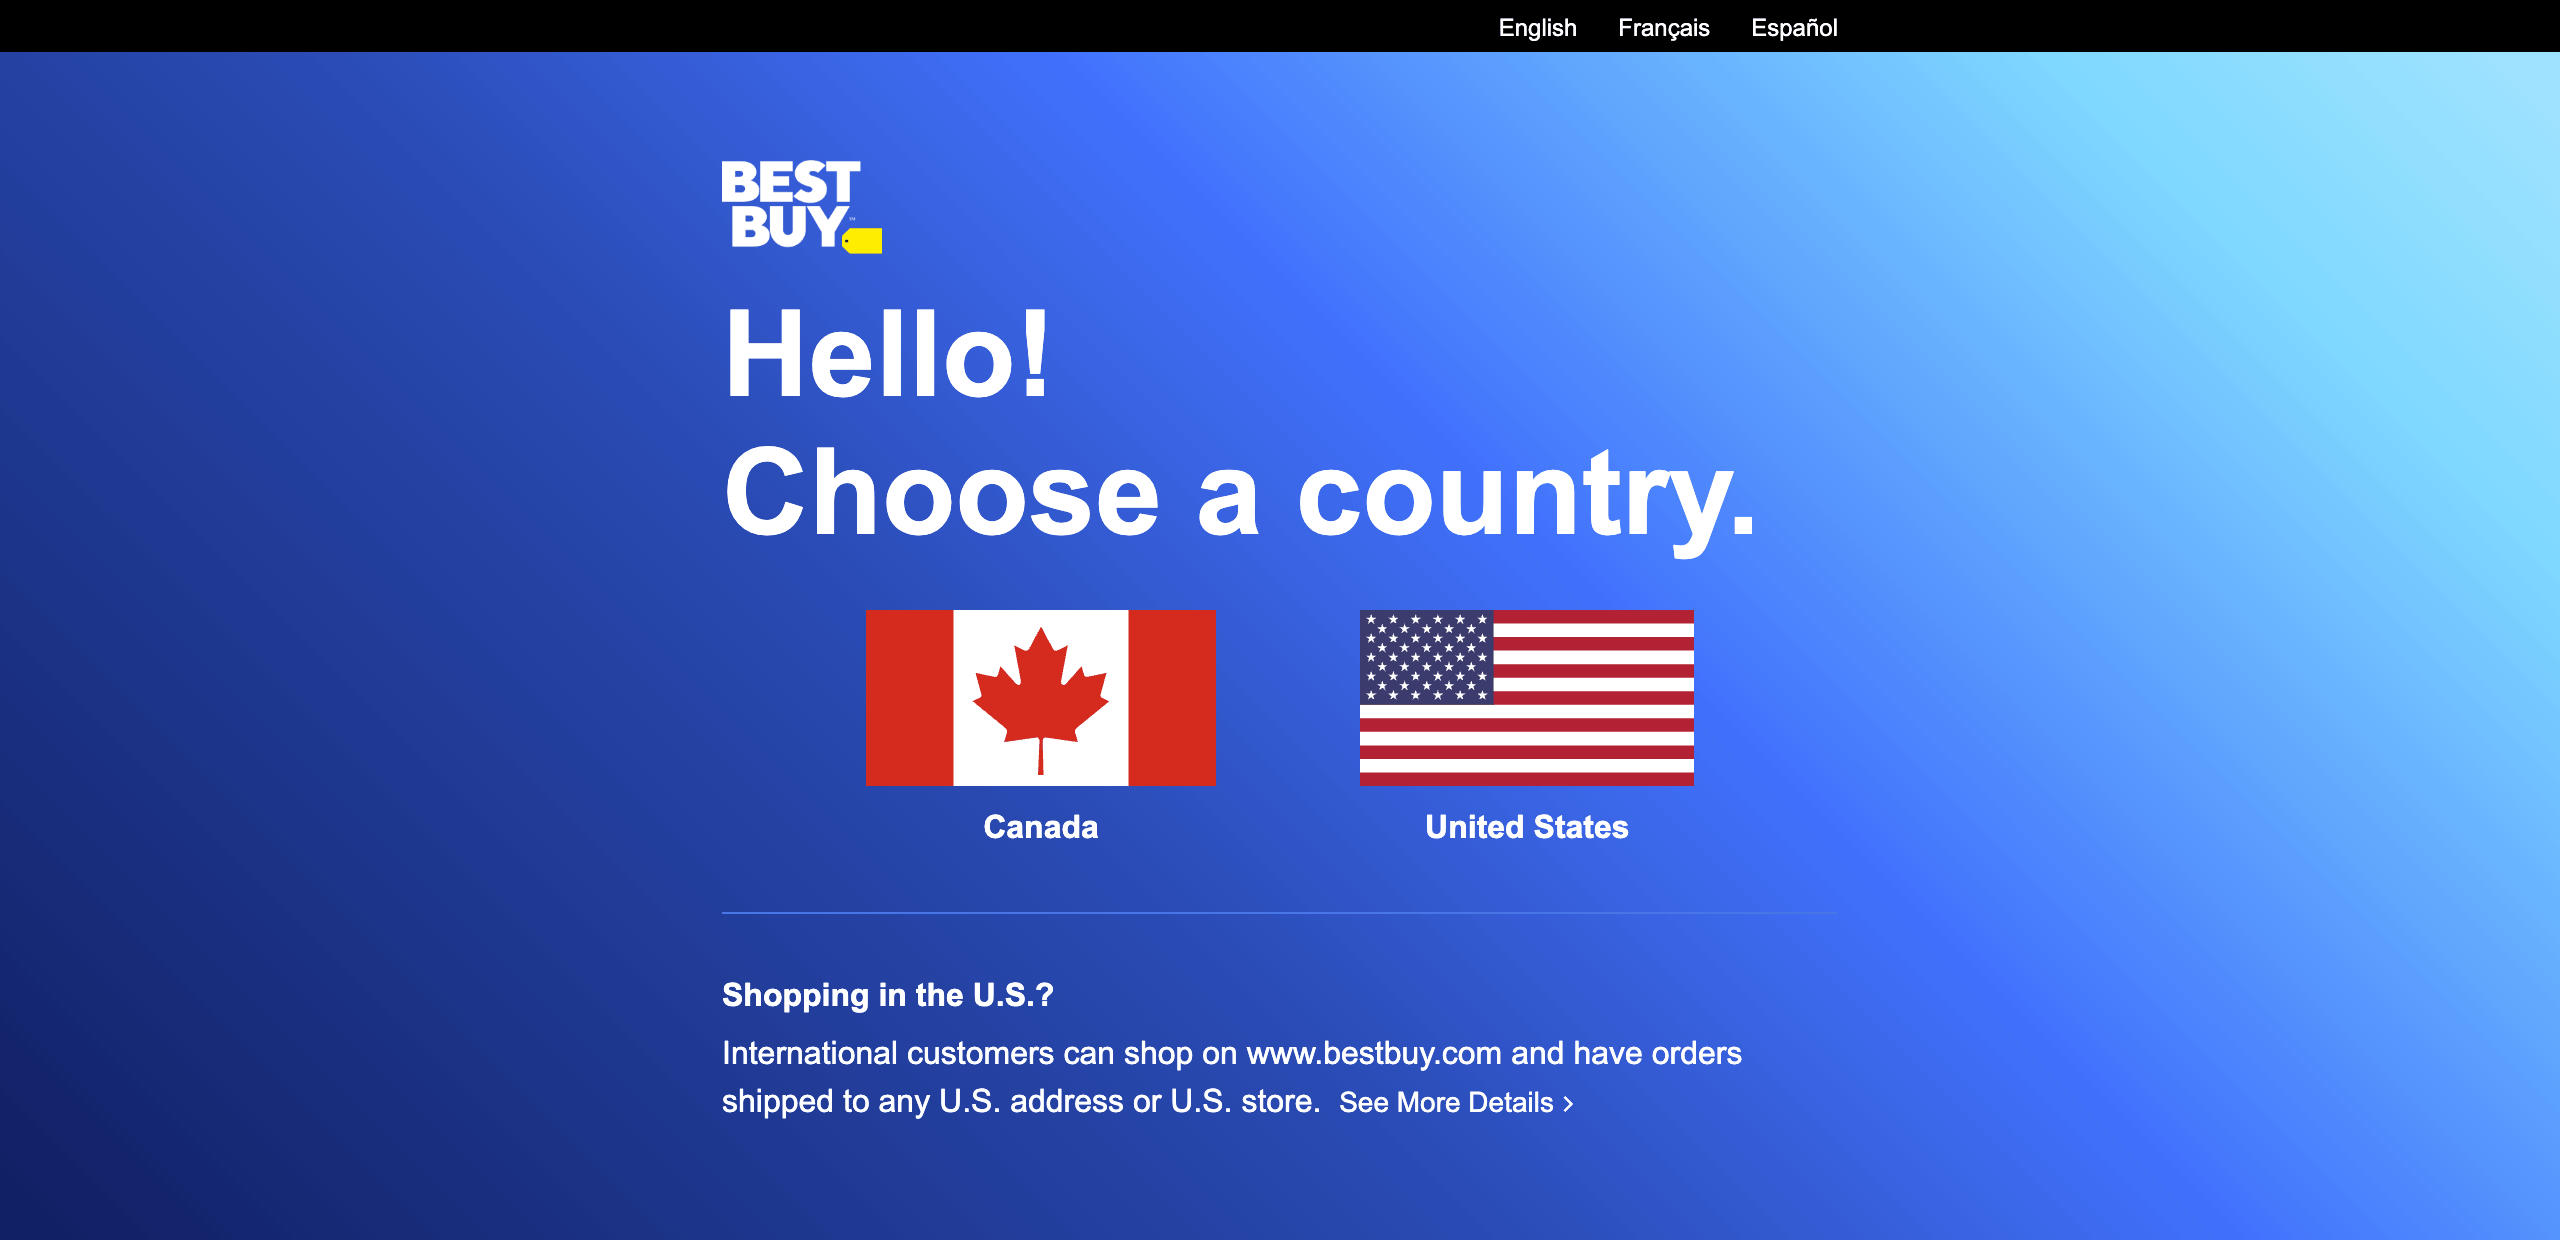
Renderizado del HTML guardado de esa respuesta.
Los fallos no parecían errores. Un detector construido con 8 firmas comunes de páginas de bloqueo, como páginas de presionar y mantener y de tráfico inusual, marcó solo 8 de las 39. El resto fueron páginas de desafío que la lista no cubría, una página de selección de país de un minorista, páginas solo de JavaScript, y páginas de 670 KB con resultados vacíos.
Las páginas de 670 KB parecían completas excepto por un área de resultados vacía:
La página que Chrome headless recibió con HTTP 202, renderizada de su HTML guardado. Una verificación de tamaño de respuesta la habría aprobado.
El mismo detector marcó 12 de las 49 respuestas buenas como bloqueadas. En 2 de los sitios, un script de defensa anti-bots se carga en páginas de listados normales, y su etiqueta coincidió con una de las firmas. Verifica los datos que esperas, no una página de bloqueo.
Las defensas anti-bots comparan los clientes con navegadores reales
Los sitios pueden identificar un cliente antes de que se envíe cualquier HTML, comparando su huella digital TLS y encabezados con los de navegadores reales. En una verificación de huella digital, la huella TLS de Web Unlocker coincidió con la de un Chrome instalado y actualizado. Al momento de la prueba, el objetivo Chrome más reciente en la biblioteca de imitación curl_cffi estaba 5 versiones principales por detrás del Chrome instalado. Chrome headless obtuvo datos de solo 3 de los 13 sitios mientras su User-Agent contenía HeadlessChrome, y de 8 con un User-Agent normal.
Desde esa conexión doméstica, 5 de 13 sitios no devolvieron datos a ningún cliente de código abierto, pero la prueba no separó el cliente de la red. Mantener el acceso funcionando significa rastrear lanzamientos de navegadores, huellas digitales, encabezados y reputación de IP a medida que cambian. O contratas personas para ese trabajo o lo compras, a través de Web Unlocker para páginas o el Browser API para sesiones de navegador completas.
Los agentes enfrentan las mismas defensas
En las 13 URLs de la prueba de consulta, la herramienta WebFetch de Claude Code devolvió listados de 2 de ellas en una sola ejecución. De las otras 11 solicitudes, 7 devolvieron un estado de error.
Las 4 restantes devolvieron una página de desafío, una página de selección de país, una página vacía y un mensaje de error, todas con un estado de éxito. El agente tiene que verificar el contenido él mismo.
Para acceso en vivo, los agentes pueden usar el Bright Data MCP Server, que ejecuta búsquedas y consultas de páginas a través de la API SERP y Web Unlocker.
Algunos sitios también permiten que los agentes se identifiquen y obtengan acceso bajo términos acordados. Los sitios en Cloudflare pueden verificar agentes que firman sus solicitudes con Web Bot Auth. El estándar Really Simple Licensing (RSL) permite que un sitio publique términos de licencia. Donde un sitio ofrezca cualquiera de los dos, planea usarlo.
Verifica lo que reporta el recolector, no solo el estado HTTP
Web Unlocker reporta el resultado de cada consulta en 2 encabezados de respuesta. x-brd-status-code contiene el estado del sitio objetivo. x-brd-error contiene la razón cuando una consulta falla, como se lista en los códigos de error de Web Unlocker. Tu código de ingesta debe decidir qué hacer basándose en estos encabezados, el estado de la propia llamada API y el contenido.
Guarda esta verificación como content_check.py. Genera un error para una clave o zona incorrecta, y de lo contrario devuelve accept, retry o quarantine en su campo action:
import os, re, requests

# Un marcador por fuente, un patrón que aparece solo cuando hay registros reales presentes.
MARKERS = {
    "amazon_search": r'data-component-type="s-search-result"',
    "walmart_search": r'"usItemId"',
}


def fetch_and_check(source: str, url: str, min_hits: int = 5) -> dict:
    r = requests.post(
        "https://api.brightdata.com/request",
        headers={"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"},
        json={"zone": "web_unlocker", "url": url, "format": "raw", "country": "us"},
        timeout=(15, 240),
    )
    # Una clave o nombre de zona incorrectos. Un reintento no lo arreglará.
    if r.status_code in (400, 401, 403):
        r.raise_for_status()
    # La consulta falló o alcanzó un límite de tasa. Reintentar más tarde.
    if r.headers.get("x-brd-error") or r.status_code == 429 or r.status_code >= 500:
        reason = r.headers.get("x-brd-error") or f"HTTP {r.status_code}"
        return {"source": source, "action": "retry", "reason": reason[:60]}
    hits = len(re.findall(MARKERS[source], r.text))
    action = "accept" if hits >= min_hits else "quarantine"
    return {
        "source": source,
        "action": action,
        "target_status": r.headers.get("x-brd-status-code"),
        "marker_hits": hits,
        "bytes": len(r.content),
    }


if __name__ == "__main__":
    amazon = "https://www.amazon.com/s?k=noise+cancelling+headphones"
    walmart = "https://www.walmart.com/search?q=noise+cancelling+headphones"
    print(fetch_and_check("amazon_search", amazon))
    print(fetch_and_check("walmart_search", walmart))
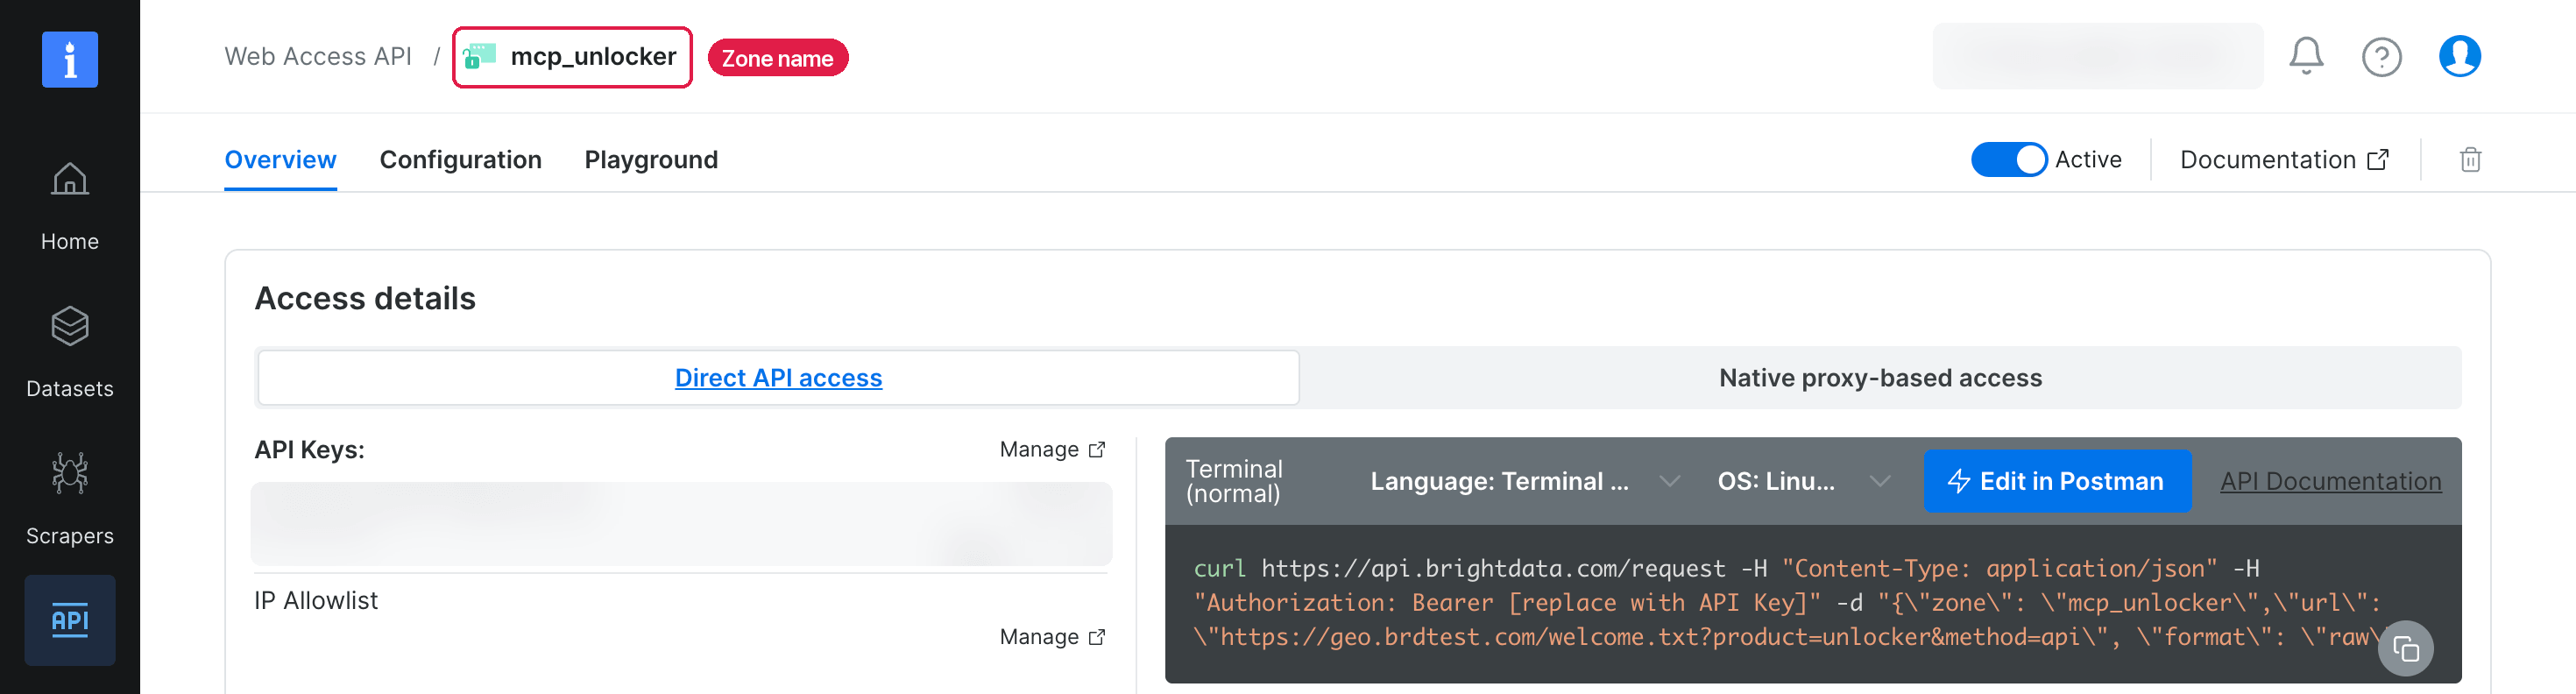
Para ejecutarlo, crea una zona de Web Unlocker, una configuración nombrada para ese producto, bajo Web Access en el panel de control de Bright Data. Las cuentas nuevas reciben créditos gratis mensuales, suficientes para ejecutar los scripts de esta guía.
Crea una clave API bajo Account settings en el panel de control, y guárdala en una variable de entorno llamada BRIGHTDATA_API_KEY. Reemplaza web_unlocker con el nombre de tu zona. El nombre aparece en la parte superior de la página de la zona, y el ejemplo de solicitud de la página lo usa:
Después de pip install requests, ejecuta python content_check.py. Una ejecución de ejemplo aceptó ambas páginas:
{'source': 'amazon_search', 'action': 'accept', 'target_status': '200', 'marker_hits': 16, 'bytes': 1516805}
{'source': 'walmart_search', 'action': 'accept', 'target_status': '200', 'marker_hits': 395, 'bytes': 1535496}
Tu pipeline repite una consulta retry con backoff, esperando más tiempo después de cada fallo. Una página en quarantine va a una persona o un clasificador, porque la fuente puede haber cambiado. Los front ends pueden cambiar sin aviso, así que cuando una fuente de repente no devuelve datos, verifica primero que su marcador aún aparezca en el HTML de la página.
Un pipeline de ingesta de datos de referencia para fuentes web
El pipeline de referencia de abajo usa el Web Scraper API, que devuelve registros estructurados, así la validación verifica campos en lugar de parsear páginas.
Filtra lo que devuelve el descubrimiento
Para una búsqueda de un modelo de auriculares, la API SERP devolvió los 7 resultados orgánicos de Google, el AI Overview, videos y People Also Ask como campos JSON separados. Google clasificó solo 3 páginas de minoristas entre los 7, y una de ellas vendía un producto diferente, la versión de auriculares inalámbricos del mismo modelo. La declaración del AI Overview sobre el precio citaba una reseña de YouTube, no un minorista, como su primera fuente. Trata las respuestas de IA como afirmaciones a verificar, y filtra resultados por dominio y por un identificador como un número de modelo.
Construye y ejecuta el pipeline
El pipeline toma una lista de URLs de productos, como resultados de descubrimiento filtrados. Inicia un trabajo con el endpoint /trigger del Web Scraper API, lo rastrea con /progress, y descarga los registros con /snapshot. Con include_errors=true, el API reporta cada entrada fallida como su propio registro con un error_code.
En Python, el Bright Data SDK reemplaza estas 3 llamadas con una llamada por scraper. El script de abajo llama a los endpoints directamente, así cada etapa permanece visible, y el script funciona con cualquier orquestador. Guárdalo como pipeline.py. Sus funciones siguen las etapas del diagrama, con collect(), store_raw(), validate() y model() para las tablas, luego domain_checks() para las alertas:
"""Pipeline de datos web de referencia que recolecta, almacena en bruto, valida, modela y verifica.

Recolección: Bright Data Web Scraper API (trigger async + descarga de snapshot).
Almacenamiento: una carpeta local en lugar de almacenamiento de objetos (bronze), DuckDB para silver y gold.
"""
import json, os, sys, time, pathlib, datetime as dt
import duckdb, requests
from pydantic import BaseModel, Field, ValidationError

API = "https://api.brightdata.com/datasets/v3"
# El replay no necesita clave.
HEADERS = {"Authorization": f"Bearer {os.environ.get('BRIGHTDATA_API_KEY', '')}"}
DATASET = "gd_l7q7dkf244hwjntr0"  # Productos de Amazon, recolectar por URL
LAKE = pathlib.Path("lake")


def collect(inputs: list[dict]) -> str:
    """Dispara una recolección asíncrona y espera por ella. Devuelve el ID de snapshot."""
    params = {"dataset_id": DATASET, "include_errors": "true"}
    r = requests.post(
        f"{API}/trigger", headers=HEADERS, json=inputs, params=params, timeout=60
    )
    r.raise_for_status()
    snapshot_id = r.json()["snapshot_id"]
    deadline = time.time() + 3600  # falla después de una hora, para que el orquestador pueda alertar
    while time.time() < deadline:
        url = f"{API}/progress/{snapshot_id}"
        p = requests.get(url, headers=HEADERS, timeout=60).json()
        if p["status"] == "ready":
            summary = {k: p.get(k) for k in ("records", "errors", "error_codes")}
            print("progress:", summary)
            return snapshot_id
        if p["status"] in ("failed", "canceled"):
            raise RuntimeError(f"snapshot {snapshot_id} ended as {p['status']}")
        time.sleep(15)
    raise TimeoutError(f"snapshot {snapshot_id} not ready after 1 hour")


def store_raw(snapshot_id: str) -> pathlib.Path:
    """Escribe el snapshot sin cambios en una ruta inmutable y particionada."""
    url = f"{API}/snapshot/{snapshot_id}"
    r = requests.get(url, headers=HEADERS, params={"format": "ndjson"}, timeout=300)
    # Cualquier cosa que no sea 200, como 202 mientras se construye el snapshot, no son datos.
    if r.status_code != 200:
        raise RuntimeError(
            f"snapshot {snapshot_id} not downloadable: HTTP {r.status_code}"
        )
    day = dt.datetime.now(dt.timezone.utc).date()
    path = LAKE / "bronze/amazon_products" / f"dt={day}" / f"{snapshot_id}.ndjson"
    path.parent.mkdir(parents=True, exist_ok=True)
    if not path.exists():  # un snapshot almacenado nunca se reescribe
        path.write_bytes(r.content)
    return path


class Product(BaseModel):
    """El contrato de datos, que define qué pueden recibir las tablas posteriores."""
    asin: str = Field(pattern=r"^[A-Z0-9]{10}$")
    parent_asin: str | None = None
    title: str = Field(min_length=3)
    final_price: float = Field(gt=0, lt=100_000)
    currency: str = Field(pattern=r"^[A-Z]{3}$")
    rating: float | None = Field(default=None, ge=0, le=5)
    reviews_count: int | None = Field(default=None, ge=0)
    buybox_seller: str | None = None
    timestamp: dt.datetime


def validate(path: pathlib.Path) -> tuple[list[dict], list[dict]]:
    """Divide un archivo en bruto en filas aceptadas y filas en cuarentena con una razón."""
    accepted, quarantined = [], []
    for line in path.read_text().splitlines():
        rec = json.loads(line)
        if rec.get("error_code"):  # entrada fallida, reportada por registro
            quarantined.append({"input": rec.get("input"), "reason": rec["error_code"]})
            continue
        try:
            row = Product(**rec).model_dump()
            row["snapshot_file"] = path.name  # linaje de vuelta a los bytes en bruto
            accepted.append(row)
        except ValidationError as e:
            fields = ",".join(str(x["loc"][0]) for x in e.errors())
            reason = f"contract:{fields}"
            quarantined.append({"input": rec.get("url"), "reason": reason})
    return accepted, quarantined


def model(accepted: list[dict]) -> duckdb.DuckDBPyConnection:
    """Carga silver de forma idempotente, luego construye tablas gold en la granularidad correcta."""
    con = duckdb.connect(str(LAKE / "warehouse.duckdb"))
    con.execute("SET TimeZone = 'UTC'")  # almacena y muestra cada observación en UTC
    con.execute("""CREATE TABLE IF NOT EXISTS silver_prices (
        asin TEXT, parent_asin TEXT, title TEXT, final_price DOUBLE,
        currency TEXT, rating DOUBLE, reviews_count BIGINT, buybox_seller TEXT,
        observed_at TIMESTAMPTZ, snapshot_file TEXT,
        PRIMARY KEY (asin, observed_at))""")
    # La llave primaria convierte una repetición en una operación nula en lugar de un duplicado.
    for r in accepted:
        con.execute(
            "INSERT OR IGNORE INTO silver_prices VALUES (?,?,?,?,?,?,?,?,?,?)",
            [r["asin"], r["parent_asin"] or r["asin"], r["title"], r["final_price"],
             r["currency"], r["rating"], r["reviews_count"], r["buybox_seller"],
             r["timestamp"], r["snapshot_file"]],
        )
    con.execute("""CREATE OR REPLACE VIEW latest_prices AS
        SELECT * FROM silver_prices
        QUALIFY row_number() OVER (PARTITION BY asin ORDER BY observed_at DESC) = 1""")
    # El precio pertenece a la variante. Las reseñas pertenecen al listado padre.
    con.execute("""CREATE OR REPLACE VIEW gold_parent_reviews AS
        SELECT parent_asin, max(reviews_count) AS reviews_count, max(rating) AS rating,
               count(DISTINCT asin) AS variants_seen
        FROM latest_prices GROUP BY parent_asin""")
    return con


def domain_checks(con: duckdb.DuckDBPyConnection) -> None:
    """Compara cada producto con su observación previa. Marca, nunca elimines."""
    con.execute("""CREATE OR REPLACE TABLE flags AS
        WITH obs AS (
            SELECT *,
                lag(final_price) OVER w AS prev_price,
                lag(currency) OVER w AS prev_currency,
                lag(reviews_count) OVER w AS prev_reviews,
                lag(buybox_seller) OVER w AS prev_seller
            FROM silver_prices WINDOW w AS (PARTITION BY asin ORDER BY observed_at))
        SELECT asin, observed_at, 'price_moved_over_30pct' AS flag FROM obs
            WHERE abs(final_price - prev_price) / prev_price > 0.3
        UNION ALL SELECT asin, observed_at, 'currency_changed' FROM obs
            WHERE currency <> prev_currency
        UNION ALL SELECT asin, observed_at, 'reviews_went_down' FROM obs
            WHERE reviews_count < prev_reviews
        UNION ALL SELECT asin, observed_at, 'reviews_jumped_over_50pct' FROM obs
            WHERE reviews_count > prev_reviews * 1.5
        UNION ALL SELECT asin, observed_at, 'buybox_seller_changed' FROM obs
            WHERE buybox_seller <> prev_seller""")


if __name__ == "__main__":
    # --replay carga cada archivo bronze en las tablas de nuevo, sin un nuevo rastreo.
    if sys.argv[1] == "--replay":
        raws = sorted(LAKE.glob("bronze/amazon_products/*/*.ndjson"))
    else:
        inputs = json.load(open(sys.argv[1]))
        snapshot_id = sys.argv[2] if len(sys.argv) > 2 else collect(inputs)
        raws = [store_raw(snapshot_id)]
    for raw in raws:
        ok, bad = validate(raw)
        con = model(ok)
        print(f"{raw.name}: accepted={len(ok)} quarantined={len(bad)}")
        for q in bad:
            print("quarantine:", q)
    domain_checks(con)
    print(con.sql(
        "SELECT count(*) AS rows, count(DISTINCT asin) AS asins FROM silver_prices"
    ))
    print(con.sql(
        "SELECT * FROM gold_parent_reviews WHERE variants_seen > 1 ORDER BY parent_asin"
    ))
    print(con.sql("SELECT * FROM flags ORDER BY asin"))
El valor DATASET en el script es el ID del scraper de productos de Amazon, uno de los scrapers prediseñados que Bright Data mantiene. Su página en el panel de control muestra ese ID en su ejemplo de solicitud, junto a un campo de entrada zipcode:
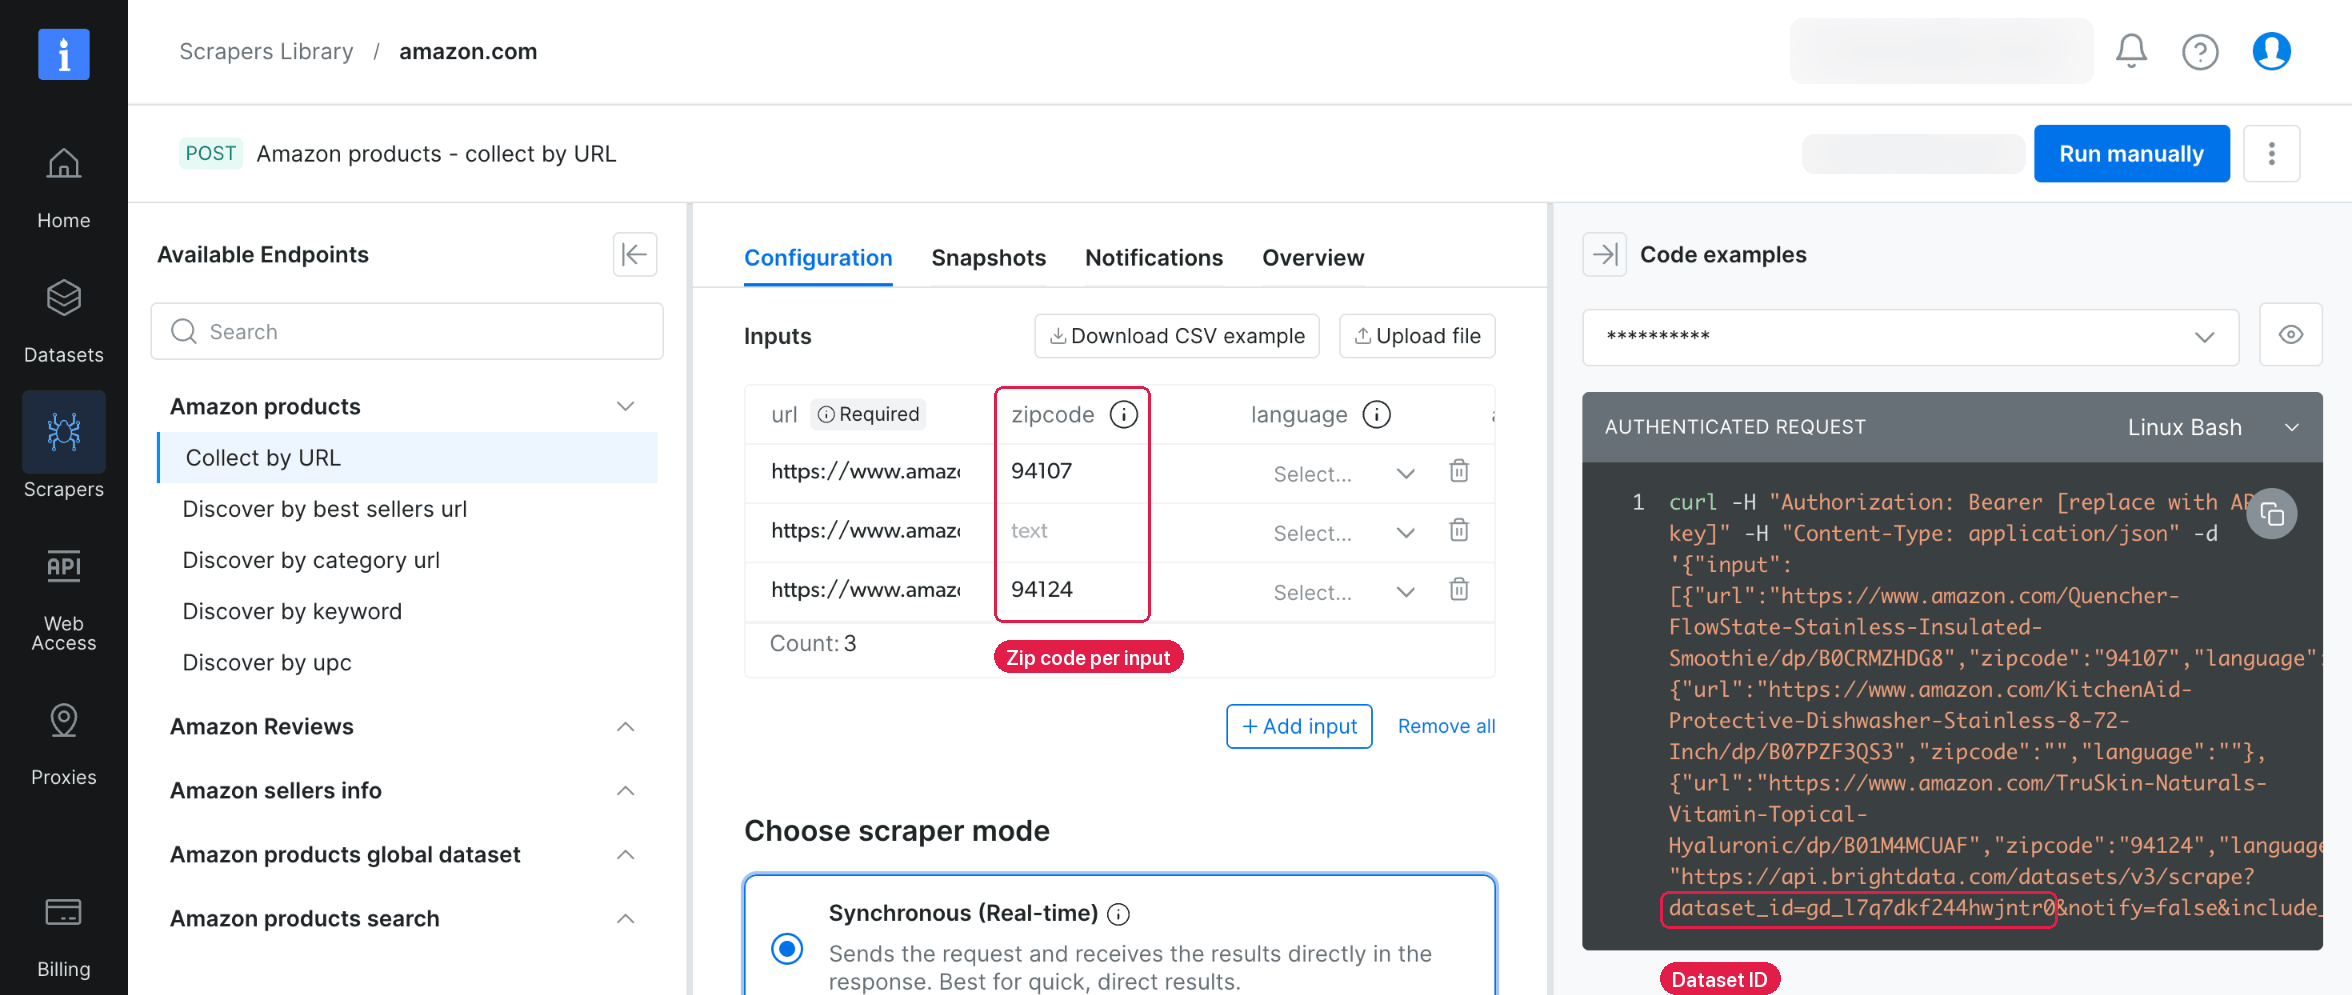
El ejemplo de solicitud de la página usa el endpoint síncrono /scrape, que devuelve registros en la misma llamada. El script usa /trigger en su lugar, que ejecuta lotes grandes en segundo plano y entrega los resultados como un snapshot.
En Python 3.10 o posterior, guarda tus entradas como inputs.json en el formato [{"url": "https://www.amazon.com/dp/<ASIN>", "zipcode": "<ZIP>"}], donde <ASIN> es el ID del producto de Amazon. Luego ejecuta:
pip install requests pydantic duckdb
export BRIGHTDATA_API_KEY="your_api_key"
python pipeline.py inputs.json
python pipeline.py --replay
El primer comando python recolecta y carga una ejecución. El comando --replay carga cada archivo en bruto guardado en las tablas de nuevo, sin llamar al API. La salida de abajo proviene de una lista a vigilar de 20 productos de Amazon y 1 ID deliberadamente inválido, recolectada dos veces con unas 2 horas de diferencia y luego reproducida:
sd_mvgo38o997m0dxre9.ndjson: accepted=20 quarantined=1
quarantine: {'input': {'url': 'https://www.amazon.com/dp/B0ZZZZZZZZ', 'asin': '', 'zipcode': '', 'language': ''}, 'reason': 'dead_page'}
sd_mvgsyvcx1fcvvspadf.ndjson: accepted=20 quarantined=1
quarantine: {'input': {'url': 'https://www.amazon.com/dp/B0ZZZZZZZZ', 'asin': '', 'zipcode': '', 'language': ''}, 'reason': 'dead_page'}
┌───────┬───────┐
│ rows  │ asins │
│ int64 │ int64 │
├───────┼───────┤
│    40 │    20 │
└───────┴───────┘

┌─────────────┬───────────────┬────────┬───────────────┐
│ parent_asin │ reviews_count │ rating │ variants_seen │
│   varchar   │     int64     │ double │     int64     │
├─────────────┼───────────────┼────────┼───────────────┤
│ B0FMZYMXNR  │          3015 │    4.2 │             3 │
│ B0GKGDTLG2  │           668 │    4.5 │             6 │
│ B0H1QVR9JS  │         17115 │    4.3 │             2 │
└─────────────┴───────────────┴────────┴───────────────┘

┌────────────┬────────────────────────────┬───────────────────────────┐
│    asin    │        observed_at         │           flag            │
│  varchar   │  timestamp with time zone  │          varchar          │
├────────────┼────────────────────────────┼───────────────────────────┤
│ B0FDKQZ18F │ 2026-10-20 14:53:09.044+00 │ buybox_seller_changed     │
│ B0HJ5K8WN4 │ 2026-10-20 14:53:11.293+00 │ reviews_jumped_over_50pct │
└────────────┴────────────────────────────┴───────────────────────────┘
Para mantener la demostración simple, estas ejecuciones no establecieron un código postal, pero las ejecuciones de producción deberían establecer uno. La tabla silver mantuvo ambas observaciones de los 20 productos. Reproducir de nuevo dejó la tabla en 40 filas, porque la llave primaria bloquea filas duplicadas.
Decisiones de diseño que encuentran problemas temprano
- Escribe los datos en bruto una vez y nunca los edites. Con el archivo en bruto conservado, añadir un campo no necesita un nuevo rastreo. Agrégalo al contrato
Producty a la tablasilver_prices, eliminalake/warehouse.duckdb, y ejecuta--replay. El campo de vendedor buy-box del script, que registra al comerciante que gana el botón predeterminado Add to Cart, se añadió de esta manera. - Rechaza cualquier descarga que no sea HTTP 200. El endpoint de snapshot devuelve HTTP 202 mientras el trabajo aún se ejecuta, como hacen muchos APIs asíncronos. El código que omite esta verificación guarda el mensaje de espera como datos. El contrato entonces lo pone en cuarentena, porque el mensaje no tiene ninguno de los campos requeridos.
- Añade alertas después de la verificación del contrato, y nunca elimines filas marcadas. Una verificación de esquema detecta un precio faltante, no un precio que corresponde al tamaño de paquete equivocado. En la salida de arriba, las verificaciones de dominio marcaron un cambio de vendedor buy-box y un conteo de reseñas que subió de 27 a 52. Los conteos también pueden bajar, como de 15 a 14 en una tercera ejecución, lo que parece reseñas que el sitio eliminó.
- Mantén un código de razón en cuarentena. Una fila
dead_pagesignifica que la URL de entrada desapareció, así quien posee la lista de entradas la elimina. Una filacontract:significa que faltaba un campo o estaba fuera de rango, así un ingeniero de datos verifica la fuente. - Mantén la zona horaria en cada marca de tiempo. Una columna sin ella almacenó una observación de 14:53 UTC como las 20:23 hora local, lo que rompe las comparaciones entre fuentes. Usa
TIMESTAMPTZy UTC.
Antes de ejecutar el pipeline en producción
Quien use tus datos, dentro o fuera de la empresa, generalmente juzga cada entrega por cobertura, frescura, procedencia y reproducibilidad. Estas prácticas respaldan esas 4 medidas:
- Envía un resumen de ejecución con cada entrega. Lista entradas, filas aceptadas, razones de cuarentena y alertas, así los usuarios pueden ver exactamente qué cubre el dataset. Verifica la cobertura contra una referencia independiente también, como el sitemap del sitio, porque las métricas de una ejecución solo cubren las entradas que enviaste.
- Alerta contra la línea base de cada fuente. Envía una alerta cuando la tasa de aceptación de una ejecución o la tasa de llenado de un campo cae por debajo de su línea base. Cada campo necesita su propia línea base, establecida desde su historial reciente, como una mediana móvil de las últimas 7 ejecuciones.
- Establece una severidad para cada alerta. Un agente puede usar un precio incorrecto antes de que un analista lo vea. Bloquea a los agentes de leer filas con alertas de precio o moneda, y envía alertas menos graves, como una pequeña caída de reseñas, a una persona. Verifica también una muestra diaria de filas aceptadas contra sus páginas fuente, porque las reglas solo detectan los errores que predijiste.
- Mide las propias verificaciones. Rastrea falsos positivos, falsos negativos, tasa de revisión manual e incidentes por fuente. El detector de páginas de bloqueo en la prueba de consulta marcó páginas buenas como bloqueadas, así cada verificación necesita su propia tasa de error.
- Mantén un solo archivo de contrato. El código de ingesta y las pruebas de tablas deben leer el mismo archivo. Herramientas como el
datacontract-clide código abierto prueban un archivo ODCS contra tablas directamente. - Deja que el recolector te notifique. El trigger del Web Scraper API acepta una URL de webhook en
endpointconnotifyestablecido entrue, así el orquestador puede iniciar la validación cuando el snapshot esté listo. - Presupuesta para almacenamiento en bruto. Una página de Amazon de 2.4 MB se comprimió a 449 KB con gzip, así recolectar 100K páginas en bruto al día añade unos 45 GB de almacenamiento cada día. El registro JSON completo del mismo producto tenía 24 KB antes de comprimir, unas 100 veces más pequeño que la página. Almacena cada cuerpo de respuesta en bruto con su estado y encabezados en JSON o un archivo WARC, luego mueve los archivos antiguos a almacenamiento frío.
Modela cada campo según la granularidad que usa el sitio web
La granularidad de una tabla es lo que representa una fila, como una variante de producto o un listado padre. Un registro scrapeado parece una sola fila, pero sus campos pueden describir cosas diferentes. En un marketplace, el precio generalmente pertenece a la variante exacta. Las calificaciones y conteos de reseñas a menudo pertenecen al listado padre que agrupa todos los colores y tallas.
En el listado de Amazon de uno de los auriculares en la lista a vigilar, el total de reseñas aparece sobre las opciones de color que cubre:
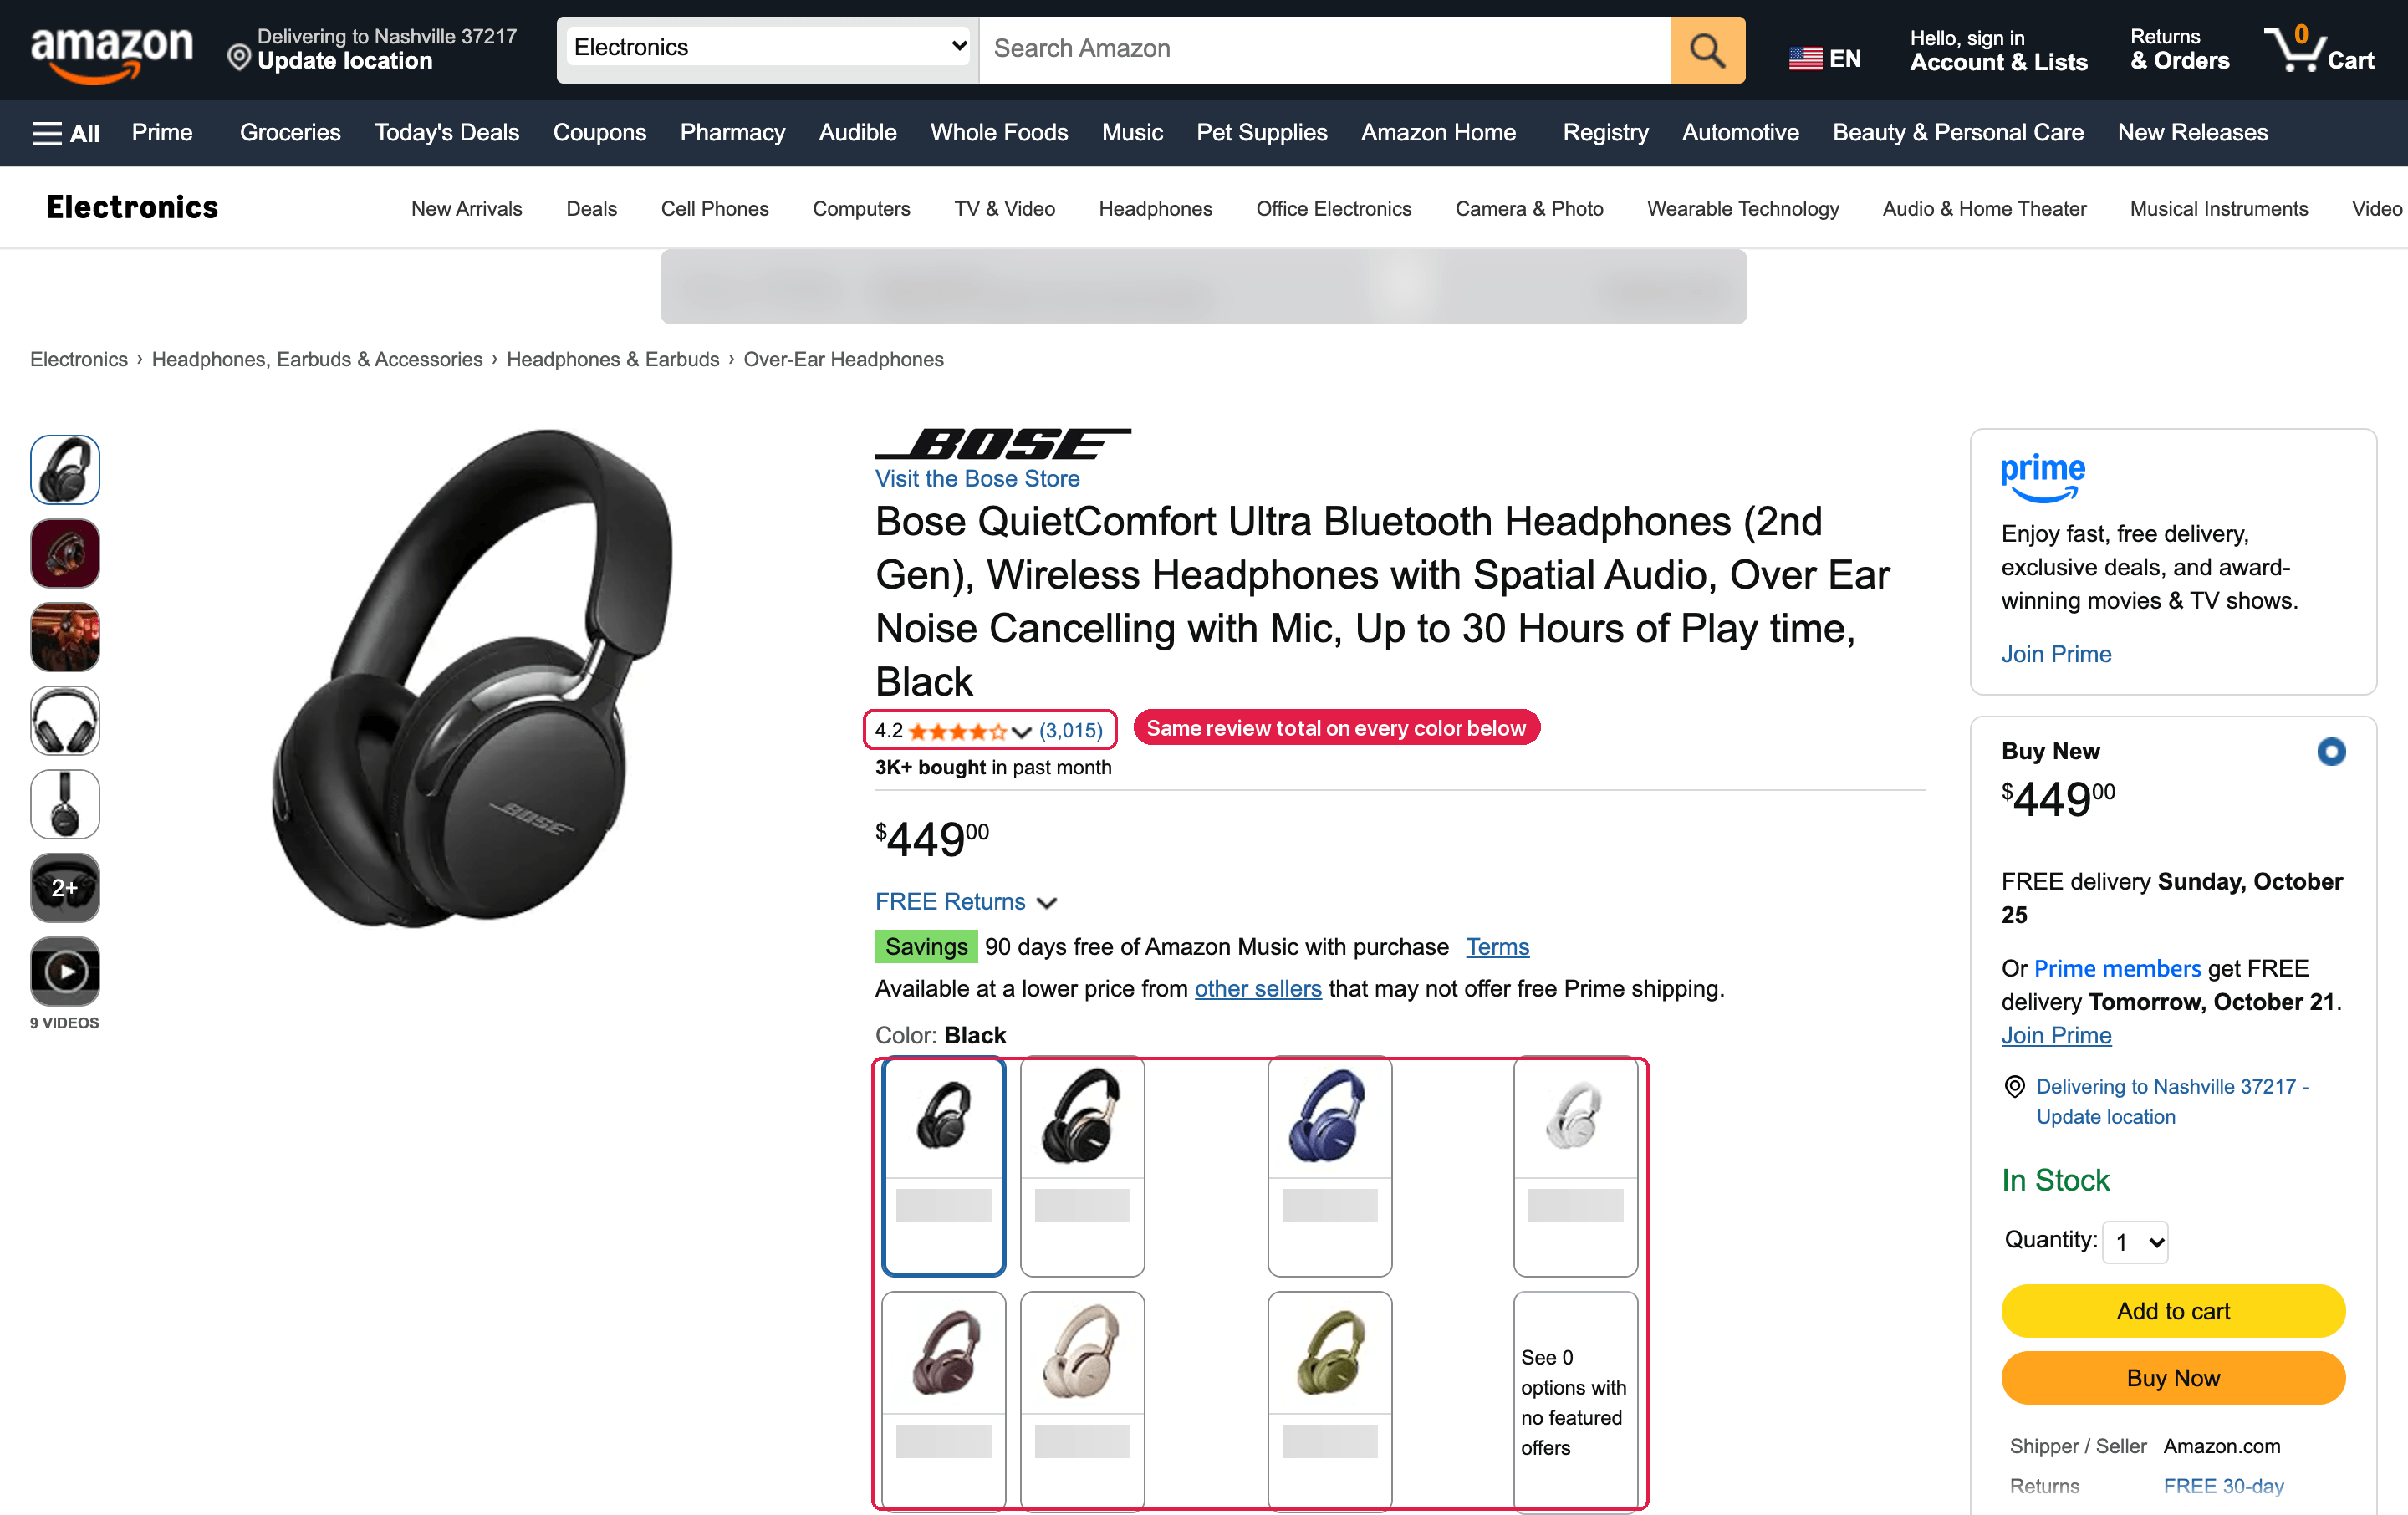
El listado tal como fue recolectado, renderizado desde su HTML guardado. Los 3 colores en la lista a vigilar reportaron cada uno las mismas 3,015 calificaciones.
En la lista a vigilar de 20 productos, 11 productos eran variantes de solo 3 listados padres, como 6 versiones de un par de orejeras. Así los 20 productos pertenecían a solo 12 listados padres. Una suma fila por fila entonces cuenta las 3,015 calificaciones de los auriculares Bose 3 veces, una por color. Cada registro del Web Scraper API incluye un parent_asin, así un GROUP BY sobre él cuenta cada total de reseñas una vez:
-- Granularidad incorrecta: un total de reseñas por fila de variante
SELECT sum(reviews_count) AS naive_variant_sum FROM latest_prices;

-- Granularidad correcta: un total de reseñas por listado padre
SELECT sum(reviews_count) AS parent_grain_sum, count(*) AS parents
FROM gold_parent_reviews;
En lake/warehouse.duckdb, las 2 consultas devolvieron:
┌───────────────────┐
│ naive_variant_sum │
│      int128       │
├───────────────────┤
│            139537 │
└───────────────────┘

┌──────────────────┬─────────┐
│ parent_grain_sum │ parents │
│      int128      │  int64  │
├──────────────────┼─────────┤
│           113052 │      12 │
└──────────────────┴─────────┘
La suma a nivel de fila infló el conteo de reseñas en un 23%. Tampoco puedes almacenar el precio a nivel del padre, porque las variantes de orejeras iban de $12.95 a $14.99. Escribe la granularidad de cada campo en el contrato de datos, y construye una tabla gold por granularidad.
La ubicación también es parte de la granularidad. Las ofertas y estimaciones de entrega pueden cambiar según la ubicación del comprador. Establece el código postal o país en cada entrada, y almacénalo con cada registro. El scraper de productos de Amazon toma un zipcode en cada entrada.
El precio suele ser varios campos. El campo coupon_description, por ejemplo, contenía una oferta de compra múltiple en 1 de los 20 productos. En otros 5, contenía una prueba gratuita de Amazon Music, que no es un descuento de precio. La insignia Savings en la captura de Bose de arriba es una de esas pruebas.
Almacena el precio de lista, precio de oferta, tipo de promoción y texto del cupón por separado, y parsea un cupón antes de contarlo como descuento. Declara los tipos también, porque JSON escribe $449 como 449, y un cargador que infiere tipos de una muestra puede hacer del precio un entero.
Empareja productos entre minoristas
Una coincidencia de título puede unir un par de auriculares con los auriculares inalámbricos que comparten su nombre de producto, así que empareja por identificadores. Pero los identificadores a menudo faltan o son inconsistentes. Solo 7 de los 20 listados de Amazon mostraban un UPC (Código Universal de Producto) en la página. Sony también escribió un modelo base de 2 formas, como WH-CH720N/P y WHCH720N/W.
Así que empareja en orden de confianza. Comienza con un GTIN (Número Global de Artículo Comercial), como un UPC. Luego, prueba marca más un número de modelo normalizado, luego una coincidencia de título con un umbral de confianza. Normaliza los números de modelo eliminando separadores y sufijos de color.
De los 20 productos, solo 6 no tenían ni UPC ni número de modelo, y los 6 eran variantes de un producto. Así que solo las coincidencias de título de ese producto necesitaron revisión humana.
Establece horarios de actualización según la rapidez con que cambian los datos
Los datos web pierden valor a diferentes velocidades, y el horario de actualización debe coincidir. Incluso los campos de un registro cambian a diferentes velocidades. Las ejecuciones por hora de la lista a vigilar muestran cuánto:
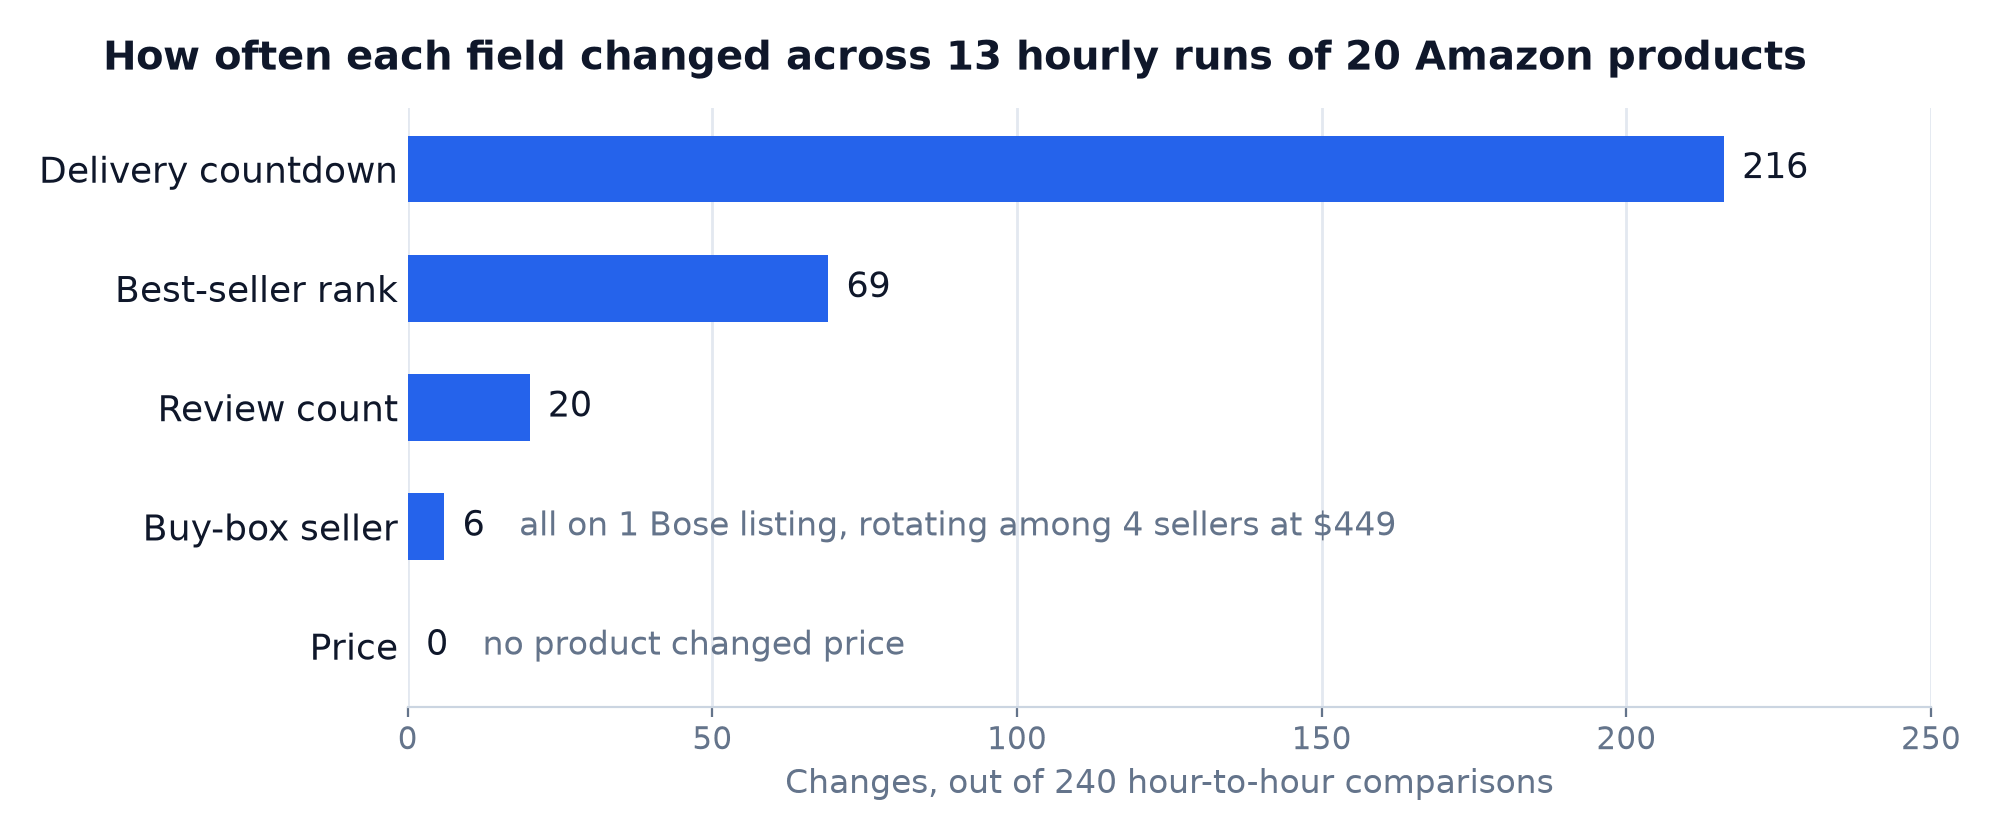
Recolectado con el Web Scraper API. La cuenta regresiva de entrega es el mensaje de Amazon “Ordena en 2 hrs 44 mins”.
En un listado de Bose, el buy box se movió entre 4 vendedores 6 veces mientras el precio se mantuvo en $449. Un monitor que rastreara solo el precio se habría perdido cada cambio.
Agrupa productos según la rapidez con que cambian sus campos clave, y da a cada grupo su propio horario de recolección, así el gasto va donde cambian los datos. Ejecuta un trabajo pequeño varias veces al día, en horas variadas, en productos donde el buy box importa, y un trabajo diario para el resto.
El rastreo incremental reduce el costo de la frescura al re-recolectar solo las páginas con probabilidad de haber cambiado, usando señales como las fechas lastmod en los sitemaps. Después de la recolección, compara un hash de los campos que usa tu contrato, así las etapas posteriores solo reprocesan registros cambiados.
En la prueba de consulta, el hash del HTML en bruto difirió en cada consulta repetida. En las 240 comparaciones hora a hora de las ejecuciones por hora, un hash de registro completo cambió en 239. La mayoría de esos cambios provenían de la cuenta regresiva de entrega. Un hash de los 8 campos del contrato distintos de la marca de tiempo cambió solo 26 veces, cada uno un cambio real en el conteo de reseñas o vendedor buy-box.
Una mediana de antigüedad baja puede ocultar unos pocos registros muy antiguos. Así que mide la frescura como una distribución, con antigüedad p50 y p99 por fuente, y alerta sobre el p99.
Arquitectura de pipeline de datos para IA y agentes
Un pipeline de IA usa las mismas 5 etapas, generalmente con un modelo o un agente en la etapa de entrega.
Deja que un LLM escriba parsers para fuentes de alto volumen
La pregunta principal es si un modelo de lenguaje grande debería extraer datos de cada página. Una página de producto de Amazon, contada con el tokenizador o200k_base, ayuda a responderla:
| Forma de la misma página de producto | Bytes | Tokens |
|---|---|---|
| Página completa como HTML en bruto | 2,446,738 | 911,129 |
| Página completa como markdown | 236,088 | 97,977 |
| Solo contenido principal, extraído del HTML en bruto | 17,339 | 3,252 |
| Registro JSON completo, todos los campos | 23,923 | 7,692 |
| Registro JSON recortado (12 campos) | 501 | 171 |
El markdown de página completa le viene bien a un agente que lee una página, pero a alto volumen, los equipos generalmente reducen las páginas a su contenido principal antes de la extracción. Reducida de esta manera, la página aún usó 19 veces los tokens del registro de 12 campos. A un ejemplo de $0.10 por 1M de tokens de entrada, 100K de esas páginas al día cuestan unos $33 en entrada de modelo. Leer los registros de 12 campos en su lugar costaría unos $2.
Ambas cifras excluyen la recolección, que cada camino paga a una tasa diferente. Así que compara el costo total, no solo el costo de tokens. El contenido principal extraído se abría con una venta adicional de garantía, y un modelo que lo lee aún puede elegir el precio o variante equivocados. Un registro del Web Scraper API entrega el precio y la variante como campos separados, así ningún modelo tiene que extraerlos del texto de la página.
Elige el enfoque según volumen y riesgo. Para una fuente recolectada miles de veces al día, usa el modelo para escribir el parser y arreglarlo cuando falle. El código ordinario entonces ejecuta ese parser en cada página y devuelve la misma salida para la misma página. Scraper Studio ejecuta este patrón como un servicio, construyendo un scraper desde una instrucción en lenguaje natural, con auto-reparación de un clic cuando el sitio cambia.
Para sitios de bajo volumen cuyos diseños cambian a menudo, la extracción con LLM por página puede costar menos que mantener un parser. De cualquier forma, verifica la salida contra el mismo contrato.
Cuando falla la validación, un agente de codificación puede proponer una corrección de parser y reproducirla sobre las páginas en bruto en la capa bronze. La reproducción muestra cuántas filas en cuarentena recupera la corrección y si alguna fila aceptada cambió, y un humano revisa ambas antes de fusionar.
Sirve a los agentes desde tablas validadas
Para los agentes, una consulta en vivo es más riesgosa que una lectura de tabla, porque una consulta bloqueada puede detener la tarea de un agente mientras un usuario espera. En septiembre de 2026, por ejemplo, Cloudflare cambió los valores predeterminados para dominios recién añadidos, bloqueando agentes de IA y bots de entrenamiento en páginas que muestran anuncios. Así que sirve a los agentes desde tablas validadas primero, a través de una interfaz MCP que incluya las reglas de uso del contrato.
Los agentes también necesitan una verificación de inyección de instrucciones, porque el texto de la página, incluyendo campos de reseñas y títulos en tus tablas, puede contener instrucciones dirigidas a un agente. Para lecturas en vivo, el MCP Server de Bright Data tiene una puerta de contenido, activada por defecto. Pide al usuario confirmar antes de devolver texto de página que parece instrucciones para cambiar la configuración del servidor.
Rastrea las respuestas de IA como una fuente de datos
Los asistentes de IA también son una fuente de datos, porque sus respuestas pueden llegar a un comprador antes que cualquier resultado de búsqueda. En una prueba, la primera recomendación de ChatGPT para la misma pregunta de compras fue Bose en 3 de 5 ejecuciones y Sony en 2. Así que muestrea cada instrucción varias veces, y mantén el mismo país en cada ejecución para que los resultados sigan siendo comparables. Los scrapers de chat de IA del Web Scraper API recolectan respuestas de ChatGPT, Copilot, Gemini, Perplexity y Grok, con sus citas como JSON estructurado.
Construir o comprar la capa de recolección
La mayor parte de la infraestructura de pipeline de datos, incluyendo almacenamiento, transformación y orquestación, funciona con herramientas bien establecidas. La recolección de sitios web protegidos es diferente, porque tiene que cambiar cada vez que cambian los navegadores y las defensas anti-bots.
Compara costos por registro aceptado, no por solicitud. Web Unlocker factura solo por resultados exitosos, y el Web Scraper API solo por registros entregados. Divide el gasto total entre los registros que cumplen tu contrato.
Del lado de construir, incluye las horas de ingeniero dedicadas a proxies, correcciones de parsers y desbloqueo. En ambos lados, cuenta lo que cuesta una entrega mala, como una decisión de repricing basada en precios incorrectos.
Compara recolectores en tus propias URLs
Obtén estos costos de un benchmark, de la forma en que muchos equipos de compra evalúan proveedores en una prueba de concepto. Ejecuta tu recolector actual y cada candidato en las mismas URLs durante varios días, desde la red y con la concurrencia que tu pipeline realmente usa. Compara cada candidato según las mismas medidas:
| Medida | Cómo contarla |
|---|---|
| Registros aceptados | Filas que cumplen tu contrato de datos, por fuente |
| Fallos por razón | Bloqueos, desafíos y respuestas exitosas que fallan tu verificación de contenido, como páginas vacías o de región equivocada |
| Costo por 1K registros aceptados | Todo el gasto, incluyendo reintentos, proxies y las horas de ingeniero de abajo, por 1K filas aceptadas |
| Latencia | Tiempo p50 y p95 de entrega, para trabajos por lotes y consultas en vivo |
| Horas de ingeniero | Tiempo dedicado a bloqueos, correcciones de parsers y alertas durante la prueba |
Los créditos gratis mensuales de Bright Data pueden cubrir una primera prueba en una muestra de tus URLs.
Decide por fuente
Decide por cada fuente por separado, porque un pipeline generalmente mezcla sitios protegidos y no protegidos. Cuenta un sitio como protegido cuando tu propio cliente falla la verificación de contenido en él durante el benchmark:
| Situación | Construir | Comprar |
|---|---|---|
| Algunos sitios no protegidos, recolectados ocasionalmente | Sí | Comienza con créditos gratis, luego pasa a pago por uso a medida que crece el volumen |
| Sitios protegidos, recolectados según un horario | Solo con un equipo que rastree lanzamientos de navegadores, y generalmente con proxies residenciales | Web Unlocker o Browser API gestiona el acceso, así tu equipo solo escribe los parsers |
| Sitios donde necesitas registros, no páginas | A menudo no vale la pena a menos que el sitio sea central para tu producto | El Web Scraper API devuelve JSON estructurado, y Scraper Studio construye scrapers personalizados desde una instrucción |
| Datos que necesitas pero no necesitas recolectar tú mismo | No | Conjuntos de datos, actualizados según un horario con solo registros nuevos o actualizados, o el Web Archive API para páginas ya recolectadas |
| Agentes que navegan o buscan en vivo | Solo para herramientas internas pequeñas | MCP Server, que usa la API SERP y Web Unlocker |
Un contrato de datos también facilita cambiar el recolector, así probar uno nuevo es de bajo riesgo. Las tablas, alertas y notificaciones posteriores dependen solo de los campos del contrato. Cambiar significa conectar la etapa de recolección a un nuevo recolector y volver a ejecutar el benchmark en tus propias URLs. Sigue rastreando la tasa de aceptación de cada fuente, porque los sitios cambian sus defensas con el tiempo.
Para la planificación de presupuesto, la página de precios del Web Scraper API lista las tarifas de pago por uso actuales y planes por volumen. La guía de métricas de calidad de datos ayuda a definir “aceptado” antes de comparar costos.
Cumplimiento y procedencia
Recolecta solo datos públicos, sin iniciar sesión y a tasas de solicitud que cada sitio pueda manejar. Recolecta datos personales solo donde tengas una base legal, y verifica el estado de derechos de autor de cualquier cosa que vuelvas a publicar o con la que entrenes.
Mantén la procedencia con cada registro, incluyendo URL de fuente, hora de recolección, método, versión de código y los términos de servicio que aplicaban. Así podrás mostrar dónde y cómo se recolectó cualquier registro.
Bright Data tiene certificación ISO 27001 y un informe SOC 2 Tipo II, ambos listados en su resumen de seguridad.
Cómo se ejecutaron las pruebas
Cada prueba se ejecutó contra sitios y servicios en vivo, que cambian con el tiempo:
| Prueba | Configuración |
|---|---|
| Prueba de consulta | Cada uno de 4 clientes de código abierto consultó 13 páginas de búsqueda y listados 3 veces. Los clientes fueron Python requests con encabezados predeterminados, requests con encabezados de Chrome, curl_cffi con su objetivo Chrome 150, y Chrome headless 155 a través de Playwright. Todos se ejecutaron desde una conexión de internet doméstica en India, sin proxies. Una respuesta se contó como datos cuando tenía los patrones HTML que marcan los listados del sitio, y un detector separado verificó 8 firmas de páginas de bloqueo. Una repetición headless con un User-Agent normal consultó cada página 2 veces. |
| Verificación de huella digital | Handshakes TLS de Web Unlocker, Python requests, curl_cffi (objetivo Chrome 150), y Chrome 155 instalado, comparados en tls.peet.ws |
| Consulta de agente | Las mismas 13 URLs, una ejecución a través de la herramienta WebFetch que usan los agentes de Claude Code |
| Pipeline de referencia | 20 productos de Amazon más 1 ID deliberadamente inválido, Web Scraper API, 2 ejecuciones con unas 2 horas de diferencia y una tercera unas 17 horas después |
| Ejecuciones por hora | Los mismos 20 productos, 13 ejecuciones con una hora de diferencia, 240 comparaciones hora a hora |
| Descubrimiento | Una búsqueda de Google de un modelo de auriculares a través de la API SERP |
| Conteos de tokens | Una página de producto de Amazon a través de Web Unlocker (HTML y markdown) y el Web Scraper API (JSON), tokenizador o200k_base, contenido principal extraído con trafilatura 2.3 |
| Respuestas de IA | Una pregunta de compras a ChatGPT a través del Web Scraper API, 5 ejecuciones sin país establecido |
Reflexiones finales
Cuando un pipeline de datos recolecta de sitios web públicos, una respuesta puede tener un estado de éxito y ningún dato, y un registro puede mezclar varias granularidades.
Almacena los datos en bruto sin cambios, verifica el contenido contra un contrato de datos, marca cambios inusuales, y reproduce cualquier corrección de parser que un agente proponga antes de fusionarla. Si la capa de recolección cuesta más en tiempo de ingeniero que en solicitudes, el Web Scraper API puede ejecutar esa etapa por tu equipo. Comienza ejecutando una verificación de contenido en tu fuente menos confiable, y cuenta cuántas de sus respuestas exitosas contienen registros utilizables. Luego ejecuta las mismas URLs a través de Web Unlocker o el Web Scraper API en una cuenta gratuita de Bright Data, y compara el costo por registro aceptado.
Preguntas frecuentes
¿Qué son los data pipes?
“Data pipes” es un nombre informal para los pipelines de datos, los sistemas que mueven datos desde sus fuentes hacia las herramientas que los usan. Uno típico recolecta, almacena, verifica, transforma y entrega datos. La arquitectura de pipeline de datos es su diseño, que define las etapas, las herramientas y las verificaciones entre ellas.
¿Qué es el data pipelining?
El data pipelining es la práctica de construir y ejecutar pipelines de datos, que mueven datos desde las fuentes hacia las herramientas que los usan. El trabajo cubre recolectar, almacenar, verificar, transformar y entregar datos, además de programar y monitorear cada etapa. No es lo mismo que el pipelining de instrucciones en CPUs, que superpone pasos del procesador dentro de un chip.
¿Cuáles son los 5 pasos de un pipeline de datos?
Los 5 pasos de un pipeline de datos típico son recolectar, almacenar en bruto, validar, transformar y entregar. La recolección extrae datos de las fuentes, y el almacenamiento en bruto los mantiene sin cambios. La validación los verifica contra un contrato de datos, la transformación los modela en tablas, y la entrega los lleva a dashboards, modelos o agentes.
¿Qué es una arquitectura de pipeline de datos moderna?
Una arquitectura de pipeline de datos moderna generalmente almacena datos en bruto en almacenamiento de objetos y mantiene las tablas en un formato abierto como Apache Iceberg. Transforma datos con una herramienta como dbt y programa etapas con un orquestador como Airflow. Un contrato de datos controla lo que entra en las tablas, y los agentes pueden leerlas a través del Model Context Protocol (MCP).
¿Cuáles son algunos ejemplos de pipelines de datos?
Un lote nocturno de precios de competidores cargado en un warehouse es un ejemplo común. Un flujo de publicaciones sociales procesado en minutos para monitoreo de marca es otro. Uno híbrido mantiene historial diario y transmite cambios para una lista corta a vigilar, y un pipeline bajo demanda consulta datos en vivo cuando un agente pregunta. Los 4 usan las mismas 5 etapas.
¿Puede la IA crear pipelines de datos?
Sí, un agente de codificación puede escribir la mayor parte del código de un pipeline mientras un humano revisa cada cambio. Para la recolección, Scraper Studio de Bright Data construye un scraper desde una instrucción en lenguaje natural. La extracción con LLM por página funciona si cada salida cumple el contrato de datos, pero usa más tokens. El contenido principal de una página de Amazon fue de 3,252 tokens, contra 171 para un registro de 12 campos.
¿Qué es un pipeline de ingesta de datos?
Un pipeline de ingesta de datos, la primera parte de un pipeline de datos, recolecta y almacena datos de fuentes. Las fuentes web necesitan una verificación de contenido. En una prueba de clientes de código abierto en 13 sitios, 39 de 88 respuestas exitosas no tenían datos. Para sitios con defensas anti-bots, Web Unlocker de Bright Data devuelve la página, o el Web Scraper API devuelve registros estructurados.
¿Qué es un pipeline de big data?
Un pipeline de big data es un pipeline de datos construido para volúmenes donde el almacenamiento y el cómputo deben escalar por separado. Generalmente almacena datos en almacenamiento de objetos y los mantiene en formatos de tablas abiertos como Apache Iceberg o Delta Lake. Motores distribuidos como Spark o Flink lo procesan.