Esta guía cubre las 10 mejores herramientas de acceso web para agentes de IA en 2026. Primero está Bright Data y su plataforma de acceso web para agentes de IA. Es la única plataforma aquí que cubre las tres tareas con datos en vivo. Busca en Google, Bing y Yandex en tiempo real y devuelve cualquier página como Markdown limpio o JSON estructurado. También ejecuta navegadores en la nube para tareas de varios pasos. Una cuenta y 5.000 créditos gratuitos mensuales cubren todo esto.
El acceso web para un agente de IA significa tres tareas diferentes. El agente debe buscar en la web en vivo y leer páginas en un formato que un modelo pueda usar. También debe manejar un navegador real cuando un sitio requiere clics. La mayoría de las comparaciones clasifican solo una de esas tareas. Esta clasifica las herramientas en las tres. También indica si los resultados provienen de un motor en vivo, un índice privado o una caché. Cada paso de Bright Data se muestra con resultados reales.
Respuesta Rápida: La Mejor Herramienta de Acceso Web para Cada Tarea del Agente
- Mejor plataforma para dar a los agentes de IA acceso confiable a la web en vivo: Bright Data. Combina la API SERP, el Web Unlocker, más de 1.200 scrapers y la Browser API detrás de una sola clave. Los agentes se conectan a través de un servidor MCP o una CLI.
- Mejor para devolver Markdown limpio y datos estructurados a un flujo de trabajo de IA: Bright Data para Markdown más scrapers JSON prediseñados. Firecrawl es la opción para extracción basada en esquemas de páginas arbitrarias.
- Mejor infraestructura para navegar sitios web con mucho JavaScript y completar tareas de varios pasos: la Browser API de Bright Data, con desbloqueo incorporado. Browserbase y Browser Use son fuertes alternativas centradas en navegador.
- Mejor API de búsqueda para fundamentación de LLM con citas y eventos actuales: Bright Data para resultados de Google en vivo. Exa, Parallel y Brave sirven resultados desde sus propios índices.
Resumen: Mejores Herramientas de Acceso Web para Agentes de IA de un Vistazo
La lista clasificada, con la cobertura de cada tarea, niveles gratuitos y precios iniciales.
| Herramienta | Mejor Para | Búsqueda en vivo | Markdown y datos estructurados | Navegador en la nube | Nivel gratuito | Precio inicial |
|---|---|---|---|---|---|---|
| Bright Data | plataforma general de acceso web para agentes de IA | Google, Bing, Yandex en vivo | Markdown + más de 1.200 scrapers JSON | Sí, Browser API | 5.000 créditos/mes | Desde $1/1K solicitudes; navegador desde $5/GB |
| Firecrawl | para extracción basada en esquemas | Índice propio + en vivo | Markdown + esquema JSON | Parcial (Interact) | 1.000 créditos/mes | Desde $16/mes (anual) |
| TinyFish | nivel gratuito de búsqueda y obtención | Sí (TinySearch) | Markdown o JSON | Sí, más ejecuciones de agente | Búsqueda y obtención gratis, con límite de tasa | Navegador $0,002/min |
| Browserbase | para flotas de navegadores headless | Revendida (Parallel, Exa) | Markdown o esquema JSON | Sí | 1 hora de navegador + 1K llamadas de búsqueda/obtención | Desde $20/mes |
| Tavily | para resultados de búsqueda RAG fragmentados | Sí | Markdown o texto | No | 1.000 créditos/mes | Desde $30/mes |
| Exa | para búsqueda semántica | Índice propio | Contenido de página + resúmenes LLM | No | $10 de crédito/mes | Búsqueda desde $4/1K |
| Parallel | para extractos comprimidos | Índice propio | Páginas completas o extractos | No | Hasta 5.000 solicitudes/mes | Búsqueda $1 a $5/1K |
| Apify | mercado de actores prediseñados | Vía actor RAG Web Browser | Markdown + conjuntos de datos de actores | Parcial (los actores ejecutan navegadores) | $5 de crédito/mes | Desde $1,33/1K páginas |
| Browser Use | agente de navegador de código abierto | No | Vía salida del agente | Sí, Chromium sigiloso | Crédito único de $1 | $0,02/hr + $5/GB de proxy |
| Brave Search API | índice de búsqueda independiente | Índice propio | No | No | $5 de crédito/mes | $5/1K solicitudes |
¿Qué Es una Herramienta de Acceso Web para Agentes de IA?
Una herramienta de acceso web le da a un agente de IA una forma de llegar a la web pública mientras trabaja. Expone herramientas para buscar, obtener páginas, extraer campos y controlar un navegador. Los agentes llaman a estas herramientas a través de una API, un servidor MCP, una CLI o un SDK. La herramienta maneja lo que un modelo no puede: bloqueos, CAPTCHAs, renderizado de JavaScript y convertir HTML en texto que un modelo pueda leer.
De dónde proviene el dato importa tanto como el formato. Un motor de búsqueda en vivo devuelve lo que una persona ve en Google o Bing ahora mismo. Un índice privado devuelve páginas que el proveedor rastreó antes, clasificadas por su propio modelo. Una caché devuelve una copia almacenada de una página, que puede tener horas o días de antigüedad. Para precios, noticias y notas de lanzamiento, un agente necesita datos en vivo o una forma explícita de solicitarlos.
¿Qué Herramienta de Acceso Web Se Ajusta a Cada Tarea?
Relaciona la tarea que hace tu agente con las herramientas que la cubren. La mayoría de los agentes hacen más de una tarea, por lo que la cobertura en las tres importa.
| Tarea del agente | Qué necesita el agente | Mejor opción | Alternativas |
|---|---|---|---|
| Búsqueda web en vivo y fundamentación de LLM | Resultados actuales con URLs para citar, incluyendo noticias y resultados locales | Bright Data SERP API | Tavily, Exa, Parallel, Brave |
| Markdown limpio y datos estructurados | Texto de página sin elementos sobrantes, o campos JSON tipados | Bright Data Web Unlocker y Web Scraper API | Firecrawl, TinyFish, Apify |
| Sitios con mucho JavaScript y tareas de varios pasos | Un navegador real que pueda hacer clic, escribir, desplazarse e iniciar sesión | Bright Data Browser API | Browserbase, Browser Use, TinyFish |
| Rastreo de sitio completo | Cada página bajo un dominio en un formato listo para LLM | Bright Data Crawl API | Firecrawl, Apify |
Cómo Se Clasifican Estas Herramientas
Cada herramienta aquí ofrece una API construida para agentes de IA y cubre al menos una de las tres tareas. Los datos de proveedores provienen de las propias páginas de precios y documentación de cada proveedor, a octubre de 2026. Las herramientas se puntúan según siete factores.
- Cobertura de tareas: búsqueda, Markdown y datos estructurados, y navegadores en la nube.
- Frescura: resultados de motor en vivo y lecturas de página en vivo, o un índice o caché.
- Desbloqueo: manejo de verificaciones de bots, CAPTCHAs y páginas restringidas por geolocalización.
- Salida: Markdown limpio, JSON con un esquema y resultados eficientes en tokens.
- Interfaces de agente: un servidor MCP alojado, SDKs y una CLI.
- Nivel gratuito: las asignaciones mensuales puntúan más que los créditos únicos.
- Confianza: certificaciones de seguridad y cumplimiento publicado.
Las 10 Mejores Herramientas de Acceso Web para Agentes de IA en 2026
1. Bright Data
Bright Data brinda a los agentes de IA los tres tipos de acceso web desde una sola plataforma. La API SERP devuelve resultados en vivo de Google, Bing y Yandex, incluyendo noticias, compras y resultados locales por país. El Web Unlocker devuelve cualquier página pública como Markdown limpio o HTML, y maneja CAPTCHAs, verificaciones de bots y reintentos. La Web Scraper API añade más de 1.200 scrapers prediseñados que devuelven JSON tipado, para sitios como Amazon y Best Buy. La Browser API ejecuta navegadores en la nube que Playwright, Puppeteer o Selenium controlan vía CDP, con desbloqueo incorporado. Los agentes acceden a todo esto a través del servidor MCP de Bright Data alojado, la CLI, o SDKs de Python y Node.js. Logró la tasa de éxito promedio más alta, 98,87%, de las 16 APIs de scraping en el benchmark 2026 de Scrape.do.
Detalles clave:
- Mejor para: agentes que necesitan búsqueda en vivo, lectura de páginas, datos estructurados y navegadores desde un solo proveedor.
- Productos: SERP API, Web Unlocker, Web Scraper API, Crawl API y Browser API.
- Interfaces de agente: servidor MCP alojado con OAuth, CLI de Bright Data, SDKs de Python y Node.js.
- Frescura: cada búsqueda y lectura de página se ejecuta en vivo contra la fuente.
- Nivel gratuito: 5.000 créditos al mes, sin tarjeta de crédito, compartidos entre búsqueda, lecturas de página, scrapers y la Browser API.
- Precios: búsqueda y lecturas de página desde $1 por 1.000 solicitudes; la Browser API desde $5/GB.
- Cumplimiento: informes SOC 2 y SOC 3, ISO 27701, y GDPR, listados en el Centro de Confianza.
Pros:
- Cubre búsqueda, Markdown, JSON estructurado, rastreo y navegadores con una sola clave.
- Resultados de Google en vivo, no un índice privado.
- Desbloqueo incorporado en cada producto, en una red de más de 400M de IPs.
- MCP, CLI y SDKs, así la misma cuenta se ajusta a apps de chat y agentes de código.
Contras:
- Muchos productos significa más opciones desde el primer día.
- Las búsquedas en vivo de Google tardan unos segundos, más lento que una búsqueda en índice.
⭐ Puntuación de reseñas: G2 4.7/5 (349 reseñas)
2. Firecrawl
Firecrawl es una API de datos web para búsqueda, scraping, rastreo e interacción con navegador. Devuelve Markdown limpio, y su modo JSON extrae campos que coinciden con un esquema que defines. La búsqueda se basa en su índice Alexandria o en una obtención en vivo. Las sesiones Interact añaden clics, desplazamiento y escritura en una página. La documentación de Firecrawl establece un maxAge predeterminado de dos días. Una lectura de página puede devolver una copia en caché a menos que solicites una nueva.
Detalles clave:
- Mejor para: extracción de JSON basada en esquemas desde páginas arbitrarias.
- Interfaces de agente: servidor MCP alojado, SDKs de Python y Node, y una CLI.
- Nivel gratuito: 1.000 créditos al mes, sin tarjeta de crédito.
- Precios: Hobby $19/mes, o $16/mes facturado anualmente, por 5.000 créditos.
- Cumplimiento: SOC 2 Tipo II.
Pros:
- Fuerte extracción de JSON basada en esquemas.
- Cubre búsqueda, scraping, rastreo e interacción con páginas.
- Gran comunidad de código abierto.
Contras:
- Lecturas de página en caché por defecto.
- Las sesiones de navegador cuestan 2 créditos por minuto además del scraping.
⭐ Puntuación de reseñas: G2 4.6/5 (94 reseñas)
3. TinyFish
TinyFish se llama a sí mismo el stack web para agentes de IA. TinySearch y TinyFetch son gratuitos y con límite de tasa, a 500 búsquedas por hora y 1.000 URLs obtenidas al día. TinyFetch renderiza JavaScript y devuelve Markdown, HTML o JSON. TinyBrowser ejecuta sesiones de navegador en la nube que controlas a través de CDP y Playwright, y TinyAgent ejecuta automatización de varios pasos. Su documentación indica que Fetch puede servir una entrada en caché a menos que establezcas un ttl de cero.
Detalles clave:
- Mejor para: equipos que quieren búsqueda y obtención gratuitas con navegadores en la misma cuenta.
- Interfaces de agente: servidor MCP alojado, SDKs de Python y Node, y una CLI.
- Nivel gratuito: búsqueda y obtención a $0, con límite de tasa, sin tarjeta.
- Precios: navegador a $0,002 por minuto, ejecuciones de agente a $0,016 por paso.
- Cumplimiento: ISO 27001 en el plan Enterprise.
Pros:
- Búsqueda y obtención gratuitas con límites publicados.
- Sesiones de navegador y un agente en una plataforma.
Contras:
- Fetch puede devolver páginas en caché por defecto.
- Las ejecuciones de agente se facturan por paso, lo que suma en tareas largas.
⭐ Puntuación de reseñas: G2 4.3/5 (103 reseñas)
4. Browserbase
Browserbase ejecuta navegadores headless en la nube para agentes de IA. Soporta Playwright, Puppeteer, Selenium, y su propio framework de código abierto Stagehand. Los planes pagos añaden resolución de CAPTCHA y proxies residenciales. Browserbase Fetch devuelve páginas como Markdown, HTML o JSON que coincide con un esquema. Su Search API funciona sobre Parallel y Exa, según su página de precios.
Detalles clave:
- Mejor para: equipos que ejecutan su propia automatización de navegador a gran escala.
- Interfaces de agente: servidor MCP alojado, SDKs de Node y Python, y la CLI Browse.
- Nivel gratuito: una hora de navegador, 1.000 llamadas de búsqueda y 1.000 llamadas de obtención.
- Precios: Developer $20/mes con 100 horas de navegador, luego $0,12 por hora; proxies $12/GB.
- Cumplimiento: SOC 2.
Pros:
- Plataforma de navegador madura con Stagehand.
- Fetch con salida de esquema JSON.
Contras:
- La búsqueda es revendida de otros proveedores.
- El tráfico de proxy se factura por separado.
⭐ Puntuación de reseñas: G2 4.3/5 (56 reseñas)
5. Tavily
Tavily es una API de búsqueda y extracción construida para agentes de IA, ahora parte de Nebius. Devuelve resultados clasificados y fragmentados listos para un modelo, con contenido de página opcional. Extract devuelve Markdown o texto plano. Los endpoints Crawl, Map y Research lo completan. No hay producto de navegador.
Detalles clave:
- Mejor para: pipelines RAG que quieren resultados de búsqueda fragmentados.
- Interfaces de agente: servidor MCP alojado, SDKs de Python y JavaScript, y una CLI.
- Nivel gratuito: 1.000 créditos al mes, sin tarjeta de crédito.
- Precios: Project $30/mes por 4.000 créditos, o $0,008 por crédito.
- Nota: una búsqueda básica cuesta 1 crédito; cinco URLs extraídas cuestan 1 crédito.
Pros:
- Los resultados llegan fragmentados para un modelo.
- Modelo de crédito simple.
Contras:
- Sin extracción de JSON estructurado por esquema.
- Sin navegador en la nube.
⭐ Puntuación de reseñas: G2 4.5/5 (3 reseñas)
6. Exa
Exa ejecuta su propio índice web con búsqueda neuronal para consultas basadas en significado. Su Contents API devuelve el texto completo de la página para un modelo, y los resúmenes pueden extraer campos en un esquema JSON. Exa describe su índice como el más grande independiente del mundo. Su documentación indica que Contents usa una copia en caché cuando está disponible a menos que solicites contenido fresco.
Detalles clave:
- Mejor para: búsquedas semánticas y de “encontrar similares”.
- Interfaces de agente: servidor MCP alojado, SDKs de Python y JavaScript.
- Nivel gratuito: $10 de crédito al mes más un bono de registro de $10.
- Precios: búsqueda desde $4 por 1.000 solicitudes; contenido $1 por 1.000 páginas.
- Cumplimiento: SOC 2 Tipo II, GDPR, y HIPAA con un BAA.
Pros:
- Fuerte búsqueda semántica.
- Crédito mensual renovable.
Contras:
- Los resultados provienen de su propio índice, no de un motor en vivo.
- Sin navegador en la nube.
⭐ Puntuación de reseñas: G2 4.4/5 (23 reseñas)
7. Parallel
Parallel construye APIs de búsqueda e investigación sobre su propio índice web. Search devuelve URLs clasificadas con extractos comprimidos, y Extract devuelve páginas completas o extractos. Su Task API ejecuta investigación profunda y devuelve enriquecimientos estructurados. Consulta nuestra comparación Bright Data vs. Parallel para una mirada más cercana.
Detalles clave:
- Mejor para: extractos densos en tokens para fundamentación.
- Interfaces de agente: servidor MCP alojado, SDKs de Python y TypeScript, y una CLI.
- Nivel gratuito: hasta 5.000 solicitudes al mes.
- Precios: búsqueda $0,001 a $0,005 por 10 resultados; extract $0,001 por solicitud.
- Cumplimiento: SOC 2 Tipo 2.
Pros:
- Extractos compactos mantienen el contexto pequeño.
- API de investigación profunda en la misma cuenta.
Contras:
- Los resultados provienen de su propio índice.
- Sin navegador en la nube, y sin listado en G2 todavía.
8. Apify
Apify es un mercado de scrapers listos para ejecutar llamados Actors. Su actor RAG Web Browser busca en Google, extrae las páginas principales en un navegador completo, y devuelve Markdown limpio. Miles de otros actores devuelven conjuntos de datos estructurados para sitios específicos. Un servidor MCP alojado permite a un agente encontrar y ejecutar actores.
Detalles clave:
- Mejor para: equipos que quieren un actor prediseñado para cada sitio.
- Interfaces de agente: servidor MCP alojado, clientes de JavaScript y Python, y una CLI.
- Nivel gratuito: $5 de crédito de plataforma al mes, sin tarjeta de crédito.
- Precios: RAG Web Browser desde $1,33 por 1.000 páginas obtenidas; Starter $19/mes.
- Cumplimiento: SOC 2, GDPR, y CCPA.
Pros:
- Enorme biblioteca de actores específicos de sitios.
- Fuerte posición en G2 entre 690 reseñas.
Contras:
- La calidad varía entre los actores de la comunidad.
- Sin producto de navegador CDP crudo para tu propio código de agente.
⭐ Puntuación de reseñas: G2 4.7/5 (690 reseñas)
9. Browser Use
Browser Use comenzó como una biblioteca de código abierto para agentes de navegador y ahora ejecuta una nube. Browser Use Cloud aloja Chromium sigiloso que manejas vía CDP con Playwright, Puppeteer, o la biblioteca browser-use. Browser Use Agents toman una tarea en lenguaje simple y la terminan en el navegador. No tiene API de búsqueda.
Detalles clave:
- Mejor para: equipos que ya construyen sobre la biblioteca browser-use.
- Interfaces de agente: servidor MCP alojado, SDKs de Python y TypeScript, y una CLI.
- Nivel gratuito: un crédito único de $1 para registros elegibles.
- Precios: navegadores en la nube a $0,02 por hora más $5/GB para proxies residenciales.
- Cumplimiento: SOC 2 Tipo II y HIPAA.
Pros:
- Agente de navegador de código abierto popular.
- Bajo precio de navegador por hora.
Contras:
- Sin APIs de búsqueda o lectura de página.
- El crédito gratuito es único.
⭐ Puntuación de reseñas: G2 4.3/5 (89 reseñas)
10. Brave Search API
La Brave Search API responde cada consulta desde el índice independiente propio de Brave. Su endpoint LLM Context devuelve solo el contenido que un modelo necesita, y Answers devuelve respuestas fundamentadas. No obtiene URLs arbitrarias ni ejecuta navegadores. Los términos de Brave restringen el almacenamiento de resultados y su uso para entrenar modelos de IA.
Detalles clave:
- Mejor para: un índice de búsqueda independiente para fundamentación.
- Nivel gratuito: $5 de créditos gratis al mes, prepagado.
- Precios: $5 por 1.000 solicitudes para búsqueda y LLM Context.
- Cumplimiento: SOC 2 Tipo II.
Pros:
- Índice independiente, no un revendedor.
- Precios simples por solicitud.
Contras:
- Solo búsqueda.
- Los términos restringen el almacenamiento de resultados.
Cómo Dar a un Agente de IA Búsqueda Web en Vivo con Citas
La fundamentación necesita resultados actuales y URLs que el modelo pueda citar. La API SERP devuelve la página de resultados en vivo, con títulos, enlaces y fragmentos clasificados. Las respuestas también incluyen bloques People Also Ask y AI Overview cuando Google los muestra. La CLI de Bright Data lo envuelve en un comando, así un agente de código puede buscar desde su shell.
  npm install -g @brightdata/cli
bdata login
bdata search "model context protocol specification latest version" --json
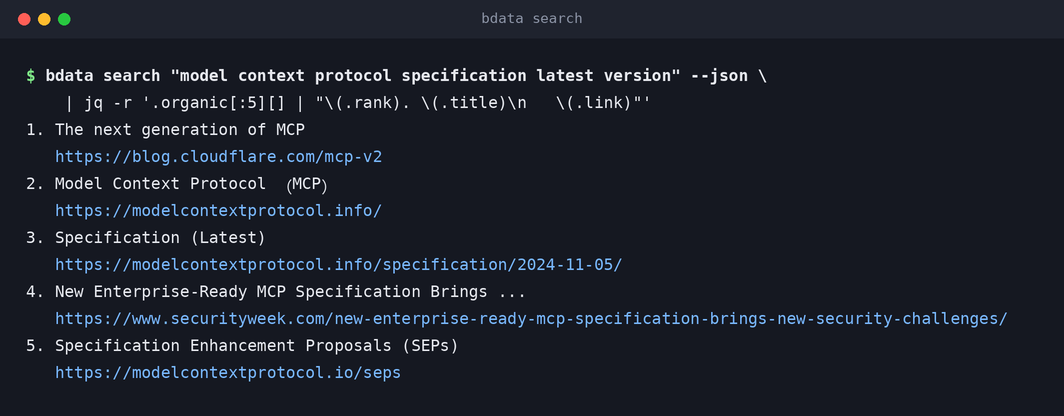
El agente lee las URLs clasificadas y las cita en su respuesta. Añade --type news para eventos actuales, o --country para resultados locales. Para una mirada más profunda a los costos de fundamentación, lee fundamentación SERP ligera con Bright Data MCP.
Cómo Devolver Markdown Limpio y Datos Estructurados a un Flujo de Trabajo de IA
Los agentes necesitan dos formatos. Markdown se adapta a leer y razonar sobre una página completa. El JSON estructurado se adapta a pipelines, comparaciones, y cualquier cosa que alimente una base de datos. El costo en tokens de cada uno es muy diferente, como muestra una página de producto de Best Buy.
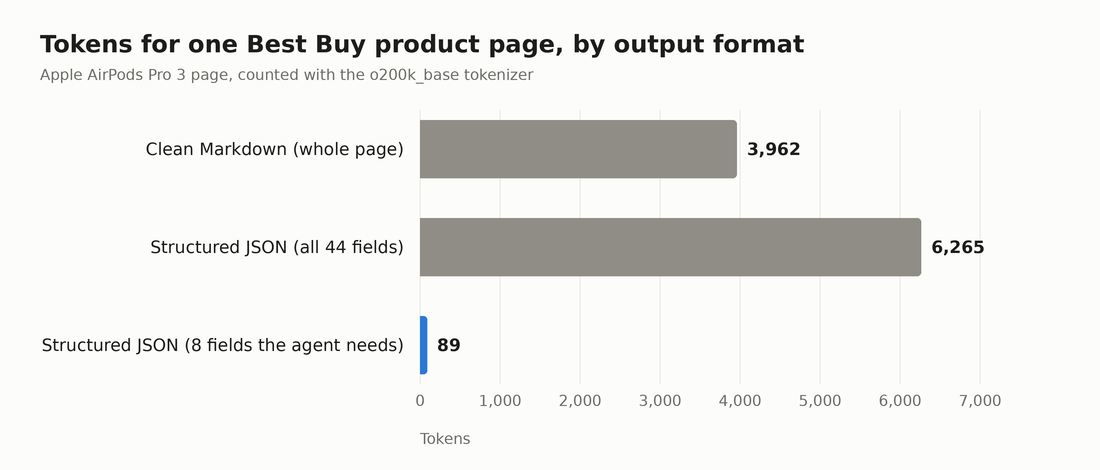
La página completa como Markdown limpio cuesta 3.962 tokens. El registro estructurado completo, con 44 campos, cuesta 6.265. Mantén solo los 8 campos que un agente necesita para una verificación de precio, y el registro baja a 89 tokens. Usa Markdown cuando el agente deba leer, y campos JSON cuando deba comparar o almacenar. Bright Data devuelve ambos desde la misma cuenta.
  # cualquier página como Markdown limpio (Web Unlocker)
bdata scrape "https://www.amazon.com/dp/B0DM63WNWL" -o page.md

# el mismo tipo de página como JSON tipado (Web Scraper API)
bdata pipelines search amazon product
bdata pipelines run gd_l7q7dkf244hwjntr0 collect_by_url "https://www.amazon.com/dp/B0DM63WNWL" --pretty
A través del servidor MCP, las mismas tareas son scrape_as_markdown para páginas, y search_scrapers más run_scraper para registros estructurados. Para un sitio completo, la Crawl API devuelve cada página como Markdown, texto, HTML o JSON.
Cómo Permitir que un Agente de IA Navegue Sitios Web con Mucho JavaScript y Complete Tareas de Varios Pasos
Algunas tareas necesitan un navegador real. Cuadros de búsqueda, filtros, inicios de sesión, y desplazamiento infinito solo funcionan cuando algo hace clic y escribe. La Browser API ejecuta esos navegadores en la nube, con huellas digitales, resolución de CAPTCHA, e IPs residenciales manejadas por ti. La CLI lo expone como comandos cortos. Un snapshot lista los elementos de la página con referencias, y el agente actúa sobre una referencia.
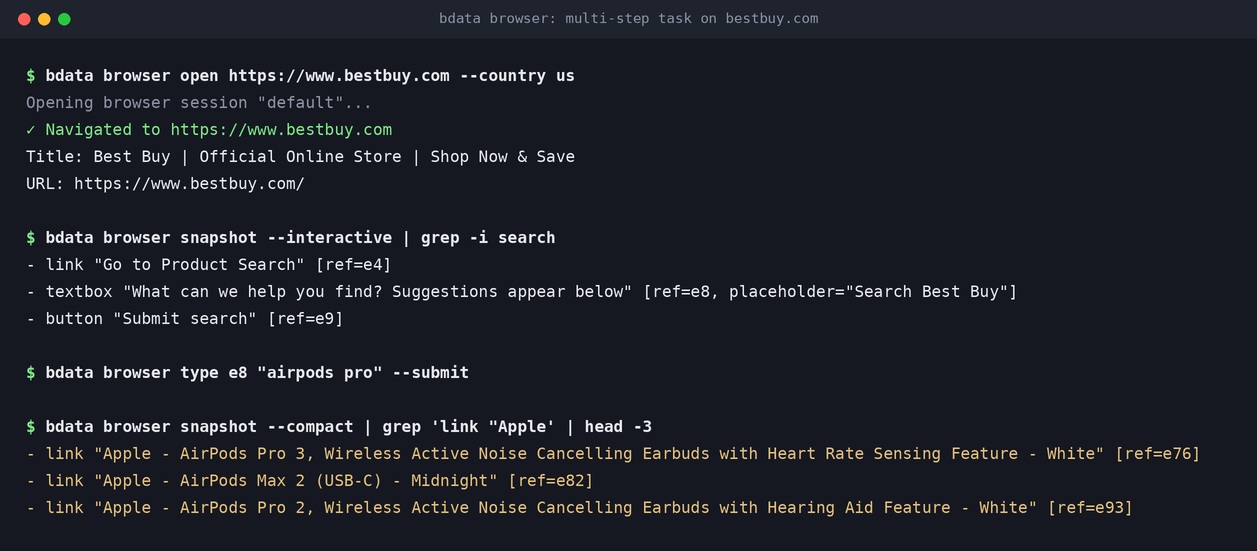
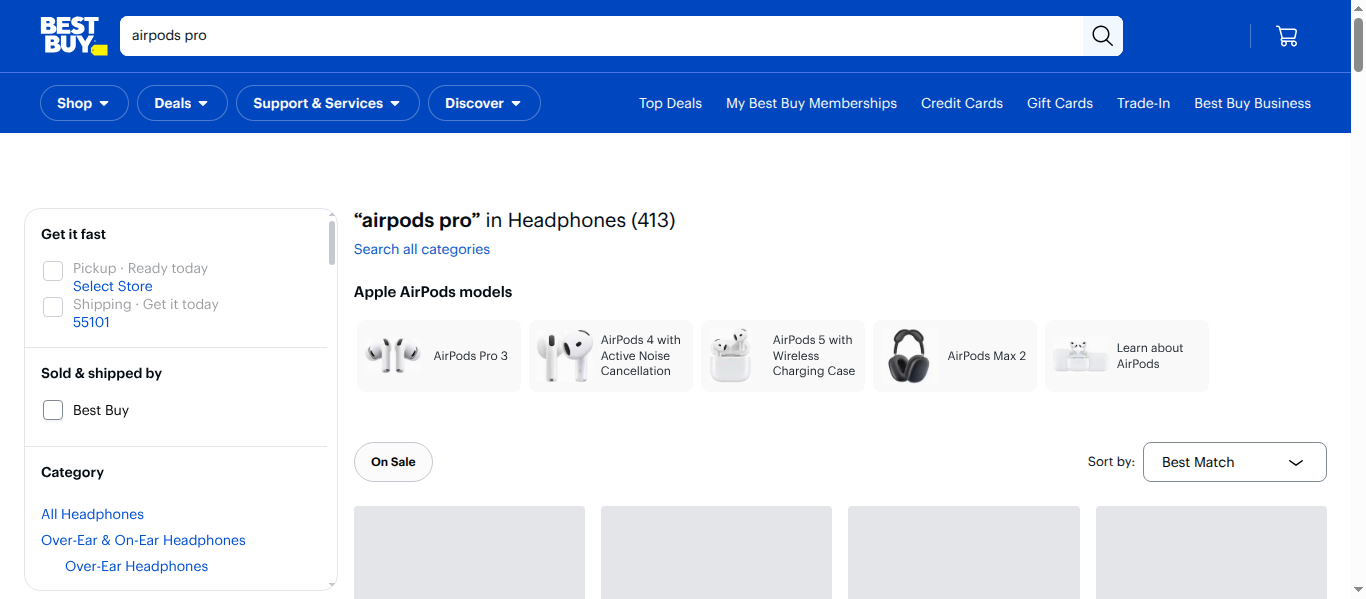
Los cuatro comandos anteriores abren bestbuy.com, encuentran el cuadro de búsqueda, ejecutan una búsqueda, y leen los resultados. Best Buy carga sus resultados con JavaScript detrás de la protección de bots de Akamai, y el navegador en la nube maneja ambos. Esta es la página que el navegador vio después de la búsqueda.
Tu propio código de agente puede manejar los mismos navegadores vía CDP. Conecta Playwright con tus credenciales de zona de la Browser API.
  import asyncio
from playwright.async_api import async_playwright

CDP = "wss://brd-customer-<customer_id>-zone-<zone>:<password>@brd.superproxy.io:9222"

async def main():
    async with async_playwright() as pw:
        browser = await pw.chromium.connect_over_cdp(CDP)
        page = await browser.new_page()
        await page.goto("https://www.bestbuy.com")
        print(await page.title())
        await browser.close()

asyncio.run(main())
En clientes MCP, añade groups=browser a la URL alojada para cargar las herramientas de navegador. Incluyen scraping_browser_navigate, scraping_browser_type_ref, y scraping_browser_click_ref. ¿Comparando plataformas de navegador? Consulta nuestra clasificación de los mejores navegadores de agente.
claude mcp add --transport http brightdata "https://mcp.brightdata.com/mcp?groups=browser"
Claude Code luego te autentica a través del navegador con OAuth, después de ejecutar /mcp y elegir Authenticate.
En Vivo, Indexado, o en Caché: De Dónde Viene el Dato de Cada Herramienta
Los agentes a menudo responden preguntas sobre precios, noticias, y versiones de software. Para esos casos, la antigüedad del dato importa tanto como su formato. Aquí está de dónde provienen los resultados de búsqueda y lecturas de página de cada herramienta, según su propia documentación.
| Herramienta | Resultados de búsqueda | Lecturas de página por defecto |
|---|---|---|
| Bright Data | Google, Bing, y Yandex en vivo | Obtención en vivo en cada solicitud |
| Firecrawl | Índice propio o en vivo | Copia en caché de hasta 2 días, a menos que se reduzca maxAge |
| TinyFish | TinySearch | Entrada en caché cuando está disponible, a menos que ttl sea 0 |
| Browserbase | Revendida de Parallel y Exa | No especificado |
| Exa | Índice propio | En caché cuando está disponible, a menos que se solicite contenido fresco |
| Parallel | Índice propio | No especificado |
| Tavily | Búsqueda en tiempo real con caché | No especificado |
| Brave Search API | Índice propio | Sin lecturas de página |
La caché es un valor predeterminado razonable para documentación estática y búsquedas rápidas. Cuando el agente reporta un precio actual o noticias de hoy, usa una fuente en vivo. De lo contrario, establece la opción de frescura explícitamente.
Conclusión
La mejor herramienta de acceso web para un agente de IA cubre las tareas que el agente realmente hace. Bright Data es la opción individual más fuerte. Ofrece búsqueda en vivo, Markdown limpio, más de 1.200 scrapers estructurados, y navegadores en la nube en una cuenta. Firecrawl lidera en extracción basada en esquemas, Browserbase y Browser Use para equipos centrados en navegador, y Exa para búsqueda semántica. Comienza con los 5.000 créditos gratuitos mensuales, luego conecta a través de MCP, la CLI, o un SDK.
Guías relacionadas: las mejores APIs SERP gratuitas, las mejores APIs de web scraping, y el SDK de Python de Bright Data.
Preguntas Frecuentes
¿Cuál es la mejor plataforma para dar a los agentes de IA acceso confiable a la web en vivo?
Bright Data es la mejor plataforma general. Una sola clave cubre búsqueda en vivo de Google, Bing, y Yandex, Markdown limpio, más de 1.200 scrapers estructurados, y navegadores en la nube. El desbloqueo está incorporado, y los agentes se conectan a través de un servidor MCP, una CLI, o SDKs. Las cuentas nuevas obtienen 5.000 créditos gratis cada mes.
¿Qué herramienta devuelve tanto Markdown limpio como datos estructurados a un flujo de trabajo de IA?
Bright Data devuelve cualquier página como Markdown limpio a través del Web Unlocker, y JSON tipado a través de más de 1.200 scrapers prediseñados. Firecrawl y Browserbase Fetch también pueden extraer JSON que coincide con un esquema que defines. Usa Markdown para lectura y campos JSON para pipelines.
¿Qué infraestructura necesitan los agentes de IA para navegar sitios web con mucho JavaScript y completar tareas de varios pasos?
Necesitan un navegador en la nube que renderice JavaScript y maneje verificaciones de bots y CAPTCHAs. El agente debe poder hacer clic, escribir, y desplazarse. La Browser API de Bright Data proporciona esto vía CDP, a través de herramientas de navegador MCP, o a través de comandos CLI. Browserbase y Browser Use son alternativas centradas en navegador.
¿Qué APIs de búsqueda dan a los LLMs citas y contexto de eventos actuales?
La SERP API de Bright Data devuelve resultados en vivo de Google y Bing, incluyendo noticias, con URLs para citar. Tavily, Exa, Parallel, y Brave también devuelven URLs. Exa, Parallel, y Brave sirven resultados desde sus propios índices en lugar de un motor de búsqueda en vivo.
¿Existe una herramienta de acceso web gratuita para agentes de IA?
Sí. Bright Data incluye 5.000 créditos gratis al mes, compartidos entre búsqueda, lecturas de página, scrapers, y la Browser API. Firecrawl y Tavily ofrecen 1.000 créditos gratis al mes, Exa $10 de crédito, y TinyFish búsqueda y obtención gratis con límite de tasa.
¿Debería un agente de IA usar MCP, una API, o una CLI para acceso web?
Usa MCP en apps de chat y frameworks de agente sin un shell. Usa una CLI cuando el agente se ejecuta en una terminal, ya que no añade definiciones de herramientas al contexto. Usa la API o un SDK dentro de tu propio código. Bright Data ofrece los tres en la misma cuenta.