La API de búsqueda web de Parallel responde a la consulta de un agente desde el propio índice de Parallel, con URLs clasificadas y extractos en Markdown. La API SERP de Bright Data obtiene la página de resultados en vivo del motor de búsqueda (SERP) de Google y otros motores. Devuelve la página que vería un usuario en un país o ciudad elegidos.
El primer resultado de Google para “plomero de emergencia” en Chicago fue un map pack de 3 negocios locales. Parallel devolvió páginas clasificadas sin map pack, por lo que el agente se perdería lo que ven primero los usuarios de Chicago.
Esta guía compara ambas opciones en resultados, ubicación, precios y contenido de página completa, con código ejecutable.
Resumen
- Elige Bright Data cuando la respuesta depende de lo que muestra Google. Devuelve la página de Google, y el modo Advanced de Parallel devolvió del 35 al 43% de las URLs de esa página en 30 consultas.
- Elige Parallel cuando la clasificación de Google no importa. El modo Advanced devolvió una mediana de 4.082 tokens de extractos por 10 resultados.
- Los resultados locales suelen cambiar según la ciudad. Las páginas de Google para 3 ciudades no compartieron ninguna URL orgánica en 3 de 4 consultas, y la configuración de ubicación de Parallel aceptaba países, no ciudades.
- Agregar Bright Data requiere solo una entrada de configuración MCP. Una clave funciona para búsqueda y scraping. El plan gratuito no requiere tarjeta de crédito.
Qué devuelven Bright Data y Parallel
Bright Data y Parallel responden a la misma solicitud de un agente desde fuentes diferentes. Bright Data obtiene la página de resultados en vivo del motor de búsqueda, y Parallel consulta su propio índice de búsqueda.
Con un SERP en vivo, el agente también puede obtener las páginas completas que elija:
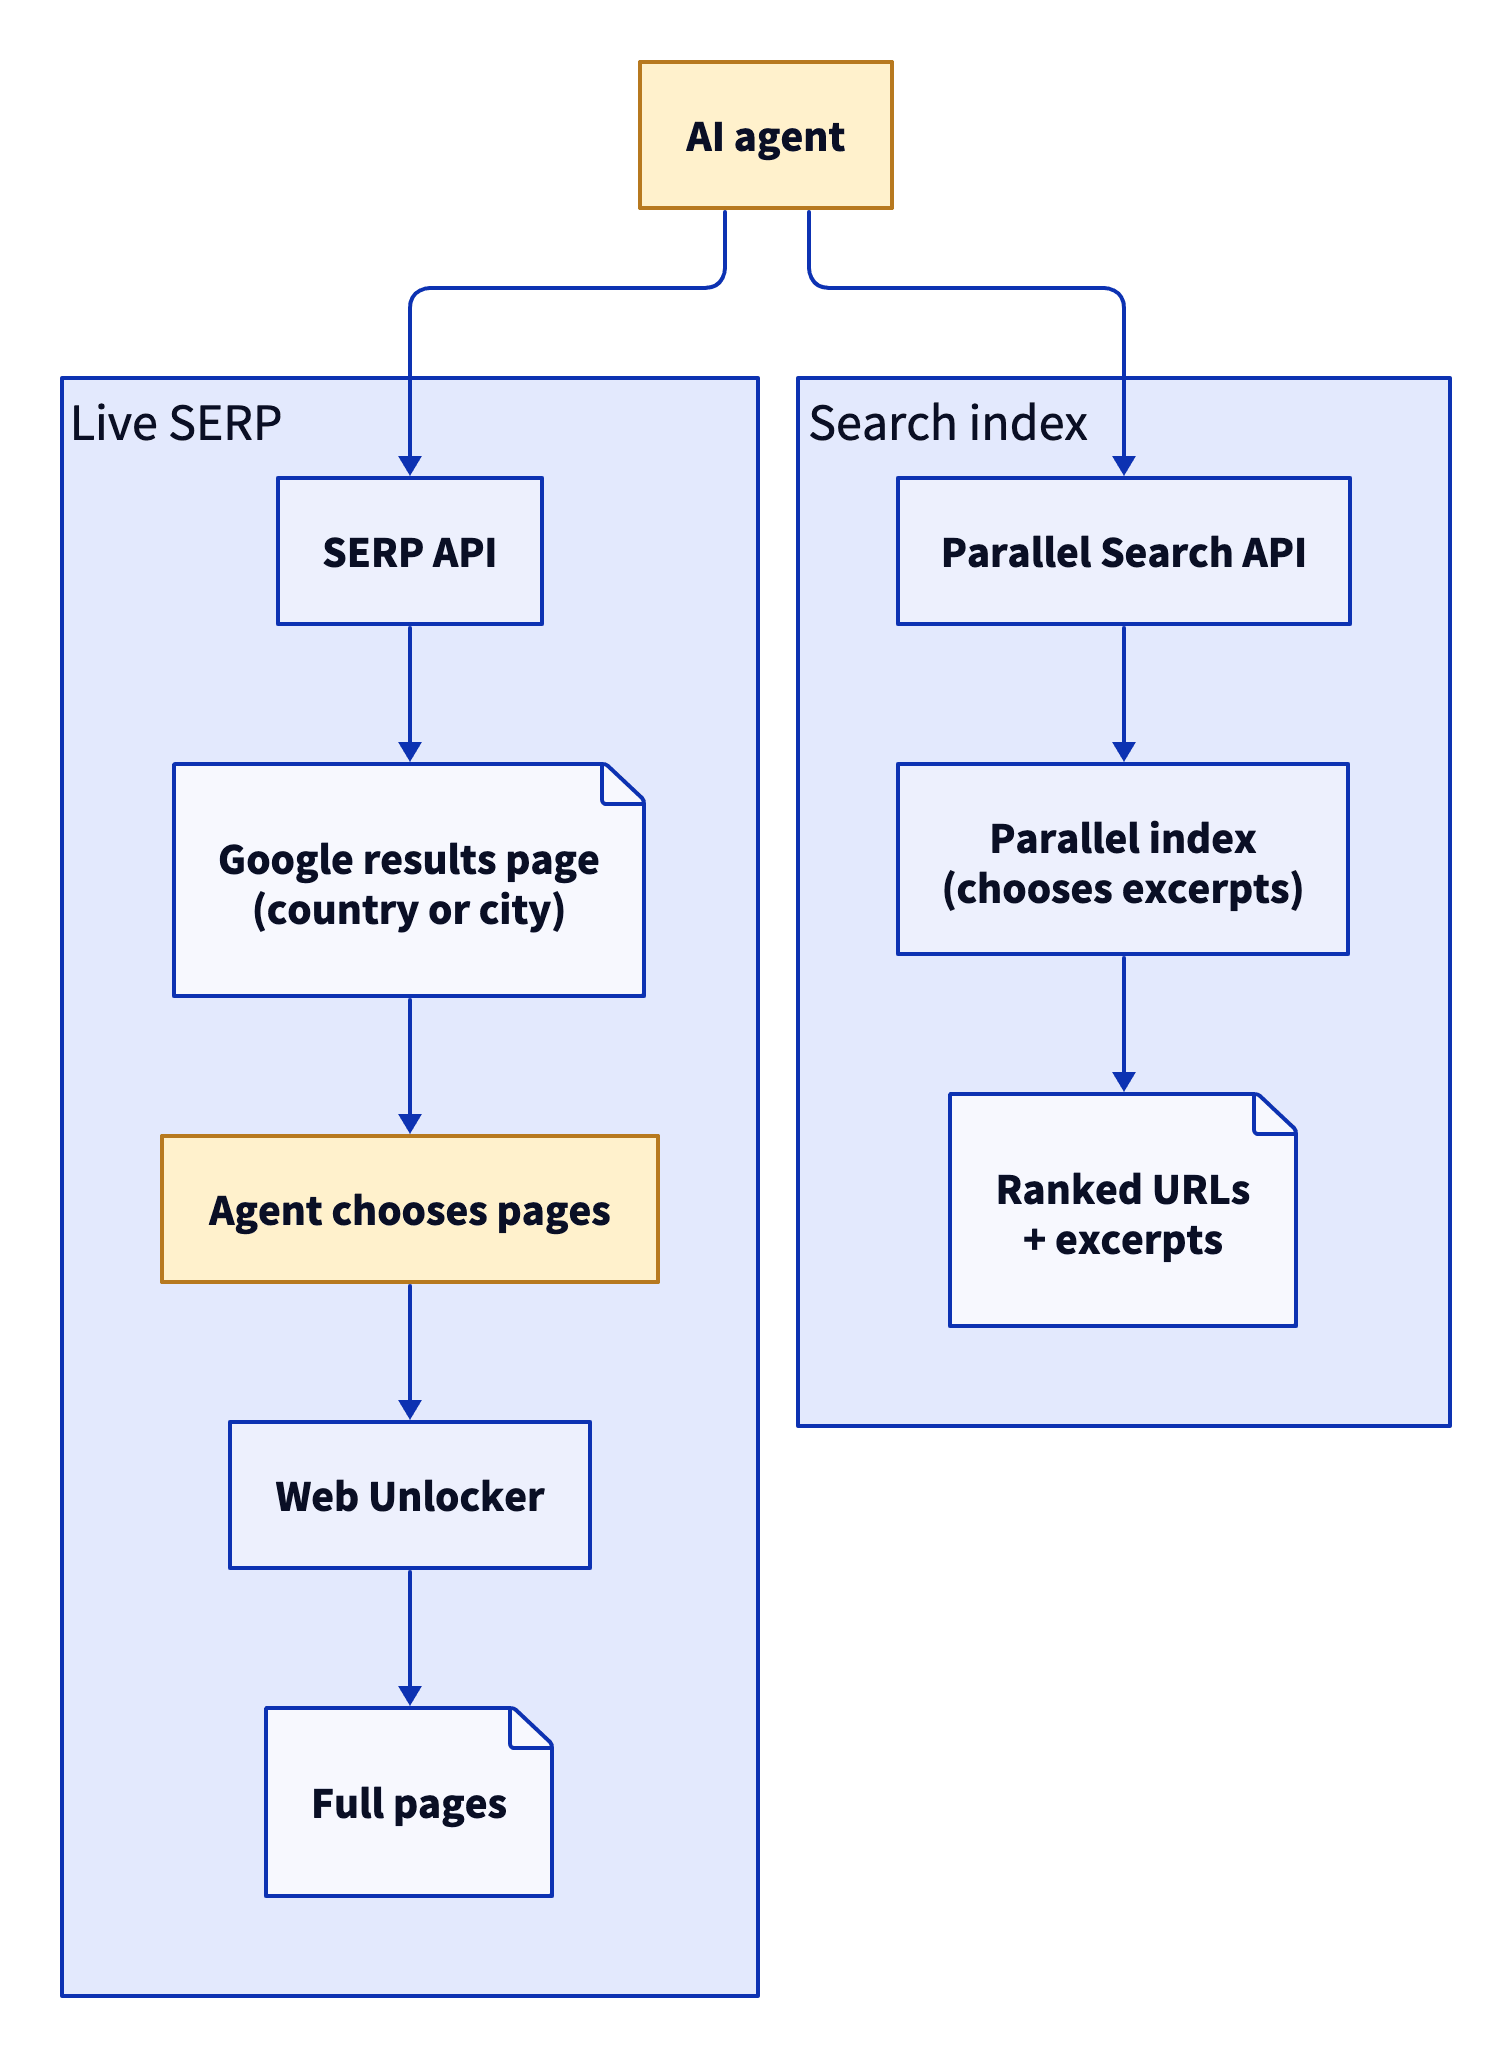
Con un SERP en vivo, el agente elige qué páginas leer. Con un índice de búsqueda, el índice elige los extractos.
Bright Data: resultados en vivo y páginas completas para agentes
La API SERP devuelve la página de resultados en vivo como JSON parseado, HTML en bruto o Markdown, incluyendo funciones SERP como el map pack (listados de negocios locales de Google) y AI Overview. Web Unlocker obtiene las páginas a las que enlazan esos resultados y está diseñado para páginas con protección antibots. El servidor MCP de Bright Data envuelve la búsqueda y el scraping como herramientas del Protocolo de Contexto de Modelo (MCP) para agentes, y ambas herramientas usan una sola clave de API.
Parallel: extractos clasificados desde su propio índice
La API de búsqueda de Parallel acepta un objective en lenguaje natural más search_queries breves, y devuelve URLs clasificadas con extractos en Markdown elegidos para el objetivo. Sus modos turbo, fast, basic y advanced ofrecen una opción entre latencia y calidad, y advanced era el predeterminado al probarlo. Parallel también vende una API Extract para contenido de página completa, además de otras API para agentes.
Bright Data vs. Parallel: comparación directa
Bright Data devuelve la página de resultados en vivo del motor de búsqueda más las páginas a las que enlaza, y Parallel clasifica páginas de su propio índice de búsqueda. Cada dato sobre Parallel en esta tabla proviene de la propia documentación o página de precios de Parallel, verificada durante las pruebas. La página de la API SERP enumera los motores, ubicaciones y planes actuales de Bright Data.
| Bright Data | Parallel | |
|---|---|---|
| Fuente de resultados | Página de resultados en vivo del motor de búsqueda | Propio índice de Parallel, con una obtención en vivo cuando su copia en caché supera una antigüedad máxima configurada |
| Clasificación | Clasificación propia del motor | Clasificación de relevancia de Parallel para el objetivo |
| Motores | Google, Bing y otros motores principales | Su propio índice |
| Ubicación | Segmentación a nivel de país y ciudad | Código de país, de una lista fija. Otros códigos se ignoran con una advertencia |
| Salida | JSON parseado, HTML o Markdown de la página de resultados completa | URL, título, fecha de publicación, extractos en Markdown |
| Funciones SERP | Orgánico, map pack, AI Overview, People Also Ask, compras, anuncios | No aplicable (solo lista clasificada) |
| Contenido de página | Markdown de página completa a través de Web Unlocker o el servidor MCP | Extractos en la misma llamada, texto completo mediante Extract |
| Páginas con protección antibots | Web Unlocker, diseñado para sitios con protección antibots | Sin desbloqueador, y sin acceso a sitios que lo bloqueen, según Parallel |
| Servidor MCP | MCP alojado o local, gratis para empezar sin tarjeta de crédito | MCP de búsqueda, gratis sin clave de API |
La comparación con la API de búsqueda de Brave y la comparación con Exa prueban los mismos 2 enfoques con otras API de índice. Para una lista más amplia, consulta las mejores API SERP y de búsqueda web y las mejores herramientas de búsqueda para agentes de IA.
Precios y límites de tasa: API SERP de Bright Data vs. API de búsqueda de Parallel
La API SERP factura solo las solicitudes exitosas, por lo que pagas por los resultados que recibes. Puedes empezar con precios de autoservicio de pago por uso, y los planes mensuales más grandes reducen la tarifa por cada 1.000 solicitudes. Parallel fijó el precio de cada búsqueda según el modo al probarlo, y su modo Advanced predeterminado costó 5 veces más que Turbo y Fast.
Consulta la página de precios de Parallel y la página de precios de la API SERP de Bright Data para conocer las tarifas actuales antes de planificar tu presupuesto:
| API SERP de Bright Data | Parallel (precios de lista al probarlo) | |
|---|---|---|
| Precio de búsqueda | Precios de autoservicio de pago por uso, o planes mensuales Scale con una tarifa menor a medida que crece el volumen (tarifas actuales en la página de precios) | $1 por cada 1.000 solicitudes para Turbo y Fast, y $5 por cada 1.000 para Basic y Advanced. Cada precio incluía 10 resultados, y los resultados adicionales costaban $1 por cada 1.000 |
| Contenido de página completa | Web Unlocker, a través del servidor MCP o su propia API (tarifas actuales) | Extract a $1 por cada 1.000 URLs |
| Plan gratuito | Plan gratuito mensual recurrente, sin necesidad de tarjeta de crédito (asignación actual en la página de precios) | $5 en créditos al mes, para organizaciones que agregaron una tarjeta de crédito |
| Facturación | Solo se facturan las solicitudes exitosas | Por cada 1.000 solicitudes, según el modo |
| Límites de tasa y concurrencia | Los planes Scale enumeran concurrencia ilimitada | 600 solicitudes por minuto por defecto, personalizable en planes empresariales |
El precio unitario es solo parte de la factura de un agente. Cada resultado, extracto y página que lee el modelo también suma tokens del modelo a la factura. En un bucle que busca, lee y vuelve a buscar, el modelo relee los resultados anteriores en cada turno, y esos tokens se facturan de nuevo. Compara el costo por respuesta, que es el gasto en API más el costo de tokens del modelo, dividido entre las respuestas que tu agente realmente usa.
Por ejemplo, un agente que realiza 3 búsquedas y lee 3 páginas hace 6 llamadas a la API por respuesta. Multiplica esas llamadas por las tarifas actuales de cada API, luego suma los tokens del modelo que el agente lee, para comparar el costo por respuesta.
Misma consulta, resultados diferentes: la coincidencia de Parallel con Google
El modo Advanced predeterminado de Parallel devolvió del 35 al 43% de las URLs en la primera página de Google. Sus modos Turbo y Fast devolvieron del 6 al 18%.
Envié las mismas 30 consultas de EE. UU. a Google, a través de la API SERP, y a los 4 modos de Parallel, luego comparé las 10 URLs principales. La tabla muestra la proporción de las URLs principales de Google que cada modo de Parallel también devolvió, con el número de consultas de cada grupo entre corchetes. La primera página de Google cambió entre ejecuciones, por lo que un rango muestra los resultados de 2 ejecuciones:
| Grupo (consultas) | Advanced | Basic | Fast | Turbo |
|---|---|---|---|---|
| Factual (5) | 35 al 61% | 33 al 53% | 15 al 18% | 11 al 17% |
| Documentación técnica (5) | 50 al 63% | 64% | 27% | 11% |
| Noticias (4) | 25 al 36% | 31 al 42% | 26 al 39% | 5 al 8% |
| Marca y SEO (6) | 21 al 42% | 29 al 52% | 12 al 16% | 3 al 8% |
| Comercial (6) | 35 al 52% | 37 al 53% | 8 al 10% | 0 al 2% |
| Local (4) | 17 al 25% | 17% | 0% | 0% |
| Todas las consultas (30) | 35 al 43% | 39 al 45% | 15 al 18% | 6% |
El SDK de Parallel recomendaba un objetivo en lenguaje natural y 2 o 3 consultas de búsqueda por llamada. Con esa configuración, el modo Advanced devolvió 34% y el modo Fast devolvió 11%, por lo que la configuración recomendada no aumentó la coincidencia. Cada grupo tiene de 4 a 6 consultas, así que trata cada fila de grupo como un indicador aproximado y la fila de 30 consultas como la cifra general.
Parallel clasifica las páginas según el objetivo, lo cual funciona bien para preguntas de investigación abierta. El seguimiento de posiciones, el seguimiento de visibilidad de IA, el monitoreo de marca y el monitoreo de anuncios necesitan la página que los usuarios realmente ven. Esa página es la página de resultados de Google, que devuelve la API SERP.
Segmentación a nivel de ciudad: los resultados de Google en Chicago, Austin y Seattle
Los resultados de Google cambiaron según la ciudad en 3 de 4 consultas locales, y la configuración de ubicación de Parallel aceptaba países, no ciudades, durante las pruebas. La API SERP obtuvo la primera página de Google para 4 consultas de intención local en Chicago, Austin y Seattle:
| Consulta | URLs orgánicas compartidas entre 2 ciudades cualesquiera | Negocios del map pack compartidos |
|---|---|---|
| plomero de emergencia | Ninguna | Ninguno |
| mejor pizza | Ninguna | Ninguno |
| dentista abierto sábado | Ninguna | Ninguno |
| cotizaciones de seguro de auto | 6 de 9 | Google no mostró map pack |
Encima del map pack, la página de Google para Chicago muestra la ubicación que aplicó:
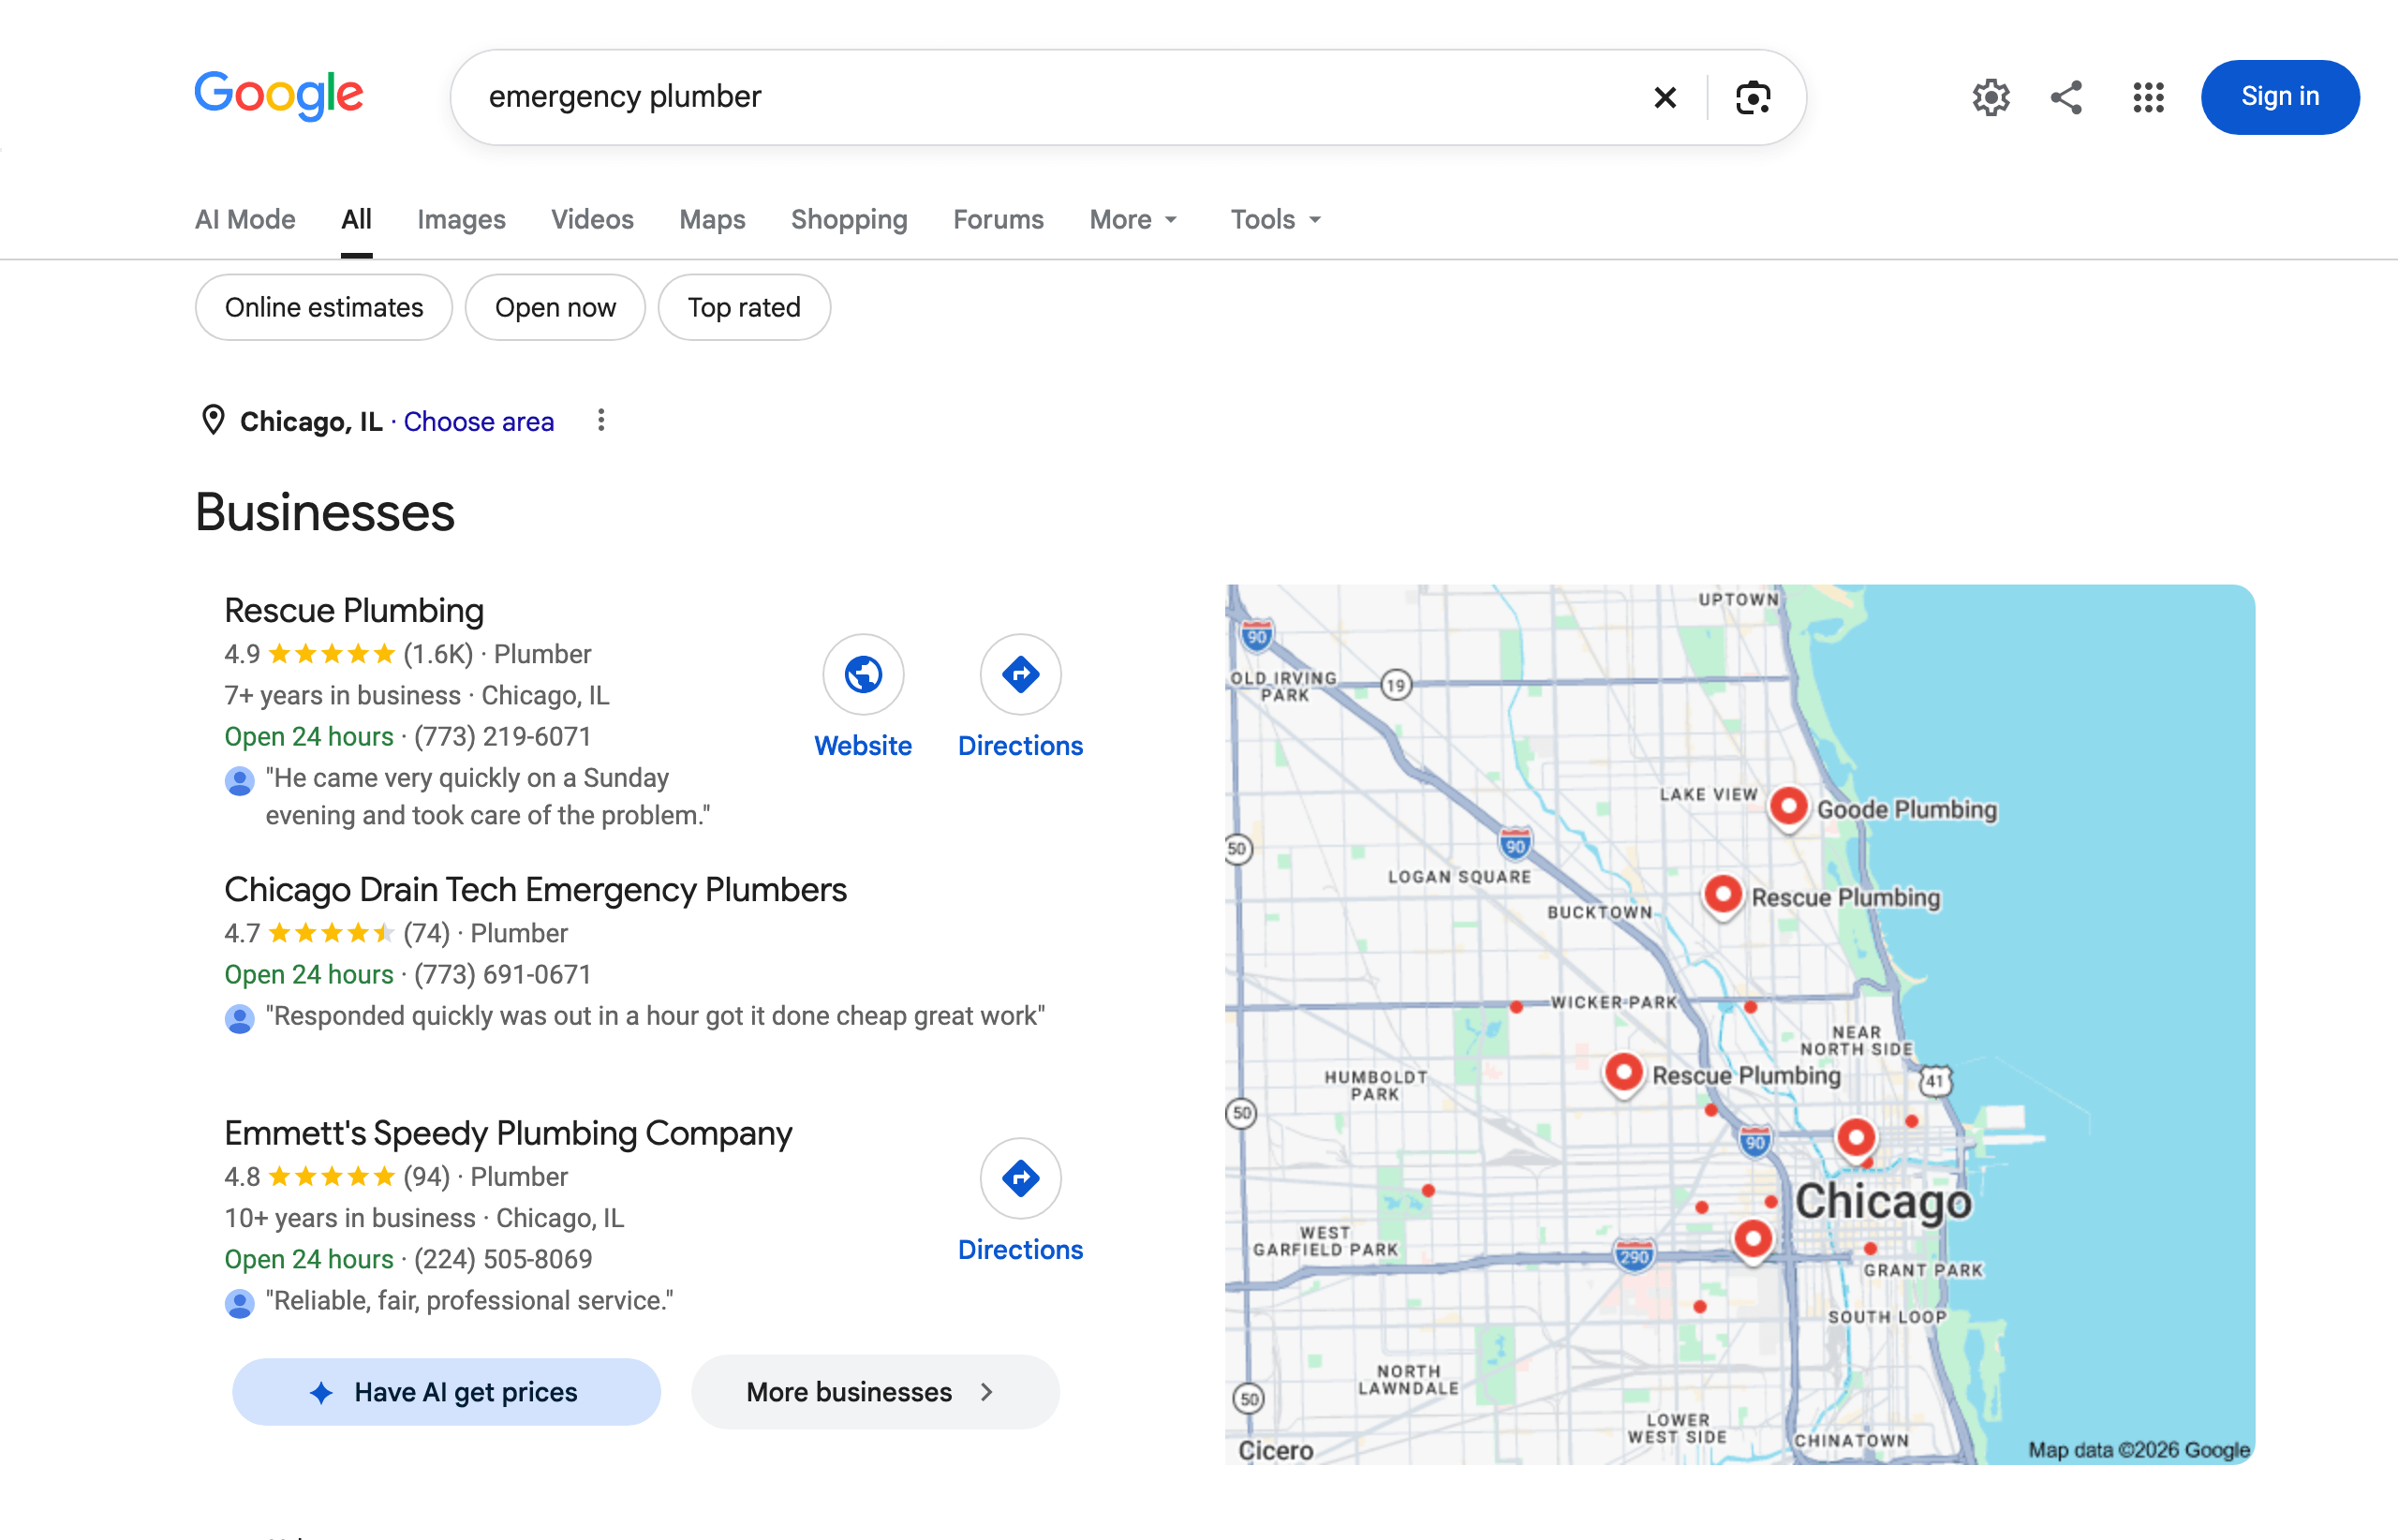
La etiqueta de ubicación confirma la segmentación.
La página de Austin para la misma consulta enumera otros negocios:
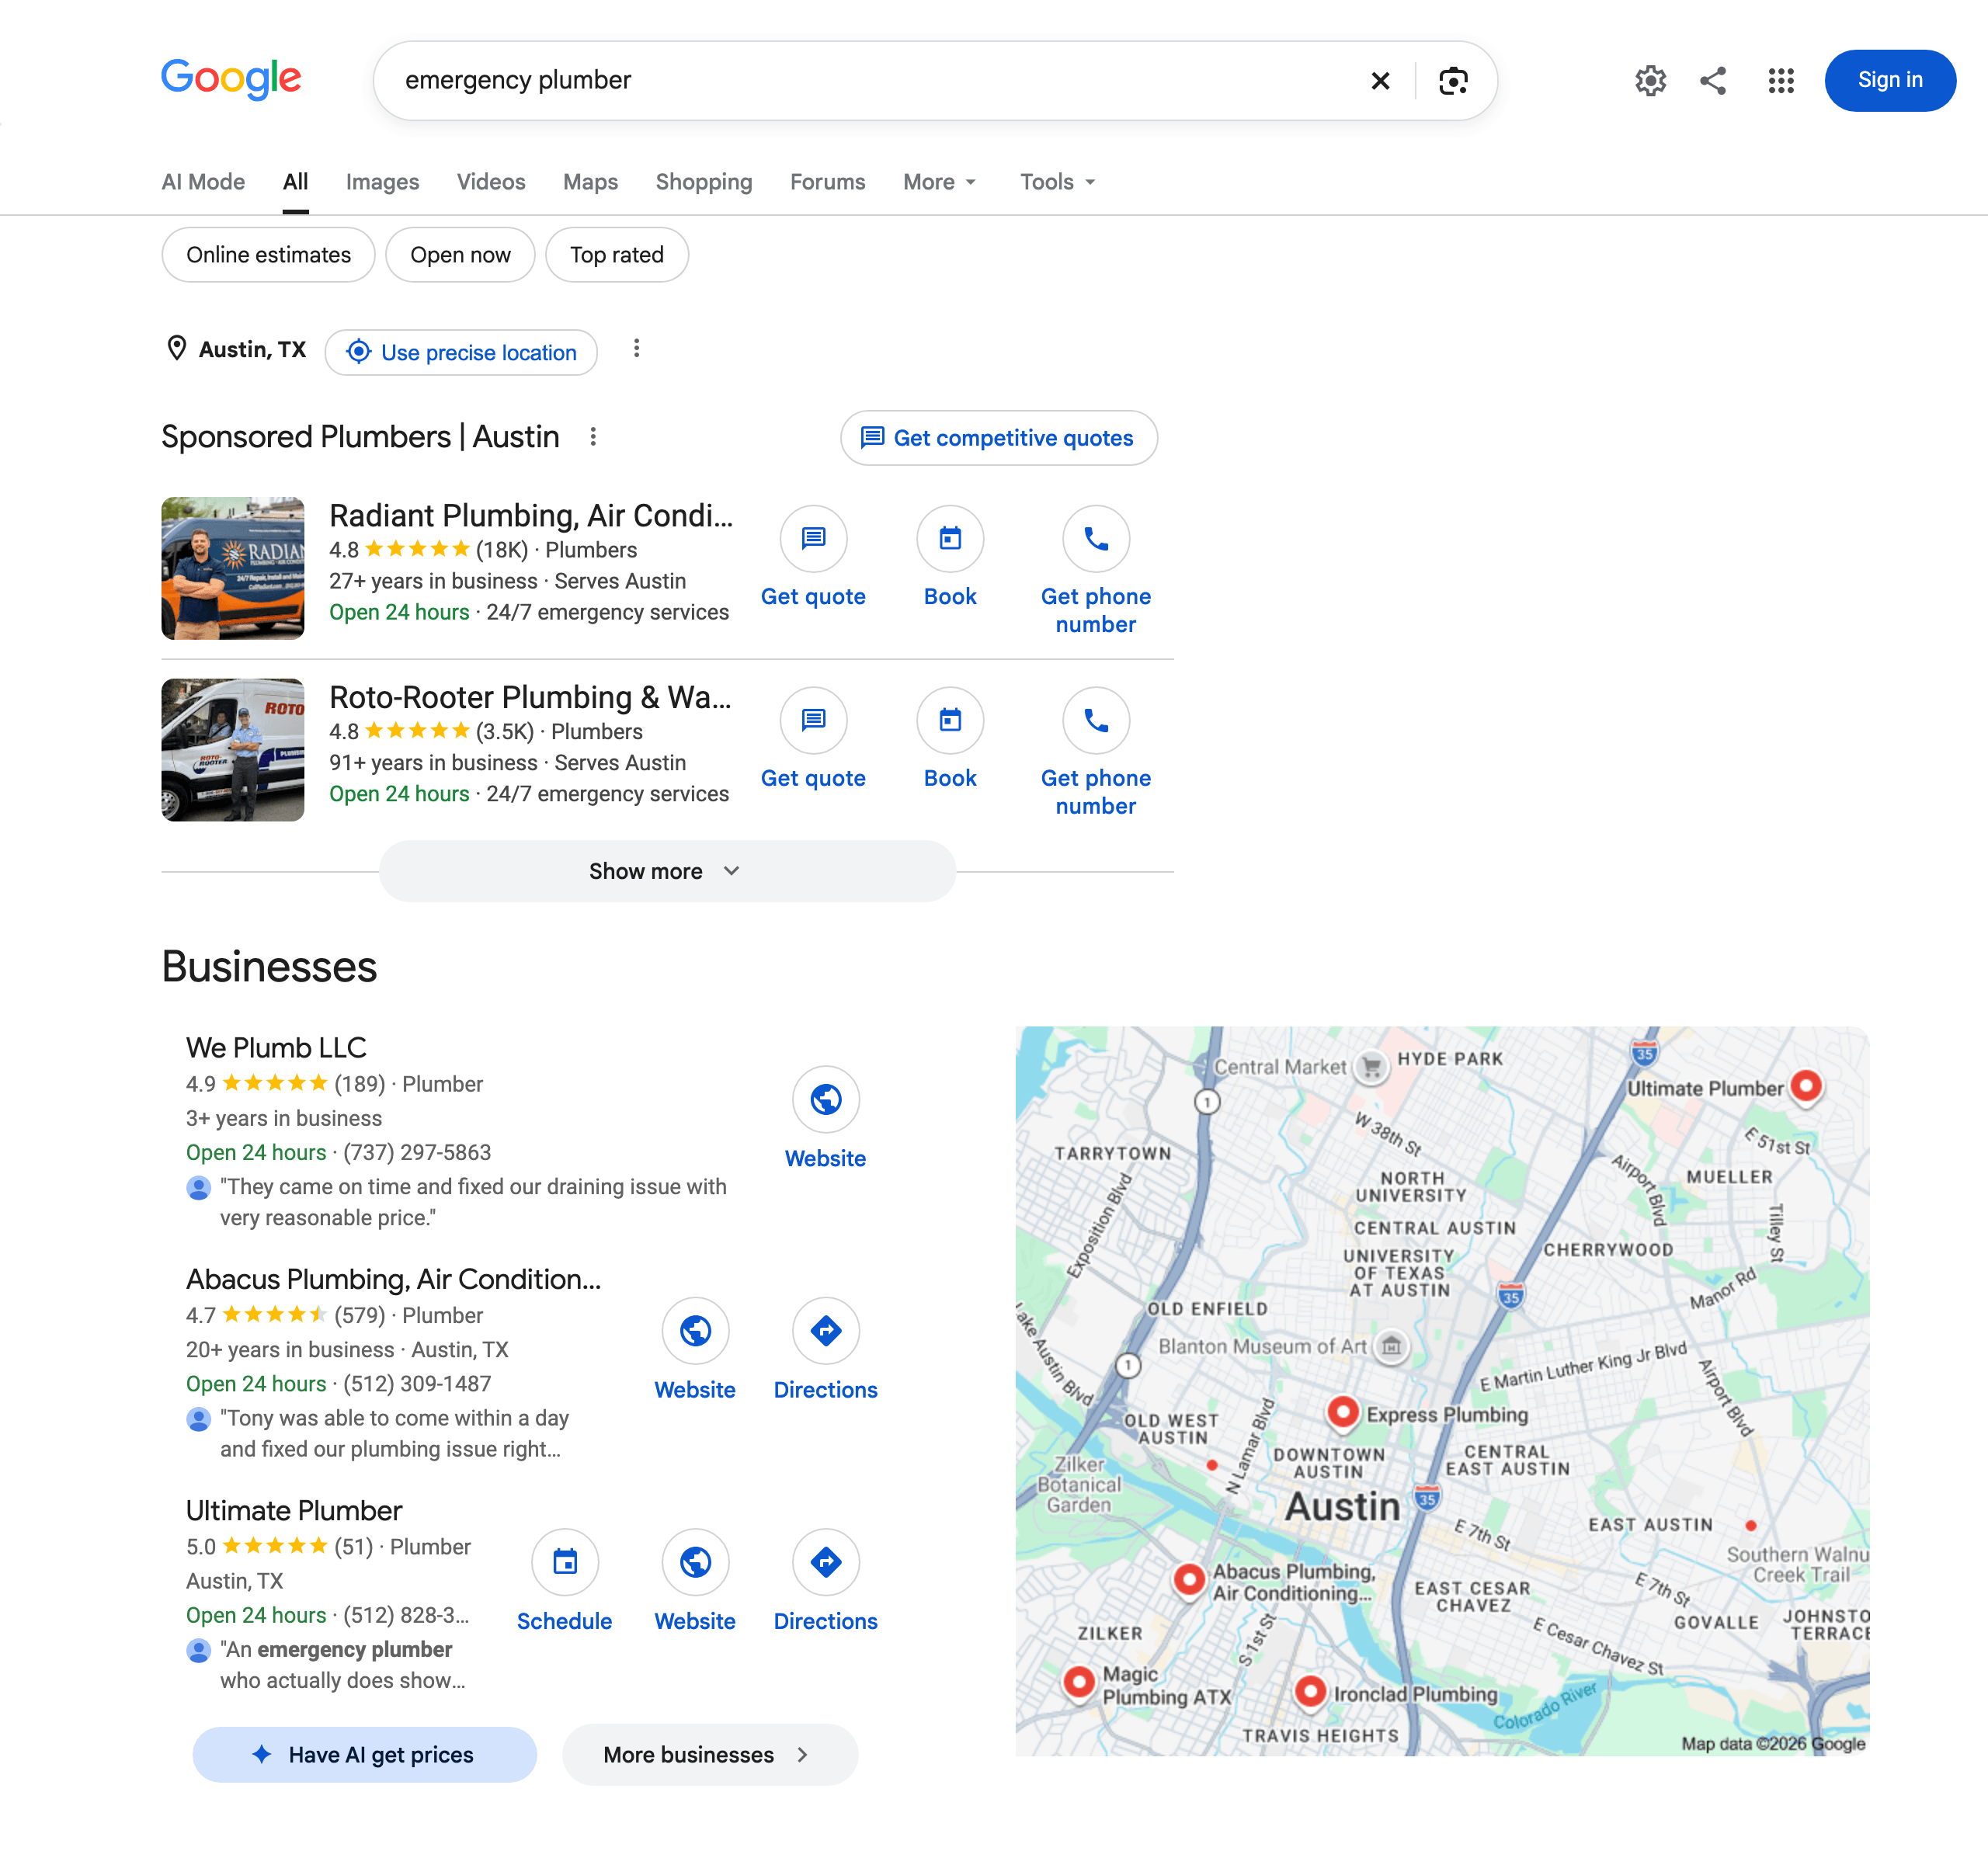
Misma consulta y motor, sin negocios compartidos. Una configuración a nivel de país no puede solicitar la página de ninguna de las dos ciudades.
Para “dentista abierto sábado” con la ubicación establecida en EE. UU., los resultados de Parallel incluyeron una página de Los Ángeles y una búsqueda en Yelp de Port St. Lucie, Florida. Agregar el nombre de la ciudad al texto de la consulta ayudó a Parallel a coincidir con más resultados locales de Google. Con el nombre de la ciudad añadido a cada consulta, el modo Advanced devolvió 39 de las 107 URLs en las páginas de Google segmentadas por ciudad. Los extractos de Parallel nombraron 4 de los 27 negocios en los map packs de Google.
Con la ubicación establecida en los Emiratos Árabes Unidos, Vietnam o Nigeria, Parallel igual devolvió resultados, más una advertencia de que la ubicación “no es compatible actualmente. Se ignora el parámetro de ubicación”. Si usas Parallel, revisa el campo warnings, porque esos resultados no tenían ningún país aplicado. La API SERP aplica el país en cada solicitud, y la misma consulta devolvió map packs locales en los 3 países.
La segmentación por ciudad en la API SERP usa el parámetro uule de Google. La API SERP acepta un nombre de ubicación canónico simple, como Chicago,Illinois,United States, sin codificación adicional. Agrega brd_mobile=1 a la URL de búsqueda para obtener la página de resultados móvil, ya que muchos rastreadores de posiciones informan los resultados móviles y de escritorio por separado.
Funciones SERP que un índice de búsqueda no devuelve
En las 30 consultas de prueba, las páginas de Google mostraron estas funciones SERP, y el índice de Parallel no devolvió ninguna de ellas:
| Función SERP | Consultas que la mostraron |
|---|---|
| People Also Ask | 21 de 30 |
| AI Overview | 15 de 30 |
| Resultados de video | 8 de 30 |
| Map pack | 4 de 30 |
| Resultados de compras | 4 de 30 |
| Anuncios | 3 de 30 |
Un agente que informa lo que Google dice a los usuarios necesita el propio AI Overview. El resumen para “mejor crm para pequeñas empresas” recomendó HubSpot, Pipedrive y Zoho, y enumeró sus fuentes en un panel junto a la respuesta:
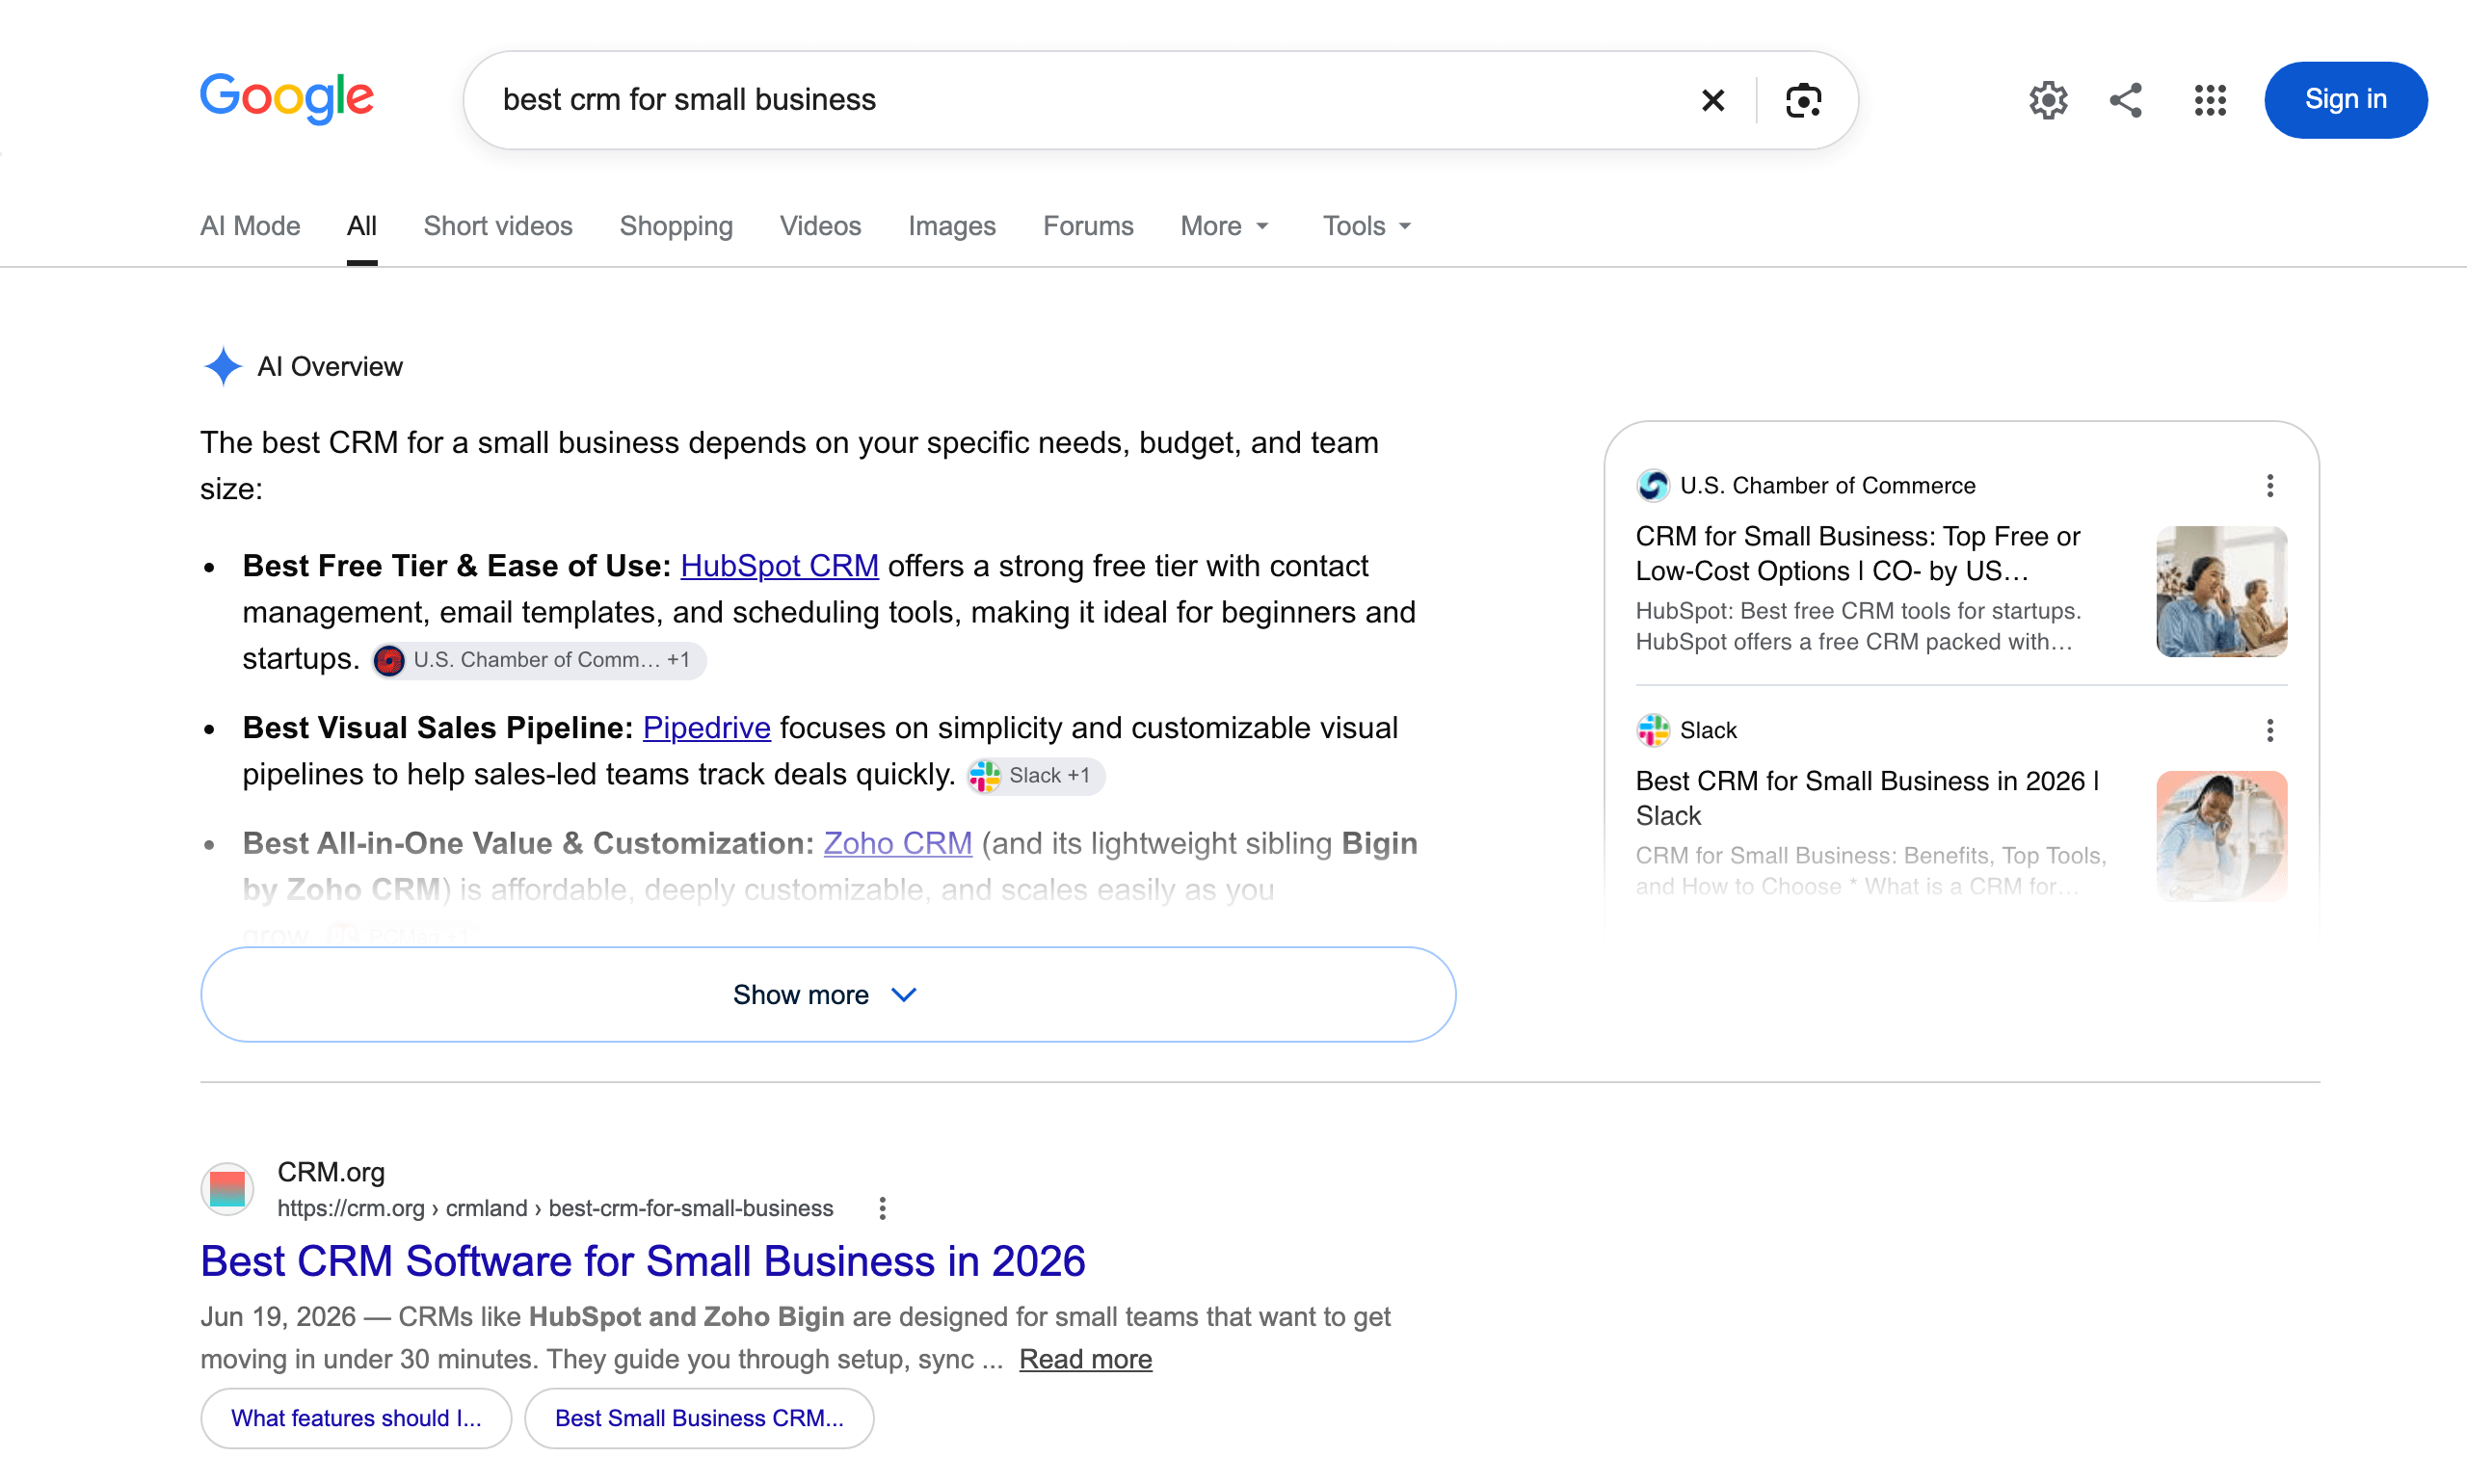
Google actualiza el resumen con el tiempo, así que la respuesta puede cambiar entre ejecuciones.
Los 15 resúmenes citaron 64 fuentes, y los resultados de Fast y Advanced de Parallel para las mismas consultas incluyeron 7 de ellas. Alrededor de 9 de cada 10 páginas que citó la IA de Google no estaban en los resultados de Parallel.
La API SERP con brd_json=1 devuelve la página completa como JSON parseado, con el resumen en un campo ai_overview y sus fuentes bajo references. Un agente puede citar el resumen y verificar qué páginas citó Google.
SERP en vivo vs. índice de búsqueda: actualidad, copias en caché y páginas bloqueadas
La API SERP obtiene la página de Google en el momento de la solicitud, por lo que sus resultados incluyen noticias nuevas tan pronto como Google las muestra. Para 14 noticias que Google News etiquetó entre 20 minutos y 17 horas de antigüedad, consulté a Parallel con términos clave de cada titular. El modo Advanced devolvió la URL exacta de la noticia para 9 de las 14, incluida una noticia publicada 55 minutos antes. El modo Fast devolvió 6, y los 2 modos juntos encontraron 10.
Las 14 noticias provinieron de Google News a través de la API SERP, con tbm=nws para resultados de noticias y tbs=qdr:d para el último día. Para el monitoreo de noticias, donde cada noticia perdida cuenta, consulta Google News de la misma manera.
Para páginas completas, la API Extract de Parallel devolvió contenido para 15 de 18 páginas de retail, viajes y listados en 2,1 segundos o menos. La página de precios de Parallel indicaba de 1 a 3 segundos para páginas en caché y de 60 a 90 segundos para obtenciones en vivo. Ese tiempo coincide con las copias en caché, y una copia en caché puede mostrar la ubicación equivocada para tu usuario.
Las copias que devolvió Extract mostraban una ubicación de entrega que las solicitudes no pedían. La página de Target mostraba “Ship to 51503 Council Bluffs” cerca de la parte superior, y la página de Walmart mostraba “Sacramento, 95829” en el mismo lugar. Si un agente cita precios, existencias o tiempos de entrega a un usuario en Austin, el agente necesita la página para la ubicación de ese usuario. La API SERP acepta el país o la ciudad en cada solicitud, y Web Unlocker obtiene la página en el momento de la solicitud desde el país que elijas.
El sitio web de Parallel describió a Parallel como que no tiene “capacidad de llegar a un sitio que ha decidido bloquearte” y sin desbloqueador para esos sitios. Web Unlocker está diseñado para páginas con protección antibots, y las herramientas scrape_as_markdown y scrape_batch del servidor MCP enrutan las solicitudes a través de él.
Páginas completas mediante el servidor MCP: el agente elige qué leer
En el servidor MCP de Bright Data, search_engine devuelve la lista de resultados de Google. scrape_batch luego devuelve las páginas que el agente elige como Markdown completo en una sola llamada. Una clave de API y un plan gratuito funcionan para ambas herramientas.
La lista de resultados es compacta, con enlace, título y descripción por resultado. En las 30 consultas de prueba, la lista tuvo una mediana de unos 720 tokens con el tokenizador o200k_base. Parallel devolvió extractos con cada búsqueda en su lugar. Una respuesta de 10 resultados tuvo una mediana de 5.438 tokens en modo Fast y 4.082 tokens en modo Advanced.
Con extractos, cada búsqueda suma el texto del extracto al contexto. Con la lista de resultados compacta, solo las páginas que el agente abre suman texto de página. El agente decide cuántas páginas abrir, por lo que controla cuánto texto de página suma cada respuesta.
Las páginas completas conservan las tablas, bloques de código y precios que un extracto puede omitir. Divide las páginas largas en fragmentos y conserva los más relevantes antes de que el modelo escriba la respuesta. La ventana de contexto entonces contiene lo que la pregunta necesita.
Conecta el servidor MCP alojado y carga solo las 2 herramientas que usa este flujo de trabajo. Cada herramienta cargada suma su definición al contexto del agente antes de la primera llamada, así que menos herramientas mantienen el contexto pequeño.
Este .mcp.json para Claude Code lee la clave de la variable de entorno BRIGHTDATA_API_KEY. La clave no se almacena en el archivo ni se muestra en las URL registradas:
{
  "mcpServers": {
    "bright-data": {
      "type": "http",
      "url": "https://mcp.brightdata.com/mcp?tools=search_engine,scrape_batch",
      "headers": {
        "Authorization": "Bearer ${BRIGHTDATA_API_KEY}"
      }
    }
  }
}
Guárdalo como .mcp.json en la raíz de tu proyecto. Los clientes que admiten encabezados personalizados aceptan la misma URL y encabezado en su propio formato de configuración. Obtén una clave de API desde la configuración de tu cuenta de Bright Data. La referencia de herramientas MCP documenta las herramientas y grupos de herramientas.
En las pruebas, el servidor alojado envolvió la salida de search_engine y scrape_batch en marcadores que la etiquetan como datos web no confiables. Los marcadores indican al modelo que trate cada página como datos en lugar de instrucciones. Agregan una capa de protección contra la inyección de prompts que funciona junto con las propias defensas del agente.
Cuándo elegir Bright Data o Parallel
La elección correcta depende de la función que la herramienta de búsqueda cumple dentro de tu agente.
Elige Bright Data cuando el agente necesita la página de resultados en vivo o la página completa:
- Lo que muestra Google en el momento de la solicitud, incluyendo clasificaciones, AI Overviews, People Also Ask, anuncios, resultados de compras y el map pack
- Resultados para un país o ciudad específicos
- Motores más allá de Google, como Bing, Baidu, Yandex y Naver
- Trabajos por lotes de gran volumen, con concurrencia ilimitada indicada en los planes Scale
- Páginas completas mediante Web Unlocker, diseñado para sitios con protección antibots, con la misma clave que la búsqueda
Elige Parallel cuando el agente necesita extractos clasificados a partir de los cuales responder:
- Páginas clasificadas con extractos en una sola llamada
- Modos Turbo y Fast de baja latencia
- Un precio bajo por búsqueda en Turbo y Fast
- Preguntas de investigación abierta donde la clasificación de Google no importa
Algunos agentes cumplen ambas funciones. En ese caso, envuelve ambas en una sola herramienta de búsqueda que enrute cada consulta según la intención. Las preguntas locales, comerciales y de “qué muestra Google” van a la API SERP, y las preguntas de investigación abierta van a Parallel. El mismo envoltorio es un buen lugar para registrar cada llamada y establecer límites de gasto.
Algunas preguntas no necesitan una búsqueda. Cuando el agente verifica las mismas páginas conocidas según un calendario, como una página de precios cada mañana, obtenlas directamente mediante Web Unlocker. Una obtención directa evita pagar por la misma búsqueda en cada verificación.
Ambas comienzan gratis. La API SERP tiene un plan gratuito mensual recurrente sin necesidad de tarjeta de crédito. Parallel ofrecía $5 en créditos al mes al probarlo.
Metodología de prueba
Los resultados de coincidencia y funciones SERP provienen de una configuración:
- Las mismas 30 consultas, en 6 grupos, se enviaron a Google a través de la API SERP y a los 4 modos de Parallel.
- La ubicación se estableció en EE. UU., y Google devolvió resultados de escritorio en inglés.
- Cada consulta era el objetivo de Parallel y su única consulta de búsqueda.
- La comparación usó las 10 URLs principales de cada API, tras eliminar etiquetas de seguimiento como el
srsltidde Google. - Cada cifra de coincidencia es el promedio de la proporción por consulta en una ejecución. Advanced y Fast se ejecutaron dos veces, y Turbo y Basic se ejecutaron una vez, unas horas después.
- Los recuentos de funciones SERP provienen de la primera ejecución. En la segunda ejecución, los resultados de Parallel incluyeron 6 de las 61 fuentes que citaron los AI Overviews.
Mide la coincidencia con Google en tus propias consultas
La coincidencia de Parallel con Google depende de las consultas. Muestrea 100 o más consultas de los registros de tu agente, divididas por tipo, como local, comercial y técnico. Las consultas registradas incluyen la variedad que las consultas de prueba escritas a mano no captan. Usa el plan gratuito de la API SERP para la mitad de Google de la prueba.
Antes de ejecutar el script, obtén una clave de API de Parallel y el nombre de tu zona de API SERP. Una zona es la configuración de producto nombrada que especifica cada solicitud de Bright Data. Para agregar una, abre el panel de control de Bright Data y elige Crear API > API SERP. Copia el nombre de la zona desde su pestaña Overview:
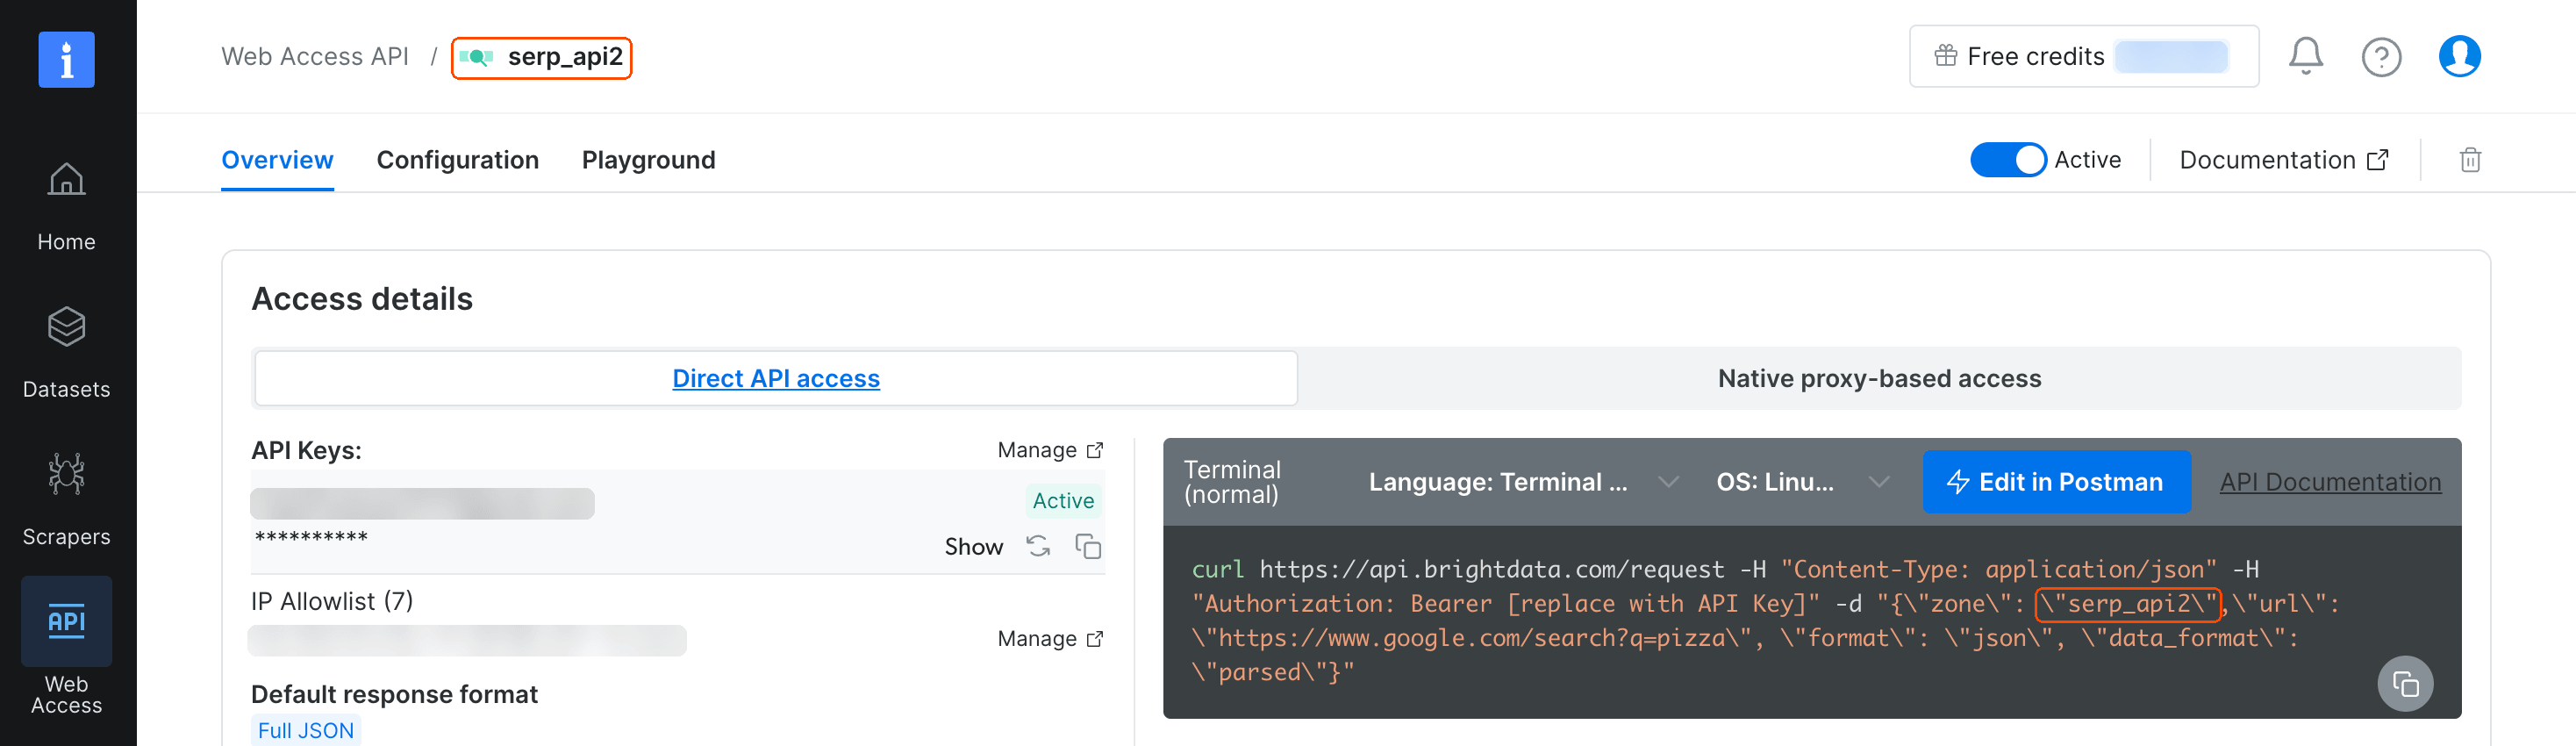
La clave de API proviene del enlace Manage en la misma página.
Guarda este script como overlap_check.py. Acepta consultas como argumentos e imprime cuántas de las URLs principales de Google también aparecen en las 10 principales de Parallel:
# /// script
# requires-python = ">=3.9"
# dependencies = ["requests"]
# ///
# Imprime cuántas de las 10 URLs principales de Google (desde la API SERP de Bright Data)
# también aparecen en las 10 principales de Parallel. Necesita BRIGHTDATA_API_KEY,
# BRIGHTDATA_SERP_ZONE, y PARALLEL_API_KEY en el entorno.
import json
import os
import sys
import time
import urllib.parse
from concurrent.futures import ThreadPoolExecutor

import requests
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

BRIGHTDATA_API_KEY = os.environ["BRIGHTDATA_API_KEY"]
BRIGHTDATA_SERP_ZONE = os.environ["BRIGHTDATA_SERP_ZONE"]
PARALLEL_API_KEY = os.environ["PARALLEL_API_KEY"]
MODE = os.environ.get("PARALLEL_MODE", "advanced")
# Nombre de ubicación canónico opcional, p. ej. "Chicago,Illinois,United States"
LOCATION = os.environ.get("GOOGLE_LOCATION", "")


session = requests.Session()
# Reintenta 429 (demasiadas solicitudes), esperando lo que pida Retry-After
session.mount("https://", HTTPAdapter(max_retries=Retry(
    total=3, status_forcelist=[429], allowed_methods=None,
    backoff_factor=1, raise_on_status=False)))


def post(url, headers, body, timeout):
    resp = session.post(url, headers=headers, json=body, timeout=timeout)
    resp.raise_for_status()
    return resp


def key(url):
    # Compara URLs sin esquema, "www.", fragmento, barra final, ni
    # etiquetas de seguimiento como srsltid de Google, que pueden diferir entre solicitudes
    parts = urllib.parse.urlsplit(url.lower().split("#")[0])
    query = urllib.parse.urlencode(
        [(k, v) for k, v in urllib.parse.parse_qsl(parts.query)
         if not k.startswith(("utm", "srsltid"))])
    host = parts.netloc.removeprefix("www.")
    return (host + parts.path).rstrip("/") + ("?" + query if query else "")


def google_top10(query):
    params = {"q": query, "gl": "us", "hl": "en", "brd_json": "1"}
    if LOCATION:
        params["uule"] = LOCATION
    body = {"zone": BRIGHTDATA_SERP_ZONE, "format": "raw",
            "url": "https://www.google.com/search?"
                   + urllib.parse.urlencode(params)}
    headers = {"Authorization": f"Bearer {BRIGHTDATA_API_KEY}"}
    resp = post("https://api.brightdata.com/request", headers, body, 120)
    # Bright Data informa el estado de la solicitud en el encabezado x-brd-error
    if resp.headers.get("x-brd-error"):
        raise RuntimeError(resp.headers["x-brd-error"])
    serp = resp.json()
    # Confirma que Google aplicó la ubicación antes de usar los resultados
    city = LOCATION.split(",")[0]
    applied = serp.get("general", {}).get("location", "")
    if city and not applied.startswith(city):
        raise RuntimeError(f"Google no aplicó la ubicación {LOCATION}")
    return [r["link"] for r in serp.get("organic", [])][:10]


def parallel_top10(query):
    body = {"objective": query, "search_queries": [query], "mode": MODE,
            "advanced_settings": {"location": "us", "max_results": 10}}
    resp = post("https://api.parallel.ai/v1/search",
                {"x-api-key": PARALLEL_API_KEY}, body, 60)
    return [r["url"] for r in resp.json()["results"]][:10]


def with_retries(fetch, query, attempts=3, pause=15):
    # Reintenta cualquiera de las APIs varias veces, con una pausa entre intentos
    for attempt in range(attempts):
        try:
            return fetch(query)
        except (RuntimeError, requests.RequestException) as err:
            # Una respuesta 4xx significa que la propia solicitud necesita corrección
            response = getattr(err, "response", None)
            if response is not None and response.status_code < 500:
                raise
            if attempt == attempts - 1:
                raise
            time.sleep(pause)


def compare(query):
    google = with_retries(google_top10, query)
    parallel = with_retries(parallel_top10, query)
    shared = {key(u) for u in google} & {key(u) for u in parallel}
    return {"query": query, "mode": MODE, "location": LOCATION,
            "shared": len(shared), "total": len({key(u) for u in google}),
            "google": google, "parallel": parallel}


def safe_compare(query):
    # Conserva los resultados de las demás consultas si una falla
    try:
        return compare(query)
    except (RuntimeError, requests.RequestException) as err:
        return {"query": query, "error": str(err)}


# Las consultas vienen de los argumentos, o una por línea desde stdin
queries = sys.argv[1:] or [line.strip() for line in sys.stdin if line.strip()]
# Ejecuta las consultas de forma concurrente e imprime los resultados en el orden de entrada
with ThreadPoolExecutor(max_workers=8) as pool:
    results = list(pool.map(safe_compare, queries))
# Conserva las URLs en bruto para que los resultados se puedan recalificar sin nuevas solicitudes
with open("overlap_results.jsonl", "a") as f:
    f.writelines(json.dumps(r) + "\n" for r in results)
ok = [r for r in results if "error" not in r]
for r in results:
    if "error" in r:
        print(f"Error ({r['error']}): {r['query']}")
    else:
        print(f"{r['shared']}/{r['total']} de las URLs principales de Google también en "
              f"Parallel ({MODE}): {r['query']}")
mean = sum(r["shared"] / max(r["total"], 1) for r in ok) / max(len(ok), 1)
noun = "consulta" if len(ok) == 1 else "consultas"
print(f"Promedio en {len(ok)} {noun}: {mean:.0%} de las URLs principales de Google "
      "también en Parallel")
El script tiene 6 partes:
google_top10obtiene la primera página de Google a través de la API SERP conbrd_json=1y verifica que Google aplicó la ubicación.parallel_top10envía la misma consulta a la API de búsqueda de Parallel en el modo que elijas.keynormaliza cada URL, para que la misma página coincida incluso cuando las etiquetas de seguimiento difieren.with_retriesreintenta cualquiera de las APIs varias veces, con una pausa entre intentos.comparecuenta las URLs compartidas por consulta, y las últimas líneas imprimen los resultados y guardan las URLs en bruto.safe_compareregistra el error cuando una consulta falla, para que se conserven los resultados de las demás consultas.
Pasa las consultas como argumentos, o canaliza un archivo al script con una consulta por línea. uv instala requests desde el encabezado del script en la primera ejecución. Sin uv, instala requests en un entorno virtual y ejecuta el script con python en lugar de uv run. Establece el nombre de la zona y ambas claves de API, luego ejecuta el script:
export BRIGHTDATA_API_KEY="tu-clave-de-api-de-bright-data"
export BRIGHTDATA_SERP_ZONE="tu-nombre-de-zona-serp"
export PARALLEL_API_KEY="tu-clave-de-api-de-parallel"
uv run overlap_check.py "mejor crm para pequeñas empresas" \
  "rendimiento del índice jsonb de postgres" "dentista abierto sábado"
# Para leer una consulta por línea desde un archivo en su lugar, ejecuta:
# uv run overlap_check.py < queries.txt
# Para probar otro modo de Parallel, establécelo primero, por ejemplo:
# export PARALLEL_MODE=fast
Si una línea muestra un error 4xx, revisa el nombre de la zona y ambas claves de API. Para esas 3 consultas, una ejecución imprimió:
2/9 de las URLs principales de Google también en Parallel (advanced): mejor crm para pequeñas empresas
4/9 de las URLs principales de Google también en Parallel (advanced): rendimiento del índice jsonb de postgres
1/9 de las URLs principales de Google también en Parallel (advanced): dentista abierto sábado
Promedio en 3 consultas: 26% de las URLs principales de Google también en Parallel
La última línea promedia la proporción por consulta, la misma medida que la tabla de coincidencia. El 9 en cada línea es el número de resultados orgánicos en la primera página de Google para esa consulta. Los resultados cambian entre ejecuciones, y la consulta de Postgres compartió de 0 a 6 URLs en 9 ejecuciones. Basa una decisión en muchas consultas, y ejecuta cada consulta más de una vez.
Cada ejecución también añade las URLs en bruto a overlap_results.jsonl. Puedes recalificar esos resultados más tarde, por ejemplo con una regla de coincidencia de URL diferente, sin pagar por nuevas solicitudes. Cuando tu agente o su tráfico cambie, vuelve a ejecutar la verificación con una nueva muestra de tus registros.
Establece GOOGLE_LOCATION en un nombre de ubicación canónico para ejecutar la verificación para una sola ciudad de EE. UU.:
GOOGLE_LOCATION="Chicago,Illinois,United States" \
  uv run overlap_check.py "plomero de emergencia"
Con Chicago, el script imprimió:
0/9 de las URLs principales de Google también en Parallel (advanced): plomero de emergencia
Promedio en 1 consulta: 0% de las URLs principales de Google también en Parallel
Para consultas de investigación abierta, donde la clasificación de Google no importa, agrega 2 verificaciones más a la medida de coincidencia. Revisa si las páginas recuperadas contienen la evidencia que necesita la respuesta, y si la respuesta está completa. Usa un juez LLM con una rúbrica escrita, y verifica al juez contra una muestra de etiquetas humanas.
Reflexiones finales
La API SERP de Bright Data devuelve la página que vería una persona en una ciudad determinada, con funciones como el map pack y AI Overview. En 30 consultas ejecutadas dos veces, el modo Advanced de Parallel devolvió del 35 al 43% de las URLs de la primera página de Google, así que tu elección cambia lo que lee tu agente.
Para contenido de página completa, el servidor MCP obtiene páginas con la misma clave de API a través de Web Unlocker, diseñado para sitios con protección antibots. Los extractos clasificados de Parallel son una buena opción para preguntas de investigación abierta donde la clasificación de Google no importa. Ejecuta el script de coincidencia con las consultas registradas de tu agente usando el plan gratuito de la API SERP, luego conecta el servidor MCP a tu agente.
Preguntas frecuentes
¿Qué es la búsqueda web de Parallel?
La búsqueda web de Parallel es una API de búsqueda que Parallel Web Systems creó para agentes de IA. Responde a consultas desde su propio índice web con URLs clasificadas y extractos en Markdown, en varios modos de velocidad y calidad. La API SERP de Bright Data devuelve, en cambio, la página de resultados en vivo de Google, para un país o ciudad elegidos.
¿Es gratis la búsqueda de Parallel?
En parte. La página de precios de Parallel indicaba $5 en créditos gratuitos al mes al probarla, suficiente para hasta 5.000 búsquedas Turbo o Fast. Los créditos requerían una tarjeta de crédito en la cuenta, y el Search MCP alojado de Parallel era gratis sin clave de API. La API SERP de Bright Data incluye un plan gratuito mensual recurrente, sin necesidad de tarjeta de crédito.
¿Cuánto cuesta la API de búsqueda de Parallel?
La página de precios de Parallel indicaba $1 por cada 1.000 solicitudes para Turbo y Fast y $5 por cada 1.000 para Basic y Advanced al probarla. Cada precio incluía 10 resultados, y los resultados adicionales costaban $1 por cada 1.000. La API Extract de Parallel costaba $1 por cada 1.000 URLs. La API SERP de Bright Data es de autoservicio y factura solo las solicitudes exitosas, con los planes actuales en su página de precios.
¿Es mejor Bright Data o Parallel para agentes de IA?
Ninguna de las dos APIs es mejor para todas las funciones. Elige Bright Data cuando el agente necesite la página de resultados en vivo de Google, segmentación por ciudad, AI Overviews o páginas con protección antibots. Elige Parallel cuando la clasificación de Google no importe, como en preguntas de investigación abierta. En 30 consultas de prueba ejecutadas dos veces, el modo Advanced de Parallel devolvió del 35 al 43% de las URLs de la primera página de Google.
¿Qué API es mejor para la búsqueda web?
Para agentes que necesitan la página de resultados de Google, usa una API SERP como la de Bright Data. Devuelve la página de resultados en vivo con segmentación a nivel de ciudad y funciones SERP como AI Overviews. Para investigación abierta, una API de índice como Parallel devuelve extractos clasificados para un objetivo.