En este tutorial, verás:
- El escenario de análisis de datos para explorar el mercado inmobiliario de San Diego.
- Por qué el SDK de Python de Bright Data simplifica el acceso a conjuntos de datos estructurados y listos para usar.
- Cómo filtrar, obtener y exportar datos de ventas de propiedades de Zillow.
- Cómo limpiar los datos, estandarizar unidades y calcular métricas útiles.
- Cómo visualizar precios de venta, tendencias geográficas, precisión del Zestimate y rendimientos estimados de alquiler.
¡Empecemos!
Presentando el Escenario
Imagina que eres un analista de datos encargado de entender el mercado inmobiliario de San Diego. Quieres responder preguntas clave, como: ¿Por cuánto se venden realmente las casas? ¿Qué barrios tienen los precios más altos por metro cuadrado? ¿Y qué tan precisas son las estimaciones de Zillow al predecir los precios finales de venta?
Para ello, necesitas un conjunto de datos reciente, confiable y rico de casas vendidas. Para tareas similares, Bright Data ofrece acceso a un conjunto de datos de propiedades de Zillow que contiene más de 137 millones de registros.
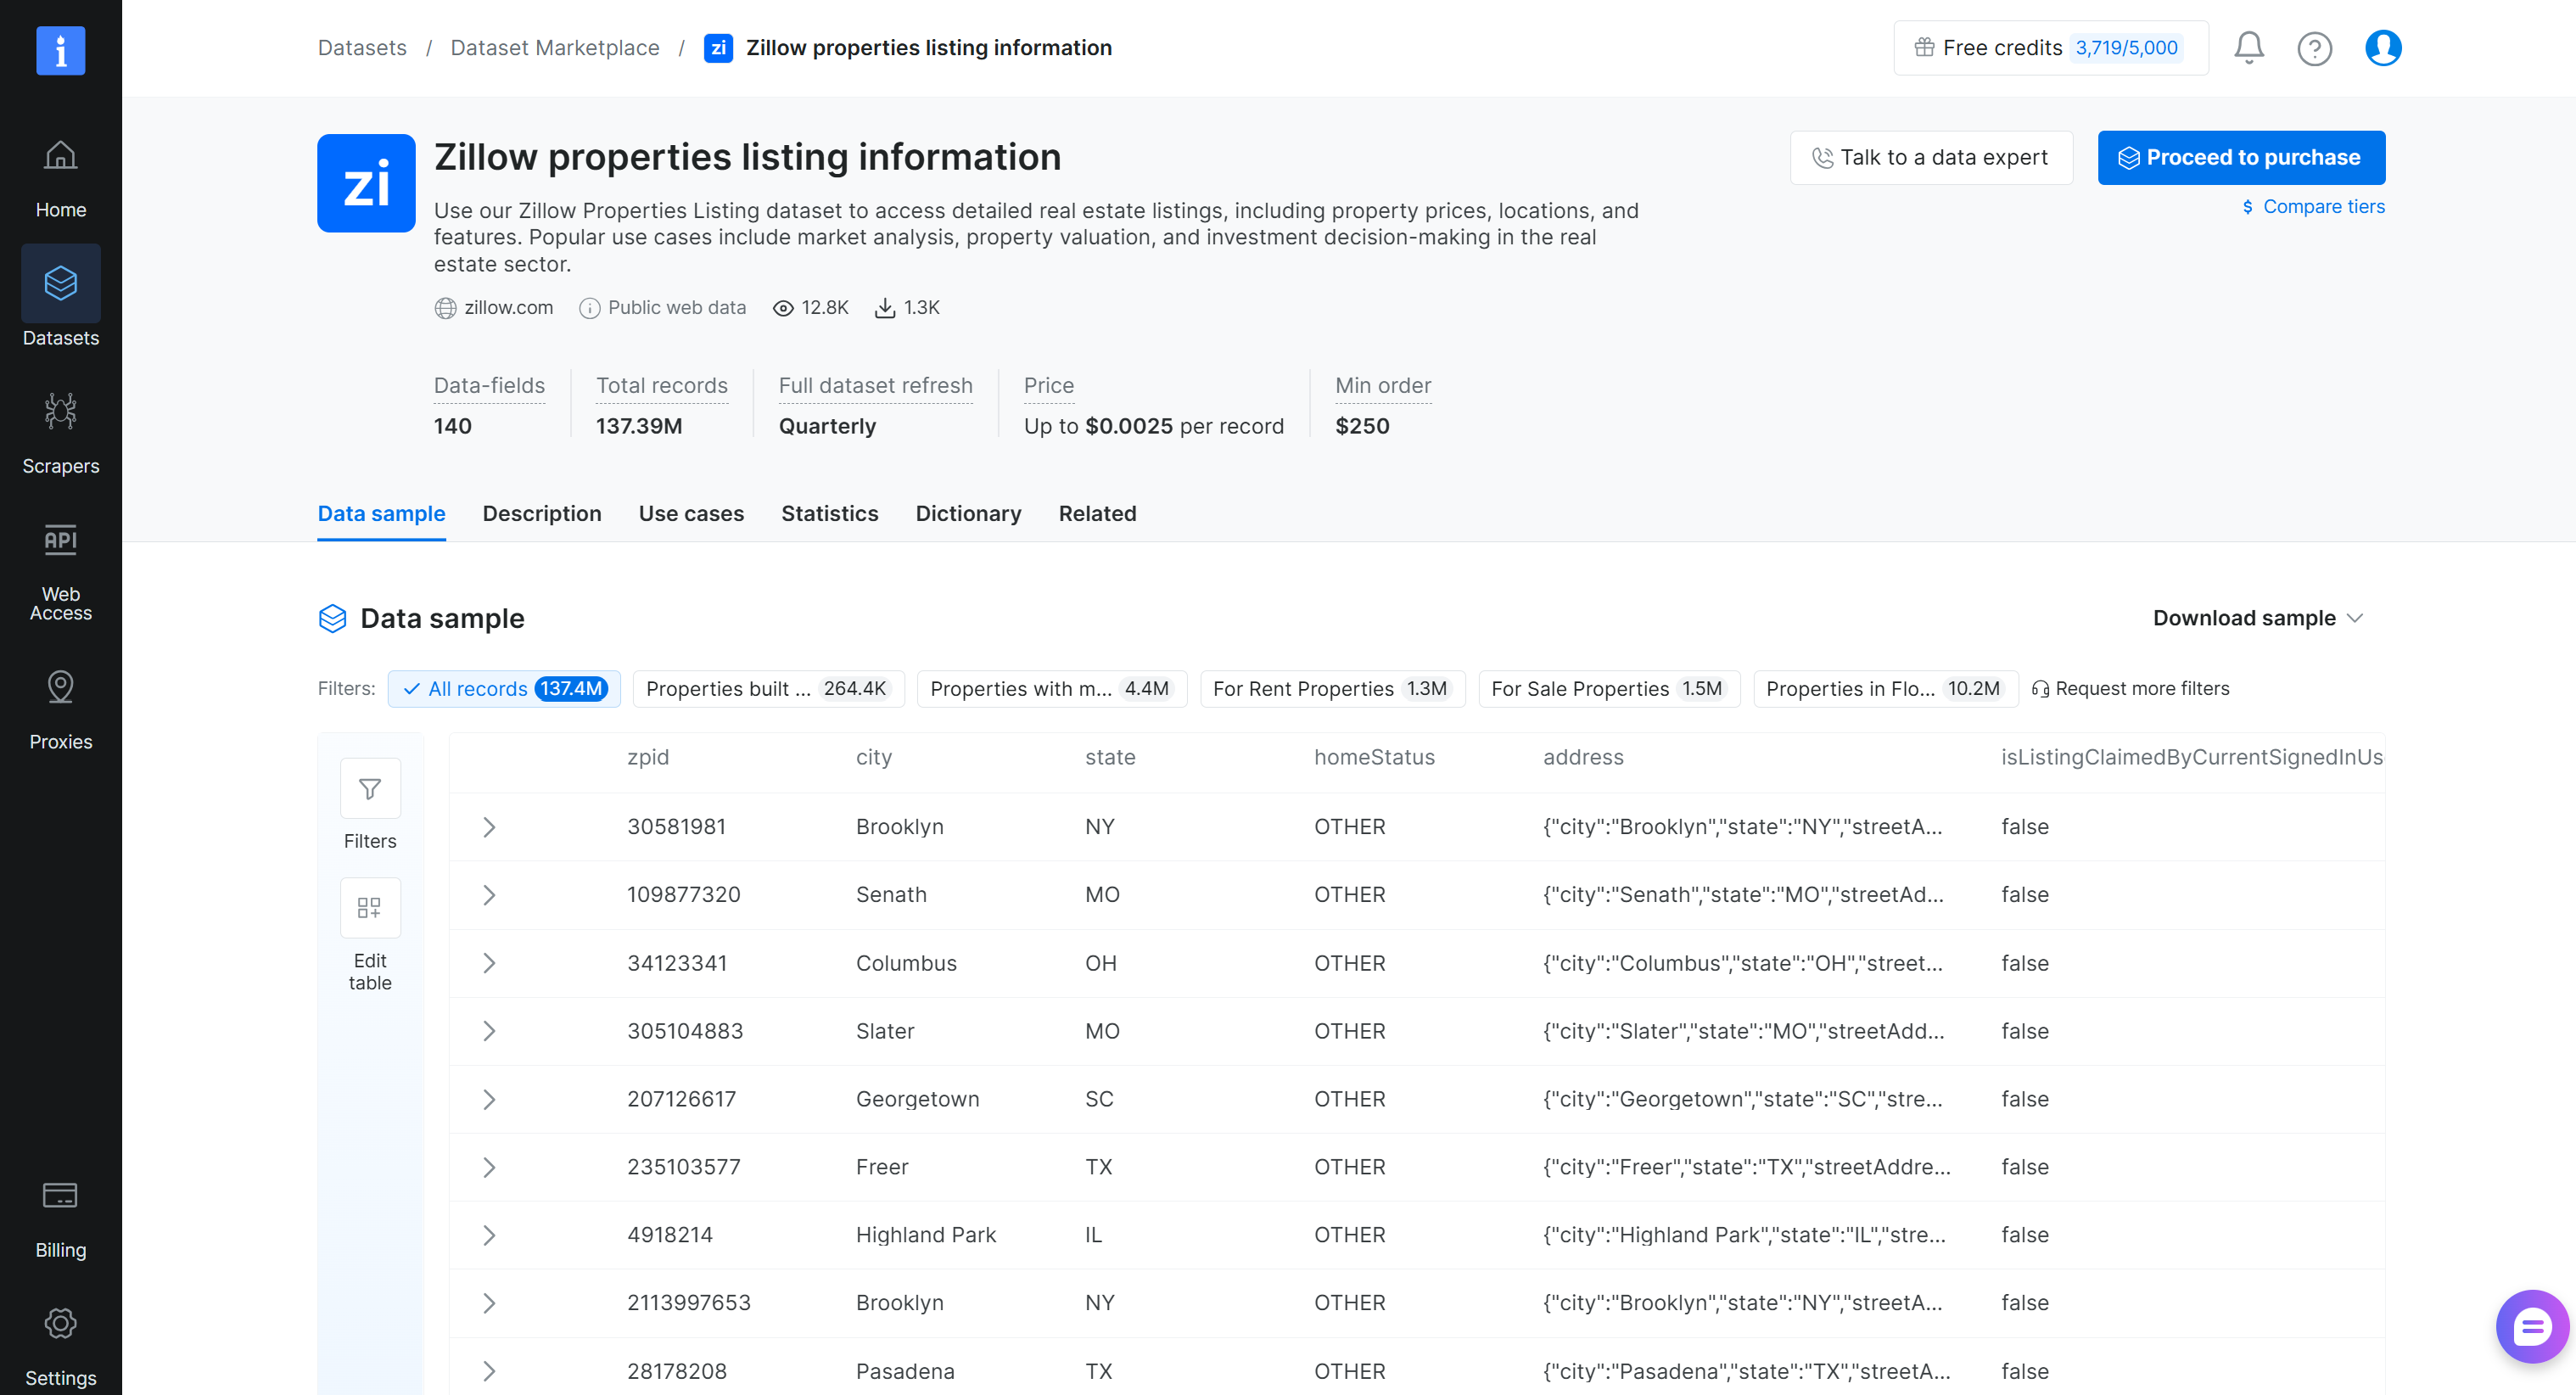
En los siguientes pasos, aprenderás a usar el SDK de Python de Bright Data para obtener una instantánea filtrada de ese conjunto de datos que contenga solo los registros relevantes para el escenario. Luego cargarás los datos en pandas y construirás un Jupyter Notebook con los gráficos y análisis necesarios para responder tus preguntas.
En el camino, también verás cómo limpiar los datos, estandarizar unidades de medida y calcular métricas derivadas para garantizar comparaciones justas y significativas entre barrios.
¿Por Qué Usar el SDK de Python de Bright Data?
Bright Data es un sitio web líder de conjuntos de datos, particularmente como proveedor de datos inmobiliarios. Ofrece una extensa colección de conjuntos de datos estructurados y actualizados frecuentemente que contienen miles de millones de registros de datos web disponibles públicamente.
Al trabajar en un proyecto de análisis y/o visualización de datos, el primer paso es obtener los datos que necesitas. Hay dos enfoques principales:
- Recolectar datos bajo demanda: Construir y ejecutar flujos de scraping web para extraer la información que necesitas directamente de los sitios web.
- Usar conjuntos de datos existentes: Obtener conjuntos de datos filtrados y pre-recolectados, listos para el análisis.
El SDK de Python de Bright Data admite ambos enfoques. Ofrece una interfaz de Python simplificada y tipada para acceder a las soluciones de recolección de datos web de Bright Data y proporciona métodos convenientes para recopilar conjuntos de datos estructurados directamente desde el marketplace de Bright Data.
Para más información, consulta los siguientes recursos:
- Documentación del SDK de Python
- Repositorio del SDK de Python
- Conoce el SDK de Python de Bright Data: Haz scraping, busca y obtén datos web
Obtener los Datos para Análisis y Visualización
Sigue los pasos a continuación para comenzar tu proyecto de análisis y visualización de datos, empezando por la obtención de datos.
Requisitos Previos
Asegúrate de tener:
- Python 3.10+ instalado en tu máquina local.
- Una cuenta de Bright Data con una clave API configurada. Consulta cómo obtener tu clave API de Bright Data.
Ejecuta el siguiente comando para instalar los paquetes de Python utilizados a lo largo de esta guía:
pip install brightdata-sdk jupyter pandas numpy matplotlib seaborn plotlyEstas bibliotecas proporcionan las herramientas necesarias para acceder a los conjuntos de datos de Bright Data, manipular y analizar datos, y manejar visualizaciones en un Jupyter Notebook.
Para autenticar el SDK de Python de Bright Data, configura tu clave API en la variable de entorno BRIGHTDATA_API_KEY. En macOS o Linux, ejecuta:
export BRIGHTDATA_API_KEY="<YOUR_BRIGHT_DATA_API_KEY>"En Windows, ejecuta el siguiente comando en PowerShell:
$env:BRIGHTDATA_API_KEY="<YOUR_BRIGHT_DATA_API_KEY>"Reemplaza <YOUR_BRIGHT_DATA_API_KEY> con tu clave API real de Bright Data.
Por simplicidad, asumiremos que ya tienes un proyecto local de Python con un Jupyter Notebook configurado.
Obtener los Datos Objetivo
Los datos de interés provienen del conjunto de datos de información de listados de propiedades de Zillow en Bright Data.
En este escenario, supón que solo te interesan las propiedades vendidas en San Diego durante el último año.
En tu proyecto de Python, crea un script que use el SDK de Bright Data para solicitar una instantánea del conjunto de datos con los filtros elegidos, espere a que la instantánea esté disponible y exporte los registros resultantes:
import asyncio
from datetime import date, timedelta
from brightdata import BrightDataClient
from brightdata.datasets import export

async def main():
    # Obtiene la fecha actual
    today = date.today()
    # Calcula el inicio de la ventana de ventas de interés (último año)
    one_year_ago = today - timedelta(days=365)

    # Define los filtros que cada propiedad devuelta debe cumplir
    filters = {
        "operator": "and",
        "filters": [
            {
                # Mantiene solo casas en San Diego
                "name": "city",
                "operator": "=",
                "value": "San Diego",
            },
            {
                # Mantiene solo casas en California
                "name": "state",
                "operator": "=",
                "value": "CA",
            },
            {
                # Mantiene solo listados vendidos
                "name": "homeStatus",
                "operator": "includes",
                "value": "SOLD",
            },
            {
                # Mantiene solo ventas del último año
                "name": "dateSold",
                "operator": ">=",
                "value": one_year_ago.isoformat(),
            },
        ],
    }

    async with BrightDataClient() as client:
        # Solicita hasta 1,000 registros del conjunto de datos filtrado
        snapshot_id = await client.datasets.zillow_properties(
            filter=filters,
            records_limit=1000,
        )

        # Espera a que la instantánea termine y descarga los registros
        data = await client.datasets.zillow_properties.download(
            snapshot_id,
            timeout=600 # Espera hasta 10 min
        )

        # Confirma cuántos registros se descargaron
        print(f"Downloaded {len(data)} records")

        # Guarda los registros en un archivo CSV
        export(data, "properties.csv")

if __name__ == "__main__":
    asyncio.run(main())
El script anterior solicita de forma asíncrona una instantánea del conjunto de datos, espera hasta 10 minutos a que se complete, descarga los registros, informa el número obtenido y los exporta a properties.csv, listos para el análisis en pandas.
Utiliza el SDK de Bright Data para obtener registros de propiedades de Zillow que coincidan con los filtros especificados: casas en San Diego, California, vendidas en los últimos 365 días. Internamente, el SDK llama a la API de Filtrado de Bright Data, que te permite obtener instantáneas filtradas de los conjuntos de datos de Bright Data.
Ten en cuenta que el límite de registros está fijado en 1,000, pero puedes ajustarlo a cualquier número que se adapte a tus necesidades. También puedes agregar nuevos filtros o modificar los existentes para refinar el conjunto de datos y obtener solo los registros relevantes para tu análisis.
Nota: La función auxiliar export() detecta el formato de salida a partir de la extensión del archivo, por lo que .csv produce un archivo CSV. Otros formatos de exportación compatibles incluyen JSON, NDJSON y JSONL.
Explorar el Conjunto de Datos Obtenido
Ejecuta el script de obtención de datos. Aparecerá un archivo properties.csv en el directorio de tu proyecto:
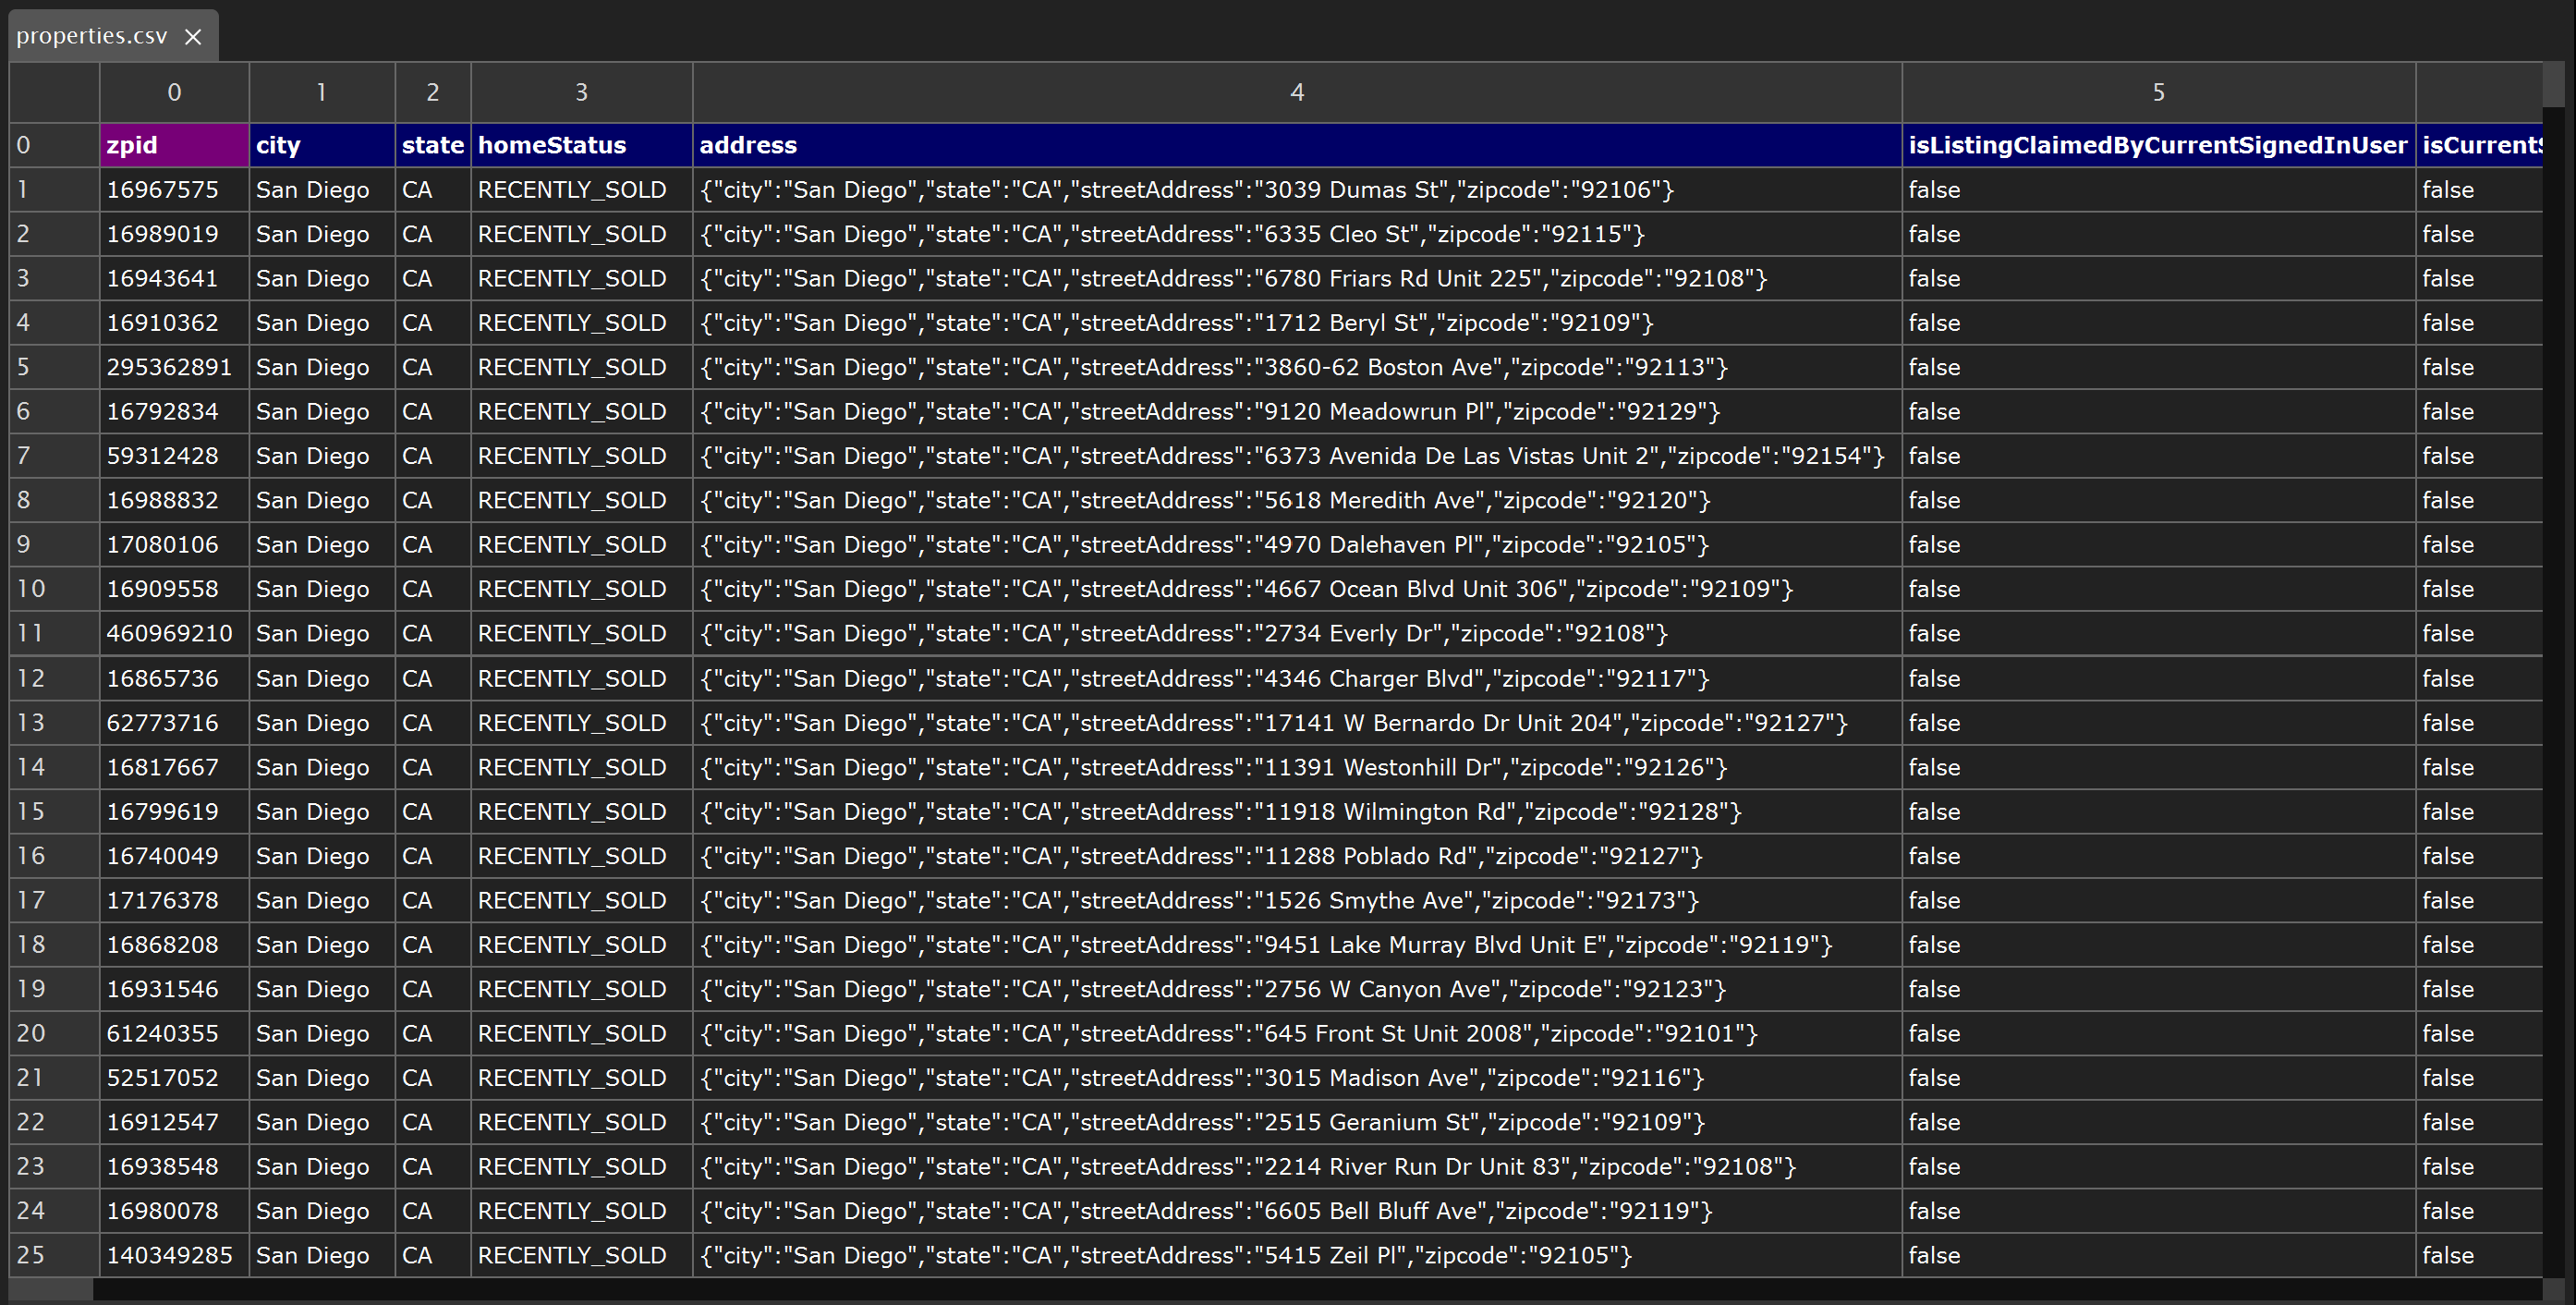
Abre el archivo, y notarás los 1,000 registros de propiedades de Zillow devueltos en formato CSV estructurado. Cada registro contiene aproximadamente 140 columnas. Las más relevantes son:
| Columna | Descripción |
|---|---|
zipcode, latitude, longitude |
Ubicación de la casa |
homeType |
Tipo de propiedad, como SINGLE_FAMILY o CONDO |
bedrooms, bathrooms |
Número de habitaciones y baños |
price |
Precio de venta en USD |
livingAreaValue, livingAreaUnits |
Tamaño interior y su unidad |
lotAreaValue, lotAreaUnits |
Tamaño del terreno, en pies cuadrados o acres |
yearBuilt |
Año de construcción |
dateSoldString |
Fecha de venta (YYYY-MM-DD) |
daysOnZillow |
Cuánto tiempo estuvo activo el listado |
zestimate, rentZestimate |
Valor estimado de Zillow y alquiler mensual |
taxAssessedValue |
Valor usado para impuestos de la propiedad |
Descúbrelas todas en la sección “Dictionary” de la página del panel de control de Bright Data para el conjunto de datos de listados de propiedades de Zillow:
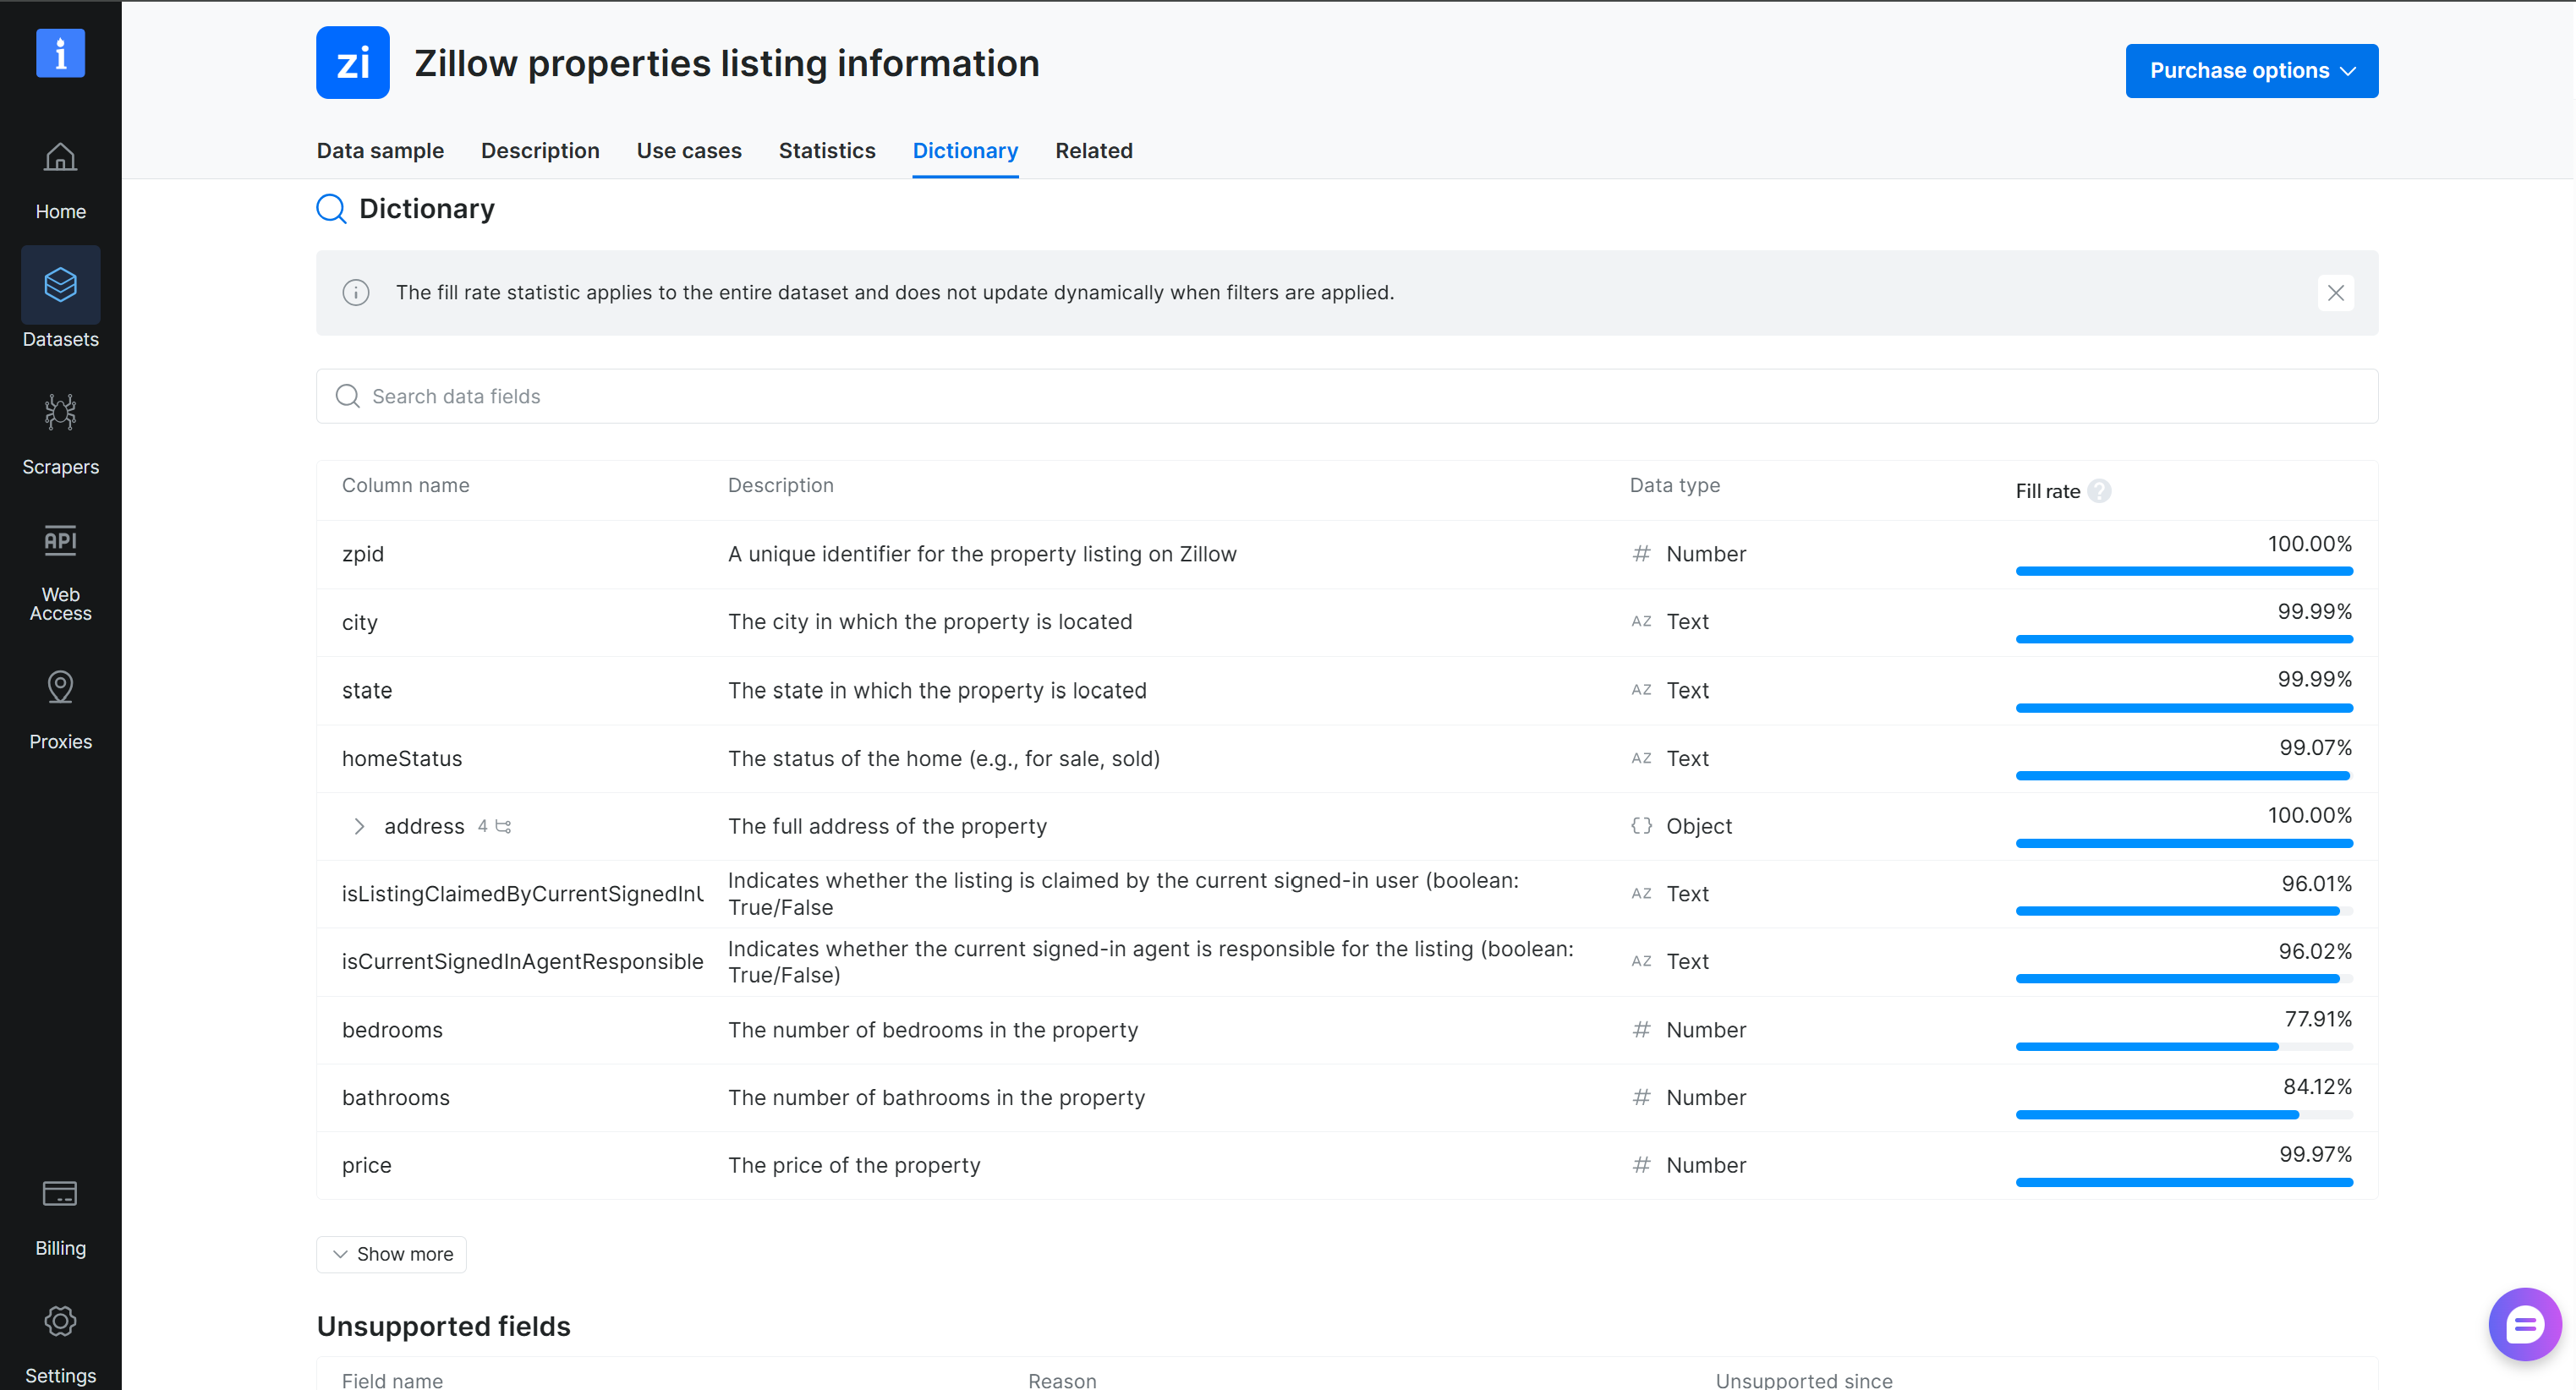
¡Misión cumplida! Ahora tienes los datos crudos y estructurados.
A continuación, aprenderás a limpiarlos y prepararlos para el análisis y la visualización. Luego, definirás más de 10 escenarios para explorar el mercado inmobiliario de San Diego y responder tus preguntas clave sobre precios de venta de casas, asequibilidad de barrios y la precisión de las estimaciones de Zillow.
Preparar los Datos para Análisis y Visualización
Ahora que has obtenido el conjunto de datos, abre tu notebook y prepara el conjunto de datos para el análisis de datos. En una celda dedicada, realiza estas tareas:
- Importa las bibliotecas necesarias para la manipulación de datos, el análisis estadístico y la visualización.
- Configura las opciones de trazado de datos.
- Carga el conjunto de datos importando
properties.csven un DataFrame de pandas. - Limpia y estandariza los datos manejando valores faltantes, corrigiendo tipos de datos y convirtiendo campos a formatos consistentes.
- Crea variables adicionales para respaldar un análisis, comparaciones y visualizaciones más efectivos.
Completa estos pasos con:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import plotly.express as px
from matplotlib.ticker import FuncFormatter
from IPython.display import display

# Muestra los precios del eje como números completos, por ejemplo 1,000,000
usd_fmt = FuncFormatter(lambda x, _: f"{x:,.0f}")

# Usa un estilo de cuadrícula limpio para todos los gráficos
sns.set_theme(style="whitegrid")

# Factor de conversión de pies cuadrados a metros cuadrados
SQFT_TO_M2 = 0.092903
# Factor de conversión de acres a pies cuadrados
ACRE_TO_SQFT = 43560
# Ignora códigos postales con menos ventas que esto
MIN_SALES = 3

# Formatea las columnas de un DataFrame como texto, luego muéstralo como tabla
def show_table(frame, formats, title=""):
    # Trabaja sobre una copia para no modificar los datos originales
    out = frame.copy()
    # Aplica cada formato a su columna, mostrando valores faltantes como un guion
    for col, fmt in formats.items():
        out[col] = out[col].map(lambda v, f=fmt: f.format(v) if pd.notna(v) else "-")
    # Imprime un encabezado sobre la tabla cuando se da un título
    if title:
        print(title)
    # Muestra la tabla formateada
    display(out)

# Carga el CSV, manteniendo los códigos postales como texto
df = pd.read_csv("properties.csv", dtype={"zipcode": str})

# Lista las columnas que deberían ser números
numeric_cols = ["price", "bedrooms", "bathrooms", "livingAreaValue", "lotAreaValue",
                "yearBuilt", "daysOnZillow", "zestimate", "rentZestimate",
                "taxAssessedValue", "latitude", "longitude"]
# Convierte esas columnas a números, convirtiendo valores inválidos en NaN
df[numeric_cols] = df[numeric_cols].apply(pd.to_numeric, errors="coerce")

# Rellena los códigos postales a 5 dígitos
df["zipcode"] = df["zipcode"].str.zfill(5)
# Convierte el texto de la fecha de venta en un datetime
df["dateSold"] = pd.to_datetime(df["dateSoldString"])

# Encuentra las filas donde el área habitable está en pies cuadrados
is_sqft = df["livingAreaUnits"].eq("Square Feet")
# Convierte pies cuadrados a m², y deja NaN para otras unidades
df["living_area_m2"] = np.where(is_sqft, df["livingAreaValue"] * SQFT_TO_M2, np.nan)

# Convierte el tamaño del terreno a pies cuadrados, ya sea que estuviera en acres o ya en pies cuadrados
lot_sqft = np.where(df["lotAreaUnits"].eq("Acres"),
                    df["lotAreaValue"] * ACRE_TO_SQFT,
                    df["lotAreaValue"])
# Convierte el tamaño del terreno a metros cuadrados
df["lot_m2"] = lot_sqft * SQFT_TO_M2

# Elimina filas sin un precio de venta válido
df = df[df["price"] > 0].copy()
# Calcula el precio de venta por metro cuadrado
df["price_per_m2"] = df["price"] / df["living_area_m2"]
# Calcula la diferencia entre el precio de venta y el Zestimate como porcentaje
df["zestimate_error_pct"] = ((df["price"] - df["zestimate"])
                             / df["zestimate"].where(df["zestimate"] > 0) * 100)
# Calcula el alquiler anual como porcentaje del precio de venta
df["rent_yield_pct"] = df["rentZestimate"] * 12 / df["price"] * 100
# Agrupa los precios en bandas, etiquetadas con números completos en USD
df["price_band"] = pd.cut(df["price"], bins=[0, 500_000, 1_000_000, 1_500_000, np.inf],
                          labels=["<500,000", "500,000-1,000,000",
                                  "1,000,000-1,500,000", ">1,500,000"])
# Agrupa las casas por era de construcción
df["age_band"] = pd.cut(df["yearBuilt"], bins=[0, 1949, 1979, 1999, np.inf],
                        labels=["<1950", "1950-1979", "1980-1999", "2000+"])

# Resume cuántas casas y códigos postales hay en el conjunto de datos limpio
print(f"{len(df)} sold homes across {df['zipcode'].nunique()} ZIP codes")

# Previsualiza las columnas clave con precios y áreas formateados
show_table(
    # Selecciona las columnas clave para la vista previa
    df[["zpid", "streetAddress", "zipcode", "homeType", "bedrooms", "bathrooms",
        "price", "living_area_m2", "dateSold"]].head(),
    # Formatea los precios como números completos y las áreas con un decimal
    formats={"price": "{:,.0f}", "living_area_m2": "{:,.1f} m²"},
    title="Sample of sold homes",
)
Ejecútala, y obtendrás este resultado:
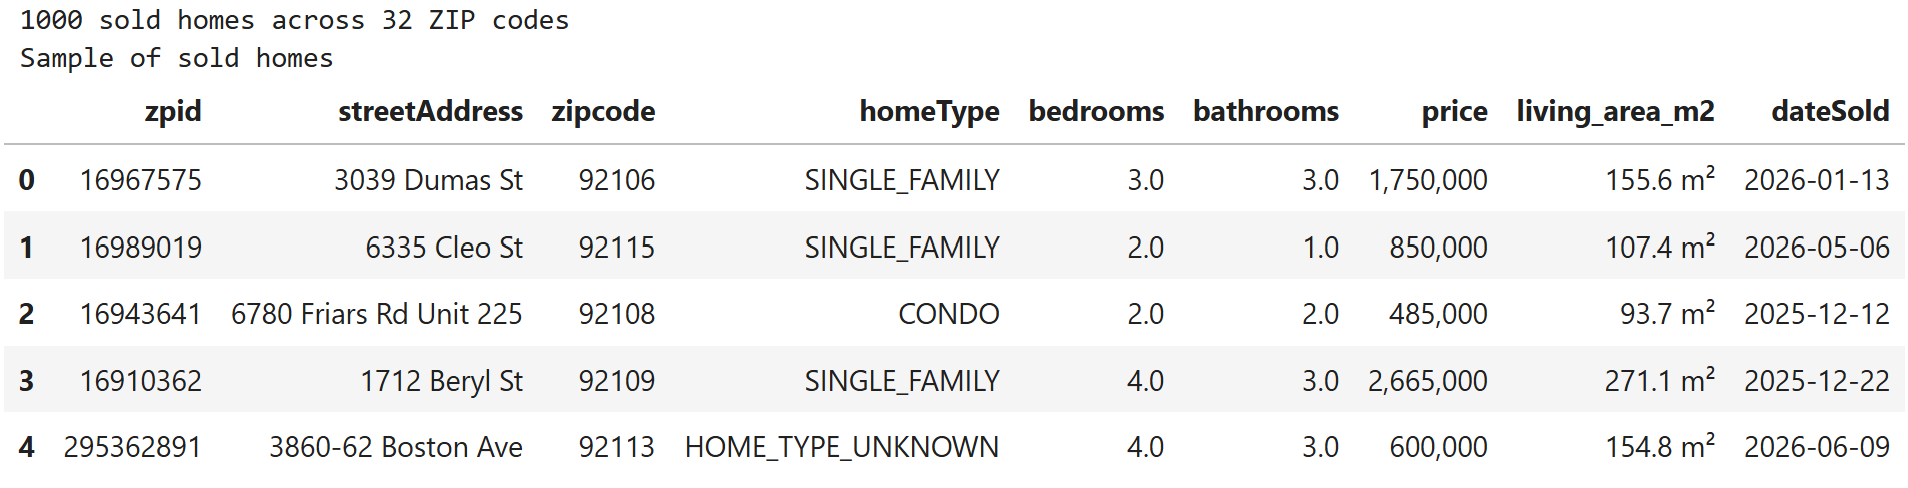
Cabe destacar que la celda anterior se encarga de:
- Normalizar unidades de medida: Las áreas habitables y los tamaños de terreno se convierten a metros cuadrados, de modo que cada métrica basada en tamaño use la misma unidad.
- Manejar valores faltantes: Los errores del Zestimate solo se calculan cuando el Zestimate es mayor que cero, lo que evita la división por cero.
- Agregar campos derivados: El precio por m², el rendimiento de alquiler, las bandas de precio y las bandas de antigüedad se agregan como columnas para simplificar la visualización de datos.
¡Fantástico! Estás listo para continuar con el análisis y la visualización de datos.
Análisis y Visualización
Aquí verás más de 10 formas prácticas de examinar y visualizar el conjunto de datos, descubriendo patrones e información sobre el mercado inmobiliario de San Diego. Cada sección incluye una breve descripción, el código de la celda, el resultado obtenido y una interpretación de los hallazgos.
Distribución de los Precios de Venta
Descripción: Explora dónde se concentran la mayoría de los precios de venta, con la mediana marcada para ver qué tan sesgado está el mercado.
Celda:
plt.figure(figsize=(10, 6))

# Dibuja un histograma de precios con una curva de densidad suavizada
sns.histplot(df["price"], bins=30, kde=True, color="steelblue")

# Calcula el precio de venta mediano
median = df["price"].median()

# Dibuja una línea roja discontinua en la mediana, etiquetada con el número completo
plt.axvline(median, color="red", linestyle="--", label=f"Median: {median:,.0f} USD")
# Muestra los precios del eje x como números completos
plt.gca().xaxis.set_major_formatter(usd_fmt)

plt.title("Distribution of Sold Prices in San Diego")
plt.xlabel("Sold price (USD)")
# Elimina el recorte automático en el eje x
plt.xlim(left=0)
plt.ylabel("Number of homes")
plt.legend()
plt.show()Resultado:
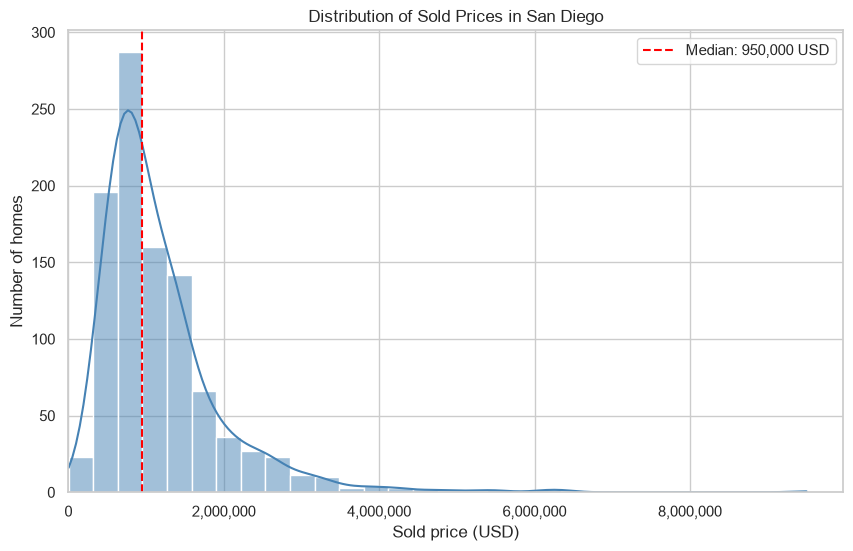
Comentario: La mayoría de las ventas se concentran entre aproximadamente 500,000 y 1,500,000 USD, con un pico cerca de 750,000 USD, mientras que la mediana de 950,000 USD se ubica más alta. Una larga cola llega hasta casi 9,500,000 USD. La distribución está sesgada a la derecha, lo que eleva la media por encima de la mediana.
Precio Mediano por Tipo de Vivienda
Descripción: Compara el precio de venta mediano y medio entre tipos de propiedades para ver qué tipos de vivienda impulsan el mercado.
Celda:
# Agrupa las ventas por tipo de propiedad y calcula estadísticas resumidas
by_type = (df.groupby("homeType")
             # Cuenta las casas, y toma el precio mediano y medio para cada tipo
             .agg(homes=("zpid", "count"),
                  median_price=("price", "median"),
                  mean_price=("price", "mean"))
             # Ordena los tipos del precio mediano más alto al más bajo
             .sort_values("median_price", ascending=False))

show_table(by_type.reset_index(),
           formats={"median_price": "{:,.0f}", "mean_price": "{:,.0f}"},
           title="Sold price by home type (USD)")

plt.figure(figsize=(10, 6))
sns.barplot(data=by_type.reset_index(), x="homeType", y="median_price", color="steelblue")
plt.gca().yaxis.set_major_formatter(usd_fmt)
plt.xticks(rotation=30)
plt.title("Median Sold Price by Home Type")
plt.xlabel("Home type")
plt.ylabel("Median price (USD)")
plt.show()Resultado:
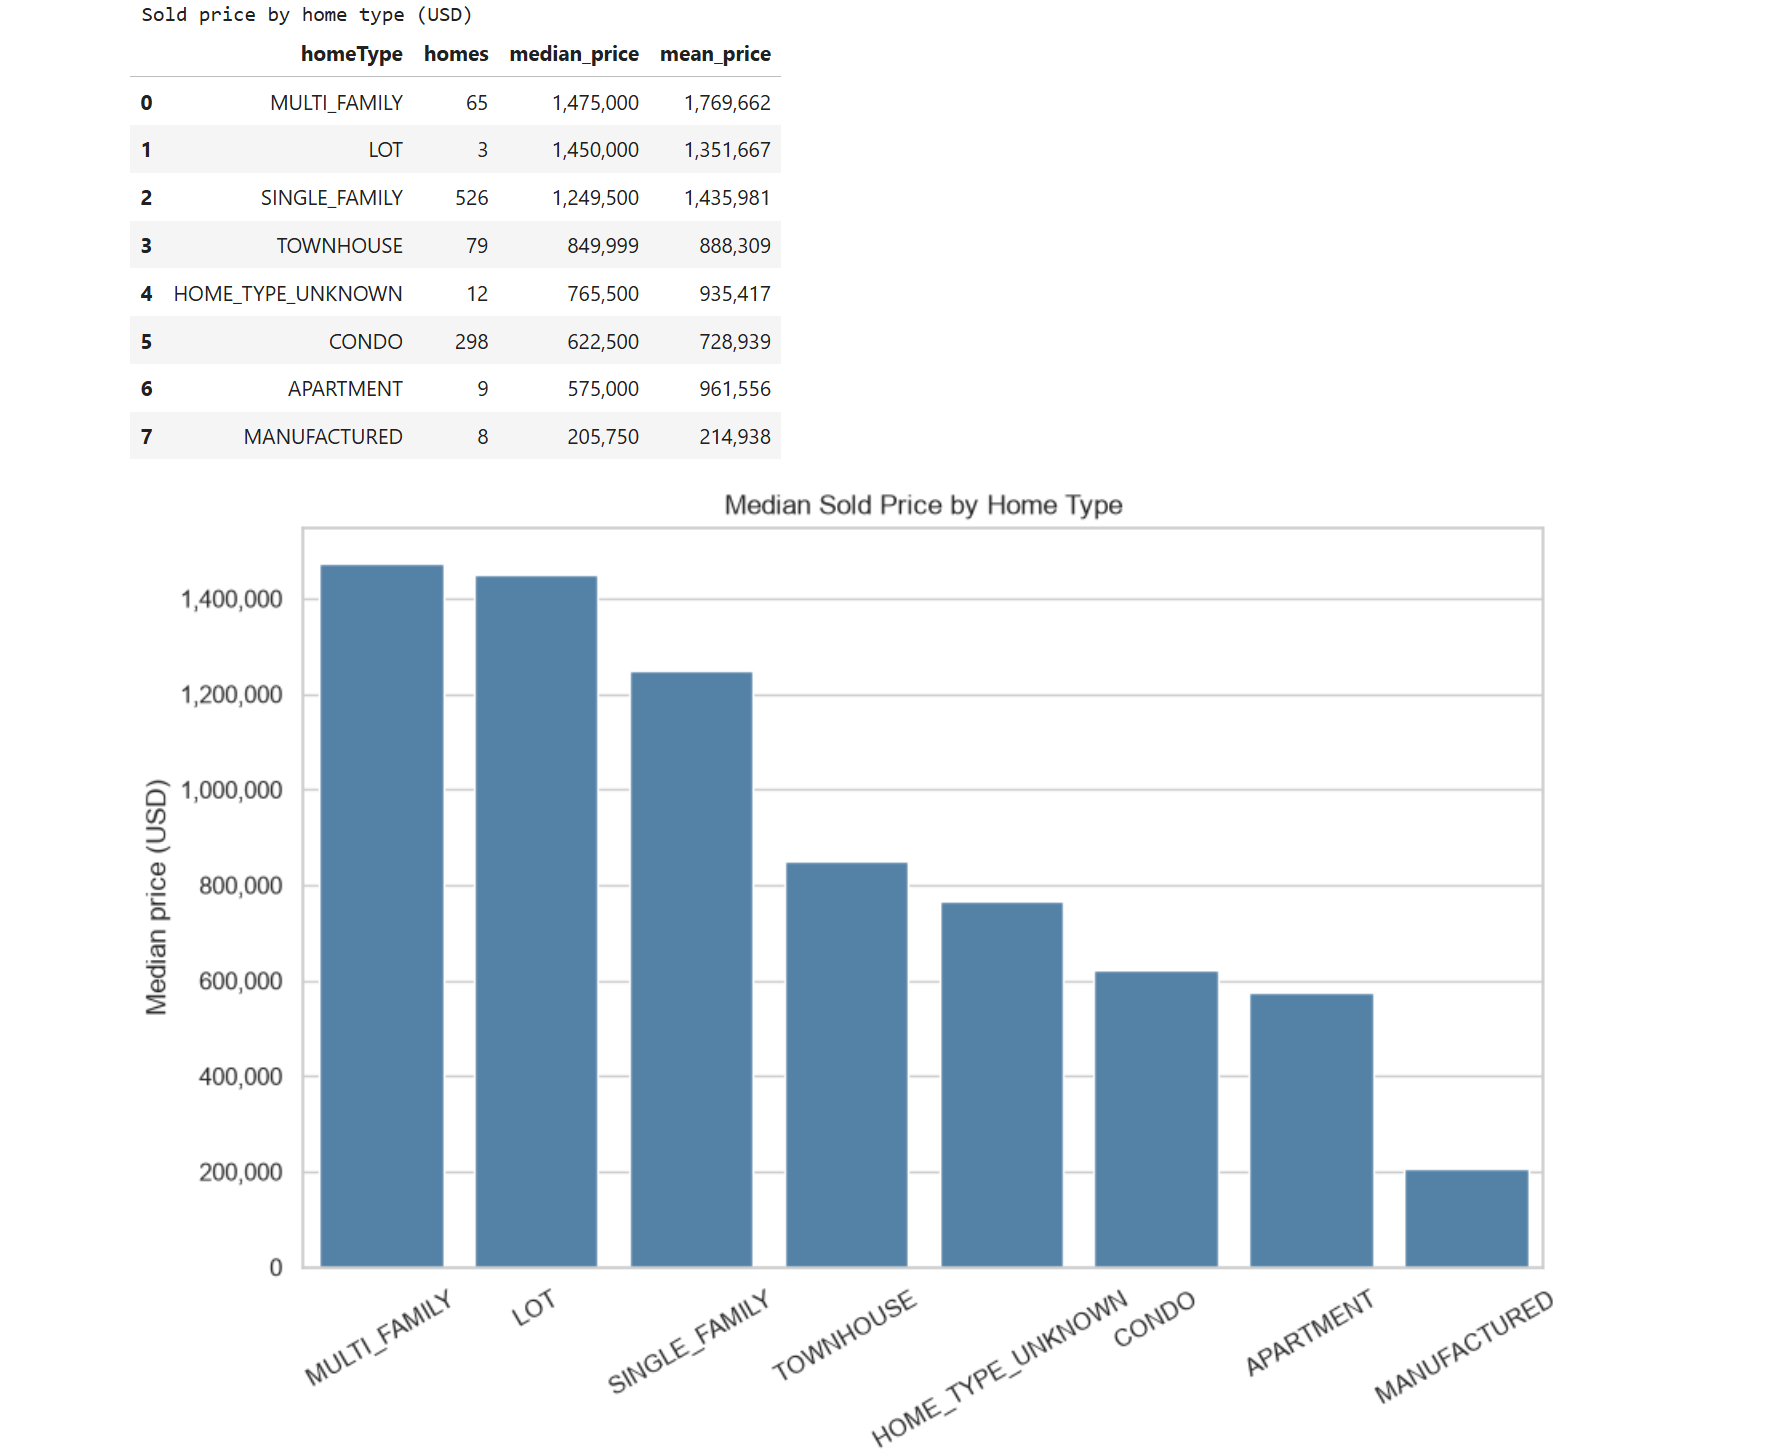
Comentario: Las casas unifamiliares son el punto de referencia más confiable, con una mediana de 1,249,500 USD en 526 ventas. Las medianas de multifamiliares y terrenos parecen más altas, pero se basan en muchas menos ventas (65 y 3), mientras que las casas prefabricadas son las más baratas con 205,750 USD, y los condominios se sitúan en 622,500 USD.
Principales Códigos Postales por Precio de Venta Mediano
Descripción: Clasifica los 15 códigos postales más caros por precio de venta mediano. Se excluyen los códigos postales con muy pocas ventas para evitar medianas engañosas.
Celda:
# Agrupa las ventas por código postal y calcula el conteo de ventas y el precio mediano
zip_stats = (df.groupby("zipcode")
               .agg(sales=("zpid", "count"), median_price=("price", "median"))
               # Elimina códigos postales con muy pocas ventas
               .query("sales >= @MIN_SALES")
               # Ordena de más a menos caro
               .sort_values("median_price", ascending=False)
               # Mantiene solo los primeros 15
               .head(15)
               # Convierte el índice de código postal de nuevo en columna
               .reset_index())

show_table(zip_stats,
           formats={"median_price": "{:,.0f}"},
           title=f"Top 15 ZIP codes by median sold price (min. {MIN_SALES} sales)")

plt.figure(figsize=(10, 7))
sns.barplot(data=zip_stats, x="median_price", y="zipcode", color="steelblue")
plt.gca().xaxis.set_major_formatter(usd_fmt)
plt.title(f"Top 15 ZIP Codes by Median Sold Price (min. {MIN_SALES} sales)")
plt.xlabel("Median price (USD)")
plt.ylabel("ZIP code")
plt.show()Resultados:
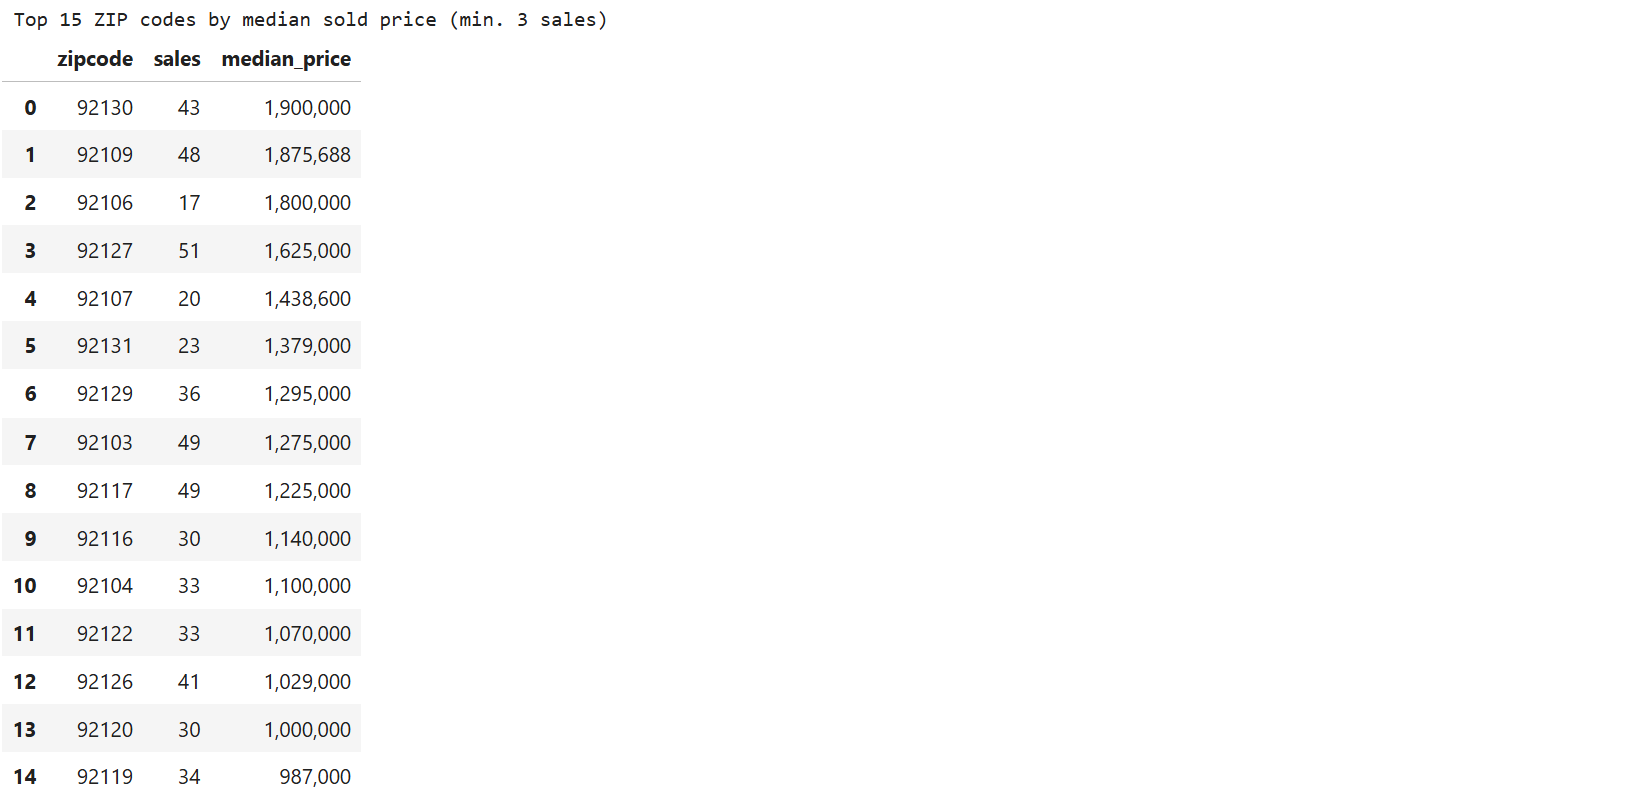
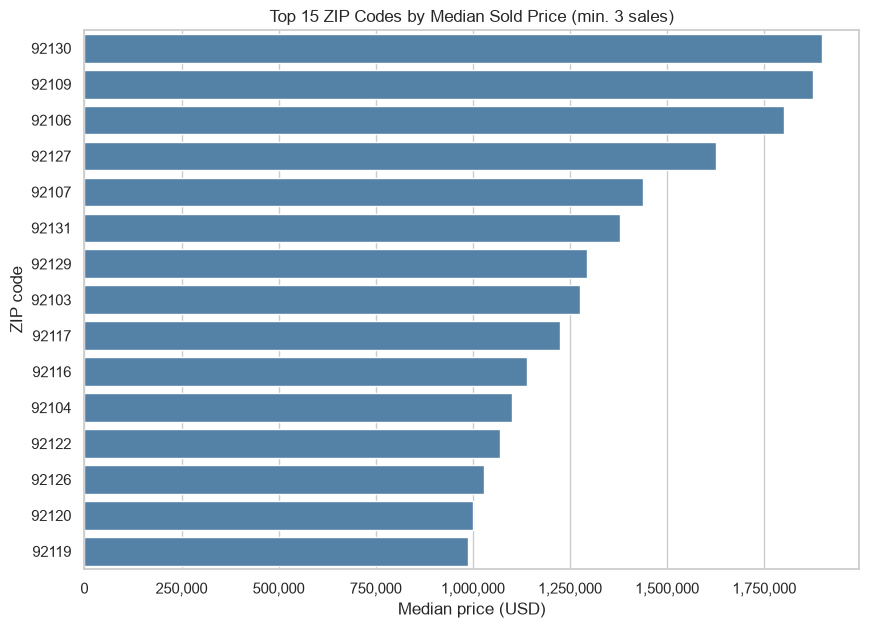
Comentario: 92130, 92109 y 92106 lideran, con medianas de al menos 1,800,000 USD. 92118 (Coronado) tiene la mediana más alta, por encima de 3,300,000 USD, pero muy pocas ventas para clasificar. 92106 se basa en solo 17 ventas, por lo que su posición puede cambiar.
Mapa de Dónde se Vendieron las Casas
Descripción: Traza cada venta en un mapa, coloreado por precio de venta, para ver dónde están ubicadas las casas más caras.
Celda:
# Copia los datos originales
map_df = df.copy()

for col in ["latitude", "longitude", "price"]:
    map_df[col] = pd.to_numeric(map_df[col], errors="coerce")

# Mantiene filas con coordenadas y precios de venta válidos
map_df = map_df.dropna(subset=["latitude", "longitude", "price"])

fig = px.scatter_map(
    map_df,
    lat="latitude",
    lon="longitude",
    color="price",
    hover_name="streetAddress",
    hover_data={
        "zipcode": True,
        "homeType": True,
        "bedrooms": True,
        "price": ":,.0f",
        "latitude": False,
        "longitude": False,
    },
    labels={
        "price": "Sold price (USD)",
    },
    color_continuous_scale="Viridis",

    center={"lat": 32.8157, "lon": -117.1611},
    zoom=8.8,
    height=650,
    map_style="open-street-map",
    title="Where Homes Sold in San Diego (color = sold price in USD)",
)

fig.show(renderer="notebook")

# Define los cortes geográficos
longitude_cutoff = -117.2
latitude_cutoff = 32.8

# Divide las propiedades en grupos occidental y oriental
west = geo_df[geo_df["longitude"] < longitude_cutoff]
east = geo_df[geo_df["longitude"] >= longitude_cutoff]

# Divide las propiedades en grupos norte y sur
north = geo_df[geo_df["latitude"] >= latitude_cutoff]
south = geo_df[geo_df["latitude"] < latitude_cutoff]

# Muestra los precios medianos y el tamaño de las muestras
print("WESTERN VS. EASTERN PROPERTIES")
print("-" * 40)
print(f"West of longitude {longitude_cutoff}:")
print(f"  Median sold price: ${west['price'].median():,.0f}")
print(f"  Number of properties: {len(west):,}")

print(f"\nEast of or at longitude {longitude_cutoff}:")
print(f"  Median sold price: ${east['price'].median():,.0f}")
print(f"  Number of properties: {len(east):,}")

print("\nNORTHERN VS. SOUTHERN PROPERTIES")
print("-" * 40)
print(f"North of or at latitude {latitude_cutoff}:")
print(f"  Median sold price: ${north['price'].median():,.0f}")
print(f"  Number of properties: {len(north):,}")

print(f"\nSouth of latitude {latitude_cutoff}:")
print(f"  Median sold price: ${south['price'].median():,.0f}")
print(f" Number of properties: {len(south):,}")Resultados:
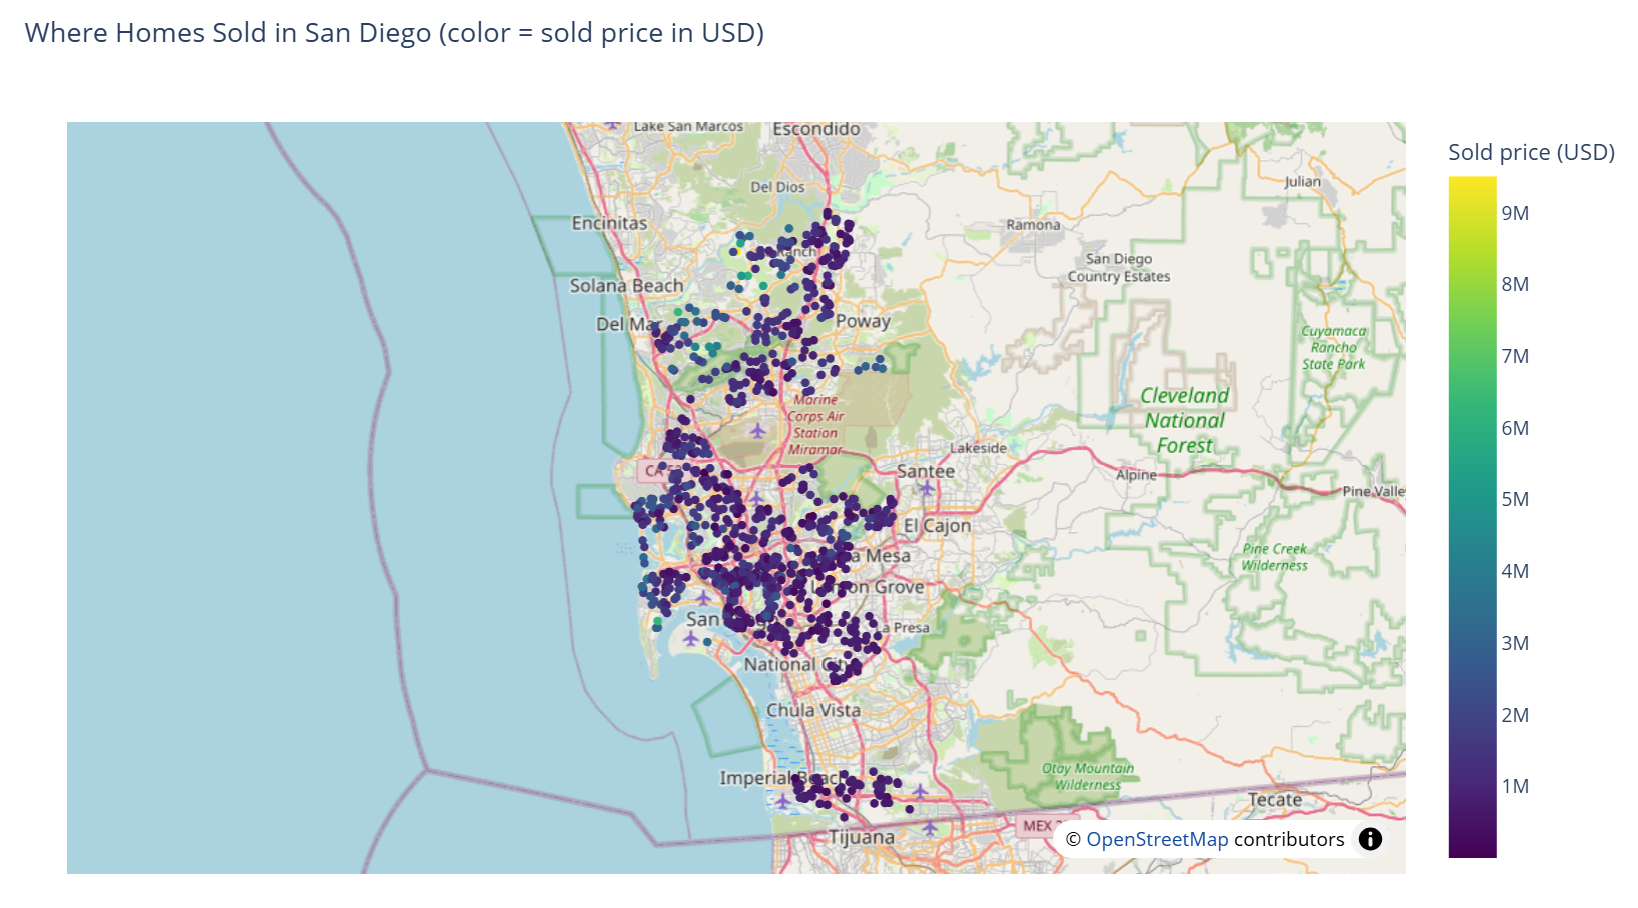
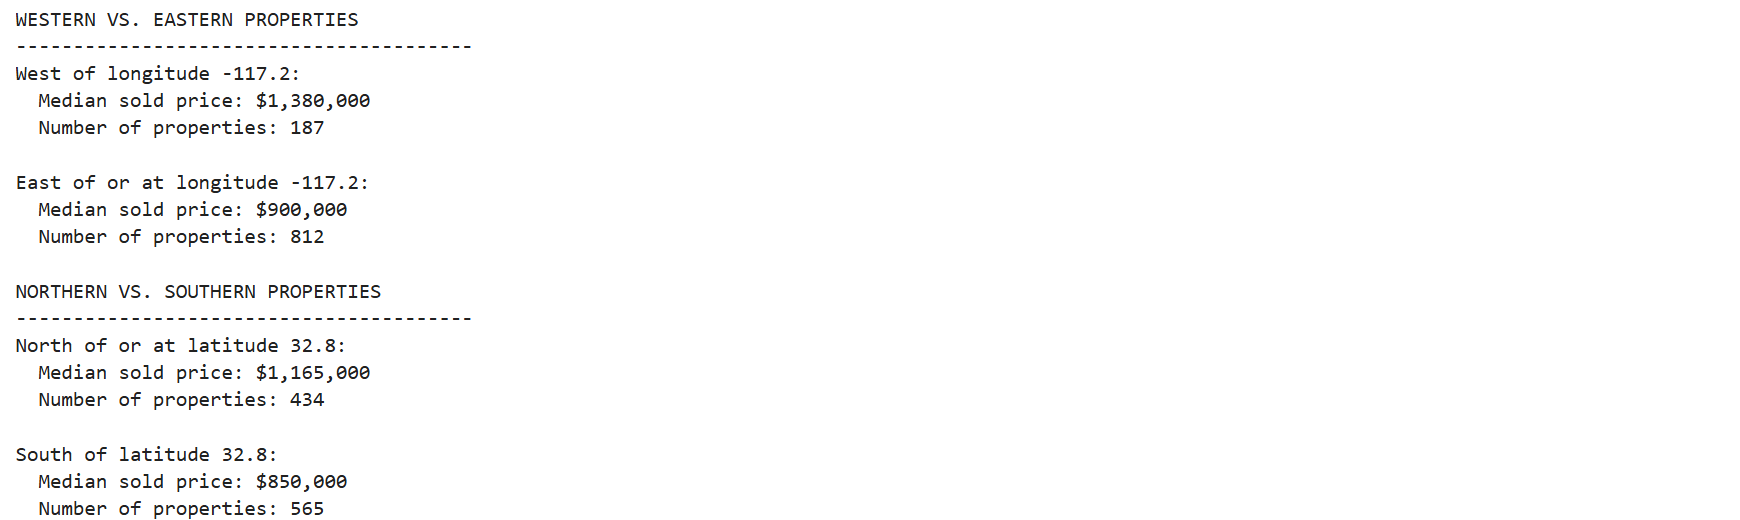
Comentario: Las casas al oeste de la longitud -117.2 tienen una mediana de alrededor de 1,380,000 USD, frente a 900,000 USD tierra adentro. Las ventas del norte (mediana de 1,165,000 USD) son mucho más caras que las del sur (850,000 USD).
Precio por m² por Código Postal
Descripción: Compara la dispersión del precio por metro cuadrado en los 10 códigos postales con más ventas.
Celda:
# Encuentra los 10 códigos postales con más ventas
top_zips = df["zipcode"].value_counts().head(10).index
# Mantiene las ventas en esos códigos postales que tienen un precio por m² válido
zip_m2 = df[df["zipcode"].isin(top_zips)].dropna(subset=["price_per_m2"])
# Ordena los códigos postales por su precio mediano por m², el más alto primero
order = (zip_m2.groupby("zipcode")["price_per_m2"]
               # Toma el precio mediano por m² para cada código postal
               .median()
               # Ordena de mayor a menor
               .sort_values(ascending=False)
               # Mantiene los códigos postales en ese orden
               .index)

plt.figure(figsize=(12, 6))
sns.boxplot(data=zip_m2, x="zipcode", y="price_per_m2", order=order,
            hue="zipcode", legend=False, palette="Set2", showfliers=False)
plt.gca().yaxis.set_major_formatter(usd_fmt)
plt.title("Sold Price per m² in the 10 Most Active ZIP Codes")
plt.xlabel("ZIP code")
plt.ylabel("Price per m² (USD)")
plt.show()Resultado:
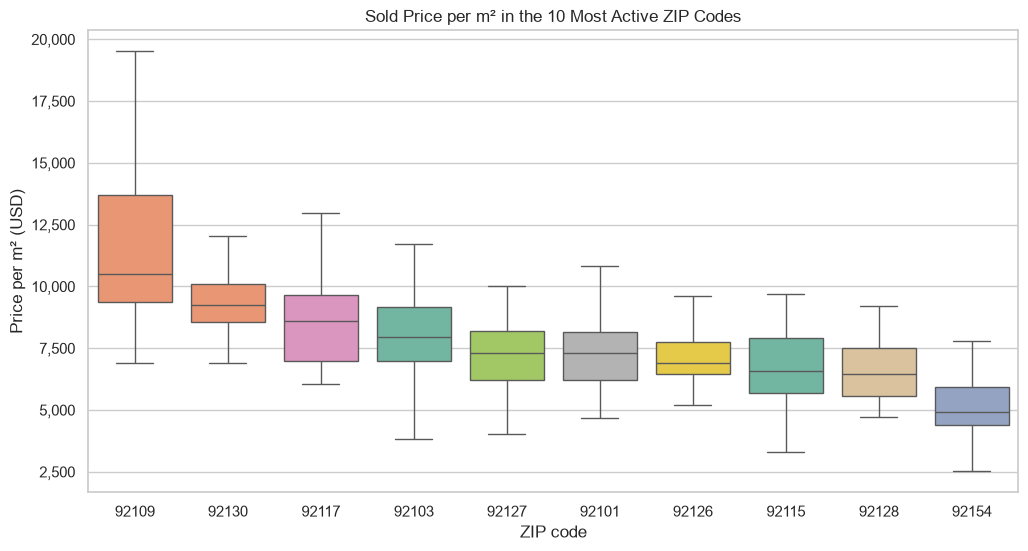
Comentario: 92109 tiene el precio mediano por m² más alto (alrededor de 10,500 USD) y la mayor dispersión. 92154 es el más barato, con alrededor de 4,900 USD.
Precio por m² vs. Área Habitable por Código Postal para Viviendas Unifamiliares
Descripción: Comprueba si las viviendas unifamiliares más grandes se venden a menor precio por metro cuadrado según el código postal.
Celda:
# Mantiene solo casas unifamiliares con precio por m² y área habitable
d = df[
    (df["homeType"] == "SINGLE_FAMILY")
].dropna(subset=["price_per_m2", "living_area_m2"]).copy()

# Mantiene los 10 códigos postales más activos como sus propios grupos y pone el resto en "Other"
d["zip_group"] = np.where(d["zipcode"].isin(top_zips), d["zipcode"], "Other")

zip_order = list(top_zips) + ["Other"]

fig = px.scatter(
    d,
    x="living_area_m2",
    y="price_per_m2",
    facet_col="zip_group",
    facet_col_wrap=4,
    category_orders={"zip_group": zip_order},
    hover_data={
        "zipcode": True,
        "price": ":,.0f",
        "living_area_m2": ":,.1f",
        "zip_group": False,
    },
    labels={
        "living_area_m2": "Living area (m²)",
        "price_per_m2": "Price per m² (USD)",
        "price": "Sold price (USD)",
    },
    height=1200,
    title="Price per m² vs. Living Area for Single-Family Homes by ZIP Code",
)

fig.for_each_annotation(
    lambda a: a.update(text=a.text.split("=")[-1])
)

fig.update_xaxes(
    matches=None,
    showticklabels=True,
    showline=True,
    tickformat=",.0f",
    title_text="Living area (m²)",
)

fig.update_yaxes(
    tickformat=",.0f",
    title_text="Price per m² (USD)",
)

fig.show(renderer="notebook")Resultado:
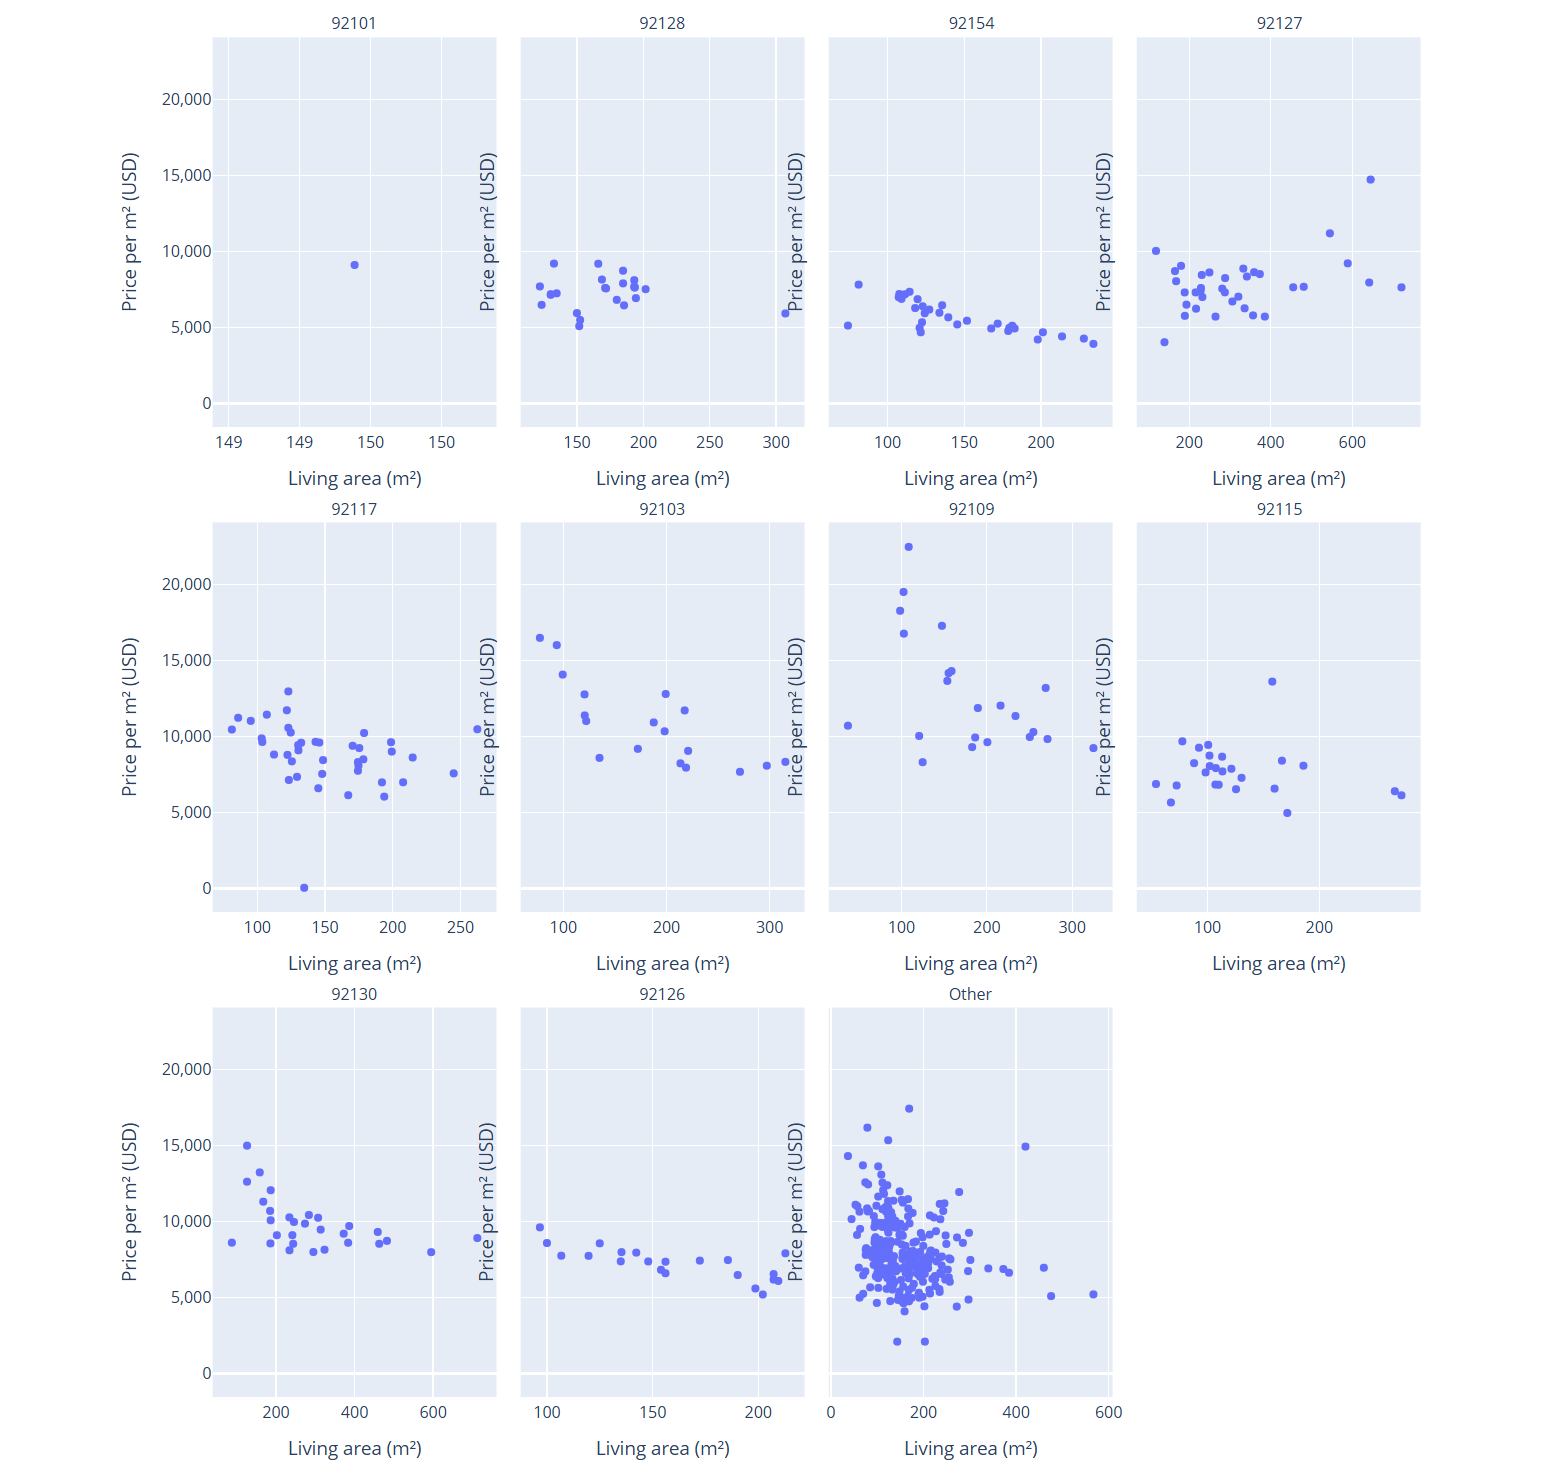
Comentario: Algunos códigos postales (ej. 92154, 92126, 92103) muestran casas más grandes que cuestan menos por m². 92127 es la excepción, con tendencia al alza. En general, la correlación parece ser casi nula, por lo que el barrio importa más que el tamaño.
Matriz de Correlación de Características de las Viviendas
Descripción: Verifica la correlación de Pearson entre el precio y las principales características físicas y del listado.
Celda:
corr_cols = {
    # Precio de venta en USD
    "price": "Price",
    # Número de habitaciones
    "bedrooms": "Bedrooms",
    # Número de baños
    "bathrooms": "Bathrooms",
    "living_area_m2": "Living area",
    "lot_m2": "Lot size",
    # Año de construcción
    "yearBuilt": "Year built",
    # Valor estimado de Zillow
    "zestimate": "Zestimate",
    # Valor evaluado para impuestos
    "taxAssessedValue": "Tax assessed value",
}
# Calcula correlaciones de Pearson por pares entre las columnas renombradas
corr = df[list(corr_cols)].rename(columns=corr_cols).corr()

plt.figure(figsize=(10, 8))
sns.heatmap(corr, annot=True, fmt=".2f", cmap="coolwarm", vmin=-1, vmax=1, linewidths=0.5)
plt.title("Correlation Matrix of Sold Home Features (Pearson)")
plt.show()Resultado:
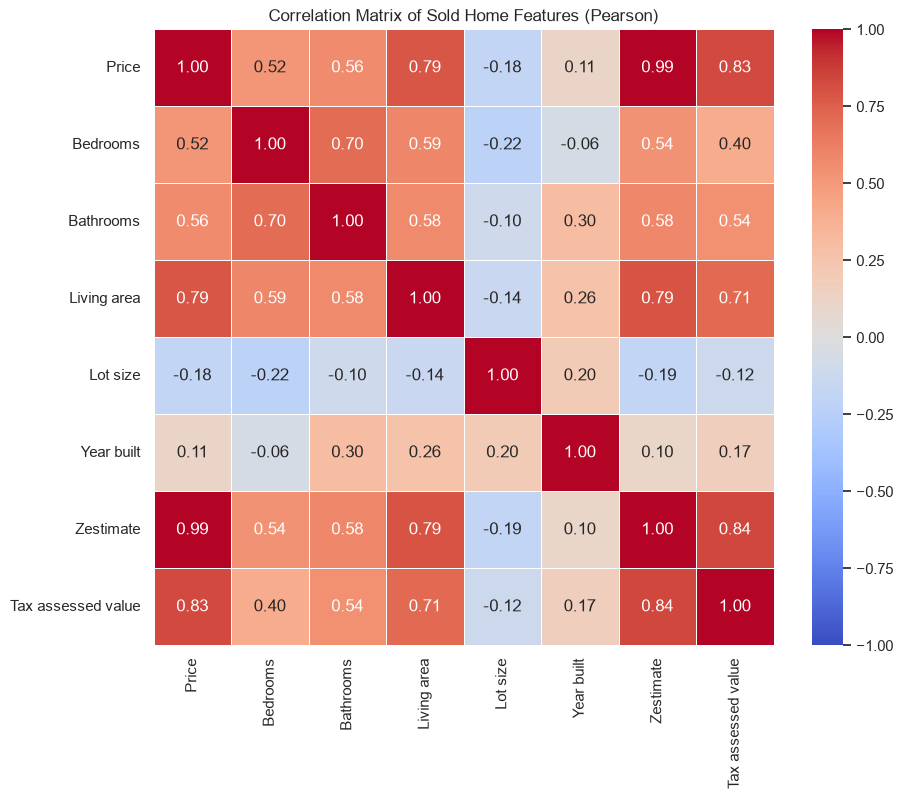
Comentario: El Zestimate (0.99) funciona casi como una copia del precio. El área habitable (0.79), los baños (0.56) y las habitaciones (0.52) son los indicadores de precio más útiles, mientras que el año de construcción apenas influye en el precio (0.11).
Mezcla de Bandas de Precio en los Códigos Postales Más Activos
Descripción: Muestra cómo difiere la proporción de ventas en cada banda de precio entre los 10 códigos postales más activos.
Celda:
# Mantiene las ventas de los 10 códigos postales más activos
top_df = df[df["zipcode"].isin(top_zips)]
# Calcula el porcentaje de cada banda de precio dentro de cada código postal
mix = pd.crosstab(top_df["zipcode"], top_df["price_band"], normalize="index") * 100

ax = mix.plot(kind="barh", stacked=True, figsize=(10, 6),
              colormap="RdYlGn_r", width=0.8)
ax.set_xlabel("Share of sales (%)")
ax.set_ylabel("ZIP code")
ax.set_title("Price Band Mix in the 10 Most Active ZIP Codes")
ax.legend(title="Price band (USD)", bbox_to_anchor=(1.02, 1), loc="upper left")
plt.tight_layout()
plt.show()Resultado:
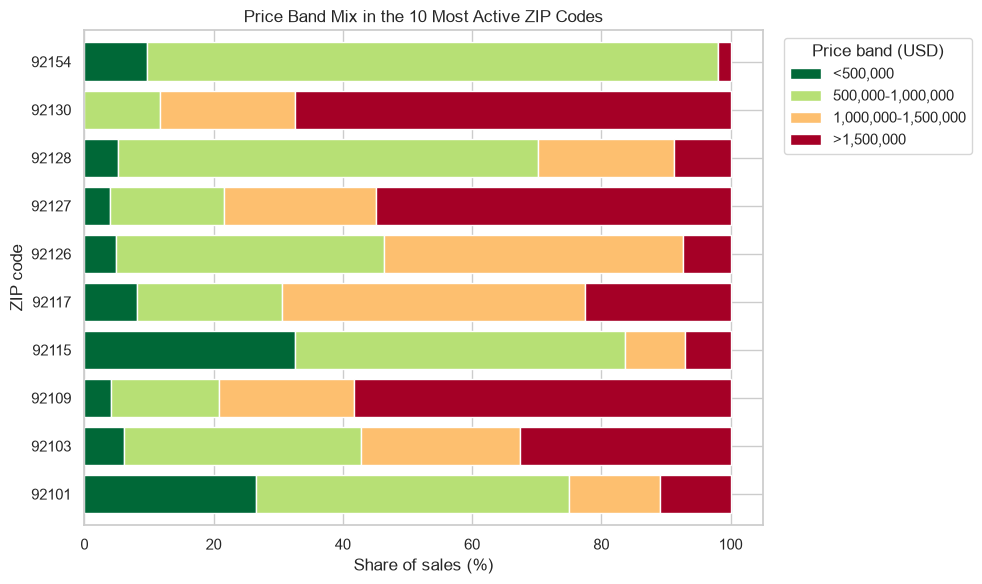
Comentario: El código postal 92154 es el más de gama media, con alrededor del 88% de las ventas entre 500,000 y 1,000,000 USD. Los códigos 92130, 92109 y 92127 están mayormente por encima de 1,500,000 USD. Las ventas asequibles son más comunes en 92115, con alrededor de un tercio por debajo de 500,000 USD.
Días en Zillow por Banda de Precio
Descripción: Comprueba si las viviendas más caras tardan más en venderse, usando los días en Zillow por banda de precio.
Celda:
# Mantiene las casas con días en el mercado y una banda de precio
d = df.dropna(subset=["daysOnZillow", "price_band"])
# Calcula la correlación de Spearman, que es la correlación de Pearson en rangos
rho = d["price"].rank().corr(d["daysOnZillow"].rank())

plt.figure(figsize=(10, 6))
sns.boxplot(data=d, x="price_band", y="daysOnZillow", hue="price_band",
            legend=False, palette="Oranges")
plt.title(f"Days on Zillow by Price Band (Spearman ρ with price = {rho:.2f})")
plt.xlabel("Price band (USD)")
plt.ylabel("Days on Zillow")
plt.show()Resultado:
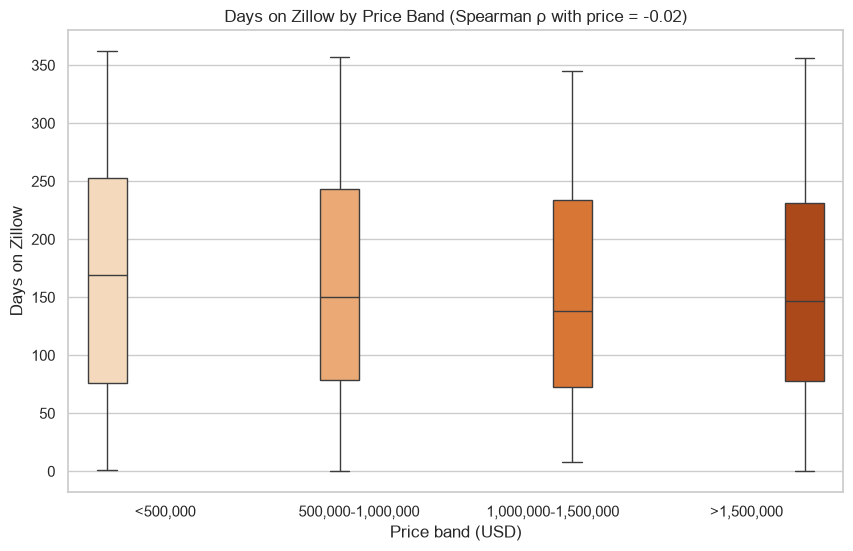
Comentario: Los días en Zillow apenas cambian con el precio (Spearman ρ = -0.02). El tiempo mediano de listado se mantiene entre aproximadamente 140 y 170 días en todas las bandas, con una amplia dispersión desde casi cero hasta más de 350 días. Así que el precio por sí solo no explica la rapidez con la que se vende una casa.
¿Qué Tan Preciso Es el Zestimate?
Descripción: Mide la diferencia entre cada precio de venta y el Zestimate de Zillow para ver qué tan precisas son las estimaciones.
Celda:
# Mantiene las casas donde se pudo calcular el error
d = df.dropna(subset=["zestimate_error_pct"])
median_abs_error = d["zestimate_error_pct"].abs().median()

plt.figure(figsize=(10, 6))
sns.histplot(d["zestimate_error_pct"], bins=40, kde=True, color="purple")
# Marca el error cero, donde la estimación coincide con el precio de venta
plt.axvline(0, color="black", linestyle="--")
# Se enfoca en errores entre -20% y +20%
plt.xlim(-20, 20)
plt.title(f"Sold Price vs. Zestimate (median absolute error: {median_abs_error:.1f}%)")
plt.xlabel("(Sold price - Zestimate) / Zestimate (%)")
plt.ylabel("Number of homes")
plt.show()Resultado:
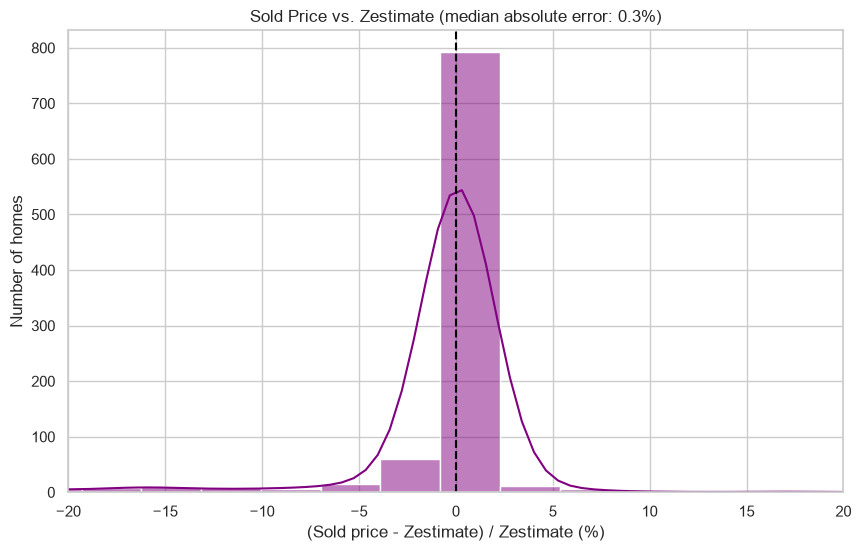
Comentario: El error absoluto mediano es de solo 0.3%, por lo que el Zestimate es preciso para la mayoría de las casas. Un puñado de ventas se sitúa un 20% o más lejos de la estimación.
Rendimiento Bruto de Alquiler Estimado por Código Postal
Descripción: Estima el alquiler anual como proporción del precio de venta para cada código postal, para comparar rendimientos de alquiler.
Celda:
# Agrupa las ventas por código postal y calcula el conteo de ventas y el rendimiento mediano
yield_stats = (df.groupby("zipcode")
                 .agg(sales=("zpid", "count"), median_yield=("rent_yield_pct", "median"))
                 # Elimina códigos postales con muy pocas ventas
                 .query("sales >= @MIN_SALES")
                 # Ordena de mayor a menor rendimiento
                 .sort_values("median_yield", ascending=False)
                 # Mantiene solo los primeros 15
                 .head(15)
                 # Convierte el índice de código postal de nuevo en columna
                 .reset_index())

show_table(yield_stats,
           formats={"median_yield": "{:.1f}%"},
           title="Top 15 ZIP codes by estimated gross rental yield")

plt.figure(figsize=(10, 7))
sns.barplot(data=yield_stats, x="median_yield", y="zipcode", color="seagreen")
plt.title("Estimated Gross Rental Yield by ZIP Code (Top 15)")
plt.xlabel("Gross yield (%) = rent Zestimate × 12 / sold price")
plt.ylabel("ZIP code")
plt.show()Resultado:
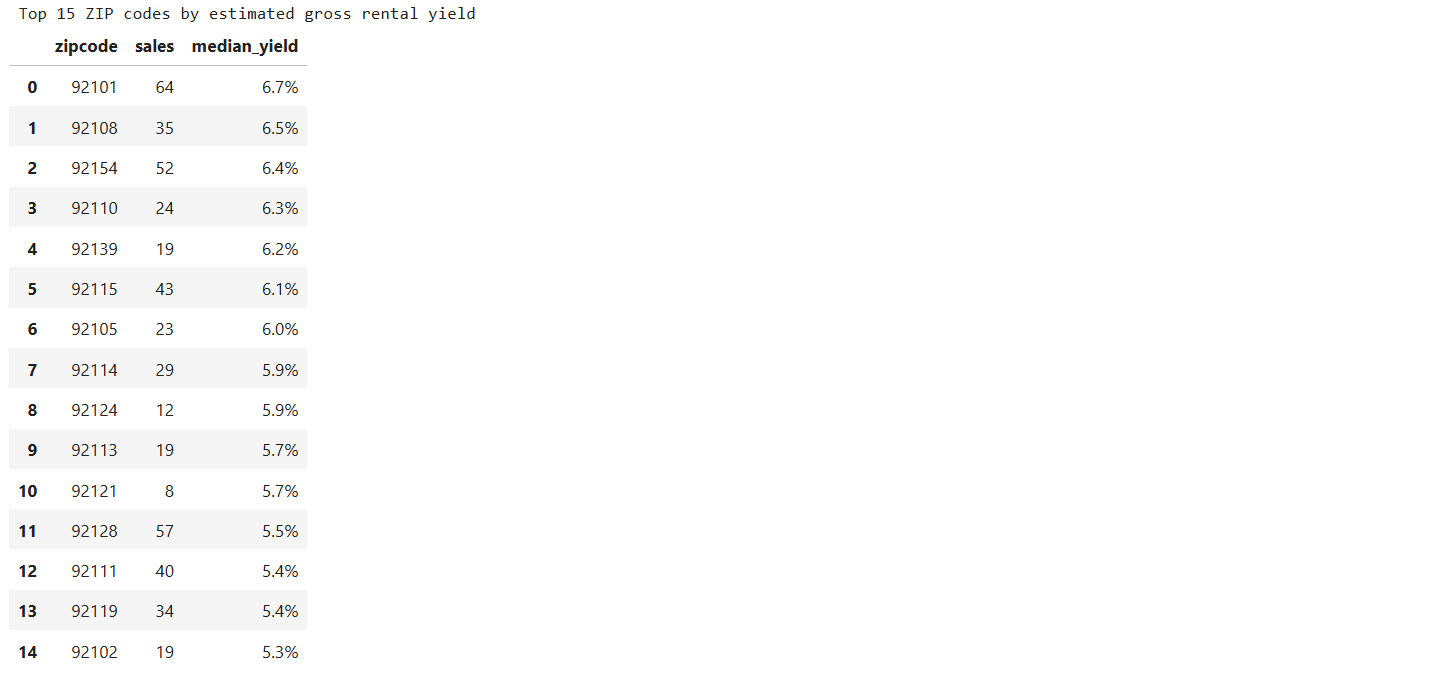
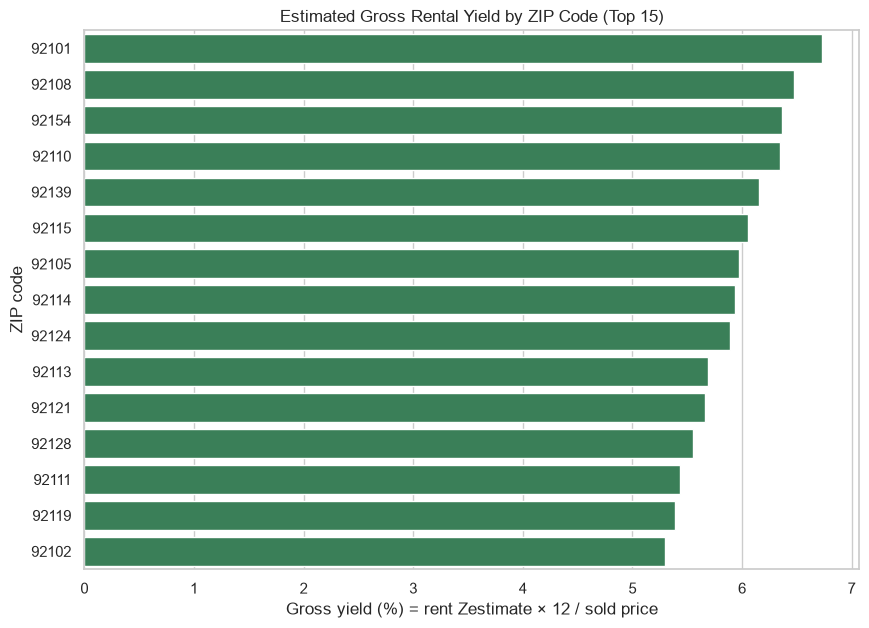
Comentario: Los 15 principales códigos postales rinden entre 5.3% y 6.7% bruto, una banda estrecha. 92101 lidera con 6.7%, seguido de 92108 (6.5%) y 92154 (6.4%). Dado que las cifras de alquiler son estimaciones de Zillow, trata estos datos como orientativos y no como rendimientos exactos.
Lecturas Adicionales
Si te interesan enfoques similares para el análisis y la visualización de datos web, usando gráficos o IA, consulta estas guías:
- Filtra un Conjunto de Datos de Crunchbase y Procésalo con IA para Prospectar Nuevos Clientes
- Análisis de los Productos Más Vendidos de Amazon
- Análisis de Datos de Crunchbase para Prospección de Clientes
Para ampliar este ejemplo, podrías entrenar un modelo de regresión para predecir precios de venta, comparar mercados inmobiliarios entre dos ciudades, o analizar tendencias históricas de precios para propiedades individuales.
Conclusión
En este artículo, aprendiste a usar el SDK de Python de Bright Data para obtener conjuntos de datos estructurados y listos para análisis, adaptados a tus necesidades. En concreto, viste cómo obtener datos de Zillow sobre casas vendidas en San Diego, limpiar y preparar los datos, y crear más de 10 visualizaciones que cubren precios de venta, ubicaciones, tamaños de propiedades, valoraciones y rendimientos de alquiler.
El SDK de Python de Bright Data ofrece acceso programático a los productos de Bright Data, incluido su extenso marketplace de conjuntos de datos. El SDK simplifica el proceso de recolección de datos, para que puedas enfocarte en el análisis en lugar de en la recopilación y preparación de datos.
Obtén tus resultados como CSV, JSON, JSONL u otros formatos compatibles, luego cárgalos directamente en un Jupyter Notebook para análisis y visualización, o pásalos a herramientas de IA para un análisis más profundo.
¡Crea una cuenta de Bright Data para acceder a los datos web públicos que necesitas para tus proyectos de análisis de datos!