En esta guía, aprenderás:
- Qué es el SDK de Python de Bright Data.
- Cómo funciona por dentro, incluyendo cómo funciona la autenticación.
- Qué ofrece, incluyendo modos síncronos y asíncronos, características clave y métodos.
- Cómo instalar el SDK y ejecutar tus primeras solicitudes paso a paso.
- Temas avanzados como polling, scraping concurrente y más.
- Casos de uso reales, desde comparar resultados de motores de búsqueda hasta parsear páginas web con BeautifulSoup para extracción manual de datos.
¡Empecemos!
¿Qué es el SDK de Python de Bright Data?
El SDK de Python de Bright Data es una librería de Python diseñada para simplificar las interacciones con los productos de Bright Data.
El SDK está disponible a través del paquete PyPI brightdata-sdk. Proporciona una interfaz unificada para hacer scraping de sitios web, obtener resultados de motores de búsqueda, acceder a conjuntos de datos listos para usar y trabajar con las soluciones de Bright Data.
En detalle, el SDK de Python incluye integraciones listas para usar con más de 100 APIs de Scraper de Bright Data, lo que te ayuda a acceder a datos públicos actualizados y estructurados de plataformas como Amazon, LinkedIn, Instagram, TikTok y muchas otras.
Nota: Si prefieres trabajar en la terminal, el CLI de Bright Data te ofrece muchas de las mismas capacidades a través de comandos de línea de comandos. Aprende a usar el CLI de Bright Data con agentes de IA.
Lectura adicional:
Cómo funciona el SDK de Python
Internamente, el SDK envuelve las APIs de Bright Data en clases de Python. De esta forma, puedes interactuar con los servicios de Bright Data sin construir manualmente solicitudes HTTP, llamar a endpoints de API ni parsear respuestas. En cambio, solo tienes que llamar a métodos de Python amigables para el desarrollador.
La librería está completamente tipada y minuciosamente documentada, lo que facilita explorar sus capacidades en tu IDE.
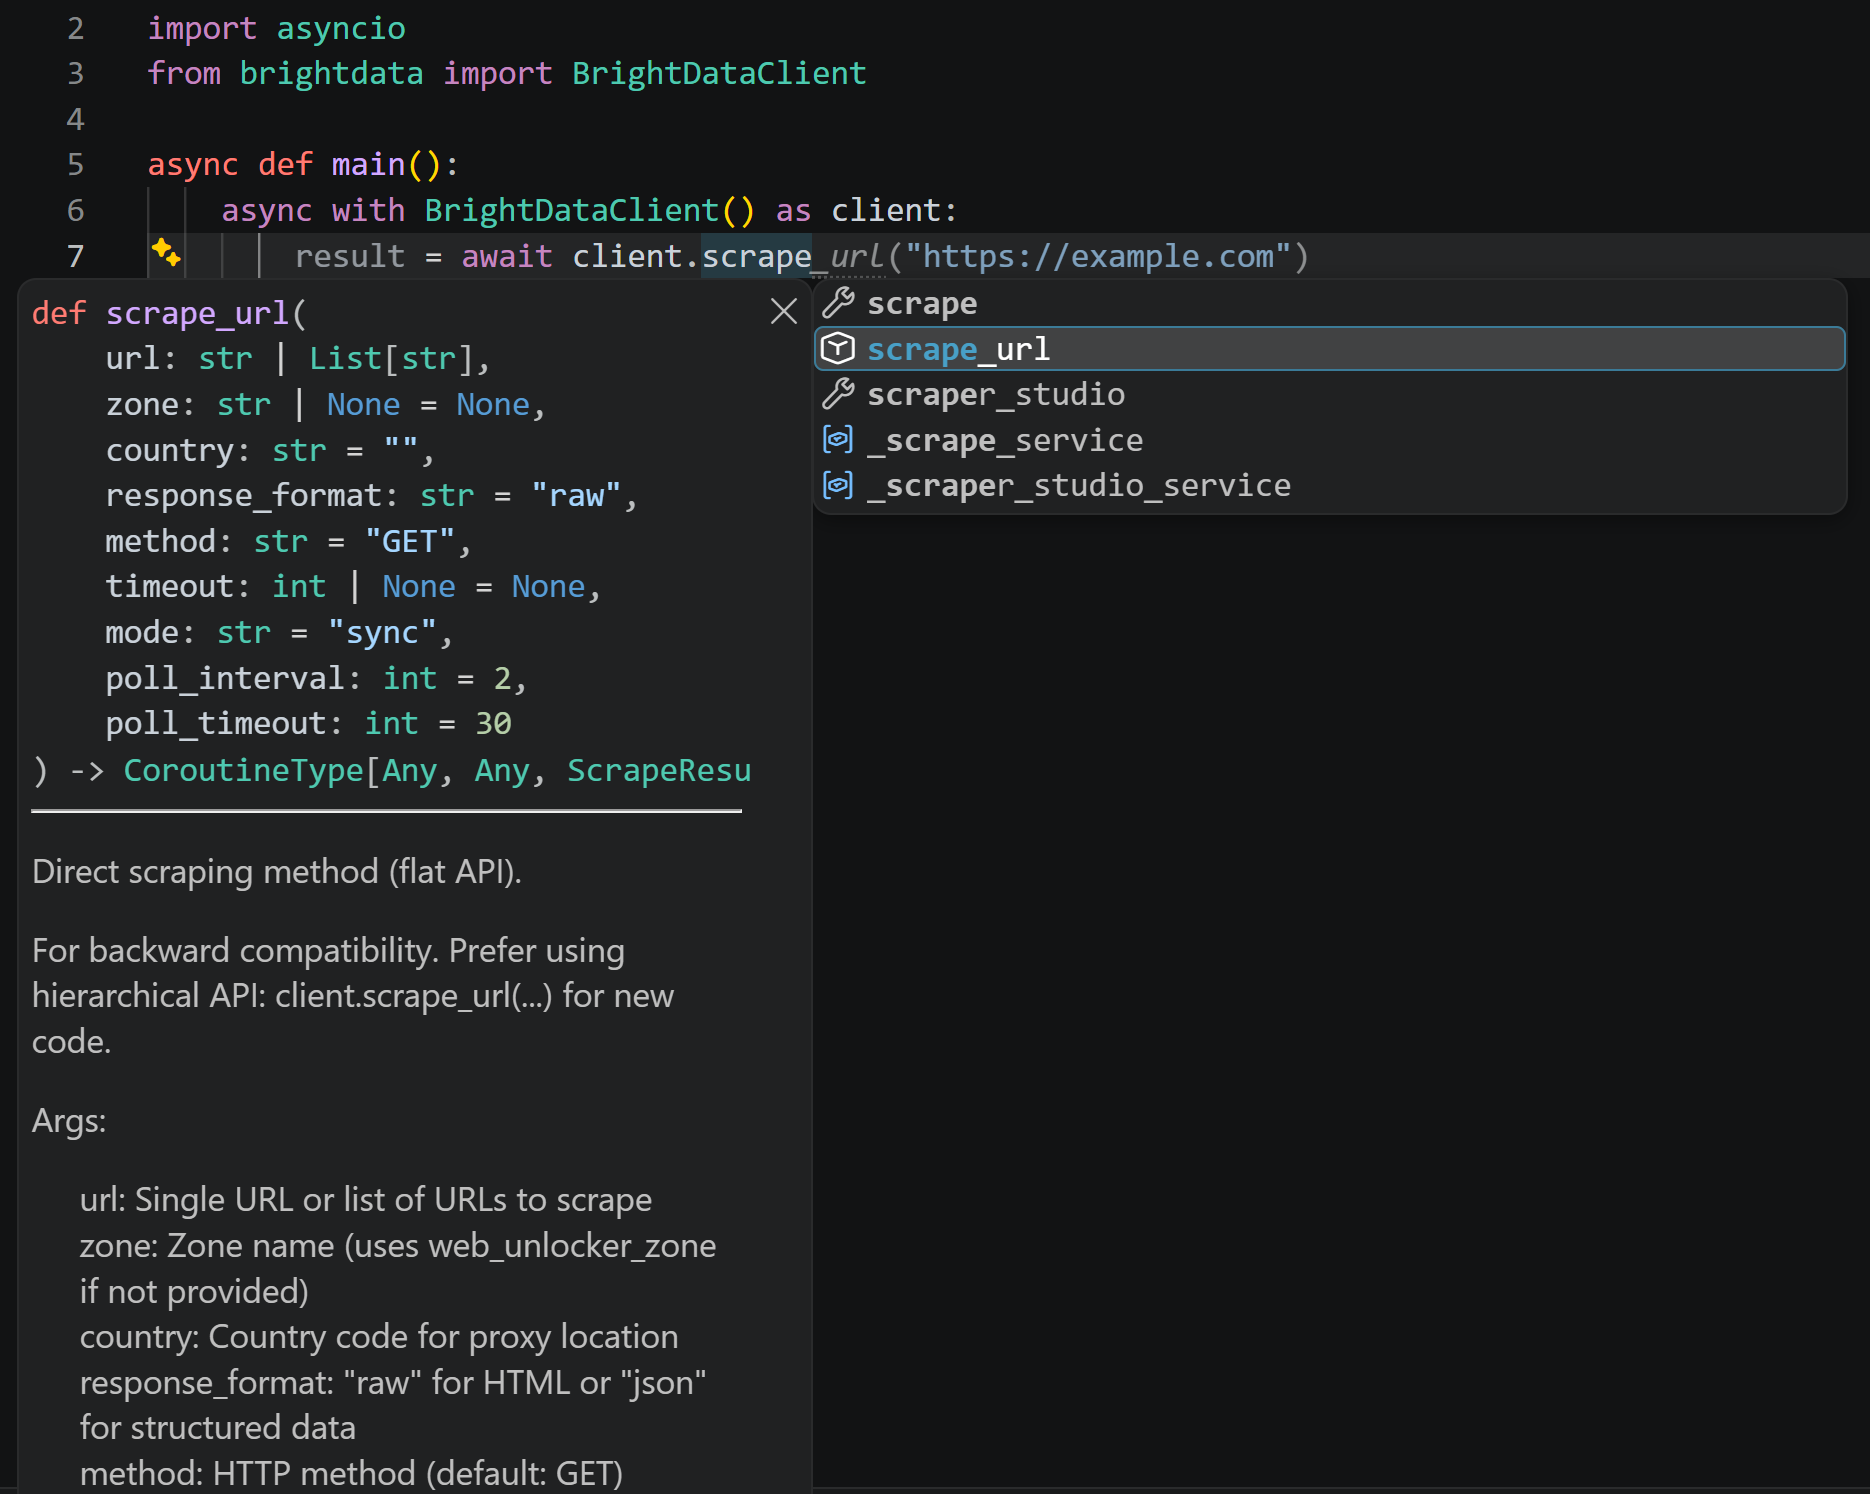
Obtienes autocompletado, sugerencias de tipos y ejemplos de uso que te ayudan a entender los parámetros disponibles y cómo usar cada método. Los objetos devueltos también están tipados, lo que te permite acceder fácilmente a los campos de respuesta.
La autenticación se gestiona mediante el token de API de Bright Data o, si ya te has autenticado a través del CLI de Bright Data, las credenciales guardadas por brightdata login. Ten en cuenta que si tu cuenta de Bright Data no cuenta con las APIs necesarias que el SDK invoca internamente, la librería las configura automáticamente por ti.
Qué ofrece el SDK
Ahora que el modelo principal está claro, el siguiente paso es explorar qué aporta el SDK de Python.
Características principales
El SDK de Python de Bright Data cubre un amplio conjunto de capacidades, incluyendo:
- Scraping web: Haz scraping de URLs individuales o múltiples de forma concurrente y obtén el contenido del sitio web con código mínimo.
- Resultados de motores de búsqueda: Obtén resultados de Google, Bing y Yandex, con soporte para consultas específicas por ubicación y búsquedas por lotes.
- Scrapers específicos por plataforma: Extrae datos estructurados de Amazon, LinkedIn, Instagram, Facebook, TikTok, YouTube, Reddit, Pinterest, ChatGPT, Perplexity y otras plataformas.
- Búsqueda específica por plataforma: Descubre perfiles, empleos, publicaciones y otro contenido usando parámetros de búsqueda en lugar de solo URLs.
- Integración con Scraper Studio: Ejecuta scrapers personalizados, activa trabajos de recolección, monitorea su estado y obtén los resultados.
- Métodos y respuestas tipados: Benefíciate de sugerencias de tipos, autocompletado en el IDE, sugerencias de parámetros y objetos de respuesta estructurados para un desarrollo más sencillo.
- Gestión de cuenta y API: Verifica la conectividad, inspecciona la información y uso de la cuenta, lista las APIs y gestiona configuraciones de API.
- Exportación de datos: Guarda los resultados de los conjuntos de datos web recolectados en formatos JSON, CSV o JSONL.
Métodos principales del SDK
Comienza instalando el SDK de Python de Bright Data:
pip install brightdata-sdkUna vez instalado, importa el SDK y tendrás acceso a muchos métodos, tales como:
| Método | Qué hace | Producto de Bright Data |
|---|---|---|
client.scrape_url(url) |
Obtiene el contenido de una URL o una lista de URLs, evitando cualquier sistema anti-bot | API Unlocker |
client.search.google(query=...) |
Ejecuta una búsqueda en Google y devuelve resultados orgánicos parseados | API SERP |
client.search.bing(query=...) |
Ejecuta una búsqueda en Bing y devuelve resultados orgánicos parseados | API SERP (consulta la guía de migración de la API Bing Web Search) |
client.scrape.<platform>.<method>(url=...) |
Extrae datos estructurados de una plataforma objetivo, como client.scrape.amazon.products |
APIs de Scraper |
client.search.linkedin.jobs(...) |
Busca en una plataforma mediante parámetros en lugar de URLs | APIs de Scraper específicas |
client.datasets.<name>(filter=...) |
Solicita una instantánea filtrada de un conjunto de datos precargado | APIs de Dataset |
client.scraper_studio.run(collector=..., input=...) |
Activa un recolector de scraping web personalizado y devuelve sus registros | Scraper Studio |
client.browser.get_connect_url() |
Construye el endpoint CDP para conectar Playwright o Puppeteer a un navegador en la nube | API Browser |
client.list_zones() |
Lista las zonas disponibles en tu cuenta | Ninguno |
Clientes síncronos y asíncronos
El SDK proporciona dos clientes con los mismos nombres de métodos pero diferentes modelos de ejecución:
BrightDataClient: El cliente asíncrono, diseñado para aplicaciones que usanasyncioy necesitan manejar cargas de trabajo de alta concurrencia.SyncBrightDataClient: El cliente síncrono, ideal para scripts sencillos y solicitudes secuenciales directas.
Así es como se llama a scrape_url() usando SyncBrightDataClient:
from brightdata import SyncBrightDataClient

with SyncBrightDataClient() as client:
    result = client.scrape_url("https://example.com")
    print(result.data)
De forma equivalente, con BrightDataClient, necesitas usar async with para gestionar el cliente y await para llamar a métodos asíncronos:
import asyncio
from brightdata import BrightDataClient

async def main():
    async with BrightDataClient() as client:
        result = await client.scrape_url("https://example.com")
        print(result.data)

asyncio.run(main())
Ambos ejemplos devuelven el HTML de la página objetivo en result.data:
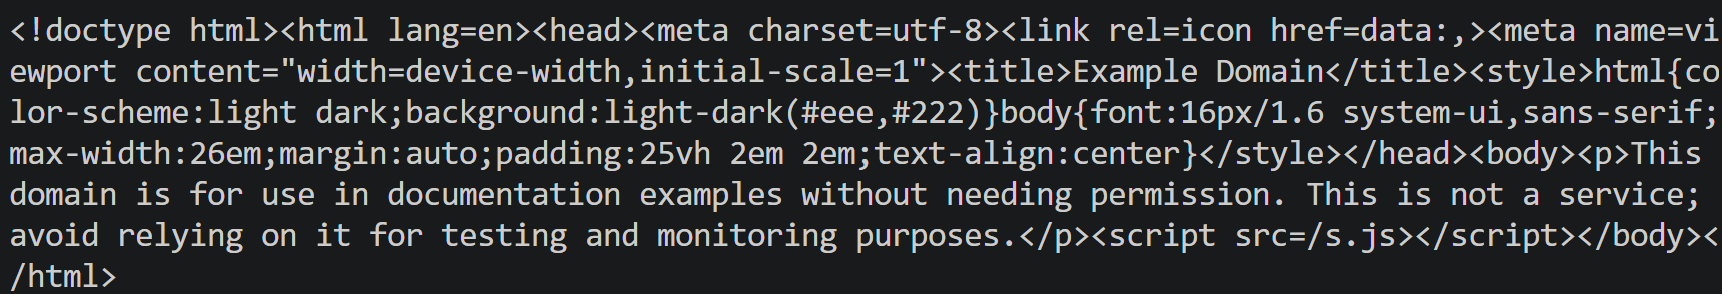
Ten en cuenta que, aunque BrightDataClient es asíncrono, scrape_url() usa mode="sync" por defecto. Esto significa que la llamada espera hasta que el resultado del scraping esté disponible antes de devolver un valor. Para usar scrape_url() en modo puramente asíncrono, pasa mode="async":
import asyncio
from brightdata import BrightDataClient

async def main():
    async with BrightDataClient() as client:
        result = await client.scrape_url(
            url="https://example.com",
            mode="async",
            poll_interval=5,   # Comprueba cada 5 segundos
            poll_timeout=180,  # Permite hasta 3 minutos
        )
        print(result.data)

asyncio.run(main())
En el modo de scraping asíncrono, el SDK:
- Envía una solicitud al endpoint de la API Web Unlocker.
- Recibe un
response_idque identifica la solicitud pendiente. - Consulta periódicamente el endpoint de resultados usando ese ID hasta que los datos estén listos o se alcance el tiempo de espera.
- Devuelve los datos del resultado cuando están disponibles.
Para más información sobre cómo elegir entre modos de solicitud síncronos y asíncronos, consulta la documentación de Sync vs. Async.
Notas:
- Los parámetros
poll_intervalypoll_timeoutcontrolan con qué frecuencia el SDK verifica los resultados y cuánto tiempo espera. Parascrape_url(), sus valores predeterminados son2segundos y30segundos, respectivamente. - Las solicitudes asíncronas de Web Unlocker pueden tardar alrededor de dos minutos en completarse, así que establece
poll_timeouten consecuencia.
Configuración automática de las APIs de Bright Data
Las solicitudes realizadas a través del SDK dependen de las APIs de Bright Data configuradas en tu cuenta:
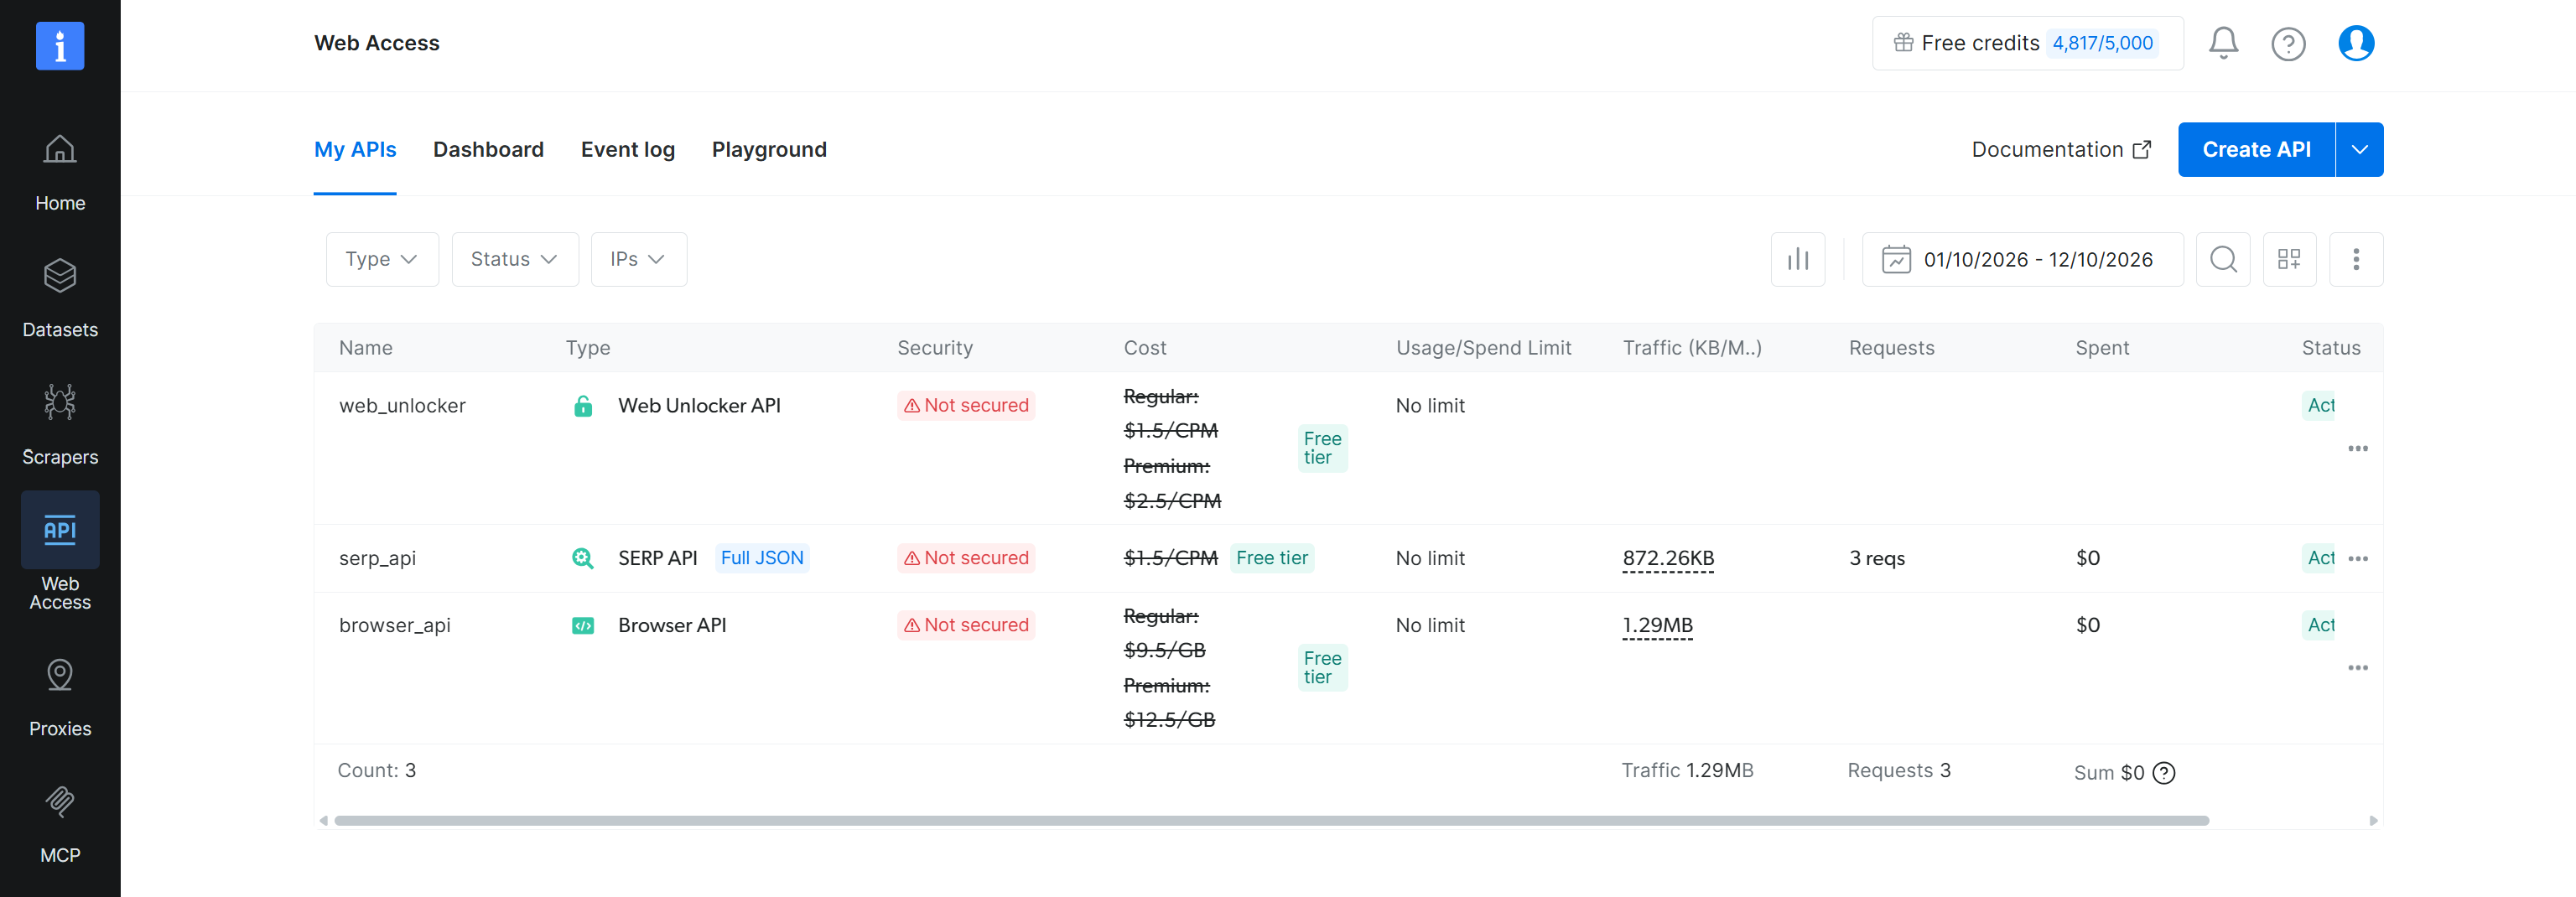
Por defecto, tanto SyncBrightDataClient como BrightDataClient establecen auto_create_zones=True. Esta opción controla si el SDK crea las zonas de API necesarias en caso de que no existan ya.
Cuando la creación automática está habilitada, el SDK garantiza que las siguientes zonas estén disponibles antes de realizar la primera solicitud de API:
sdk_unlockerpara la API Web Unlockersdk_serppara la API SERP
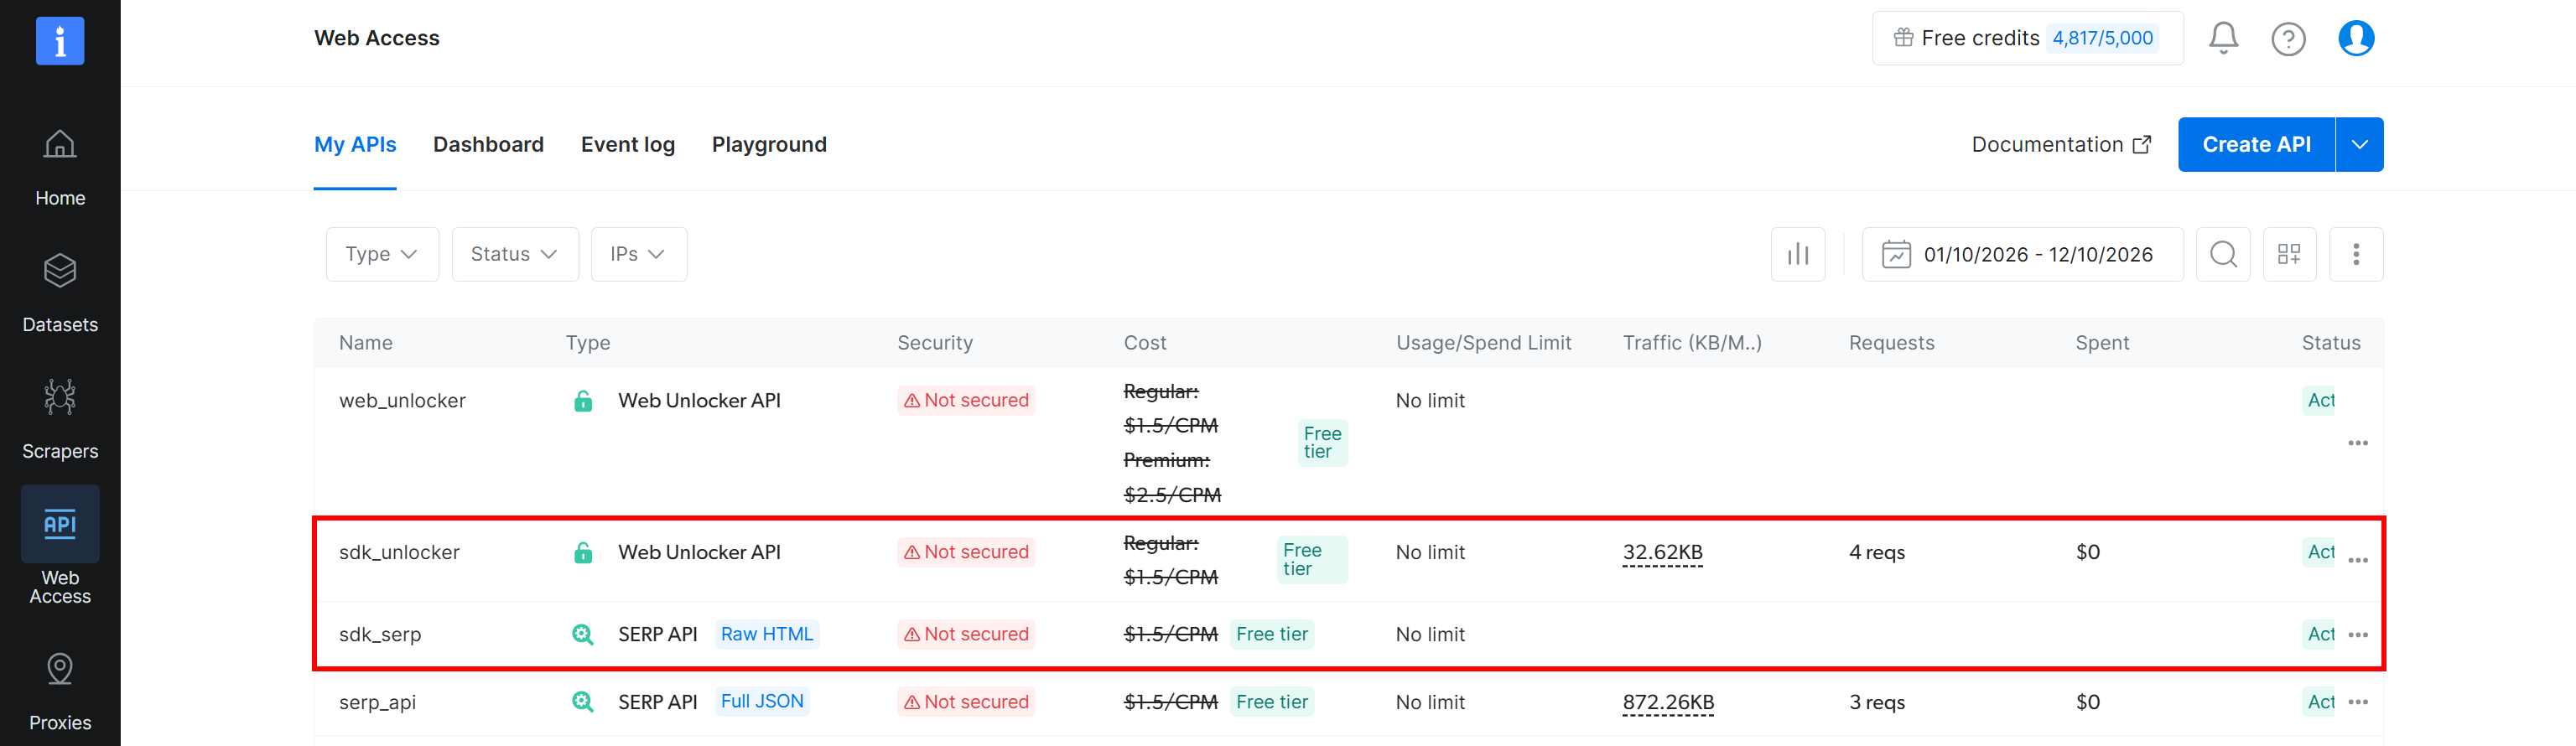
Si prefieres gestionar tus zonas de API tú mismo, establece auto_create_zones=False. El SDK no creará las APIs, así que debes proporcionar los nombres de tus zonas existentes mediante web_unlocker_zone y serp_zone.
Para usar una zona de API Unlocker personalizada, escribe:
import asyncio
from brightdata import BrightDataClient

async def main():
    async with BrightDataClient(
        auto_create_zones=False,
        web_unlocker_zone="web_unlocker", # Reemplaza con tu zona de API Unlocker personalizada
    ) as client:
        result = await client.scrape_url("https://example.com")
        print(result.data)

asyncio.run(main())
Primeros pasos con el SDK de Python de Bright Data: Guía paso a paso
Con los conceptos claros, es hora de instalar, autenticar y probar los métodos del SDK.
Requisitos previos
Antes de comenzar, asegúrate de tener:
- Python 3.9+ instalado localmente.
- Una cuenta de Bright Data.
- Un token de API de Bright Data, que puedes generar en el Panel de Control de Bright Data.
Paso #1: Instala el SDK
Instala el SDK de Python de Bright Data vía pip con:
pip install brightdata-sdkSi ya tienes una versión anterior instalada, actualízala con:
pip install -U brightdata-sdkImportante: Esta guía se refiere a versiones del SDK posteriores a la 2.5.0.
¡Bien hecho! Pasa a la autenticación de inmediato.
Paso #2: Autentícate con tu token de API de Bright Data
El SDK de Python de Bright Data lee la variable de entorno BRIGHTDATA_API_KEY para autenticar las solicitudes a las APIs de Bright Data.
En Linux o macOS, establece la variable requerida con tu clave de API de Bright Data mediante:
export BRIGHTDATA_API_KEY="<YOUR_BRIGHT_DATA_API_KEY>"En Windows PowerShell, ejecuta:
$Env:BRIGHTDATA_API_KEY = "<YOUR_BRIGHT_DATA_API_KEY>"Una vez establecida la variable de entorno, el cliente asíncrono predeterminado recoge automáticamente tu clave de API:
from brightdata import BrightDataClient

async with BrightDataClient() as client:
    # ...
También puedes pasar tu clave de API directamente al crear el cliente mediante el argumento token:
from brightdata import BrightDataClient

async with BrightDataClient(token="<YOUR_BRIGHT_DATA_API_KEY>") as client:
    # Realiza solicitudes de API aquí
    ...
Pasar el token directamente puede ser útil para pruebas rápidas. Sin embargo, evita codificar claves de API en archivos fuente.
El SDK verifica las credenciales en el siguiente orden:
- El argumento
tokenpasado aBrightDataClientoSyncBrightDataClient. - La variable de entorno
BRIGHTDATA_API_TOKEN. - La variable de entorno
BRIGHTDATA_API_KEY. - Las credenciales guardadas por el CLI de Bright Data usando
brightdata login, si están disponibles.
¡Ya está todo listo! Ahora puedes emplear el SDK de Python para hacer scraping de páginas web, obtener resultados de búsqueda y acceder a otras APIs de Bright Data.
Paso #3: Ejecuta tu primera tarea de recolección de datos web
Con el SDK instalado y autenticado, ejecuta tu primer scraping. Supón que quieres recolectar datos estructurados de un perfil específico de LinkedIn.
Para esta tarea, puedes usar la API LinkedIn Profiles Scraper de Bright Data, disponible mediante el método client.scrape.linkedin.profiles(). Este devuelve los datos del perfil en un objeto estructurado:
import asyncio
from brightdata import BrightDataClient
from pprint import pprint

async def main():
    async with BrightDataClient() as client:
        result = await client.scrape.linkedin.profiles(
            url="https://linkedin.com/in/antonello-zanini" # Perfil de LinkedIn objetivo a scrapear
        )

        print(f"Success: {result.success}")
        print("\nScraped profile data:")
        pprint(result.data, indent=2, sort_dicts=False)

asyncio.run(main())
El resultado será:
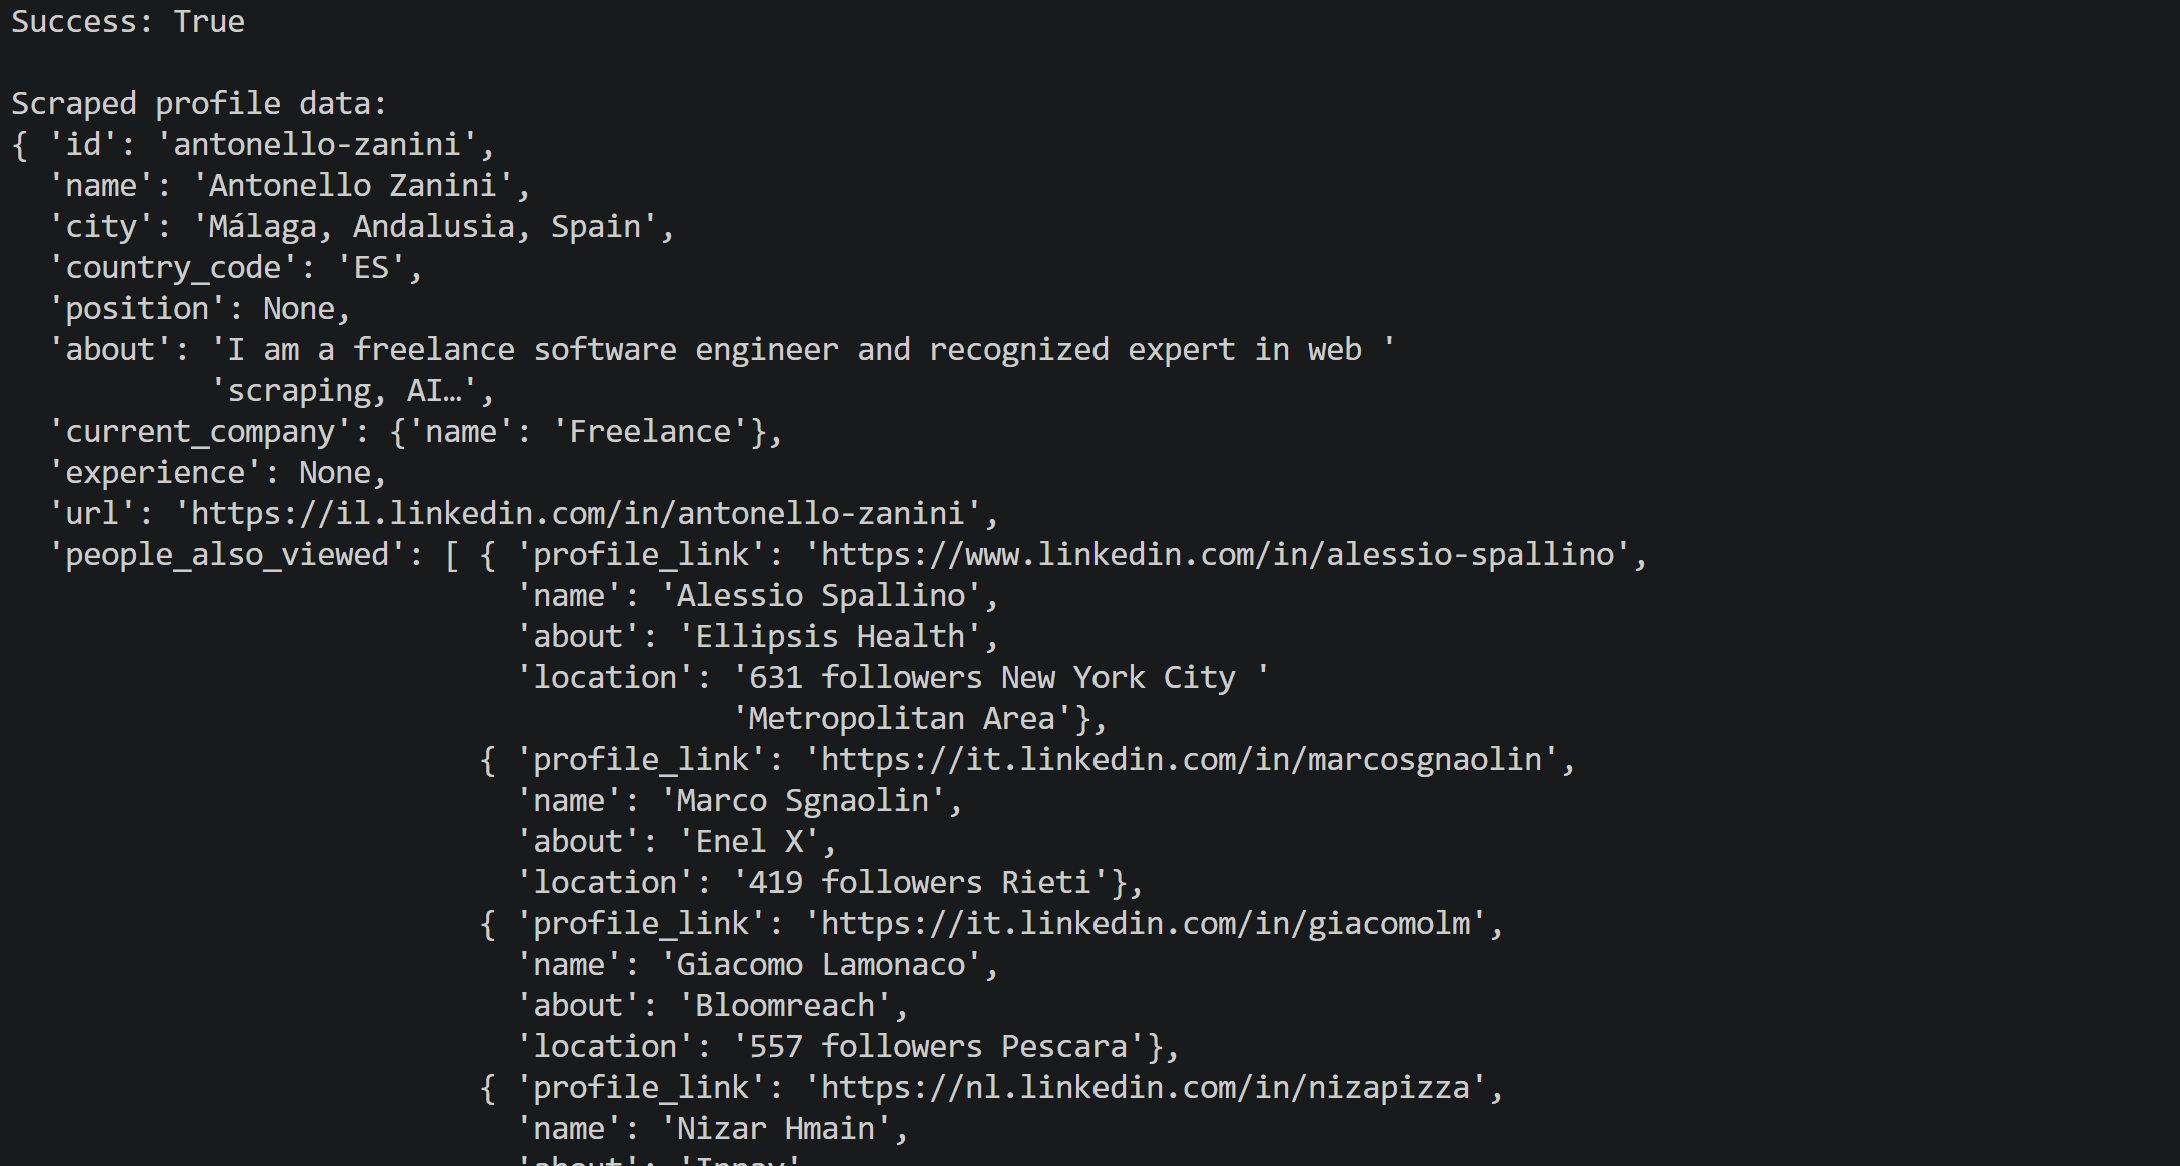
Observa cómo el método devuelve datos públicos recién extraídos y estructurados del perfil de LinkedIn dado, tal como se esperaba:
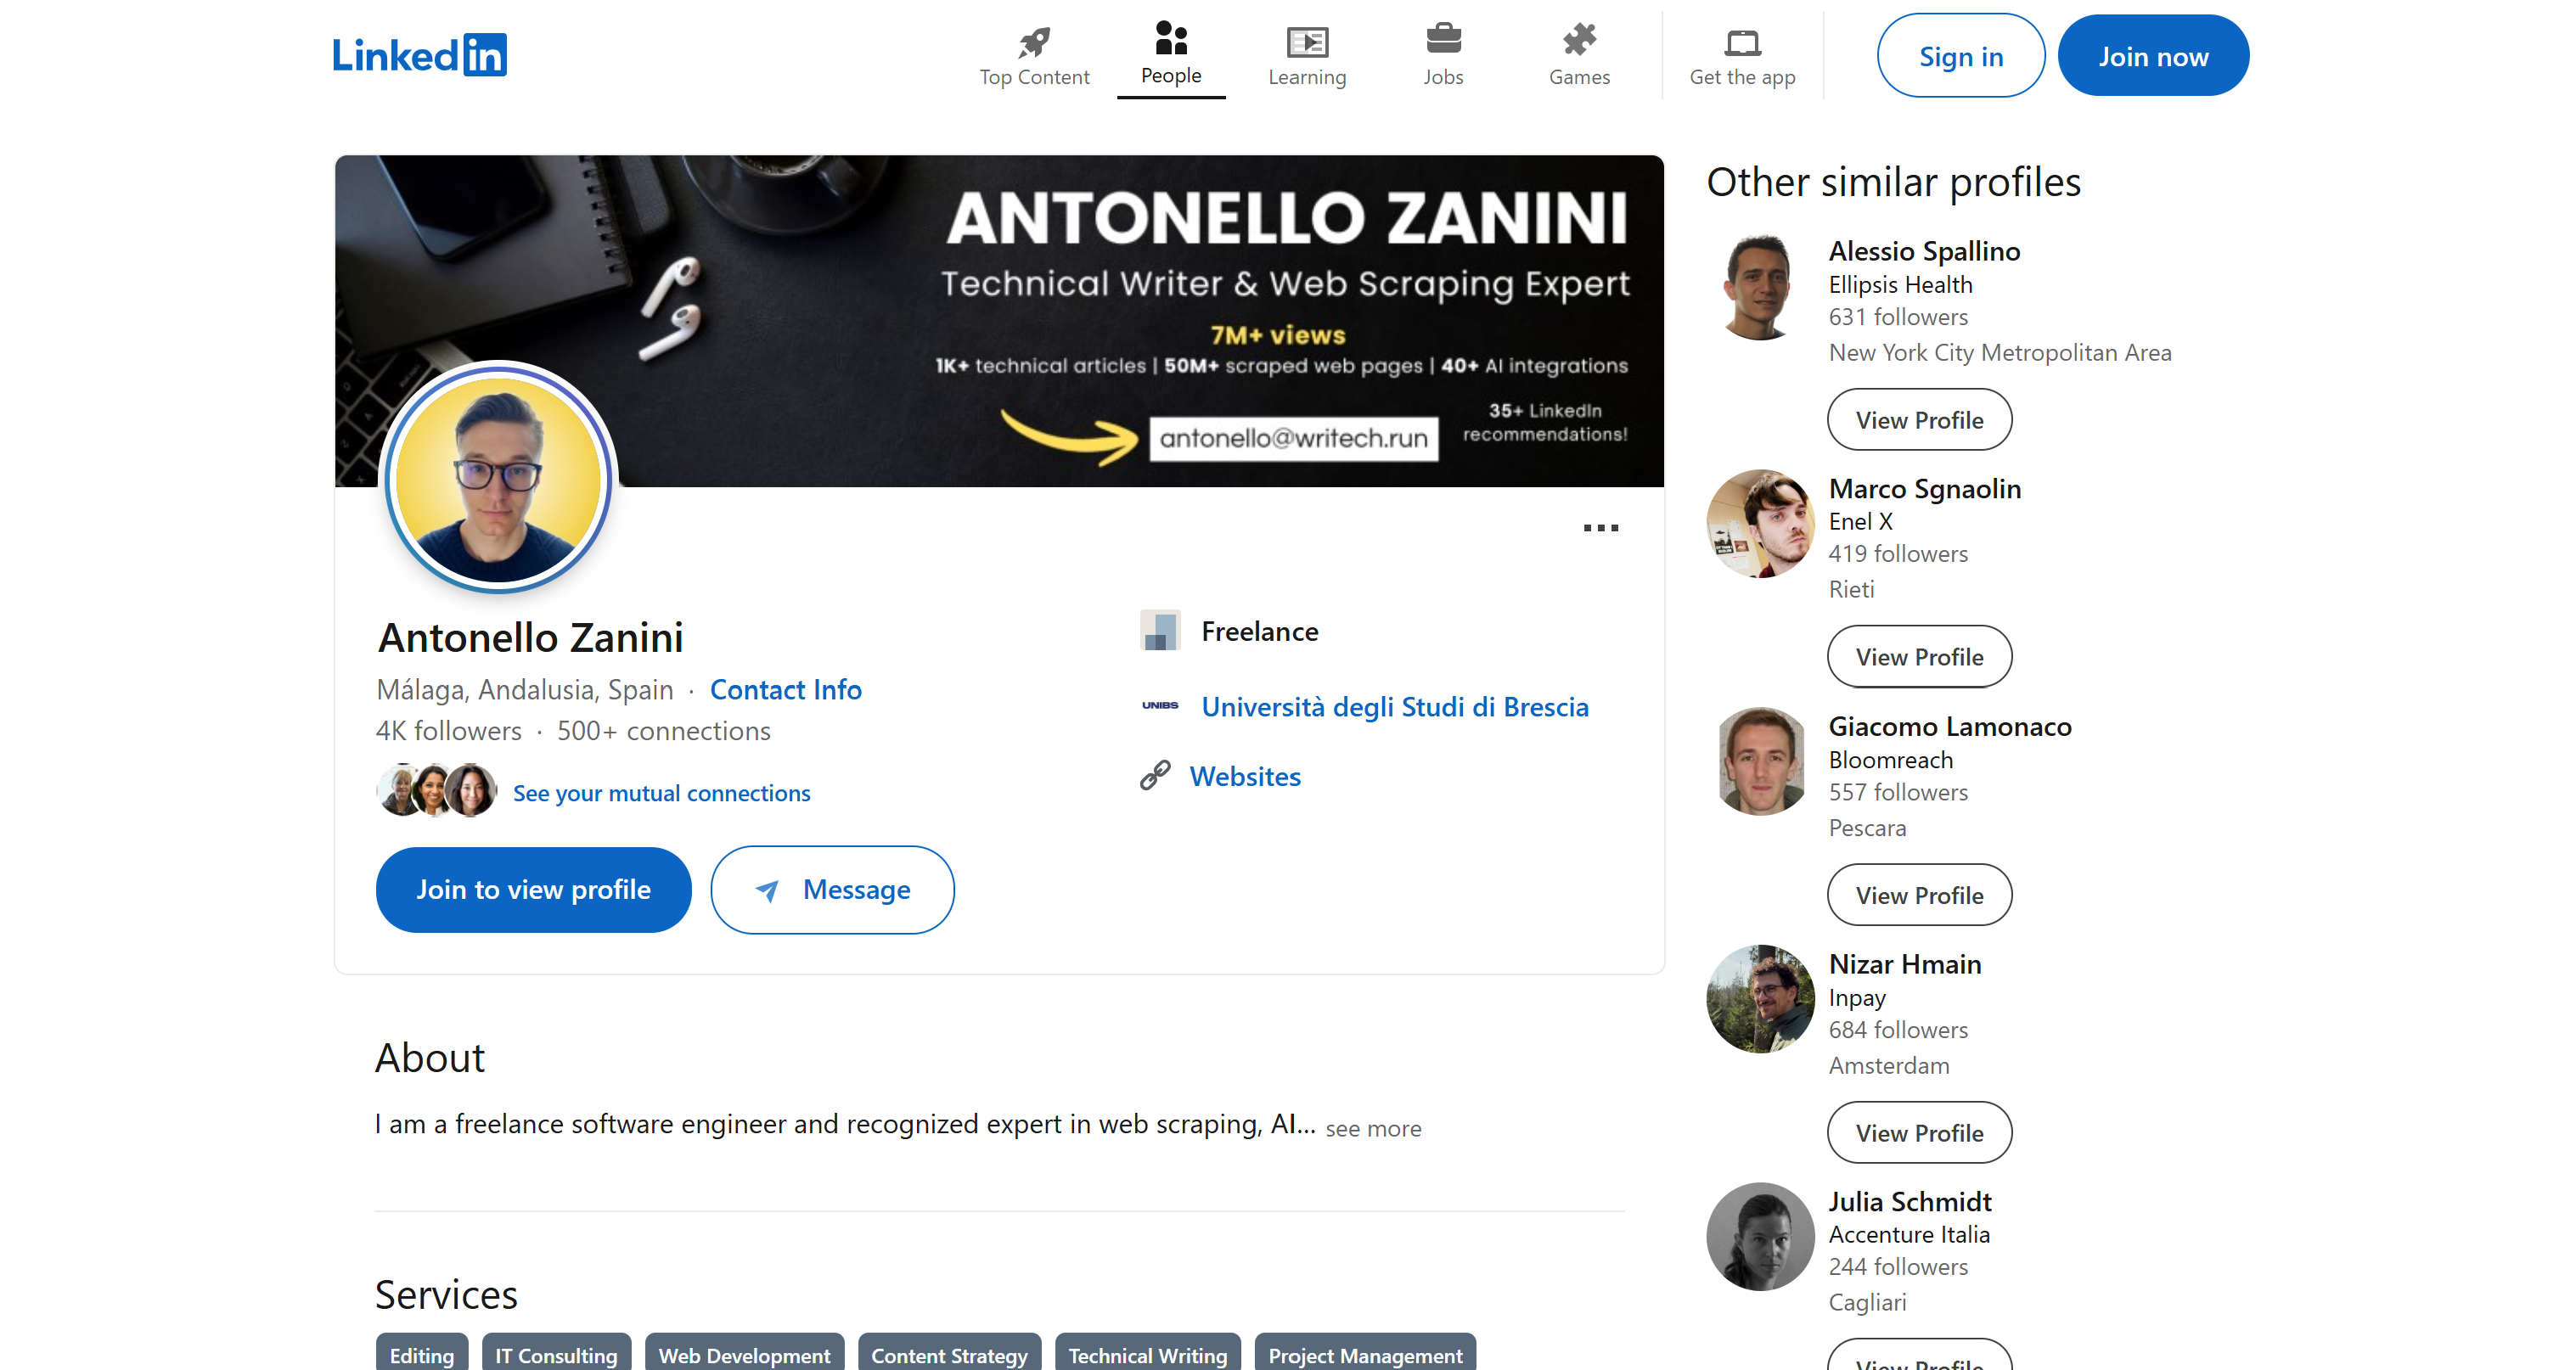
¡Misión cumplida!
Uso avanzado
Ahora que te sientes cómodo con lo básico, estás listo para explorar temas más avanzados.
Mecanismo de polling
Algunos trabajos de scraping tardan más que unos segundos, y es posible que quieras tener control sobre lo que ocurre mientras se ejecutan. Para estas situaciones, Bright Data te permite ejecutar las APIs de Scraper como trabajos asíncronos.
La idea es activar el scraping y recibir un trabajo de inmediato. Luego, verificas su estado, esperas a que finalice y obtienes los resultados cuando se han generado. Normalmente, esto requeriría una lógica de polling personalizada, pero el SDK ya proporciona métodos que simplifican el proceso.
El siguiente script logra el scraping asíncrono de un perfil de LinkedIn:
import asyncio
from brightdata import BrightDataClient

async def main():
    async with BrightDataClient() as client:
        # Inicia la tarea de scraping y devuelve un trabajo de inmediato
        job = await client.scrape.linkedin.profiles_trigger(
            url="https://es.linkedin.com/in/antonello-zanini"
        )
        print(f"Job triggered: {job.snapshot_id}")  # El ID que identifica este trabajo

        # Verifica el estado actual del trabajo, como "running" o "ready"
        status = await job.status()
        print(f"Status: {status}")

        # Consulta el trabajo hasta que esté "ready"
        await job.wait(timeout=180, verbose=True)

        # Descarga los registros una vez que el trabajo esté listo
        data = await job.fetch()
        print(f"Got {len(data) if isinstance(data, list) else 1} records")

asyncio.run(main())
A continuación, lo que hace cada método del SDK:
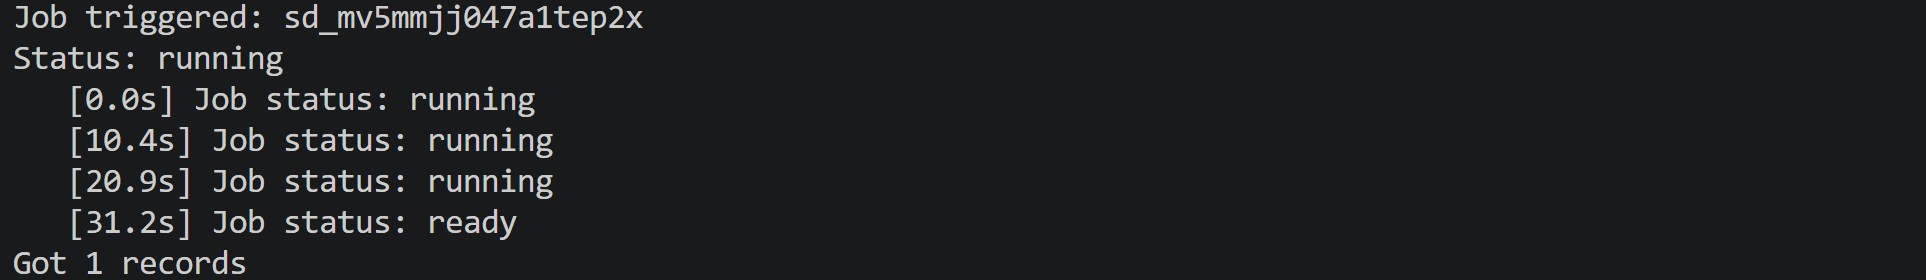
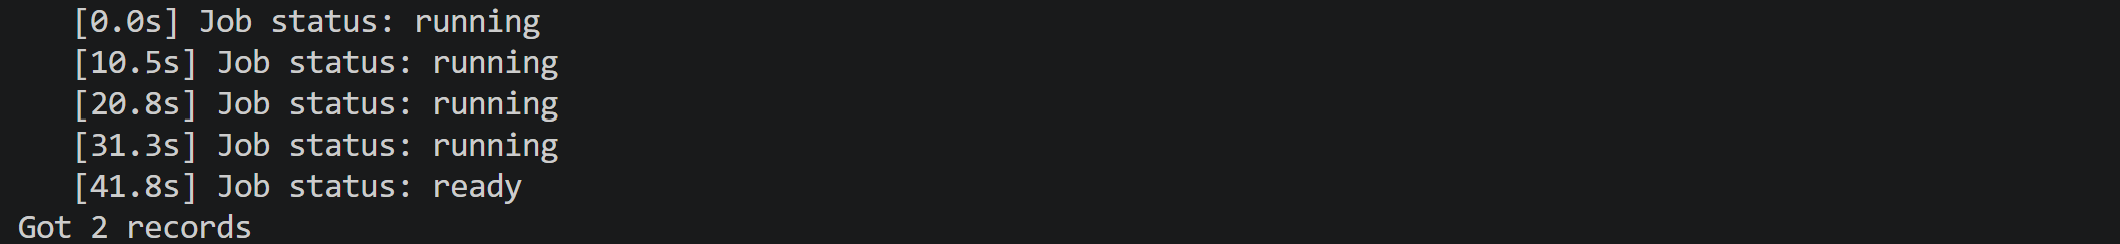
profiles_trigger()inicia el trabajo de scraping y devuelve un objeto de trabajo sin esperar a que termine el scraping.job.status()verifica el estado actual del trabajo.job.wait()consulta el estado del trabajo a intervalos regulares hasta que esté listo o se alcance el tiempo de espera. Por defecto, verifica el estado cada 10 segundos. Si se alcanza primero el tiempo de espera, lanza unTimeoutError.job.fetch()recupera los registros scrapeados una vez que el trabajo está listo.
Al establecer verbose=True se imprime cada verificación de estado para que puedas seguir el progreso del trabajo:
Si no necesitas gestionar cada paso tú mismo, to_result() combina la espera, la obtención y el empaquetado de los datos en un objeto de resultado:
import asyncio
from brightdata import BrightDataClient
from pprint import pprint

async def main():
    async with BrightDataClient() as client:
        # Inicia la tarea de scraping y devuelve un trabajo de inmediato
        job = await client.scrape.linkedin.profiles_trigger(
            url="https://es.linkedin.com/in/antonello-zanini"
        )
        print(f"Job triggered: {job.snapshot_id}")  # El ID que identifica este trabajo

        result = await job.to_result(timeout=180) # Espera, obtiene y recibe los datos

        print(f"Success: {result.success}")
        print("\nScraped profile data:")
        pprint(result.data, indent=2, sort_dicts=False)

asyncio.run(main())
Esto devuelve el mismo objeto de resultado que el método scrape.linkedin.profiles() mostrado anteriormente en este tutorial.
Si necesitas más control sobre el polling, considera implementar tu propio bucle llamando repetidamente a job.status() y ajustando tu lógica según el estado devuelto (es decir, "running", "ready" o "error").
Scrapea varias páginas de forma concurrente
Cuando necesites obtener varias páginas, pasa una lista de URLs al método de scraping del SDK de Python de Bright Data. El SDK las obtiene de forma concurrente y devuelve un objeto de resultado por cada URL. Echa un vistazo al siguiente ejemplo:
import asyncio
from brightdata import BrightDataClient

urls = [
    "https://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html",
    "https://books.toscrape.com/catalogue/tipping-the-velvet_999/index.html",
    "https://books.toscrape.com/catalogue/soumission_998/index.html",
]

async def main():
    async with BrightDataClient() as client:
        # Obtiene todas las URLs de forma concurrente
        results = await client.scrape_url(urls)

        # Cada elemento en results es un objeto de resultado para una URL
        for i, r in enumerate(results):
            if r.success:  # Omite las URLs que fallaron
                print(f"URL: {urls[i]}")
                print(f"{r.data[:500]}...")  # Primeros 500 caracteres del HTML sin procesar
                print("-" * 80 + "\n")

asyncio.run(main())
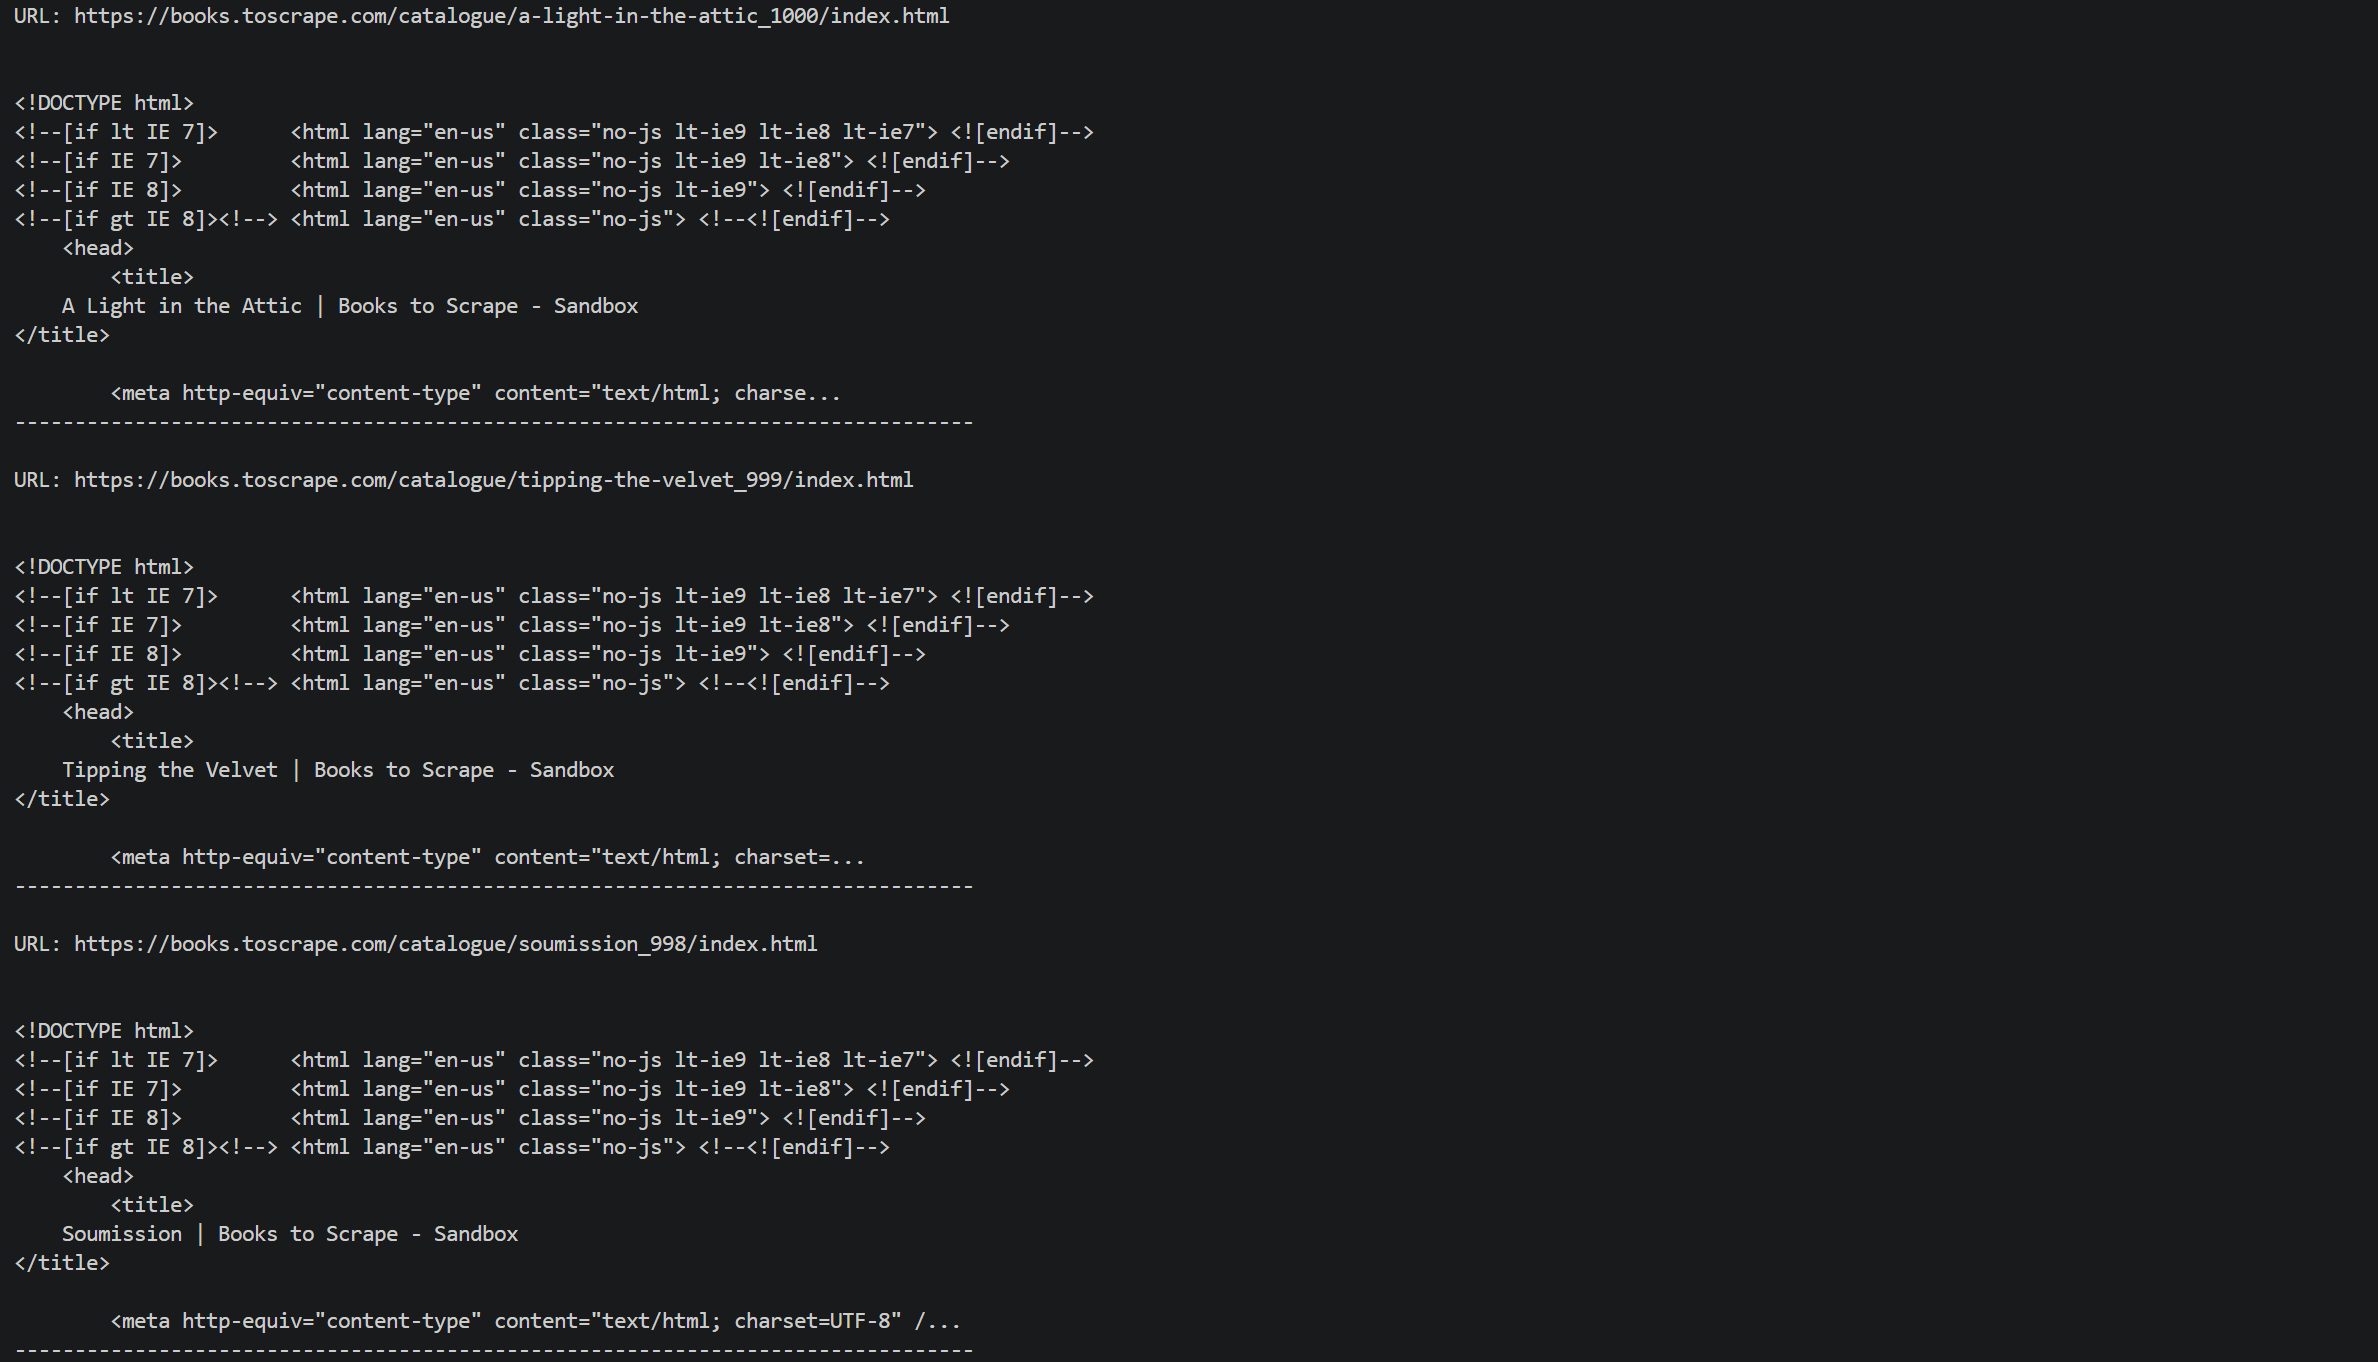
El script imprime una línea por cada URL exitosa, mostrando los primeros 500 caracteres de su HTML sin procesar:
La misma idea se aplica a los scrapers de plataforma. El siguiente script recolecta dos perfiles de LinkedIn al mismo tiempo:
import asyncio
from brightdata import BrightDataClient

PROFILE_URLS = [
    "https://es.linkedin.com/in/antonello-zanini",
    "https://it.linkedin.com/in/federico-trotta",
]

async def main():
    async with BrightDataClient() as client:
        linkedin = client.scrape.linkedin

        # Activa primero cada perfil, para que todos los trabajos comiencen antes de esperar alguno
        job = await linkedin.profiles_trigger(url=PROFILE_URLS)

        # Consulta el trabajo hasta que esté "ready"
        await job.wait(timeout=180, verbose=True)

        # Descarga los registros una vez que el trabajo esté listo
        data = await job.fetch()
        print(f"Got {len(data) if isinstance(data, list) else 1} records")

asyncio.run(main())
La salida será un conjunto de datos que contiene dos perfiles, scrapeados de forma concurrente:
Exportar los datos obtenidos
El SDK puede guardar dos tipos de datos: registros de conjuntos de datos y resultados del método scrape. Los registros de conjuntos de datos se pueden exportar con el helper export(), mientras que un resultado de scrape tiene el helper save_to_file().
Los conjuntos de datos son útiles cuando necesitas datos ya recolectados en lugar de scrapings nuevos. Para exportar registros de conjuntos de datos, crea una instantánea y descarga los registros, luego pásalos al helper export(), que los escribe en un archivo:
import asyncio
from brightdata import BrightDataClient
from brightdata.datasets import export

async def main():
    async with BrightDataClient() as client:
        imdb = client.datasets.imdb_movies

        # Crea una instantánea para los registros filtrados
        # (películas con una calificación IMDB de 9+ y 100+ calificaciones)
        # y luego descárgalos como una lista
        snapshot_id = await imdb(
            filter={
                "operator": "and",
                "filters": [
                    {"name": "imdb_rating", "operator": ">=", "value": 9},
                    {"name": "imdb_rating_count", "operator": ">", "value": 100},
                ],
            },
            records_limit=10,
        )
        data = await imdb.download(snapshot_id)

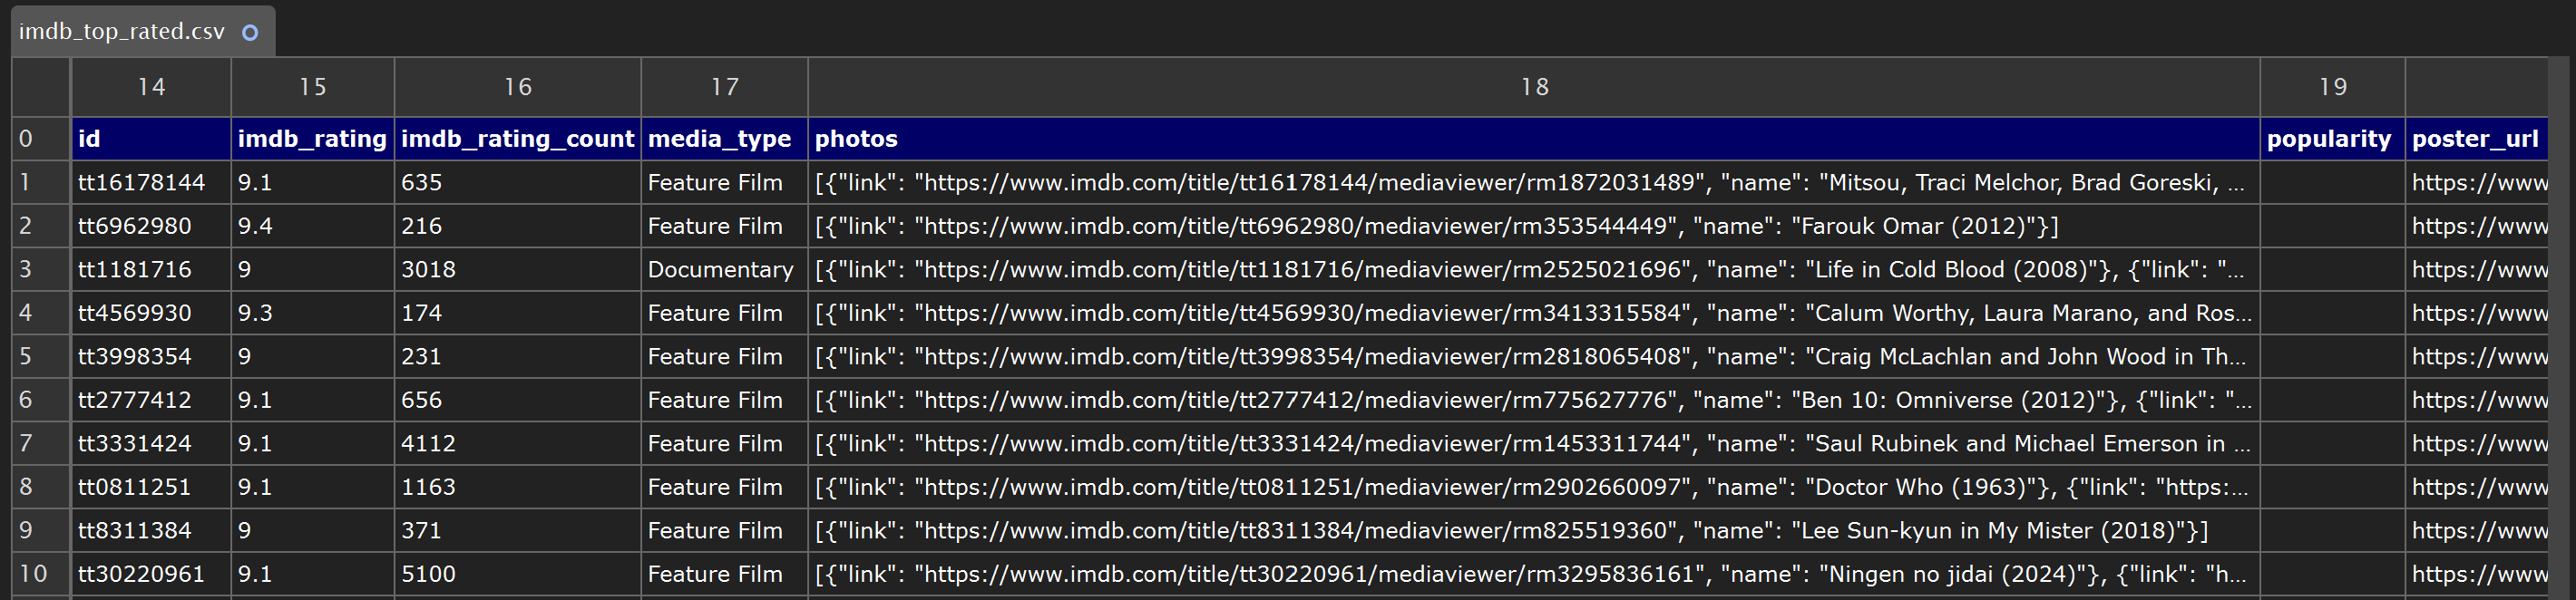
        export(data, "imdb_top_rated.csv")  # La extensión .csv selecciona el formato CSV

asyncio.run(main())Nota: El formato de salida se elige según la extensión, y se admiten .json, .jsonl y .csv.
El script anterior creará el siguiente archivo imdb_top_rated.csv en la carpeta de tu proyecto:
Para exportar un resultado del método scrape a un archivo, llama a save_to_file():
import asyncio
from brightdata import BrightDataClient

async def main():
    async with BrightDataClient() as client:
        result = await client.scrape.linkedin.profiles(
            url="https://es.linkedin.com/in/antonello-zanini"
        )

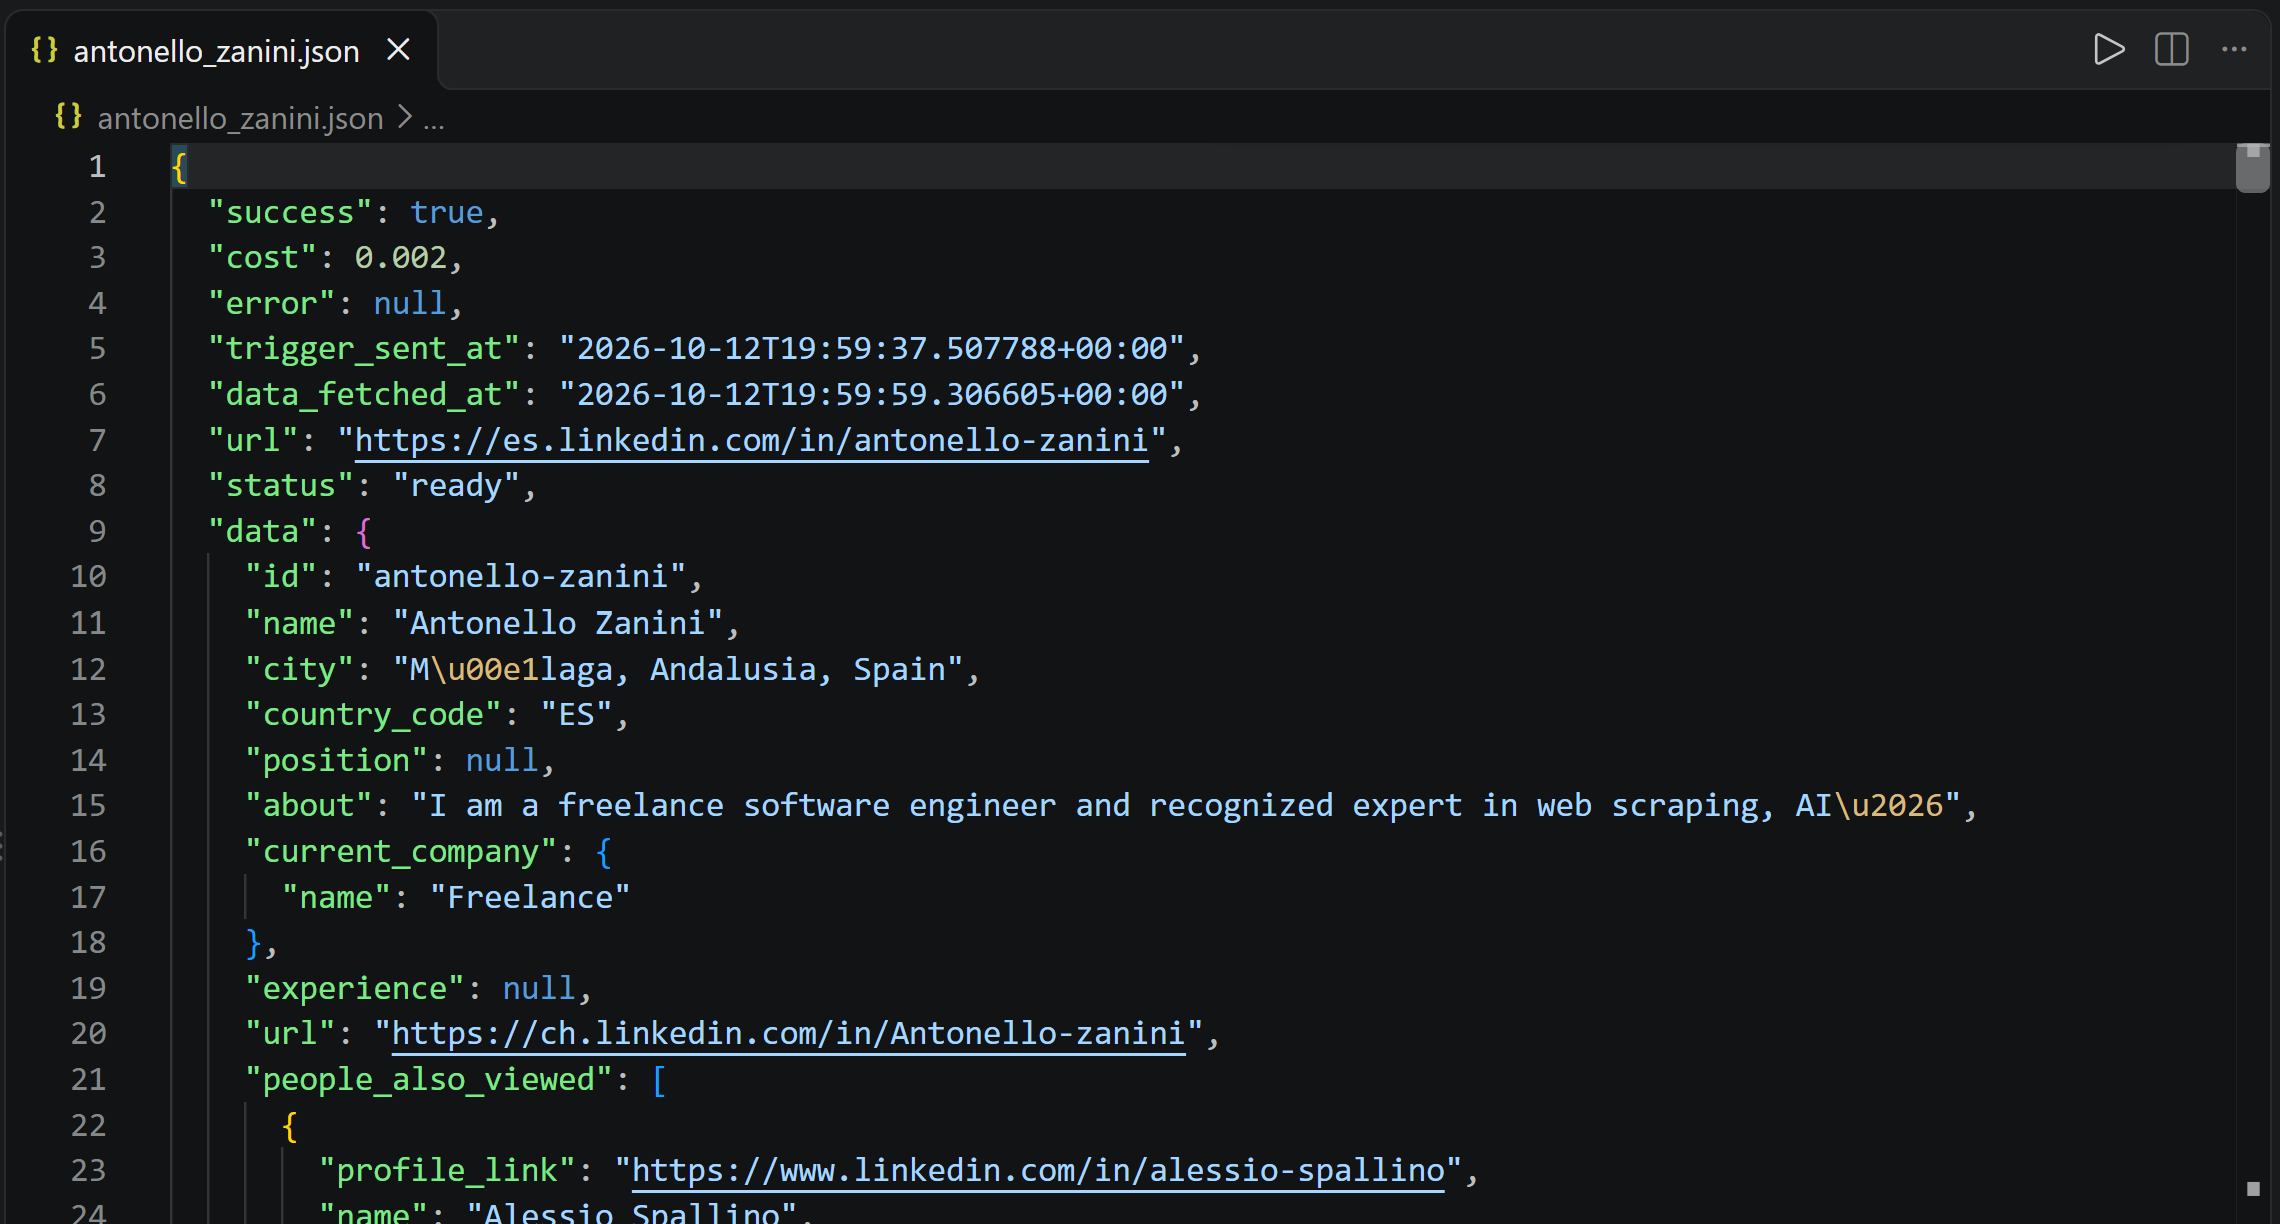
        result.save_to_file("antonello_zanini.json", format="json")  # Escrito en disco

asyncio.run(main())Nota: Solo se admite el formato JSON.
Esto producirá un archivo antonello_zanini.json de la siguiente manera:
El SDK de Python de Bright Data en acción: casos de uso
Tras explorar escenarios más avanzados, ahora cuentas con los conocimientos necesarios para abordar casos de uso del mundo real.
Comparar resultados de motores de búsqueda
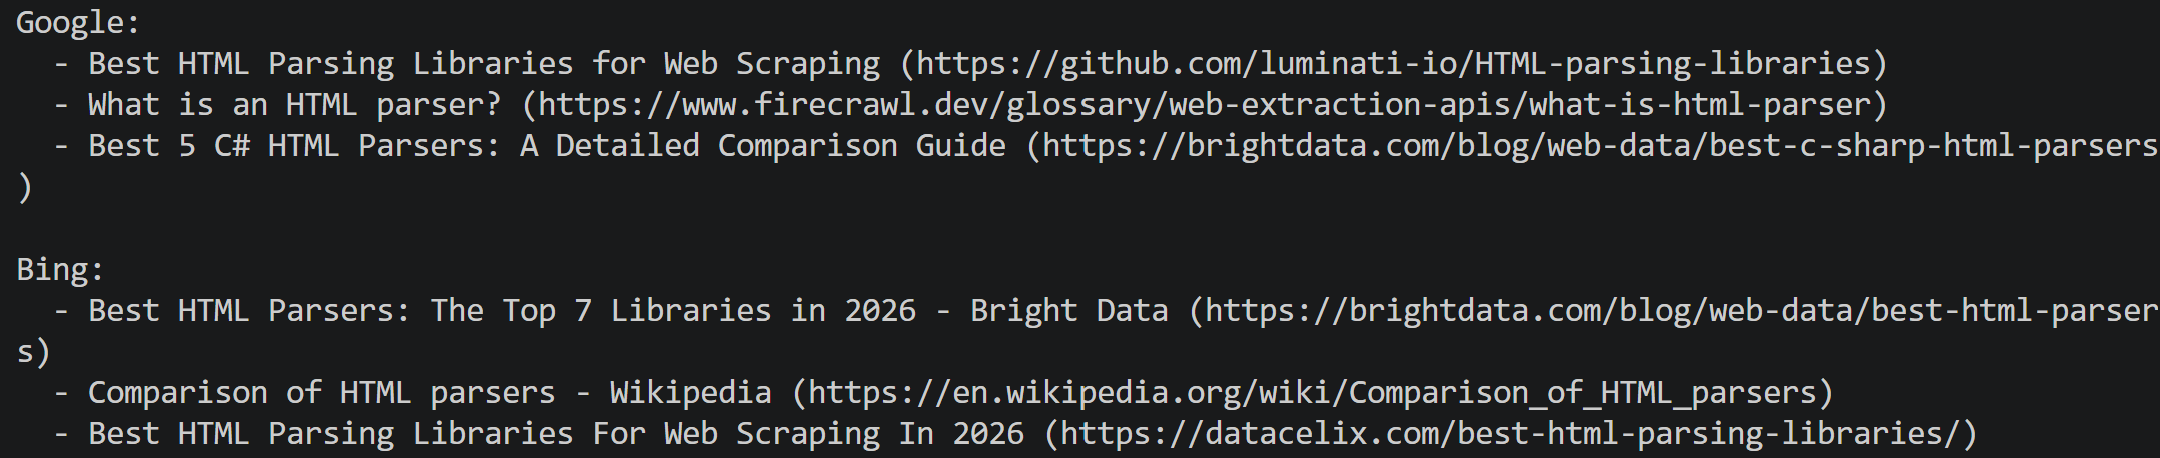
Cuando se trata de seguimiento de SERP, es importante entender cómo diferentes motores de búsqueda manejan la misma consulta. El siguiente script ejecuta la misma consulta en Google y Bing:
# pip install brightdata-sdk

import asyncio
from brightdata import BrightDataClient

# La consulta a ejecutar en varios motores de búsqueda
query = "best HTML parsers"

async def main():
    async with BrightDataClient() as client:
        # Obtiene resultados de búsqueda parseados de Google y Bing
        google = await client.search.google(query=query, num_results=10)
        bing = await client.search.bing(query=query, num_results=10)

        # Imprime los tres primeros resultados de cada motor de búsqueda
        for name, result in [("Google", google), ("Bing", bing)]:
            print(f"\n{name}:")
            for item in result.data[:3]:
                print(f"  - {item['title']} ({item['url']})")

asyncio.run(main())
Google y Bing devuelven resultados de búsqueda orgánicos parseados con campos como title y url. Puedes acceder a estos datos directamente, por ejemplo, para imprimir los tres primeros resultados:
Obtén información completa de un producto de Amazon
Hacer scraping de Amazon es más que recolectar datos estructurados de una página de producto. También puede implicar extraer reseñas de productos, que ofrecen información valiosa para la evaluación de productos, el análisis de sentimiento, el monitoreo y más.
Gracias a las diferentes APIs de Scraper de Bright Data, puedes obtener tanto la información del producto como las reseñas a través del SDK, como se muestra a continuación:
# pip install brightdata-sdk

import asyncio
from brightdata import BrightDataClient

product_url = "https://www.amazon.com/dp/B0DCH8VDXF/"

async def main():
    async with BrightDataClient() as client:
        # Obtiene tanto los datos del producto como de las reseñas
        product = await client.scrape.amazon.products(url=product_url)
        reviews = await client.scrape.amazon.reviews(url=product_url, pastDays=30, keyWord="quality")

        # Imprime los datos scrapeados
        print(f"Title: {product.data['title']}")
        print(f"Price: {product.data['final_price']}")
        print(f"Rating: {product.data['rating']}")
        print(f"Reviews fetched: {len(reviews.data)}")

asyncio.run(main())
El script se basó en las opciones de filtrado de client.scrape.amazon.reviews() para obtener solo las reseñas de los últimos 30 días que contienen la palabra clave “quality”.
La salida se verá así:

Nota: Los valores devueltos dependen del producto y del momento de la solicitud.
Parsear una página desbloqueada con BeautifulSoup
Un flujo de trabajo de scraping web común implica:
- Obtener una página web.
- Parsearla con un parser HTML.
- Extraer los datos requeridos.
El problema es que muchos sitios web usan medidas anti-scraping que pueden bloquear solicitudes automatizadas de contenido HTML. Una posible solución es acceder a estas páginas a través de un servicio como la API Web Unlocker de Bright Data, que gestiona la huella digital del navegador, la rotación de proxies, la resolución de CAPTCHA y otros desafíos.
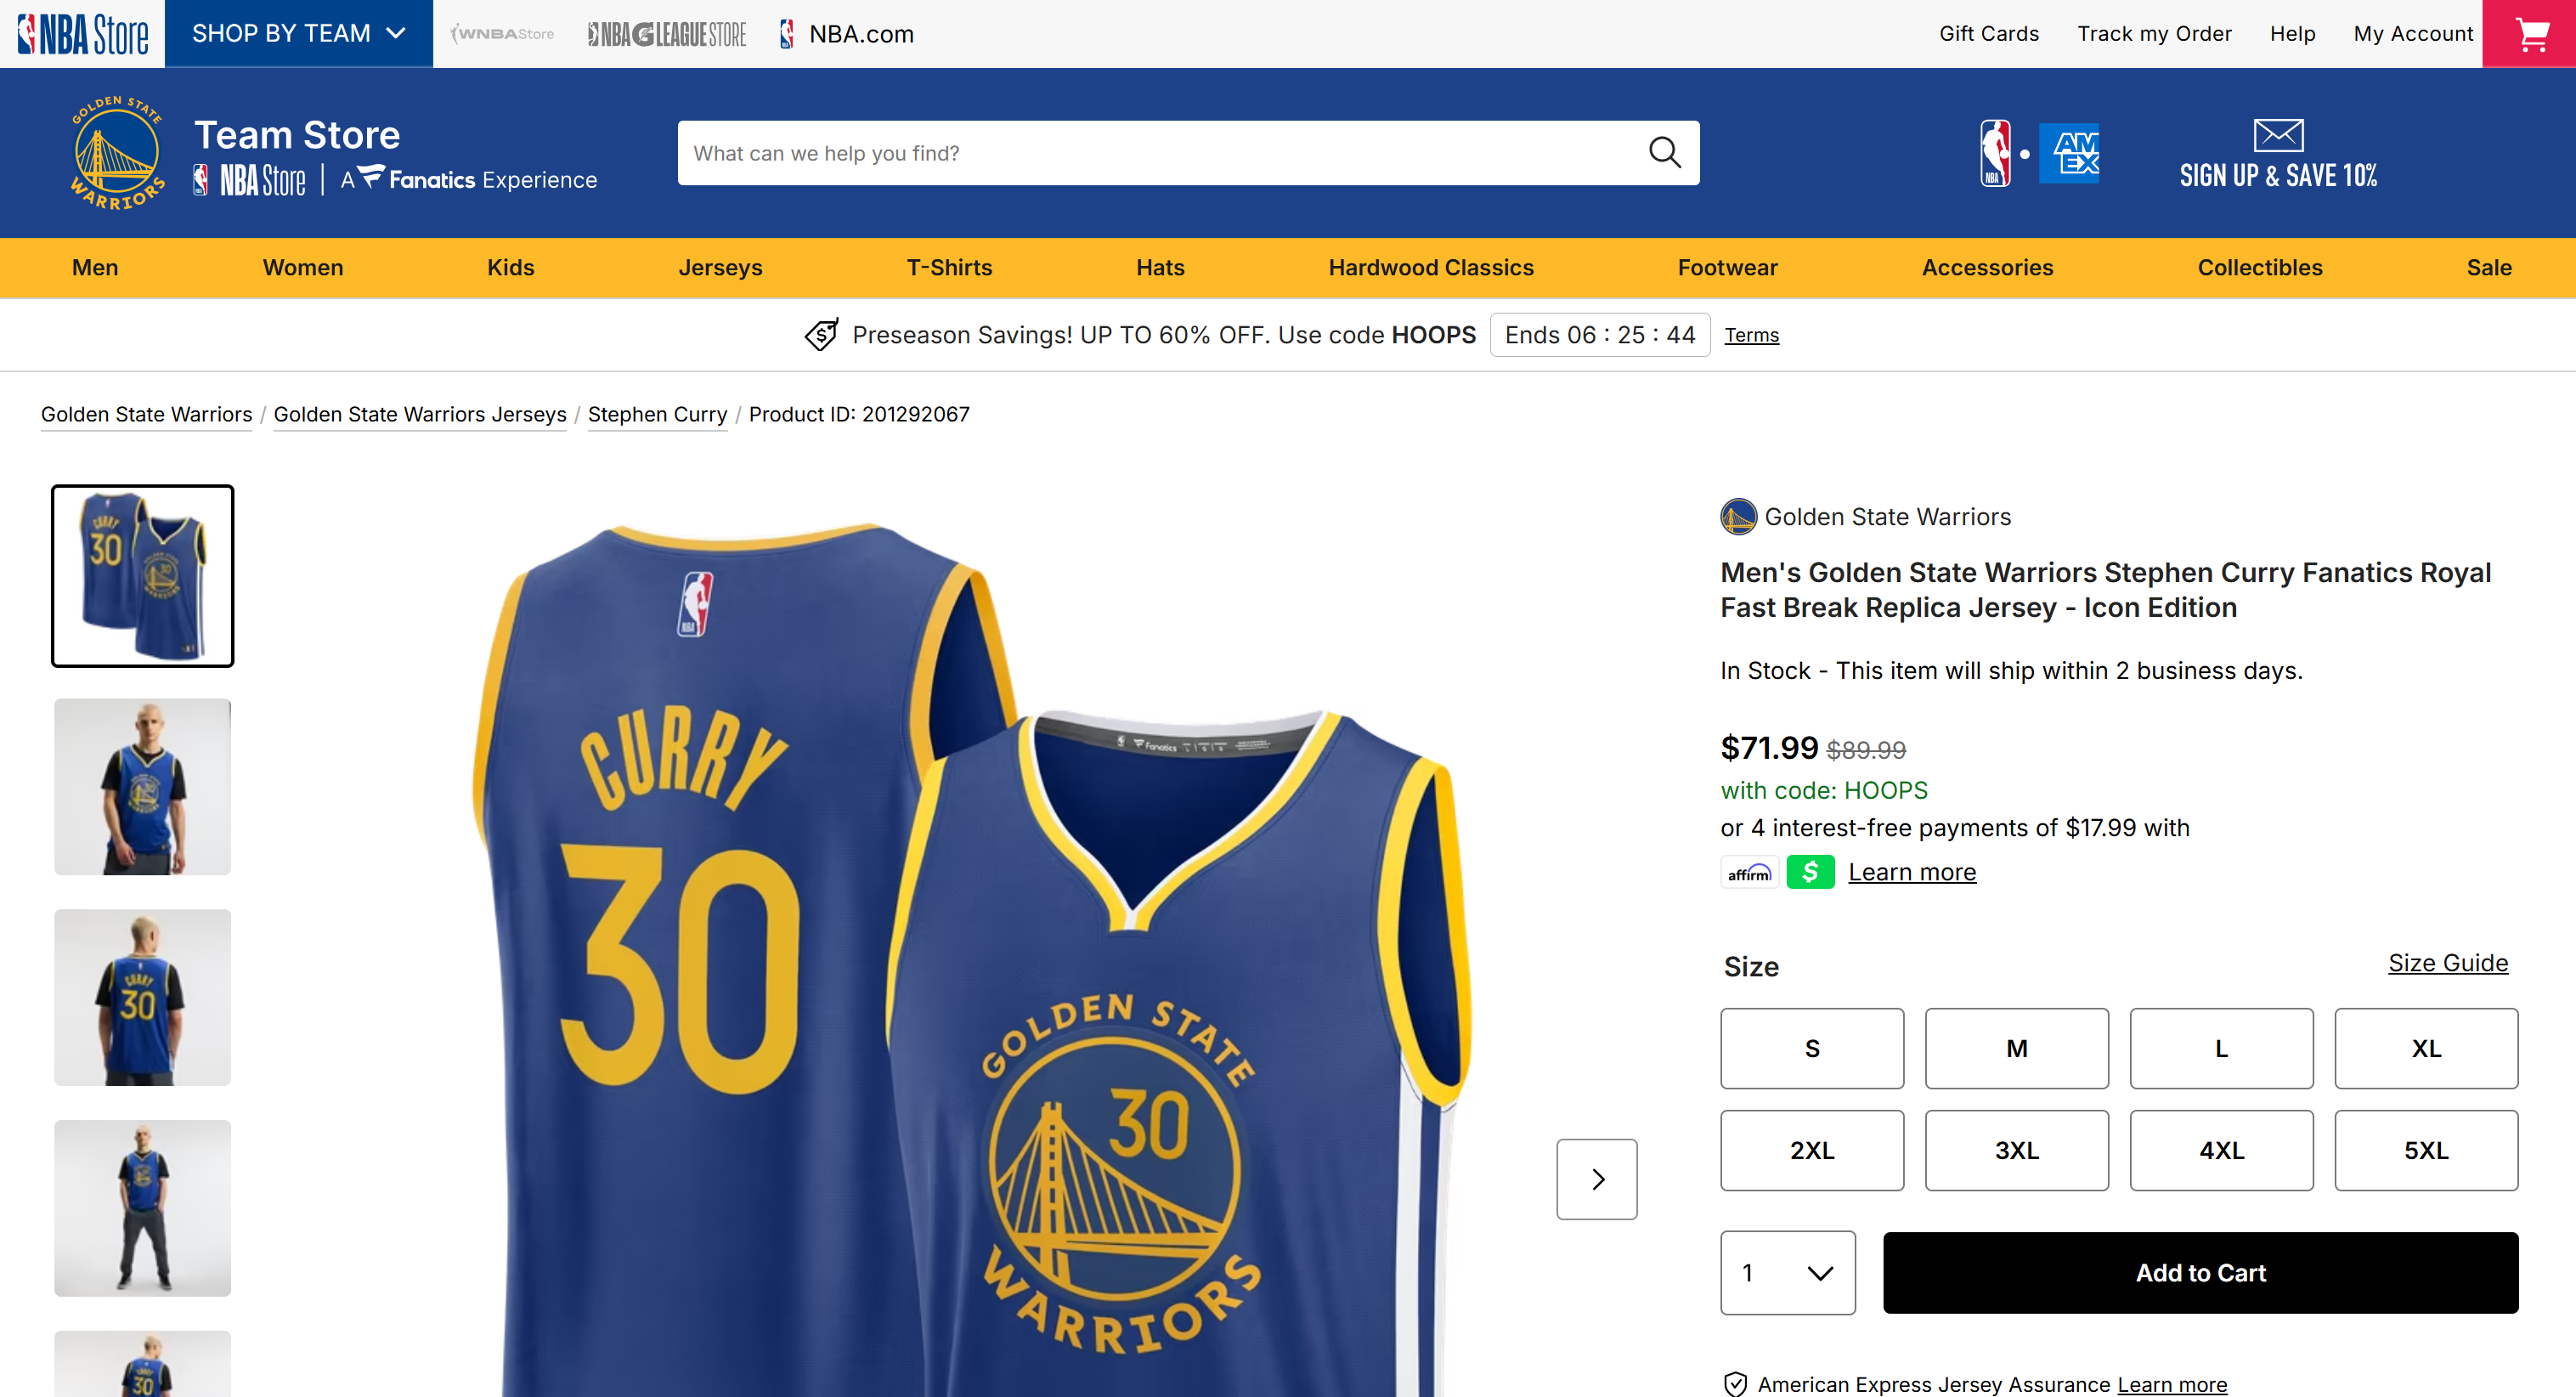
Por ejemplo, supongamos que quieres obtener una página de producto de la NBA Store de una camiseta de Stephen Curry de los Golden State Warriors y recopilar su nombre, marca, precio, disponibilidad y tallas disponibles.
El siguiente script utiliza el método scrape_url() del SDK para obtener la página, carga el HTML devuelto en BeautifulSoup y extrae los campos del producto:
# pip install brightdata-sdk beautifulsoup4

import asyncio
from brightdata import BrightDataClient
from bs4 import BeautifulSoup
import json


NBA_PRODUCT_URL = (
    "https://store.nba.com/golden-state-warriors/mens-golden-state-warriors-stephen-curry-"
    "fanatics-royal-fast-break-replica-jersey-icon-edition/t-14140641+p-138834682113177+z-9-2551128663"
    "?_ref=p-SFLP:m-GRID:i-r0c0:po-0"
)

async def main():
    # Obtiene la página mediante scrape_url() para evitar los anti-bots
    async with BrightDataClient() as client:
        result = await client.scrape_url(NBA_PRODUCT_URL)

    # Carga el HTML en BeautifulSoup para parsearlo
    soup = BeautifulSoup(result.data, "html.parser")

    # Extrae el nombre del producto del encabezado principal de la página
    title = soup.find("h1", attrs={"data-talos": "labelPdpProductTitle"}).get_text(strip=True)

    # Encuentra el bloque JSON-LD que describe el producto
    product_ld_data = None
    for script in soup.find_all("script", type="application/ld+json"):
        data = json.loads(script.string)
        if data.get("@type") == "Product":
            product_ld_data = data
            break

    # Accede a algunos datos de él
    brand = product_ld_data["brand"]
    images = product_ld_data["image"]

    # Lee el precio y la disponibilidad de la primera oferta
    offer = product_ld_data["offers"][0]
    price = offer["priceSpecification"]["price"]
    currency = offer["priceSpecification"]["priceCurrency"]
    availability = offer["availability"].rsplit("/", 1)[-1]

    # Extrae las tallas, que son botones, y su texto visible es la etiqueta de talla (S, M, L, ...)
    sizes = [b.get_text(strip=True) for b in soup.find_all("button", attrs={"data-talos": "buttonSize"})]

    # Recopila los datos scrapeados
    product = {
        "title": title,
        "brand": brand,
        "images": images,
        "price": price,
        "currency": currency,
        "availability": availability,
        "sizes": sizes,
    }

    # Imprime los datos scrapeados
    print(json.dumps(product, indent=2))

asyncio.run(main())
La salida se verá así:
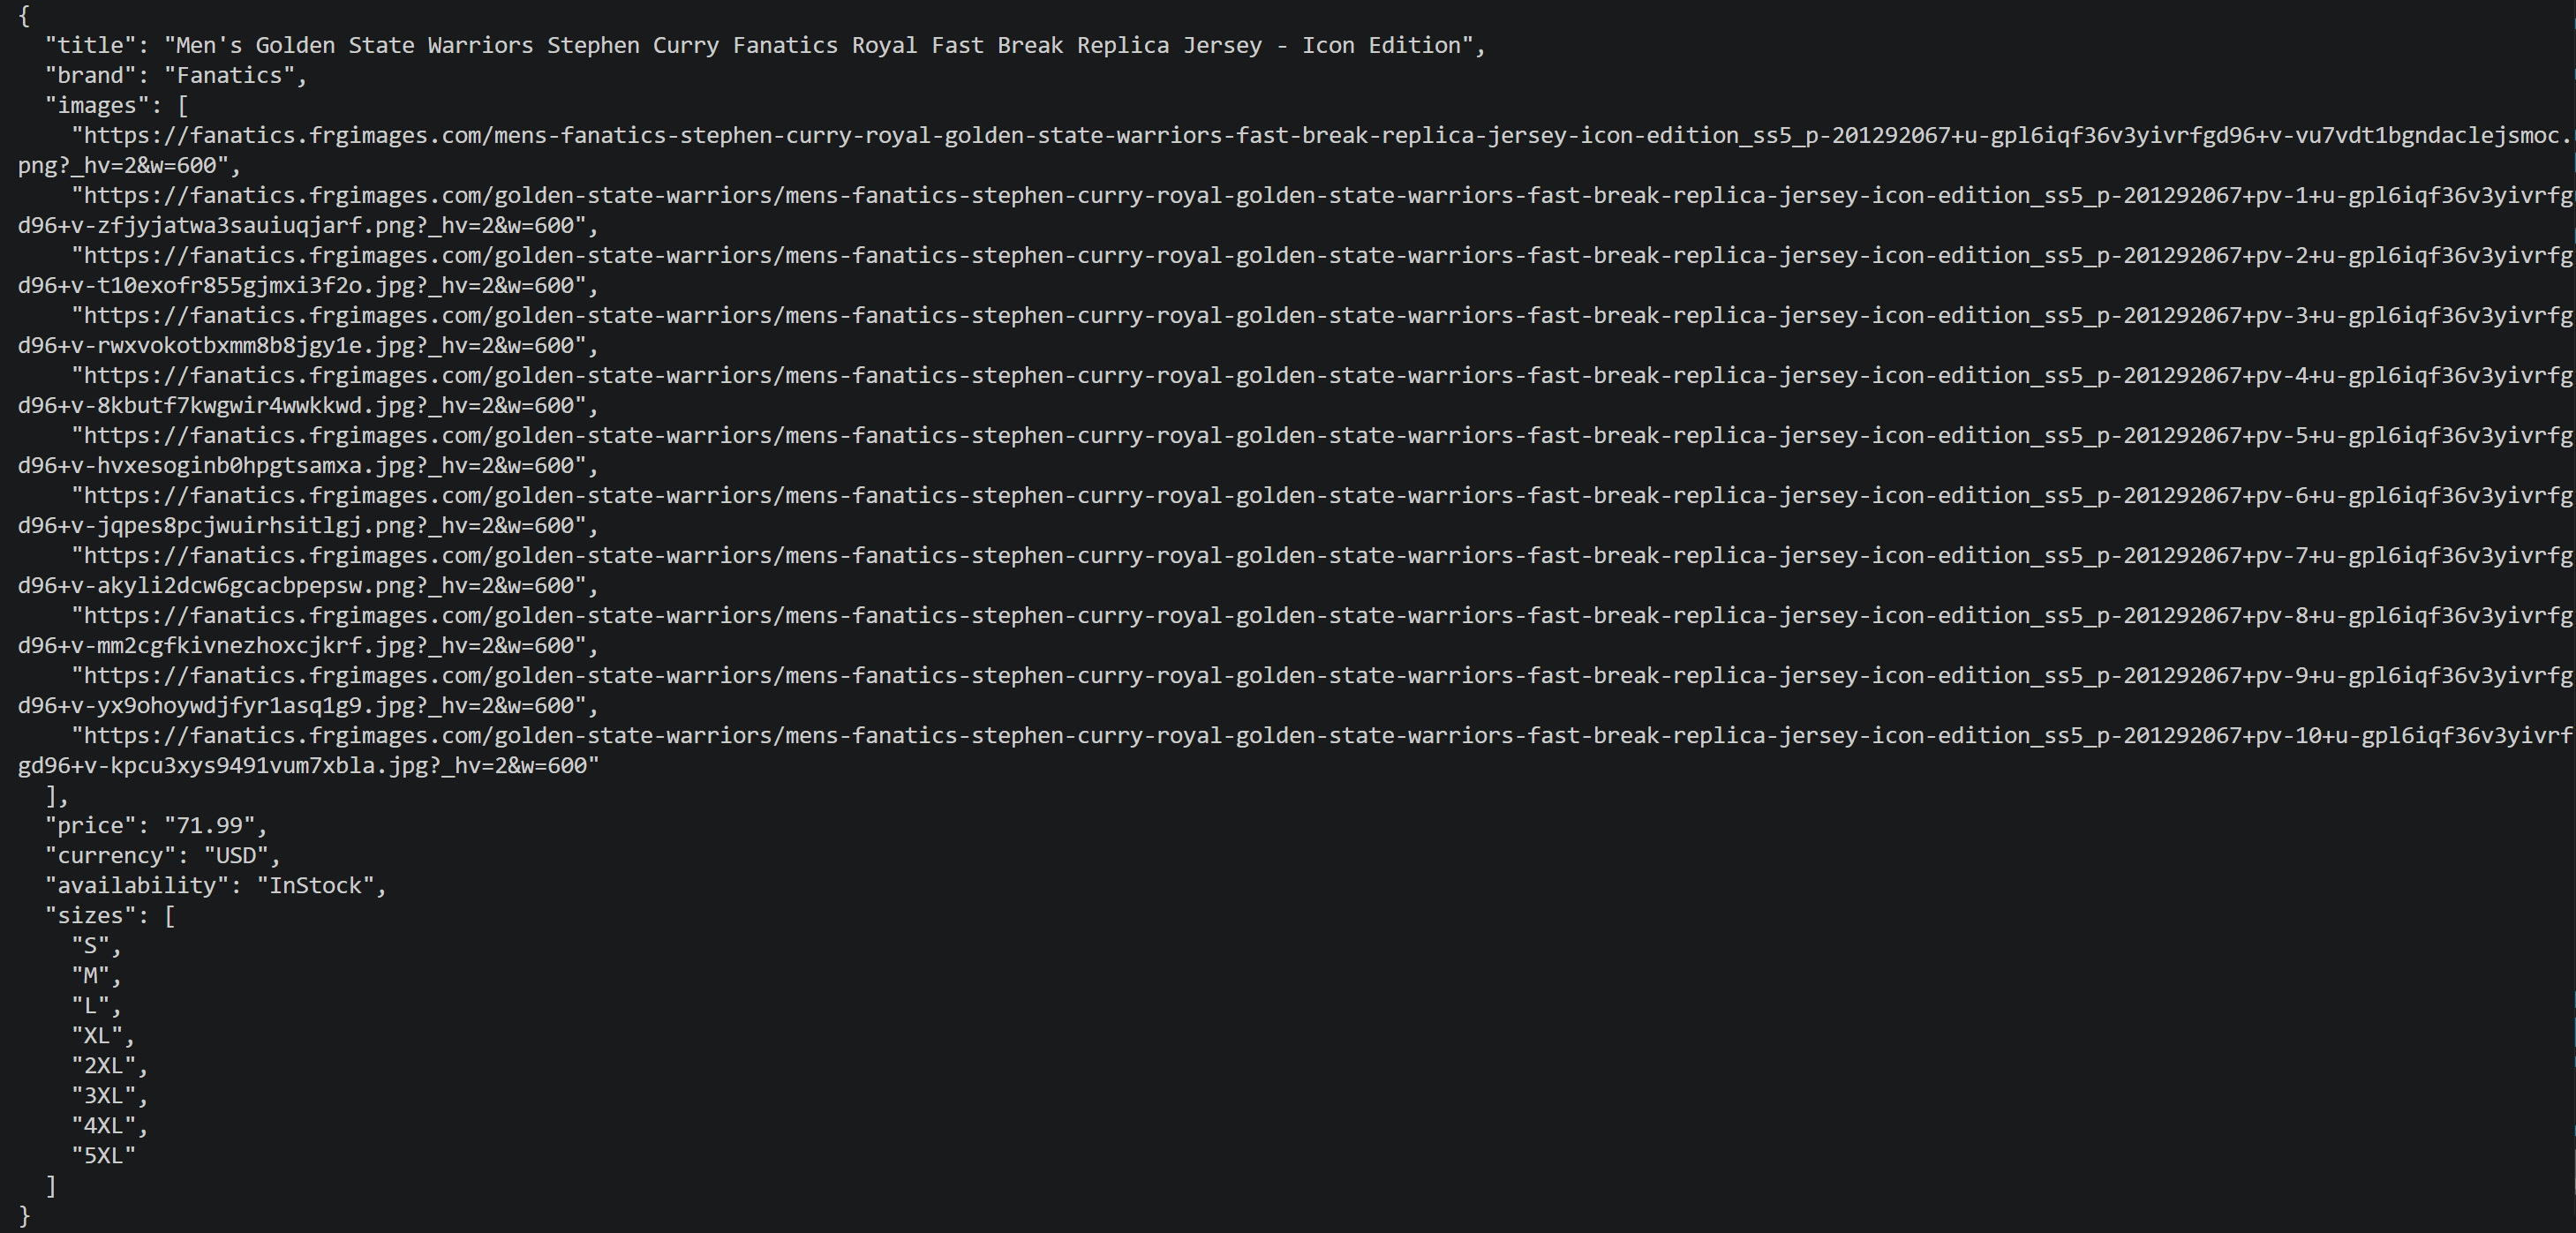
Esos campos corresponden a la información mostrada en la página objetivo.
Conclusión
En este artículo de blog, aprendiste cómo el SDK de Python de Bright Data proporciona un único paquete de Python para acceder a los productos de scraping, búsqueda y conjuntos de datos de Bright Data. También viste cómo instalar el SDK y usarlo en escenarios del mundo real.
Para saber más, explora la documentación oficial, el repositorio de GitHub y el directorio de ejemplos, que contiene scripts funcionales para cada característica. Si te resulta útil el SDK, ¡considera darle una estrella al repositorio!
Crea una cuenta de Bright Data hoy mismo y prueba el SDK de Python para simplificar el acceso a las APIs de Bright Data.
Preguntas frecuentes
¿Por qué es útil el SDK de Python de Bright Data?
Le brinda a los desarrolladores de Python un único paquete consistente para hacer scraping de sitios web, ejecutar consultas en motores de búsqueda, evitar la detección de bots y CAPTCHAs, extraer datos estructurados de plataformas y acceder a más de 100 conjuntos de datos listos para usar. Gracias a él, no tienes que construir esa infraestructura tú mismo.
¿Necesito el CLI de Bright Data para usar el SDK?
No. El SDK funciona con un token de API establecido en BRIGHTDATA_API_KEY o BRIGHTDATA_API_TOKEN. Si ya has ejecutado brightdata login, el SDK recurre a las credenciales almacenadas por el CLI, por lo que no necesitas configurar nada más.
¿Cuál es la diferencia entre el CLI de Bright Data, el SDK de Python, el MCP y las Agent Skills?
El CLI ejecuta comandos de Bright Data desde tu terminal. El SDK de Python permite que tu código Python llame a las APIs. El servidor MCP de Bright Data ofrece a los agentes de IA herramientas de scraping y búsqueda, y las Agent Skills enseñan a los agentes de codificación cómo usar Bright Data.
¿Cuál es la diferencia entre el SDK de Python de Bright Data y el SDK de JavaScript de Bright Data?
El SDK de Python (brightdata-sdk, instalado con pip) ofrece clientes síncronos y asíncronos con métodos en snake_case como scrape_url(). El SDK de JavaScript (@brightdata/sdk, instalado con npm) se ejecuta en Node.js y usa métodos en camelCase como scrapeUrl().
¿Cuándo debo usar el modo síncrono o asíncrono?
Usa el cliente síncrono para scripts sencillos y verificaciones rápidas, ya que cada llamada se bloquea hasta que el resultado esté listo. Usa el cliente asíncrono para cargas de trabajo de alta concurrencia, trabajos por lotes y procesamiento en segundo plano.