Scrapear Walmart a gran escala brinda a los equipos de precios los precios, el stock y las reseñas que ven los compradores, recopilados de miles de páginas según un calendario.
El control de bots de Walmart es solo el primer problema. Cuando obtuve páginas de productos desde IPs rotativas, Walmart fijó el precio de cada página para una tienda diferente. Si tu scraper no define un código postal o tienda, Walmart elige una tienda según la dirección IP. Tu tabla de precios entonces mezcla tiendas, y ningún error te lo advierte.
Esta guía explica las defensas y los límites de listado de Walmart, qué método elegir, y cómo recopilar precios a nivel de tienda en Python.
TL;DR
- La tienda puede cambiar el precio. En 8 códigos postales, el mismo galón de leche varió entre $2.42 y $6.28.
- Definir la tienda por solicitud funcionó. Con un ID de tienda, la API Walmart Scraper de Bright Data devolvió los precios exactos que mostraba el navegador en las dos tiendas que comparé.
- Un listado de categoría de Walmart se detuvo cerca de 390 productos únicos. Afirmaba tener unos 2,450 artículos pero mostraba 389, y al dividirlo en 9 rangos de precio se encontraron 2,069.
- Un estado 200 no significó éxito. Walmart sirvió su desafío “¿Robot o humano?” con HTTP 200, así que verifica el contenido y el ID de tienda de cada registro.
Cómo detecta Walmart a los scrapers
Las páginas de producto de Walmart estaban protegidas por Akamai, HUMAN, y un firewall de aplicación web (WAF) de F5. Los encabezados, cookies y configuración de tiempo de ejecución de una sola respuesta de página de producto mostraron los 3:
| Capa | Cómo la reconocí | Qué recibían los scripts |
|---|---|---|
| Borde de Akamai | Los encabezados x-ak-protocol y server-timing: ak_p, la cookie akavpau_p2, y las cookies de Bot Manager ak_bmsc y bm_sv en sesiones de navegador |
418 Access Denied para llamadas GraphQL sin los encabezados de cliente de Walmart |
| HUMAN, antes PerimeterX | Un sensor propio en /px/PXu6b0qd2S/init.js y las cookies _pxhd, _px3, y _pxvid |
Una redirección 307 a /blocked, luego una página “¿Robot o humano?” de presionar-y-mantener con estado 200 |
| WAF de F5 | 6 cookies con prefijo TS en una sesión de navegador, como TS012768cf |
Ninguna respuesta de bloqueo rastreada hasta él |
Chrome headless simple, lanzado con Playwright, recibió el CAPTCHA de presionar-y-mantener de HUMAN ambas veces que lo intenté. La página de desafío parecía una página normal de Walmart y devolvió el estado 200:
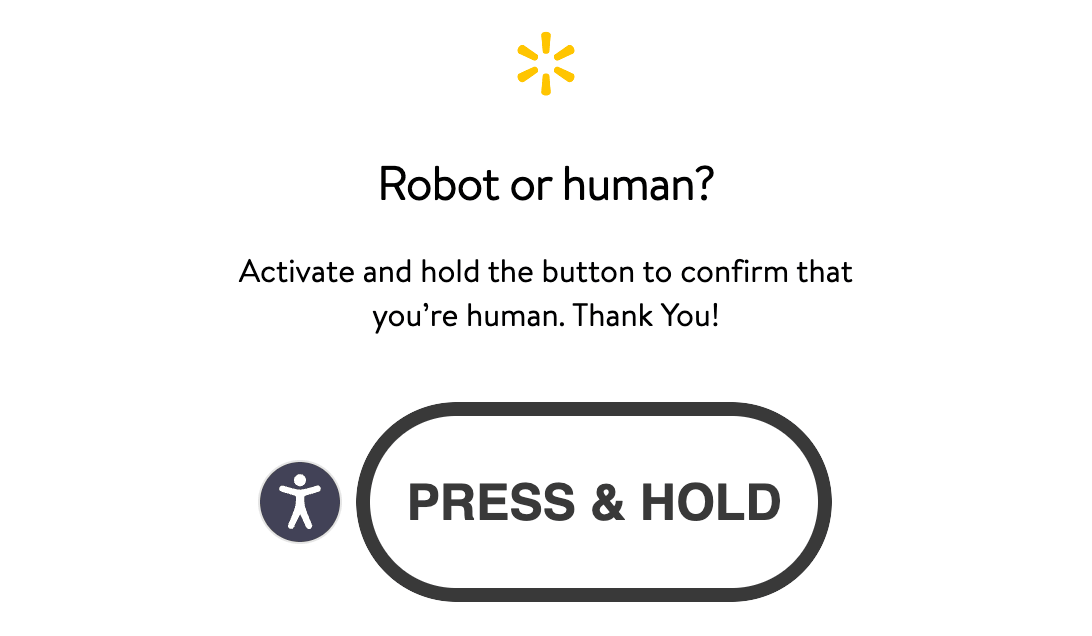
Un scraper que solo revisa el código de estado guardaría esta página como un éxito.
La misma configuración de tiempo de ejecución habilitaba ThreatMetrix, un servicio de perfilado de dispositivos, solo en páginas de cuenta como carrito, pedidos, billetera, y suscripciones. Esa lista no incluía páginas de producto, categoría, o reseñas, las que necesita el monitoreo de precios.
La propia señal de bot de Walmart no mostraba si una solicitud pasaba. Cada página de producto incorporaba un objeto psych con campos como isAkamaiBot. Ese campo era "1" incluso en páginas que Walmart servía completas, así que juzga una respuesta por su contenido y su ID de tienda.
Qué clientes HTTP fueron desafiados
En la misma IP, si Walmart mostraba un desafío dependía del cliente HTTP. Solicité las mismas 5 URLs de producto de Walmart con 6 clientes HTTP desde una IP de banda ancha doméstica no estadounidense, 1 URL por ronda. En cada ronda, los clientes solicitaban esa URL uno a la vez, con 2 segundos de diferencia, y cada uno mantenía su propio almacén de cookies.
De las 5 URLs, 3 estaban muertas, y aun así dieron una señal clara. Un cliente que pasaba recibía la página 404 de Walmart, mientras que un cliente desafiado recibía la página de desafío:
| Cliente | Páginas de desafío en 5 solicitudes |
|---|---|
| curl con LibreSSL | 4 |
Python requests |
2 |
httpx con HTTP/2 |
1 |
curl_cffi imitando Firefox |
2 |
curl_cffi imitando Chrome |
0 |
curl_cffi imitando Safari |
0 |
En las 2 rondas con URLs de producto activas, curl, requests, y el perfil de Firefox recibieron el desafío. En las mismas rondas, segundos después, los perfiles de Chrome y Safari recibieron la página de producto.
Nuestra guía de curl_cffi cubre la configuración de imitación, y nuestro artículo de huella digital TLS cubre lo que expone el protocolo de enlace.
A través de una sesión estadounidense en los proxies residenciales de Bright Data, los mismos 6 clientes hicieron 30 solicitudes sin una sola página de desafío. Cada cliente obtuvo una IP residencial estadounidense. Los resultados dependen de cada combinación de cliente y proxy, así que prueba la tuya contra Walmart en la concurrencia que planeas ejecutar.
Dónde guardan sus datos las páginas de Walmart
Walmart renderizaba páginas de producto, búsqueda, categoría, y reseñas con el enrutador de páginas de Next.js. Cada página incorporaba su modelo de datos como JSON en una etiqueta de script __NEXT_DATA__. En una página de producto de dulces, ese JSON era 401 KB de los 592 KB de HTML. Estas rutas JSON contenían los campos que importan:
- Páginas de producto:
props.pageProps.initialData.data.product, incluyendo precio, disponibilidad, vendedor, y un objetolocation - Páginas de búsqueda y categoría:
props.pageProps.initialData.searchResult.itemStacks[].items, con el total reportado ensearchResult.aggregatedCount - Páginas de reseñas:
props.pageProps.initialData.data.reviews, con su propio bloque de paginación
La etiqueta tenía un atributo nonce, así que empárejala por id con un patrón que permita atributos extra.
En el navegador, la API GraphQL de Walmart servía datos que la página no incorporaba, como detalles de artículos más abajo en la página. La API usaba consultas persistentes, que son consultas guardadas que el cliente llama mediante un hash SHA-256 en la URL:
/orchestra/pdp/graphql/ItemByIdBtf/<sha256-hash>/ip/<item-id>Walmart bloqueó repeticiones scripteadas de estas llamadas GraphQL. Sin los encabezados de cliente x-o-* de Walmart, una llamada scripteada a /orchestra/home/graphql recibía el 418 de Akamai. Con los encabezados, recibía un bloqueo de HUMAN como JSON con estado 412.
Esos encabezados también incluían la versión de la aplicación web, que cambia con los lanzamientos de Walmart, así que los valores codificados en scrapers de código abierto más antiguos quedan desactualizados.
El script de abajo obtiene una página de producto a través de la API Web Unlocker de Bright Data, luego lee los datos del producto y la tienda para la que se fijó el precio. Necesita Python 3.9 o posterior y requests, tu clave API en BRIGHTDATA_API_TOKEN, y tu nombre de zona Web Unlocker en BRIGHTDATA_UNLOCKER_ZONE:
import json
import os
import re

import requests

API_KEY = os.environ["BRIGHTDATA_API_TOKEN"]
ZONE = os.environ["BRIGHTDATA_UNLOCKER_ZONE"]  # nombre de tu zona Web Unlocker
NEXT_DATA = re.compile(r'<script id="__NEXT_DATA__"[^>]*>(.*?)</script>', re.S)


def fetch(url: str) -> tuple[str, str]:
    """Devuelve el código de estado y el HTML de la página."""
    r = requests.post(
        "https://api.brightdata.com/request",
        headers={"Authorization": f"Bearer {API_KEY}"},
        json={"zone": ZONE, "url": url, "format": "raw", "country": "us"},
        timeout=180,
    )
    r.raise_for_status()
    # Web Unlocker reporta el código de estado de la página objetivo en este encabezado.
    return r.headers.get("x-brd-status-code", ""), r.text


def parse_product(html: str) -> dict:
    if "Robot or human" in html:
        raise RuntimeError("página de desafío, no una página de producto")
    match = NEXT_DATA.search(html)
    if match is None:
        raise RuntimeError("no hay bloque __NEXT_DATA__ en la página")
    data = json.loads(match.group(1))["props"]["pageProps"]["initialData"]
    product = data["data"]["product"]
    location = product.get("location") or {}
    price = (product.get("priceInfo") or {}).get("currentPrice") or {}
    return {
        "us_item_id": product.get("usItemId"),
        "name": product.get("name"),
        "price": price.get("price"),
        "availability": product.get("availabilityStatus"),
        "seller": product.get("sellerName"),
        "store_id": (location.get("storeIds") or [None])[0],
        "zip": location.get("postalCode"),
    }


status, html = fetch("https://www.walmart.com/ip/10450114")
if status != "200":
    raise RuntimeError(f"estado de página {status}, no 200")
print(status, json.dumps(parse_product(html), indent=2))
Una ejecución devolvió un producto activo con precio fijado para una tienda que el script nunca solicitó. Tu ejecución probablemente mostrará otra tienda:
200 {
  "us_item_id": "10450114",
  "name": "Great Value Whole Vitamin D Milk, Gallon",
  "price": 3.32,
  "availability": "IN_STOCK",
  "seller": "Walmart.com",
  "store_id": "3081",
  "zip": "95829"
}
La API Web Unlocker reporta el propio código de estado de Walmart en el encabezado x-brd-status-code, como describe su página de códigos de error. El script verifica ese encabezado antes de analizar la página.
Analiza primero el JSON incorporado. Para datos que la página no incorpora, llama a GraphQL desde una sesión de navegador, porque las llamadas scripteadas fueron bloqueadas.
Por qué un precio de Walmart depende de la tienda
La documentación de la API de Marketing de Afiliados de Walmart decía que el precio y disponibilidad de un artículo dependen del código postal y el ID de tienda de la solicitud. Sobre precios en tienda, un portavoz de Walmart dijo a CNBC que “el precio que ves es el mismo para todos en cualquier tienda dada.” Cada página de producto tenía precio fijado para una tienda específica.
La página nombraba esa tienda en su texto “Recoger en”, y el precio variaba según la tienda. El mismo galón de leche costaba $3.32 en la tienda de Sacramento que Walmart asignó y $3.03 en una tienda de Atlanta que elegí manualmente:
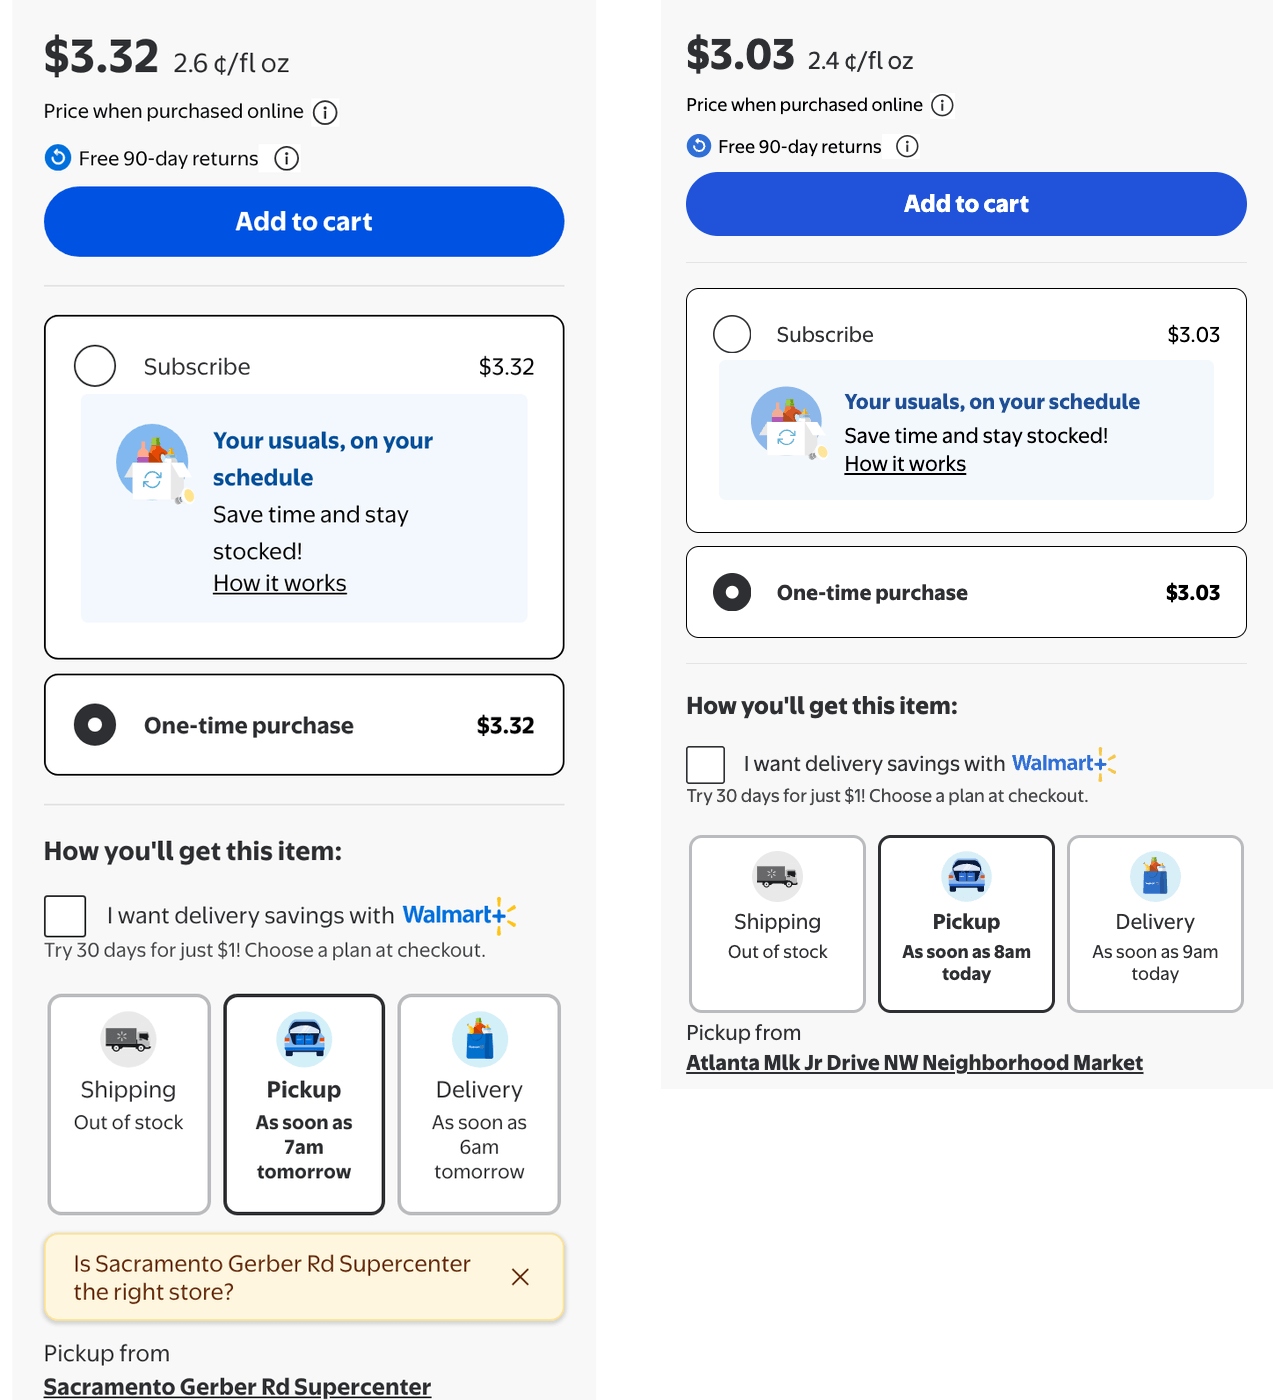
Sin la tienda en cada registro, estos 2 precios para la misma leche parecerían un cambio de precio.
Cuando una solicitud no incluía ubicación, Walmart elegía una tienda, la registraba en el objeto location de la página, y marcaba la elección como IMPLICIT. Algunas conexiones recibían una tienda predeterminada, la tienda 3081 en Sacramento, código postal 95829, que es la tienda en la salida del script. Walmart basaba la tienda en la IP de salida, así que las IPs rotativas también cambiaban la tienda:
- IPs rotativas: cada una de 48 páginas de producto tenía precio fijado para una tienda diferente.
- Otras conexiones: una IP de banda ancha no estadounidense y una IP satelital obtuvieron ambas la tienda predeterminada. Walmart ubicó otra sesión en Big Water, Utah, código postal 84741, y también le dio la tienda predeterminada.
Por qué definir la tienda desde un script no fue confiable
Probé 2 maneras, y ambas dejaron la elección de tienda a Walmart:
- Cookies de ubicación: Definí
assortmentStoreIdy una cookielocGuestDataconstruida a mano. De 9 solicitudes con las cookies, 6 recibieron la página de desafío, mientras que 0 de 3 solicitudes sin ellas lo hicieron. Las 3 que pasaron mantuvieron la tienda de la IP. - Elegir la IP de salida: Walmart usaba su propia geolocalización de IP. Esa geolocalización coincidió con el código postal de una búsqueda de IP estándar en solo 5 de 11 páginas, así que el código postal de una IP no predecía la tienda.
Cómo un código postal o ID de tienda define la tienda
La entrada zipcode de la API Walmart Scraper de Bright Data define la ubicación para cada solicitud. Recopilé 4 artículos de comestibles en cada uno de 8 códigos postales, y el mismo galón de leche entera Great Value mostró 8 precios diferentes:
| Código postal | ID de tienda en el registro | Precio |
|---|---|---|
| 60614, Chicago, IL | 5402 | $2.42 |
| 75201, Dallas, TX | 5823 | $2.46 |
| 72712, Bentonville, AR | 100 | $2.72 |
| 33177, área de Miami, FL | 6397 | $2.92 |
| 94103, San Francisco, CA | 2648 | $3.32 |
| 10001, Nueva York, NY | 3520, Secaucus Supercenter, NJ | $4.07 |
| 99504, Anchorage, AK | 4359 | $4.98 |
| 96813, Honolulu, HI | 3478 | $6.28 |
Los plátanos variaron de $0.13 en Bentonville a $0.42 en Honolulu. Los huevos costaron $1.67 en los 8 códigos postales, pero la recogida no estaba disponible en 3 de ellos. Registra la disponibilidad por tienda, de la misma forma que el precio.
Definir la tienda aún importó para el polvo de proteína, que varió menos que la leche. Recopilé 387 de sus productos dos veces, primero sin código postal y luego con el código postal de Bentonville. Los registros de la primera ejecución provinieron de 170 tiendas diferentes, y 24 productos cambiaron de precio entre las 2 ejecuciones.
Un código postal no es una tienda. El código postal 10001 en Manhattan se resolvió al Secaucus Supercenter en Nueva Jersey, tienda 3520. El selector de tiendas de Walmart listó varias tiendas para el código postal 30303 en Atlanta:
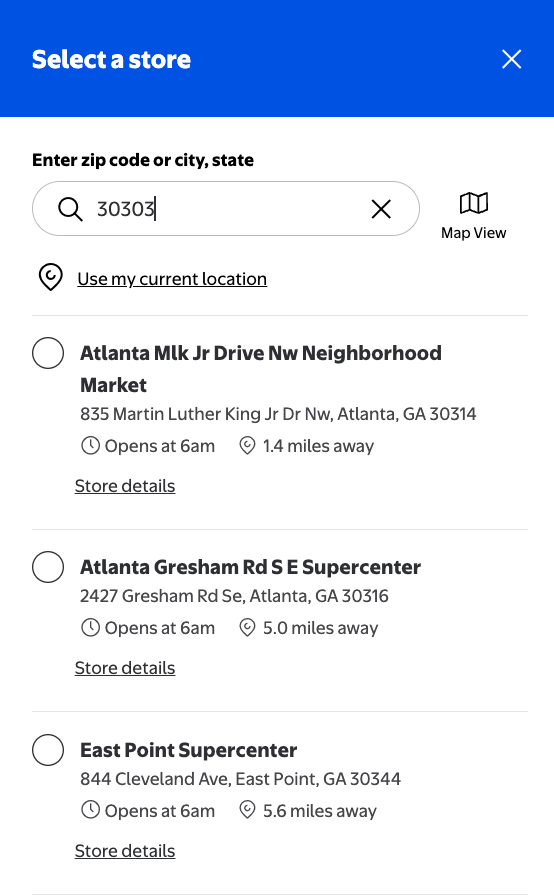
Las primeras 3 tiendas listadas para el código postal 30303. Un código postal apunta a un área, y un ID de tienda apunta a una tienda.
Cuando necesitas una tienda específica, la API Walmart Scraper también acepta un store_id. La URL de página de cada tienda en walmart.com contenía su ID, como 100 en walmart.com/store/100-bentonville-ar. El mapa de sitio de tiendas de Walmart, walmart.com/sitemap_store_main.xml, listaba estas URLs por tipo de tienda, incluyendo páginas para 3,582 Supercenters y 675 Neighborhood Markets. Cuando definí las 2 tiendas de las capturas de la leche, la API devolvió los precios que mostraba el navegador, $3.32 en Sacramento y $3.03 en Atlanta.
Las ejecuciones repetidas para el mismo código postal devolvieron los mismos precios. La leche de Chicago costó $2.42 de nuevo en 2 ejecuciones posteriores dentro de 90 minutos. En Bentonville, 2 trabajos que se ejecutaron al mismo tiempo devolvieron los mismos precios para los 39 productos que ambos trabajos recopilaron. Un día después, el código postal 72712 aún se resolvía a la tienda 100, y la leche allí todavía costaba $2.72.
Qué registrar con cada precio
Ambos precios de leche en las capturas tenían la etiqueta de Walmart “Precio al comprar en línea”, así que trata los precios obtenidos por scraping como los precios en línea de cada tienda.
La disponibilidad también depende del método de cumplimiento. En la página de la leche, el envío mostraba sin stock mientras que la recogida y entrega desde la misma tienda mostraban en stock. Los registros de la API Walmart Scraper tenían indicadores separados de recogida y entrega para esto. Su campo Fulfillment_type nombraba quién cumplía el pedido, como el vendedor o Walmart Fulfillment Services.
Los precios unitarios de Walmart también usaban unidades diferentes. El mismo galón mostraba un unit_price de 0.023 por onza líquida en Miami y 1.02 por cuarto en Nueva York. Recalcula los precios unitarios a partir del tamaño del paquete. Para la leche, el registro completo listaba el tamaño del paquete bajo specifications como 128 onzas líquidas.
Los precios también cambian con el tiempo. Walmart reportó más de 11,000 rollbacks, su término para recortes temporales de precio, en un solo trimestre.
Identifica cada precio por ID de tienda, código postal, y marca de tiempo, y registra la disponibilidad para cada método de cumplimiento. Rechaza cualquier registro con precio fijado para una ubicación que no solicitaste.
Cómo trabajar dentro de los límites de listado y reseñas de Walmart
La página de categoría de polvo de proteína de Walmart reportó unos 2,450 artículos y un maxPage de 25. Las páginas 1 a 10 tenían unos 50 espacios de producto cada una, de los cuales unos 10 eran patrocinados. Las páginas después de la página 11 no tenían productos:
| Página de categoría | Espacios de producto devueltos |
|---|---|
| 1 a 10 | 47 a 50 por página |
| 11 | 13 en una ejecución, 0 en otra |
| 12 a 25 | 0 |
Las páginas 1 a 11 tenían 501 espacios en total, y contenían 389 productos únicos. Este límite de paginación provenía del propio listado de Walmart, así que apareció de la misma forma en cada sesión que ejecuté.
En un navegador de escritorio, los números de página aún llegaban a 25, y la página 12 devolvía la página de no encontrado de Walmart:
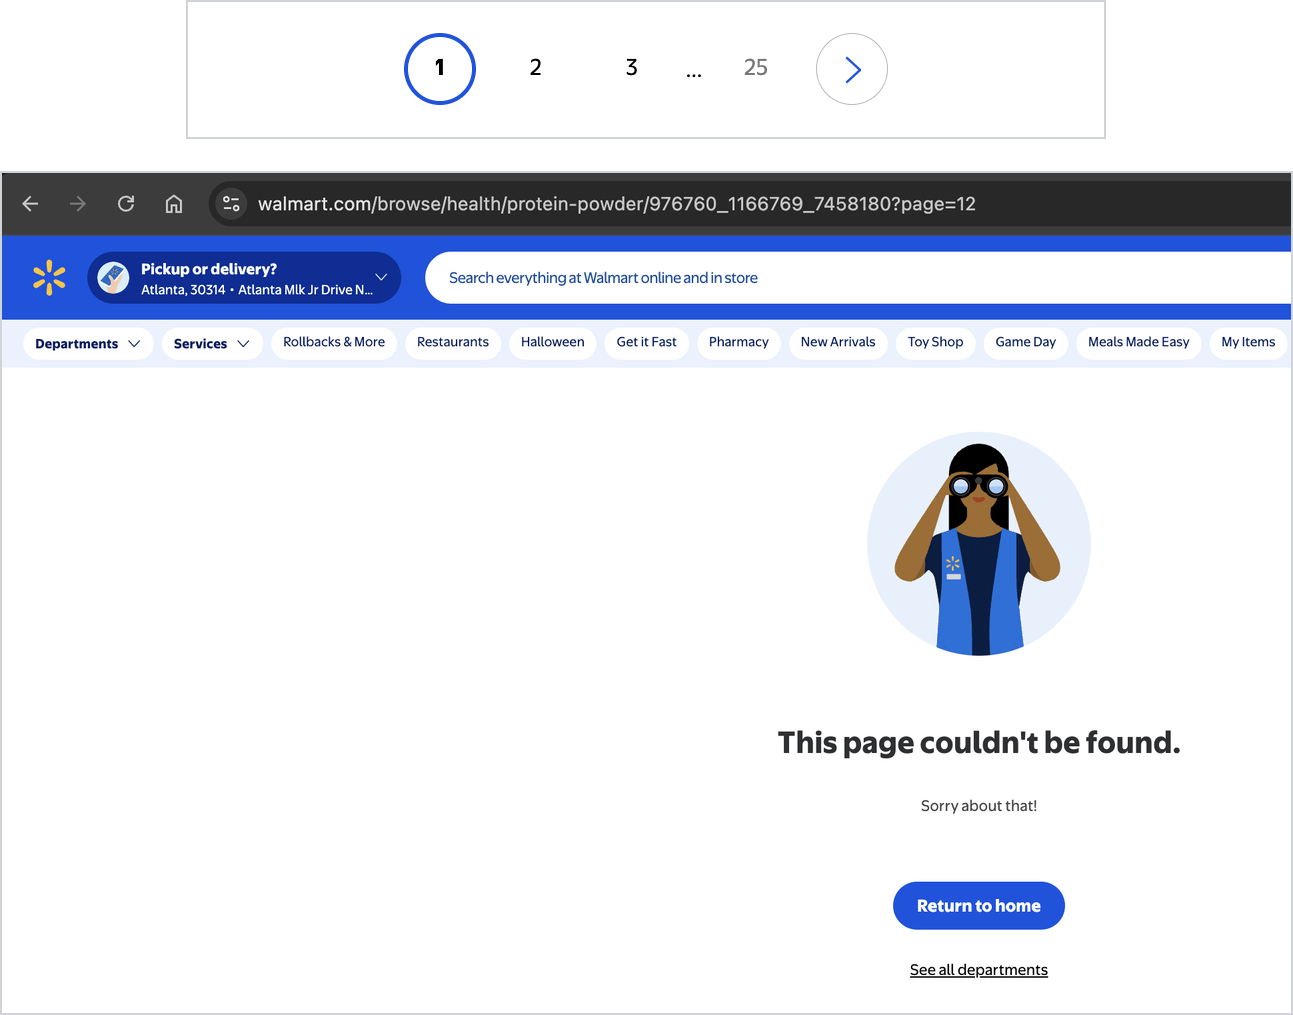
Un scraper que siguió los números de página hasta 25 no obtuvo nada después de la página 11.
Cómo dividir una categoría en rangos de precio
El descubrimiento de categorías de la API Walmart Scraper acepta URLs de categoría con los filtros de precio de Walmart, así que puedes recopilar una categoría rango por rango. Como base, la URL de categoría sin filtrar devolvió 393 productos únicos, cerca de los 389 que mostraba el listado.
Los parámetros de URL min_price y max_price de Walmart dividieron la categoría en rangos de precio, y cada rango reportó su propio conteo. Primero dividí la categoría en $15, $25, $35, $50, y $75. Luego dividí los 3 rangos que reportaron más de 500 productos, en $42, $62, y $100, y ejecuté el descubrimiento en los 9 rangos:
| Rango de precio | Productos reportados por Walmart | Productos únicos descubiertos |
|---|---|---|
| $0 a $15 | 75 | 60 |
| $15 a $25 | 230 | 189 |
| $25 a $35 | 429 | 330 |
| $35 a $50, en 2 rangos | 718 | 569 |
| $50 a $75, en 2 rangos | 592 | 484 |
| $75 en adelante, en 2 rangos | 519 | 444 |
Los 9 rangos devolvieron 2,069 productos únicos, unas 5 veces la base. La columna suma 2,076 porque algunos productos aparecieron en 2 rangos. Ningún rango devolvió más de 330 productos únicos, así que todos se mantuvieron bajo el límite de paginación.
Los conteos reportados por Walmart fueron de 17% a 30% más altos que los productos únicos que devolvió cada fila. En el rango de $0 a $15, las 2 páginas del listado mostraban solo 62 productos únicos, no los 75 reportados por Walmart. El descubrimiento devolvió 60, cerca de los 62 en las páginas. Trata el conteo reportado por Walmart como un límite superior.
Divide cada categoría en rangos de precio hasta que cada rango devuelva menos productos únicos que su límite de paginación, que fue de unos 390 para el polvo de proteína.
Los mapas de sitio de productos de Walmart listaban muchos más productos que un listado de categoría. A través de la API Web Unlocker, obtuve un índice de mapa de sitio de productos que apuntaba a 5,916 archivos de mapa de sitio. El primer archivo solo contenía 50,000 URLs de producto de categorías mixtas, y cada URL tenía solo una fecha de última modificación. Usa mapas de sitio para listas de URL de todo el catálogo, y usa rangos de precio para las categorías que rastreas.
Dónde se detienen los resultados de búsqueda y reseñas
La búsqueda tenía su propio límite de página. Una búsqueda de “laptop” reportó 20,251 resultados pero un maxPage de 14, a 40 resultados por página, así que como máximo 560 resultados eran alcanzables. Donde puedas, descubre productos a través de categorías o mapas de sitio.
Cuando necesites los resultados de búsqueda en sí, como en el seguimiento de participación en el estante, usa el scraper de búsqueda de productos de Walmart, cuyos registros marcaban los resultados patrocinados. Una búsqueda de “polvo de proteína” devolvió 568 registros, incluyendo 164 patrocinados. Entre esos registros, 55 ID de artículo aparecieron más de una vez, y 52 de ellos fueron tanto resultados patrocinados como orgánicos. Mantén ambas colocaciones para el seguimiento de participación en el estante, y deduplica por ID de artículo para una lista de productos.
Las reseñas tenían su propio límite de paginación. La página de la leche mostraba 399,133 calificaciones, de las cuales 27,412 tenían texto escrito. Bajo el orden predeterminado, su paginación mostraba 10 reseñas por página y se detenía en 10,000. La página 1001 no fallaba sino que devolvía la página 1 de nuevo, así que detente en el conteo de páginas que reporta Walmart en lugar de esperar una página vacía.
El scraper de reseñas de Walmart acepta una entrada sort_by para el orden de reseñas. Para un producto de dulces con 127 calificaciones, devolvió las 41 reseñas escritas.
Por qué tu lista de URL necesita actualizaciones regulares
Alrededor de 1 de cada 7 URLs de producto antiguas estaban muertas. De 150 URLs de producto de unos 2 años de antigüedad, 22 devolvieron 404 o 410, y otras 37 páginas activas no tenían precio.
Ejecuta el descubrimiento de nuevo con la frecuencia suficiente para mantener tu lista de URL actualizada, así cada trabajo recopila productos activos.
Cómo elegir un método para scrapear Walmart
Cada método de abajo hace por ti una cantidad diferente de trabajo, desde el acceso crudo a páginas hasta registros terminados. La página de precios de cada producto lista sus precios actuales:
| Método | Qué maneja por ti | Base de facturación | Selección de tienda | Precio actual |
|---|---|---|---|---|
| Proxies residenciales rotativos con tu propio parser | IPs residenciales rotativas para tu propio cliente y parser | Por GB de tráfico | Definida por Walmart desde la IP de salida | Precios de proxies residenciales |
| API Web Unlocker con tu propio parser | Desbloqueo, con el código de estado de Walmart en un encabezado de respuesta | Por solicitud exitosa | Definida por Walmart desde la IP de salida | Precios de Web Unlocker |
| API Walmart Scraper | Descubrimiento, recopilación, y registros analizados con campos de tienda | Por registro entregado | Definida por solicitud con zipcode y store_id |
Precios de la API Web Scraper |
| API de navegador | Un navegador completo con resolución de CAPTCHA integrada, para flujos interactivos | Por GB de tráfico | Definida eligiendo una tienda en la página | Precios de la API de navegador |
| Conjuntos de datos de Walmart | Datos listos de productos, reseñas, y vendedores de Walmart | Por registro | Definida al momento de la recopilación | Precios de conjuntos de datos |
Los proxies residenciales y la API Web Unlocker entregan la página cruda, así que tu equipo ejecuta el parseo y la validación de tienda. La API Walmart Scraper devuelve registros analizados que puedes validar directamente.
Los proxies residenciales te dan control total de cada solicitud. Eliges el cliente, encabezados, y parser, lo que conviene a equipos que ya ejecutan su propia pila.
La API Web Unlocker maneja el acceso para que puedas enfocarte en el parseo. También obtuvo los mapas de sitio de productos de Walmart para listas de URL de todo el catálogo.
La API Walmart Scraper se ajusta al trabajo a nivel de tienda en volumen. Sus entradas zipcode y store_id definen la ubicación, y sus registros reportan la tienda para la que tuvieron precio fijado, así que tu pipeline puede verificar cada registro.
Usa la API de navegador para flujos interactivos. Ejecuta un navegador completo, lo que conviene para explorar una página y capturar nuevos endpoints. Para volumen a escala de catálogo, combínala con la API Walmart Scraper o la API Web Unlocker.
Los conjuntos de datos se ajustan a rellenos de datos y análisis de todo el catálogo. Los conjuntos de datos de Walmart ofrecen una elección de programaciones de actualización.
Los agentes pueden ejecutar búsquedas de producto único. El CLI de Bright Data tiene un pipeline walmart_product, y el servidor MCP de Bright Data tiene una herramienta web_data_walmart_product. Desde una URL de producto, el pipeline del CLI devolvió un registro con el mismo esquema que los registros de la API Walmart Scraper.
Compara cada método por costo por registro válido, porque una página con precio fijado para la tienda equivocada no es un registro utilizable a nivel de tienda.
Cómo construir un pipeline de precios a nivel de tienda con la API Walmart Scraper
Para scrapear Walmart a gran escala, descubre URLs por rango de precio, define un código postal o ID de tienda en cada una, y verifica el ID de tienda de cada registro. La API Walmart Scraper tiene scrapers separados para productos, reseñas, vendedores, y búsqueda, todos disponibles a través de la misma API REST. Las cuentas nuevas pueden comenzar en el nivel gratuito. Cada scraper tiene su propio ID de conjunto de datos y entradas:
| Scraper | ID de conjunto de datos | Entradas principales | Úsalo para |
|---|---|---|---|
| Productos de Walmart | gd_l95fol7l1ru6rlo116 |
url con zipcode y store_id opcional, o descubrimiento por category_url, keyword, o sku |
Precios a nivel de tienda, detalles de producto, e imágenes |
| Códigos postales de productos Walmart | gd_m693oc1r1gebnayxq |
url con zip_code y store_id opcional, o descubrimiento por categoría o palabra clave |
Tienda de recogida, cantidad en stock, y tiempo estimado de entrega |
| Reseñas de Walmart | gd_mpql1v8g2o8o6l1wzd |
url con sort_by opcional |
Reseñas escritas |
| Info de vendedores de Walmart | gd_m7ke48w81ocyu4hhz0 |
url de página de vendedor |
Perfiles de vendedor |
| Búsqueda de productos de Walmart | gd_m7khey0wb7wviejgj |
url de página de búsqueda |
Resultados de búsqueda con indicadores patrocinados |
En el panel de control, el scraper de productos de Walmart aceptaba un código postal y un store_id con cada URL:
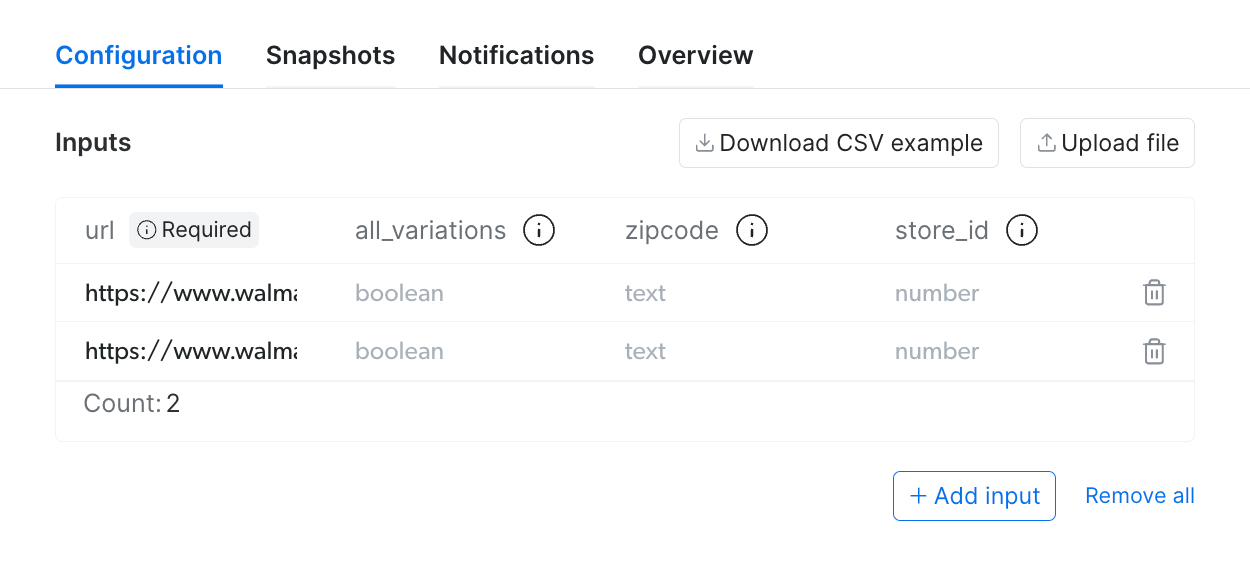
Las columnas zipcode y store_id solicitan una tienda para cada registro.
Crea los auxiliares compartidos
Estos auxiliares necesitan una clave API en BRIGHTDATA_API_TOKEN. La función post respeta Retry-After, así que tu cliente espera y reintenta cuando alcanza los límites de solicitudes asíncronas:
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_TOKEN']}"}
WALMART_PRODUCTS = "gd_l95fol7l1ru6rlo116"


def post(url, **kwargs):
    """POST que respeta Retry-After para mantenerse dentro de los límites de tasa."""
    for attempt in range(6):
        r = requests.post(url, headers=HEADERS, timeout=120, **kwargs)
        if r.status_code != 429:
            r.raise_for_status()
            return r
        time.sleep(int(r.headers.get("Retry-After") or 2 ** (attempt + 1)))
    r.raise_for_status()


def wait_and_download(snapshot_id, every=30):
    while True:
        r = requests.get(f"{API}/progress/{snapshot_id}", headers=HEADERS,
                         timeout=60)
        r.raise_for_status()
        status = r.json()["status"]
        if status == "ready":
            break
        if status in ("failed", "canceled"):
            raise RuntimeError(f"{snapshot_id} terminó como {status}")
        time.sleep(every)
    while True:  # 202 significa que el archivo aún se está ensamblando
        r = requests.get(f"{API}/snapshot/{snapshot_id}", headers=HEADERS,
                         params={"format": "json"}, timeout=300)
        if r.status_code == 200:
            return r.json()
        r.raise_for_status()
        time.sleep(10)
Los bloques de descubrimiento y recopilación de abajo reutilizan post, wait_and_download, API, y HEADERS, así que mantén los 3 bloques en el mismo archivo.
Descubre URLs de producto por rango de precio
Estas funciones dividen una categoría en rangos de precio y devuelven una lista ordenada de URLs únicas:
def price_ranges(category_url, edges):
    """Una entrada de descubrimiento por rango de precio.

    Elige límites que mantengan cada rango bajo el límite de paginación.
    """
    sep = "&" if "?" in category_url else "?"
    urls = [f"{category_url}{sep}min_price={lo}&max_price={hi}"
            for lo, hi in zip(edges, edges[1:])]
    return [{"category_url": u, "all_variations": False} for u in urls]


def discover(category_url, edges, per_range=600):
    body = {"input": price_ranges(category_url, edges),
            "limit_per_input": per_range}
    params = {"dataset_id": WALMART_PRODUCTS, "type": "discover_new",
              "discover_by": "category_url", "include_errors": "true"}
    job = post(f"{API}/trigger", params=params, json=body)
    records = wait_and_download(job.json()["snapshot_id"])
    urls = {r["url"].split("?")[0] for r in records if r.get("url")}
    return sorted(urls)
Con per_range=600, un solo trabajo de descubrimiento a través de los 9 rangos de precio del polvo de proteína devolvió 2,069 URLs de producto únicas.
Los registros de error tenían un mensaje error descriptivo junto con su error_code, como el estado 410 Gone que Walmart devolvió para productos eliminados. discover conserva solo registros con una url, así que lee los registros de error desde la captura cruda cuando verifiques una ejecución.
Recopila y valida registros a nivel de tienda
Luego recopila cada URL con un código postal, y valida cada registro antes de que llegue a tu almacén de datos. Incluye input, error, y error_code en la lista de campos, así cada registro conserva su entrada y cualquier detalle de error. Agrega specifications si recalculas precios unitarios a partir del tamaño del paquete:
FIELDS = "|".join([
    "product_id", "product_name", "final_price", "currency", "unit_price",
    "available_for_pickup", "available_for_delivery", "store_id",
    "store_name", "store_location", "seller", "timestamp",
    "input", "error", "error_code",  # conserva la entrada y detalles del error
])


def collect(urls, zipcode, store_id=None, webhook=None):
    """Inicia un trabajo asíncrono para un código postal. Devuelve el ID de captura."""
    params = {"dataset_id": WALMART_PRODUCTS, "include_errors": "true",
              "format": "json", "custom_output_fields": FIELDS}
    if webhook:  # Bright Data envía los registros terminados a esta URL
        params |= {"endpoint": webhook, "uncompressed_webhook": "true",
                   "auth_header": os.environ["WEBHOOK_AUTH_HEADER"]}
    row = {"zipcode": zipcode} | ({"store_id": store_id} if store_id else {})
    body = {"input": [{"url": u, **row} for u in urls]}
    job = post(f"{API}/trigger", params=params, json=body)
    return job.json()["snapshot_id"]


def validate(records, zipcode, store_id=None):
    """Conserva registros con precio fijado para la tienda solicitada. Enruta el resto según el motivo."""
    valid, rejected, seen = [], [], set()
    for rec in records:
        url = rec["input"]["url"]
        if rec.get("error_code"):
            rejected.append((url, rec["error_code"]))
            continue
        where = rec.get("store_location") or ""
        if store_id:  # store_location entonces muestra el propio código postal de la tienda
            matched = bool(where) and str(rec.get("store_id")) == str(store_id)
        else:  # store_location debería mostrar el código postal solicitado
            matched = where.endswith(", " + zipcode)
        if not matched:
            rejected.append((url, f"precio fijado para {where or 'sin tienda'}"))
            continue
        try:
            price = float(rec["final_price"])
        except (KeyError, TypeError, ValueError):
            rejected.append((url, "sin precio, verifica la disponibilidad"))
            continue
        key = (rec["product_id"], rec["store_id"])
        if key not in seen:
            seen.add(key)
            valid.append(rec | {"final_price": price})
    return valid, rejected


if __name__ == "__main__":
    category = ("https://www.walmart.com/browse/health/protein-powder/"
                "976760_1166769_7458180")
    edges = [0, 15, 25, 35, 42, 50, 62, 75, 100, 100000]
    urls = discover(category, edges, per_range=5)
    print(len(urls), "URLs de producto descubiertas")
    records = wait_and_download(collect(urls, zipcode="72712"))
    valid, rejected = validate(records, "72712")
    print(len(valid), "registros válidos,", len(rejected), "rechazados")
Una ejecución con 5 productos por rango y el código postal de Bentonville, 72712, imprimió los conteos de abajo. Mientras se ejecutan los trabajos de descubrimiento y recopilación, el script consulta sus resultados. Tus conteos diferirán, porque dependen de los listados de Walmart en el día que ejecutes el pipeline:
42 URLs de producto descubiertas
41 registros válidos, 1 rechazado
Los 41 registros válidos tenían precio fijado para la tienda 100 en Bentonville. Walmart listó el producto restante sin precio. La lista rejected registra por qué se rechazó cada registro.
Solo con un código postal, store_location mostraba el código postal solicitado, así que validate confirma cada registro contra ese código postal. Para una tienda específica, envía su store_id con un código postal donde esa tienda esté disponible, como el propio código postal de la tienda. El registro entonces mostraba el propio código postal de la tienda, así que pasa el mismo store_id a validate, que compara IDs de tienda. La API verificó el emparejamiento, así que la tienda 3520 en Secaucus, enviada con el 72712 de Bentonville, produjo un registro de error que nombraba la discrepancia.
A escala de catálogo, un solo trabajo con el código postal 72712 ejecutó las 2,069 URLs descubiertas, y validate verificó la ubicación reportada de cada registro.
Ejecuta el pipeline en volumen
En volumen, 4 prácticas hacen el pipeline más predecible.
Agrupa URLs en trabajos. Los trabajos se ejecutan de forma asíncrona, así que deja que wait_and_download consulte el resultado. Usa el disparador asíncrono para cada trabajo. Cuando un trabajo necesita más tiempo, el endpoint síncrono devuelve un ID de captura para consultar, así que iniciar de forma asíncrona mantiene una única ruta de código.
Cuenta las entradas únicas. La API deduplicó las entradas repetidas, así que un trabajo de 34 entradas con 2 repetidas devolvió 32 registros. La misma URL enviada con 3 códigos postales contó como 3 entradas, y cada una tenía precio fijado para su propia tienda.
Verifica los registros de error antes de reintentar. Los registros de error nombraban su causa, así que elimina las URLs de producto muertas de tu lista y reenvía el resto.
Entrega a tu almacenamiento. Llama a collect(urls, zipcode, webhook=URL), y coloca el valor completo del encabezado, como Bearer <secret>, en WEBHOOK_AUTH_HEADER. Bright Data envía los registros terminados a la URL del webhook con ese valor como el encabezado Authorization. La guía de entrega cubre la confirmación que envía tu endpoint, las IPs de origen para incluir en la lista blanca, y destinos como Amazon S3, Google Cloud Storage, y Snowflake.
Mantén la validación de tienda en tu pipeline, así cada registro en tu almacén tiene una ubicación verificada.
Reflexiones finales
Scrapear Walmart a gran escala es tanto un problema de ubicación de tienda como un problema de acceso. Cada precio pertenece a la tienda para la que tuvo precio fijado, y un estado de éxito no te dice cuál fue esa tienda. Define un código postal o ID de tienda en cada solicitud de recopilación, y divide el descubrimiento en rangos de precio que cada uno se mantenga bajo el límite de paginación.
Cuando necesites un relleno de datos en lugar de precios diarios por tienda, comienza desde un conjunto de datos de Walmart. De lo contrario, ejecuta algunos rangos de precio y códigos postales a través de la API Walmart Scraper en el nivel gratuito, luego escala una vez que pase la validación de tienda.
Preguntas frecuentes
¿Cómo se scrapean los precios de Walmart por código postal?
Envía un código postal con cada URL de producto en lugar de depender de la IP de salida, que de otra manera Walmart usa para elegir una tienda. Un código postal puede resolverse a una tienda en otro estado, así que agrega un ID de tienda cuando necesites una tienda específica. La API Walmart Scraper de Bright Data acepta ambos y reporta la tienda para cada registro.
¿Tiene Walmart una API pública?
Cuando lo verifiqué, las APIs de Walmart eran para socios. La API de Marketing de Afiliados devolvía precio y disponibilidad por código postal para aplicaciones que ganan comisiones por referidos. Las búsquedas de tienda necesitaban aprobación adicional. Las APIs de Marketplace cubrían solo los propios catálogos de los vendedores, así que los rastreadores de precios a nivel de tienda recopilan páginas de producto públicas.
¿Se pueden scrapear las reseñas de Walmart?
Sí. En una página de producto de leche, la paginación de reseñas de Walmart mostraba 10 reseñas por página y se detenía en 10,000 bajo el orden predeterminado. La página 1001 devolvía la página 1 de nuevo, así que detente en el conteo de páginas que reporta Walmart. El scraper de reseñas de Walmart de Bright Data recopila reseñas escritas y acepta una entrada sort_by para el orden de reseñas.
¿Existe un conjunto de datos de productos de Walmart?
Sí. Bright Data ofrece conjuntos de datos de Walmart listos para productos, reseñas, y vendedores en una programación de actualización que elijas. Se ajustan a rellenos de datos y análisis de todo el catálogo. Para precios diarios a nivel de tienda, recopila registros actuales para un código postal o ID de tienda con la API Walmart Scraper.