Hacer scraping de Yelp implica recopilar listados de negocios, calificaciones y reseñas para análisis de sentimiento, estudio de mercado o leads de ventas. Los planes de autoservicio de la API de Yelp incluían como máximo 7 extractos de reseñas por negocio, mientras que yelp.com muestra el texto completo.
La protección antibots de Yelp devolvió una página de desafío a cada solicitud HTTP de Python que enviamos. Un navegador Chromium local recibió un CAPTCHA deslizante. Incluso cuando una página de negocio cargaba, su HTML no tenía texto completo de reseñas.
Esta guía muestra dónde almacena Yelp sus datos y cómo recopilar detalles de negocios y reseñas completas en Python. También explica cuándo usar la API de Scraper de Yelp de Bright Data.
Resumen
- DataDome, la protección antibots de Yelp, detuvo a los clientes HTTP de Python con un desafío de JavaScript, incluso con suplantación TLS e IPs residenciales de EE. UU.. La API Web Unlocker de Bright Data cargó las 30 páginas de negocios de prueba.
- Las reseñas completas provinieron de la API GraphQL de Yelp, hasta 49 por llamada. Las 582 reseñas recomendadas de un restaurante tomaron 12 llamadas.
- El ID de consulta persistida puede cambiar cuando Yelp despliega cambios, y un script de la API de Navegador captura el nuevo. Un scraper de código abierto publicó un ID desactualizado.
- La API de Scraper de Yelp de Bright Data gestiona el mantenimiento del parser y del ID de consulta por ti, a un precio más alto por reseña. También recopila reseñas que Yelp no recomienda.
Qué bloquea un scraper de Yelp
En nuestras pruebas, las páginas de Yelp estaban protegidas por DataDome, un servicio comercial de protección antibots. Las respuestas bloqueadas incluían sus encabezados (server: DataDome y x-datadome: protected) y establecían una cookie datadome.
Enviamos solicitudes para páginas de negocios de Yelp desde varias configuraciones de cliente. Los clientes incluían curl_cffi, un cliente HTTP de Python que suplanta el handshake TLS de un navegador.
En banda ancha doméstica, cada configuración solicitó la misma página. A través de proxies residenciales de EE. UU., cada cliente solicitó 12 páginas diferentes. Ninguna de las configuraciones pasó el desafío:
| Cliente | Red | Qué devolvió Yelp |
|---|---|---|
requests y httpx (HTTP/2) |
Banda ancha doméstica fuera de EE. UU. | Página CAPTCHA 403, 5 de 5 cada uno |
curl_cffi con perfil TLS de Chrome, Safari o Firefox |
Banda ancha doméstica fuera de EE. UU. | Página de verificación de dispositivo 403, 5 de 5 cada uno |
curl_cffi con perfil TLS de Chrome y User-Agent de Python |
Banda ancha doméstica fuera de EE. UU. | Página CAPTCHA 403, 5 de 5 |
requests y curl_cffi |
Proxies residenciales de EE. UU., nueva IP por solicitud | Página de verificación de dispositivo 403, 12 de 12 cada uno |
| Playwright con Chromium sin interfaz | Banda ancha doméstica fuera de EE. UU. | Página CAPTCHA 403 |
| Playwright con Chromium con interfaz | Banda ancha doméstica fuera de EE. UU. | Verificación de dispositivo primero, luego un CAPTCHA deslizante en 8 segundos |
Cada cuerpo 403 de estas configuraciones era la página de desafío de DataDome. La página incrustaba un objeto var dd={...}, y el campo rt del objeto mostraba el tipo de desafío. El valor c cargaba el script CAPTCHA, y i cargaba una página de verificación de dispositivo.
En la conexión doméstica, requests y httpx obtuvieron c. Con un perfil TLS de navegador, curl_cffi obtuvo i, y con un User-Agent de Python obtuvo c de nuevo. A través de IPs residenciales de EE. UU., la biblioteca requests también obtuvo i. Forzar HTTP/1.1 en curl_cffi devolvió la misma página de verificación de dispositivo.
La verificación de dispositivo ejecutaba JavaScript, y un cliente HTTP no puede ejecutarlo. Un navegador con interfaz ejecutó la verificación de dispositivo y luego recibió este deslizador:
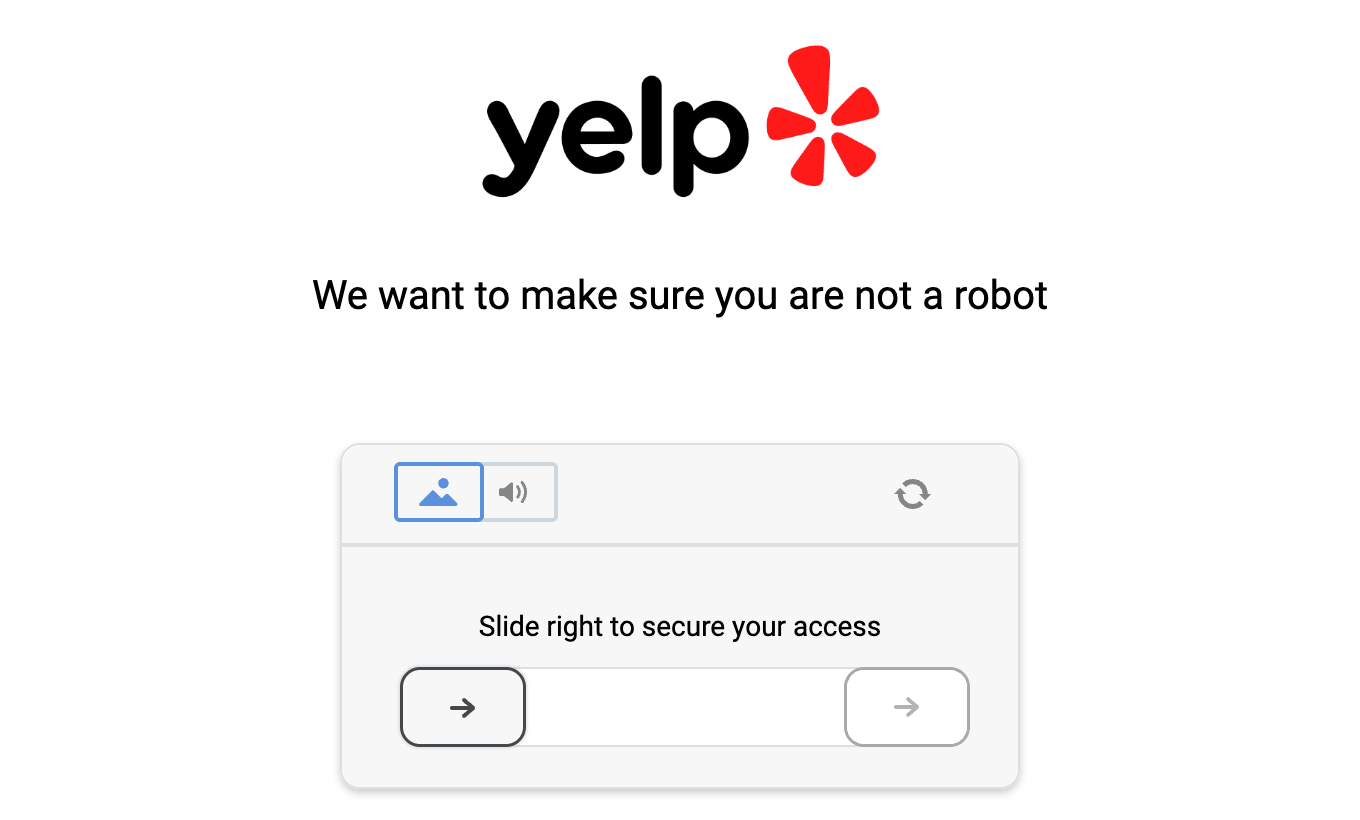
Una sesión de Chromium con interfaz en una conexión doméstica mostró este deslizador a los 8 segundos de cargar la página. Si una persona debe arrastrar el deslizador, un scraper no puede ejecutarse automáticamente.
Los clientes HTTP se detuvieron en un desafío de JavaScript que no pueden ejecutar, incluso a través de IPs residenciales de EE. UU. Los navegadores podían ejecutar JavaScript pero usaban una sola IP doméstica, y Yelp devolvía páginas CAPTCHA a esa IP. La API Web Unlocker de Bright Data gestiona el entorno del navegador, la IP y los desafíos de DataDome por ti, incluyendo los CAPTCHAs en Yelp. Cada solicitud a Yelp en el scraper de Python la usa.
Dónde almacena Yelp los datos de negocios y reseñas
La API de Navegador de Bright Data, un navegador en la nube que controlas con Playwright, muestra cómo una página de negocio de Yelp carga sus datos. Una carga de página registrada envió 12 solicitudes XHR y fetch a www.yelp.com, y 7 de las 12 fueron solicitudes POST a /gql/batch. Los datos estaban en 3 lugares:
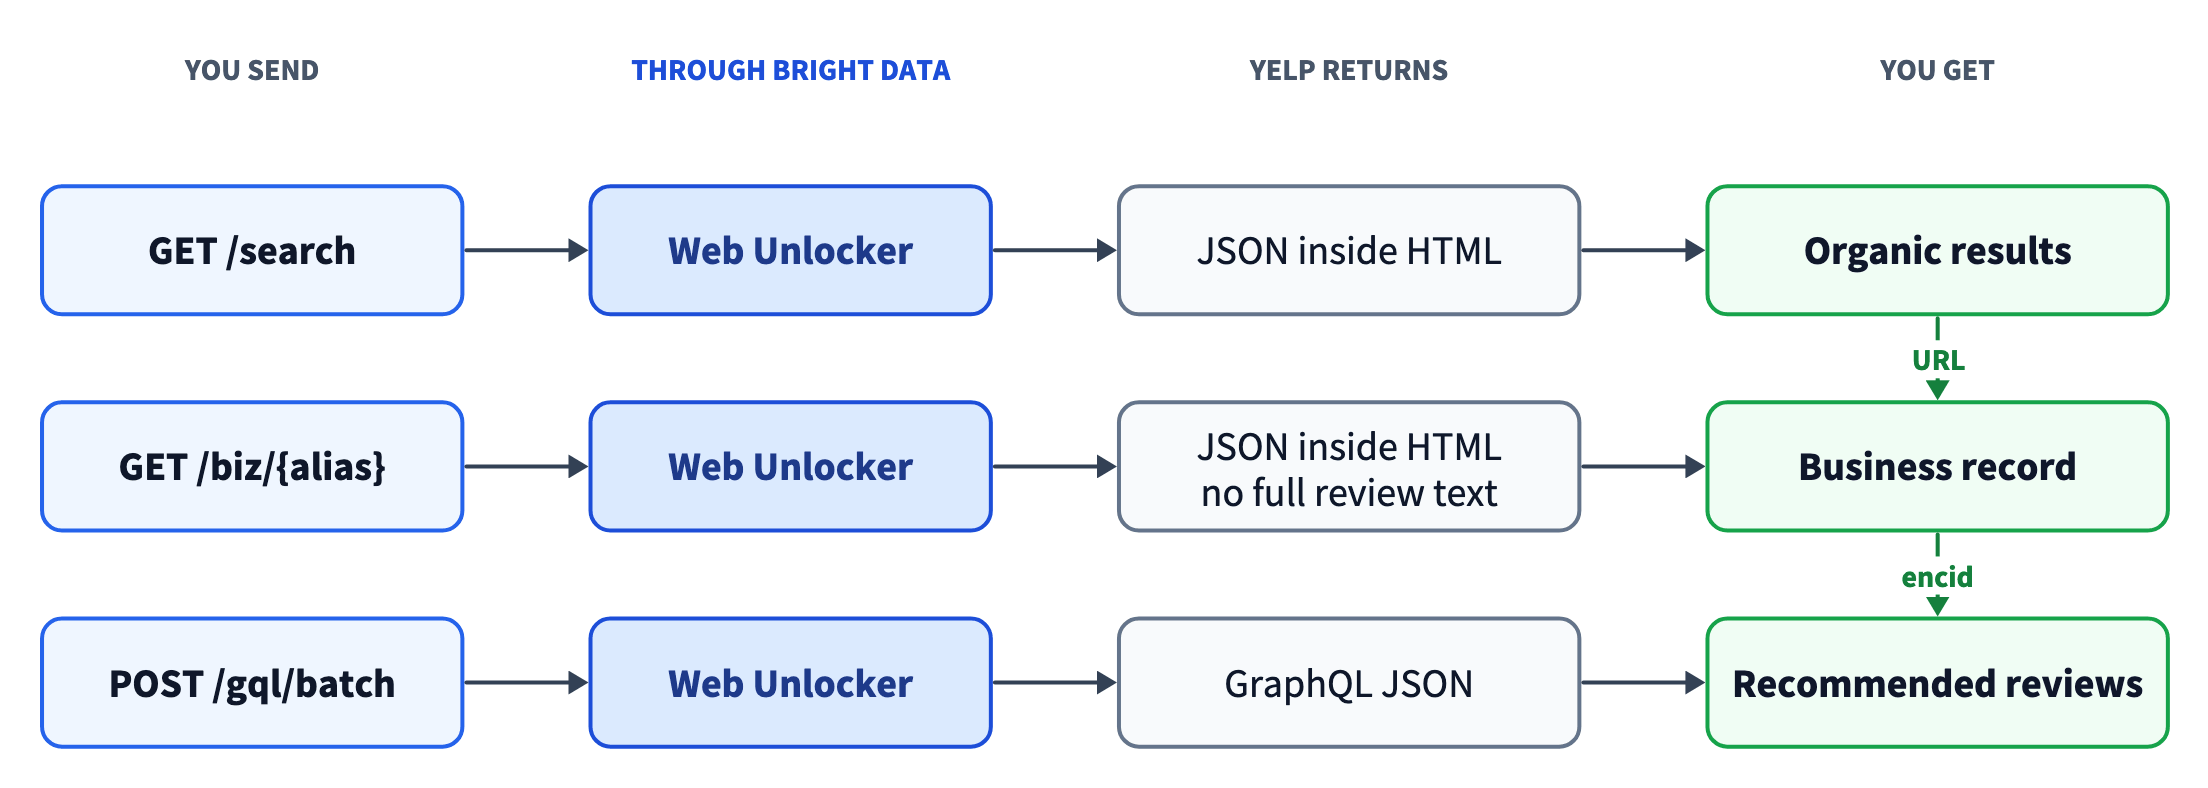
Las páginas de búsqueda y negocio contenían sus datos como JSON dentro del HTML. Las reseñas necesitaban una llamada GraphQL separada que usaba el ID del negocio de la página.
Páginas de búsqueda
Yelp renderizaba los resultados de búsqueda en el servidor con Hypernova, que incrustaba 2 objetos JSON en el HTML. Una etiqueta <script data-hypernova-key> contenía las propiedades de la página, incluyendo la lista de tarjetas de resultados. Una etiqueta <script data-apollo-state> contenía una caché de Apollo Client. Ambos objetos JSON estaban envueltos en un comentario HTML, y la caché de Apollo también tenía escape HTML (").
Los 2 objetos dividían cada resultado entre ellos. Una tarjeta orgánica incluía solo su bizId, rango y URL, mientras que el nombre, calificación y número de reseñas estaban en la caché de Apollo bajo Business:<bizId>. Las tarjetas patrocinadas eran lo contrario, con sus detalles en línea y enlaces a través de /adredir. Un parser que solo leyera las tarjetas obtendría detalles completos para resultados patrocinados y ningún nombre, calificación o número de reseñas para los orgánicos.
En la página de búsqueda renderizada, los 2 tipos de tarjeta se veían así:
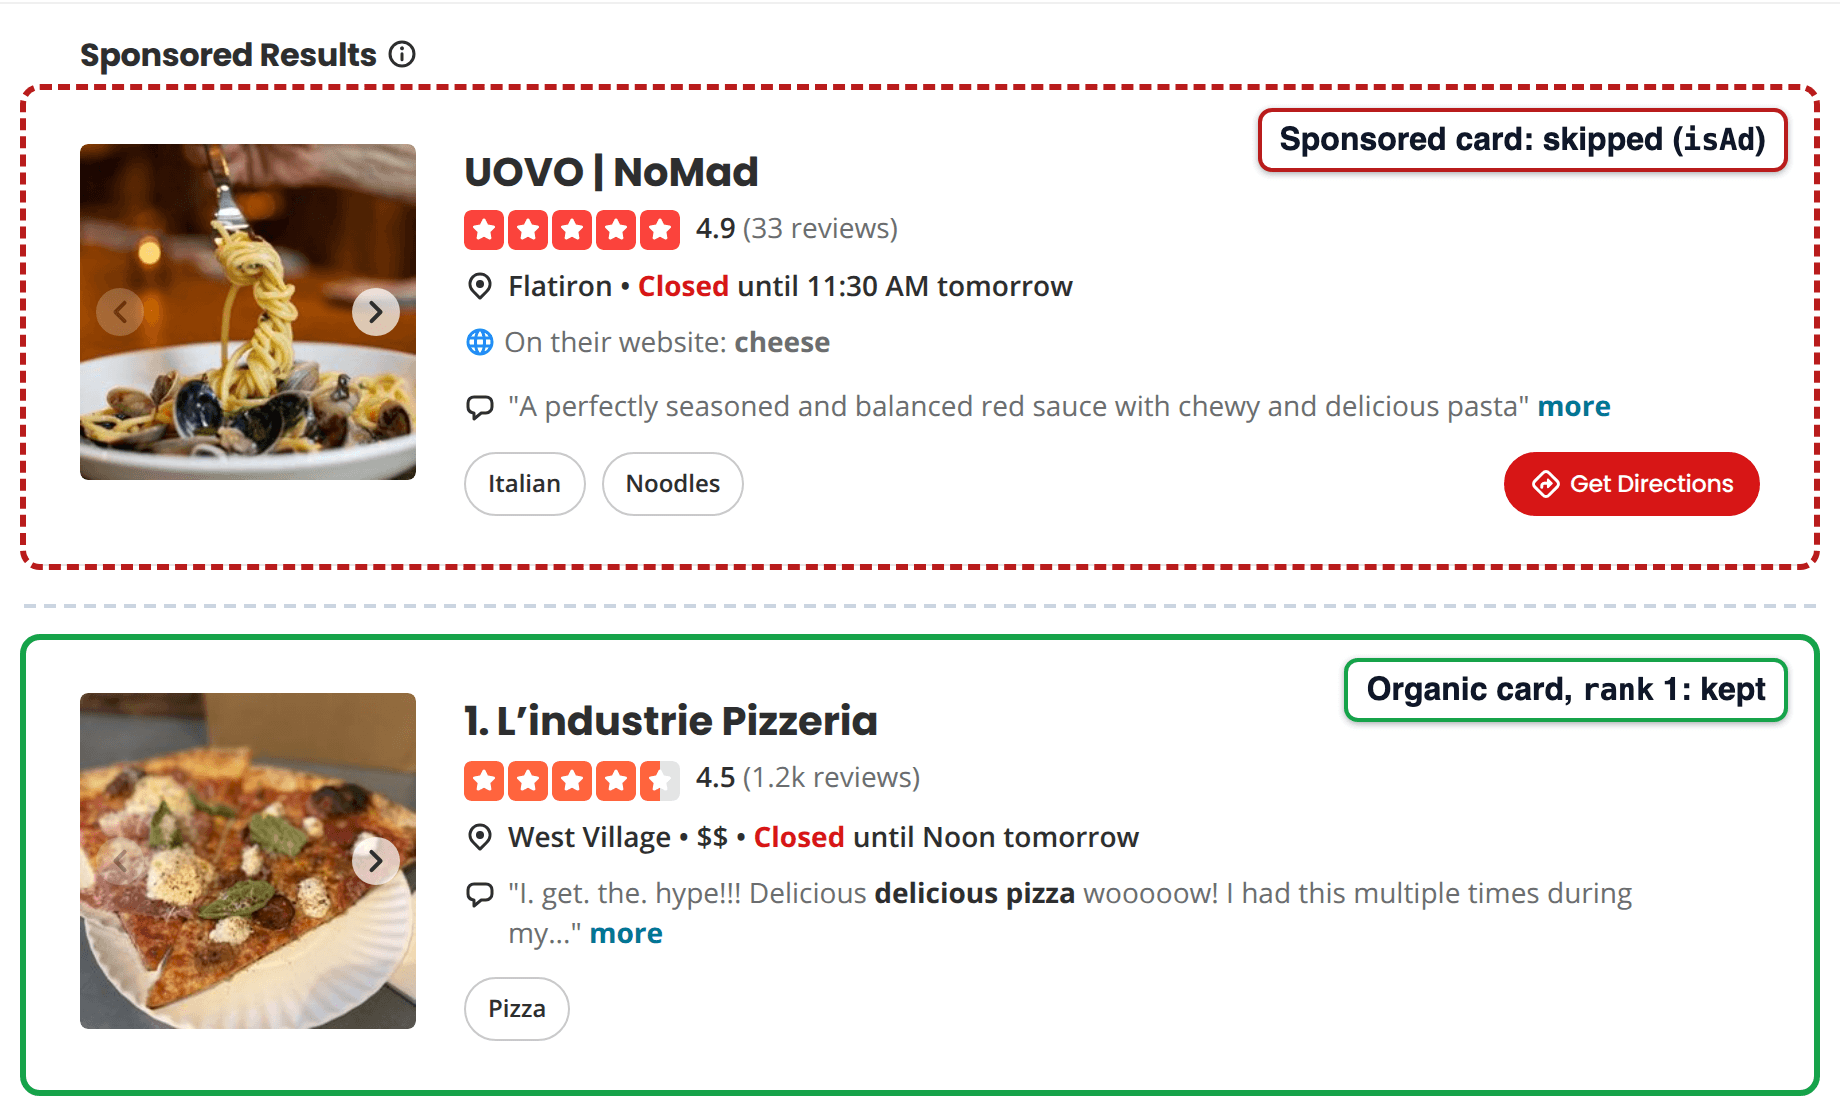
Yelp listaba los resultados patrocinados antes de los resultados orgánicos numerados. parse_search() conserva el rango de cada tarjeta orgánica y omite cualquier tarjeta marcada como isAd.
La búsqueda de Yelp también limitaba el número de resultados. El bloque de paginación reportó totalResults: 240 para las 4 consultas que verificamos, incluyendo “Restaurants” en Dallas, y cada página mostraba 10 resultados. Para recopilar resultados de toda una ciudad, divide la consulta por vecindario, categoría o área del mapa.
Páginas de negocios
Una página de negocio contenía la misma caché de Apollo, y esa caché tenía la mayoría de los campos del negocio. Incluía el ID del negocio (encid), calificación, número de reseñas, dirección, teléfono, rango de precios, categorías, estado de reclamo y sitio web. La etiqueta <meta name="yelp-biz-id"> también contenía el encid. Las tarjetas de búsqueda llaman al mismo ID bizId, y la solicitud GraphQL lo llama encBizId.
En la página de L’industrie Pizzeria, esos campos aparecían en el encabezado y la barra lateral:
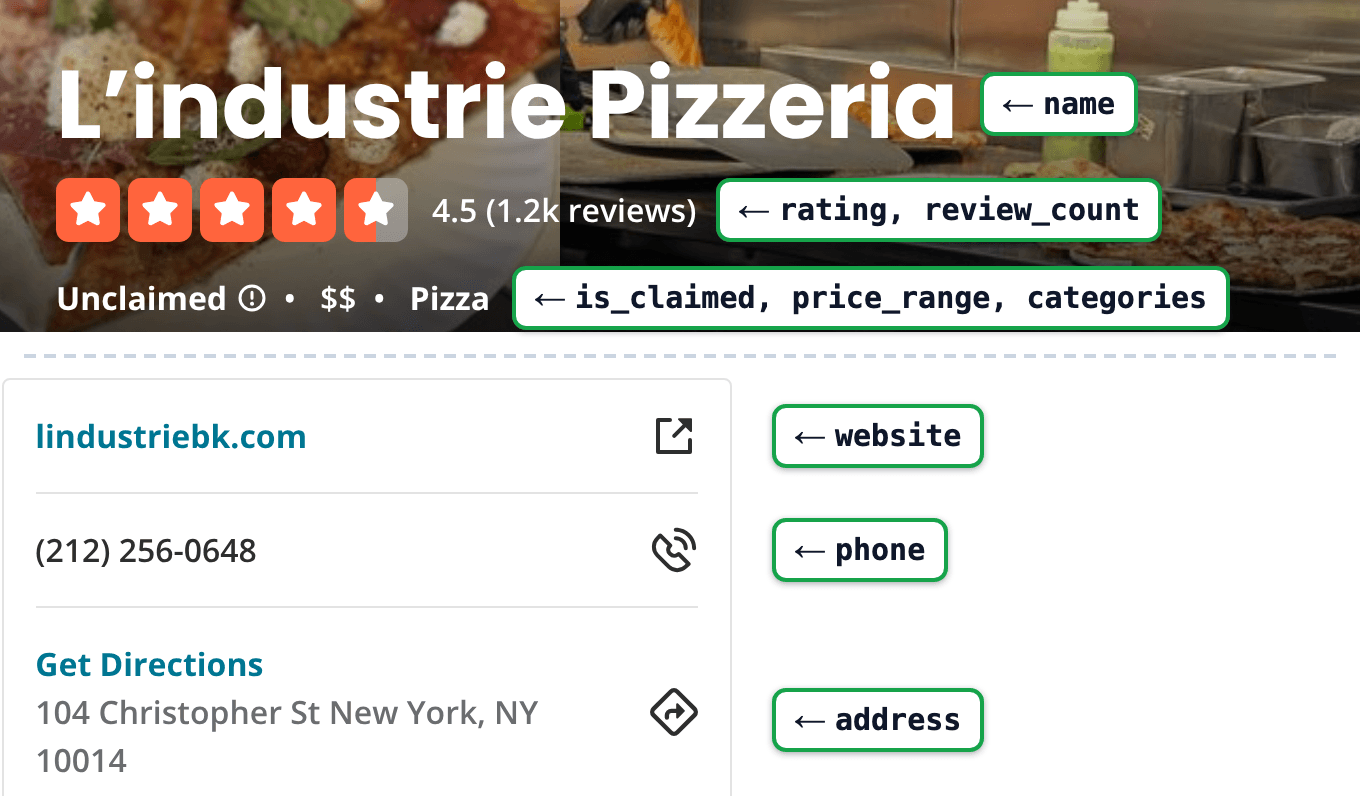
Las etiquetas son las claves que devuelve parse_business(), y cada valor provino de la caché de Apollo en el HTML de la página. La página redondeó el número de reseñas a 1.2k, mientras que la caché tenía el número exacto.
Guías anteriores leían la calificación desde JSON-LD y leían las reseñas desde la propia página. En las 19 páginas de negocios que guardamos, los bloques JSON-LD contenían solo listas de fotos y migas de pan, sin calificación del negocio. La caché de Apollo no contenía texto completo de reseñas en ninguna de las 19 páginas.
En 14 de esas páginas, la caché tenía IDs de reseñas y breves fragmentos destacados, y las otras 5 no tenían referencias a reseñas. La lista completa de reseñas cargaba después, a través de una solicitud GraphQL desde el navegador.
Reseñas en la API GraphQL
Las reseñas provenían del endpoint GraphQL de Yelp. La página enviaba un POST a /gql/batch con un array JSON de operaciones, y la operación GetBusinessReviewFeed devolvía la lista de reseñas. Yelp usaba consultas persistidas, así que la solicitud contenía un ID de consulta persistida de 64 caracteres (documentId) en lugar del texto de la consulta. El servidor rechazaba IDs que no reconocía.
Al abrir la página 2 de las reseñas se envió esta solicitud, mostrada aquí en Chrome DevTools:
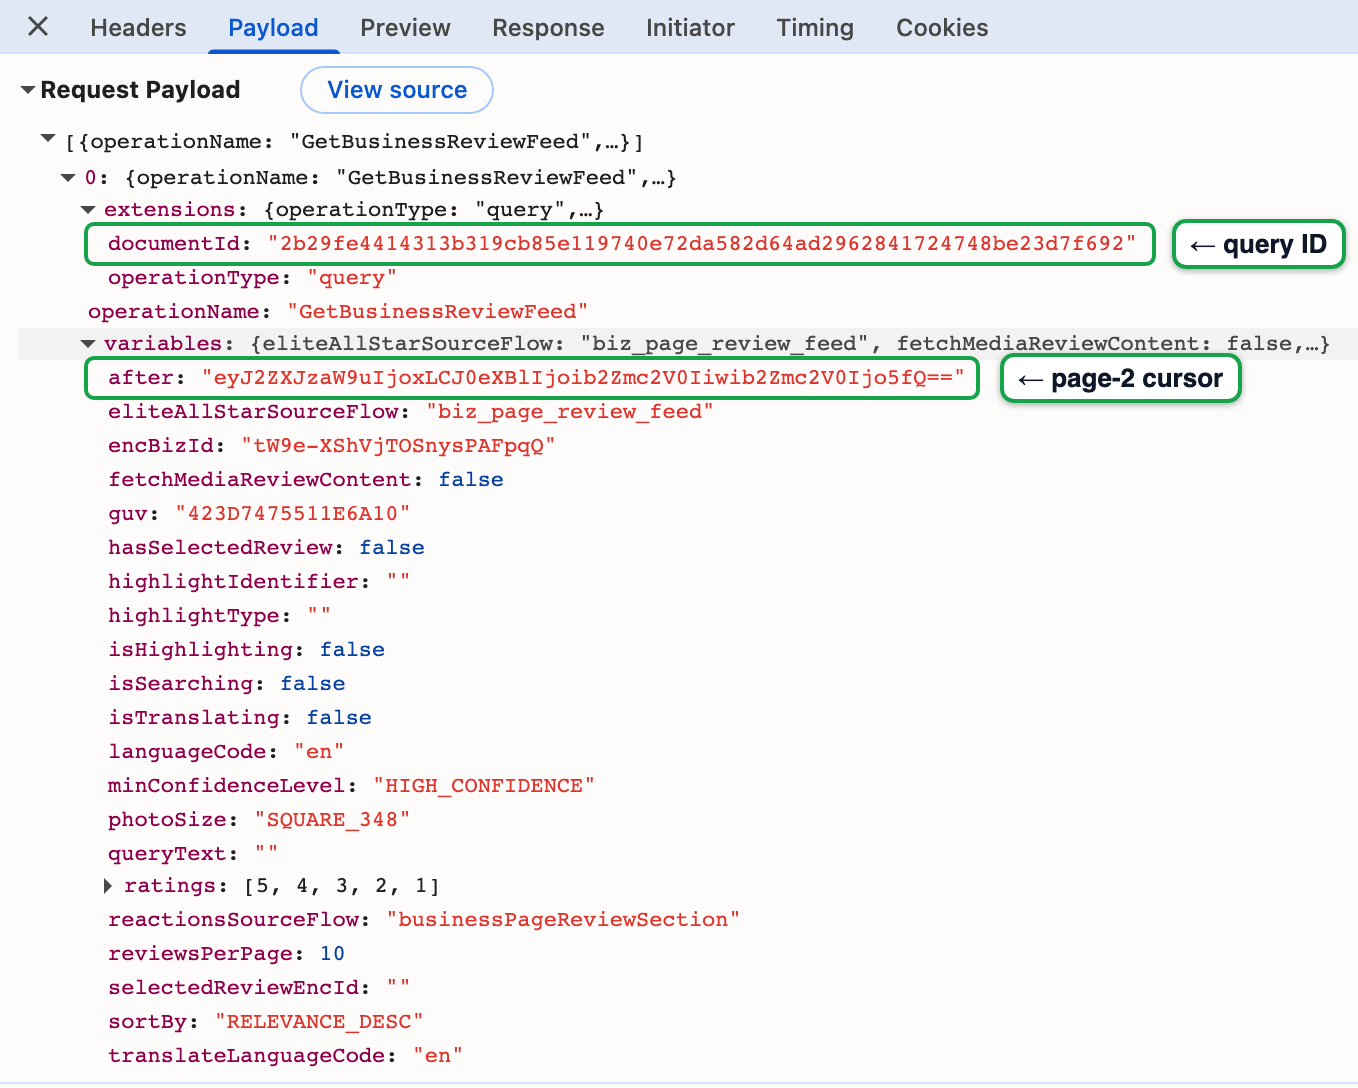
La propia solicitud de la página para la página 2 de reseñas. El scraper envía el mismo documentId y construye el cursor after él mismo.
La API GraphQL se comportó así en nuestras pruebas:
- Tamaño de página:
reviewsPerPageaceptaba 49. Un valor de 50 devolvía un errorBAD_USER_INPUT. - Paginación: el cursor
afterera JSON codificado en base64. El navegador solicitaba 10 reseñas por página, y su cursor de página 2 decodificaba a{"version":1,"type":"offset","offset":9}. Ese formato te permite construir el cursor de cada página tú mismo y obtener las páginas en paralelo. - Ordenamiento y filtros:
sortByaceptabaRELEVANCE_DESC,DATE_DESC,DATE_ASC,RATING_ASC, yELITES_DESC. Un valor deratingsde[1]reducíatotalCounta 35. Ese es el número de reseñas de 1 estrella en Ziziki’s en Dallas, el restaurante que usamos para las pruebas GraphQL. - Errores: los errores de validación se devolvían en una respuesta HTTP 200 y listaban cada variable faltante. Un
documentIddesconocido recibía una respuesta HTTP 403Forbiddenen el navegador. A través de Web Unlocker, la misma solicitud devolvía502con el código de errorhttp_status, lo que significa que Yelp devolvió un estado de error. Ninguna de las respuestas contenía la página de desafío de DataDome, así que un ID desactualizado no parece un bloqueo. - Alcance:
GetBusinessReviewFeeddevolvía las reseñas recomendadas de Yelp, el conjunto que lista la página del negocio. Según Yelp, su software mueve las reseñas que marca como no confiables, solicitadas o injustamente sesgadas a una lista separada de no recomendadas. Para Ziziki’s,totalCountera 582, el encabezado del negocio mostraba 583, y la sección colapsada de la página mostraba 39 reseñas no recomendadas.
La página de Yelp mostraba la misma división. Bajo la paginación de reseñas, una sección colapsada mostraba el número de reseñas que no recomendaba:
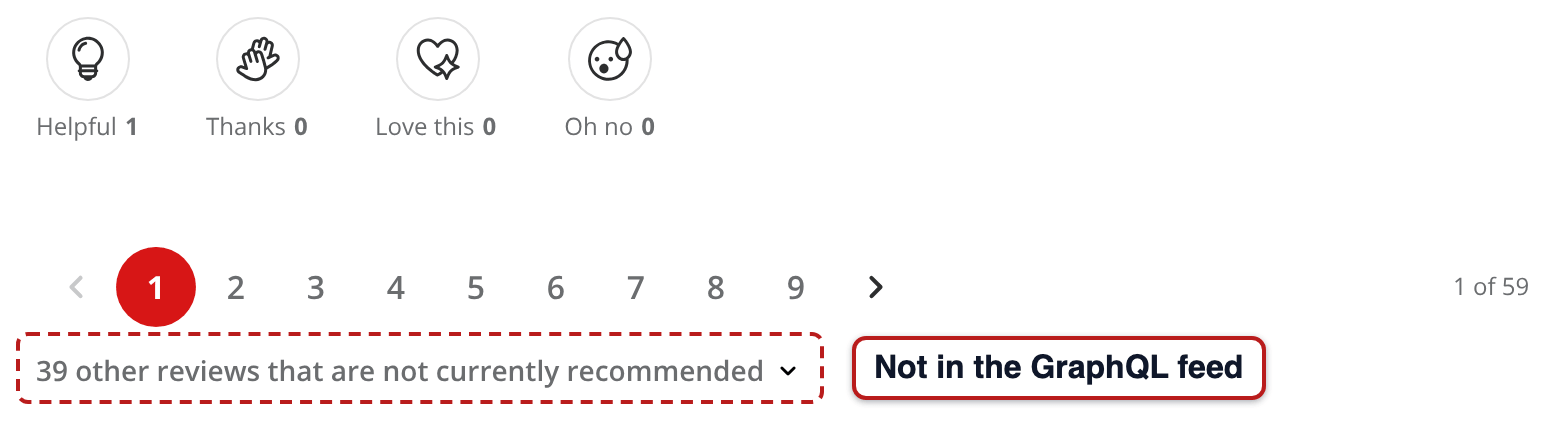
La página de Ziziki’s listaba 59 páginas de reseñas recomendadas, 10 por página, y mostraba 39 más en la sección colapsada.
El documentId puede cambiar cuando Yelp lanza nuevo código frontend. Un popular scraper de Yelp de código abierto publicó un documentId, pero ese ID ya no coincidía con el que enviaba la página en vivo. Un breve script de la API de Navegador, refresh_doc_id.py, captura el ID actual de una página en vivo, para que puedas actualizar el scraper después de que Yelp lance nuevo código.
Construye un scraper de Yelp en Python
El scraper solicita páginas de búsqueda y negocio a través de Web Unlocker con GET. Envía la solicitud GraphQL para reseñas como un POST con un cuerpo JSON.
El código genera un error cuando falta un objeto JSON o una clave requerida. También genera uno cuando el ID de consulta persistida está desactualizado o Yelp rechaza una variable GraphQL. Otros cambios aparecen como campos vacíos o un conteo de filas por debajo de totalCount, así que verifica ambos después de cada ejecución.
Si eres nuevo en el scraping con Python, comienza con nuestra guía de scraping web con Python, que cubre lo básico. Necesitas Python 3.10 o posterior, el paquete requests, y una cuenta de Bright Data. Crea una zona de Web Unlocker, la configuración nombrada a la que hace referencia cada solicitud, siguiendo la guía rápida de Web Unlocker de Bright Data. Luego genera una clave API.
El nivel gratuito incluye 5K créditos al mes, compartidos entre las APIs de scraping de Bright Data. Cada solicitud de Web Unlocker o registro entregado de la API de Scraper de Yelp usa 1 crédito. Web Unlocker cobra solo por solicitudes exitosas. Instala la dependencia y exporta tu clave API y nombre de zona:
pip install requests
export BRIGHTDATA_API_KEY="your_api_key"
export BRIGHTDATA_UNLOCKER_ZONE="web_unlocker"
Las solicitudes de Web Unlocker y de la API de Navegador a Yelp necesitan una cuenta con acceso completo. Las cuentas en modo de acceso inmediato, que no requiere verificación KYC (Know Your Customer), siguen el robots.txt. El robots.txt de Yelp prohibía los rastreadores que no nombraba cuando lo leímos.
Obtienes acceso completo después de la verificación KYC o a través de tu gerente de cuenta. Hasta entonces, Web Unlocker devuelve un error ub_bad_endpoint_robots para las URLs de Yelp, y la API de Navegador devuelve un error brob.
Obtén páginas a través de Web Unlocker
El ayudante envía cada URL al endpoint /request de Web Unlocker y devuelve el cuerpo de respuesta del objetivo, con hasta 3 intentos por URL. Guárdalo como la primera parte de yelp_scraper.py:
import base64
import html
import json
import os
import re
import time
import urllib.parse
from concurrent.futures import ThreadPoolExecutor

import requests

API_KEY = os.environ["BRIGHTDATA_API_KEY"]
ZONE = os.environ.get("BRIGHTDATA_UNLOCKER_ZONE", "web_unlocker")

# ID de consulta persistida de la operación GetBusinessReviewFeed de Yelp.
# Puede cambiar cuando Yelp despliega. refresh_doc_id.py lo captura.
REVIEW_FEED_DOC_ID = os.environ.get(
    "YELP_REVIEW_FEED_DOC_ID",
    "2b29fe4414313b319cb85e119740e72da582d64ad2962841724748be23d7f692",
)
PAGE_SIZE = 49  # La API GraphQL de Yelp rechazó 50 con BAD_USER_INPUT


class FetchError(Exception):
    pass


def unlock(url, method="GET", body=None, attempts=3):
    """Obtiene una URL a través de Web Unlocker; devuelve el cuerpo de respuesta del objetivo."""
    payload = {"zone": ZONE, "url": url, "format": "raw",
               "country": "us", "method": method}
    if body is not None:
        payload["body"] = json.dumps(body)
        payload["headers"] = {"content-type": "application/json"}
    last_error = None
    for attempt in range(attempts):
        try:
            r = requests.post(
                "https://api.brightdata.com/request",
                headers={"Authorization": f"Bearer {API_KEY}"},
                json=payload,
                timeout=180,
            )
            # r.status_code reporta sobre la llamada API en sí.
            # El estado propio del objetivo está en x-brd-status-code.
            status = r.headers.get("x-brd-status-code", str(r.status_code))
            if status == "200" and r.text:
                return r.text
            last_error = f"{status} {r.headers.get('x-brd-error-code')}"
        except requests.RequestException as exc:
            last_error = type(exc).__name__
        if attempt < attempts - 1:
            time.sleep(2 ** attempt)
    raise FetchError(f"{url}: {last_error}")
En una prueba separada de 30 páginas de negocios de Yelp, unlock() cargó cada página.
Analiza los detalles del negocio desde la caché de Apollo
Agrega este parser a yelp_scraper.py. Extrae la caché de Apollo, encuentra el negocio del cual trata la página, y aplana sus campos en un solo registro:
def embedded_json(page, marker, escaped):
"""Devuelve el JSON que Yelp envuelve en <!-- --> dentro de una etiqueta <script>."""
m = re.search(
r"<script[^>]*" + marker + r"[^>]*>\s*<!--(.*?)-->\s*</script>",
page,
re.S,
)
if not m:
raise FetchError(f"{marker} missing: soft block or markup change")
raw = html.unescape(m.group(1)) if escaped else m.group(1)
return json.loads(raw)
def apollo_state(page):
# La caché de Apollo tenía escape HTML (") dentro de un comentario HTML.
return embedded_json(page, "data-apollo-state", escaped=True)
def parse_business(page):
state = apollo_state(page)
ref = next(v["__ref"] for k, v in state["ROOT_QUERY"].items()
if k.startswith("business("))
biz = state[ref]
loc = state[biz["location"]["__ref"]]
claim = next((v for k, v in biz.items()
if k.startswith("claimability(")), None) or {}
website = (biz.get("externalResources") or {}).get("website") or {}
return {
"encid": biz["encid"],
"alias": biz["alias"],
"name": biz["name"],
"rating": biz["rating"],
"review_count": biz["reviewCount"],
"price_range": (biz.get("priceRange") or {}).get("display"),
"phone": (biz.get("phoneNumber") or {}).get("formatted"),
"address": loc["address"]["formatted"].replace("\n", ", "),
"neighborhoods": loc.get("neighborhoods"),
"categories": [state[c["__ref"]]["title"] for c in biz["categories"]],
"is_claimed": claim.get("isClaimed"),
"is_closed": biz.get("isClosed"),
"website": website.get("url"),
}
def get_business(url):
return parse_business(unlock(url))Apollo almacena objetos relacionados una vez y los señala con claves __ref, así que el parser sigue location y categories hasta sus propias entradas. Algunas claves incluían sus argumentos de consulta, como claimability({"useConsumerClaimability":true}), así que el código coincide esas claves por prefijo. El parser leyó las 19 páginas de negocios guardadas sin error.
Extrae reseñas de Yelp desde la API GraphQL
Para extraer reseñas de Yelp, envía una solicitud con el encid del negocio, el documentId persistido, y las variables que la consulta espera. La siguiente parte de yelp_scraper.py construye el cursor de offset ella misma, así que cada página después de la primera se ejecuta en paralelo. El cursor de Yelp contenía el offset de la última reseña de la página anterior, así que review_page() pasa start - 1:
def review_cursor(offset):
    # El cursor "after" de Yelp es JSON en base64 con un offset numérico dentro.
    raw = json.dumps({"version": 1, "type": "offset", "offset": offset},
                     separators=(",", ":"))
    return base64.b64encode(raw.encode()).decode()


def review_page(encid, start, sort_by="DATE_DESC"):
    variables = {
        "encBizId": encid,
        "reviewsPerPage": PAGE_SIZE,
        "after": review_cursor(start - 1) if start else None,
        "sortBy": sort_by,  # RELEVANCE_DESC, DATE_DESC, DATE_ASC, ...
        "ratings": [5, 4, 3, 2, 1],
        "queryText": "",
        "isSearching": False,
        "selectedReviewEncId": "",
        "hasSelectedReview": False,
        "isTranslating": False,
        "translateLanguageCode": "en",
        "isHighlighting": False,
        "highlightType": "",
        "highlightIdentifier": "",
        "photoSize": "SQUARE_348",
        "fetchMediaReviewContent": False,
        "eliteAllStarSourceFlow": "biz_page_review_feed",
        "reactionsSourceFlow": "businessPageReviewSection",
        "minConfidenceLevel": "HIGH_CONFIDENCE",
    }
    body = [{
        "operationName": "GetBusinessReviewFeed",
        "variables": variables,
        "extensions": {"operationType": "query",
                       "documentId": REVIEW_FEED_DOC_ID},
    }]
    try:
        raw = unlock("https://www.yelp.com/gql/batch", method="POST",
                     body=body)
    except FetchError as exc:
        # A través de Web Unlocker, un documentId desconocido se devolvió como
        # 502 http_status, así que el mensaje sugiere actualizar el ID.
        raise FetchError(f"{exc} (outdated documentId? run refresh_doc_id.py)")
    result = json.loads(raw)[0]
    # Los errores GraphQL pueden devolverse en una respuesta HTTP 200.
    if result.get("errors"):
        raise FetchError(result["errors"][0]["message"])
    return result["data"]["business"]["reviews"]


def flatten_review(node):
    author = node.get("author") or {}
    # Los campos del autor son datos personales, así que elimínalos si solo necesitas sentimiento.
    return {
        "review_id": node["encid"],
        "rating": node["rating"],
        "created_at": node["createdAt"]["localDateTimeForBusiness"],
        "text": (node.get("text") or {}).get("full"),
        "language": (node.get("text") or {}).get("language"),
        "author": author.get("displayName"),
        "author_location": author.get("displayLocation"),
        "author_review_count": author.get("reviewCount"),
    }


def get_reviews(encid, max_reviews=None, workers=4):
    first = review_page(encid, 0)
    total = first["totalCount"]
    if max_reviews:
        total = min(total, max_reviews)
    reviews = [e["node"] for e in first["edges"]]
    # Los offsets se conocen de antemano, así que las páginas restantes se ejecutan en paralelo.
    starts = range(PAGE_SIZE, total, PAGE_SIZE)
    with ThreadPoolExecutor(workers) as pool:
        for page in pool.map(lambda s: review_page(encid, s), starts):
            reviews += [e["node"] for e in page["edges"]]
    unique = {r["encid"]: flatten_review(r) for r in reviews}
    return list(unique.values())[:total], first["totalCount"]
get_reviews() recopiló las 582 reseñas recomendadas de Ziziki’s en 12 llamadas GraphQL, y las fechas de las reseñas abarcaban unos 20 años.
El navegador también enviaba un ID de visitante guv y un valor languageCode. La API GraphQL no requería ninguno de los dos en nuestras pruebas, así que el código no los envía.
El valor created_at está en la zona horaria local del negocio, con un offset como -05:00 o -06:00 para Dallas, según el horario de verano. Antes de comparar fechas de reseñas entre ciudades, conserva el offset al almacenar cada valor, o conviértelo a UTC.
Descubre negocios desde los resultados de búsqueda
Las funciones hasta ahora parten de una URL de negocio que ya tienes. Las páginas de búsqueda te dan las URLs de negocios para get_business() y los valores encid para get_reviews(). Agrega también las funciones de búsqueda a yelp_scraper.py. El parser une cada tarjeta orgánica a su registro de Apollo y omite las tarjetas patrocinadas:
def parse_search(page):
    props = embedded_json(page, "data-hypernova-key", escaped=False)
    comps = (props["legacyProps"]["searchAppProps"]["searchPageProps"]
             ["mainContentComponentsListProps"])
    state = apollo_state(page)
    hits = []
    for comp in comps:
        section = comp.get("props") or {}
        if comp.get("type") != "searchResultSection":
            continue
        for item in section.get("searchResults", []):
            if item.get("isAd"):
                continue  # omitir tarjetas patrocinadas
            # Toma los detalles de la caché de Apollo; las tarjetas orgánicas pueden carecer de ellos.
            biz = state.get(f"Business:{item['bizId']}", {})
            hits.append({
                "rank": item.get("ranking"),
                "encid": item["bizId"],
                "name": biz.get("name"),
                "rating": biz.get("rating"),
                "review_count": biz.get("reviewCount"),
                "url": "https://www.yelp.com"
                       + item["businessUrl"].split("?")[0],
            })
    paging = next(c["props"] for c in comps if c.get("type") == "pagination")
    return hits, paging["totalResults"]


def search(term, location, pages=1):
    query = urllib.parse.urlencode({"find_desc": term, "find_loc": location})
    base = f"https://www.yelp.com/search?{query}"
    hits = []
    for n in range(pages):
        # La página 1 no tiene parámetro start, tal como la carga un navegador.
        url = f"{base}&start={n * 10}" if n else base
        batch, total = parse_search(unlock(url))
        hits += batch
        if (n + 1) * 10 >= total:
            break
    return hits
search() envía la página 1 sin start, tal como un navegador carga primero una búsqueda. Se detiene en la última página que totalResults permite, así que una consulta que alcanza el límite de 240 resultados de Yelp necesita 24 páginas.
Ejecuta el scraper de Yelp
El último bloque de yelp_scraper.py ejecuta los pasos en orden. Obtiene 2 páginas de búsqueda, 1 página de negocio, y las 150 reseñas más nuevas de ese negocio, y escribe las reseñas en un archivo JSON Lines:
if __name__ == "__main__":
    hits = search("Pizza", "Lower Manhattan, New York, NY", pages=2)
    print(f"{len(hits)} organic results")
    for hit in hits[:3]:
        print(hit["rank"], hit["name"], hit["rating"], hit["review_count"])

    business = get_business(hits[0]["url"])
    print(json.dumps(business, indent=2, ensure_ascii=False))

    reviews, reported = get_reviews(business["encid"], max_reviews=150)
    print(f"collected {len(reviews)} of {reported} reviews")
    for r in reviews[:2]:
        print(r["created_at"], r["rating"], r["text"][:60])

    with open("reviews.jsonl", "w") as f:
        for row in reviews:
            f.write(json.dumps({"business": business["alias"], **row}) + "\n")
Ejecuta el script desde el directorio donde lo guardaste. La primera línea se imprime solo después de que ambas páginas de búsqueda cargan:
python yelp_scraper.pyLa ejecución imprimió los primeros resultados de búsqueda, el registro del negocio, y las primeras 2 reseñas:
20 organic results
1 L’industrie Pizzeria 4.5 1222
2 Prince Street Pizza 4.3 5720
3 Juliana's 4.4 2997
{
  "encid": "G9hV4H2iGpWD8RoUpjtokg",
  "alias": "l-industrie-pizzeria-new-york",
  "name": "L’industrie Pizzeria",
  "rating": 4.5,
  "review_count": 1222,
  "price_range": "$$",
  "phone": "(212) 256-0648",
  "address": "104 Christopher St, New York, NY 10014",
  "neighborhoods": [
    "West Village"
  ],
  "categories": [
    "Pizza"
  ],
  "is_claimed": false,
  "is_closed": false,
  "website": "http://lindustriebk.com"
}
collected 150 of 1220 reviews
2026-09-25T20:43:26-04:00 4 I arrived here on a Saturday afternoon and man what a line.
2026-09-25T20:37:09-04:00 4 The pizza was like 4.25/5, I came with locals and they said
La ejecución usó 7 solicitudes facturables (2 para páginas de búsqueda, 1 para la página de negocio, y 4 para llamadas GraphQL). La página del negocio reportó 1,222 reseñas, mientras que el totalCount de la API GraphQL era 1,220. Compara tu conteo de filas con totalCount, no con el número en la página, cuando verifiques que una ejecución está completa.
Actualiza el ID de consulta persistida cuando Yelp despliega
Cuando las llamadas de reseñas comienzan a fallar con 502 http_status mientras las páginas de negocios aún cargan, el documentId probablemente ha cambiado. Guarda este script como refresh_doc_id.py. Abre una sola página de negocio en la API de Navegador y se desplaza hasta que la página envíe la solicitud GraphQL para reseñas. Imprime el ID de esa solicitud, o None después de 30 desplazamientos sin ninguno:
import asyncio
import json
import os

from playwright.async_api import async_playwright

# Endpoint de la API de Navegador desde la pestaña Overview de la zona, con -country-us agregado.
BROWSER_WSS = os.environ["BRIGHTDATA_BROWSER_WSS"]
BIZ_URL = "https://www.yelp.com/biz/zizikis-dallas-2"


async def capture_review_feed_doc_id():
    async with async_playwright() as p:
        browser = await p.chromium.connect_over_cdp(BROWSER_WSS)
        page = await browser.new_page()
        found = asyncio.get_running_loop().create_future()

        def on_request(request):
            if (request.url.endswith("/gql/batch")
                    and "GetBusinessReviewFeed" in (request.post_data or "")
                    and not found.done()):
                ops = json.loads(request.post_data)
                op = next(o for o in ops
                          if o["operationName"] == "GetBusinessReviewFeed")
                found.set_result(op["extensions"]["documentId"])

        page.on("request", on_request)
        await page.goto(BIZ_URL, wait_until="domcontentloaded",
                        timeout=120_000)
        # Se desplaza hasta que la página envía la solicitud GraphQL para reseñas.
        for _ in range(30):
            if found.done():
                break
            await page.mouse.wheel(0, 1200)
            await page.wait_for_timeout(1500)
        await browser.close()
        return found.result() if found.done() else None


if __name__ == "__main__":
    print(asyncio.run(capture_review_feed_doc_id()))
Instala Playwright con pip install playwright, y crea una zona de API de Navegador siguiendo la guía rápida de la API de Navegador de Bright Data. Luego configura BRIGHTDATA_BROWSER_WSS con el endpoint de la zona, y agrega -country-us al nombre de usuario. El valor tiene la forma wss://brd-customer-<id>-zone-<zone>-country-us:<password>@brd.superproxy.io:9222. La ejecución imprimió el ID que el scraper ya usa:
2b29fe4414313b319cb85e119740e72da582d64ad2962841724748be23d7f692Cuando el ID impreso difiere, expórtalo como YELP_REVIEW_FEED_DOC_ID y ejecuta yelp_scraper.py de nuevo.
La API de Navegador cobra por GB de tráfico, y 6 cargas de página de negocio de Yelp promediaron unos 8 MB cada una. Web Unlocker cobra por solicitud exitosa. Usa la API de Navegador solo para la actualización ocasional del documentId, y envía solicitudes de páginas y reseñas a través de Web Unlocker.
Soluciona errores comunes
Relaciona lo que ves con una causa probable:
| Lo que ves | Causa probable | Qué hacer |
|---|---|---|
FetchError con 401 None o 400 None |
Una clave API incorrecta (401) o nombre de zona (400) | Verifica BRIGHTDATA_API_KEY, y configura BRIGHTDATA_UNLOCKER_ZONE con el nombre exacto de la zona |
FetchError con ub_bad_endpoint_robots, o brob de la API de Navegador |
La cuenta está en modo de acceso inmediato (sin KYC), que sigue el robots.txt de Yelp | Completa la verificación KYC, o pide a tu gerente de cuenta acceso completo |
FetchError con data-apollo-state missing o data-hypernova-key missing |
Un bloqueo suave (una página de bloqueo devuelta con HTTP 200) o un cambio de marcado | Guarda el HTML que devolvió unlock() y búscalo por la etiqueta <script> nombrada en el error |
Las llamadas de reseñas fallan con 502 http_status mientras las páginas de negocios cargan |
Un nuevo documentId |
Ejecuta refresh_doc_id.py y exporta el ID que imprime |
FetchError con un mensaje de validación GraphQL |
Una variable faltante o fuera de rango | Compara tus variables con el payload de la página en DevTools |
Cualquier otro FetchError de unlock() |
La solicitud falló en los 3 intentos | Reintenta la URL más tarde, o aumenta attempts en unlock() |
Campos vacíos, o un KeyError o StopIteration en un parser |
Una clave renombrada en el JSON de Yelp | Compara el JSON de la página con las claves que lee el parser |
Escala el scraping de Yelp con la API de Scraper de Yelp de Bright Data
Cuando escribes tu propio scraper, también lo mantienes. El ID de consulta persistida, la lista de variables, y los parsers dependen todos del frontend de Yelp, así que cada uno puede fallar cuando Yelp lanza cambios de frontend.
La API de Scraper de Yelp, parte de la API de Web Scraper de Bright Data, toma URLs de Yelp o filtros de búsqueda y devuelve registros analizados. Bright Data mantiene los parsers a medida que cambia el frontend de Yelp. Bright Data también ofrece un scraper de imágenes de Yelp dedicado y un servidor MCP de Yelp para agentes de IA.
La API de Scraper de Yelp también puede recopilar reseñas no recomendadas, que la consulta GetBusinessReviewFeed no devolvió en nuestras pruebas. El software de Yelp no recomendó el 17% de las reseñas publicadas en 2025, según su Informe de Confianza y Seguridad 2025.
Ejecuta la API de Scraper de Yelp desde Python
En el panel de control, la biblioteca de scrapers lista los endpoints de Yelp. Los endpoints de negocios aceptan URLs, filtros de búsqueda, o un cuadro delimitador como entrada, y los endpoints de reseñas aceptan URLs de negocios o filtros de búsqueda. Cada endpoint acepta una lista de entradas y se ejecuta en modo síncrono o asíncrono:
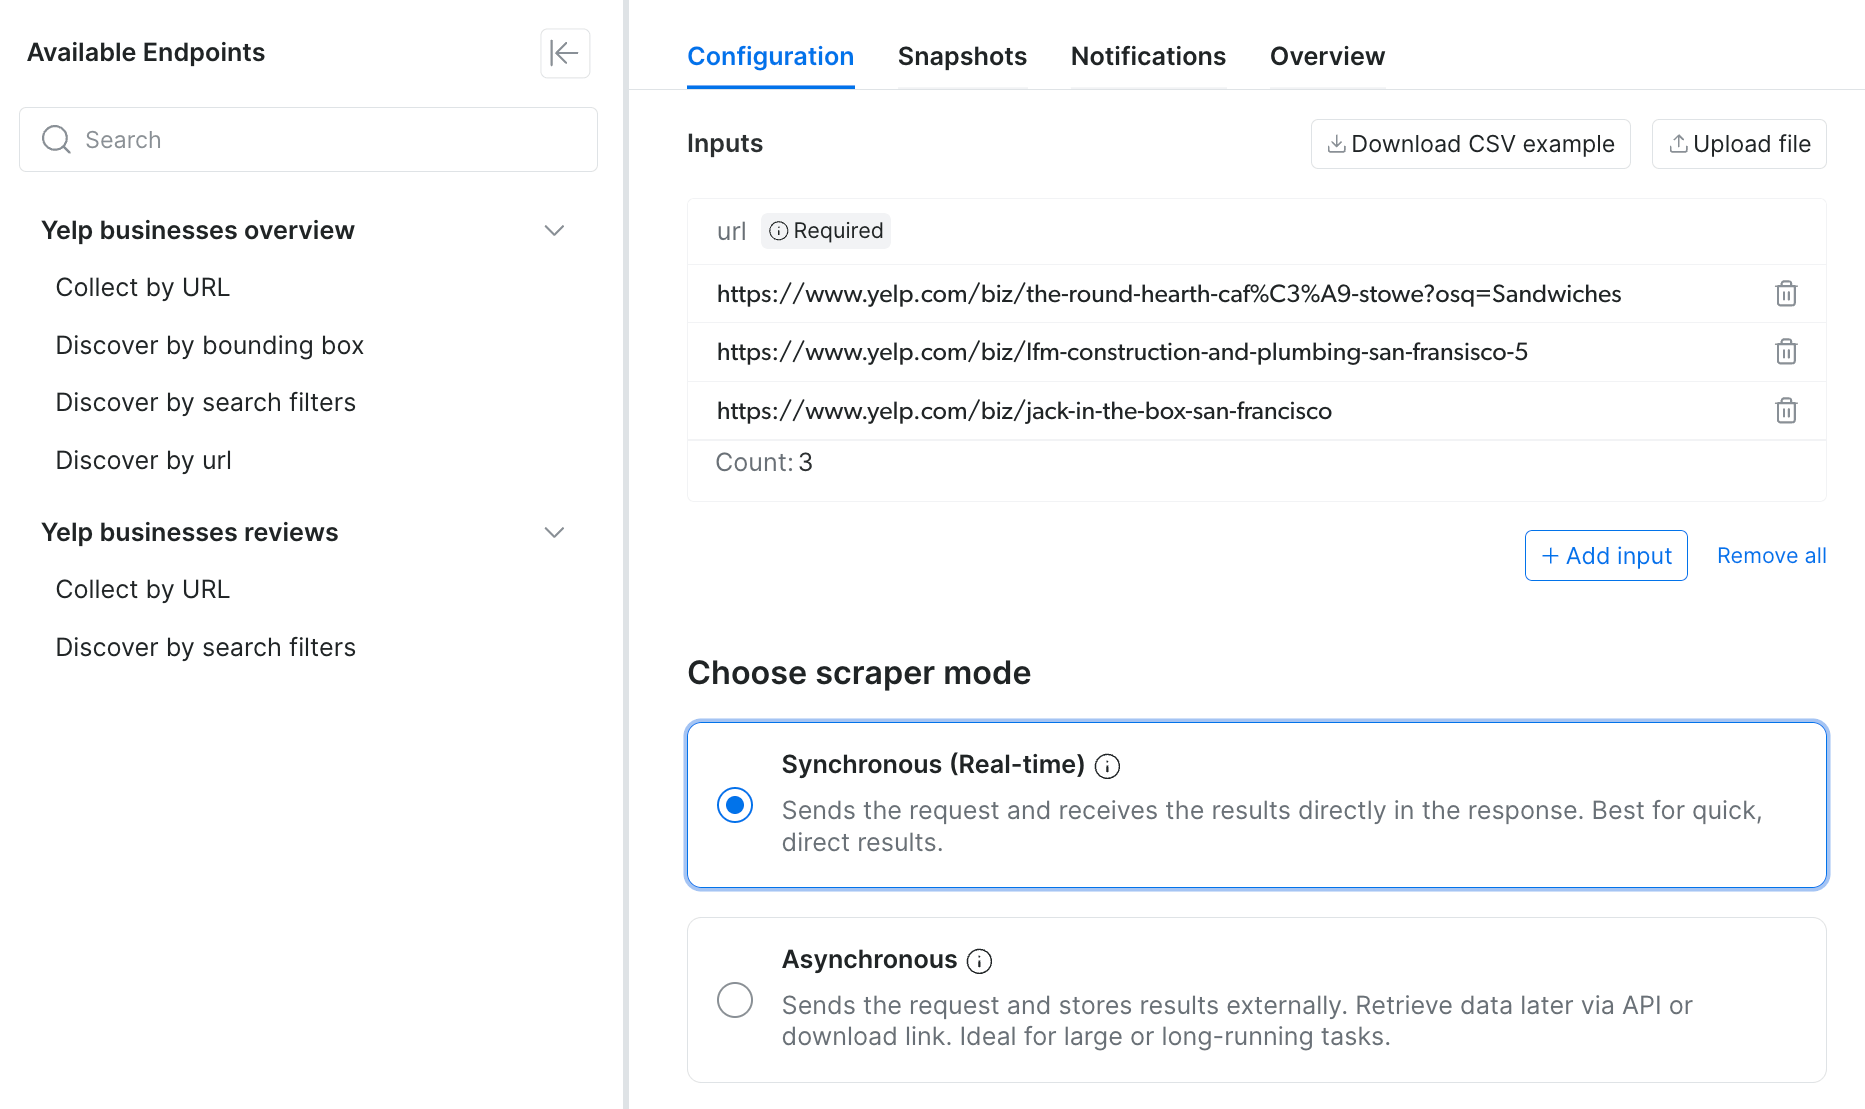
El endpoint Collect by URL para registros de negocios, con 3 entradas de ejemplo y el modo Synchronous seleccionado. Una llamada síncrona que tarda más que su límite de 1 minuto devuelve un ID de snapshot en lugar de registros, así que scraper_api.py se ejecuta de forma asíncrona.
Puedes ejecutar los mismos scrapers desde Python a través del endpoint de activación asíncrona. Guarda este script como scraper_api.py. Solo necesita BRIGHTDATA_API_KEY, porque las llamadas de la API de Scraper no usan una zona. Ejecuta una búsqueda de descubrimiento de pizza en Brooklyn, NY, y luego recopila las 20 reseñas más nuevas del primer resultado:
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}

YELP_BUSINESSES = "gd_lgugwl0519h1p14rwk"
YELP_REVIEWS = "gd_lgzhlu9323u3k24jkv"


def collect(dataset_id, inputs, limit_per_input=None, poll_every=15,
            **params):
    """Activa un trabajo de la API de Scraper, espera a que termine, y devuelve sus registros."""
    body = {"input": inputs}
    if limit_per_input:
        body["limit_per_input"] = limit_per_input
    r = requests.post(
        f"{API}/trigger",
        headers=HEADERS,
        params={"dataset_id": dataset_id, "include_errors": "true",
                **params},
        json=body,
        timeout=60,
    )
    r.raise_for_status()
    snapshot_id = r.json()["snapshot_id"]

    while True:
        progress = requests.get(f"{API}/progress/{snapshot_id}",
                                headers=HEADERS, timeout=60).json()
        if progress["status"] == "ready":
            break
        if progress["status"] in ("failed", "canceled"):
            raise RuntimeError(f"{snapshot_id}: {progress}")
        time.sleep(poll_every)

    records = requests.get(f"{API}/snapshot/{snapshot_id}",
                           headers=HEADERS, params={"format": "json"},
                           timeout=120).json()
    # Con include_errors=true, las entradas fallidas se devuelven como registros de error.
    errors = [x for x in records if x.get("error")]
    rows = [x for x in records if not x.get("error")]
    return rows, errors


if __name__ == "__main__":
    rows, errors = collect(
        YELP_BUSINESSES,
        [{"country": "US", "category": "Pizza",
          "location": "Brooklyn, NY, United States"}],
        limit_per_input=5,
        type="discover_new",
        discover_by="search_filters",
    )
    for row in rows:
        print(row["name"], row["overall_rating"], row["reviews_count"],
              row["url"])
    print(f"{len(rows)} businesses, {len(errors)} errors")
    if not rows:
        raise SystemExit("discovery returned no businesses")

    reviews, errors = collect(
        YELP_REVIEWS,
        [{"url": rows[0]["url"], "unrecommended_reviews": False,
          "sort_by": "DATE_DESC"}],
        limit_per_input=20,
    )
    print(f"{len(reviews)} reviews, {len(errors)} errors")
    for r in reviews[:1]:
        print(r["date_iso_format"], r["Rating"], r["Content"][:120])
YELP_BUSINESSES y YELP_REVIEWS son los IDs de los conjuntos de datos de los scrapers de Yelp de Bright Data, mostrados en los ejemplos de API de cada scraper en el panel de control. collect() verifica el progreso de cada trabajo cada 15 segundos y devuelve sus registros una vez que el trabajo está listo. Para cada negocio descubierto, el script imprime el nombre, calificación, número de reseñas y URL. Luego imprime el número de reseñas y la fecha, calificación, y primeros 120 caracteres de texto de la primera reseña.
La API de Scraper de Yelp cobra solo por entregas exitosas. limit_per_input establece el número máximo de registros por entrada. Este script usa 5 para negocios y 20 para reseñas, así que una ejecución de prueba en un negocio con 5K reseñas no se factura por 5K registros. Las entradas que un trabajo no pudo recopilar se devuelven como registros de error que incluyen su entrada, listos para reenviar.
Configura trabajos de reseñas y mapea sus campos
Estos 3 detalles afectan qué registros devuelve un trabajo y cómo los lees:
unrecommended_reviewsseleccionaba 1 de los 2 conjuntos de reseñas. Contrue, un trabajo devolvía solo reseñas no recomendadas (recommended_review: false). Para recopilar ambos conjuntos, envía la URL del negocio una vez con cada valor. Deja vacío el rango de fechas en la entradatruepara recopilar reseñas no recomendadas de todas las fechas.- Los filtros de fecha en reseñas recomendadas coincidían con el conteo de GraphQL. Con
unrecommended_reviewsconfigurado comofalsey un rango de fechas destart_dateaend_date, el trabajo devolvió 6 reseñas. El scraper de GraphQL encontró las mismas 6 para ese rango. - Las etiquetas de reacción de Yelp cambiaron con el tiempo. Los registros recientes usaban
Helpful,Thanks,Love this, yOh no, mientras que las reseñas antiguas de Yelp usabanuseful,funny, ycool. Mapea ambos conjuntos antes de comparar reacciones entre años.
Para trabajos recurrentes, la API de Scraper de Yelp entrega a un webhook, Amazon S3, Google Cloud Storage, Google Pub/Sub, Microsoft Azure Storage, Snowflake, o SFTP.
API de Yelp, scraper, o dataset: cuánto cuestan 1K negocios
La opción correcta depende de si necesitas el texto completo de las reseñas y quién mantiene la recopilación de datos. Esta tabla muestra el costo de una sola carga de trabajo, 1K negocios con 200 reseñas cada uno, a los precios de lista cuando verificamos:
| Opción | Texto completo de reseñas | Costo para 1K negocios y 200K reseñas | Tu trabajo continuo |
|---|---|---|---|
| Yelp Places API, plan Enhanced | No, 3 extractos de unos 160 caracteres | $299 al mes, dentro de las 30K llamadas incluidas | Seguir las reglas de visualización y el límite de caché de 24 horas |
| Yelp Insights API, plan Premium | Sí | Cotización personalizada del equipo de ventas de Yelp, desde $0.08 por ubicación en base rotativa de 12 meses | Seguir los términos del contrato de Yelp |
| Tu propio scraper en Web Unlocker | Sí, reseñas recomendadas | $9 por 6K solicitudes (1K páginas de negocios y 5K llamadas GraphQL) a $1.5 por 1K | Actualizar el ID de consulta persistida, variables, y parsers cuando cambie el frontend de Yelp |
| API de Scraper de Yelp de Bright Data | Sí, recomendadas y no recomendadas | $301.50 por 201K registros a $1.5 por 1K | Gestionar listas de entrada y entrega |
| Conjuntos de datos de Yelp de Bright Data | Sí, precompilados | Hasta $502.50 por 201K registros a hasta $0.0025 por registro (pedido mínimo de $250) | Sin trabajo de recopilación, actualización mensual de datos |
La cifra de Web Unlocker es baja porque cada llamada GraphQL devolvió hasta 49 reseñas, y Web Unlocker cobra solo las solicitudes exitosas. La API de Scraper de Yelp cobra por registro, así que los trabajos con muchas reseñas cuestan más. Por ese precio, no gastas tiempo de ingeniería en parsers o IDs de consulta persistida.
El descubrimiento agrega costo con ambas opciones. En Web Unlocker, pagas por páginas de búsqueda, que mostraban 10 resultados cada una. En la API de Scraper de Yelp, pagas por registros de descubrimiento.
Los conjuntos de datos de Yelp de Bright Data funcionan bien para rellenos históricos. Incluyen más de 200M registros de reseñas y más de 9M registros de negocios. También está disponible un conjunto de datos de restaurantes de Yelp separado.
Cada página de conjunto de datos en el panel de control muestra los campos, precio, y una muestra de datos antes de la compra:
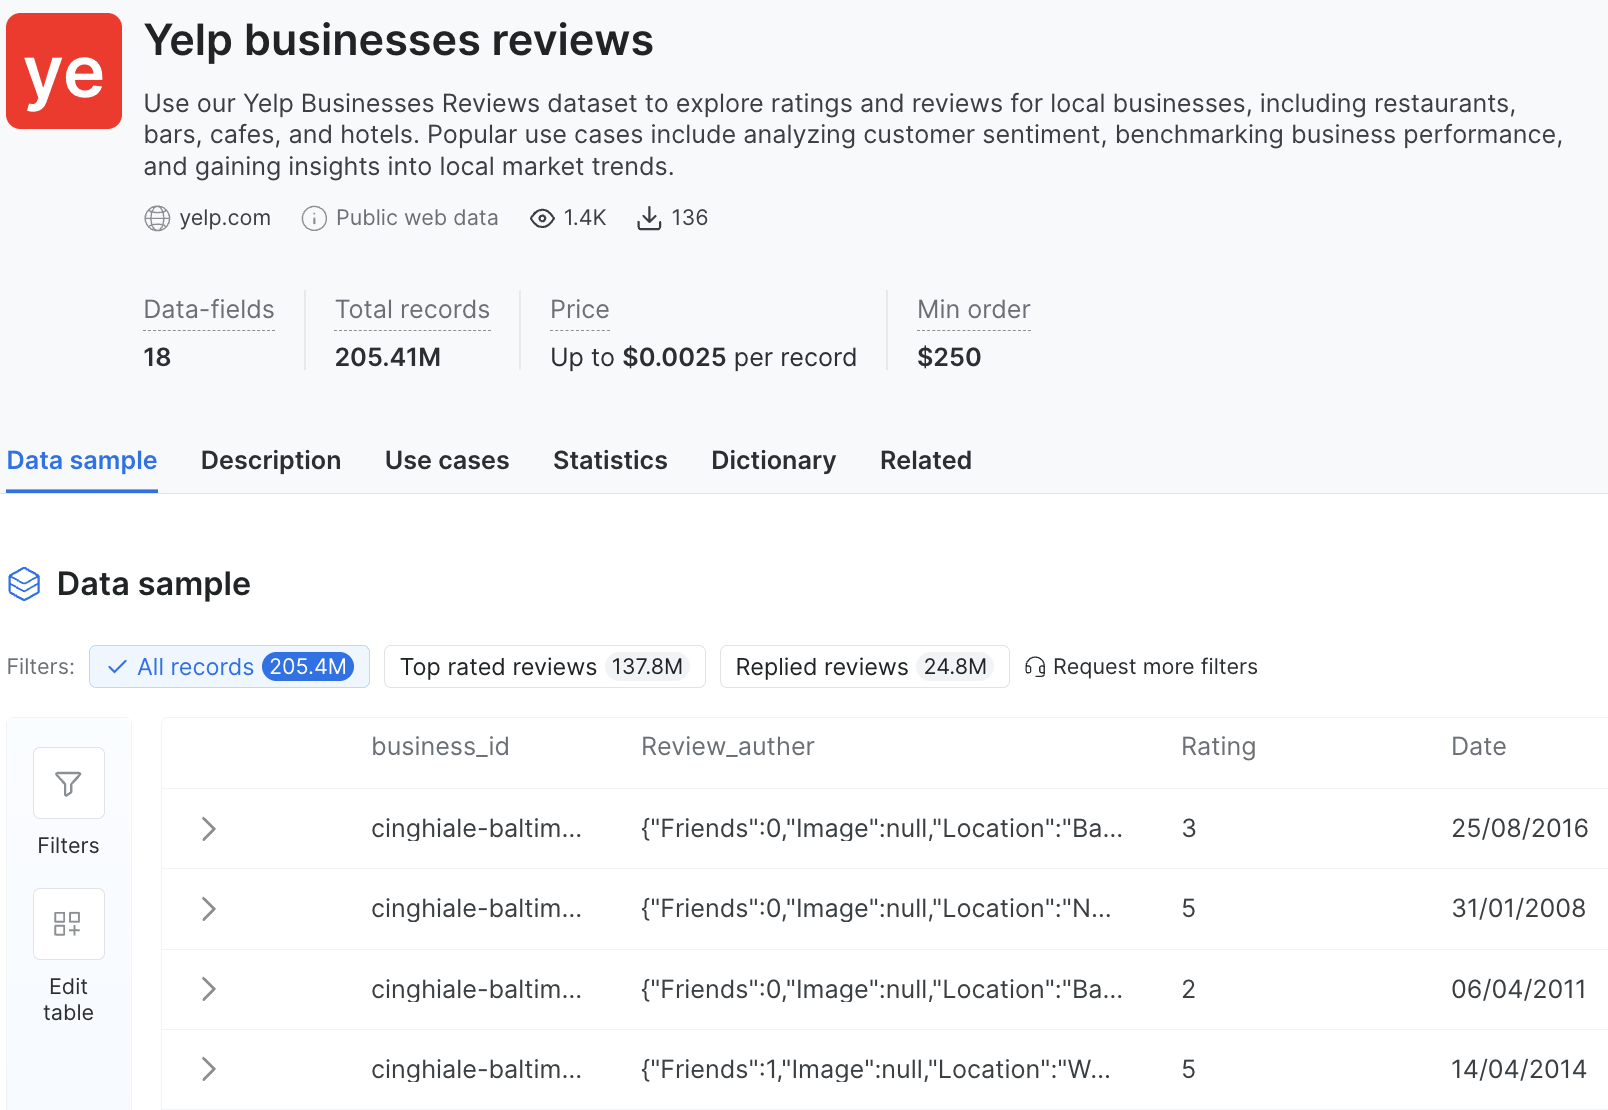
El conjunto de datos de reseñas de negocios de Yelp. A hasta $0.0025 por registro, el pedido mínimo de $250 compra al menos 100K reseñas.
Reflexiones finales
Hacer scraping de Yelp en Python funcionó en nuestras pruebas una vez que cada solicitud usaba Web Unlocker y las reseñas provenían de la API GraphQL, no del HTML. El ID de consulta persistida puede cambiar cuando Yelp despliega cambios, así que si las llamadas de reseñas comienzan a fallar, ejecuta primero refresh_doc_id.py. La API de Scraper de Yelp de Bright Data gestiona el mantenimiento del parser y agrega reseñas no recomendadas, a un precio más alto por reseña. Los conjuntos de datos de Yelp de Bright Data proporcionan datos históricos para rellenos. Comienza con el nivel gratuito de Bright Data con un negocio que conozcas, y compara el conteo de filas de yelp_scraper.py con totalCount antes de ejecutarlo en más negocios.
Preguntas frecuentes
¿Cómo se hace scraping de reseñas de Yelp?
Solicítalas desde el endpoint GraphQL de Yelp, /gql/batch, con el ID de consulta persistida GetBusinessReviewFeed, porque el HTML de la página de negocio no tenía texto completo de reseñas en nuestras pruebas. Cada llamada devolvió hasta 49 reseñas. Enruta las llamadas a través de la API Web Unlocker de Bright Data, porque DataDome, la protección antibots de Yelp, bloqueó los clientes HTTP de Python que probamos.
¿La API de Yelp da todas las reseñas?
No, no cuando lo verificamos. La documentación de Yelp listaba 3 extractos de reseñas de la Places API en Enhanced y hasta 7 en Premium, cada uno de unos 160 caracteres. El texto completo estaba disponible en el plan Premium de la Insights API de Yelp o en la API GraphQL que usa yelp.com, que devolvía reseñas recomendadas. La API de Scraper de Yelp de Bright Data también devuelve texto completo, incluyendo reseñas no recomendadas.
¿Puedo usar la API de Yelp gratis?
Solo para evaluación. La documentación de Yelp listaba 5K llamadas gratuitas de la Places API durante una prueba de 30 días, y las llamadas de prueba no eran para uso comercial. Los planes pagos comenzaban en $229 al mes para el plan Base, que no incluía extractos de reseñas ni fotos.
¿Cuánto cuesta la API Yelp Fusion?
La página de precios de Yelp listaba la Places API (también llamada Fusion) a $229 al mes para Base, $299 para Enhanced, y $643 para Premium. Cada plan incluía 30K llamadas al mes por defecto, y las llamadas extra costaban de $5.91 a $14.13 por 1K, dependiendo del plan.
¿Hay un scraper de Yelp gratuito?
Sí, los scrapers de Yelp de código abierto son gratuitos, pero en nuestras pruebas, DataDome, la protección antibots de Yelp, bloqueó los clientes HTTP de Python. El nivel gratuito de Bright Data incluye 5K créditos al mes, suficiente para 5K registros de la API de Scraper de Yelp. Las solicitudes de Web Unlocker a Yelp necesitan una cuenta con acceso completo.
¿Pueden los sitios web detectar el scraping?
Sí. Los servicios de protección antibots pueden verificar huellas TLS, IPs, y ejecución de JavaScript, y Yelp usó DataDome en nuestras pruebas. Los clientes HTTP de Python obtuvieron páginas de desafío 403 en cada solicitud de prueba, incluso con huellas TLS de navegador e IPs residenciales de EE. UU. Las 30 páginas de negocios de prueba cargaron a través de la API Web Unlocker de Bright Data.