Yahoo Finance ofrece cotizaciones gratuitas, historial de precios, estados financieros y estimaciones de analistas, pero no tiene una API oficial. Sus páginas de cotización contienen esos datos como JSON dentro del HTML, así que un pipeline de Python puede leerlos sin un navegador.
El código de muchos tutoriales antiguos fallaba de 2 formas. Con su User-Agent predeterminado, la librería requests de Python recibía 429 Too Many Requests en su primera solicitud. Cuando una solicitud tenía éxito, los selectores antiguos no coincidían con nada o mostraban el precio del S&P 500 en lugar del de la acción.
Esta guía te muestra cómo hacer scraping de Yahoo Finance desde ese JSON, evitar el 429 y mover todo a un servidor.
TL;DR
- El 429 de Yahoo en la primera solicitud depende del cliente, no de la tasa de solicitudes. Al imitar a Chrome, curl_cffi solicitó 503 páginas de cotización del S&P 500 sin recibir un 429.
- Una sola solicitud devuelve el historial de precios completo de un ticker. Con period1=0, la pestaña de datos históricos de MSFT devolvió cada barra diaria desde 1986.
- Valida cada página, incluso cuando devuelve 200. FB, el antiguo símbolo de Meta, devolvió un ETF de ProShares, y el precio londinense de Vodafone estaba en peniques.
- Muévete a un servidor cambiando la función de fetch. La API Web Unlocker de Bright Data agrega rotación de IP y reintentos automáticos. O la API Scraper de Yahoo Finance de Bright Data devuelve registros estructurados.
Dónde guarda Yahoo Finance sus datos
Los números de una página de cotización están incrustados como JSON dentro de su HTML. Yahoo renderiza las páginas en el servidor con SvelteKit, un framework de JavaScript, y llama a sus propias API JSON durante el renderizado. SvelteKit incrusta cada respuesta en el HTML, para que el navegador pueda reutilizarla sin volver a solicitarla. Cada respuesta está en su propia etiqueta script, que tiene un atributo data-sveltekit-fetched y la URL de la API de origen en data-url.
Una etiqueta de la pestaña de resumen de MSFT se ve así, con su cuerpo JSON acortado:
<script type="application/json" data-sveltekit-fetched
data-url="https://query1.finance.yahoo.com/v1/finance/quoteType/MSFT?formatted=true&enablePrivateCompany=true&overnightPrice=true&lang=en-US&region=US"
data-hash="1ibomen" data-ttl="1800">
{"status":200,"statusText":"","headers":{"cache-control":"public, max-age=1800, stale-while-revalidate=1800"},"body":"{\"quoteType\":{\"result\":[{\"symbol\":\"MSFT\",\"quoteType\":\"EQUITY\",\"exchange\":\"NMS\",\"longName\":\"Microsoft Corporation\"}],\"error\":null}}"}
</script>El campo body contiene la respuesta de la API como una cadena JSON. Parsear una etiqueta necesita 2 llamadas a json.loads(). La primera llamada parsea el envoltorio, y la segunda parsea la cadena body. Cada pestaña de una página de cotización incrusta un conjunto distinto de respuestas de API:
| Pestaña | Respuesta de API incrustada | Qué puedes leer de ella |
|---|---|---|
/quote/MSFT/ |
v10/finance/quoteSummary y v7/finance/spark |
Precio, capitalización de mercado, P/E, dividendo, rango de 52 semanas, objetivos de precio de analistas, hasta 24 horas de cierres de 5 minutos |
/quote/MSFT/history/ |
v8/finance/chart |
Precios diarios, semanales o mensuales, cierre ajustado, splits, dividendos |
/quote/MSFT/financials/, balance-sheet/, cash-flow/ |
ws/fundamentals-timeseries |
Partidas anuales y de los últimos 12 meses |
/quote/MSFT/analysis/ |
v10/finance/quoteSummary con earningsTrend |
Estimaciones de EPS e ingresos, cantidad de analistas, sorpresas de ganancias |
/quote/MSFT/key-statistics/ |
ws/fundamentals-timeseries |
Capitalización de mercado trimestral, valor empresarial y ratios de valoración |
/quote/MSFT/profile/ |
v10/finance/quoteSummary con assetProfile |
Ejecutivos clave, número de empleados, sector, presentaciones ante la SEC |
/quote/MSFT/holders/ |
v10/finance/quoteSummary con módulos de propiedad |
Tenedores institucionales, de fondos y de información privilegiada |
/quote/MSFT/options/ |
v7/finance/options |
La cadena de opciones para el vencimiento más cercano, además de la lista de fechas de vencimiento |
Los hosts de API de Yahoo, query1.finance.yahoo.com y query2.finance.yahoo.com, sirven el mismo JSON, y la librería de código abierto yfinance los llama directamente. En esos hosts, los endpoints de quote, quoteSummary y options devolvieron 401 cuando una solicitud no tenía crumb. Un crumb es un token que Yahoo emite con cada cookie de sesión y espera como parámetro de consulta crumb=.
La antigua descarga CSV devolvió 401 User is not logged in. En ambos hosts de API, robots.txt prohíbe cada ruta (Disallow: /). Las respuestas incrustadas en la página de cotización no necesitan cookie, crumb ni acceso al host de API:
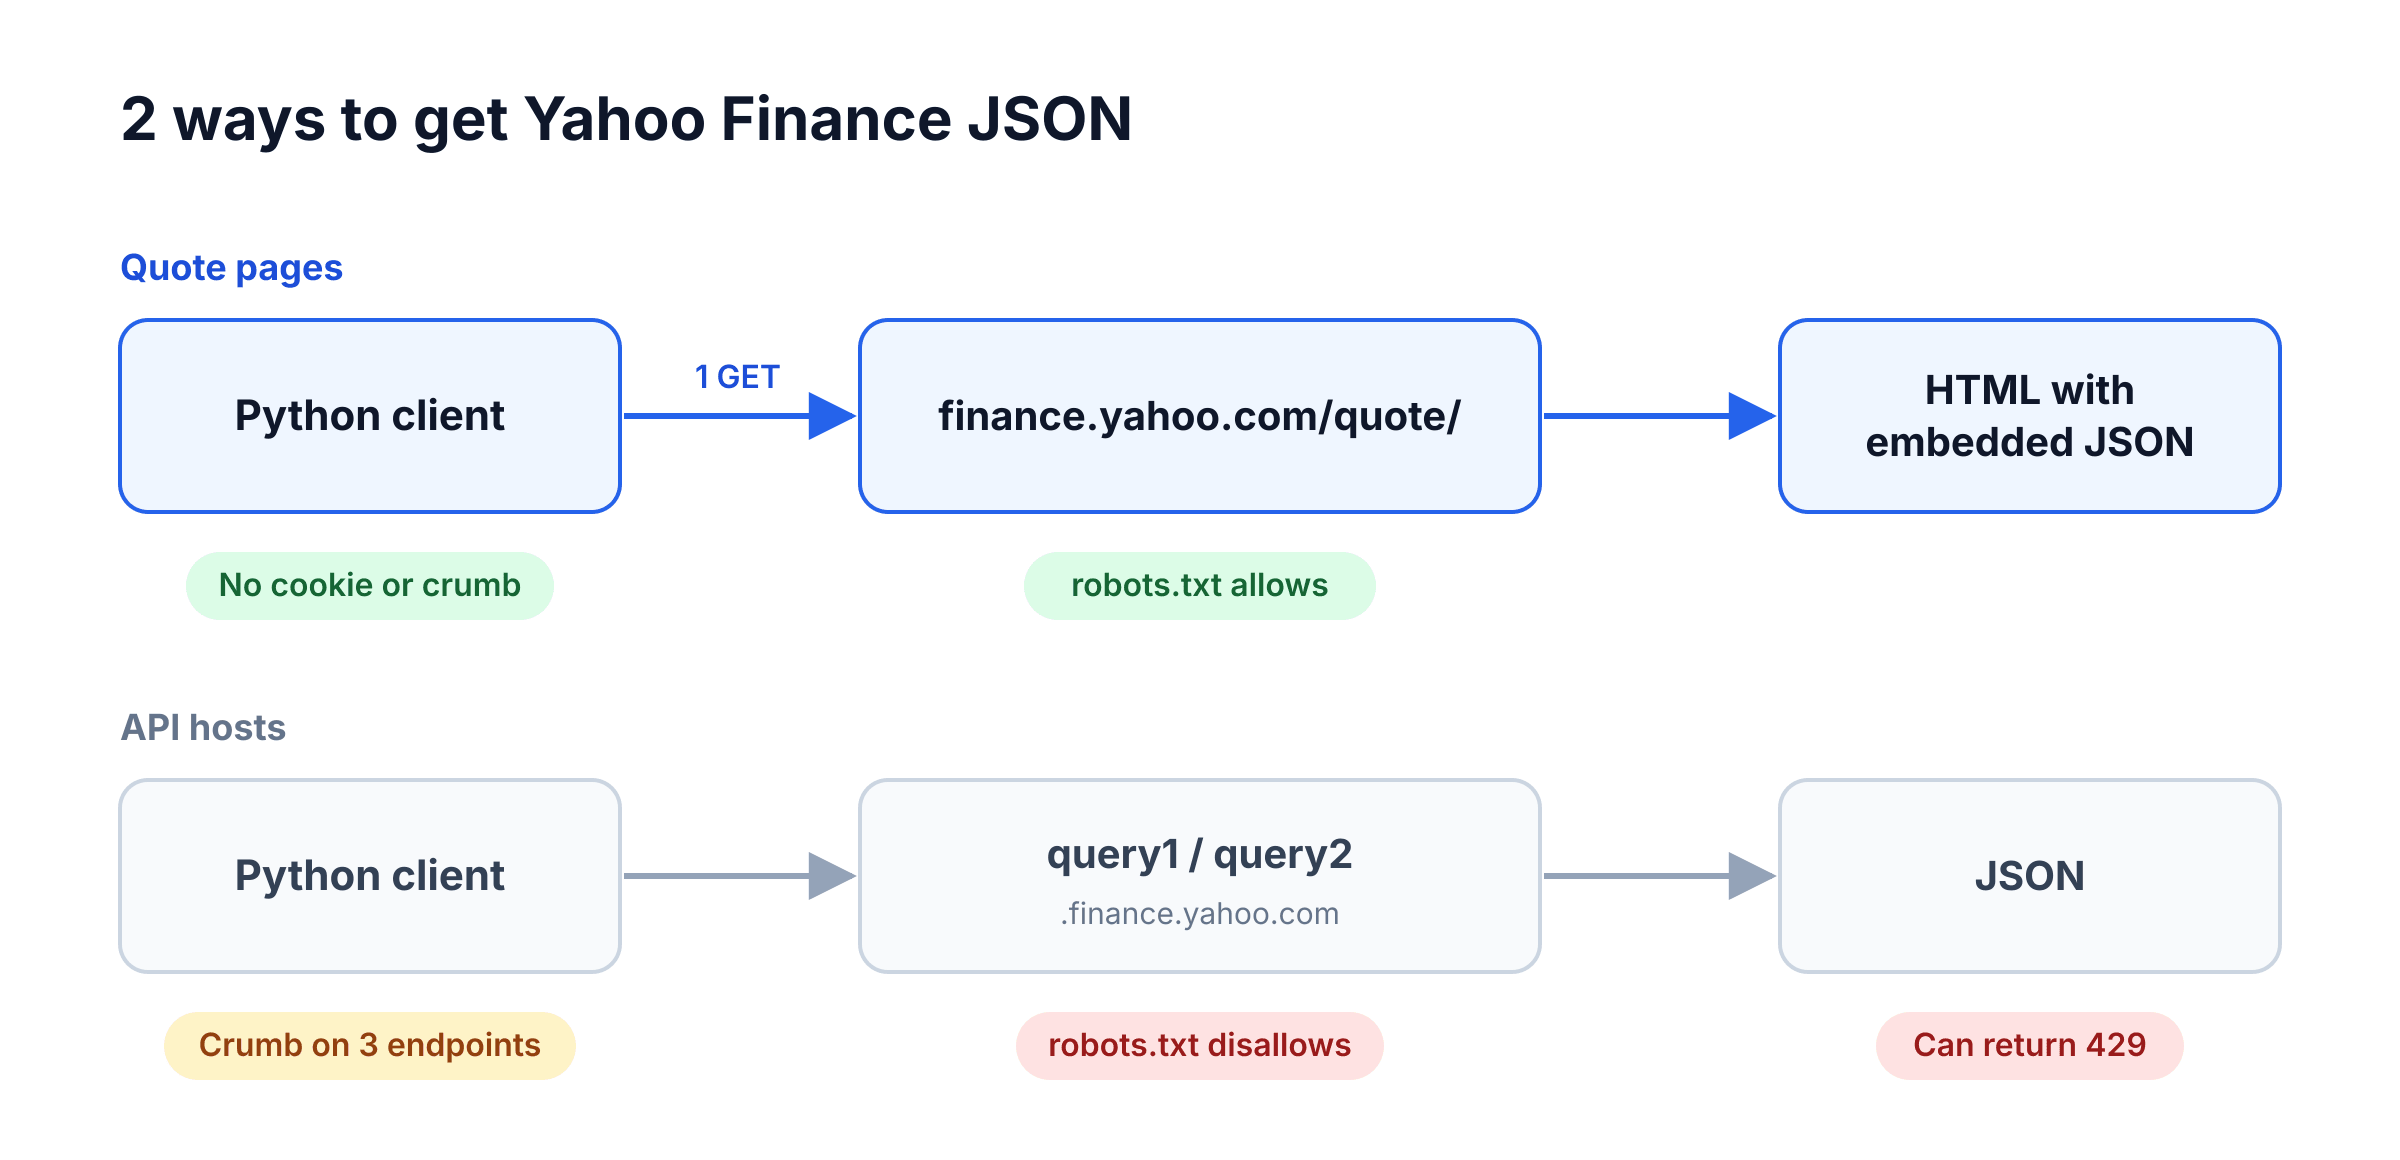
Los scripts solo leen las páginas de cotización, así que nunca llaman a los hosts de API.
Muchos tutoriales antiguos leen precios con selectores CSS que ya no funcionan. En la página de MSFT, [data-symbol="MSFT"][data-field="regularMarketPrice"] y #quote-summary [data-test="PREV_CLOSE-value"] no coincidieron con ningún elemento. El selector menos específico fin-streamer[data-field="regularMarketPrice"] coincidió con 9, y la primera coincidencia contenía el precio del S&P 500 del resumen de mercado de la página.
Otros tutoriales automatizan un navegador. El JSON incrustado hace innecesario un navegador para cotizaciones, historial diario, estados anuales y estimaciones, porque 1 solicitud HTTP por pestaña devuelve los mismos datos.
Si usas un navegador, lee la respuesta HTML cruda, porque el código del lado del cliente de SvelteKit elimina cada etiqueta script después de leerla. En 2 de 4 cargas de página de prueba, page.content() devolvió la página sin las etiquetas. En 1 de esos casos, el scraper leyó la página justo cuando se disparó DOMContentLoaded.
Por qué Yahoo Finance puede devolver 429 en la primera solicitud
Las respuestas de Yahoo dependían del User-Agent del cliente y del handshake TLS, así que un cliente puede recibir un 429 en su primera solicitud. El encabezado server: ATS en las respuestas identifica Apache Traffic Server. Con su configuración predeterminada, la librería requests de Python recibió un 429 en su primera solicitud. Las respuestas 429 tenían 2 formas:
- Con el User-Agent predeterminado
python-requests/2.34.2, cada stack TLS de la tabla siguiente recibió una respuesta de 23 bytesEdge: Too Many Requests. La librería requests de Python obtuvo la misma respuesta enfinance.yahoo.com. - En los hosts de API, algunos User-Agent de navegador sobre el stack TLS de Python recibieron una respuesta de 19 bytes
Too Many Requests.
La tabla muestra cómo query1, el host de API que usa yfinance, respondió a solicitudes de gráficos enviadas desde 1 conexión residencial con al menos 1.5 segundos de separación. La librería curl_cffi, un cliente HTTP de Python, puede imitar el handshake TLS de un navegador. Cada fila combina un stack TLS con un encabezado User-Agent:
| Stack TLS | Encabezado User-Agent | Recibió 429 |
|---|---|---|
| Python requests (OpenSSL) | python-requests/2.34.2, el predeterminado |
5 de 5 |
| Python requests (OpenSSL) | Chrome 140 en macOS | 26 de 26 |
| Python requests (OpenSSL) | Firefox 147 en Windows | 16 de 17 |
| Python requests (OpenSSL) | Safari 26 en macOS | 8 de 11 |
| Python requests (OpenSSL) | Chrome 150 en macOS | 3 de 6 |
| Python requests (OpenSSL) | Chrome 150 en Windows | 0 de 11 |
| Python requests (OpenSSL) | Mozilla/5.0 solo |
0 de 11 |
| curl_cffi (handshake de Chrome, Firefox o Safari) | Chrome 140 o 150, Firefox 147, Safari 26, o Mozilla/5.0 |
0 de 80 |
| curl_cffi (mismos 3 handshakes) | python-requests/2.34.2 |
15 de 15 |
¿Por qué importa el handshake TLS?
La respuesta de Yahoo dependía del stack TLS, incluso cuando el User-Agent era el mismo. En una prueba controlada, requests y curl_cffi enviaron el mismo User-Agent (Chrome 140 en macOS) y el mismo encabezado Accept sobre HTTP/1.1 desde la misma dirección IP. Solo cambió el cliente HTTP y su stack TLS. A través de la librería requests de Python, 0 de 8 solicitudes tuvieron éxito, y a través del stack TLS de Chrome de curl_cffi, 8 de 8 lo tuvieron.
Los 2 stacks ya difieren antes de enviar cualquier encabezado. Una huella JA4, una forma común de fingerprinting TLS, resume el ClientHello, el primer mensaje que un cliente envía en un handshake TLS. El handshake OpenSSL de Python produjo t13d1812h1_85036bcba153_b26ce05bbdd6, y el objetivo chrome de curl_cffi produjo t13d1516h2_8daaf6152771_806a8c22fdea, que coincide con los conjuntos de cifrado de Chrome. Solicita https://tls.peet.ws/api/all desde tu propio cliente para ver qué envía.
Cada resultado dependía de la combinación de stack TLS y User-Agent. La cadena Mozilla/5.0 sola tuvo éxito 11 de 11 veces sobre el TLS de Python. Chrome 140 en macOS falló 26 de 26 veces, y Firefox 147 falló 16 de 17 veces. Así que un User-Agent de navegador realista puede hacer que la librería requests de Python falle más seguido.
Con un handshake TLS de navegador de curl_cffi, los User-Agent de navegador de la tabla tuvieron éxito en 80 de 80 solicitudes. En una prueba más pequeña, finance.yahoo.com mismo aceptó la cadena Chrome 140 sobre el TLS de Python y bloqueó la cadena predeterminada de python-requests. El código del scraper usa curl_cffi también en finance.yahoo.com, así que el User-Agent y el handshake TLS coinciden con Chrome.
Si envías un User-Agent de navegador, envía también un handshake TLS de navegador.
¿Importa la tasa de solicitudes?
No para los 429 en primeras solicitudes, que dependen del cliente. Con 8 hilos, curl_cffi solicitó las 503 páginas de cotización del S&P 500, luego 501 páginas de datos históricos, sin un 429. Ese es el volumen de una actualización diaria del S&P 500. Si aparece un 429 con mayor volumen, el código del scraper espera y reintenta.
Un fragmento de limitación de tasa publicado en el rastreador de problemas de yfinance limita el tráfico a 60 solicitudes por minuto, 360 por hora, y 8,000 por día. Esas cifras provienen de la página de límites de tasa de la API de tráfico DSP de Yahoo. Yahoo DSP es una plataforma de demanda para comprar anuncios, así que el fragmento usa los límites de otro producto.
La librería yfinance también recibió errores 429 de Yahoo, que generaba como YFRateLimitError('Too Many Requests. Rate limited. Try after a while.'). Después de que un hilo sobre errores 429 recibiera más de 140 comentarios, los mantenedores de yfinance adoptaron la misma solución: un handshake TLS de navegador. La versión 0.2.58 (2025) movió la librería a curl_cffi, y la versión 1.7.0 crea su sesión predeterminada con impersonate="chrome".
¿Funciona el código desde un servidor en la nube?
Sí, en 3 ejecutores de GitHub Actions con direcciones IP de Microsoft Azure. En cada ejecutor, la primera solicitud de curl_cffi devolvió una página de cotización para cada uno de 20 símbolos, desde acciones y ETF de EE. UU. hasta criptomonedas y listados extranjeros. En una segunda ejecución, cada ejecutor solicitó las 503 páginas de cotización del S&P 500 sin un 429.
Los scripts devolvieron el mismo historial, estados y estimaciones que desde casa. En los ejecutores, la librería requests de Python con su User-Agent predeterminado recibió la misma respuesta 429 de 23 bytes, mientras que yfinance obtuvo el historial diario completo de MSFT.
Los fallos reportados en la nube involucraban clientes antiguos y rangos de IP compartidos, así que prueba los scripts desde tu propio servidor antes de programar un trabajo. En 2025, antes de que yfinance migrara a curl_cffi, sus mantenedores eliminaron su trabajo de prueba de GitHub Actions después de que fallara al obtener datos de Yahoo. Otro desarrollador rastreó respuestas 401 “Invalid Crumb” hasta el rango de IP compartido del nivel gratuito de Render, una plataforma en la nube. Las mismas llamadas funcionaron desde una IP residencial.
Extrae el JSON incrustado de una página de cotización
Necesitas Python 3.11 o posterior y 5 paquetes. El código se probó en Python 3.11, 3.13 y 3.14 con curl_cffi 0.16.3, beautifulsoup4 4.15.0, lxml 6.1.3, pandas 3.0.6, y requests 2.34.2. Instálalos con pip:
pip install curl_cffi beautifulsoup4 lxml pandas requestsPara conceptos básicos de scraping con Python, consulta nuestra guía de scraping web con Python. El módulo central obtiene una sola pestaña, verifica que Yahoo devolvió una página de cotización, y devuelve las respuestas incrustadas indexadas por su URL de API. Guárdalo como yahoo_embedded.py, porque los scripts que leen las páginas de Yahoo dependen de él:
import json
import random
import threading
import time
from urllib.parse import quote

from bs4 import BeautifulSoup
from curl_cffi import requests

QUOTE_URL = "https://finance.yahoo.com/quote"
_local = threading.local()


class SymbolNotFound(Exception):
    """Yahoo devolvió su página de búsqueda o un soft 404 en lugar de una página de cotización."""


def page_url(symbol: str, tab: str = "") -> str:
    return (
        f"{QUOTE_URL}/{quote(symbol.upper(), safe='')}/{tab}"  # ^GSPC se convierte en %5EGSPC
    )


def embedded(html: str) -> dict[str, dict]:
    """Mapea las URL de API desde las que se renderizó la página a sus cuerpos JSON."""
    soup = BeautifulSoup(html, "lxml")
    found = {}
    for tag in soup.select('script[type="application/json"][data-sveltekit-fetched]'):
        try:
            wrapper = json.loads(tag.string)
            found[tag["data-url"]] = json.loads(wrapper["body"])
        except (TypeError, KeyError, ValueError):
            continue  # una respuesta incrustada cuyo cuerpo no es JSON
    return found


def pick(found: dict[str, dict], path: str) -> dict:
    """Devuelve la primera respuesta incrustada cuya URL contiene `path`."""
    for url, body in found.items():
        if path in url:
            return body
    raise LookupError(f"no hay respuesta incrustada para {path}")


def is_quote_page(html: str, symbol: str) -> bool:
    """True para una página de cotización, False en otro caso, SymbolNotFound para un símbolo desconocido."""
    found = embedded(html)
    if any("/v1/finance/lookup" in url for url in found):
        raise SymbolNotFound(symbol)
    for url, body in found.items():
        if "/v1/finance/quoteType/" in url:
            result = (body.get("quoteType") or {}).get("result") or [{}]
            if not result[0].get("exchange"):
                # Un soft 404, como con BRK.B (Yahoo lo escribe BRK-B)
                raise SymbolNotFound(symbol)
            return True
    return False


def _session() -> requests.Session:
    # Una sesión imitando Chrome por hilo, como recomienda curl_cffi.
    if not hasattr(_local, "session"):
        _local.session = requests.Session(impersonate="chrome")
    return _local.session


def fetch_page(
    symbol: str, tab: str = "", params: dict | None = None, attempts: int = 4
) -> str:
    """Devuelve el HTML de una página de cotización, por ejemplo tab="history/"."""
    for attempt in range(attempts):
        if attempt:
            time.sleep(2**attempt + random.random())  # espera antes de cada reintento
        try:
            response = _session().get(
                page_url(symbol, tab), params=params, timeout=30, allow_redirects=False
            )
        except requests.RequestException:
            continue  # timeout o conexión interrumpida
        if response.is_redirect:
            location = response.headers.get("location", "")
            if "/lookup" in location:
                raise SymbolNotFound(symbol)
            # Por ejemplo, una pestaña que no existe
            raise LookupError(f"{symbol} {tab}: Yahoo redirigió a {location}")
        if response.status_code == 200 and is_quote_page(response.text, symbol):
            return response.text
        if 400 <= response.status_code < 500 and response.status_code != 429:
            response.raise_for_status()
    # Cada intento agotó el tiempo o recibió 429, 5xx, o una página sin datos de cotización
    raise RuntimeError(f"{symbol} {tab}: sin datos de cotización tras {attempts} intentos")


if __name__ == "__main__":
    from urllib.parse import urlsplit

    found = embedded(fetch_page("MSFT"))
    print(len(found), "respuestas incrustadas")
    for url in found:
        if url.startswith("https://"):
            print(urlsplit(url).netloc, urlsplit(url).path)
El módulo maneja 3 casos especiales:
allow_redirects=Falsedetiene al cliente en una redirección en lugar de seguirla. Un 302 a/lookup/significa un símbolo desconocido, así que el módulo lanzaSymbolNotFound. No obtiene la página de búsqueda, que robots.txt prohíbe. Cualquier otra redirección, como una pestaña que un ETF no tiene, lanzaLookupErroren el primer intento.is_quote_page()verifica la respuestaquoteType, porque un estado 200 por sí solo no prueba que la página tenga datos. Las 11 pestañas de MSFT la incrustaron, incluyendonews/. UnquoteTypesin un exchange significa un soft 404, una página con estado 200 pero sin datos de cotización. Yahoo devolvió ese tipo de página paraBRK.B, porque escribe el símbolo comoBRK-B.quote(symbol.upper(), safe='')pone el símbolo en mayúsculas y codifica con porcentaje símbolos de índices como^GSPC, porque^no es un carácter de URL válido hasta que se codifica.
Para MSFT, el módulo lista las API de Yahoo que la página llama:
23 embedded responses
query1.finance.yahoo.com /ws/obi-integration/v1/premiumTiersMeta
query1.finance.yahoo.com /v1/finance/quoteType/MSFT
query1.finance.yahoo.com /v7/finance/spark
query1.finance.yahoo.com /v6/finance/quote/marketSummary
query1.finance.yahoo.com /v7/finance/quote
query1.finance.yahoo.com /v7/finance/quote
query1.finance.yahoo.com /v6/finance/recommendationsbysymbol/MSFT
query1.finance.yahoo.com /v6/finance/markettime
query1.finance.yahoo.com /v7/finance/spark
query1.finance.yahoo.com /v10/finance/quoteSummary/MSFT
query1.finance.yahoo.com /v1/finance/trending/US
query1.finance.yahoo.com /v7/finance/quote
query1.finance.yahoo.com /v1/finance/screener/predefined/saved
Las estadísticas de la pestaña de resumen provienen de v10/finance/quoteSummary, que contenía unos 223 KB de JSON en 17 módulos para MSFT. El listado muestra las 13 URL absolutas de API, y las otras 10 respuestas provinieron de los propios endpoints /xhr/ de Yahoo. La mayoría de las 23 proveen datos para widgets de la página, como tickers en tendencia y resúmenes de mercado. El conteo varía: desde ejecutores en la nube de EE. UU., la misma página incrustó 26 respuestas, y las adicionales incluyeron price-insights.
Parsea los campos de precio, valoración y calificación
Muchos números dentro de quoteSummary son pares {"raw": 516.17, "fmt": "516.17"}, así que una función auxiliar conserva el valor crudo. Esta función devuelve 20 campos de cotización. Guárdala como quote_summary.py, porque los scripts de estimaciones y de lote la reutilizan:
import json

from yahoo_embedded import embedded, fetch_page, pick


def raw(module: dict, key: str):
    """Muchos números son pares {"raw": 516.17, "fmt": "516.17"}. Conserva el valor crudo."""
    value = module.get(key)
    return value.get("raw") if isinstance(value, dict) else value


def quote_summary(symbol: str, fetch=fetch_page) -> dict:
    found = embedded(fetch(symbol))
    result = pick(found, "/v10/finance/quoteSummary/")["quoteSummary"]["result"][0]
    price = result.get("price", {})
    detail = result.get("summaryDetail", {})
    stats = result.get("defaultKeyStatistics", {})
    analysts = result.get("financialData", {})
    return {
        "symbol": price.get("symbol"),
        "name": price.get("longName") or price.get("shortName"),
        "quote_type": price.get("quoteType"),
        "currency": price.get("currency"),
        "price": raw(price, "regularMarketPrice"),
        "change_pct": raw(price, "regularMarketChangePercent"),
        "market_time": raw(price, "regularMarketTime"),
        "market_state": price.get("marketState"),
        "delay_minutes": price.get("exchangeDataDelayedBy"),
        "market_cap": raw(price, "marketCap"),
        "trailing_pe": raw(detail, "trailingPE"),
        "forward_pe": raw(detail, "forwardPE"),
        "dividend_yield": raw(detail, "dividendYield"),
        "beta": raw(detail, "beta"),
        "week52_low": raw(detail, "fiftyTwoWeekLow"),
        "week52_high": raw(detail, "fiftyTwoWeekHigh"),
        "eps_ttm": raw(stats, "trailingEps"),
        "target_mean": raw(analysts, "targetMeanPrice"),
        "recommendation": analysts.get("recommendationKey"),
        "reporting_currency": analysts.get("financialCurrency"),
    }


if __name__ == "__main__":
    print(json.dumps(quote_summary("MSFT"), indent=2))
Para MSFT, la función imprimió valores crudos de los 20 campos tras un cierre de mercado:
{
  "symbol": "MSFT",
  "name": "Microsoft Corporation",
  "quote_type": "EQUITY",
  "currency": "USD",
  "price": 516.17,
  "change_pct": 0.0366316,
  "market_time": 1790366401,
  "market_state": "CLOSED",
  "delay_minutes": 0,
  "market_cap": 3832843862016,
  "trailing_pe": 28.739979,
  "forward_pe": 21.801512,
  "dividend_yield": 0.0076,
  "beta": 1.108,
  "week52_low": 349.2,
  "week52_high": 553.72,
  "eps_ttm": 17.96,
  "target_mean": 577.26135,
  "recommendation": "strong_buy",
  "reporting_currency": "USD"
}
La pestaña de resumen mostró los mismos números formateados, como una capitalización de mercado de 3.833T, un P/E de 28.74, y un rendimiento de dividendo del 0.76%:
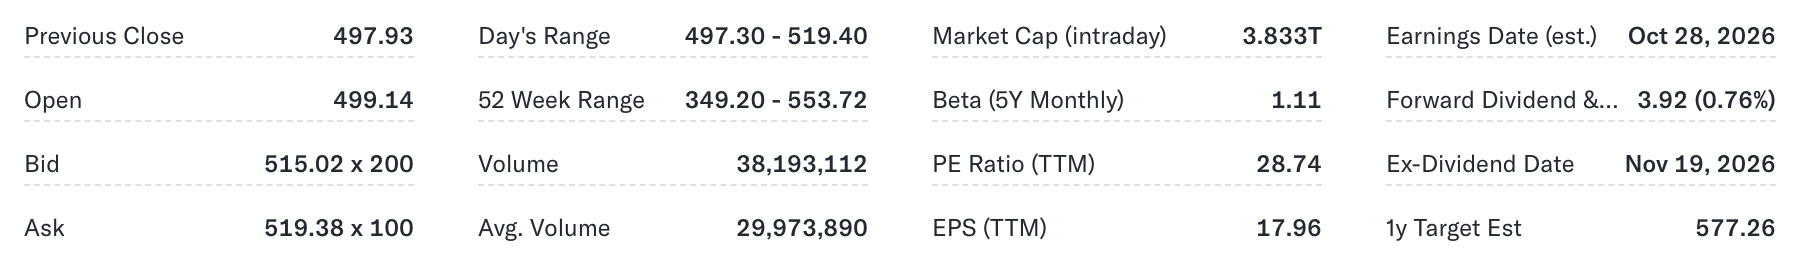
El JSON contiene en cambio los valores crudos, como 3832843862016 para la capitalización de mercado de 3.833T.
En los valores crudos, los porcentajes son fracciones, así que un change_pct de 0.0366316 es un movimiento del 3.66%, y un dividend_yield de 0.0076 es 0.76%. La función lee cada módulo con .get() porque los módulos incrustados difieren según el tipo de activo. SPY, ^GSPC, BTC-USD, y EURUSD=X devolvieron todos precios sin el módulo financialData, así que sus campos de analistas fueron None. SPY incluyó en cambio fundProfile y topHoldings.
Descarga el historial de precios completo en 1 solicitud
La pestaña de datos históricos (history/) pasa los parámetros period1, period2, y frequency desde su propia URL a la solicitud de gráfico que incrusta. Ambos parámetros de periodo son marcas de tiempo Unix, así que un period1 de 0 solicita cada barra desde el 1 de enero de 1970. El selector de fecha entonces inicia en esa fecha, y frequency=1d muestra filas diarias:
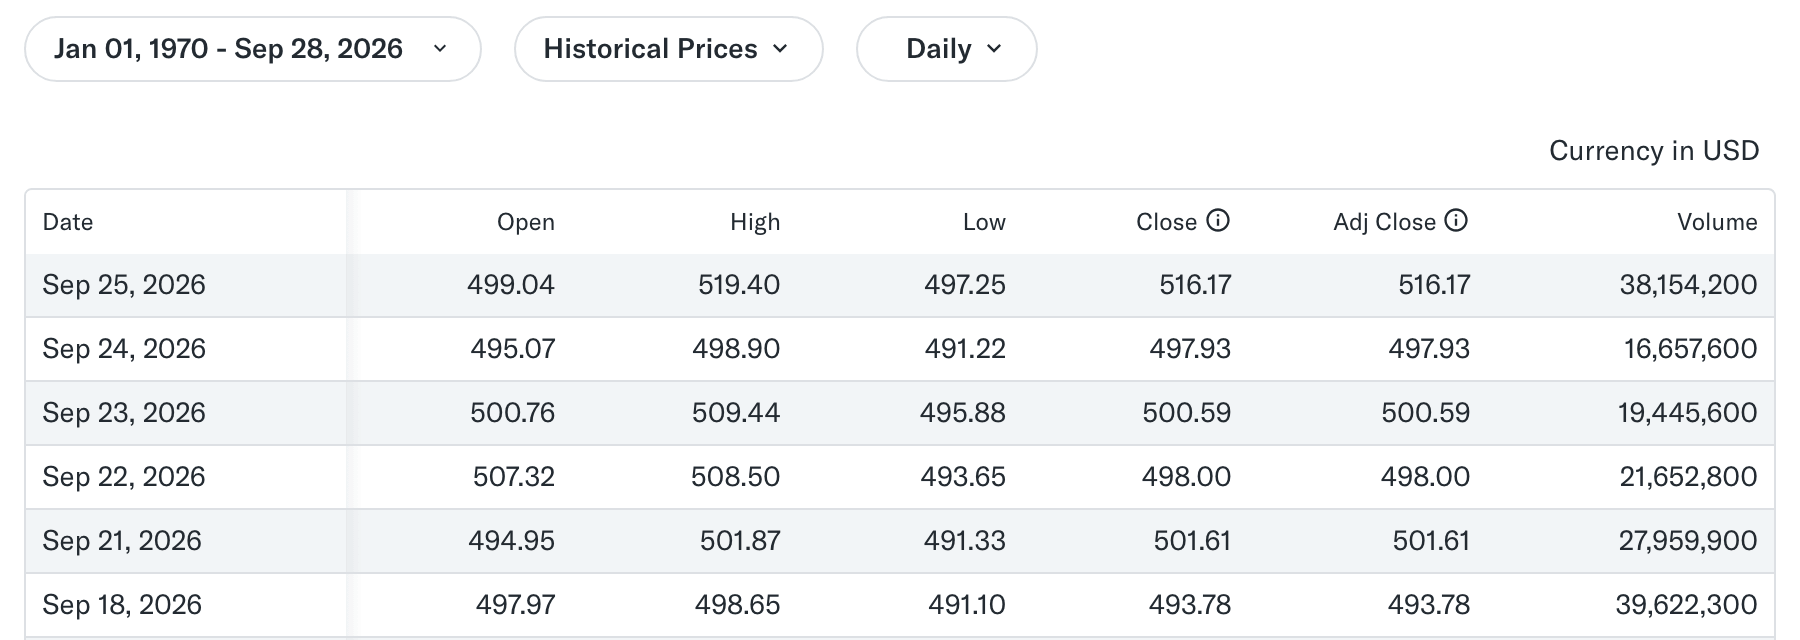
La fila más reciente de la tabla coincide con la última fila que imprime price_history() a continuación.
La función price_history() convierte la respuesta de gráfico incrustada en un DataFrame indexado por fechas en la zona horaria del exchange. Guárdala como price_history.py:
import time

import pandas as pd

from yahoo_embedded import embedded, fetch_page, pick


def price_history(
    symbol: str, frequency: str = "1d", fetch=fetch_page
) -> tuple[pd.DataFrame, dict]:
    """Cada barra desde 1970 en 1d, 1wk o 1mo, además de eventos de splits y dividendos."""
    params = {"period1": 0, "period2": int(time.time()), "frequency": frequency}
    found = embedded(fetch(symbol, "history/", params))
    result = pick(found, "/v8/finance/chart/")["chart"]["result"][0]
    bars, meta = result["indicators"]["quote"][0], result["meta"]
    utc = pd.to_datetime(result["timestamp"], unit="s", utc=True)
    index = utc.tz_convert(meta["exchangeTimezoneName"]).tz_localize(None).normalize()
    frame = pd.DataFrame(
        {
            "open": bars["open"],
            "high": bars["high"],
            "low": bars["low"],
            "close": bars["close"],
            "adj_close": result["indicators"]["adjclose"][0]["adjclose"],
            "volume": bars["volume"],
        },
        index=index,
    )
    if frequency != "1d" and result["timestamp"][-1] == meta.get("regularMarketTime"):
        frame = frame.iloc[:-1]  # Yahoo añade la sesión más reciente como una barra extra
    return frame.dropna(how="all"), result.get("events", {})


if __name__ == "__main__":
    history, events = price_history("MSFT")
    print(history.tail(3).round(2).to_string())
    print(
        f"{len(history):,} barras diarias de {history.index[0]:%Y-%m-%d} "
        f"a {history.index[-1]:%Y-%m-%d}"
    )
    splits = sorted(
        pd.Timestamp(s["date"], unit="s").date()
        for s in events.get("splits", {}).values()
    )
    if splits:
        print(f"{len(splits)} splits, el último el {splits[-1]}")
Una sola solicitud devolvió el historial completo de MSFT:
              open    high     low   close  adj_close    volume
2026-09-23  500.76  509.44  495.88  500.59     500.59  19445600
2026-09-24  495.07  498.90  491.22  497.93     497.93  16657600
2026-09-25  499.04  519.40  497.25  516.17     516.17  38154200
10,213 daily bars from 1986-03-13 to 2026-09-25
9 splits, the last one on 2003-02-18
A través del host de API, yfinance devolvió las mismas 10,213 barras para ese rango. Maneja estos 5 detalles en un pipeline de historial:
- En las pruebas, el historial no comenzó antes de 1970. La página de ayuda de Yahoo sobre datos históricos dice que los precios normalmente no empiezan antes de eso. Coca-Cola ha cotizado desde 1919, pero su historial completo comenzó el 1970-01-02. Un
period1negativo devolvió 404. frequencyadmite1d,1wk, y1mo. En1wky1mo, Yahoo añadió la última sesión como barra extra, y la función la elimina. Con esa barra eliminada, la última barra semanal o mensual puede excluir la última sesión de trading, así que toma los cierres recientes de barras diarias.- Los valores intradía como
1h,5m, y1mdevolvieron barras diarias en su lugar. La pestaña de resumen incrusta hasta 24 horas de cierres de 5 minutos desde/v7/finance/spark. También incrusta una segunda respuesta spark para el resumen de mercado, así que elige la respuesta cuyo parámetrosymbolscoincida con tu ticker. Las páginas de cotización solo contienen esas 24 horas de datos intradía, porque el historial intradía más largo proviene de los hosts de API, que robots.txt prohíbe. - Yahoo ajusta
closepor splits yadj_closepor splits y dividendos. Las barras antiguas cambian tras cada nuevo split o dividendo, así que guarda los eventos de splits y dividendos con cada descarga. - El tamaño de la página crece con el rango de fechas. Con el rango completo de fechas, la pestaña de datos históricos de MSFT fue de 4.9 MB de HTML, y la pestaña de resumen fue de alrededor de 1.1 MB. Para una actualización diaria, establece
period1en una marca de tiempo reciente, y descarga el rango completo de nuevo tras cada nuevo split o dividendo.
Obtén estados financieros y estimaciones de analistas
Los estados y las estimaciones están en pestañas distintas, así que cada uno obtiene su propia función.
Obtén estados financieros anuales
Los estados financieros provienen de la respuesta fundamentals-timeseries en las pestañas de estados financieros, balance general, y flujo de caja. En la pestaña de estados financieros de MSFT, esa respuesta contenía 96 series anuales y 96 series de los últimos 12 meses. statement() conserva las series anuales y las pivota en una tabla con 1 columna por año fiscal. Guárdala como statements.py:
import pandas as pd

from yahoo_embedded import embedded, fetch_page, pick


def statement(symbol: str, tab: str = "financials/", fetch=fetch_page) -> pd.DataFrame:
    """Partidas anuales de la pestaña financials/, balance-sheet/ o cash-flow/."""
    found = embedded(fetch(symbol, tab))
    series = pick(found, "/fundamentals-timeseries/")["timeseries"]["result"]
    rows = []
    for item in series:
        name = item["meta"]["type"][0]  # por ejemplo "annualTotalRevenue"
        if not name.startswith("annual"):
            continue  # omite series no anuales, como las de últimos 12 meses
        for point in item.get(name) or []:
            if point:
                rows.append(
                    {
                        "line_item": name.removeprefix("annual"),
                        "fiscal_year_end": point["asOfDate"],
                        "value": point["reportedValue"]["raw"],
                    }
                )
    table = pd.DataFrame(rows).pivot(
        index="line_item", columns="fiscal_year_end", values="value"
    )
    return table.sort_index(axis=1)


if __name__ == "__main__":
    income = statement("MSFT")
    billions = (
        income.loc[["TotalRevenue", "GrossProfit", "OperatingIncome", "NetIncome"]].T
        / 1e9
    )
    billions["DilutedEPS"] = income.loc["DilutedEPS"]
    print(billions.round(2).to_string())
    print(f"{len(income)} partidas")
El script imprimió 4 años fiscales del estado de resultados, en miles de millones de dólares excepto para EPS:
line_item        TotalRevenue  GrossProfit  OperatingIncome  NetIncome  DilutedEPS
fiscal_year_end
2023-06-30             211.92       146.05            88.52      72.36        9.68
2024-06-30             245.12       171.01           109.43      88.14       11.80
2025-06-30             281.72       193.89           128.53     101.83       13.64
2026-06-30             331.84       225.46           155.24     133.75       17.95
47 line items
En la pestaña de estados financieros, Yahoo muestra las mismas cifras en miles, así que los 331.84B de ingresos en la salida aparecen como 331,839,000:
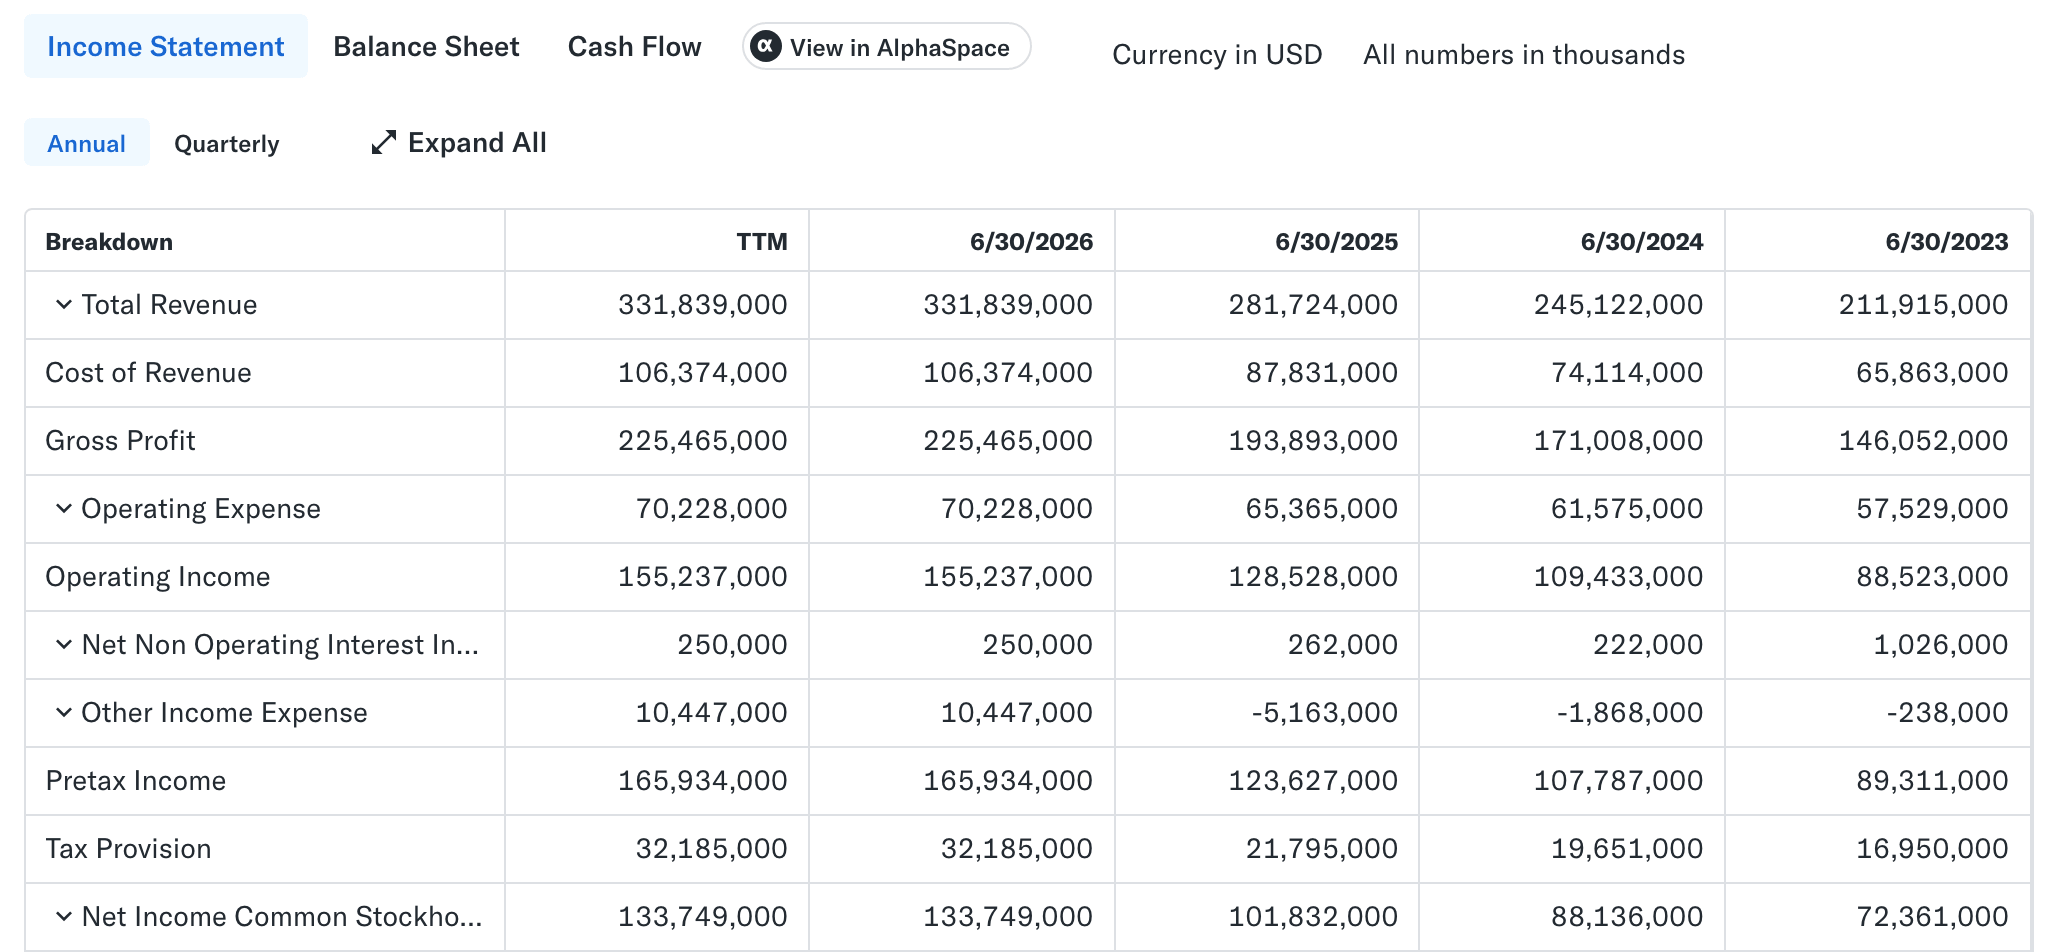
Las vistas de Estado de Resultados, Balance General, y Flujo de Caja son las pestañas financials/, balance-sheet/, y cash-flow/ que lee statement().
Para MSFT, 47 de las 96 series anuales tenían valores. Las series vacías eran partidas como reclamos de seguros, dividendos preferentes, e impuestos especiales. Para esos 4 años, la función devolvió 79 partidas de balance-sheet/ y 59 partidas de cash-flow/. Los estados trimestrales se cargan solo después de seleccionar el conmutador Trimestral, y ningún parámetro de URL probado cambió eso.
Omite los módulos incomeStatementHistory y balanceSheetHistory en quoteSummary. Sus filas de ingresos solo tenían valores reales para ingresos totales e ingreso neto, tanto en las versiones anuales como trimestrales. Las filas de balance general solo tenían fechas. Otros campos de ingresos contenían 0 como marcador de posición, así que un parser que confíe en ellos almacenaría una ganancia bruta de 0.
Obtén estimaciones de analistas
La pestaña de análisis incrusta earningsTrend, que contiene el EPS e ingresos de consenso para el trimestre actual, el siguiente trimestre, el año actual, y el próximo año. estimates() lo aplana en 1 fila por periodo. Guárdala como estimates.py:
import pandas as pd

from quote_summary import raw
from yahoo_embedded import embedded, fetch_page, pick


def estimates(symbol: str, fetch=fetch_page) -> pd.DataFrame:
    """EPS e ingresos de consenso para el trimestre actual y el siguiente, y el año actual y el siguiente."""
    found = embedded(fetch(symbol, "analysis/"))
    result = pick(found, "/v10/finance/quoteSummary/")["quoteSummary"]["result"][0]
    rows = []
    for period in result["earningsTrend"]["trend"]:
        eps, revenue = period["earningsEstimate"], period["revenueEstimate"]
        revenue_avg = raw(revenue, "avg")
        rows.append(
            {
                "period": period["period"],  # 0q, +1q, 0y, +1y
                "ends": period["endDate"],
                "eps_avg": raw(eps, "avg"),
                "eps_low": raw(eps, "low"),
                "eps_high": raw(eps, "high"),
                "eps_analysts": raw(eps, "numberOfAnalysts"),
                "revenue_avg_bn": None if revenue_avg is None else revenue_avg / 1e9,
                "revenue_analysts": raw(revenue, "numberOfAnalysts"),
            }
        )
    return pd.DataFrame(rows).set_index("period")


if __name__ == "__main__":
    print(estimates("MSFT").round(2).to_string())
Para MSFT, cada estimación provino de 25 a 51 analistas:
              ends  eps_avg  eps_low  eps_high  eps_analysts  revenue_avg_bn  revenue_analysts
period
0q      2026-09-30     4.72     4.43      4.83            25           90.66                38
+1q     2026-12-31     4.82     4.72      5.02            25           95.49                37
0y      2027-06-30    19.76    19.21     20.70            33          391.04                50
+1y     2028-06-30    23.68    22.08     26.00            32          467.27                51
En la pestaña de análisis, la tabla de Estimación de Ganancias muestra las mismas cifras de EPS. Sus columnas Trim. Actual, Próx. Trim., Año Actual, y Próximo Año coinciden con las filas 0q, +1q, 0y, y +1y:
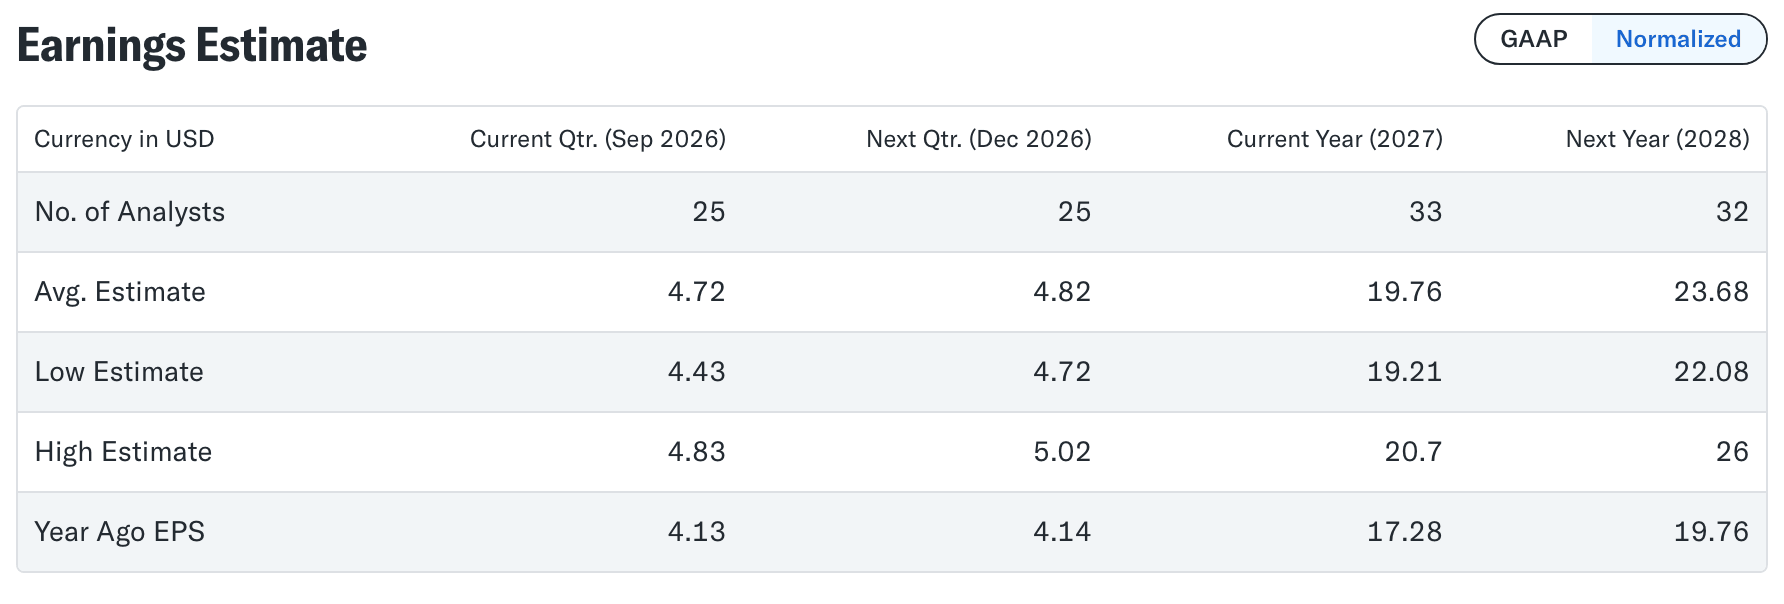
La vista Normalizada de la tabla muestra los mismos números que contiene earningsTrend.
La misma solicitud también devuelve epsTrend y epsRevisions para cada periodo, y earningsHistory con los últimos 4 trimestres reportados y sus porcentajes de sorpresa.
Haz scraping de Yahoo Finance para cientos de tickers
Muchas listas de tickers de producción incluyen símbolos antiguos, índices, y listados extranjeros, así que tu script de lote tiene que reportar problemas y continuar. Guarda el siguiente script como batch.py. Ejecuta 8 hilos por defecto, recopila por separado los símbolos faltantes y fallidos, y convierte unidades de moneda menores:
from concurrent.futures import ThreadPoolExecutor

import pandas as pd

from quote_summary import quote_summary
from yahoo_embedded import SymbolNotFound, fetch_page

# Yahoo cotiza muchos precios de Londres, Johannesburgo, y Tel Aviv en unidades menores.
# La capitalización de mercado permanece en unidades mayores.
MINOR_UNITS = {"GBp": ("GBP", 100), "ZAc": ("ZAR", 100), "ILA": ("ILS", 100)}
PRICE_FIELDS = ("price", "week52_low", "week52_high", "target_mean")


def to_major_units(row: dict) -> dict:
    unit = MINOR_UNITS.get(row["currency"])
    if unit is None:
        return row
    currency, divisor = unit
    prices = {key: row[key] / divisor for key in PRICE_FIELDS if row[key] is not None}
    return {**row, **prices, "currency": currency}


def collect(symbols: list[str], fetch=fetch_page, workers: int = 8):
    """Filas de cotización para muchos símbolos, más los símbolos faltantes o fallidos."""
    # " msft" y "MSFT" son el mismo ticker
    symbols = list(dict.fromkeys(s.strip().upper() for s in symbols))
    missing, failed = [], {}

    def one(symbol: str) -> dict | None:
        try:
            return to_major_units(quote_summary(symbol, fetch=fetch))
        except SymbolNotFound:
            missing.append(symbol)
        except Exception as error:  # mantén el lote corriendo, reporta al final
            failed[symbol] = repr(error)
        return None

    with ThreadPoolExecutor(max_workers=workers) as pool:
        rows = [row for row in pool.map(one, symbols) if row]
    return pd.DataFrame(rows), missing, failed


if __name__ == "__main__":
    tickers = "AAPL MSFT SQ ^GSPC SPY BTC-USD 7203.T SAP.DE VOD.L NPN.JO".split()
    table, missing, failed = collect(tickers)
    cols = "symbol price currency market_cap delay_minutes reporting_currency".split()
    print(table[cols].to_string(index=False))
    print("missing:", missing, "| failed:", failed)
Una lista mixta de 10 símbolos terminó en 2.5 segundos:
 symbol     price currency   market_cap  delay_minutes reporting_currency
   AAPL   341.070      USD 4.977637e+12              0                USD
   MSFT   516.170      USD 3.832844e+12              0                USD
  ^GSPC  7743.410      USD          NaN              0                NaN
    SPY   771.350      USD          NaN              0                NaN
BTC-USD 85011.320      USD 1.707212e+12              0                NaN
 7203.T  2989.500      JPY 3.540116e+13             20                JPY
 SAP.DE   185.920      EUR 2.145897e+11             15                EUR
  VOD.L     1.258      GBP 2.907280e+10             15                EUR
 NPN.JO   709.380      ZAR 5.307029e+11             15                USD
missing: ['SQ'] | failed: {}
El lote reportó SQ como faltante porque Block, Inc. cambió su símbolo a XYZ. Yahoo redirige el símbolo antiguo a su página de búsqueda, pero un símbolo reutilizado falla silenciosamente. FB, el antiguo símbolo de Meta, devolvió un ETF de ProShares con estado 200, así que compara cada name con tu lista de tickers. La página de cotización de FB se ve como cualquier otra página de cotización:
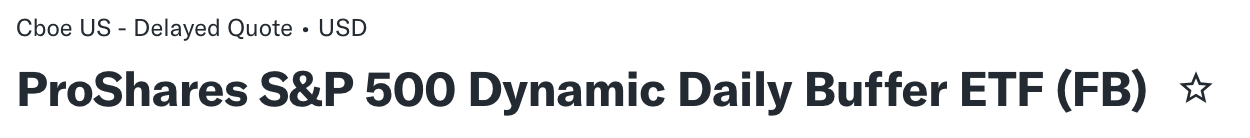
Un símbolo reutilizado devuelve una página de cotización normal, así que el nombre es la señal más clara del cambio.
Verifica unidades, monedas, y retrasos
Una verificación de código de estado no detectará 3 problemas adicionales:
- Unidades de moneda menores. Yahoo reportó el precio de VOD.L como 125.8 en
GBp(peniques) y su capitalización de mercado como 29.07B en libras. El precio de NPN.JO era 70,938 enZAc(centavos).to_major_units()solo divide los campos de precio, así que la capitalización de mercado mantiene sus unidades mayores. - Moneda de reporte. Los valores de los estados usan la moneda de reporte de la empresa, y los puntos de datos de series temporales incluyen esa moneda en un campo
currencyCode. Vodafone (VOD.L) cotiza en peniques pero reporta en euros, y Naspers (NPN.JO) cotiza en rand pero reporta en dólares estadounidenses. Los ratios pueden mezclar las 2 monedas. El P/E futuro de TEVA.TA era 43.5, mientras que TEVA, su listado en Nueva York, tenía 12.9. Yahoo había dividido el precio en shékel de TEVA.TA entre una estimación de EPS en dólares. - Retraso del exchange.
delay_minutesfue 0 para los listados de EE. UU. y Bitcoin. Las cotizaciones de Xetra, Londres, y Johannesburgo tenían un retraso de 15 minutos, y la cotización de Tokio tenía un retraso de 20 minutos. Conservadelay_minutesymarket_timecon cada fila antes de comparar precios entre exchanges.
Ejecuta lotes más grandes
Con sus 8 hilos predeterminados, collect() procesó los 503 símbolos del S&P 500 en 74 segundos desde la conexión residencial sin un 429 o un reintento. Solo BRK.B y BF.B faltaron, porque la lista del S&P 500 de Wikipedia los escribe con puntos y Yahoo usa BRK-B y BF-B. Con period1 fijado en hace 7 días, los 501 historiales se actualizaron en 48 segundos. La página mediana fue de menos de 1 MB, comparada con 4.9 MB para el historial completo de MSFT.
Con retroceso exponencial, fetch_page() ya reintenta timeouts, 429s, respuestas 5xx, y páginas sin datos de cotización. Nuestra guía de reintentos de solicitudes fallidas en Python explica el retroceso con el Retry de urllib3 y Tenacity.
Si te cambias a asyncio, verifica primero el límite de tu cliente para el tamaño de encabezados de respuesta. La respuesta para la pestaña de resumen de MSFT tenía alrededor de 37 KB de encabezados, incluyendo un Content-Security-Policy de 8,765 bytes y un encabezado Link de 27,039 bytes. Con la configuración predeterminada, aiohttp 3.14.3 lanzó un ClientResponseError en una página que Yahoo había servido con estado 200. Su mensaje empezaba con 400, message='Got more than 8190 bytes when reading.
Pasar max_field_size=65536 a aiohttp.ClientSession corrigió el error. Tanto httpx como el AsyncSession de curl_cffi manejaron la página con la configuración predeterminada. Nuestra comparación de requests, httpx, y aiohttp explica las demás ventajas y desventajas entre ellos.
Ejecuta el mismo parser desde un servidor con Web Unlocker API
Nuestra API Web Unlocker toma una URL y devuelve la página. Maneja rotación de IP, resolución de CAPTCHA, y reintentos automáticos en nuestros servidores, así que el mismo parser se ejecuta desde tu servidor mientras nosotros mantenemos el desbloqueo. fetch_page_unlocker() toma los mismos argumentos symbol, tab, y params que fetch_page(), así que quote_summary(), price_history(), statement(), y estimates() la aceptan a través de su parámetro fetch. Guárdala como unlocker.py:
import os
from urllib.parse import urlencode

import requests

from yahoo_embedded import page_url

API_URL = "https://api.brightdata.com/request"


def fetch_page_unlocker(symbol: str, tab: str = "", params: dict | None = None) -> str:
    """Toma el mismo symbol, tab, y params que fetch_page(), vía Web Unlocker API."""
    url = page_url(symbol, tab) + (f"?{urlencode(params)}" if params else "")
    response = requests.post(
        API_URL,
        headers={"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"},
        json={
            "zone": os.environ["BRIGHTDATA_UNLOCKER_ZONE"],
            "url": url,
            "format": "json",  # Estado, encabezados, y HTML de Yahoo, envueltos en JSON
            "country": "us",
        },
        timeout=120,
    )
    response.raise_for_status()
    return response.json()["body"]
Lee tu clave de API y el nombre de tu zona de Web Unlocker API de 2 variables de entorno. Una zona es una configuración de producto nombrada en tu cuenta. Encontrarás la clave en la página de configuración de la cuenta y los pasos para crear una zona en la guía rápida de Web Unlocker API. Una vez que la zona existe, su pestaña de Resumen muestra ambos valores:
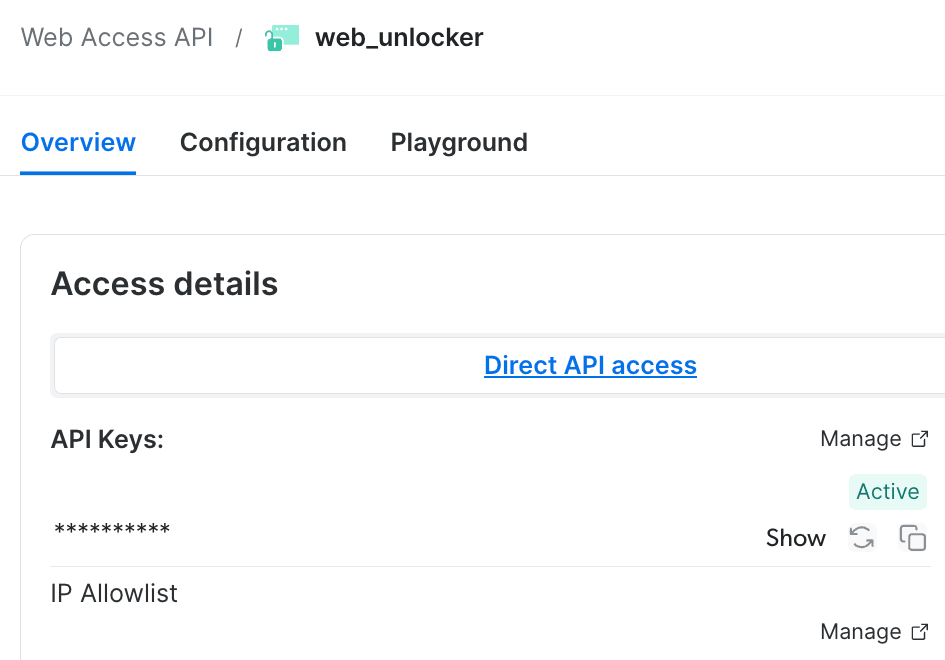
El nombre de la zona, aquí web_unlocker, está arriba, y el botón de copiar bajo API Keys copia tu clave.
Define ambas en tu shell antes de ejecutar el siguiente script:
export BRIGHTDATA_API_KEY="your-api-key"
export BRIGHTDATA_UNLOCKER_ZONE="your-zone-name"
Para enrutar quote_summary(), price_history(), statement(), o estimates() a través de Web Unlocker API, pasa fetch_page_unlocker como el argumento fetch. Guarda este script como unlocker_demo.py:
from price_history import price_history
from unlocker import fetch_page_unlocker

history, events = price_history("MSFT", fetch=fetch_page_unlocker)
print(
    f"{len(history):,} daily bars from {history.index[0]:%Y-%m-%d} "
    f"to {history.index[-1]:%Y-%m-%d}"
)
Imprimió el mismo historial que price_history.py:
10,213 daily bars from 1986-03-13 to 2026-09-25Una sola solicitud devolvió la página completa de datos históricos, y el parser no necesitó cambios para leerla. El script de lote acepta la misma función a través de collect(tickers, fetch=fetch_page_unlocker).
Ten en cuenta estos 3 detalles:
- Usa
"format": "json". La respuesta entonces contiene el código de estado, encabezados, y HTML completo de Yahoo en un solo objeto JSON. La función devuelve el HTML de su campobody. - Codifica caracteres especiales.
page_url()ya codifica con porcentaje los símbolos de índices como^GSPCcomo%5EGSPC, así que cada URL que construye es válida. - O usa nuestro SDK de Python. Instala
brightdata-sdkconpip install brightdata-sdk, y pasaresponse_format="json"ascrape_url()para obtener el código de estado de Yahoo junto con la página.
Cada pestaña es una solicitud separada, y solo pagas por las solicitudes exitosas.
Obtén registros estructurados desde la API Scraper de Yahoo Finance
Nuestra API Scraper de Yahoo Finance devuelve un registro estructurado por ticker, y los proxies, el desbloqueo, y los reintentos están integrados. Es un scraper preconstruido en nuestra API Web Scraper. Un registro combina los campos de resumen, el perfil de la empresa, ejecutivos clave, estados financieros anuales, y objetivos de precio de analistas, que la página del producto del scraper lista campo por campo. El Panel de Control muestra los modos síncrono y asíncrono del scraper y el endpoint que llama el código a continuación:
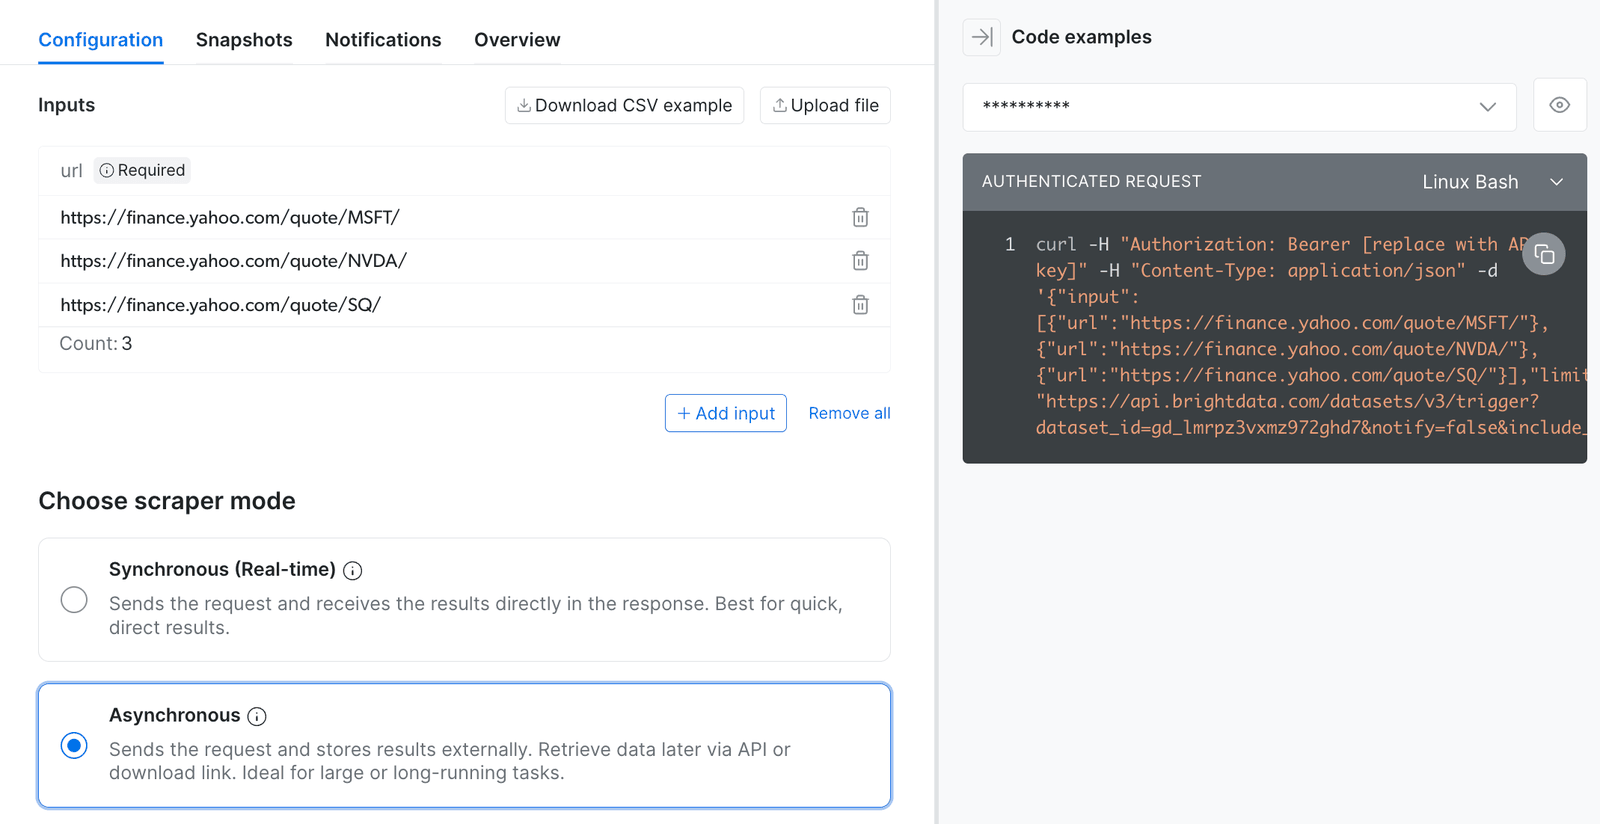
El ejemplo curl del panel usa las mismas URL de cotización, el endpoint de trigger, y el ID del conjunto de datos que scraper_api.py, y el modo Asíncrono funciona mejor para trabajos de lote programados.
Dispara un trabajo y descarga los registros
Guarda el siguiente script como scraper_api.py. Dispara un trabajo para una lista de URL, consulta su progreso, descarga los registros, y reporta los símbolos que Yahoo ya no lista:
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
DATASET_ID = "gd_lmrpz3vxmz972ghd7"  # Yahoo Finance business information
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
# La API devuelve solo estos campos, así que la lista conserva input, error, y error_code.
FIELDS = (
    "input|error|error_code|stock_ticker|closing_price|"
    "market_cap|pe_ratio|currency|timestamp"
)


def job_status(snapshot_id: str) -> str:
    progress = requests.get(
        f"{API}/progress/{snapshot_id}", headers=HEADERS, timeout=60
    )
    return progress.json()["status"]


def run_batch(urls: list[str], poll_seconds: int = 30) -> list[dict]:
    """Dispara un trabajo de recolección, espera hasta que esté listo, y devuelve sus registros."""
    trigger = requests.post(
        f"{API}/trigger",
        params={
            "dataset_id": DATASET_ID,
            "include_errors": "true",
            "custom_output_fields": FIELDS,
        },
        headers=HEADERS,
        json={"input": [{"url": url} for url in urls]},
        timeout=60,
    )
    trigger.raise_for_status()
    snapshot_id = trigger.json()["snapshot_id"]

    while job_status(snapshot_id) != "ready":
        time.sleep(poll_seconds)

    records = requests.get(
        f"{API}/snapshot/{snapshot_id}",
        params={"format": "json"},
        headers=HEADERS,
        timeout=300,
    )
    records.raise_for_status()
    return records.json()


def collect_records(urls: list[str]) -> tuple[list[dict], dict[str, str]]:
    """Ejecuta un trabajo y separa sus registros en resultados y errores por URL."""
    records = run_batch(list(dict.fromkeys(urls)))  # elimina URL duplicadas
    done = [record for record in records if not record.get("error")]
    errors = {
        record["input"]["url"]: f'{record.get("error_code")}: {record["error"]}'
        for record in records
        if record.get("error")
    }
    return done, errors


if __name__ == "__main__":
    urls = [f"https://finance.yahoo.com/quote/{s}/" for s in ("MSFT", "NVDA", "SQ")]
    records, errors = collect_records(urls)
    for record in records:
        print(record)
    print("errors:", errors)
Imprimió 2 registros y un error para SQ:
{'input': {'url': 'https://finance.yahoo.com/quote/MSFT/'}, 'stock_ticker': 'MSFT', 'closing_price': 516.17, 'market_cap': 3832843862016, 'pe_ratio': 28.739979, 'currency': 'USD', 'timestamp': '2026-09-27T16:15:44.789Z'}
{'input': {'url': 'https://finance.yahoo.com/quote/NVDA/'}, 'stock_ticker': 'NVDA', 'closing_price': 225.07, 'market_cap': 5434765213696, 'pe_ratio': 28.489874, 'currency': 'USD', 'timestamp': '2026-09-27T16:16:02.513Z'}
errors: {'https://finance.yahoo.com/quote/SQ/': 'dead_page: Target quote not found on lookup page'}
El scraper marcó SQ como dead_page porque Yahoo redirige SQ a su página de búsqueda, y fetch_page() lanza SymbolNotFound en el mismo caso.
Configura un pipeline programado
Ejecuta la API Scraper como un trabajo por lotes. Envía muchos tickers en cada llamada de trigger, luego consulta el endpoint de progreso o espera un webhook.
El endpoint síncrono /scrape devuelve registros directamente en su respuesta. Para un trabajo más largo, el endpoint devuelve en su lugar un snapshot_id para consultar, como describe la referencia de la API síncrona.
La llamada de trigger acepta algunas configuraciones que importan para un pipeline programado. La referencia de la API asíncrona las lista, y el Panel de Control ofrece las mismas opciones bajo Configuración del scraper:
- Informe de errores.
include_errors=trueañade unerrory unerror_codea cualquier entrada sin resultado, como un símbolo que Yahoo ya no lista.collect_records()reporta esas entradas por URL. - Campos de salida.
custom_output_fieldsconserva solo los campos que listas, separados por|, así que añadeinput,error, yerror_codepara mantener el informe de errores. - Límites de registros.
limit_per_inputlimita los registros por entrada, ylimit_multiple_resultslimita los registros por trabajo. Ambos límites controlan el costo de una búsqueda de Descubrir por palabra clave. - Entrega y webhooks.
endpointentrega los registros a tu URL de webhook.notify=trueenvía una notificación cuando el trabajo se completa, así un programador no tiene que consultar/progress. Pasauncompressed_webhook=truepara recibir las cargas útiles del webhook sin comprimir. Configuración de entrega en el panel también puede escribir resultados en Amazon S3, Google Cloud Storage, o Snowflake, como describe la documentación de entrega de datos. - Programaciones. El Panel de Control puede ejecutar la misma recolección en un horario recurrente, como una actualización diaria de tickers.
En una lista de tickers más larga, el scraper también marcó MMC, BK, y FI como dead_page. Esas empresas habían cambiado sus símbolos a MRSH, BNY, y FISV. Solo pagas por los registros entregados exitosamente.
Busca por palabra clave o ejecútalo desde la CLI
El modo Descubrir por palabra clave encuentra listados que coinciden con una palabra clave entre exchanges y tipos de activos. Una consulta WIX encontró Wix.com, Wickes Group (WIX.L), y contratos de opciones de WIX, y una consulta MSFT también encontró el listado de Microsoft en Toronto y ETF de una sola acción. Filtra por entity_type y stock_ticker para conservar los listados que quieres.
La API Scraper de Yahoo Finance también se ejecuta desde una terminal como brightdata pipelines yahoo_finance_business <url> en la CLI de Bright Data. A través de la herramienta web_data_yahoo_finance_business, un agente de IA puede obtener el registro de una URL de cotización que le des. La herramienta se ejecuta en nuestro Servidor MCP de Yahoo Finance, después de que habilites su grupo de herramientas finance.
Elige el enfoque correcto para tu pipeline
Empieza leyendo las páginas de cotización gratis, y añade Web Unlocker API para trabajos de servidor programados. Para registros estructurados, usa la API Scraper o el Conjunto de datos de Yahoo Finance:
| Opción | Mejor para | Tú manejas | Precio |
|---|---|---|---|
| yfinance | Investigación personal, como dice su README | Actualizaciones de librería, IPs bloqueadas | Gratis |
| Páginas de cotización con curl_cffi | Cientos de tickers al día desde casa o un ejecutor de GitHub Actions | Parser, reintentos, IPs bloqueadas | Gratis |
| Páginas de cotización con Web Unlocker API | Trabajos de servidor programados que leen cualquier pestaña | Parser | Por solicitud exitosa |
| Playwright con Browser API | Estados trimestrales y otros datos que aparecen tras seleccionar un conmutador | Script de navegador, parser | Por GB de tráfico |
| API Scraper de Yahoo Finance | Registros parseados entregados en un horario | Lista de campos de salida | Por registro entregado |
| Conjunto de datos de Yahoo Finance | Archivos ya preparados de empresas, fondos, e índices | Configuración de entrega | Por registro |
Para estimar un presupuesto mensual, cuenta 1 solicitud de Web Unlocker API por pestaña, por ticker, por actualización. La API Scraper de Yahoo Finance necesita 1 registro por ticker por actualización. Multiplica cualquiera de los volúmenes por el precio actual en la página de precios de Web Unlocker API o la página de precios de Web Scraper API.
Para estados trimestrales, un script de Playwright o Puppeteer puede seleccionar el conmutador Trimestral de la pestaña de estados financieros en nuestra API Browser. Ejecuta Chromium en la nube, y la resolución de CAPTCHA y el renderizado de JavaScript están integrados. Nuestra guía de scraping de sitios web dinámicos con Python muestra ese flujo de trabajo paso a paso.
Nuestro Conjunto de datos de Yahoo Finance empaqueta el mismo tipo de registros que la API Scraper en archivos JSON, NDJSON, CSV, o Parquet ya preparados. Incluye acciones, fondos mutuos, índices, ETF, monedas, y fondos del mercado monetario, así que filtra por entity_type para conservar las clases de activos que quieres.
Puedes comprar un subconjunto con solo los puntos de datos que necesitas y obtener actualizaciones en un horario diario, semanal, mensual, o personalizado. Cada entrega puede contener solo registros nuevos o actualizados e ir directamente a Amazon S3, Google Cloud, Azure, Snowflake, o SFTP. La página del conjunto de datos muestra el número actual de registros y el precio, y puedes descargar un archivo de muestra en JSON o CSV antes de comprar.
Para otras fuentes de datos de mercado, consulta nuestras guías de scraping de datos financieros y scraping de Google Finance. Nuestros otros scrapers y conjuntos de datos ofrecen más datos bursátiles y otros resultados de Yahoo:
- Stock Market Scraper recopila datos bursátiles de sitios como Yahoo Finance, Google Finance, y TradingView.
- Google Finance Scraper y TradingView Scraper recopilan precios de acciones y tendencias de mercado de esos 2 sitios.
- Nasdaq Scraper recopila datos del Nasdaq como precio de apertura, precio de cierre, y volumen de acciones.
- Stocktwits Scraper recopila publicaciones, sentimiento, y símbolos en tendencia de Stocktwits.
- Financial Data Scraper API devuelve campos como nombre de la empresa, ticker, exchange, y precio de cierre.
- Stock Market Dataset, Stock Prices Dataset, y Financial Dataset entregan perfiles de empresas, tickers, y precios como archivos ya preparados.
- Google Finance Datasets, Historical Financial Data, y Financial News Dataset entregan datos de Google Finance, datos financieros históricos, y noticias financieras como archivos ya preparados.
- Yahoo News API y Yahoo Search API devuelven resultados de Yahoo News y de búsqueda de Yahoo.
Reflexiones finales
Las páginas de cotización de Yahoo Finance contienen sus propias respuestas de API como JSON, así que 1 solicitud por pestaña devuelve los datos sin navegador, cookie, ni crumb. Arregla el cliente antes de añadir retrasos, porque los 429 de Yahoo en primeras solicitudes dependían del handshake TLS y User-Agent del cliente. Parsea las respuestas incrustadas, valida cada página, compara cada nombre con tu lista de tickers, y convierte las unidades de moneda menores dentro del parser.
Para trabajos de servidor programados, enruta el mismo parser a través de Web Unlocker API, o deja que la API Scraper de Yahoo Finance devuelva registros estructurados. Nuestros créditos gratuitos mensuales aplican a ambos, así que puedes probar cualquiera con tu propia lista de tickers.
Preguntas frecuentes
¿Existe una API oficial de Yahoo Finance?
No. Yahoo dice que deshabilitó el acceso a la API para datos de cotización porque sus proveedores de datos “no autorizan actualmente” la redistribución en forma de API. Los hosts internos de API que usa yfinance no están documentados y están prohibidos en robots.txt. Las páginas de cotización de Yahoo incrustan los mismos datos como JSON.
¿Sigue siendo usable yfinance?
Sí, desde casa y 3 ejecutores de GitHub Actions, yfinance obtuvo el historial diario completo de MSFT en menos de 1.5 segundos. Usa el handshake TLS de Chrome de curl_cffi. Su README llama a la API de Yahoo “destinada solo para uso personal”. Los desarrolladores reportaron 401 y fallos de obtención desde algunos hosts en la nube, así que pruébala desde tu propio servidor.
¿Bloquea Yahoo Finance el scraping web?
Sí, para algunos clientes. Yahoo bloqueó el cliente requests predeterminado de Python en su primera solicitud. Con el handshake TLS de Chrome, curl_cffi no recibió 429 en una conexión residencial ni en 3 ejecutores de GitHub Actions. Para trabajos programados, la API Web Unlocker de Bright Data obtiene las mismas páginas con rotación de IP y reintentos automáticos.
¿Se pueden descargar datos de Yahoo Finance?
Sí, pero la página de ayuda de Yahoo limita la descarga CSV a suscriptores pagos de Yahoo Finance. En código, una sola solicitud a la pestaña de datos históricos devolvió cada barra diaria de MSFT desde 1986. Para archivos masivos, el Conjunto de datos de Yahoo Finance de Bright Data entrega registros de empresas, fondos, e índices en el horario que elijas.
¿Es gratuita la API de Yahoo Finance?
No oficialmente. Los endpoints internos de Yahoo no cuestan nada al llamarlos, pero no están documentados y están prohibidos para rastreadores. La página de ayuda de Yahoo limita las descargas CSV a suscriptores pagos. La API Scraper de Yahoo Finance de Bright Data devuelve registros estructurados, y las cuentas nuevas reciben créditos gratuitos mensuales para probarla.