


 38.9K+
 6.1K+
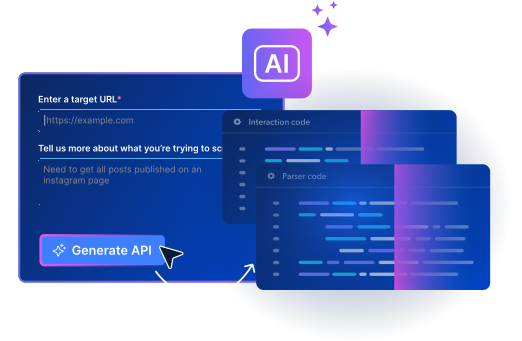


- Construye solicitudes en cualquier lenguaje
- Automatiza con programadores y webhooks
- Entrega en JSON, NDJSON o CSV


Image Scraper API
Extrae imágenes y el contexto que las rodea de sitios sociales y ecommerce. Recopila datos como fotos, videos, descripción, hashtags, fecha de publicación, likes, cantidad de comentarios y URL del post.
5K registros gratis/mes · No se requiere tarjeta de crédito
Confiado por 50,000+ clientes en todo el mundo


Web Scrapers
Scrapers relacionados disponibles
Elimina la necesidad de desarrollar y mantener la infraestructura. Simplemente extrae datos de imágenes en alto volumen, y asegura escalabilidad y confiabilidad usando API de web scraper o scrapers sin código.
Explora miles de scrapers listos para producción
Paga solo por resultados exitosos, sin sorpresas – Proxies, desbloqueo, navegadores y reintentos están incluidos.
#1
Clasificado (por AIMultiple)
99.2%
Tasa de éxito promedio
100M+
Solicitudes semanales
400M+
IPs de proxy incluidas
GDPR & CCPA
Conforme
Precios
Precios de la API Scraper de image
Paga solo por lo que se entrega con éxito. Sin tarifas ocultas, sin cargos por entregas fallidas.
Records per month: 5K
$/mo
$
per 1,000 records
Your whole bill. Proxies, unblocking, parsing included.
Comece já
- Paga solo por el éxito, sin tarifas ocultas
- Comienza gratis con 5,000 créditos mensuales
- Sin compromiso inicial, cancela cuando quieras
- Soporte experto 24/7 y funciones empresariales
Aceitamos esses métodos de pagamento:
¿Solo quieres datos? Olvídate del scraping. Compra un Conjunto de datos de image
Cómo funciona
De cero a datos de image en 3 pasos
Sin proxies que configurar, sin infraestructura que gestionar. Elige, llama y recibe.
-
Elige un scraper
Elige entre los scrapers de image de arriba o crea el tuyo con IA en minutos.
-
Llama a la API
Una llamada a la API con hasta 5,000 URLs objetivo. SDKs de Python y Node.js, CLI, servidor MCP, o cualquier cliente HTTP.
-
Obtén datos estructurados
Recibe datos limpios y parseados de image en JSON, NDJSON o CSV. Entregados vía API, webhook, o almacenamiento en la nube.
Llamada a la API de scraper
curl -H "Authorization: Bearer API_TOKEN" -H "Content-Type: application/json" -d '[{"url":"https://www.instagram.com/p/Cuf4s0MNqNr","country":""},{"url":"https://www.instagram.com/p/DP861NijuwE","country":""}]' "https://api.brightdata.com/datasets/v3/trigger?dataset_id=gd_lk5ns7kz21pck8jpis&format=json&uncompressed_webhook=true"
Carga útil de respuesta
[
  {
    "timestamp": "2026-10-15",
    "url": "https:\/\/www.instagram.com\/p\/Dd3cG9LiOKW",
    "user_posted": "olimp_nutrition_pl",
    "description": "[reklama] Miałam wejść tylko po jedną rzecz. Tylko jedną. Naprawdę. 👀\nAle wtedy zobaczyłam nową półkę SPORT, a na niej ...",
    "hashtags": null,
    "num_comments": 18,
    "date_posted": "2026-09-29T09:29:44.000Z",
    "likes": 1349
  },
  {
    "timestamp": "2026-10-15",
    "url": "https:\/\/www.instagram.com\/p\/Dd395baRKxQ",
    "user_posted": "elaineratner",
    "description": "A storybook setting, thoughtful details, and a room full of people celebrating @jetzen and @court_fox . The whole evenin...",
    "hashtags": null,
    "num_comments": 84,
    "date_posted": "2026-09-29T14:25:30.000Z",
    "likes": 845
  },
  {
    "timestamp": "2026-10-15",
    "url": "https:\/\/www.instagram.com\/reel\/DeFrVkfxLDC",
    "user_posted": "spanglishfashion",
    "description": "#AMAZON finds ( commet SHOP for links) 🖤\n\nAbout last night look! Pieces that you can use all year!\n#amazonfinds #fallvi...",
    "hashtags": [
      "#AMAZON",
      "#amazonfinds",
      "#fallvibes",
      "#nightlook"
    ],
    "num_comments": 23,
    "date_posted": "2026-10-04T22:14:26.000Z",
    "likes": null
  },
  {
    "timestamp": "2026-10-15",
    "url": "https:\/\/www.instagram.com\/reel\/DeFpacZuhbg",
    "user_posted": "sabinalynn",
    "description": "what makes me happy!? @waltdisneyworld #mickeysnotsoscaryhalloweenparty \n\n#magickindom #fyp #family #travel",
    "hashtags": [
      "#mickeysnotsoscaryhalloweenparty",
      "#magickindom",
      "#fyp",
      "#family",
      "#travel"
    ],
    "num_comments": 4,
    "date_posted": "2026-10-04T21:55:24.000Z",
    "likes": 8
  },
  {
    "timestamp": "2026-10-15",
    "url": "https:\/\/www.instagram.com\/reel\/DeFtnUhBLnI",
    "user_posted": "amanda_gallant",
    "description": "things can literally only get better lol #hungover #newapartment #bostoninfluencer",
    "hashtags": [
      "#hungover",
      "#newapartment",
      "#bostoninfluencer"
    ],
    "num_comments": 28,
    "date_posted": "2026-10-04T22:34:33.000Z",
    "likes": 1368
  }
]
Llamada a la API de scraper
curl -H "Authorization: Bearer API_TOKEN" -H "Content-Type: application/json" -d '[{"url":"https://www.facebook.com/share/p/gep5QPJZNa81fYdu/"},{"url":"https://www.facebook.com/watch/?v=327995660386452\u0026rdid=pKCuRqjaeQXhEaWZ"},{"url":"https://www.facebook.com/EURO2024/posts/pfbid02g8mkyScqMF3bVNBELqyv8u78RBKvPLyiUCPgVC1PUFUdKhnpWnbeR8J7UHfj9UoMl?rdid=fdpwFKbUJRiQhwNL"}]' "https://api.brightdata.com/datasets/v3/trigger?dataset_id=gd_lyclm1571iy3mv57zw&format=json&uncompressed_webhook=true"
Carga útil de respuesta
[
  {
    "timestamp": "2026-07-21",
    "url": "https:\/\/www.facebook.com\/usopentennis\/posts\/1249758809854689",
    "post_id": "1249758809854689",
    "user_url": "https:\/\/www.facebook.com\/usopentennis",
    "user_username_raw": "US Open Tennis Championships",
    "content": "1️⃣0️⃣0️⃣ WINS AT ROLAND GARROS.",
    "date_posted": "2025-06-02T16:38:17.000Z",
    "hashtags": []
  },
  {
    "timestamp": "2026-07-22",
    "url": "https:\/\/www.facebook.com\/jakedunnekwch\/posts\/pfbid0DPd3b3TnqSXb9o6raSYcW91Un7ABhDX35sbRoC5TYDS2648CH69A3oZ6UtVG17WNl",
    "post_id": "1232841655320575",
    "user_url": "https:\/\/www.facebook.com\/jakedunnekwch",
    "user_username_raw": "Jake Dunne",
    "content": "The first snowfall of the season is now likely tonight and Monday\n\nWhile this will NOT be a crippling storm, it will mai...",
    "date_posted": "2025-11-30T13:38:01.000Z",
    "hashtags": []
  },
  {
    "timestamp": "2026-07-22",
    "url": "https:\/\/www.facebook.com\/icc\/posts\/1241600161335026",
    "post_id": "1282683763554057",
    "user_url": "https:\/\/www.facebook.com\/icc",
    "user_username_raw": "ICC - International Cricket Council",
    "content": "Powerful and crisp from Harmanpreet Kaur 😲\n\nClick here to find out how to watch her in action at #CWC25 ➡️ http:\/\/bit.l...",
    "date_posted": "2025-09-30T04:29:13.000Z",
    "hashtags": [
      "cwc25"
    ]
  },
  {
    "timestamp": "2026-07-22",
    "url": "https:\/\/www.facebook.com\/NJDevils\/posts\/1440759063744465",
    "post_id": "1440759063744465",
    "user_url": "https:\/\/www.facebook.com\/NJDevils",
    "user_username_raw": "New Jersey Devils",
    "content": "That\u0027s our prospect. That\u0027s our Beanpot Champ. 🏆\n\n#NJDevils | Verizon",
    "date_posted": "2025-02-12T18:21:22.000Z",
    "hashtags": [
      "njdevils"
    ]
  },
  {
    "timestamp": "2025-06-27",
    "url": "https:\/\/www.facebook.com\/share\/r\/1Bse8AkmeG\/",
    "post_id": "122128263932661753",
    "user_url": "https:\/\/www.facebook.com\/people\/the-good-netizen\/61569852604555\/",
    "user_username_raw": "the good netizen ",
    "content": "Bagian 300 | saya kira seragam pabrik pak 🤣\n\n#thegoodnetizen #komedi #Reels",
    "date_posted": "2025-05-04T12:23:28.000Z",
    "hashtags": null
  }
]
Llamada a la API de scraper
curl -H "Authorization: Bearer API_TOKEN" -H "Content-Type: application/json" -d '[{"url":"https://www.amazon.com/Quencher-FlowState-Stainless-Insulated-Smoothie/dp/B0CRMZHDG8","asin":"B0CRMZHDG8","origin_url":"https://www.amazon.com/Quencher-FlowState-Stainless-Insulated-Smoothie/dp/B0CRMZHDG8","zipcode":"94107","language":""},{"url":"https://www.amazon.com/KitchenAid-Protective-Dishwasher-Stainless-8-72-Inch/dp/B07PZF3QS3","asin":"B07PZF3QS3","zipcode":"","language":""},{"url":"https://www.amazon.com/TruSkin-Naturals-Vitamin-Topical-Hyaluronic/dp/B01M4MCUAF","asin":"","origin_url":"https://www.amazon.com/TruSkin-Naturals-Vitamin-Topical-Hyaluronic/dp/B01M4MCUAF","zipcode":"94124","language":""}]' "https://api.brightdata.com/datasets/v3/trigger?dataset_id=gd_l7q7dkf244hwjntr0&format=json&uncompressed_webhook=true"
Carga útil de respuesta
[
  {
    "timestamp": "2026-10-14",
    "title": "IMPASSE 9: ESCUELAS DE FORMACION DE COMISARIOS: PERSPECTIVAS Y DE CEPCIONES",
    "seller_name": null,
    "brand": "VVAA",
    "description": null,
    "initial_price": null,
    "currency": "USD",
    "availability": null
  },
  {
    "timestamp": "2026-10-14",
    "title": "Pizarro (Art Library) (2010) ISBN: 489013641X [Japanese Import]",
    "seller_name": null,
    "brand": "Christopher Lloyd",
    "description": "Camille Pissarro (1830-1903) was not only a central figure in the Impressionist movement but a major influence on the de...",
    "initial_price": null,
    "currency": "USD",
    "availability": "Currently unavailable. We don\u0027t know when or if this item will be back in stock."
  },
  {
    "timestamp": "2026-10-14",
    "title": "Cleared for Takeoff (Funcles \u0026 Faunties™)",
    "seller_name": null,
    "brand": "Mary Moccia, Jessica Gamboa",
    "description": "Cleared for Takeoff is the first book in the Funcles \u0026 Faunties™ series, celebrating the bonds between two curious child...",
    "initial_price": 2.99,
    "currency": "USD",
    "availability": null
  },
  {
    "timestamp": "2026-10-14",
    "title": "Shanghai · English exam - 上海中考·英语",
    "seller_name": "Chinese C*****e S***e **",
    "brand": "水纯",
    "description": "《上海中考》系列一共涉及语文、数学、英语、化学和物理五个科目。每科目图书分两册:一册为讲解篇,全面讲解中考考点,并配有经典例题讲解和少量针对性习题;另一册为集训篇,按讲解的考点顺序安排强化练习,巩固考点。两册图书配合使用,适合中考第-轮复习...",
    "initial_price": 59.58,
    "currency": "USD",
    "availability": "Only 1 left in stock - order soon."
  },
  {
    "timestamp": "2026-10-14",
    "title": "Los costes del nuevo procedimiento concursal (Spanish Edition)",
    "seller_name": "Cho***ook***",
    "brand": "María Ull",
    "description": null,
    "initial_price": null,
    "currency": "USD",
    "availability": "Only 1 left in stock - order soon."
  }
]
TERMINAL
Tell your agent:
Read https://brightdata.com/SKILL.md and get structured JSON for this Instagram post via the instagram_posts pipeline: https://www.instagram.com/p/Cuf4s0MNqNrOr run it yourself:
npx -p @brightdata/cli bdata loginbdata pipelines instagram_posts "https://www.instagram.com/p/Cuf4s0MNqNr"Or connect over MCP:
https://mcp.brightdata.com/mcp?token=YOUR_API_KEY
Para agentes de código
Integra scrapers de imágenes en tu agente
Tu agente elige entre los scrapers de imágenes que ya mantenemos. Déjalo ejecutarse cuando lo necesites, y cada ejecución entrega datos web en tiempo real directo a tu almacenamiento. Funciona en Claude Code, Codex, Cursor y cualquier otro agente de código.
- Se ejecuta con npx, nada que instalar
- bdata login abre autenticación en navegador, sin clave que pegar
- Nombra un scraper, recibe JSON de vuelta
- Entrega a AWS · GCP · Azure · Snowflake · Webhook
Todo lo que necesitas, integrado
Pagas por resultados. Proxies, renderizado, concurrencia y entrega siempre incluidos en cada plan.

Ve directo a la fuente
Cada solicitud se ejecuta en la infraestructura de Bright Data. Más de 400 millones de IPs, desbloqueo y navegadores integrados.

Escala a millones de páginas al instante
Envía solicitudes concurrentes ilimitadas: sin infraestructura que gestionar, sin configuraciones que cambiar.

Los Scrapers se reparan automáticamente cuando los sitios cambian
La autocorrección impulsada por IA detecta cambios en los sitios y repara los scrapers. Tus pipelines siguen funcionando.

Miles de scrapers verificados
Cada scraper es construido, probado y mantenido por Bright Data. Sin suposiciones de la comunidad.

Paga por resultado, sin extras
Un precio por registro. Proxies, reintentos, renderizado, desbloqueo, todo incluido, sin sorpresas.

Compatible y con soporte completo
Cumplimiento GDPR y CCPA. Soporte humano 24/7 en cada plan, incluido el gratuito.
Empieza a recopilar datos de image en minutos
Llama a la API desde código, navega por el panel de control o délaselo a tu agente de IA.


Casos de uso
Casos de uso de scraping de datos de imágenes
Inteligencia de imágenes en tiempo real para tu negocio.
Recopilación de contenido visual
Fotos
Url
Fecha de publicación
Monitoreo de marca y creatividad
Fotos
Hashtags
Descripción
Análisis de interacción
Likes
Núm. comentarios
Fotos
Auditoría de imágenes de listados
Fotos
Url
Descripción
Compara Bright Data con otros
Web Scraper API vs otros proveedores
Capacidad
Bright Data
Otros proveedores de scraping
Infraestructura con autoescalado
Ilimitado
Parcial
Elusión de anti-bots y CAPTCHA
Integrado
Parcial
Red de proxies residenciales
Más de 400 M de IPs
Grupo limitado
Scrapers preconstruidos
Más de 1.400
50–200
Mantenimiento automático (cambios en el sitio)
24/7
Depende de quién lo haya creado
Modelo de precios
Un precio único por registro
Cálculo, proxy y almacenamiento medidos por separado
Solicitudes fallidas
Gratis, solo pagas por los éxitos
A menudo se cobran
Sitios personalizados (sin scraper preconstruido)
La IA lo construye en minutos, incluyendo autocuración
Scrapers creados por la comunidad, sin SLA
Cumplimiento normativo (GDPR, CCPA, SOC 2)
Completo
Parcial
Salida estructurada (JSON/CSV)
Automático
Soporte
Expertos disponibles 24/7, incluso en el plan gratuito
Foro de la comunidad
Plan gratuito
5 mil registros/mes
Varía
cumplimiento
Liderando el camino en la recopilación ética de datos web
Solo datos disponibles públicamente. Certificación ISO 27001, controles SOC 2, cumplimiento GDPR y CCPA. Cada caso de uso es revisado por un equipo dedicado de Cumplimiento y Ética, respaldado por un proceso documentado de verificación KYC y una Política de Uso Aceptable.

Bright Data es utilizado por las mejores marcas del mundo


Preguntas frecuentes sobre image Scraper API
¿Qué es la image Scraper API?
La image Scraper API es una herramienta potente diseñada para automatizar la extracción de datos del sitio web de image, permitiendo a los usuarios recopilar y procesar grandes volúmenes de datos de manera eficiente para diversos casos de uso.
¿Cómo funciona la image Scraper API?
La image Scraper API funciona enviando solicitudes automatizadas al sitio web objetivo, extrayendo los puntos de datos necesarios y entregándolos en un formato estructurado. Este proceso garantiza una recopilación de datos precisa y rápida.
¿La image Scraper API cumple con las normativas de protección de datos?
Sí, la image Scraper API está diseñada para cumplir con las normativas de protección de datos, incluyendo GDPR y CCPA. Garantiza que todas las actividades de recopilación de datos se realicen de manera ética y legal.
¿Puedo usar la image Scraper API para análisis competitivo?
¡Claro que sí! La image Scraper API es ideal para el análisis competitivo, permitiéndote obtener información sobre las actividades, tendencias y estrategias de tus competidores.
¿Cómo puedo integrar la image Scraper API con mis sistemas existentes?
La image Scraper API ofrece una integración perfecta con diversas plataformas y herramientas. Puedes usarla con tus flujos de datos existentes, sistemas CRM o herramientas de análisis para mejorar tus capacidades de procesamiento de datos.
¿Existe un nivel gratuito disponible para la image Scraper API?
¡Sí! Cada nueva cuenta de Bright Data incluye automáticamente 5,000 créditos gratuitos por mes (aproximadamente $7.50 en valor): sin tarjeta de crédito, sin código promocional, sin compromiso. Estos créditos se aplican a los Scrapers (incluyendo la image Scraper API), así como a la Unlocker API y la API SERP. Los créditos se renuevan el día 1 de cada mes, y puedes comenzar a hacer llamadas a la API inmediatamente después de registrarte.
¿Qué sucede cuando se agotan mis créditos gratuitos mientras uso la image Scraper API?
Cuando se agotan tus 5,000 créditos gratuitos mensuales, el comportamiento depende del saldo de tu cuenta. Si tienes fondos depositados previamente, el uso continúa sin interrupciones a las tarifas estándar de pago por uso. Si no tienes fondos depositados, las solicitudes devolverán un error hasta que agregues fondos o hasta que tus créditos se renueven el día 1 del mes siguiente. Ten en cuenta que los créditos gratuitos no utilizados no se acumulan.
Para evitar interrupciones, puedes habilitar la recarga automática en tu configuración de facturación en brightdata.com/cp/billing/settings.
¿Cuáles son los límites de uso para la image Scraper API?
No hay límites de uso específicos para la image Scraper API, lo que te ofrece la flexibilidad de escalar según sea necesario.
¿Ofrecen soporte para la image Scraper API?
Sí, ofrecemos soporte dedicado para la image Scraper API. Nuestro equipo de soporte está disponible 24/7 para ayudarte con cualquier pregunta o problema que puedas encontrar al usar la API.
¿Qué métodos de entrega están disponibles?
Amazon S3, Google Cloud Storage, Google PubSub, Microsoft Azure Storage, Snowflake y SFTP.
¿Qué formatos de archivo están disponibles?
JSON, NDJSON, JSON lines, CSV y archivos .gz (comprimidos).
¿Pueden los agentes de IA usar la image Scraper API?
Sí. Conecta cualquier agente a través del servidor MCP alojado, dirige un agente de codificación a brightdata.com/SKILL.md para que se configure solo, o usa la CLI. Los agentes se autentican una vez con OAuth del navegador y pueden ejecutar cualquiera de los scrapers de image.