Naver finalizó su API de búsqueda de Shopping el 31 de julio de 2026, sin reemplazo oficial. Los equipos aún necesitaban precios, rankings y nombres de vendedores de Naver Shopping y SmartStore, por lo que su principal opción era hacer scraping de las páginas de Naver.
En nuestras pruebas, los clientes HTTP simples obtuvieron resultados completos de las páginas de búsqueda de Naver. Sin embargo, las páginas de shopping de Naver devolvieron una página de bloqueo, un CAPTCHA o una redirección de inicio de sesión. Los datos seguían ahí, incrustados en esas páginas como JSON.
Esta guía muestra cómo leer ese JSON en Python, qué herramienta de Bright Data obtiene cada tipo de página, y cómo se factura cada herramienta.
TL;DR
- Haz scraping de las páginas de búsqueda de Naver con la API SERP de Bright Data. Lee precios desde
discountedSalePrice, porquesalePricefue 0 en 6 de 8 tarjetas de comparación de precios para 아이폰 17. - Usa Web Unlocker para resultados de Plus Store y Browser API para la paginación. Marca anuncios: ninguno de los primeros 6 listados para 코카콜라 제로 era orgánico.
- Reconstruye la mayoría de los campos de la API de Shopping desde la búsqueda de comparación de precios. Web Unlocker devolvió el JSON de la página, con
lowPrice,brandy categorías, en 10 de 10 consultas. - Envía URLs de productos de SmartStore a la Naver Shopping Scraper API. Un lote de 10 devolvió cada listado público, con precios que coincidían con cada página.
El fin de la API de búsqueda de Shopping de Naver
La Open API de Naver era la fuente de datos oficial para el monitoreo de precios y estanterías digitales. Su endpoint de búsqueda de Shopping devolvía hasta 100 productos por llamada y permitía 25K llamadas al día con una clave gratuita.
El aviso del centro de desarrolladores de Naver anunció que las APIs de búsqueda de Shopping, Book, y documentos de investigación terminarían el 31 de julio de 2026. El aviso decía que las claves existentes dejarían de funcionar sin periodo de gracia. También decía que Naver no proporcionaría ninguna API de reemplazo, ni siquiera en NAVER API HUB:
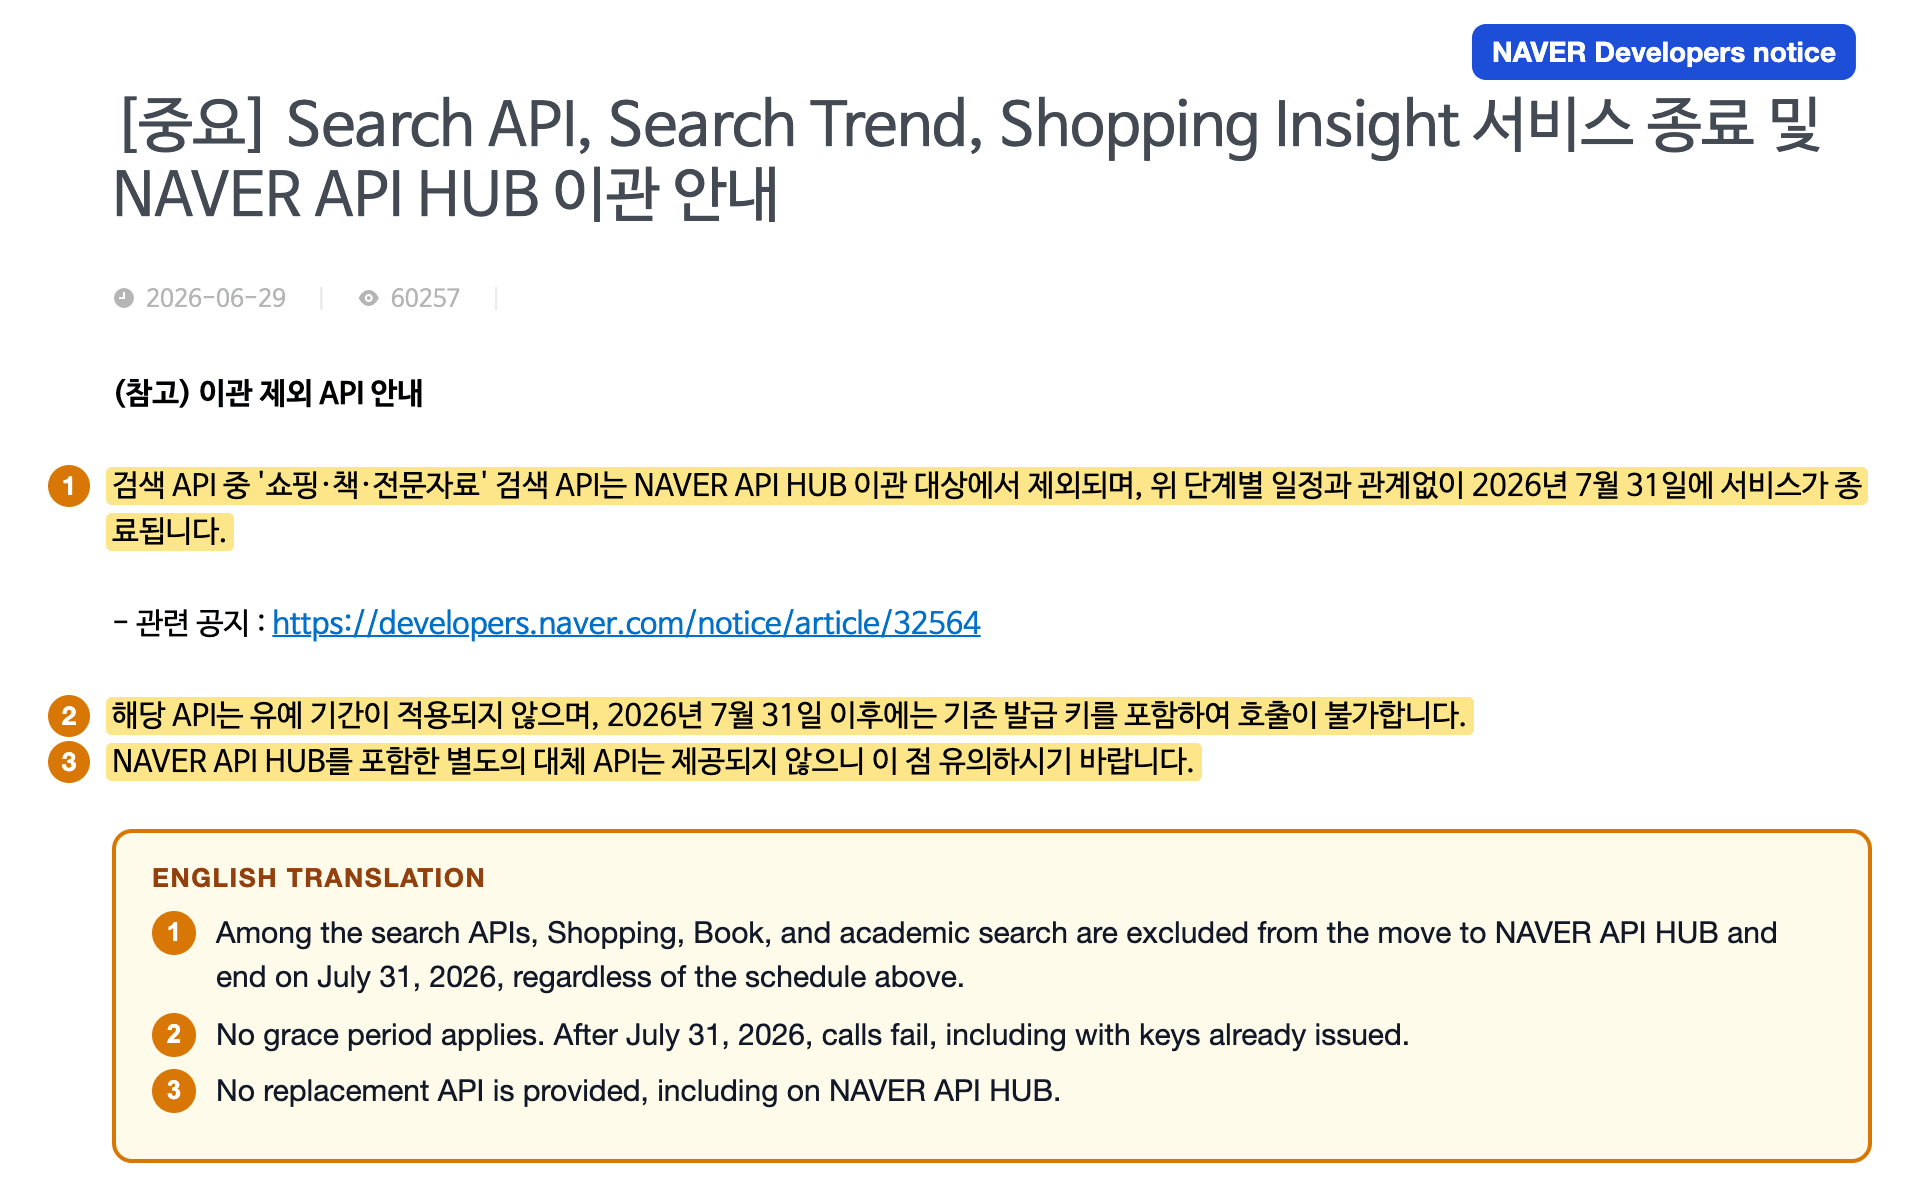
Con una fecha límite fija y sin periodo de gracia, los feeds que llamaban a esta API necesitaban una nueva fuente antes del 31 de julio de 2026.
El mismo aviso decía que las otras APIs de búsqueda, incluidas las de blog, noticias y documentos web, se trasladarían a NAVER API HUB en NAVER Cloud Platform. Las claves del centro de desarrolladores emitidas antes del 31 de julio de 2026 seguirían funcionando para estas APIs hasta el 30 de junio de 2027.
Según los términos de la Open API de Naver, esas APIs tampoco estaban pensadas para usarse como feed de monitoreo. Los términos prohibían copiar, almacenar o cachear resultados, excepto el cacheo temporal para continuidad del servicio. También prohibían proporcionar o vender resultados a terceros y usarlos como entrada o datos de entrenamiento para IA.
La API DataLab Shopping Insight de Naver devolvía tendencias de clics por categoría y palabra clave. Escalaba cada tendencia para que su punto más alto fuera 100. Estas tendencias mostraban si el interés subía o bajaba, pero no precios. Las páginas públicas de Naver mostraban precios, rankings y nombres de vendedores, así que recógelos ahí.
Cómo respondió cada propiedad de Naver a los scrapers
Probamos 4 clientes HTTP simples en cada una de 4 propiedades de Naver desde una conexión residencial en India. Las páginas de búsqueda y de hoteles devolvieron HTML completo, pero las páginas de shopping y de producto bloquearon esos clientes. Para las páginas bloqueadas, la tabla también incluye navegadores y desbloqueadores:
| Propiedad de Naver | Lo que obtuvieron los clientes HTTP simples | Lo que obtuvieron navegadores y desbloqueadores |
|---|---|---|
Búsqueda (search.naver.com) |
La página de resultados completa, unos 1.5 MB, incluso con el User-Agent predeterminado de python-requests | No fue necesario para cargar la página |
Búsqueda de Shopping (search.shopping.naver.com) |
Una página de bloqueo HTTP 418, una página CAPTCHA HTTP 405, o una redirección 307 a la página de inicio de sesión de Naver | Chrome headless obtuvo el 418, Chrome con interfaz obtuvo el CAPTCHA, y Web Unlocker obtuvo los resultados |
Productos de SmartStore (smartstore.naver.com) |
Una página HTTP 429 titulada “시스템오류” (“error del sistema”) en la primera solicitud | Web Unlocker y Browser API obtuvieron la página del producto |
Hoteles (hotels.naver.com) |
La página completa con sus datos de Next.js | No fue necesario para cargar la página |
La búsqueda de Naver devolvió resultados para las 500 solicitudes de prueba, sin CAPTCHA ni bloqueo. Las primeras 200 fueron secuenciales, espaciadas unos 2 segundos. Las otras 300 se enviaron como ráfaga a 4.9 solicitudes por segundo desde 8 workers concurrentes, y cada solicitud de ráfaga usó una sesión nueva.
La página 418 en la búsqueda de shopping decía que el acceso estaba temporalmente restringido. La página enumeraba 4 desencadenantes: visitas desde promociones externas no relacionadas con shopping, ráfagas de solicitudes desde una sola IP, IPs de VPN, y ciertas extensiones del navegador. La página 405 cargaba el propio script CAPTCHA de Naver desde ncpt.naver.com.
En Chrome con interfaz, la página 405 cargaba un módulo WebAssembly desde wtm.pstatic.net y enviaba una carga útil cifrada a ncpt.naver.com/v2/tokens. Luego la página mostraba un CAPTCHA de recibo: un recibo de tienda generado con una pregunta de completar el espacio en blanco sobre él.
Un cliente HTTP simple con el User-Agent de Chrome obtuvo el CAPTCHA 405 en lugar del 418. El CAPTCHA 405 seguía apareciendo después de que curl_cffi igualó la huella digital TLS y HTTP/2 de Chrome. Chrome headless obtuvo el 418 en su primera solicitud de documento, después de 0.5 segundos y antes de que se ejecutara cualquier script de la página. Ninguno de los 6 clientes, desde python-requests hasta Chrome con interfaz, obtuvo resultados de shopping.
El 429 de SmartStore aparecía en la primera solicitud de cada cliente nuevo, por lo que se comportaba más como un bloqueo que como un límite de velocidad típico. Su texto de error decía que la causa era tráfico intenso o una red inestable.
Recopila solo páginas que se cargan sin iniciar sesión. Los datos detrás de una redirección de inicio de sesión no son públicos, porque acceder a ellos requiere automatizar una cuenta de Naver. La política de uso aceptable de Bright Data también excluye los datos detrás de un inicio de sesión.
Trata cada propiedad como un objetivo separado.
El JSON incrustado en cada página de Naver
Cada página de Naver que probamos tenía sus datos en el HTML como JSON o un objeto JavaScript, así que los parsers no necesitan selectores CSS. En la página de resultados de búsqueda, los datos de cada bloque de shopping se asignaban a su propia variable JavaScript:
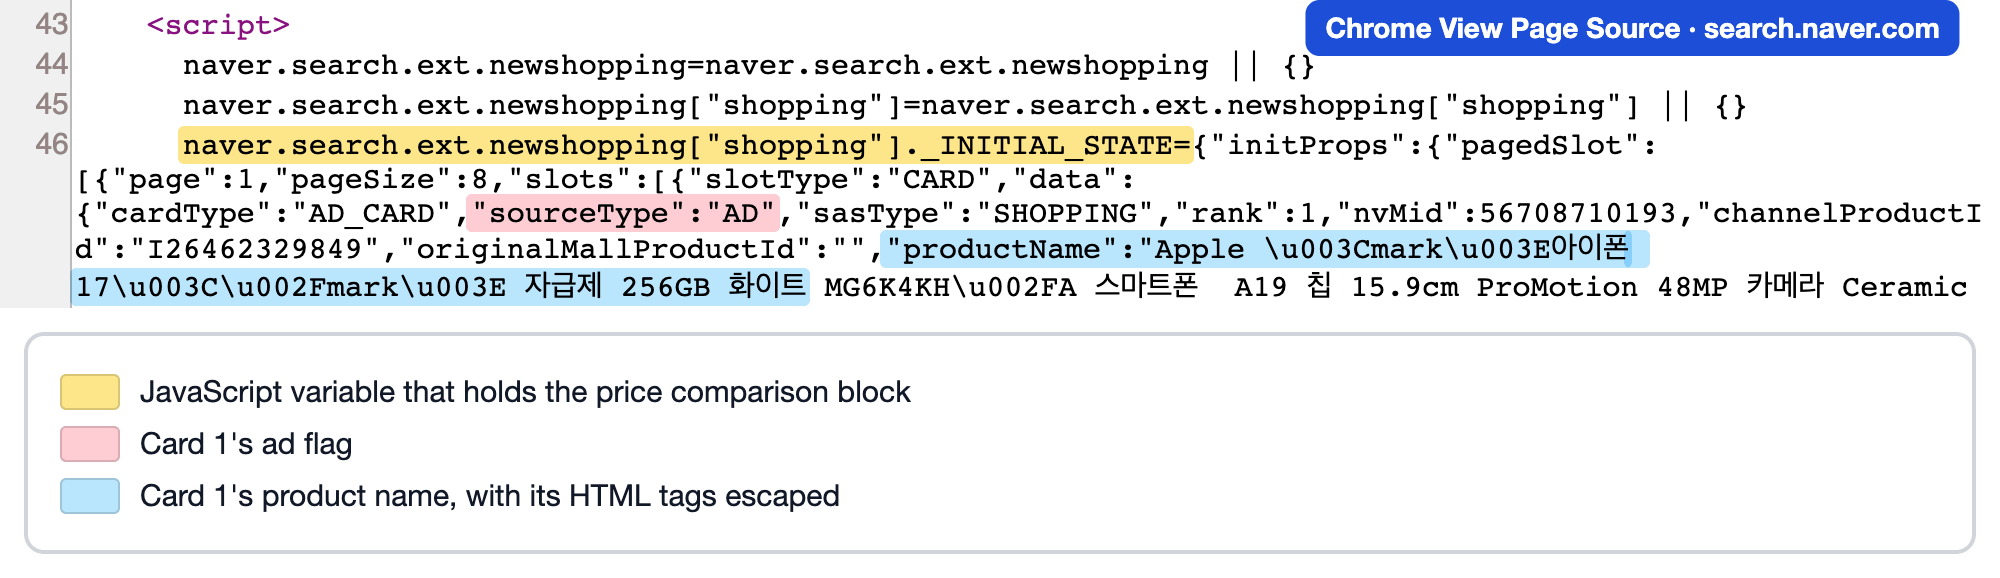
Los datos del bloque de comparación de precios eran un único objeto JSON, por lo que una sola llamada al decodificador lee cada tarjeta en él. En Ver código fuente de la página, esa asignación era una sola línea de 32,182 caracteres.
Cada página almacenaba su JSON en un lugar diferente, y cada página tenía su propio problema de parseo:
| Página | Ubicación del JSON | Problema de parseo |
|---|---|---|
| Resultados de búsqueda | Un objeto _INITIAL_STATE en naver.search.ext.newshopping["shopping"], y otro en ["nstore"] |
salePrice fue 0 en 6 de las 8 tarjetas de comparación de precios para 아이폰 17. El precio mostrado estaba en discountedSalePrice. |
Búsqueda de Plus Store (/ns/search) |
Fragmentos de React Server Component enviados con self.__next_f.push, bajo la clave initPagedCompositeCards |
Las comillas del JSON estaban escapadas dentro del HTML, así que une y decodifica los fragmentos antes de buscarlos. |
Búsqueda de comparación de precios (/search/all) |
__NEXT_DATA__, en props.pageProps.compositeList.list[].item |
price era una cadena, mientras que lowPrice era un entero, así que convierte price a número antes de usarlo. |
| Producto de SmartStore | window.__PRELOADED_STATE__, en simpleProductForDetailPage |
El objeto no era JSON estricto, y la clave product de nivel superior contenía ceros. |
Cuando un parser empieza a devolver nada, revisa primero estas rutas.
Parsea el JSON incluso cuando la página renderizada parezca más fácil de leer. La página de Naver limitaba el recuento de reseñas mostrado de un listado de Apple a “9,999+”. El JSON incrustado para el mismo listado contenía el recuento exacto, 13,971.
El estado de SmartStore necesitaba 3 comprobaciones adicionales. En una página de producto, el estado era un literal de objeto JavaScript con 34 valores undefined sin comillas, así que json.loads generaba un error. El id del producto coincidía con el número en la URL, pero el productNo interno era un número diferente, así que usa id como el ID del producto. La página también tenía 2 recuentos de reseñas, uno para el producto y otro mayor para su grupo de productos.
La función siguiente normaliza el objeto y separa los listados activos de los eliminados:
import json
import re

MARKER = "window.__PRELOADED_STATE__="


def smartstore_product(html: str) -> dict | None:
    start = html.index(MARKER) + len(MARKER)
    # The state is a JavaScript object literal, and bare undefined values break json
    text = re.sub(r"(?<=[:\[,])undefined(?=[,\]}])", "null", html[start:])
    state, _ = json.JSONDecoder().raw_decode(text)
    product = state["simpleProductForDetailPage"]
    # None for a deleted listing, an empty id for one behind an authorization check
    return product if product and product.get("id") else None
La URL de un producto eliminado seguía devolviendo una página normal, titulada “상품이 존재하지 않습니다” (“el producto no existe”). Por lo que una comprobación del código de estado trataba esa página como un listado activo. La función devuelve None para esa página y para listados detrás de una comprobación de autorización. Trata un resultado None como la señal para eliminar la URL de tu lista de seguimiento.
Configura Bright Data para Naver
Cuatro scripts llaman a las APIs REST de Bright Data con requests, y el script de paginación controla un navegador en la nube con Playwright. Necesitas:
- Una cuenta de Bright Data y una clave API desde la configuración de la cuenta.
- Una zona de SERP API, una zona de Web Unlocker, y una zona de Browser API. Una zona es la configuración de un producto en el panel de control, y los scripts usan su nombre. La Naver Shopping Scraper API solo necesita la clave API.
- Python 3.10 o más reciente con
requestsyplaywright. El script de paginación conecta Playwright a un navegador remoto, así que no necesitas descargar uno local.
Por seguridad, una zona puede aceptar solicitudes solo desde las direcciones en su Lista blanca de IP. Si las solicitudes a tu zona devuelven ip_forbidden, añade la IP de tu máquina a esa lista.
Instala los paquetes y exporta tus credenciales:
pip install requests playwright
export BRIGHTDATA_API_KEY="your_api_key"
export BRIGHTDATA_SERP_ZONE="your_serp_zone"
export BRIGHTDATA_UNLOCKER_ZONE="your_unlocker_zone"
export BRIGHTDATA_BROWSER_WSS="wss://brd-customer-<id>-zone-<zone>-country-kr:<password>@brd.superproxy.io:9222"
El valor BRIGHTDATA_BROWSER_WSS es la URL de WebSocket que se muestra en Puppeteer / Playwright en los Detalles de acceso de tu zona:
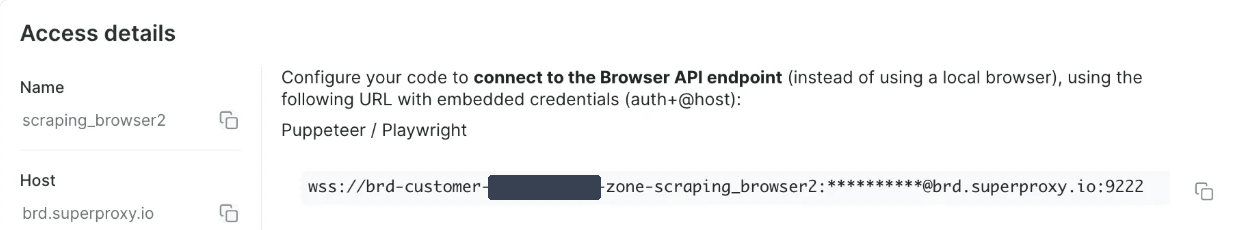
La URL ya incluye el nombre de usuario y la contraseña de la zona.
Añade -country-kr después del nombre de la zona para enrutar solicitudes a través de IPs coreanas. Si prefieres un SDK en lugar de HTTP sin procesar, instala el SDK de Python de Bright Data, brightdata-sdk.
Para verificar una sola URL antes de escribir código, usa el CLI de Bright Data, que obtiene la URL a través de Web Unlocker:
bdata scrape "https://smartstore.naver.com/acnope/products/10444371682" --country kr -f html -o product.htmlEl comando guardó la página completa del producto de SmartStore, así que smartstore_product(open("product.html", encoding="utf-8").read()) devuelve sus datos de producto.
Scraping de resultados de shopping desde la búsqueda de Naver con la API SERP
Para 아이폰 17 (iPhone 17), la página de resultados de escritorio de Naver mostraba 2 bloques de shopping, uno con tarjetas de comparación de precios y otro con productos de Naver Plus Store:
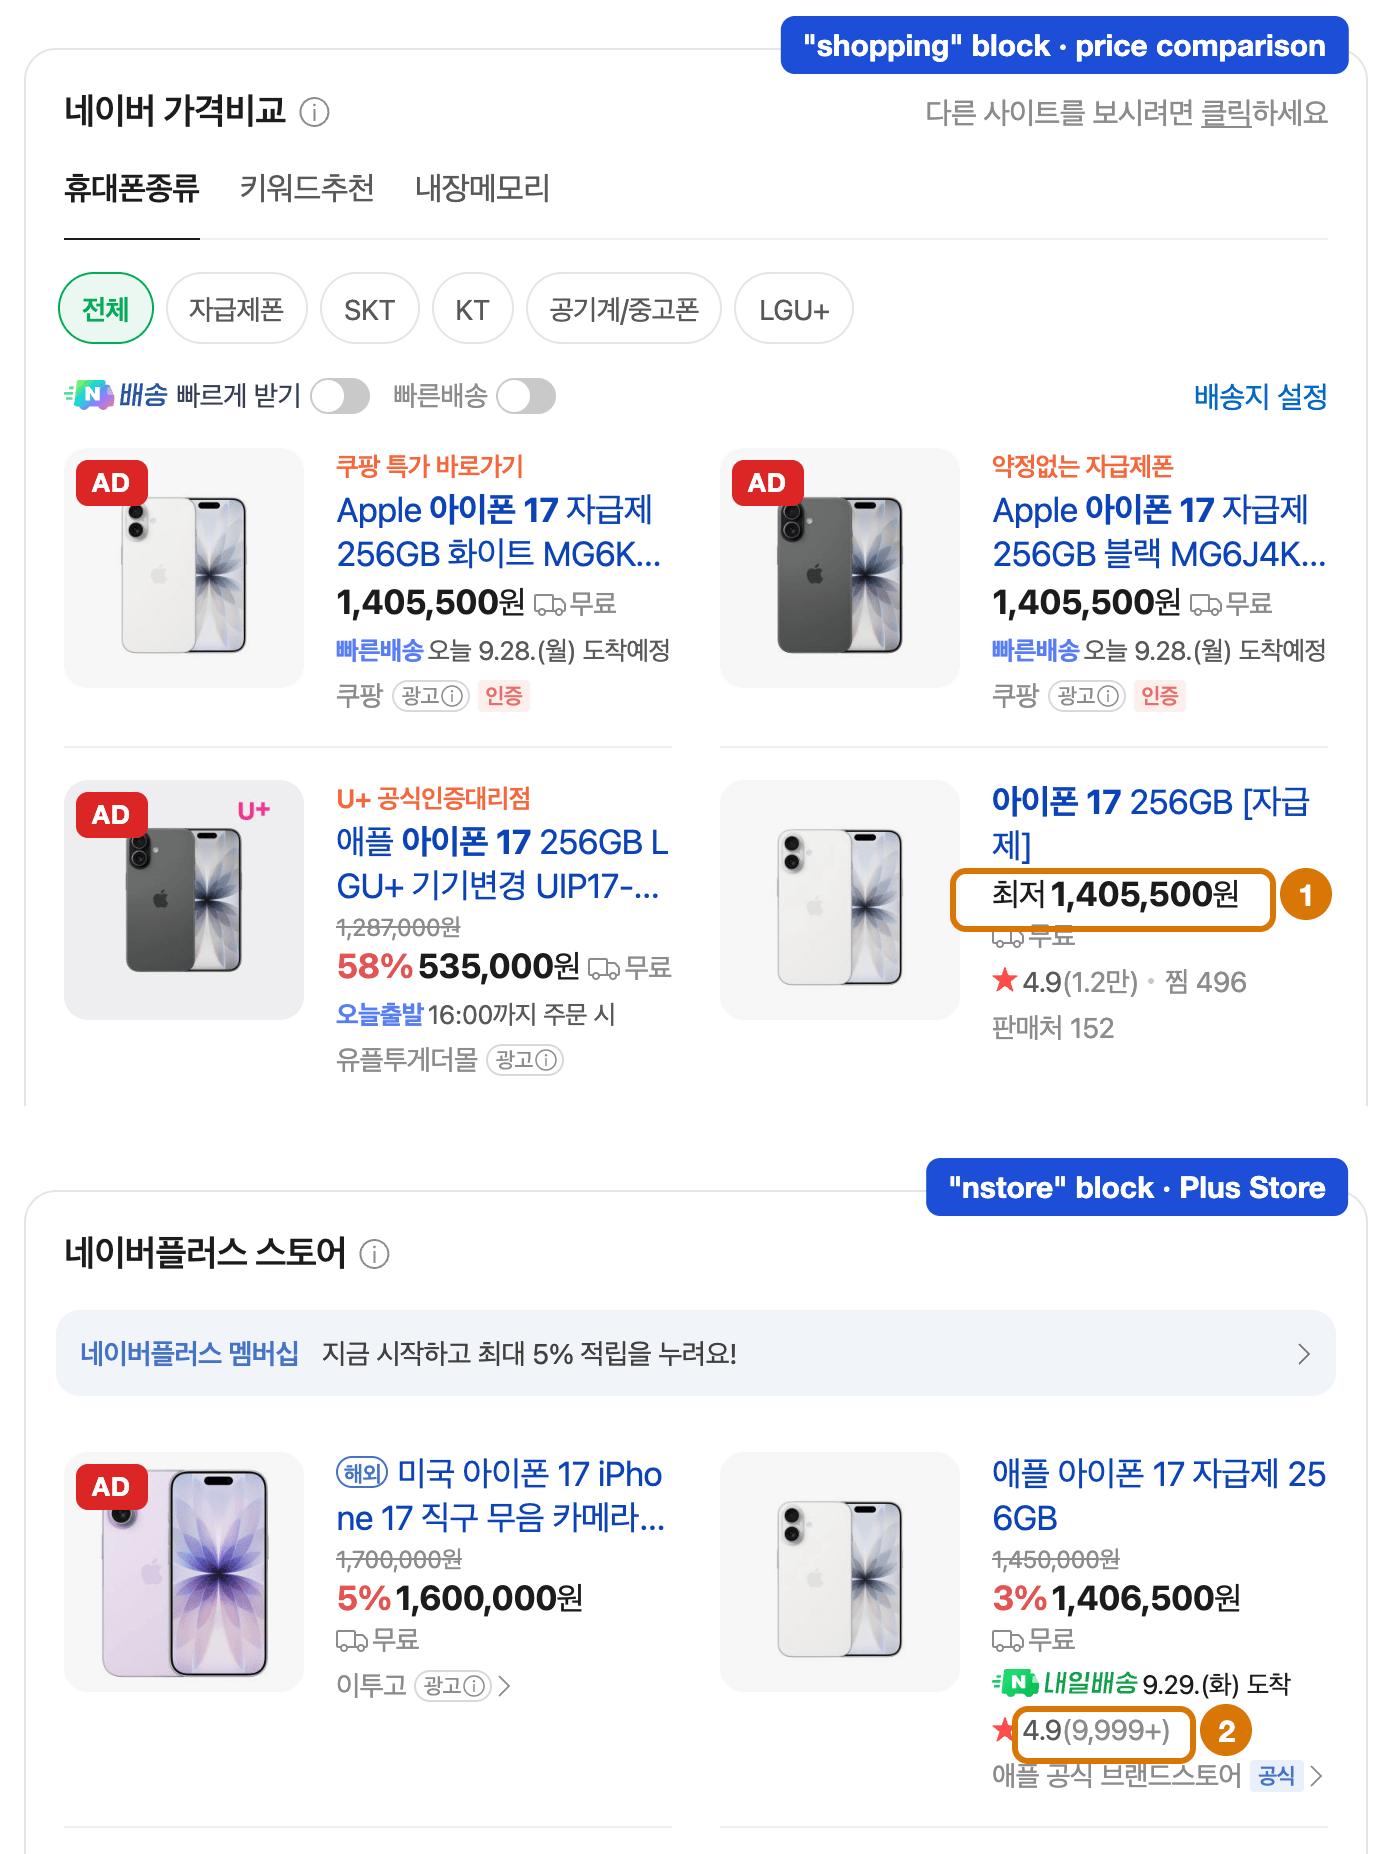
Las etiquetas rojas marcan las tarjetas que Naver etiquetó como 광고 (anuncio), que el parser marca como is_ad. En el marcador 1, la tarjeta mostraba 1,405,500원, mientras que su campo salePrice era 0. En el marcador 2, el recuento de reseñas mostraba 9,999+, mientras que el JSON contenía 13,971.
Usa la API SERP para páginas de resultados de motores de búsqueda (SERPs), incluido Naver, y Web Unlocker para otros sitios. La API SERP factura por solicitud exitosa.
Naver geolocalizó las solicitudes de la API SERP en Corea. Su JSON incrustado registró KR para esas solicitudes, y registró IN con una ciudad india para solicitudes directas desde India.
Para Naver, configura el formato de datos de la zona en HTML sin procesar, o pasa "data_format": "html" en cada solicitud:
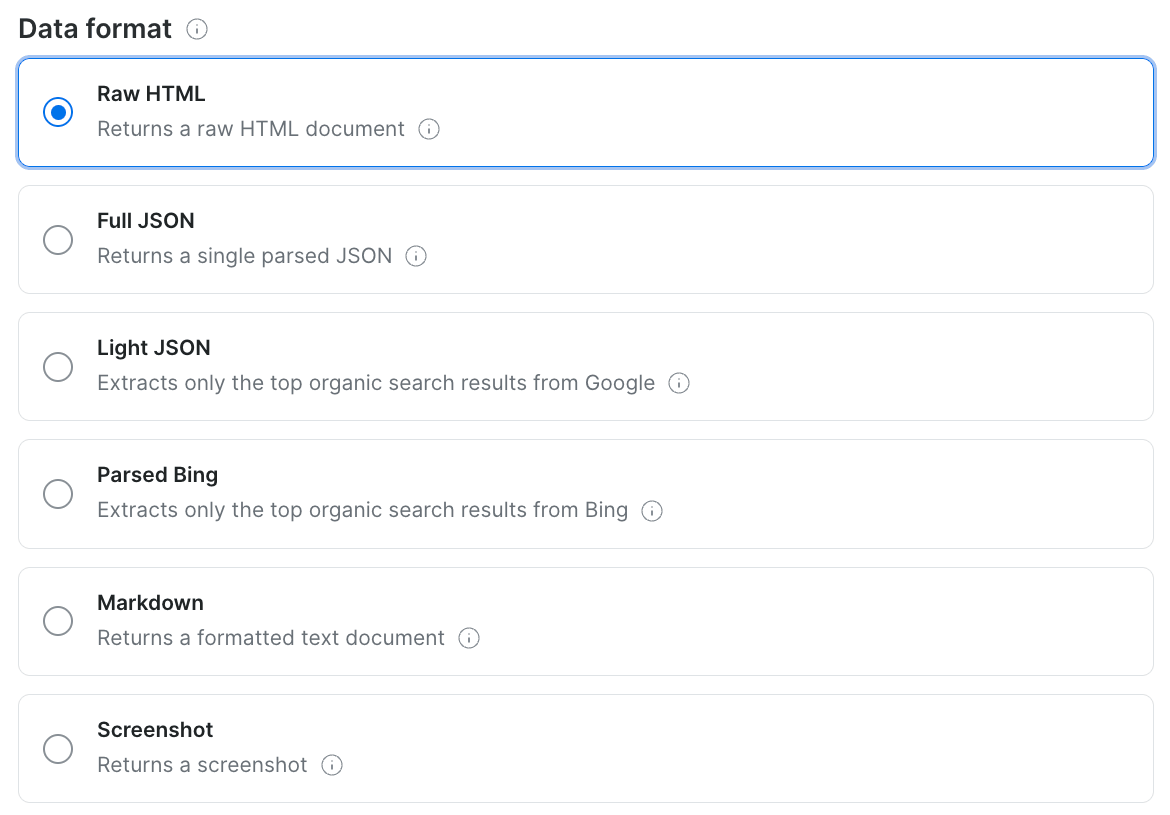
HTML sin procesar devolvió la página de resultados completa, incluido el JSON de shopping incrustado de Naver.
El script siguiente obtiene una página de resultados y devuelve cada tarjeta de ambos bloques de shopping, con los anuncios marcados:
import json
import os
import re
from urllib.parse import quote

import requests

API_URL = "https://api.brightdata.com/request"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
SERP_ZONE = os.environ["BRIGHTDATA_SERP_ZONE"]

# Each shopping block on the results page assigns its data to a JS global
STATE = re.compile(r'naver\.search\.ext\.newshopping\["(\w+)"\]\._INITIAL_STATE\s*=\s*')


def fetch_naver_serp(query: str) -> str:
    url = f"https://search.naver.com/search.naver?where=nexearch&query={quote(query)}"
    resp = requests.post(
        API_URL,
        headers=HEADERS,
        # Request the raw page, which contains Naver's embedded shopping JSON
        json={"zone": SERP_ZONE, "url": url, "format": "raw", "data_format": "html"},
        timeout=120,
    )
    resp.raise_for_status()
    if resp.headers.get("x-brd-error") or "_INITIAL_STATE" not in resp.text:
        raise RuntimeError(f"No shopping state for {query!r}: {resp.headers.get('x-brd-error')}")
    return resp.text


def parse_shopping_blocks(html: str) -> list[dict]:
    decoder = json.JSONDecoder()
    rows = []
    for match in STATE.finditer(html):
        block = match.group(1)  # "shopping" = price comparison, "nstore" = Plus Store
        state, _ = decoder.raw_decode(html, match.end())
        props = state["initProps"]
        if block == "shopping":
            items = [slot["data"] for page in props["pagedSlot"] for slot in page["slots"]]
        else:
            items = props["products"]
        for position, item in enumerate(items, start=1):
            rows.append({
                "block": block,
                "position": position,
                "is_ad": item.get("sourceType") == "AD",
                "name": re.sub(r"<[^>]+>", "", item.get("productName", "")),
                # discountedSalePrice holds the displayed price, and salePrice can be 0
                "price": item.get("discountedSalePrice") or item.get("salePrice"),
                "mall": item.get("mallName") or None,
                "reviews": item.get("totalReviewCount"),
                "nv_mid": item.get("nvMid"),
                "channel_product_id": item.get("channelProductId"),
            })
    return rows


if __name__ == "__main__":
    for row in parse_shopping_blocks(fetch_naver_serp("아이폰 17")):
        label = "ad" if row["is_ad"] else "  "
        print(f'{row["block"]:<8} {row["position"]} {label} {row["price"]:>9,} KRW  '
              f'{row["mall"] or "(catalog)":<12} {row["name"][:24]}')
Para 아이폰 17, el script imprimió 8 tarjetas de comparación de precios y 4 productos de Plus Store:
shopping 1 ad 1,405,500 KRW  쿠팡           Apple 아이폰 17 자급제 256GB 화
shopping 2 ad 1,405,500 KRW  쿠팡           Apple 아이폰 17 자급제 256GB 블
shopping 3 ad   535,000 KRW  유플투게더몰       애플 아이폰 17 256GB LGU+ 기기변
shopping 4    1,405,500 KRW  (catalog)    아이폰 17 256GB [자급제]
shopping 5    1,713,000 KRW  (catalog)    아이폰 17 프로 256GB [자급제]
shopping 6    2,006,400 KRW  (catalog)    아이폰 17 프로 512GB [자급제]
shopping 7       29,600 KRW  로트박스         [대여] 애플 아이폰 17 프로 대여 렌탈
shopping 8    2,294,400 KRW  (catalog)    아이폰 17 프로 1TB [자급제]
nstore   1 ad 1,600,000 KRW  이투고          미국 아이폰 17 iPhone 17 직구 무
nstore   2    1,406,500 KRW  애플 공식 브랜드스토어 애플 아이폰 17 자급제
nstore   3    1,790,000 KRW  애플 공식 브랜드스토어 애플 아이폰 17 프로 자급제
nstore   4    1,697,500 KRW  애플 공식 브랜드스토어 애플 아이폰 17 자급제
Las primeras 3 tarjetas eran anuncios, y la tercera mostraba un precio que requería un contrato con operadora, no el precio del teléfono libre. Las tarjetas de productos de catálogo no tenían valor mall y un channel_product_id vacío, porque apuntaban a las páginas de comparación de precios de Naver en lugar de a una sola tienda. En 10 consultas, la API SERP devolvió una página con el JSON de shopping 10 de 10 veces.
Entre 2 ejecuciones el mismo día, 2 posiciones de Plus Store se intercambiaron. Almacena una marca de tiempo y la bandera de anuncio con cada fila, y muestrea una palabra clave más de una vez antes de que tu informe de seguimiento de rankings reporte un cambio.
Scraping de resultados de búsqueda de Naver Plus Store con Web Unlocker
Naver lanzó Plus Store, una plataforma de shopping, en 2024. En su página de búsqueda, los clientes HTTP simples obtuvieron la página de bloqueo 418, el CAPTCHA 405, o la redirección de inicio de sesión.
Web Unlocker, el desbloqueador web automatizado de Bright Data, obtiene una URL y factura por solicitud exitosa. Con IPs coreanas, devolvió la página de búsqueda con sus primeras 50 tarjetas incrustadas. En 10 consultas, Web Unlocker devolvió una página de Plus Store que contenía los datos de resultados 10 de 10 veces.
La función de obtención siguiente solicita IPs coreanas, confirma que la respuesta contiene los datos de resultados, y reintenta con espera incremental:
import json
import os
import re
import time
from collections import Counter
from urllib.parse import quote

import requests

API_URL = "https://api.brightdata.com/request"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
UNLOCKER_ZONE = os.environ["BRIGHTDATA_UNLOCKER_ZONE"]

FLIGHT = re.compile(r"self\.__next_f\.push\((\[.*?\])\)</script>", re.S)
KEY = '"initPagedCompositeCards":'
MARKER = "initPagedCompositeCards"  # quotes are escaped inside the raw HTML


def fetch_plus_store_search(query: str, attempts: int = 3) -> str:
    url = f"https://search.shopping.naver.com/ns/search?query={quote(query)}"
    for attempt in range(1, attempts + 1):
        resp = requests.post(
            API_URL,
            headers=HEADERS,
            json={"zone": UNLOCKER_ZONE, "url": url, "format": "raw", "country": "kr"},
            timeout=180,
        )
        # Naver can redirect to a login page, so check for the result data, not the status
        if resp.ok and MARKER in resp.text:
            return resp.text
        reason = resp.headers.get("x-brd-error") or ("login wall" if "nidlogin" in resp.text else "no data")
        print(f"attempt {attempt} failed: {reason}")
        time.sleep(5 * attempt)
    raise RuntimeError(f"Plus Store search failed for {query!r}")


def parse_search(html: str) -> dict:
    # The page streams React Server Component data in string chunks
    chunks = [json.loads(m.group(1)) for m in FLIGHT.finditer(html)]
    flight = "".join(c[1] for c in chunks if len(c) == 2 and isinstance(c[1], str))
    start = flight.index(KEY) + len(KEY)
    result, _ = json.JSONDecoder().raw_decode(flight, start)
    products = []
    for card in result["data"]:
        item = card.get("card", {}).get("product")
        if not item:
            continue  # banners and promotion slots have no product
        products.append({
            "rank": len(products) + 1,
            "type": item.get("cardType") or "ORGANIC",
            "name": item.get("productName"),
            "price": item.get("discountedSalePrice"),
            "list_price": item.get("salePrice"),
            "mall": item.get("mallName"),
            "reviews": item.get("totalReviewCount"),
            "url": (item.get("productUrl") or {}).get("pcUrl"),
        })
    return {"total": result["total"], "next_cursor": result["cursor"], "products": products}


if __name__ == "__main__":
    page = parse_search(fetch_plus_store_search("코카콜라 제로"))
    mix = Counter(p["type"] for p in page["products"])
    print("total results:", page["total"], "| next cursor:", page["next_cursor"], "| page 1 mix:", dict(mix))
    for p in page["products"][:3] + [p for p in page["products"] if p["type"] == "ORGANIC"][:2]:
        print(json.dumps(p, ensure_ascii=False))
Para 코카콜라 제로 (Coke Zero), la página 1 tenía 47 productos entre sus 50 tarjetas, y el primer listado orgánico estaba en la posición 7:
total results: 7746 | next cursor: 33 | page 1 mix: {'AD': 12, 'SUPER_POINT': 2, 'ORGANIC': 31, 'SME_SLOT': 2}
{"rank": 1, "type": "AD", "name": "코카-콜라 제로 CAN 350ml 24개", "price": 21600, "list_price": 35290, "mall": "코카콜라직영몰", "reviews": 96956, "url": "https://smartstore.naver.com/main/products/4660954096"}
{"rank": 2, "type": "AD", "name": "코카-콜라 제로 CAN 190ml 30개", "price": 18000, "list_price": 24790, "mall": "코카콜라직영몰", "reviews": 46451, "url": "https://smartstore.naver.com/main/products/4609271837"}
{"rank": 3, "type": "AD", "name": "코카-콜라 제로 레몬라임 CAN 350ml 48개(2x24입) + 코크 큐브 블럭캘린더 (옵션선택)", "price": 38720, "list_price": 70580, "mall": "코카콜라직영몰", "reviews": 440, "url": "https://smartstore.naver.com/main/products/13689352448"}
{"rank": 7, "type": "ORGANIC", "name": "코카-콜라 제로 라벨프리 PET 370ml 24개", "price": 22880, "list_price": 35300, "mall": "코카콜라직영몰", "reviews": 25197, "url": "https://smartstore.naver.com/main/products/6006925665"}
{"rank": 8, "type": "ORGANIC", "name": "코카-콜라 제로 제로 라벨프리 PET 370ml 18개", "price": 16720, "list_price": 20900, "mall": "코카콜라직영몰", "reviews": 3676, "url": "https://smartstore.naver.com/main/products/11574172085"}
En la propia página, ninguna de las primeras 6 posiciones era un listado orgánico:
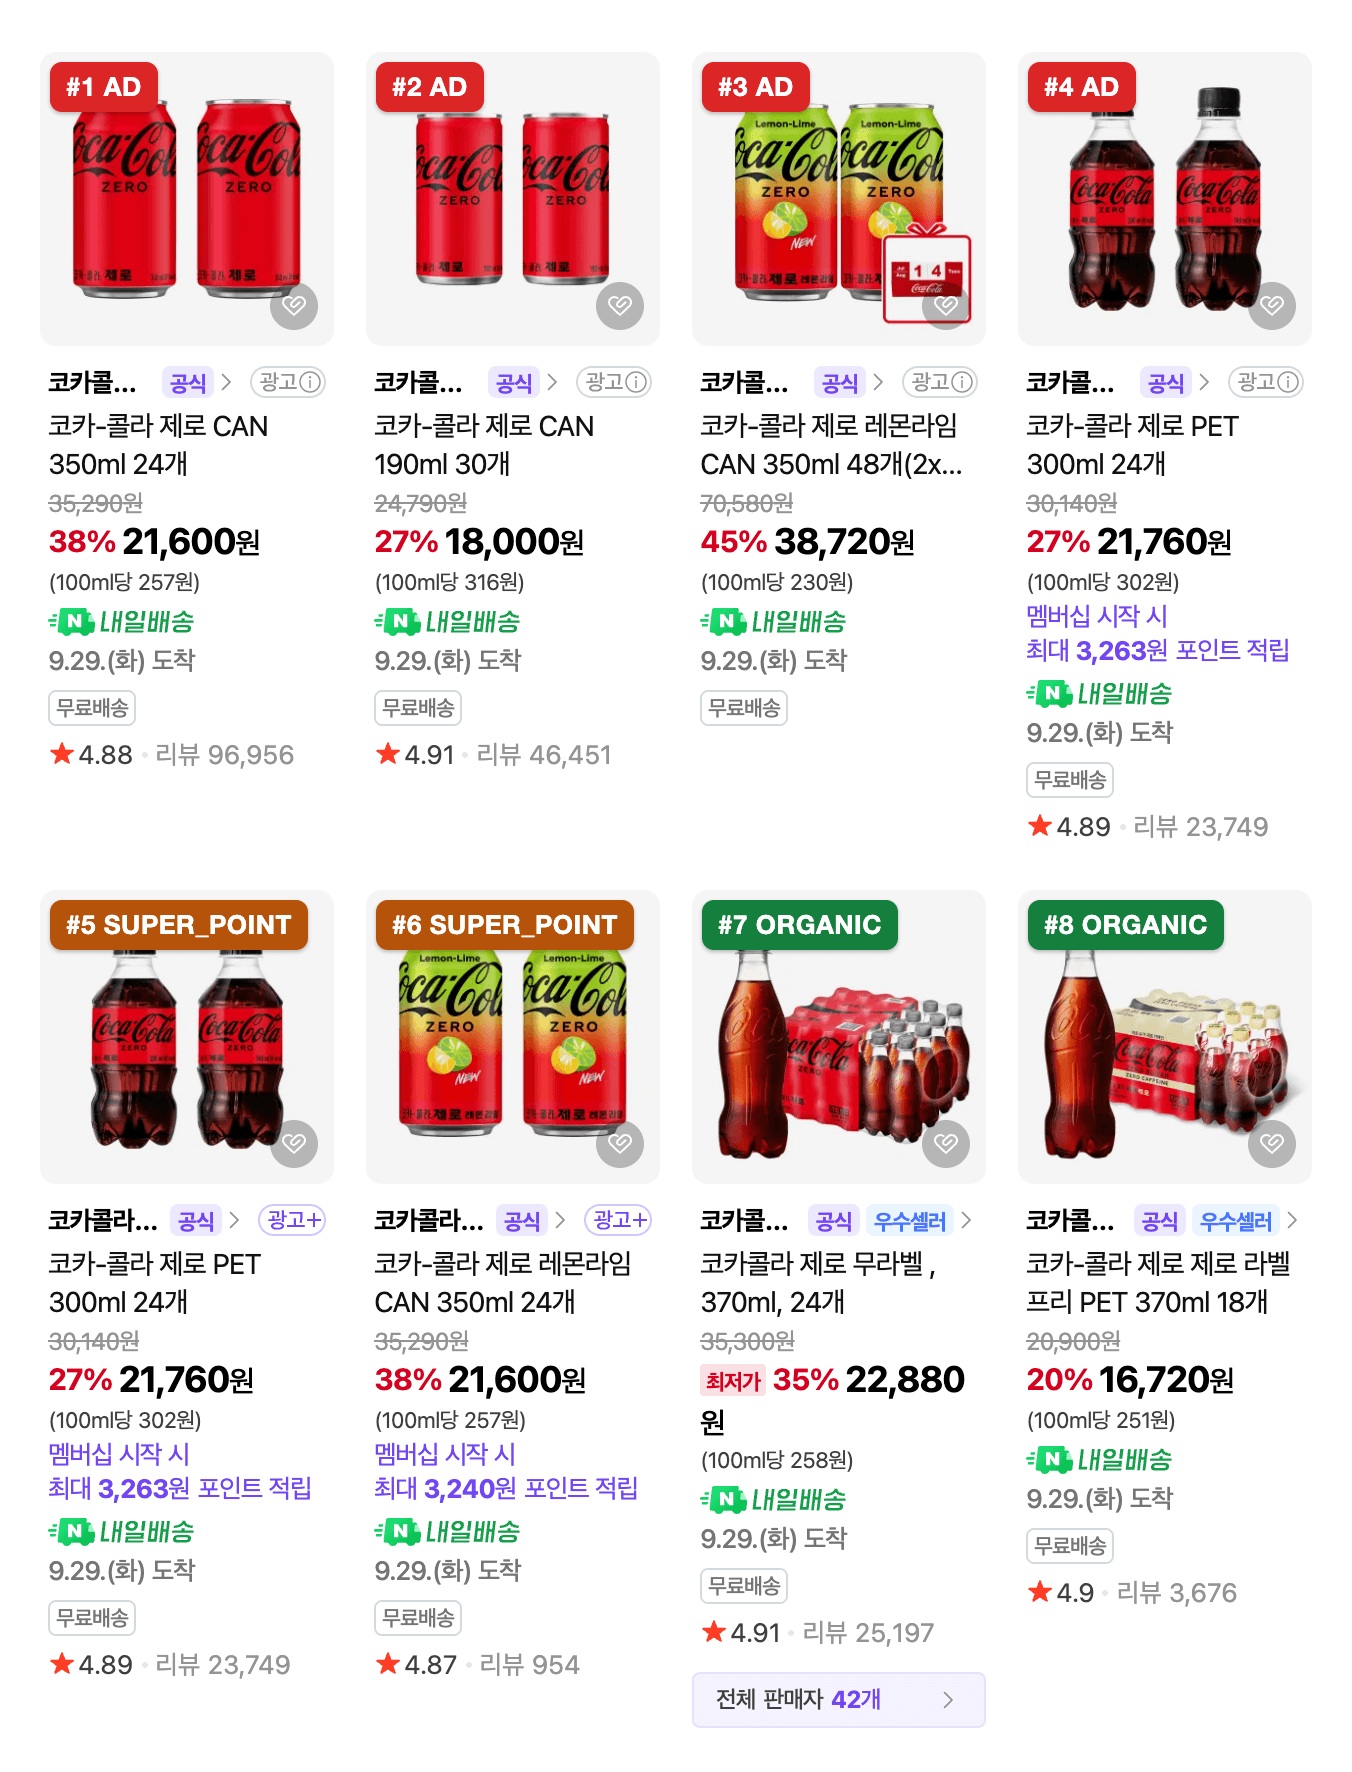
Naver marcó las posiciones 1 a 6 con etiquetas 광고 (anuncio), y el parser estableció su type en AD o SUPER_POINT.
Mantén type con cada fila, para que un informe de share-of-shelf separe anuncios y promociones de los listados orgánicos. Usa el número de producto en la URL de cada listado como el ID de producto. Los nombres son IDs poco fiables, porque en esta página, las 8 tarjetas vinculadas a un catálogo de Naver mostraban catalogName, no el productName almacenado.
Pagina resultados de búsqueda de Plus Store con Browser API
La página 1 de resultados de Plus Store estaba incrustada en el HTML, y el sitio cargaba las páginas 2 y siguientes con desplazamiento infinito. Esa es la diferencia entre Web Unlocker y Browser API: Web Unlocker devuelve una página, y Browser API puede desplazarla. Cuando un comprador se desplazaba, la página solicitaba /ns/v1/search/paged-composite-cards con un cursor, y cada solicitud llevaba un encabezado x-wtm-ncaptcha-token. La página generaba un token nuevo para cada llamada:
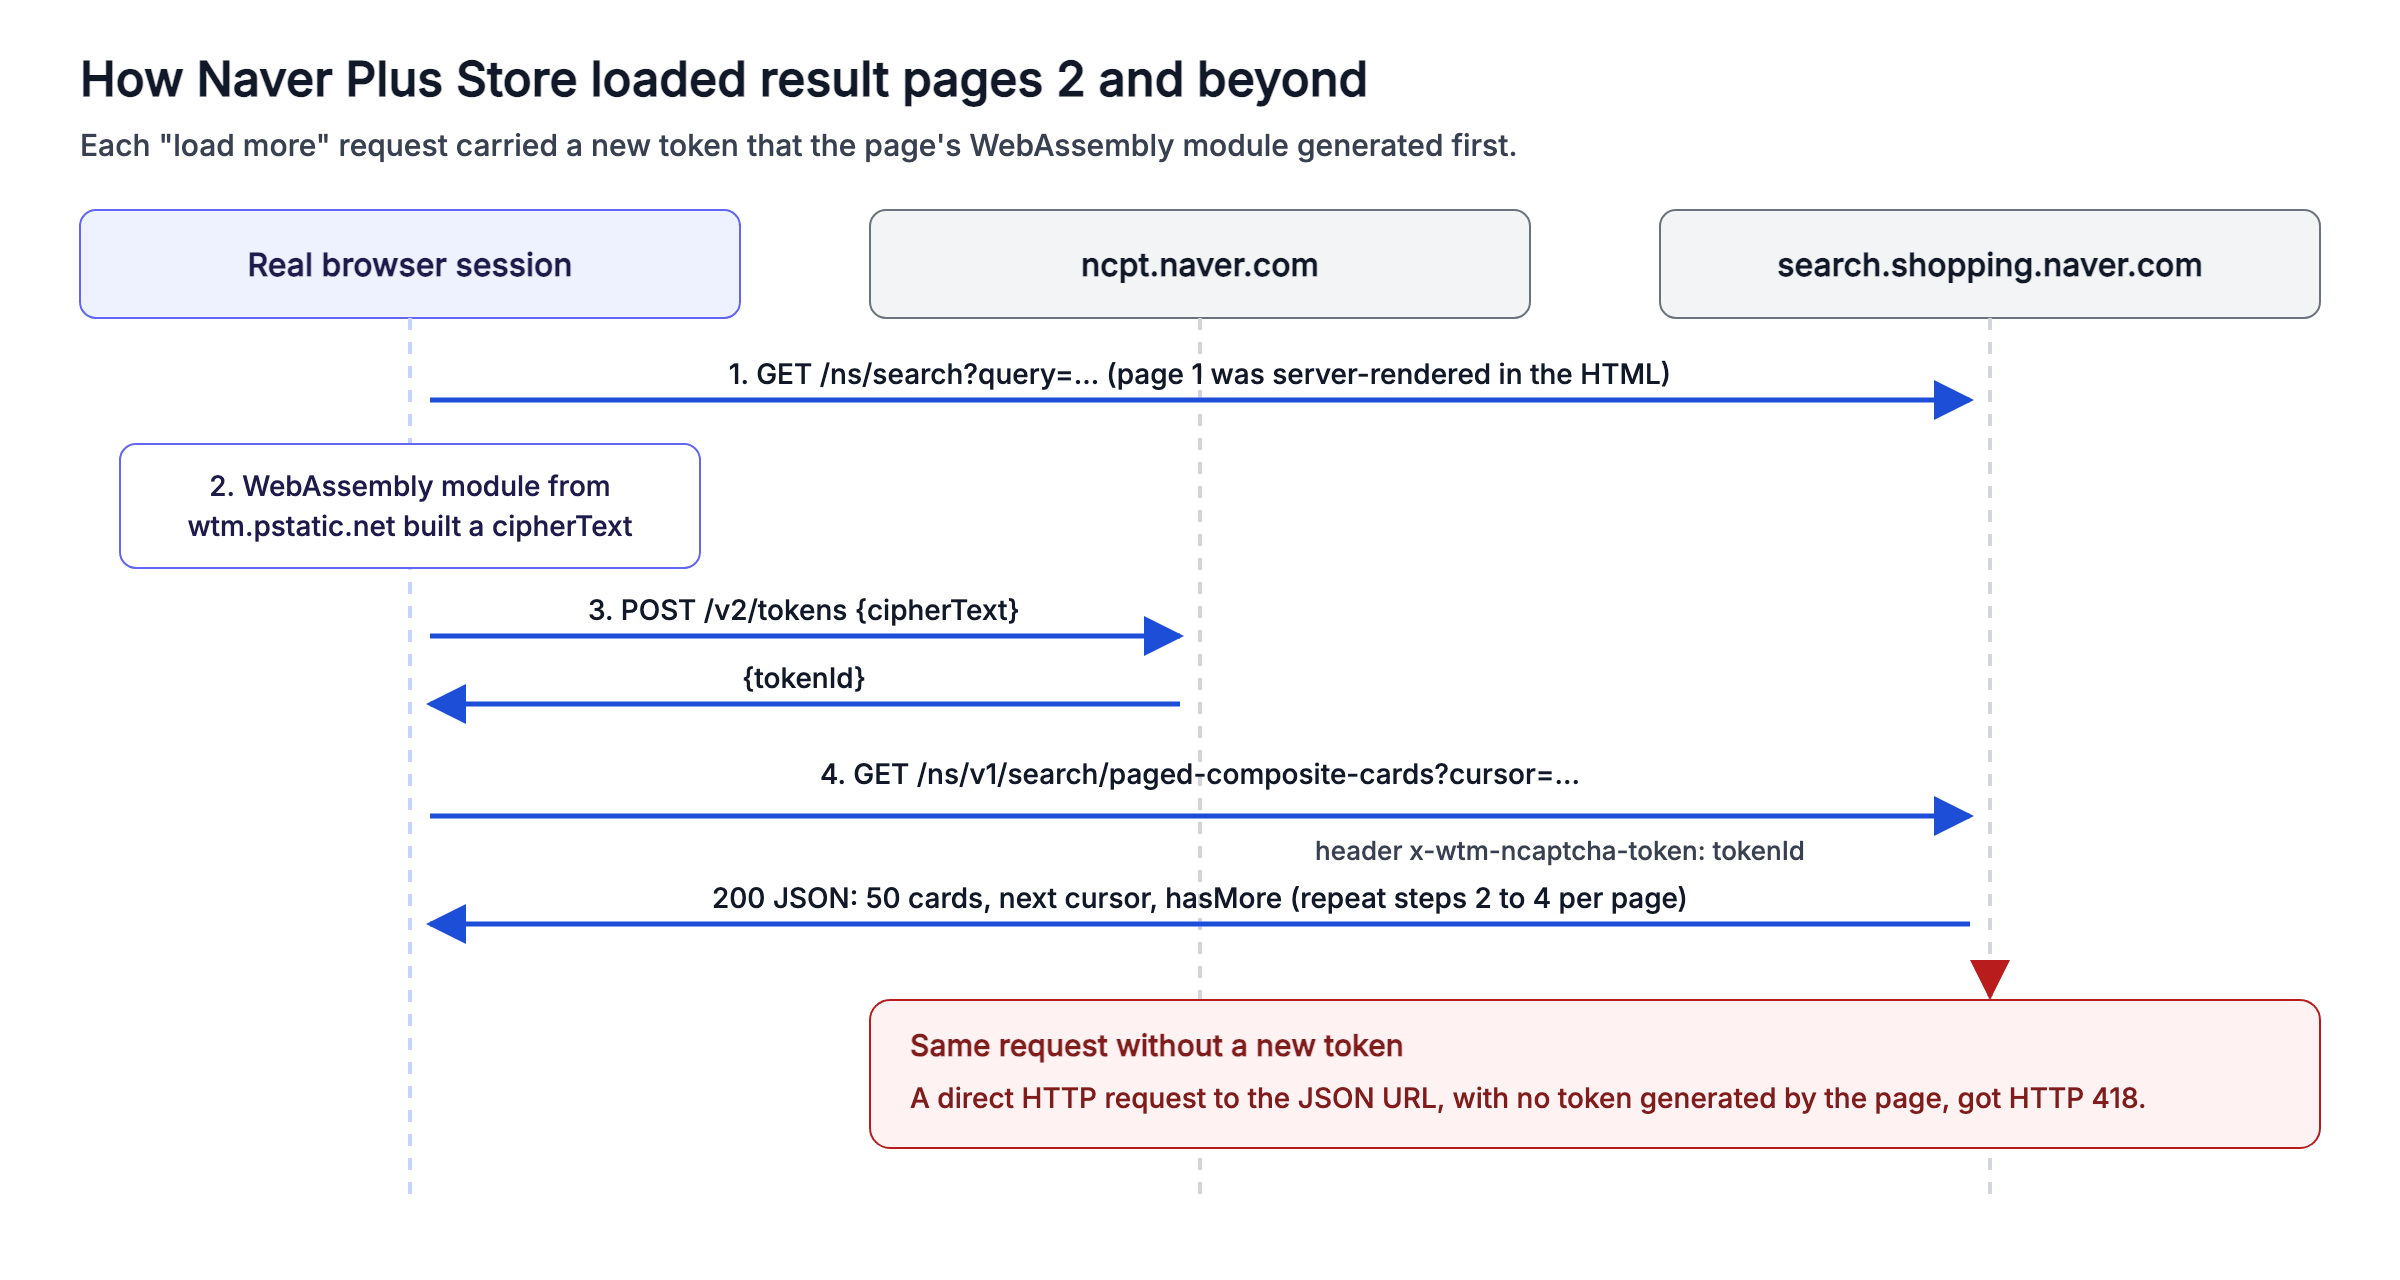
Una solicitud directa al endpoint sin un token nuevo obtuvo HTTP 418. Ejecutar la página en un navegador real permitió que sus propios scripts generaran cada token.
Browser API ejecuta Chrome en la nube de Bright Data y factura por ancho de banda. En ese navegador, el propio WebAssembly de la página generaba cada token, y el código solo tenía que leer las respuestas JSON. El script siguiente se conecta a través del Chrome DevTools Protocol (CDP), se desplaza en pasos irregulares con pausas, y captura cada página de resultados:
import asyncio
import os
import random
import time
from urllib.parse import quote

from playwright.async_api import async_playwright

# wss://brd-customer-<id>-zone-<zone>-country-kr:<password>@brd.superproxy.io:9222
BROWSER_WSS = os.environ["BRIGHTDATA_BROWSER_WSS"]
PAGED_API = "/ns/v1/search/paged-composite-cards"


async def plus_store_pages(query: str, extra_pages: int = 5, budget_s: int = 120) -> list[dict]:
    """Return result pages 2..N as JSON. The page generates each request's token itself."""
    pages = []
    async with async_playwright() as p:
        browser = await p.chromium.connect_over_cdp(BROWSER_WSS)
        page = await browser.new_page()

        async def on_response(response):
            # The page fetches each new set of cards as JSON while it scrolls
            if PAGED_API in response.url and response.ok:
                pages.append((await response.json())["data"])

        page.on("response", on_response)
        first = await page.goto(f"https://search.shopping.naver.com/ns/search?query={quote(query)}",
                                wait_until="domcontentloaded", timeout=120_000)
        if first.status != 200:
            raise RuntimeError(f"landing page returned {first.status}")
        deadline = time.time() + budget_s
        while len(pages) < extra_pages and time.time() < deadline:
            if pages and not pages[-1]["hasMore"]:
                break
            # Scroll in uneven steps with pauses
            await page.mouse.wheel(0, random.randint(900, 1500))
            await page.wait_for_timeout(random.randint(2500, 4500))
        await browser.close()
    return pages


if __name__ == "__main__":
    result = asyncio.run(plus_store_pages("캠핑의자"))
    for data in result:
        products = [c["card"]["product"] for c in data["data"] if c.get("card", {}).get("product")]
        print(f"page {data['data'][0]['page']}: {len(products)} products, next cursor {data['cursor']}")
Para 캠핑의자 (silla de camping), la sesión recolectó las páginas 2 a 6:
page 2: 50 products, next cursor 74
page 3: 50 products, next cursor 112
page 4: 50 products, next cursor 151
page 5: 50 products, next cursor 189
page 6: 50 products, next cursor 239
En 3 sesiones más con este patrón de desplazamiento, cada una recolectó las 5 páginas adicionales. Mantén los pasos irregulares y pausas al adaptar el script, para que tus sesiones coincidan con el patrón probado.
Reconstruye los campos de la API de Shopping desde la búsqueda de comparación de precios
De las páginas que probamos, la búsqueda de comparación de precios de Naver, en /search/all, fue la más similar a la API retirada. Su __NEXT_DATA__ contenía 12 de los 14 campos que devolvía la API de búsqueda de Shopping, por lo que un feed interrumpido puede mantener la mayor parte de su esquema:
| Campo de la API de búsqueda de Shopping | Campo de búsqueda de comparación de precios |
|---|---|
productId |
id |
title |
productTitle |
link |
mallProductUrl para productos de una sola tienda, o crUrl, el enlace de seguimiento de Naver, para productos de catálogo |
image |
imageUrl |
lprice |
lowPrice, el precio más bajo entre tiendas para un producto de catálogo |
hprice |
Dejar sin asignar: highPrice estaba vacío o era “0” en cada resultado verificado |
mallName |
mallName, vacío para productos de catálogo porque muchas tiendas los venden |
productType |
Parcialmente desde mallCount: por encima de 0 marcaba un producto de catálogo |
brand y maker |
brand y maker |
category1 a category4 |
category1Name a category4Name |
Web Unlocker devolvió esta página con su lista de resultados en 10 de 10 consultas de prueba. El script siguiente obtiene la página a través de Web Unlocker, intenta hasta 3 veces, y renombra los campos de cada resultado a los nombres de la API:
import json
import os
import re
import time
from urllib.parse import quote

import requests

API_URL = "https://api.brightdata.com/request"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
UNLOCKER_ZONE = os.environ["BRIGHTDATA_UNLOCKER_ZONE"]
NEXT_DATA = re.compile(r'<script id="__NEXT_DATA__" type="application/json">(.*?)</script>', re.S)


def fetch_price_comparison(query: str, attempts: int = 3) -> str:
    url = f"https://search.shopping.naver.com/search/all?query={quote(query)}"
    for attempt in range(1, attempts + 1):
        resp = requests.post(
            API_URL,
            headers=HEADERS,
            json={"zone": UNLOCKER_ZONE, "url": url, "format": "raw", "country": "kr"},
            timeout=180,
        )
        # A login page also returns 200, so check for the result list
        if resp.ok and "compositeList" in resp.text:
            return resp.text
        print(f"attempt {attempt} failed: {resp.headers.get('x-brd-error') or 'no result list'}")
        time.sleep(5 * attempt)
    raise RuntimeError(f"Price comparison search failed for {query!r}")


def as_api_items(html: str) -> list[dict]:
    """Rename each result's fields to the ones the Shopping search API returned."""
    data = json.loads(NEXT_DATA.search(html).group(1))
    rows = []
    for entry in data["props"]["pageProps"]["compositeList"]["list"]:
        item = entry["item"]
        rows.append({
            "productId": item.get("id"),
            "title": item.get("productTitle"),
            "link": item.get("mallProductUrl") or item.get("crUrl"),  # catalog products have no store URL
            "lprice": item.get("lowPrice"),  # the lowest price across stores for a catalog product
            "mallName": item.get("mallName") or None,
            "mallCount": item.get("mallCount"),  # above 0 marks a price comparison catalog product
            "brand": item.get("brand"),
            "maker": item.get("maker"),
            **{f"category{i}": item.get(f"category{i}Name") for i in range(1, 5)},
            # adId marks an ad, and entry types other than "product" are promoted slots
            "is_ad": bool(item.get("adId")) or entry["type"] != "product",
        })
    return rows


if __name__ == "__main__":
    rows = as_api_items(fetch_price_comparison("코카콜라 제로"))
    first = next(i for i, row in enumerate(rows) if not row["is_ad"])
    print(f"{len(rows)} results, {sum(r['is_ad'] for r in rows)} ads or promoted slots, first organic at rank {first + 1}")
    print(json.dumps({k: v for k, v in rows[first].items() if k != "link"}, ensure_ascii=False))
Para 코카콜라 제로, los primeros 8 resultados eran anuncios o espacios promocionados, y el primer resultado orgánico fue un producto de catálogo:
56 results, 16 ads or promoted slots, first organic at rank 9
{"productId": "54166199731", "title": "코카콜라 콜라 , 190ml, 30개", "lprice": 13400, "mallName": null, "mallCount": 8702, "brand": "코카콜라", "maker": "코카콜라", "category1": "식품", "category2": "음료", "category3": "청량/탄산음료", "category4": "콜라", "is_ad": false}
El JSON de la página también marca anuncios, una señal que la API retirada no devolvía, así que filtra por is_ad antes de comparar rankings antiguos y nuevos.
Obtén registros de productos de SmartStore con la Naver Shopping Scraper API
Para los detalles de producto, solicita registros estructurados en lugar de HTML. La Naver Shopping Scraper API, parte de la Web Scraper API de Bright Data, ejecuta un scraper de SmartStore en cada URL que envías. En el panel de control, su endpoint Collect by URL toma una lista de URLs de productos:
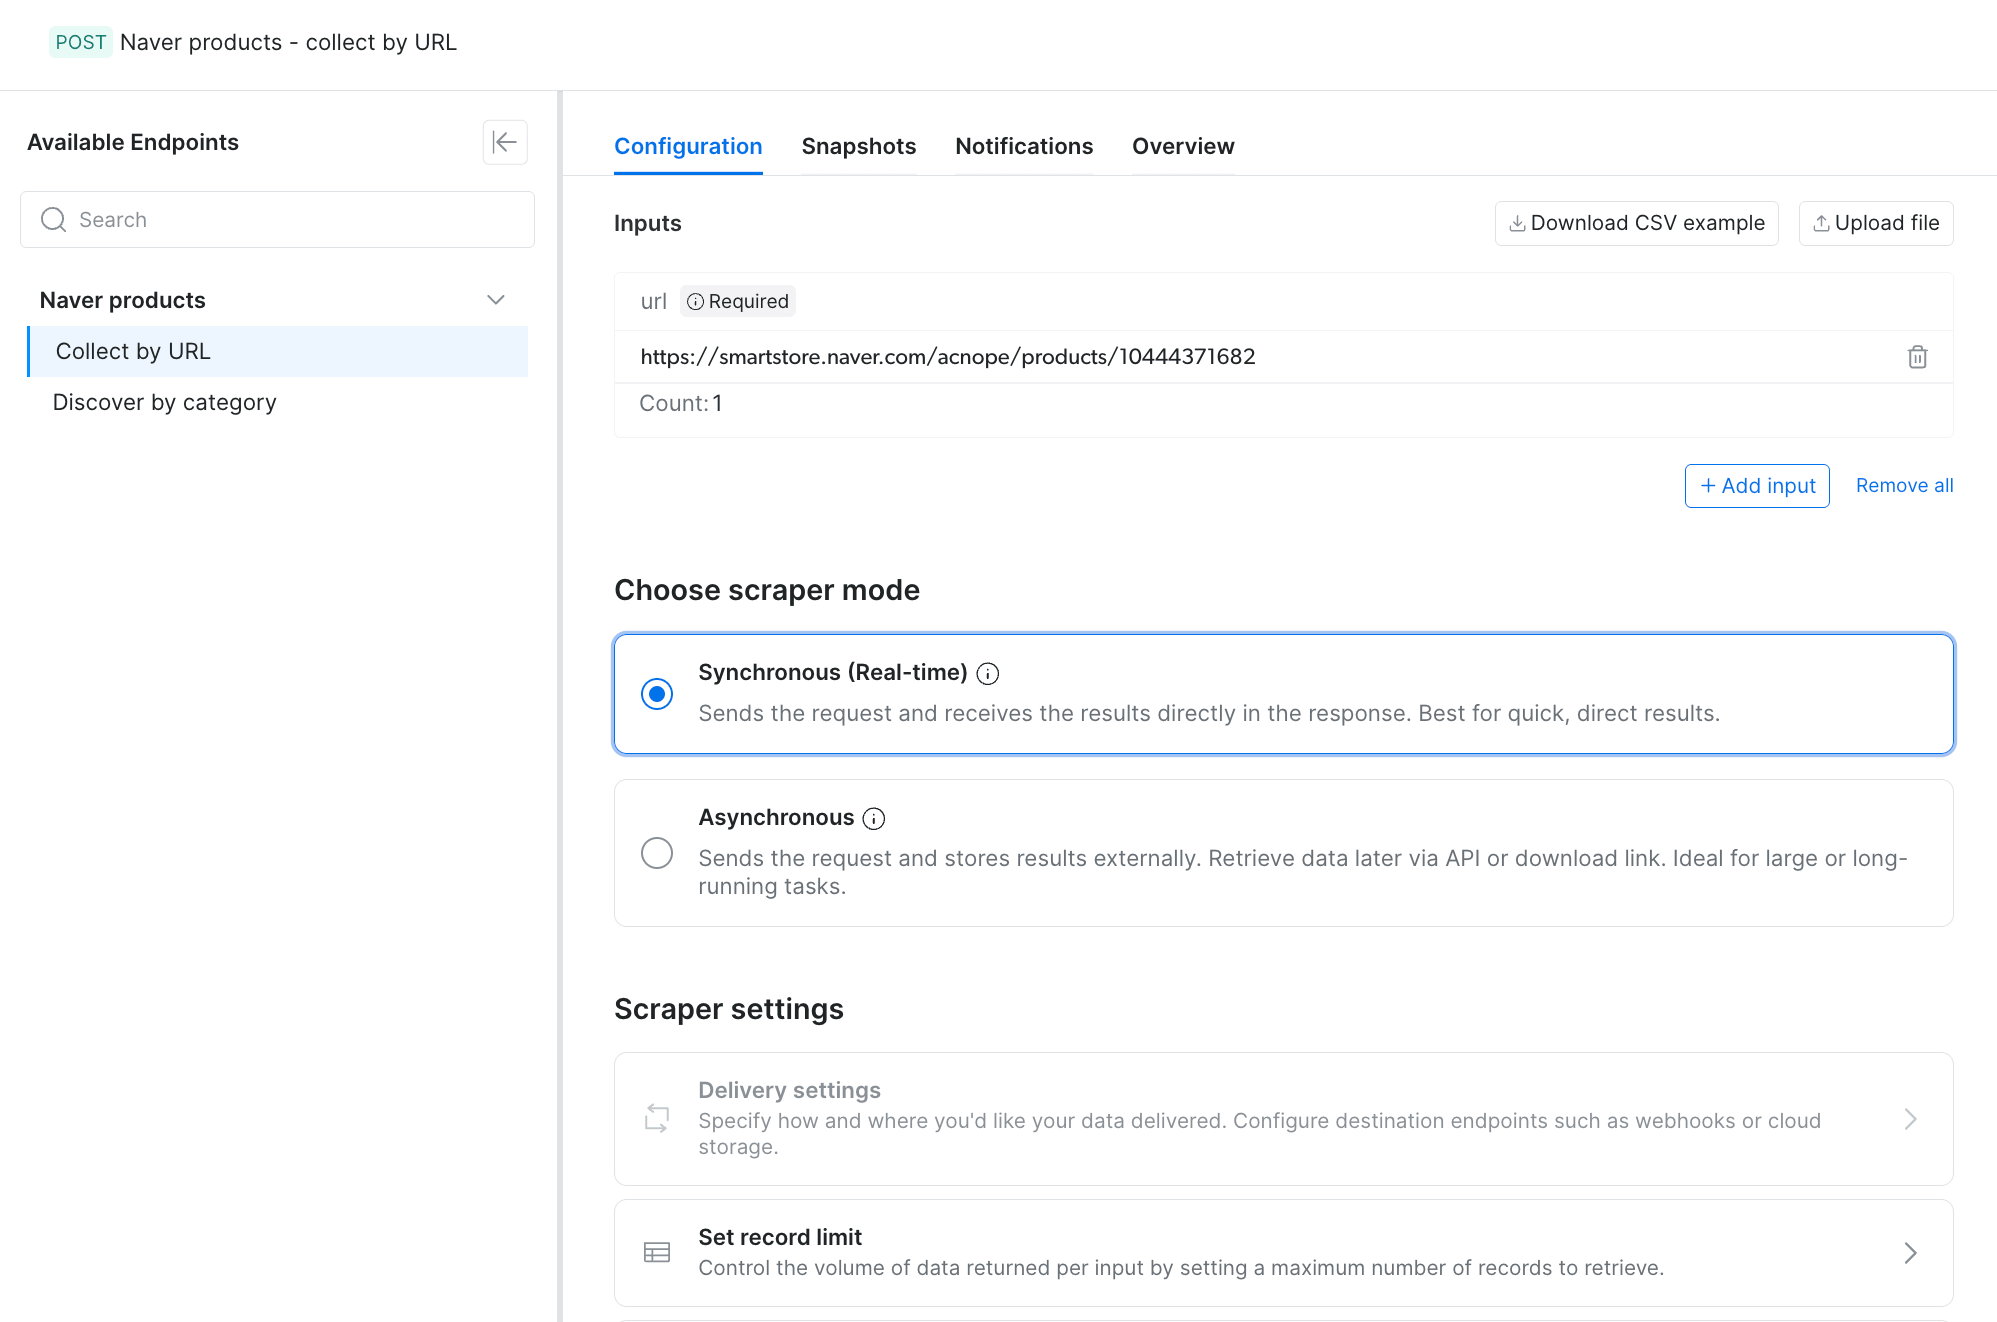
El mismo endpoint está disponible a través de la API REST, con el ID de conjunto de datos gd_m9qqjxxr1hab7okefj.
El script depende de 3 detalles de la API. Si un trabajo tarda más que el límite de tiempo de espera síncrono, el endpoint /scrape devuelve HTTP 202 con un ID de instantánea que debes consultar. Usa /scrape para lotes pequeños, y envía trabajos más grandes al endpoint asíncrono /trigger, cuya documentación indica el límite actual de tamaño de lote. Y custom_output_fields devuelve solo los campos que enumeras, así que añade input, error, y error_code para ver por qué una URL no devolvió ningún producto.
El script siguiente envía un lote, cambia a sondeo de instantáneas cuando es necesario, y valida cada registro:
import json
import os
import sys
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}"}
NAVER_PRODUCTS = "gd_m9qqjxxr1hab7okefj"
# custom_output_fields returns only what you list, so include input and the error fields
FIELDS = ("input|error|error_code|url|product_id|title|original_price|final_price"
          "|discount_rate|total_reviews|sold_out|breadcrumbs|timestamp")


def collect_products(urls: list[str]) -> list[dict]:
    params = {"dataset_id": NAVER_PRODUCTS, "format": "json",  # a JSON array instead of the default NDJSON
              "include_errors": "true", "custom_output_fields": FIELDS}
    body = {"input": [{"url": u} for u in urls]}
    resp = requests.post(f"{API}/scrape", params=params, json=body, headers=HEADERS, timeout=180)
    if resp.status_code == 202:  # the job took longer than the synchronous timeout limit
        snapshot_id = resp.json()["snapshot_id"]
        while True:
            status = requests.get(f"{API}/progress/{snapshot_id}", headers=HEADERS, timeout=60).json()["status"]
            if status == "ready":
                break
            if status == "failed":
                raise RuntimeError(f"snapshot {snapshot_id} failed")
            time.sleep(10)
        while True:  # the snapshot endpoint returns 202 until the file is built
            resp = requests.get(f"{API}/snapshot/{snapshot_id}", params={"format": "json"},
                                headers=HEADERS, timeout=120)
            if resp.status_code != 202:
                break
            time.sleep(10)
    resp.raise_for_status()
    records = resp.json()
    # Keep a list shape even if the API returns a single object
    return records if isinstance(records, list) else [records]


def validate(record: dict) -> dict:
    if record.get("error_code"):
        # dead_page means the listing is gone: drop it from the watch list, don't retry
        return {"url": record["input"]["url"], "ok": False, "reason": record["error_code"]}
    list_price = int(record["original_price"]) if record.get("original_price") else None  # int() also accepts the string form
    price = record.get("final_price")
    ok = isinstance(price, int) and price > 0 and (list_price is None or price <= list_price)
    return {"product_id": record.get("product_id"), "ok": ok, "price": price, "list_price": list_price,
            "reviews": record.get("total_reviews"), "title": (record.get("title") or "")[:40]}


if __name__ == "__main__":
    urls = json.load(open(sys.argv[1])) if len(sys.argv) > 1 else [
        "https://smartstore.naver.com/acnope/products/10444371682"]
    records = collect_products(urls)
    print(f"{len(records)} records")
    for row in map(validate, records):
        print(json.dumps(row, ensure_ascii=False))
Un lote de 10 URLs de SmartStore devolvió registros para los 7 listados públicos y marcó las otras 3 con códigos de error:
10 records
{"url": "https://smartstore.naver.com/bestymall/products/9824862314", "ok": false, "reason": "dead_page"}
{"url": "https://smartstore.naver.com/wonliveshopm/products/12177447319", "ok": false, "reason": "dead_page"}
{"url": "https://smartstore.naver.com/dajunemall/products/12725077707", "ok": false, "reason": "wait_element_timeout"}
{"product_id": "11219337734", "ok": true, "price": 16890, "list_price": null, "reviews": null, "title": "TROLLI 트롤리 올인원 젤리 1kg  사우어 구미캔디"}
{"product_id": "11499596414", "ok": true, "price": 615340, "list_price": null, "reviews": null, "title": "LG전자 2도어 344L 몽블랑 네이처 (M344MB14) 2도어 냉장고"}
{"product_id": "12465433420", "ok": true, "price": 17900, "list_price": 35000, "reviews": 41, "title": "[국산 100%] 꿈에그린X알파플러스 KF94 새부리형 마스크 100매("}
{"product_id": "12332341407", "ok": true, "price": 299000, "list_price": 608000, "reviews": 12, "title": "마이크로소프트  MS office 2024 Home & Business "}
{"product_id": "12385071329", "ok": true, "price": 277000, "list_price": null, "reviews": null, "title": "-ku- 일렉트로룩스 WELL Q8 무선스틱청소기 WQ81-3OMBF"}
{"product_id": "5494837526", "ok": true, "price": 31490, "list_price": null, "reviews": 1, "title": "로슈 아큐첵 인스턴트 혈당계+시험지50매"}
{"product_id": "9280411528", "ok": true, "price": 32200, "list_price": 32250, "reviews": 33, "title": "오딧세이 남성2종 로맨틱 레드 스페셜세트+아이오페 포케터블 토트백 증 정"}
Cada precio, recuento de reseñas y bandera coincidía con la misma página de producto obtenida a través de Web Unlocker. Las 3 URLs marcadas eran 2 listados eliminados y 1 listado detrás de la comprobación de autorización de Naver. Elimina las URLs dead_page de tu lista de seguimiento después de cada ejecución. Obtén cualquier otra URL marcada a través de Web Unlocker, y parsea cada página con smartstore_product.
Cada URL en el lote comenzaba con la URL de la tienda, como el valor predeterminado del script smartstore.naver.com/acnope/products/10444371682. Para construir una a partir de una tarjeta de Plus Store, lee la URL de la tienda desde el parámetro url de mallUrl.pcUrl y añade /products/<channelProductId>.
Verifica el contrato de datos antes de cargar registros en un almacén:
original_priceera una cadena, yfinal_priceera un entero, en los 930 registros de una muestra del conjunto de datos de productos de Naver y en registros en tiempo real. Convierte ambos a enteros antes de compararlos, como hacevalidate.- En este lote, un
original_pricenulo significaba sin descuento, y untotal_reviewsnulo significaba aún sin reseñas. total_reviewscoincidía con el recuento de reseñas en la página del producto, 19,581 para la URL predeterminada del script. Ese recuento era para todo el grupo del producto, y el estado de la página también contenía 15,422 para el producto individual.- En este lote,
product_idcoincidía con el número de producto en cada URL de entrada, así que puedes usarlo para unir registros con resultados de Plus Store. custom_output_fieldscontrola qué campos almacenas, así que conserva solo los campos que monitoreas y no almacenes datos personales del vendedor.
Para historial o cobertura masiva en lugar de recolección en tiempo real, obtén el conjunto de datos de productos de Naver, con precio por registro. Los equipos que quieran información de precios y promociones en lugar de registros sin procesar pueden usar el Naver Shopping Price Tracker.
Bright Data también tiene scrapers dedicados para reseñas de SmartStore, reseñas de Naver Shopping, y Naver Hotels.
Compara herramientas y costos para cada tipo de página de Naver
Cada tarea en el monitoreo de precios y estanterías digitales de Naver se empareja con un producto de Bright Data:
| Tarea | Producto de Bright Data | Resultado de la prueba | Cómo factura |
|---|---|---|---|
| Resultados de shopping en la búsqueda de Naver para una palabra clave | API SERP con HTML sin procesar | 10 de 10 consultas | Por solicitud exitosa (precios de la API SERP) |
| Primera página de resultados de Plus Store, 50 tarjetas | Web Unlocker | 10 de 10 consultas | Por solicitud exitosa (precios de Web Unlocker) |
| Páginas 2 y siguientes de Plus Store | Browser API | 5 de 5 páginas adicionales en cada una de 4 sesiones con pausas de desplazamiento | Por GB de ancho de banda (precios de Browser API) |
| Campos de la API de Shopping para una palabra clave, desde la búsqueda de comparación de precios | Web Unlocker | 10 de 10 consultas | Por solicitud exitosa |
| Registros completos para URLs de productos conocidas | Naver Shopping Scraper API | 7 de 7 listados públicos, con precios y reseñas que coinciden con cada página | Por registro (precios de la Web Scraper API) |
| Historial o datos de productos masivos | Conjunto de datos de productos de Naver | Los tipos de campo de precio en una muestra de 930 registros coincidieron con registros en tiempo real | Por registro (precios de conjuntos de datos) |
A través de Web Unlocker, una página de resultados de Plus Store factura como 1 solicitud. La Naver Shopping Scraper API factura por registro, así que el costo escala con la cantidad de URLs de productos que envías. En nuestra prueba, una sesión de Browser API que cargó 5 páginas adicionales de 50 productos usó alrededor de 18 MB. Multiplica estas unidades por las tarifas actuales en cada página de precios para estimar tu presupuesto.
Usa las páginas de búsqueda para encontrar productos y rastrear su ranking de búsqueda. Luego envía las URLs que monitoreas a la Naver Shopping Scraper API, para pagar por registros solo en los productos que rastreas.
Reflexiones finales
Las páginas de shopping y producto de Naver bloquearon a los clientes HTTP simples, pero su búsqueda de comparación de precios aún contenía la mayoría de los campos de la API retirada. Lee el JSON incrustado y verifica su contenido, no el código de estado, porque las redirecciones de inicio de sesión y los listados eliminados de Naver se devolvían como páginas normales.
Usa la API SERP y Web Unlocker para el descubrimiento, Browser API para la paginación, y la Naver Shopping Scraper API para registros de producto estructurados. La recolección en tiempo real muestra precios y rankings actuales, y el conjunto de datos de productos de Naver proporciona historial o datos de productos masivos. Comienza ejecutando el script de comparación de precios en las 5 palabras clave que más monitoreas, y carga sus filas en tus tablas de feed existentes.
Preguntas frecuentes
¿Naver todavía tiene una API de shopping?
Naver finalizó su API de búsqueda de Shopping el 31 de julio de 2026, sin reemplazo en NAVER API HUB. Una alternativa similar era su búsqueda de comparación de precios, cuyos datos incrustados contenían la mayoría de los campos de la API, incluido el precio más bajo, marca y categorías. Web Unlocker de Bright Data la devolvió en 10 de 10 consultas.
¿Por qué Naver Shopping devuelve un error 418?
HTTP 418 era la página de bloqueo de Naver Shopping por acceso temporalmente restringido. Enumeraba 4 desencadenantes: visitas desde promociones externas no relacionadas con shopping, ráfagas de solicitudes desde una IP, IPs de VPN, y algunas extensiones de navegador. requests de Python y Chrome headless lo obtuvieron, mientras que Web Unlocker de Bright Data obtuvo los resultados.
¿Se puede hacer scraping de Naver desde fuera de Corea?
Sí, con un desbloqueador para las páginas de shopping. Desde India, los clientes HTTP simples obtuvieron páginas completas de la búsqueda de Naver, mientras que Naver Shopping devolvía páginas de bloqueo, CAPTCHAs, o redirecciones de inicio de sesión. Web Unlocker de Bright Data devolvió 10 de 10 páginas de Plus Store allí. Usa IPs coreanas, ya que Naver registraba el país de cada solicitante.
¿Cómo haces scraping de Naver con Python?
Obtén la página, luego parsea el JSON incrustado en el HTML en lugar de usar selectores CSS. Las páginas de búsqueda almacenaban datos de shopping en objetos _INITIAL_STATE, y SmartStore usaba window.__PRELOADED_STATE__. Naver Shopping bloqueaba a los clientes HTTP de Python, así que enruta esas solicitudes a través de Web Unlocker de Bright Data.
¿Cuánto cuesta hacer scraping de Naver?
La API SERP y Web Unlocker de Bright Data facturan por solicitud exitosa, la Naver Shopping Scraper API factura por registro, y Browser API factura por GB. En nuestras pruebas, una página de resultados fue 1 solicitud, y 5 páginas adicionales a través de Browser API usaron alrededor de 18 MB. Las tarifas actuales están en la página de precios.