Amazon Bedrock Knowledge Bases es un servicio gestionado de Generación Aumentada por Recuperación (RAG). Lo apuntas a una fuente de datos, y fragmenta, incrusta e indexa tus documentos, luego responde consultas con citas. Sus conectores incluyen Amazon S3, SharePoint, y un Web Crawler nativo para páginas públicas.
Ese crawler cubre la web cooperativa. Muchos catálogos de productos, marketplaces, y sitios de noticias se renderizan con JavaScript, están detrás de protección antibots, o sirven contenido distinto según el país. El crawler devuelve un cascarón, un bloqueo, o el contenido del país equivocado. Esta guía alimenta esas páginas a una base de conocimiento a través de Bright Data y S3.
TL;DR
- Web Unlocker devuelve una página pública como Markdown en una solicitud, a menos que la página necesite interacción. Escribe cada página en S3 como
.mdmás un sidecar.metadata.json. - Calcula el hash del contenido antes de escribir, para que una actualización vuelva a incrustar las páginas que reescribiste en lugar de todo el corpus.
- Mide la recuperación contra un conjunto de referencia antes de escalar, porque tu fragmentación se fija en la fuente de datos y las claves de metadatos no filtrables se fijan en un índice de S3 Vectors. No puedes cambiar ninguna de las dos después.
- Enruta por consulta. Recurre a una búsqueda en vivo cuando la puntuación más alta esté por debajo de un piso de relevancia.
Por qué el Web Crawler nativo deja un vacío
La fuente de datos Web Crawler es un conector propio, y para tus propias páginas estáticas es una buena opción. Hoy sus limitaciones dejan los datos web públicos a escala en manos de Bright Data.
- Admite sitios web estáticos. La documentación lo dice directamente, y el crawler no recupera páginas que se renderizan del lado del cliente. Muchos catálogos, paneles y páginas de listados se renderizan así, por lo que el crawler ve un cascarón vacío donde debería estar el dato.
- Está construido para la web cooperativa. El crawler respeta
robots.txtsegún la RFC 9309, y trata el sitio como no permitido cuando no encuentra ninguno. Se identifica comobedrockbot, y se detiene ante la protección antibots por diseño. - Tiene un límite de 25,000 páginas por sincronización, y admite un solo almacén de vectores. Si superas ese límite, la sincronización falla y no ingiere nada. Ese almacén es actualmente Amazon OpenSearch Serverless, así que S3 Vectors no es una opción con el crawler.
- Devuelve páginas, no registros limpios. El crawler ingiere HTML. La navegación, los banners de cookies y el código repetitivo llegan junto con el contenido, y no hay un paso de extracción estructurada. Tus fragmentos arrastran el ruido hacia las incrustaciones.
La consola etiqueta el Web Crawler como Vista Previa en la pantalla donde lo eliges:
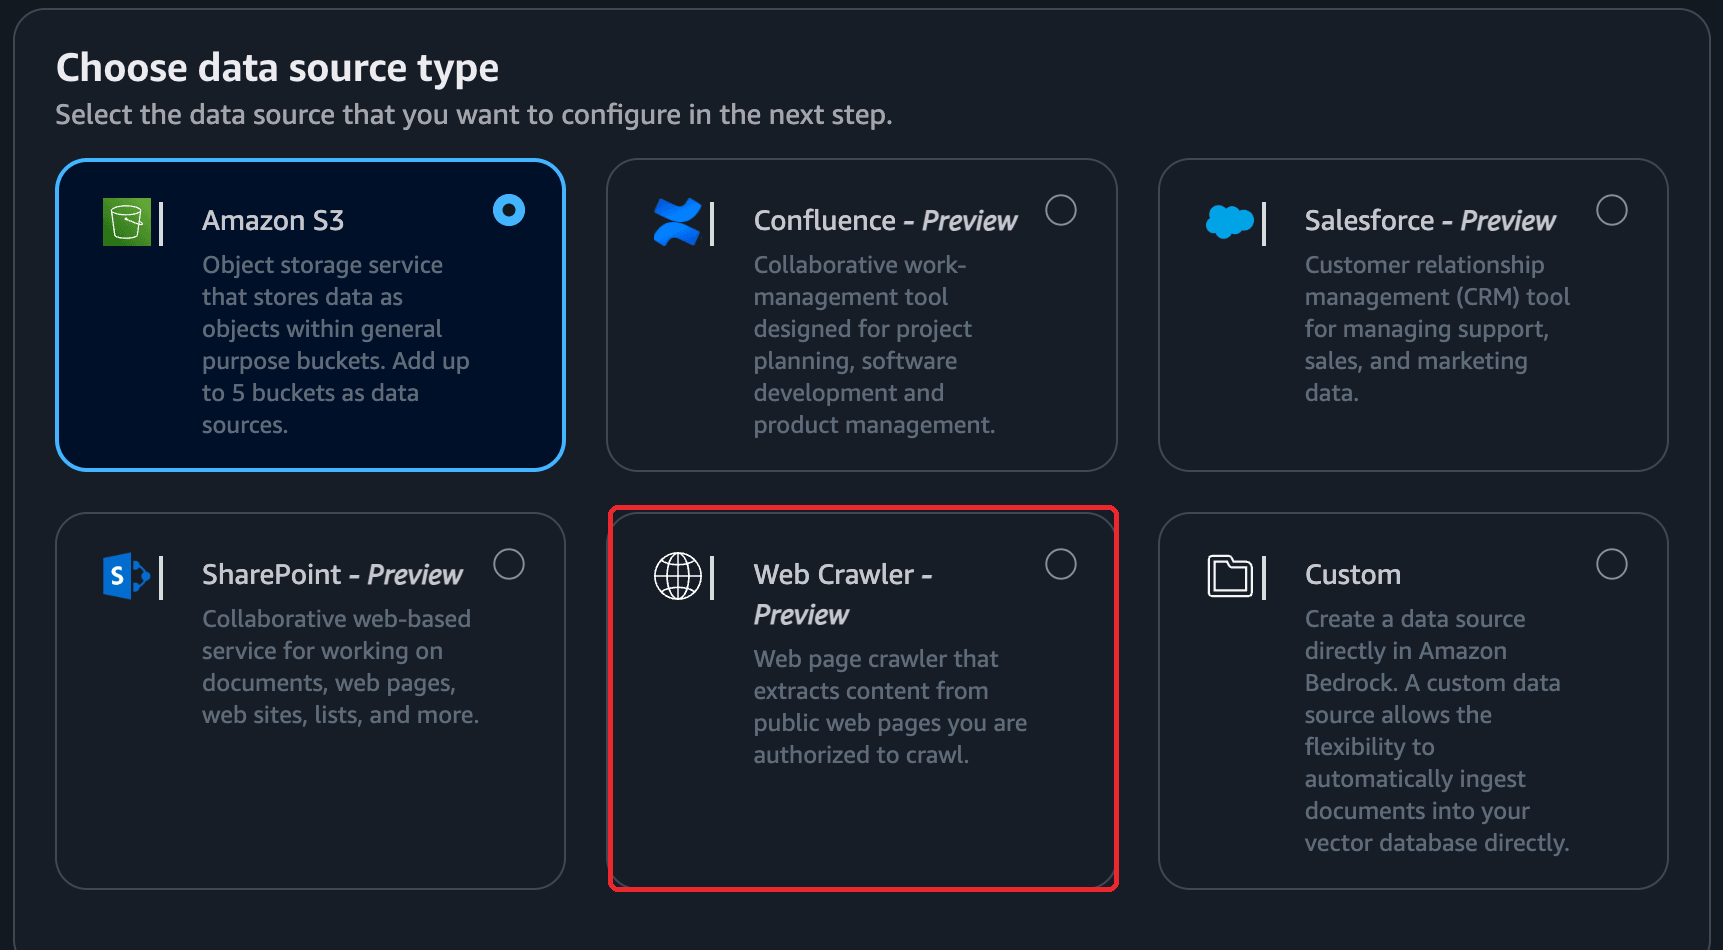
Nada de esto convierte al crawler en la opción equivocada para las páginas estáticas y cooperativas para las que fue construido. En el informe Data for AI 2026 de Bright Data, el 90% de las organizaciones de IA dijo que las restricciones de acceso limitan sus iniciativas. Cloudflare reclasificó a los crawlers de IA en julio de 2026. Dijo que bloquearía por defecto a los crawlers de uso mixto desde el 15 de septiembre de 2026, en páginas con publicidad para nuevos clientes, nuevos sitios y cuentas gratuitas sin cambios. Mantener el acceso funcionando requiere esfuerzo continuo, y Bright Data lo hace por ti.
La arquitectura
El pipeline convierte una lista de URLs públicas en una base de conocimiento buscable y citada, y la mantiene actualizada. Bright Data gestiona el acceso y la conversión a Markdown. S3 es el punto de entrega. Bedrock gestiona la indexación y la recuperación.
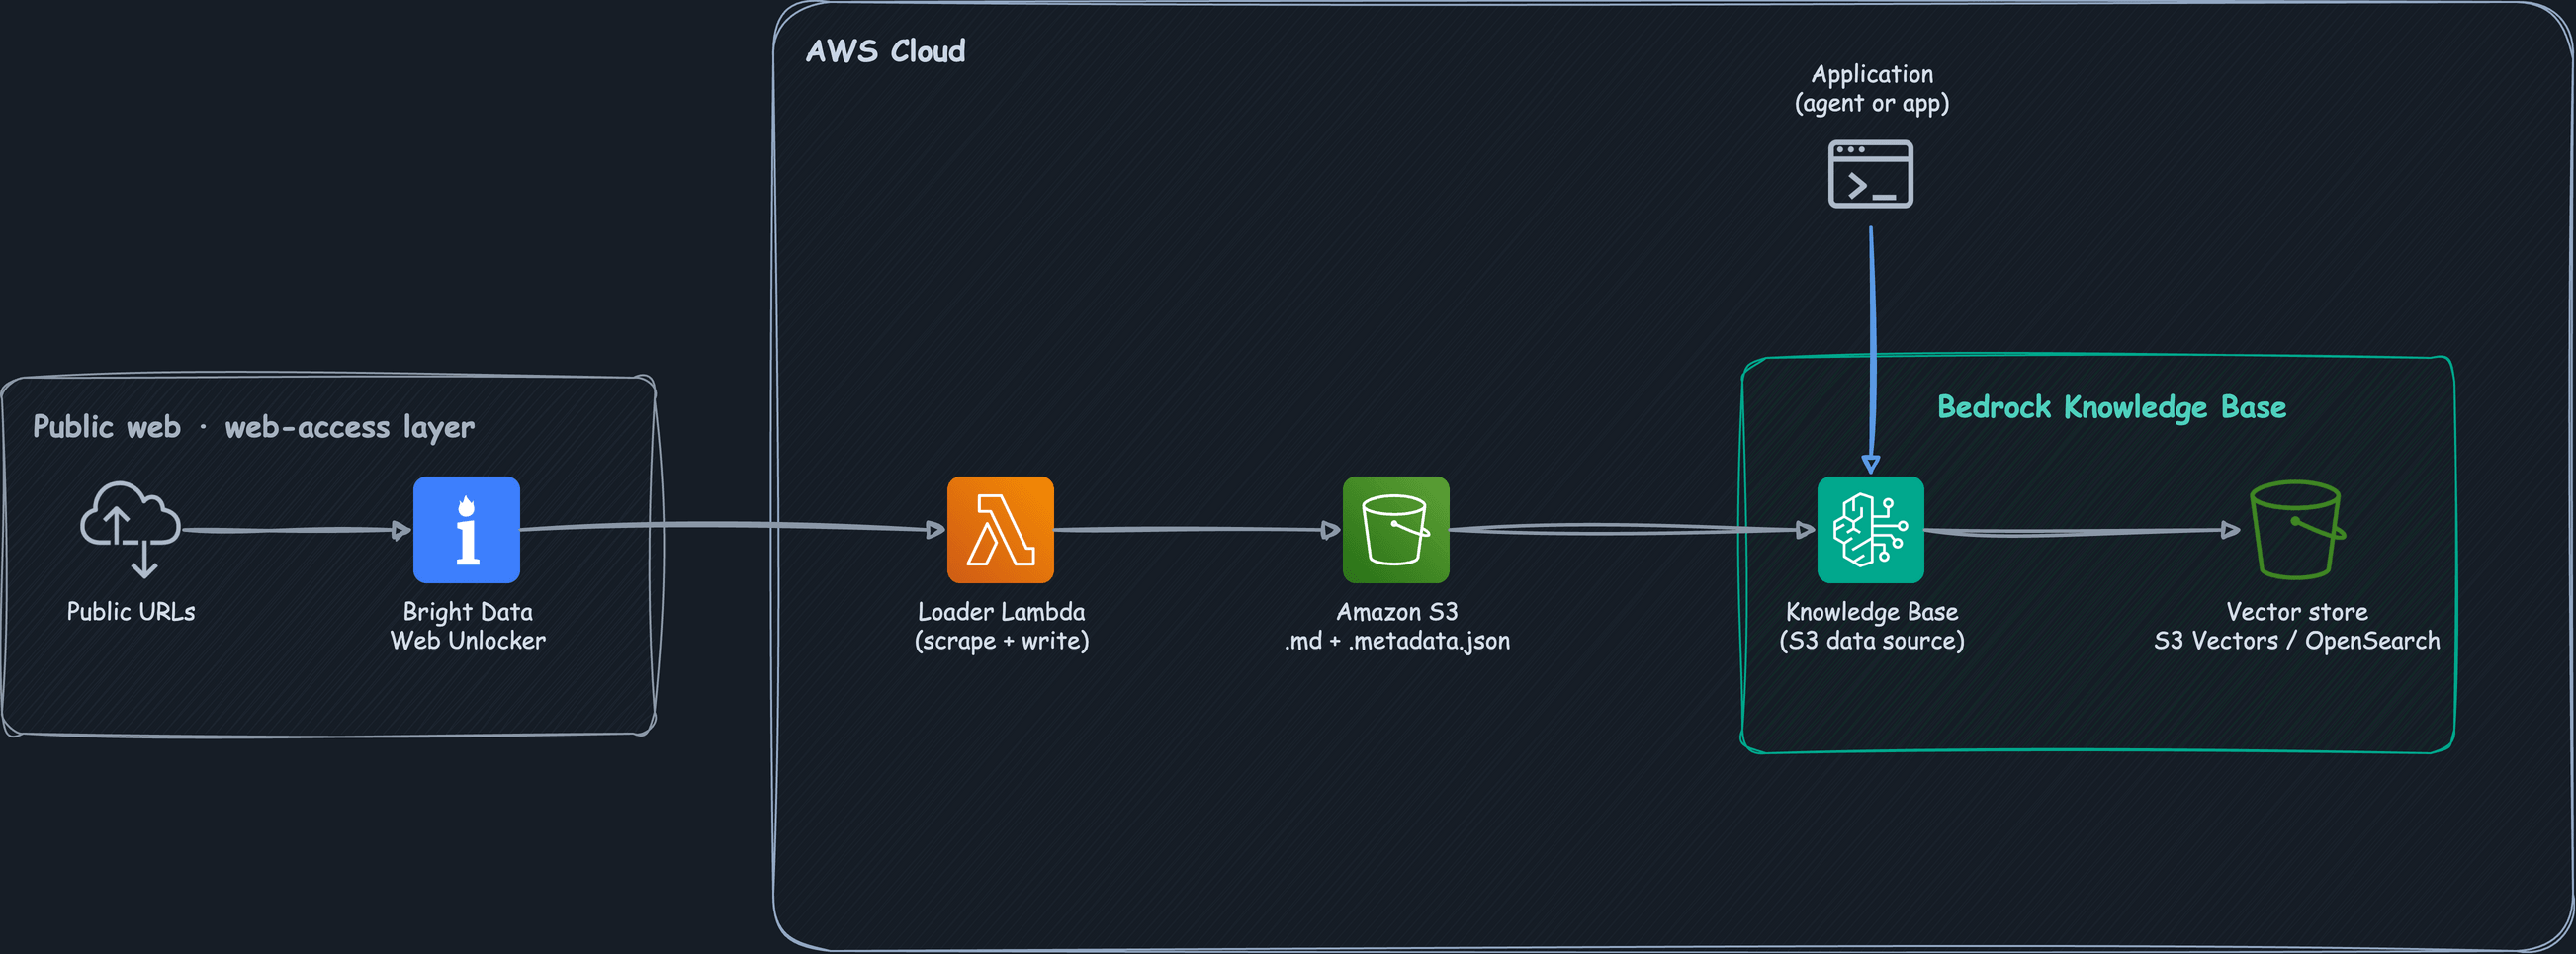
El diagrama muestra la ruta principal:
- El cargador llama al Web Unlocker de Bright Data para la protección antibots, enrutamiento geográfico, y renderizado de JavaScript, y recibe la página como Markdown.
- El cargador luego escribe cada página en Amazon S3 como un documento
<slug>.mdmás un sidecar<slug>.md.metadata.json. - La base de conocimiento sincroniza la fuente de datos de S3 con
StartIngestionJob, y las ejecuciones posteriores son incrementales. - Bedrock fragmenta cada documento, lo incrusta con Titan Text Embeddings V2, y escribe los vectores en un almacén como Amazon S3 Vectors u OpenSearch Serverless.
- Una aplicación llama a
Retrievepara obtener fragmentos sin procesar o aRetrieveAndGeneratepara una respuesta fundamentada y citada.
Tres piezas del envoltorio de producción quedan fuera de esa ruta principal, y el diagrama no las muestra. Una programación de Amazon EventBridge dispara el cargador con la frecuencia que elijas, AWS Secrets Manager guarda el token de Bright Data, y la base de conocimiento asume un rol de IAM de privilegio mínimo. El diagrama dibuja el cargador como una Lambda, que es donde se ejecuta una vez que lo programas. A continuación, ejecutas el cargador desde tu propia máquina, para que puedas observar cada etapa primero.
Escribir en S3 es una elección y no un valor predeterminado, porque también puedes enviar documentos directamente a través de una fuente de datos personalizada y la API IngestKnowledgeBaseDocuments. El bucket es la mejor opción para un corpus obtenido mediante scraping. Los objetos permanecen reproducibles, los sidecars te permiten inspeccionar el contrato de metadatos, y una ejecución fallida deja intacto el corpus anterior. La Crawl API de Bright Data también entrega de forma nativa en el mismo bucket.
Requisitos previos
- Una cuenta de AWS con acceso a Amazon Bedrock en una región compatible, y Amazon Titan Text Embeddings V2 (
amazon.titan-embed-text-v2:0) habilitado allí. Más un modelo de generación en la misma región, si quieres respuestas escritas del Paso 5 en lugar de fragmentos sin procesar. - Un principal de IAM que pueda crear buckets de S3, bases de conocimiento y fuentes de datos de Bedrock, un almacén de vectores, y el rol de servicio de IAM que asume la base de conocimiento. El repositorio complementario enumera las declaraciones de política exactas.
- Una cuenta de Bright Data con un token de API y una zona de Web Unlocker. Cada solicitud hace referencia a la zona por nombre. Un nivel gratuito cubre los primeros 5,000 créditos cada mes, suficiente para completar todos los pasos a continuación. Revisa la asignación y tarifa actuales en precios de Web Unlocker, luego establece un límite de gasto en la zona.
- Python 3.10 o posterior con
boto3yrequests. - Conocimiento práctico de Amazon S3 e IAM.
El modelo de incrustación fija tu dimensión de vector, y el índice de tu almacén de vectores debe coincidir con ella. Si creas el almacén manualmente y los dos no concuerdan, la ingesta falla al escribir. Titan Text Embeddings V2 admite 256, 512, o 1024 dimensiones.
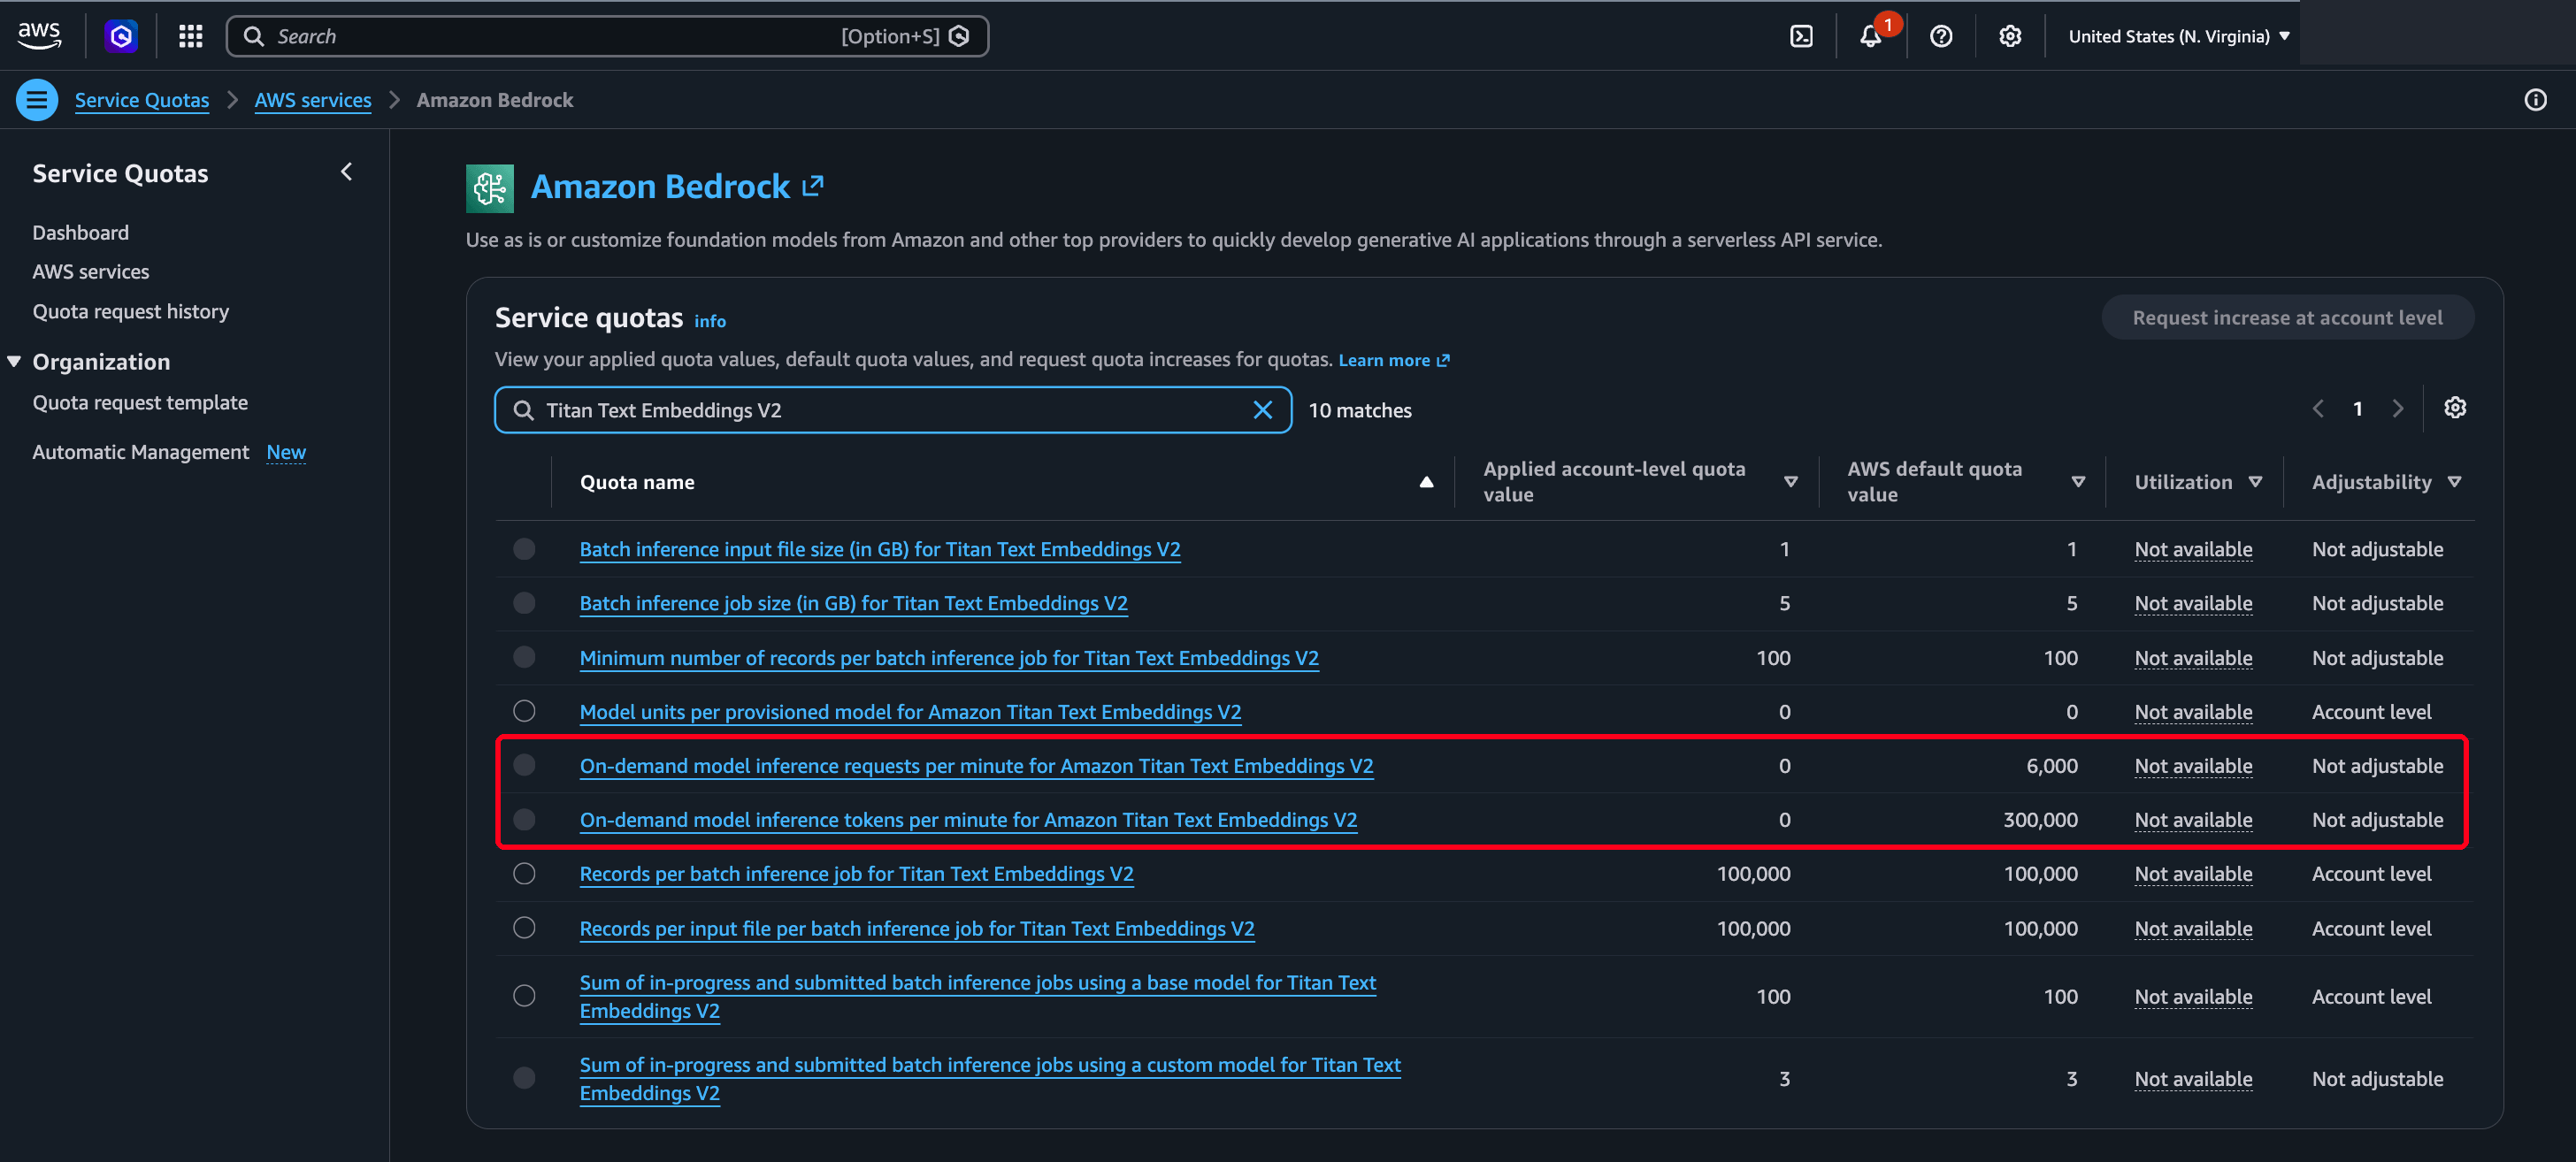
Revisa tu cuota de incrustación antes de construir nada, porque puede ser cero y nada en el flujo de creación te lo advierte. Una cuenta nueva puede tener una cuota bajo demanda de 0 solicitudes por minuto para el modelo de incrustación. Esa cuota te permite crear la base de conocimiento y la fuente de datos normalmente, pero luego falla cada trabajo de ingesta. Confírmalo en una sola llamada, y solicita un aumento en Service Quotas si marca cero:
aws service-quotas list-service-quotas --service-code bedrock --region YOUR_REGION \
  --query "Quotas[?contains(QuotaName,'Titan Text Embeddings V2')].[QuotaName,Value]" --output text
Ejecútalo contra la región que realmente pretendes usar, porque AWS establece la cuota por región, y la diferencia puede ser todo o nada. En una cuenta, el mismo día, Titan Text Embeddings V2 tenía una cuota aplicada bajo demanda de 0 solicitudes por minuto y 0 tokens por minuto en US East (Norte de Virginia):
En US East (Ohio) el mismo modelo tenía 60 solicitudes por minuto y 300,000 tokens por minuto:
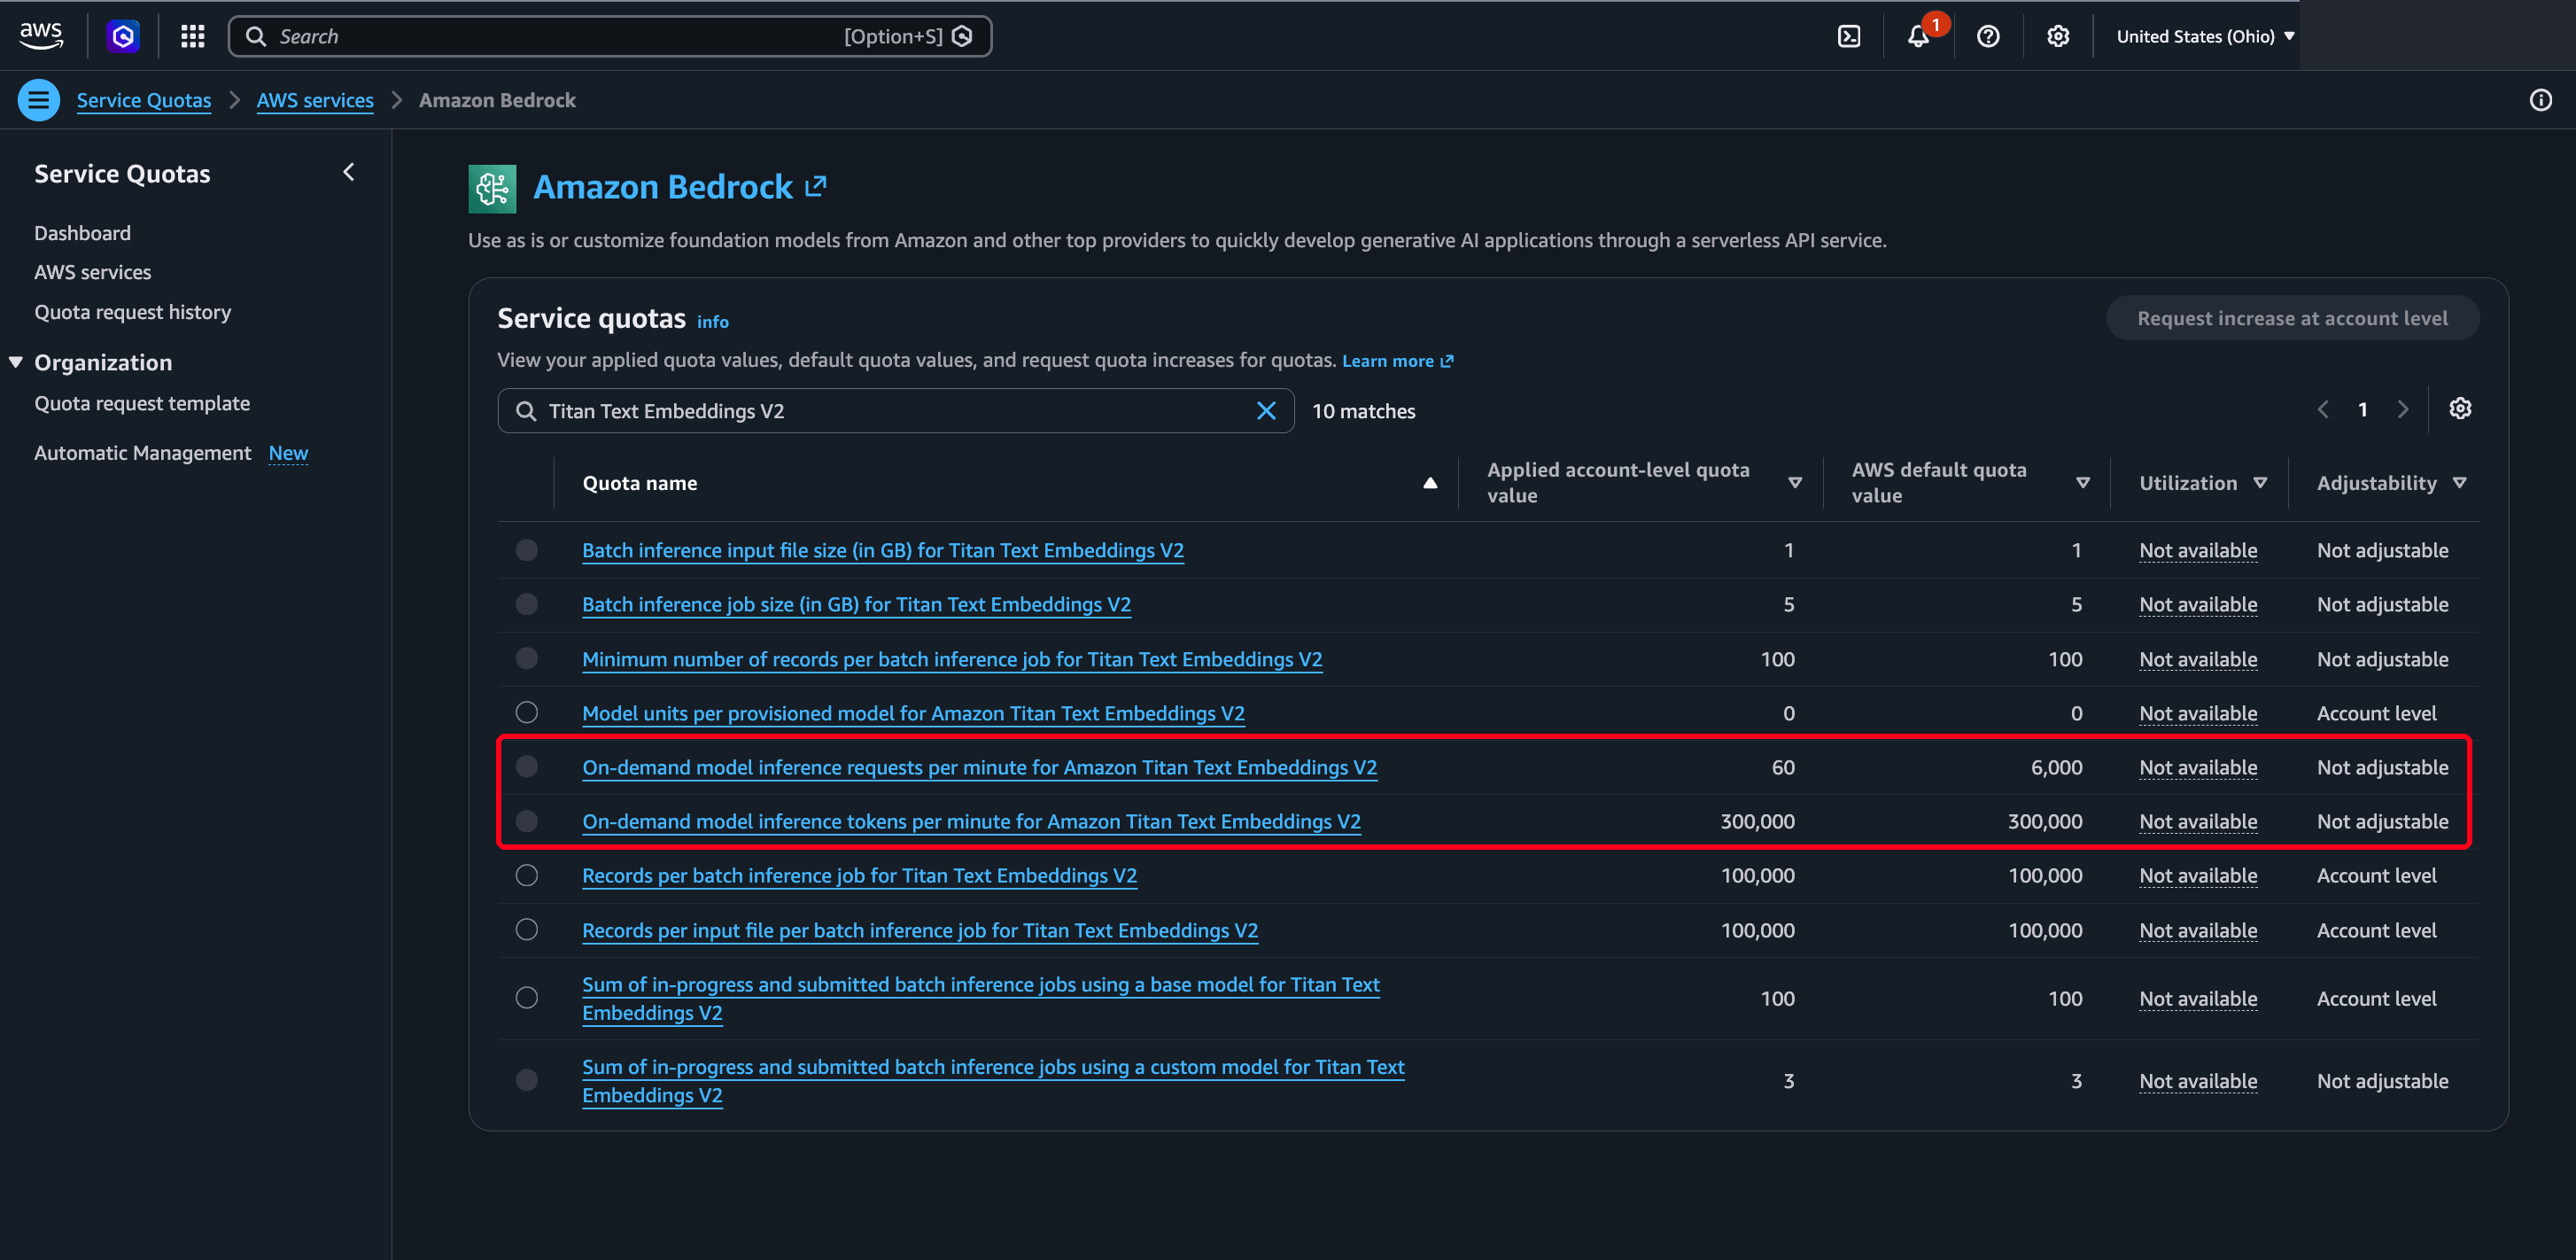
Compara el valor aplicado con el predeterminado de AWS en la consola de Service Quotas. Una cuota de 60 contra un predeterminado de 6,000 significa que la región que funciona sigue ejecutándose a una centésima parte de la tasa de solicitudes estándar. La cuota de tokens junto a ella está en el valor predeterminado completo, así que las solicitudes por minuto son el límite que importa. A aproximadamente 300 tokens por fragmento, 60 solicitudes por minuto son unos 18,000 tokens por minuto contra un tope de 300,000. Eso es suficiente para un corpus pequeño. Es un cuello de botella para uno grande.
Dos mensajes de error en este pipeline señalan la causa equivocada.
AccessDeniedExceptionenCreateKnowledgeBase, nombrando tu usuario y la acción. Esto generalmente significa unroleArnmal formado en lugar de un problema de permisos, así que revisa la cadena ARN antes de auditar IAM.not able to call specified bedrock embedding modeldurante la ingesta. Esto parece un error de permisos, y una cuota de incrustación en cero también lo produce. Invoca el modelo de incrustación directamente como tú mismo, y si eso también se limita, tienes un problema de cuota.
Ambos son problemas de configuración y no del pipeline, y ninguno vuelve a aparecer una vez que la cuenta está correcta.
Paso 1 – Extraer las páginas con Bright Data
El Web Unlocker de Bright Data toma una sola URL y devuelve la página. Las comprobaciones antibots y el enrutamiento de proxy ocurren de su lado, y renderiza JavaScript cuando habilitas esa opción. Establece data_format en markdown, y en lugar de HTML sin procesar obtienes la página como Markdown, que es la forma que quieres para RAG.
Creas la zona de Web Unlocker una vez en el panel de control de Bright Data, y cada solicitud hace referencia a ella por nombre. La zona también lleva la configuración de geolocalización. Para un sitio que sirve contenido distinto según el país, Web Unlocker obtiene datos desde el país que configures ahí, no desde donde resulte que se ejecuta tu cargador. El código a continuación necesita dos cosas de la pestaña Overview de la zona: el nombre de la zona (web_unlocker aquí) y el token de API.
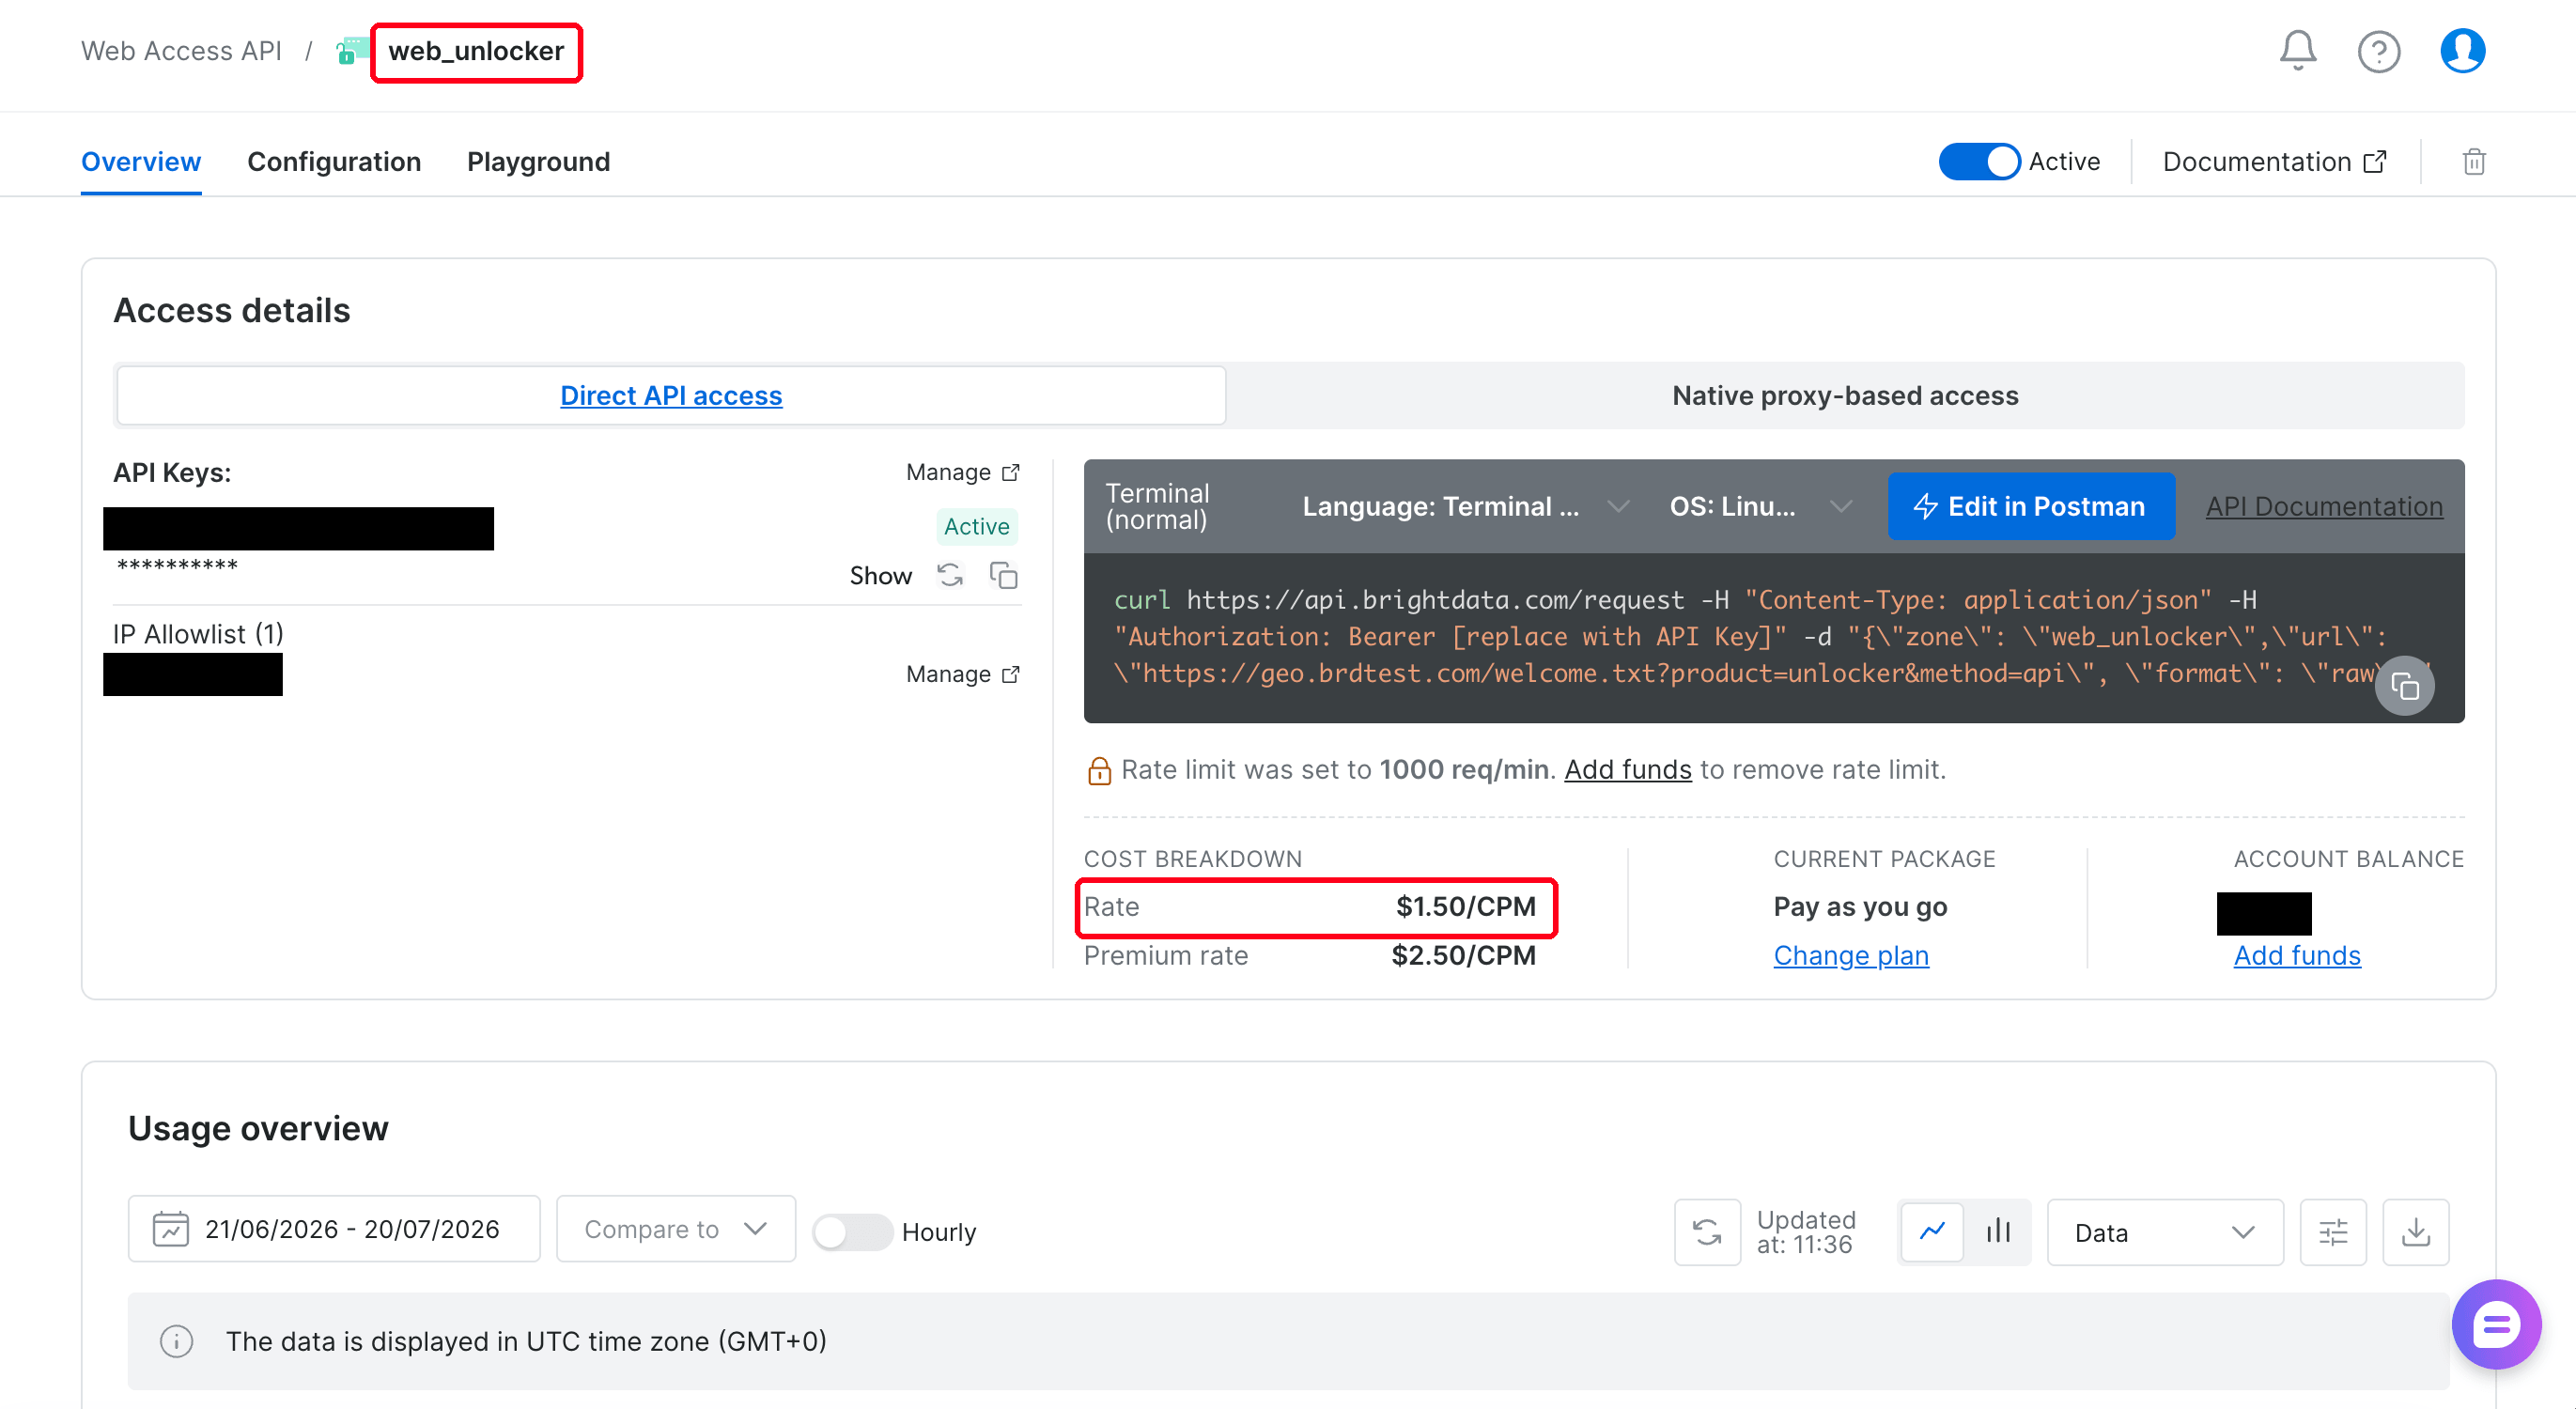
En Python esa llamada es un POST que lleva la zona, la URL objetivo, y el formato de salida que quieres:
import requests

BRIGHTDATA_TOKEN = "..."   # de tu cuenta de Bright Data
UNLOCKER_ZONE = "web_unlocker"

def scrape_markdown(url: str) -> str:
    """Obtiene una URL pública como Markdown vía Bright Data Web Unlocker."""
    resp = requests.post(
        "https://api.brightdata.com/request",
        headers={"Authorization": f"Bearer {BRIGHTDATA_TOKEN}"},
        json={
            "zone": UNLOCKER_ZONE,
            "url": url,
            "format": "raw",            # devuelve el cuerpo de la respuesta directamente
            "data_format": "markdown",  # convierte la página a Markdown
            # agrega "render": "true" cuando el contenido solo existe tras JS del lado del cliente
        },
        timeout=120,
    )
    resp.raise_for_status()
    return resp.text
No hay sesión de navegador que gestionar, ni paso de CAPTCHA, ni análisis de HTML.
Un fallo aquí no parece un fallo. Tres cosas devuelven un 200 vacío en lugar de un error: un nombre de zona equivocado, un token revocado, o una lista blanca de IP que ya no coincide con tu dirección actual. Así que raise_for_status lo acepta, y tu cargador almacena la página como un documento en blanco. Revisa la longitud de la respuesta, no solo el código de estado. Para un pipeline programado, omite la lista blanca y deja que el token sea la credencial.
Un navegador sin interfaz también renderizaría JavaScript por ti, y esa parte se mantiene igual. El resto no es una configuración que ajustas una sola vez. Es un flujo en constante cambio: encontrar una IP de salida que funcione para este objetivo, personalizar encabezados, y rotar huellas digitales cuando cambia la detección. El modelo de precios pone ese riesgo en Bright Data, ya que no factura las solicitudes fallidas.
Una vez que tienes la página, aún necesita estructuración, parseo, y limpieza, ya que el HTML es desordenado. El formato markdown traslada ese trabajo al lado de Bright Data.
Activa el renderizado solo cuando la página lo necesite
Web Unlocker no inicia un navegador en cada solicitud. Usa la ruta rápida para una página que puede obtener sin ejecutar JavaScript. Para contenido que solo existe tras el renderizado del lado del cliente, establece render en "true".
La página de práctica quotes.toscrape.com/js inyecta su contenido con JavaScript. Un GET simple arrojó 96 caracteres de texto indexable y ninguna de las citas, la ruta rápida devolvió un cascarón de 191 caracteres, y solo la solicitud renderizada devolvió los 1,583 caracteres completos. En esa página la solicitud renderizada terminó en 7.7 segundos, frente a 17.1 segundos en la ruta rápida. Eso es una muestra de uno en cada ruta, así que trata el renderizado como un interruptor de corrección y no como una penalización de latencia, y mide tus propios objetivos.
El 8_render_check.py del repositorio ejecuta esta comprobación triple contra cualquier URL, así que es lo primero que probar cuando un scraping parece sospechosamente escaso. Solo necesita un token de Bright Data y nada más. Puedes apuntarlo a tus propias URLs y ver qué devuelve cada ruta antes de crear un solo recurso de AWS. Si el contenido sigue ausente con el renderizado activado, la página probablemente necesita interacción, lo cual cubre la Browser API y Web Unlocker no. El script sale con código distinto de cero en esa página cuando pasas --probe:

Las páginas extraídas a continuación se renderizan del lado del servidor, así que la ejecución predeterminada deja render desactivado.
Extrae una lista, no una página
Web Unlocker es una solicitud por URL, así que un pequeño grupo de hilos mantiene un rendimiento alto sin un framework pesado:
from concurrent.futures import ThreadPoolExecutor

def scrape_many(urls: list[str], workers: int = 8) -> dict[str, str]:
    """Extrae un lote de URLs. Devuelve {url: markdown} para las que tienen éxito."""
    out: dict[str, str] = {}
    with ThreadPoolExecutor(max_workers=workers) as pool:
        for url, md in zip(urls, pool.map(_safe_scrape, urls)):
            if md:
                out[url] = md
    return out

def _safe_scrape(url: str) -> str | None:
    try:
        return scrape_markdown(url)
    except requests.RequestException:
        return None   # una página que falla se omite, no es fatal
Una página fallida devuelve None y abandona el lote en lugar de detener la ejecución. El cargador en el repositorio es más estricto que este fragmento. Reintenta dos veces con una espera de 1 segundo y luego de 2 segundos. También trata un cuerpo vacío o HTML como un fallo, no como contenido. Eso significa que una página que no se pudo obtener conserva su versión anterior en el corpus, y nada en una respuesta posterior la marca como obsoleta. Trata los fallos de obtención como una señal sobre la que actúas y no como una línea en un registro.
Web Unlocker obtuvo 6 páginas de documentación. Cada solicitud tardó entre 24.6 y 36.7 segundos, con una mediana de 30.6 segundos. Cada paso numerado aquí se ejecutó en vivo contra ese único corpus de 6 páginas en un solo día. Esas páginas son cooperativas, así que los tiempos miden el pipeline en sí y no las defensas de un objetivo. Desbloquear una página no es una obtención estática, lo que explica el tiempo, y la concurrencia lo hace manejable. Las mismas 6 páginas tardaron 43.1 segundos de tiempo total con 6 trabajadores, frente a los aproximadamente 3 minutos que tomaría una ejecución en serie.
Mantén el número de trabajadores bajo de todos modos, ya que el grupo apunta a un solo sitio. Bright Data limitó la zona anterior a 1,000 solicitudes por minuto hasta que agregues fondos. Con una mediana de 30 segundos, eso es mucho más margen del que usará un puñado de trabajadores. Revisa el tope de tu zona, y confirma la latencia en tus propios objetivos antes de escalar la lista.
Prefiere el gemelo Markdown propio del sitio
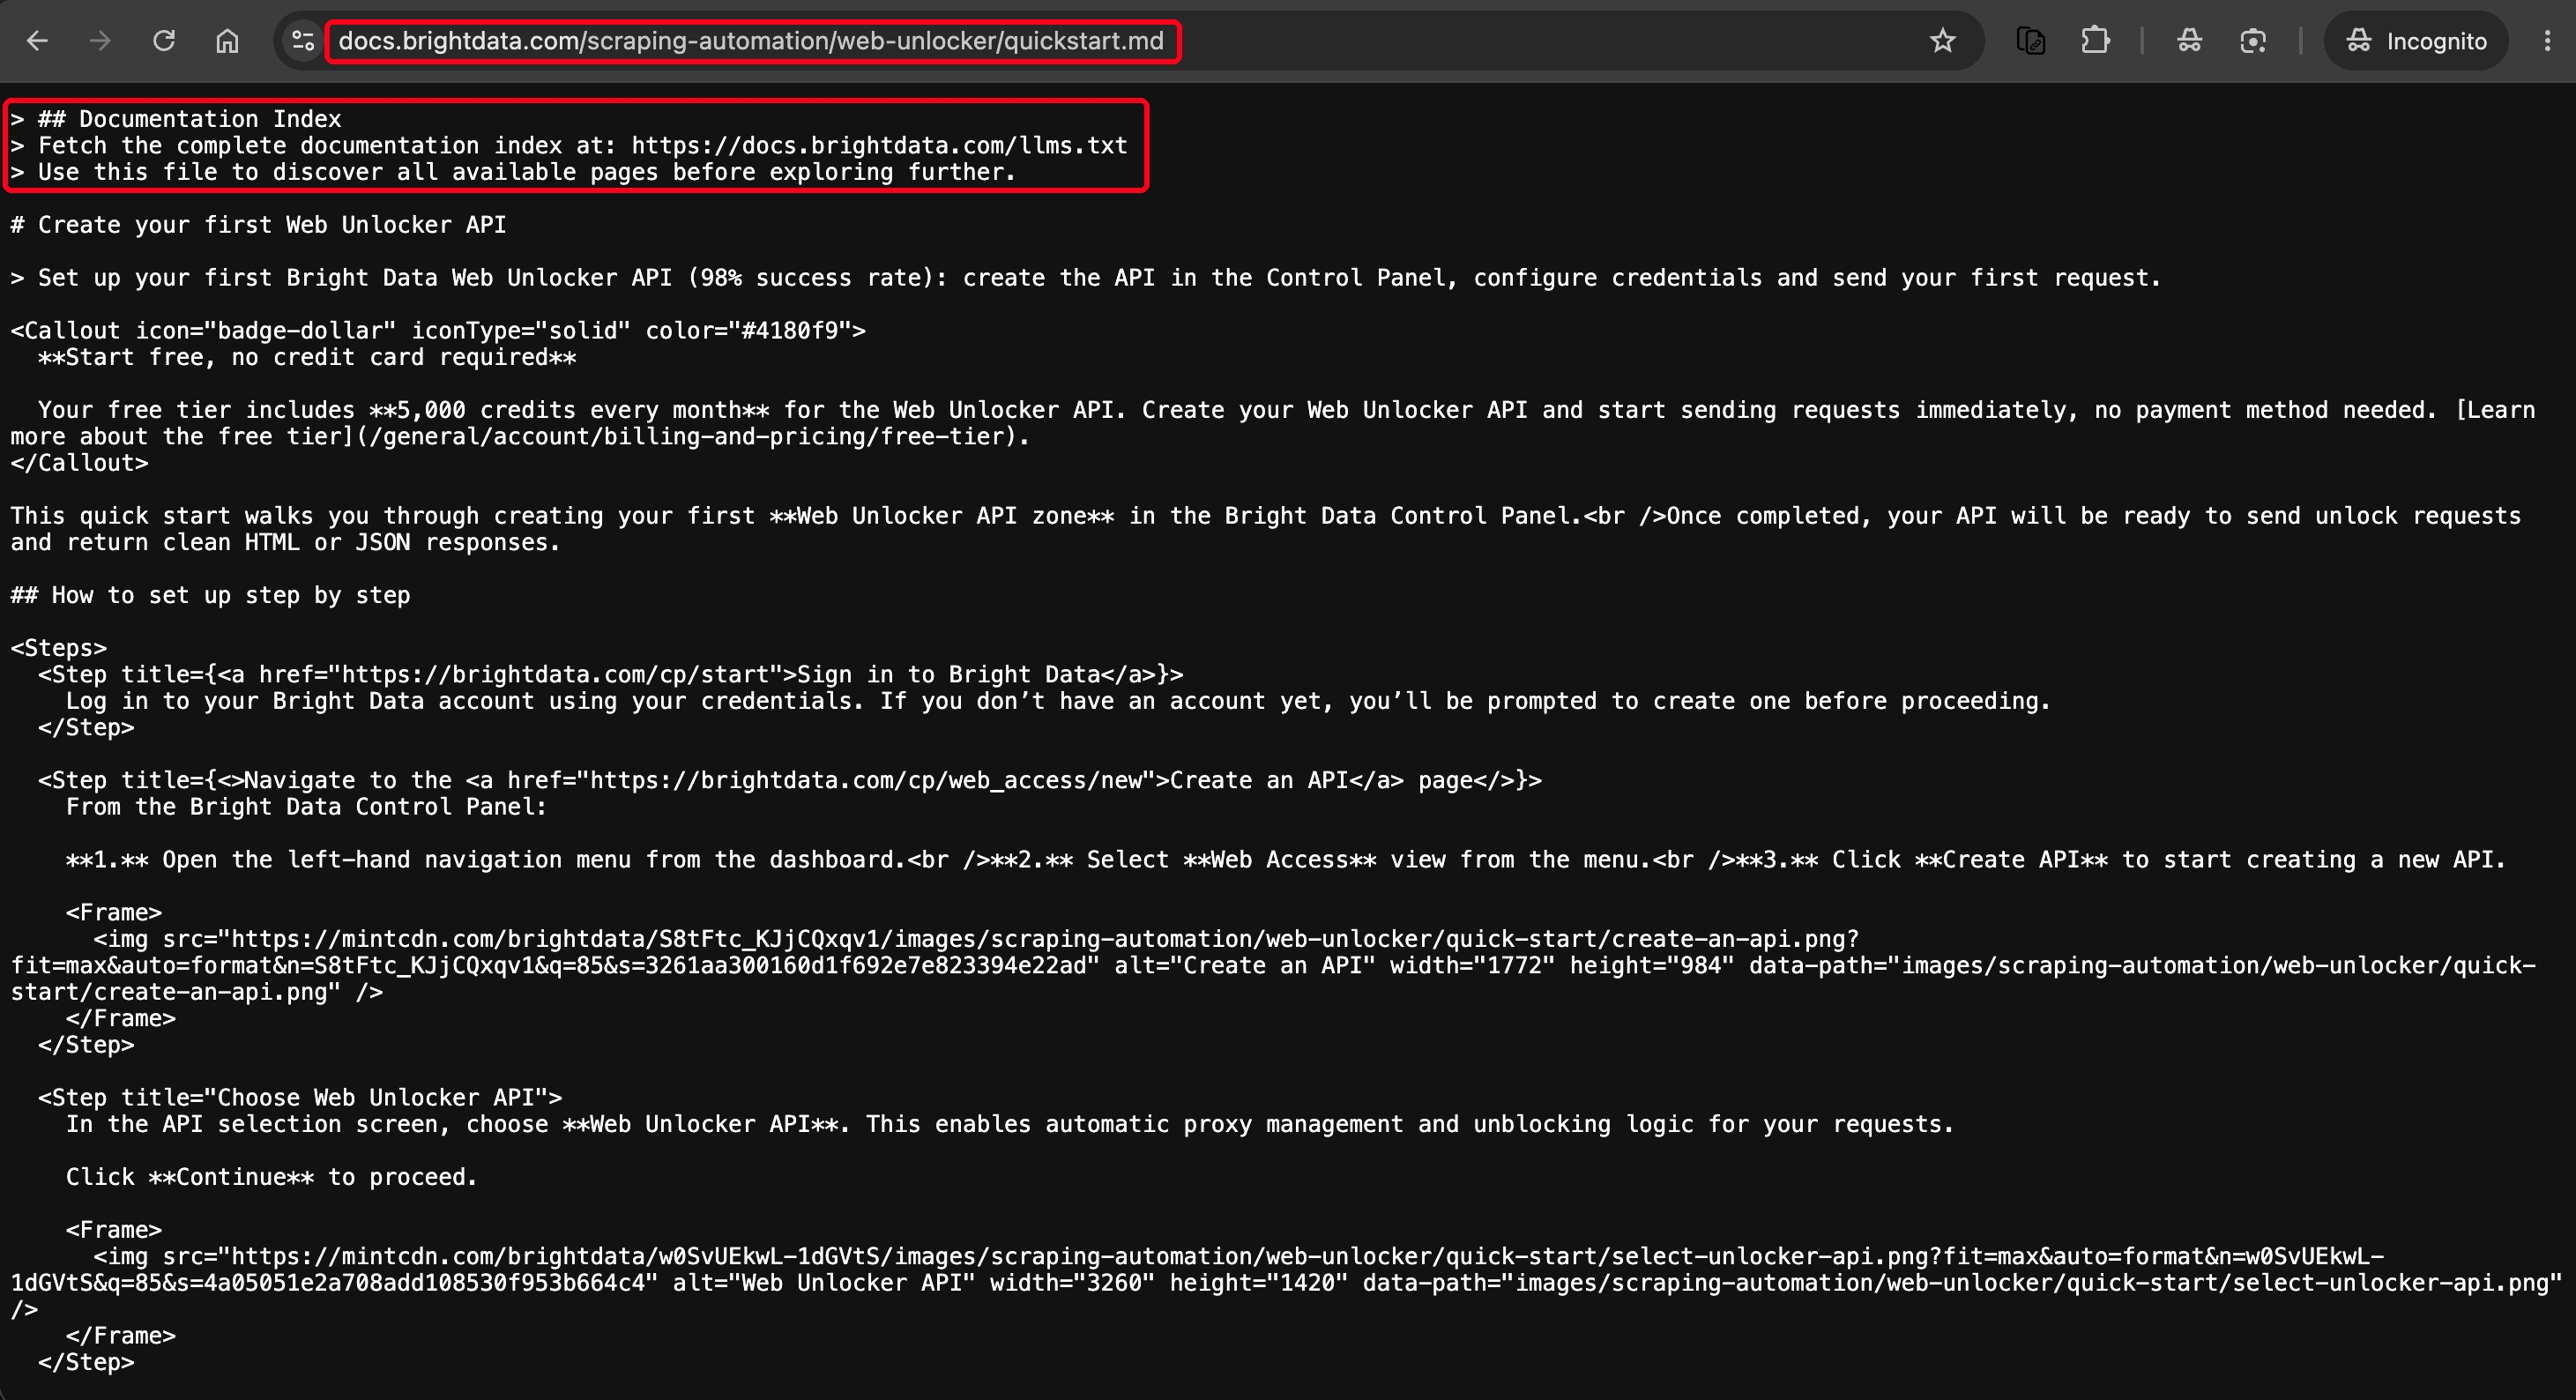
Antes de extraer un sitio, comprueba si ya publica lo que estás a punto de reconstruir. Muchas plataformas de documentación sirven un gemelo en Markdown listo para LLM de cada página, generalmente como <page-url>.md, y enumeran los gemelos en un índice /llms.txt. La propia documentación de Bright Data publica gemelos y los indexa en docs.brightdata.com/llms.txt, así que las 6 páginas anteriores tenían un gemelo. Esos gemelos son gratuitos, y un solo GET los devuelve en lugar de un scraping de 30.6 segundos. No llevan nada de la navegación que recoge el scraping.
No son prosa simple. El gemelo de abajo todavía lleva las etiquetas de componentes propias de la plataforma y URLs de imágenes completas, así que cambias el chrome del sitio por marcado que una eliminación basada en líneas no detectará:
Fuera de las plataformas de documentación para desarrolladores, un gemelo en Markdown es poco común, y Web Unlocker hace el trabajo ahí. Eso convierte la obtención en una decisión de dos pasos:
def fetch_page(url: str) -> str:
    """Prefiere el gemelo Markdown propio del sitio. Extrae solo cuando no hay uno."""
    return native_markdown(url) or scrape_markdown(url)
native_markdown es el helper src/web_kb/clean.py del repositorio, un GET de <page-url>.md que devuelve None cuando la página no tiene gemelo. No elimina el marcado de componentes, y la eliminación de chrome en el Paso 2 tampoco lo hace. Un corpus rico en gemelos necesita un paso propio con reconocimiento de etiquetas.
Cuando sí tengas que extraer, Web Unlocker devuelve la página en lugar de decidir qué partes son el contenido principal. En 6 páginas de un sitio de documentación en vivo, el Markdown aún llevaba chrome del sitio: la franja del logo, un enlace “Saltar al contenido principal”, el cuadro de búsqueda, el árbol completo de navegación lateral, y un pie de página “¿Te resultó útil esta página?”. Ese chrome era aproximadamente el 43% de los caracteres. El Paso 2 cubre la eliminación de lo que se repite.
Paso 2 – Escribir documentos y metadatos limpios en S3
Bedrock lee cada archivo compatible bajo el prefijo que le des. Cada uno se convierte en un documento de hasta 50 MB, con un sidecar opcional junto a él para metadatos. Tú escribes ambos.
Elimina primero el chrome
Un bloque de navegación es casi idéntico en cada página de un sitio, así que un corpus de 50 páginas incrusta ese mismo bloque 50 veces. Pagas por incrustarlo, pagas por almacenarlo, y en el momento de la consulta esos 50 fragmentos casi idénticos compiten con el contenido que alguien solicitó. La deduplicación más adelante en este paso no puede detectarlo, porque las páginas no son duplicados. Solo su chrome se repite.
No necesitas reglas específicas del sitio para eliminarlo, porque la mayor parte del chrome es texto que se repite. Cuenta cuántas veces aparece cada línea en el lote y descarta las que aparecen en la mayoría de las páginas:
from collections import Counter

KEEP = {"", "-" * 3, "`" * 3}          # líneas en blanco, reglas y cercas simples nunca son chrome

def strip_repeated(pages: dict[str, str], threshold: float = 0.6) -> dict[str, str]:
    """Descarta líneas que se repiten en la mayoría de las páginas del lote. Esas son el chrome."""
    counts = Counter()
    for markdown in pages.values():
        for line in {ln.strip() for ln in markdown.splitlines()}:
            if line not in KEEP and len(line) >= 2:   # >= 2 para que cuente la pista ⌘K
                counts[line] += 1

    cutoff = max(2, int(len(pages) * threshold))
    boilerplate = {line for line, n in counts.items() if n >= cutoff}
    return {url: "\n".join(ln for ln in md.splitlines() if ln.strip() not in boilerplate)
            for url, md in pages.items()}
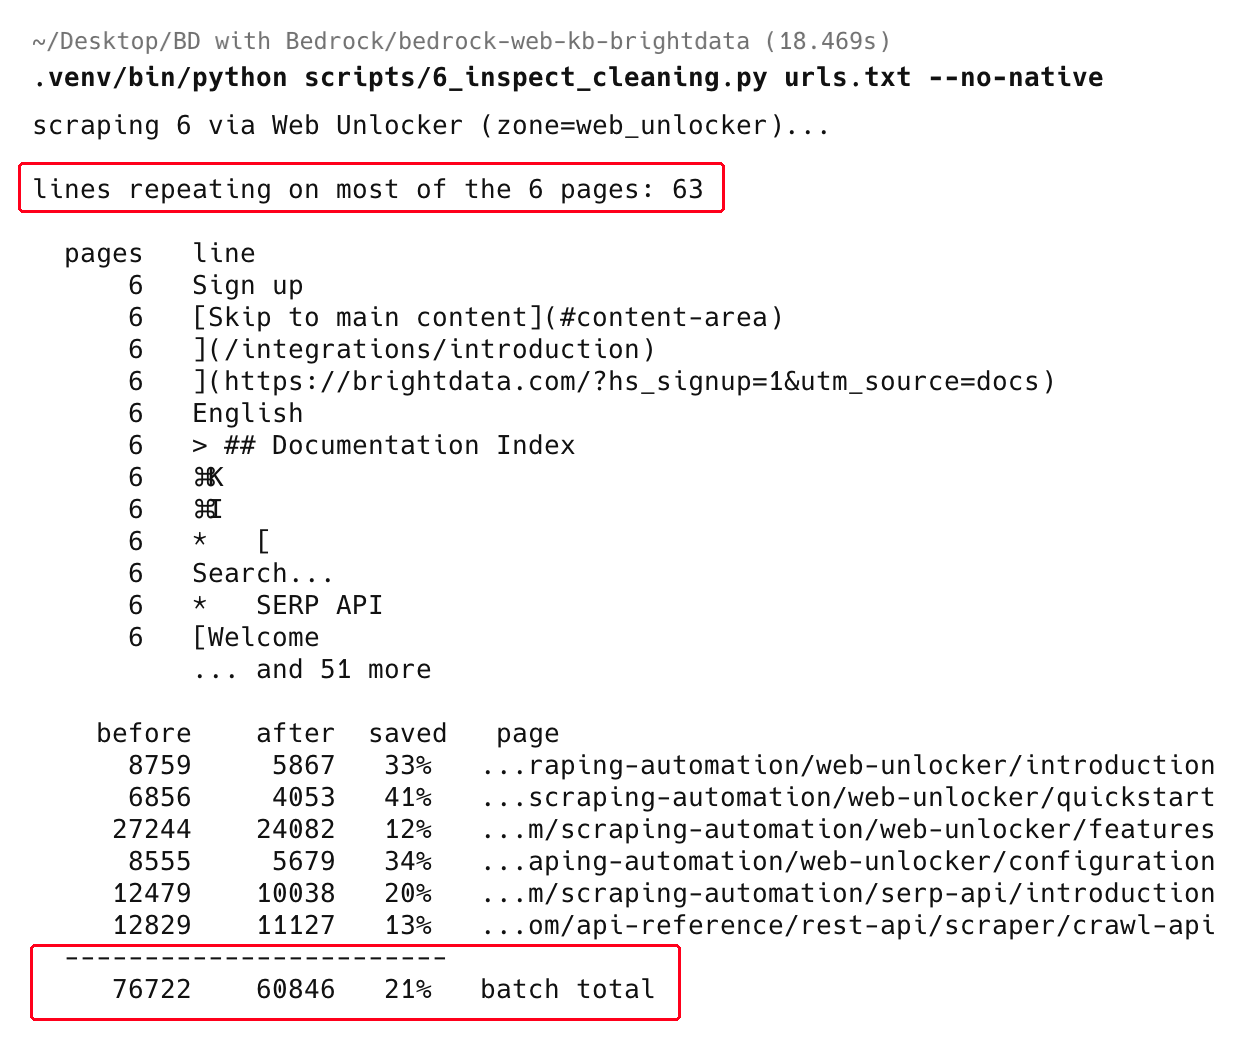
En la muestra de 6 páginas esto llevó al lote de 76,722 a 60,846 caracteres, un recorte del 21%. Eso es aproximadamente la mitad del chrome que midió el Paso 1. La regla solo se activa en líneas que son idénticas entre páginas, pero algunos sitios redactan su navegación de forma un poco distinta en cada página. Las líneas que se repitieron en la mayoría del lote pasaron de 63 a 0. Cada una de esas líneas podría haberse convertido en un fragmento duplicado. Las 6 páginas mostraban el cuadro de búsqueda, la pista de atajo ⌘K, el selector de idioma, y cada enlace de navegación lateral.
Los ahorros son desiguales, porque el chrome es un costo fijo por página. En esta ejecución eliminó el 41% de la página más corta y el 12% de la más larga. Un corpus de muchas páginas cortas pagaría de otro modo el mayor costo por incrustar navegación.
La técnica es una heurística, no un parser, así que audítala antes de confiar en ella en un sitio nuevo. En un corpus rico en código, agrega también las cercas etiquetadas por idioma a KEEP, ya que KEEP solo protege las simples, y descartar una cerca de apertura compartida deja huérfana su cerca de cierre.
El 6_inspect_cleaning.py del repositorio enumera cada línea que descartaría, y --verify puntúa lo que sobrevivió contra el propio gemelo Markdown de una página. En este corpus la eliminación no perdió ningún contenido exclusivo de página. Por esa comparación, la única línea faltante en cada página era el mismo código repetitivo de llms.txt. Para HTML sin procesar en lugar de Markdown, usa un extractor dedicado como Trafilatura.
Las 6 páginas publican un gemelo Markdown, así que la ejecución predeterminada los usa siempre. Las cifras de scraping y chrome anteriores provienen de forzar la ruta de Web Unlocker con --no-native.
Escribe el documento y su sidecar
Bedrock empareja un documento con sus metadatos solo por el nombre de archivo. Para un documento quickstart-3f9a2c1b04.md, el archivo de metadatos es quickstart-3f9a2c1b04.md.metadata.json. Dentro, cada atributo tiene un valor tipado y una marca includeForEmbedding. Esa marca controla si Bedrock agrega el valor al texto incrustado. El cargador escribe el sidecar, luego el documento, marcado con el hash de contenido que permite que la próxima ejecución omita ambos:
import boto3, json, hashlib, re
from datetime import datetime, timezone

REGION = "us-east-2"                    # una región con cuota de incrustación distinta de cero
s3 = boto3.client("s3", region_name=REGION)
BUCKET = "web-kb-corpus-111122223333"   # tu bucket
PREFIX = "docs"

def slugify(url: str) -> str:
    """Clave de objeto estable y segura derivada de la URL."""
    digest = hashlib.sha1(url.encode()).hexdigest()[:10]
    tail = url.rstrip("/").split("/")[-1][:40] or "page"
    safe = "".join(c if c.isalnum() or c in "-_" else "-" for c in tail)
    return f"{safe}-{digest}"

def content_hash(markdown: str) -> str:
    """Calcula el hash del texto significativo. Normalizar los espacios evita que distintos
    saltos de línea parezcan un cambio de contenido."""
    return hashlib.sha256(re.sub(r"\s+", " ", markdown).strip().encode()).hexdigest()

def stored_hash(key: str) -> str | None:
    """El hash guardado en el objeto la última vez, o None si el objeto no está ahí.

    Solo un objeto faltante cuenta como ausente. Capturar cada ClientError reportaría
    AccessDenied o throttling como una página nueva, la reescribiría, y volvería a incrustar el corpus."""
    try:
        return s3.head_object(Bucket=BUCKET, Key=key)["Metadata"].get("content-hash")
    except s3.exceptions.ClientError as exc:
        if exc.response["Error"]["Code"] in ("404", "NoSuchKey", "NotFound"):
            return None
        raise

def put_document(url: str, markdown: str, title: str, section: str,
                 raw: str | None = None) -> str:
    key = f"{PREFIX}/{slugify(url)}.md"
    chash = content_hash(raw or markdown)   # calcula el hash del scraping CRUDO, no del cuerpo limpiado

    if stored_hash(key) == chash:
        return "unchanged"          # deja el objeto tal cual, para que la siguiente sincronización lo omita

    metadata = {
        "metadataAttributes": {
            "source_url":  {"value": {"type": "STRING", "stringValue": url},
                            "includeForEmbedding": False},
            "title":       {"value": {"type": "STRING", "stringValue": title},
                            "includeForEmbedding": True},
            "section":     {"value": {"type": "STRING", "stringValue": section},
                            "includeForEmbedding": True},
            "scraped_date":{"value": {"type": "NUMBER",
                                      "numberValue": int(datetime.now(timezone.utc).strftime("%Y%m%d"))},
                            "includeForEmbedding": False},
        }
    }
    # Sidecar primero. El documento lleva el hash contra el que compara la siguiente ejecución, así que es
    # el punto de confirmación. El orden inverso puede dejar un documento nuevo junto a un sidecar obsoleto
    # que nunca se autocorrige, porque el hash ya coincide.
    s3.put_object(Bucket=BUCKET, Key=f"{key}.metadata.json",
                  Body=json.dumps(metadata).encode("utf-8"),
                  ContentType="application/json")
    s3.put_object(Bucket=BUCKET, Key=key, Body=markdown.encode("utf-8"),
                  ContentType="text/markdown", Metadata={"content-hash": chash})
    return "written"
Escribe solo cuando cambia el hash de contenido
La comprobación de hash al inicio de put_document mantiene barata una actualización. En una sincronización incremental, Bedrock usa el propio seguimiento de cambios de la fuente de datos para decidir qué volver a incrustar. La documentación de AWS no indica actualmente qué señal lee Bedrock para S3. Un cargador que reescribe cada objeto en cada ejecución actualiza esa señal sin importar si el contenido cambió. El supuesto seguro es que una sincronización destinada a tocar tres páginas vuelve a incrustar todo el corpus, y pagas por todo eso. Comparar el hash de contenido antes de escribir significa que dejas en paz una página sin cambios, y no cuesta nada río abajo.
Los datos de Cloudflare sugieren que más de la mitad del tráfico de crawlers de IA va a volver a obtener páginas que no cambiaron. Esta comprobación no resuelve eso, porque obtienes la página de todos modos, y solo ahorra la incrustación. La programación de resincronización en el Paso 4 controla la obtención en sí.
Calcula el hash del scraping crudo en lugar del cuerpo sin chrome. Esa eliminación anterior en este paso es relativa al lote, así que una página sin cambios en un lote distinto de otro modo haría hash diferente y volvería a incrustarse para nada. El fragmento toma un argumento raw separado exactamente por esa razón, así que pasa el texto sin eliminar cuando lo llames.
El cargador del repositorio guarda los hashes que ha visto en una ejecución, así que también descarta duplicados exactos, donde dos URLs devuelven texto idéntico byte a byte. En la práctica eso cubre alias ?utm_source= y ?print=1. Una copia sindicada o una variante paginada difiere por unos pocos bytes y escapa a esa comprobación.
Detectar eso necesita detección de casi duplicados, y el repositorio lo incluye como MinHash detrás de una bandera opcional --near-dup en el cargador. Por defecto usa un umbral de similitud de 0.85. En este corpus las páginas distintas puntuaron como máximo 0.02, y una página contra su propio gemelo Markdown puntuó 0.75, así que el valor predeterminado conserva ambas. La implementación en Python puro es adecuada para corpus de hasta unos pocos miles de páginas. Con la latencia medida antes, eso es más de lo que normalmente cubrirá una sola ejecución por lotes.
Elige lo que llevan los metadatos
El sidecar contiene las dos cosas que un corpus obtenido mediante scraping pierde en el camino hacia un almacén de vectores. source_url da a cada fragmento recuperado una cita de vuelta a la página de la que provino, así que una respuesta puede mostrar su fuente. section y scraped_date se convierten en claves de filtro en el momento de la consulta. Puedes limitar una búsqueda a una parte del corpus, o a contenido que cambió después de una fecha límite.
El sidecar también lleva el title de la página. Establecer includeForEmbedding en True en title y section los agrega al texto incrustado, así que una consulta que mencione cualquiera de los dos tiene más contra qué comparar. Establecerlo en False en source_url mantiene una URL larga fuera de los vectores, donde agregaría más ruido que señal.
Bedrock admite los tipos de metadatos STRING, NUMBER, BOOLEAN, y STRING_LIST. Guardar scraped_date como NUMBER en forma YYYYMMDD te permite filtrar con greaterThan y lessThan más adelante. No reescribes una página sin cambios, así que conserva su fecha anterior. Esto convierte a scraped_date en un filtro de antigüedad de contenido, no en una señal de que una página todavía se actualiza. Esa señal necesita una marca de última vista separada, y el repositorio escribe una en cada obtención exitosa.
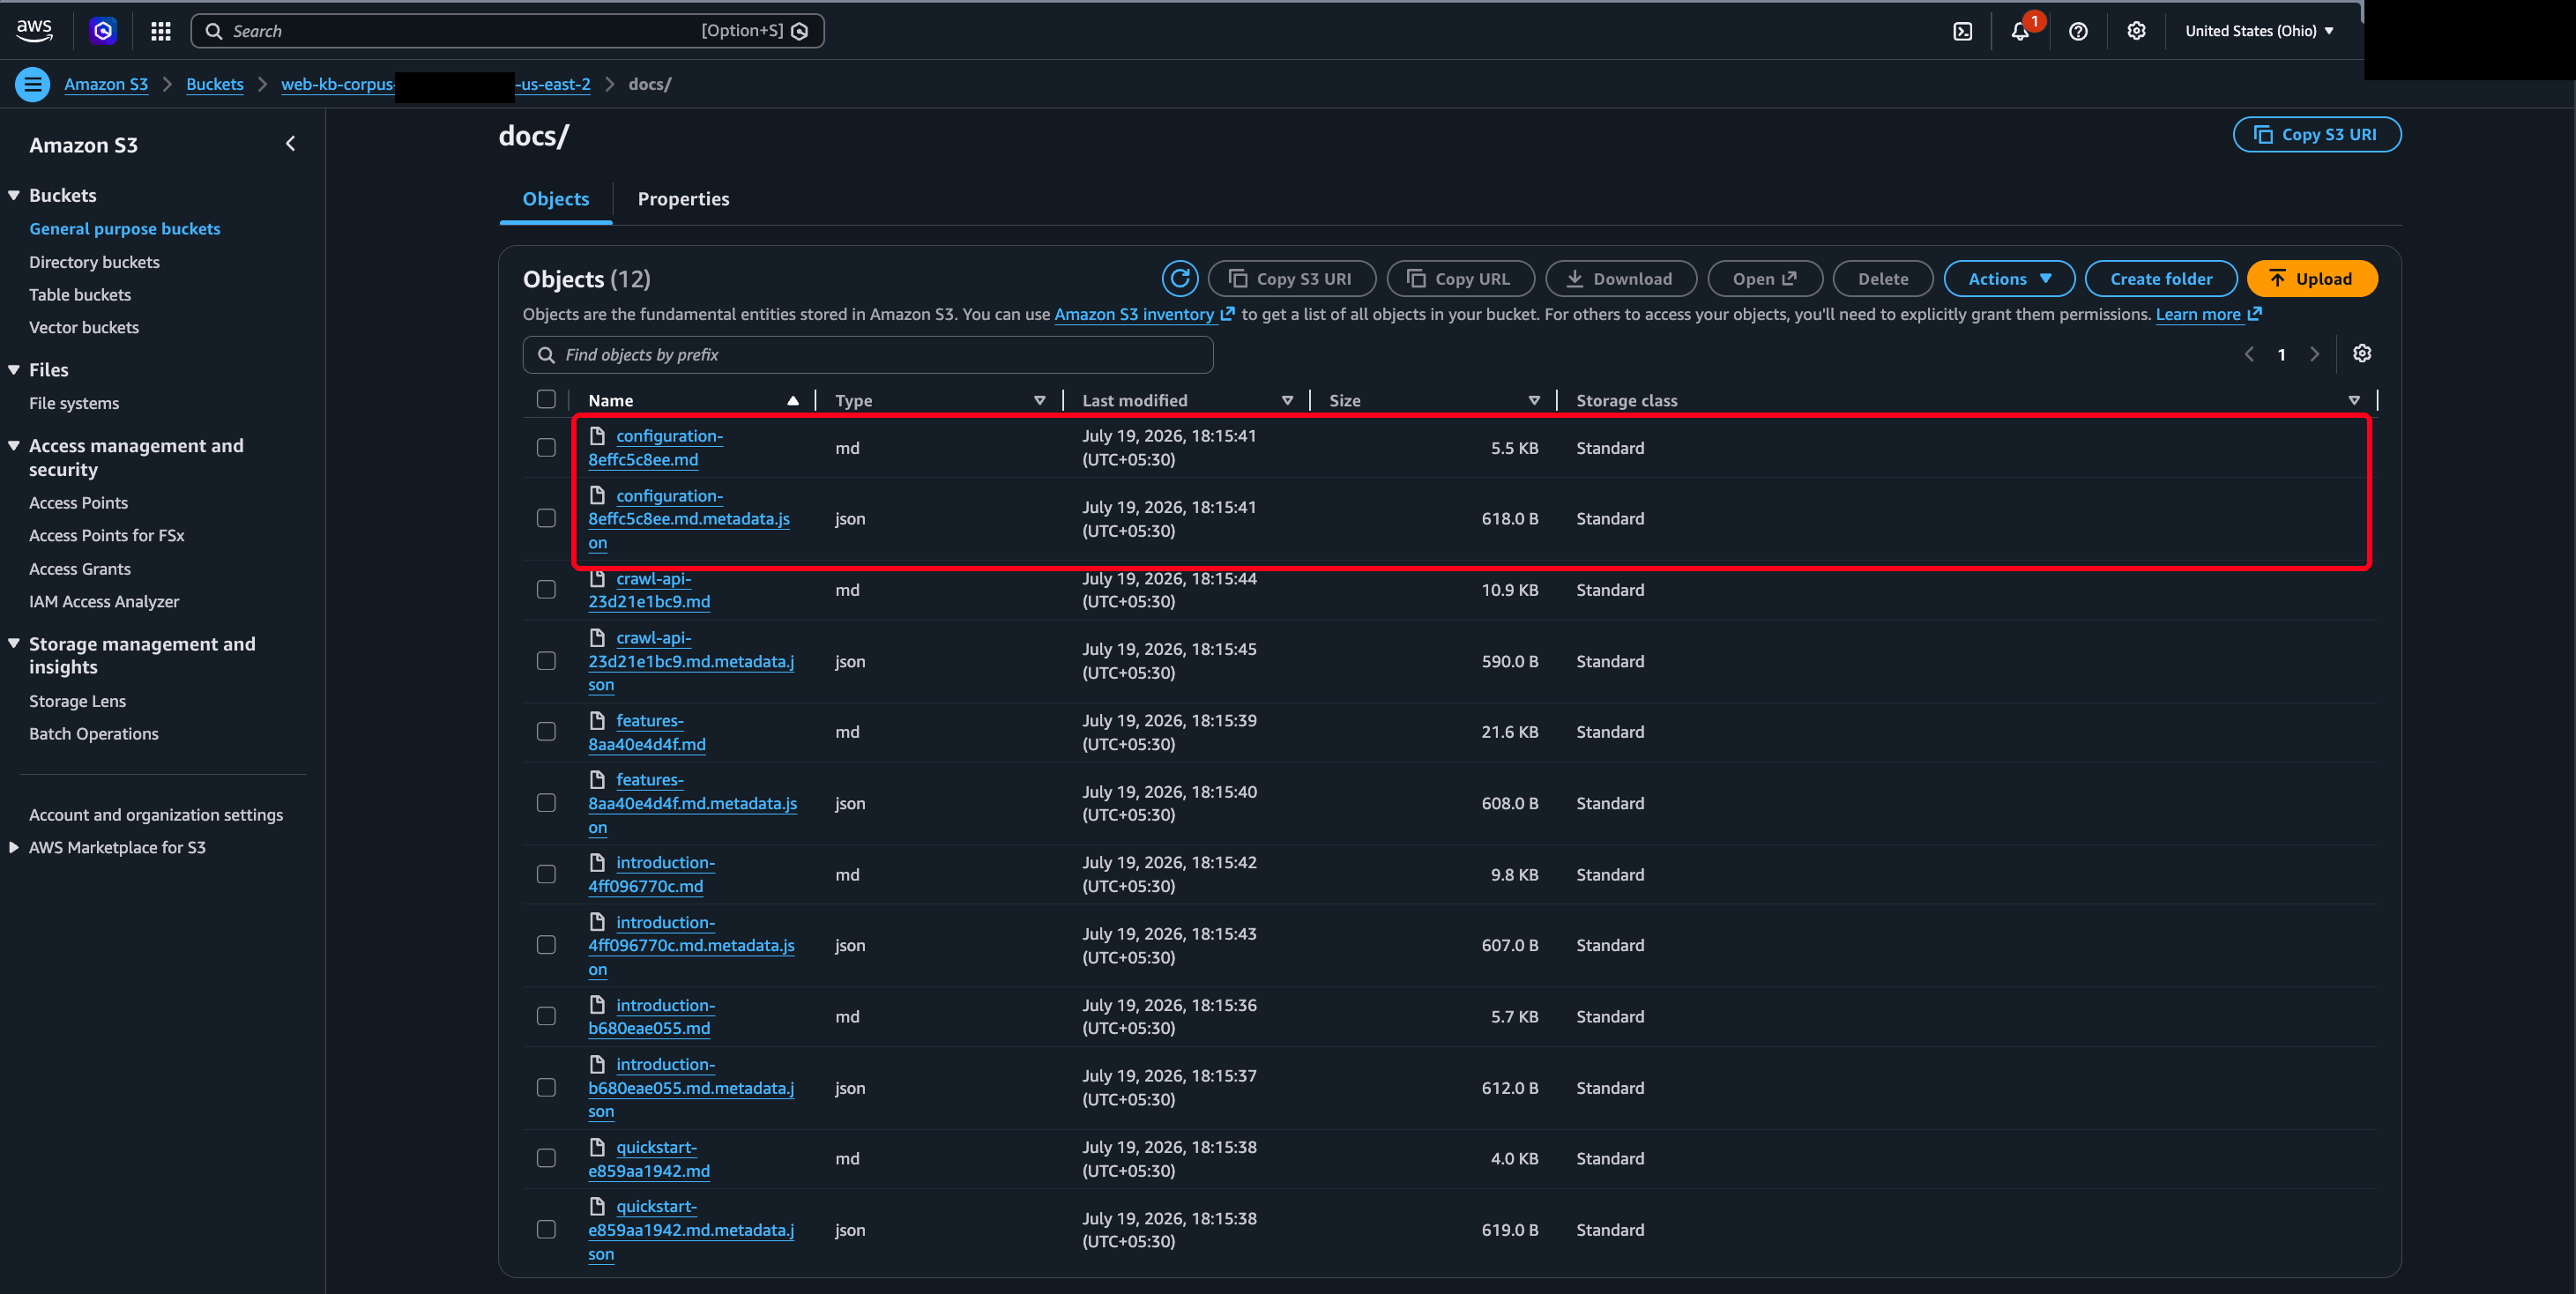
Ejecuta el cargador en tu lista de URLs, y el bucket entonces contiene un documento y un sidecar por página. Confirma los pares en la consola antes de apuntar una base de conocimiento al prefijo:
Paso 3 – Crear la base de conocimiento
Creas la base de conocimiento una vez. Después de eso el pipeline escribe archivos y activa sincronizaciones. La consola es el camino más claro para esa configuración, y el flujo de creación de base de conocimiento cubre cada pantalla.
Elige gestionada o gestionada por el cliente
La documentación de AWS recomienda la base de conocimiento totalmente gestionada por defecto. Según tu región, la consola también la ofrece. Las bases de conocimiento gestionadas ejecutan su propio almacén de datos, parseo, y reranking. También agregan recuperación agéntica e incluyen conectores nativos como Google Drive.
Esta construcción sigue la ruta gestionada por el cliente. Elegir tu propio almacén de vectores te da los precios de S3 Vectors a continuación, y deja el índice en tu cuenta. Una base de conocimiento gestionada puede ingerir los documentos que este pipeline escribe en S3, a través de la misma fuente de datos de S3. El vacío del crawler se mantiene igual en cualquiera de las dos rutas.
Fija las elecciones que no puedes cambiar después
Cuatro elecciones dan forma a la recuperación. Tres de las cuatro quedan fijas una vez que existen la base de conocimiento y su fuente de datos.
- Fuente de datos. Elige Amazon S3 y apúntalo a tu bucket y al prefijo
docs/. Bedrock entonces lee los documentos y sus sidecars desde ahí en cada sincronización. Una base de conocimiento acepta hasta 5 buckets como fuentes de datos. - Modelo de incrustación. Amazon Titan Text Embeddings V2 (
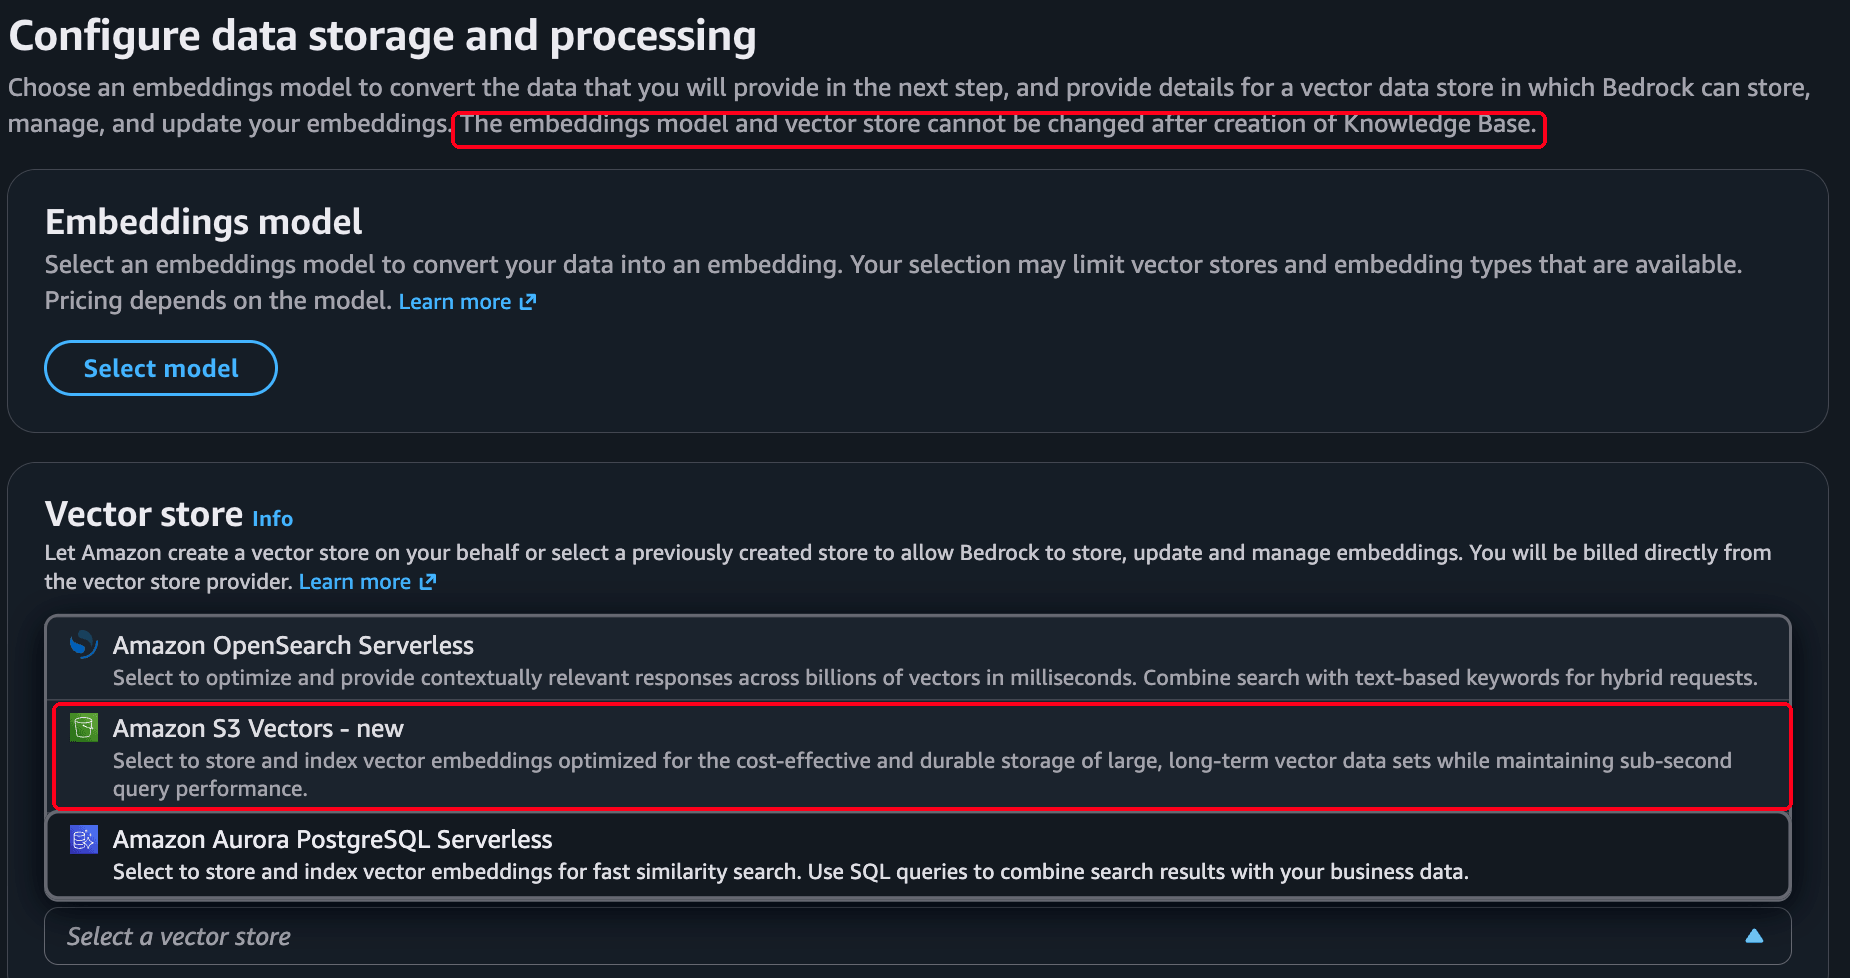
amazon.titan-embed-text-v2:0) es el predeterminado para texto, y es el modelo detrás de cada cifra de recuperación a continuación. Con 1024 dimensiones obtienes mejor calidad de recuperación, y con 256 obtienes menor costo de almacenamiento. Los modelos de incrustación compatibles incluyen Amazon Nova Multimodal Embeddings, que vale la pena considerar cuando un corpus mezcla texto con imágenes. Elige una sola vez, porque no puedes cambiar el modelo de incrustación en una base de conocimiento existente. - Almacén de vectores. Amazon S3 Vectors alcanzó disponibilidad general en diciembre de 2025. Almacena y consulta vectores con pago por uso sin clúster que ejecutar, y no puedes cambiarlo después de que exista la base de conocimiento. Crea su bucket e índice antes de abrir el asistente. Luego apunta el asistente a ese almacén existente, en lugar de dejar que Amazon cree uno por ti. La siguiente sección explica por qué. AWS dice que S3 Vectors reduce el costo de subir, almacenar, y consultar vectores hasta en un 90% comparado con soluciones alternativas sin nombrar. Amazon OpenSearch Serverless sigue siendo la opción cuando necesitas sus funciones de consulta o mayor rendimiento, aunque esta construcción se ejecutó solo en S3 Vectors. Para un corpus que actualizas según un programa en lugar de servir con alto volumen de consultas, ese intercambio suele valer la pena. La consola también ofrece Amazon Aurora PostgreSQL Serverless. Confirma el estado y precio actuales contra la documentación de S3 Vectors cuando construyas.
- Fragmentación. Los artículos extraídos tienen estructura de oraciones y párrafos, así que la fragmentación predeterminada de aproximadamente 300 tokens en límites de oración es un punto de partida razonable. Si extraes páginas de referencia largas, la fragmentación jerárquica recupera fragmentos hijo precisos y devuelve sus padres más amplios para contexto, aunque Bedrock recomienda no usarla en un almacén S3 Vectors. Bedrock también ofrece otras estrategias. La división de tamaño fijo usa un conteo de tokens que fijas. La fragmentación semántica agrupa por significado en lugar de longitud. Una opción sin fragmentación trata cada documento como un solo fragmento. No puedes cambiar la estrategia de fragmentación después de crear la fuente de datos.
El asistente te advierte sobre esto para el modelo de incrustación y el almacén de vectores, en la pantalla donde los configuras:
Nombra las claves de metadatos no filtrables
Si eliges S3 Vectors, marca el texto del fragmento y los propios metadatos de Bedrock como no filtrables al crear el índice. De lo contrario, Bedrock no logra ingerir la mayor parte de tu corpus. S3 Vectors permite como máximo 2048 bytes de metadatos filtrables por vector, y Bedrock usa parte de eso para el texto del fragmento y su propia contabilidad. Cualquier cosa excepto un fragmento muy corto supera el presupuesto. Después de ese gasto general, la documentación de la base de conocimiento de S3 Vectors establece la asignación práctica para tus atributos en 1 KB y 35 claves por vector. Mantén los sidecars pequeños.
En la primera ejecución, 5 de 6 documentos fallaron con Filterable metadata must have at most 2048 bytes, y el único que sobrevivió tenía un fragmento de 499 bytes. Nombrar ambas claves propias de Bedrock al crear el índice lo soluciona, y no puedes cambiar esa elección después:
aws s3vectors create-vector-bucket --vector-bucket-name YOUR_VECTOR_BUCKET --region YOUR_REGION

aws s3vectors create-index --vector-bucket-name YOUR_VECTOR_BUCKET --region YOUR_REGION \
  --index-name web-kb-index --data-type float32 --dimension 1024 --distance-metric cosine \
  --metadata-configuration '{"nonFilterableMetadataKeys":["AMAZON_BEDROCK_TEXT","AMAZON_BEDROCK_METADATA"]}'
El nombre que la gente confunde es AMAZON_BEDROCK_TEXT. AMAZON_BEDROCK_TEXT_CHUNK es el nombre de campo de OpenSearch, y nombrar ese en su lugar deja el fallo exactamente igual. El 2_create_kb.py del repositorio complementario crea el índice de esta manera por ti. También se niega a continuar contra un índice existente que carezca de esas claves. La alternativa es descubrir el problema durante una sincronización que informa éxito.
El asistente repite la advertencia para las estrategias de parseo y fragmentación una pantalla después.
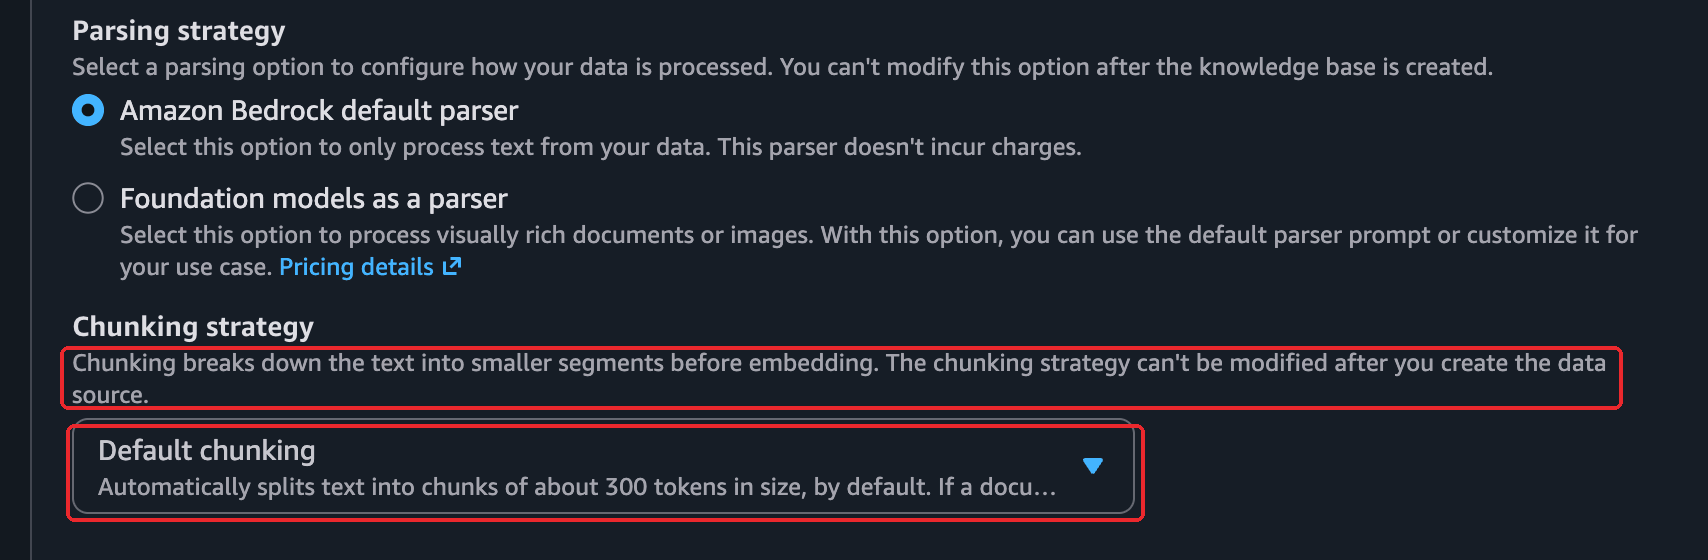
Esa misma pantalla lleva una función de transformación opcional. La recuperación contextual antepone una nota escrita por un modelo sobre el lugar de cada fragmento en el documento antes de la incrustación. Anthropic midió una caída del 35% en los fallos de recuperación top-20. Bedrock ejecuta esa función en la ingesta, al costo de una llamada al modelo por fragmento. Esta construcción la deja desactivada, así que las cifras de recuperación a continuación provienen solo de la fragmentación predeterminada.
Si prefieres crear la base de conocimiento en código, ese mismo 2_create_kb.py llama a create_knowledge_base y create_data_source del cliente bedrock-agent. Configura la configuración de S3 y el rol de servicio de IAM por ti. El repositorio también incluye Terraform para todo el lado de AWS. Es el camino más corto si prefieres no hacer clic en nada de esto, y fija las claves de metadatos no filtrables mencionadas, para que no puedas olvidarlas.
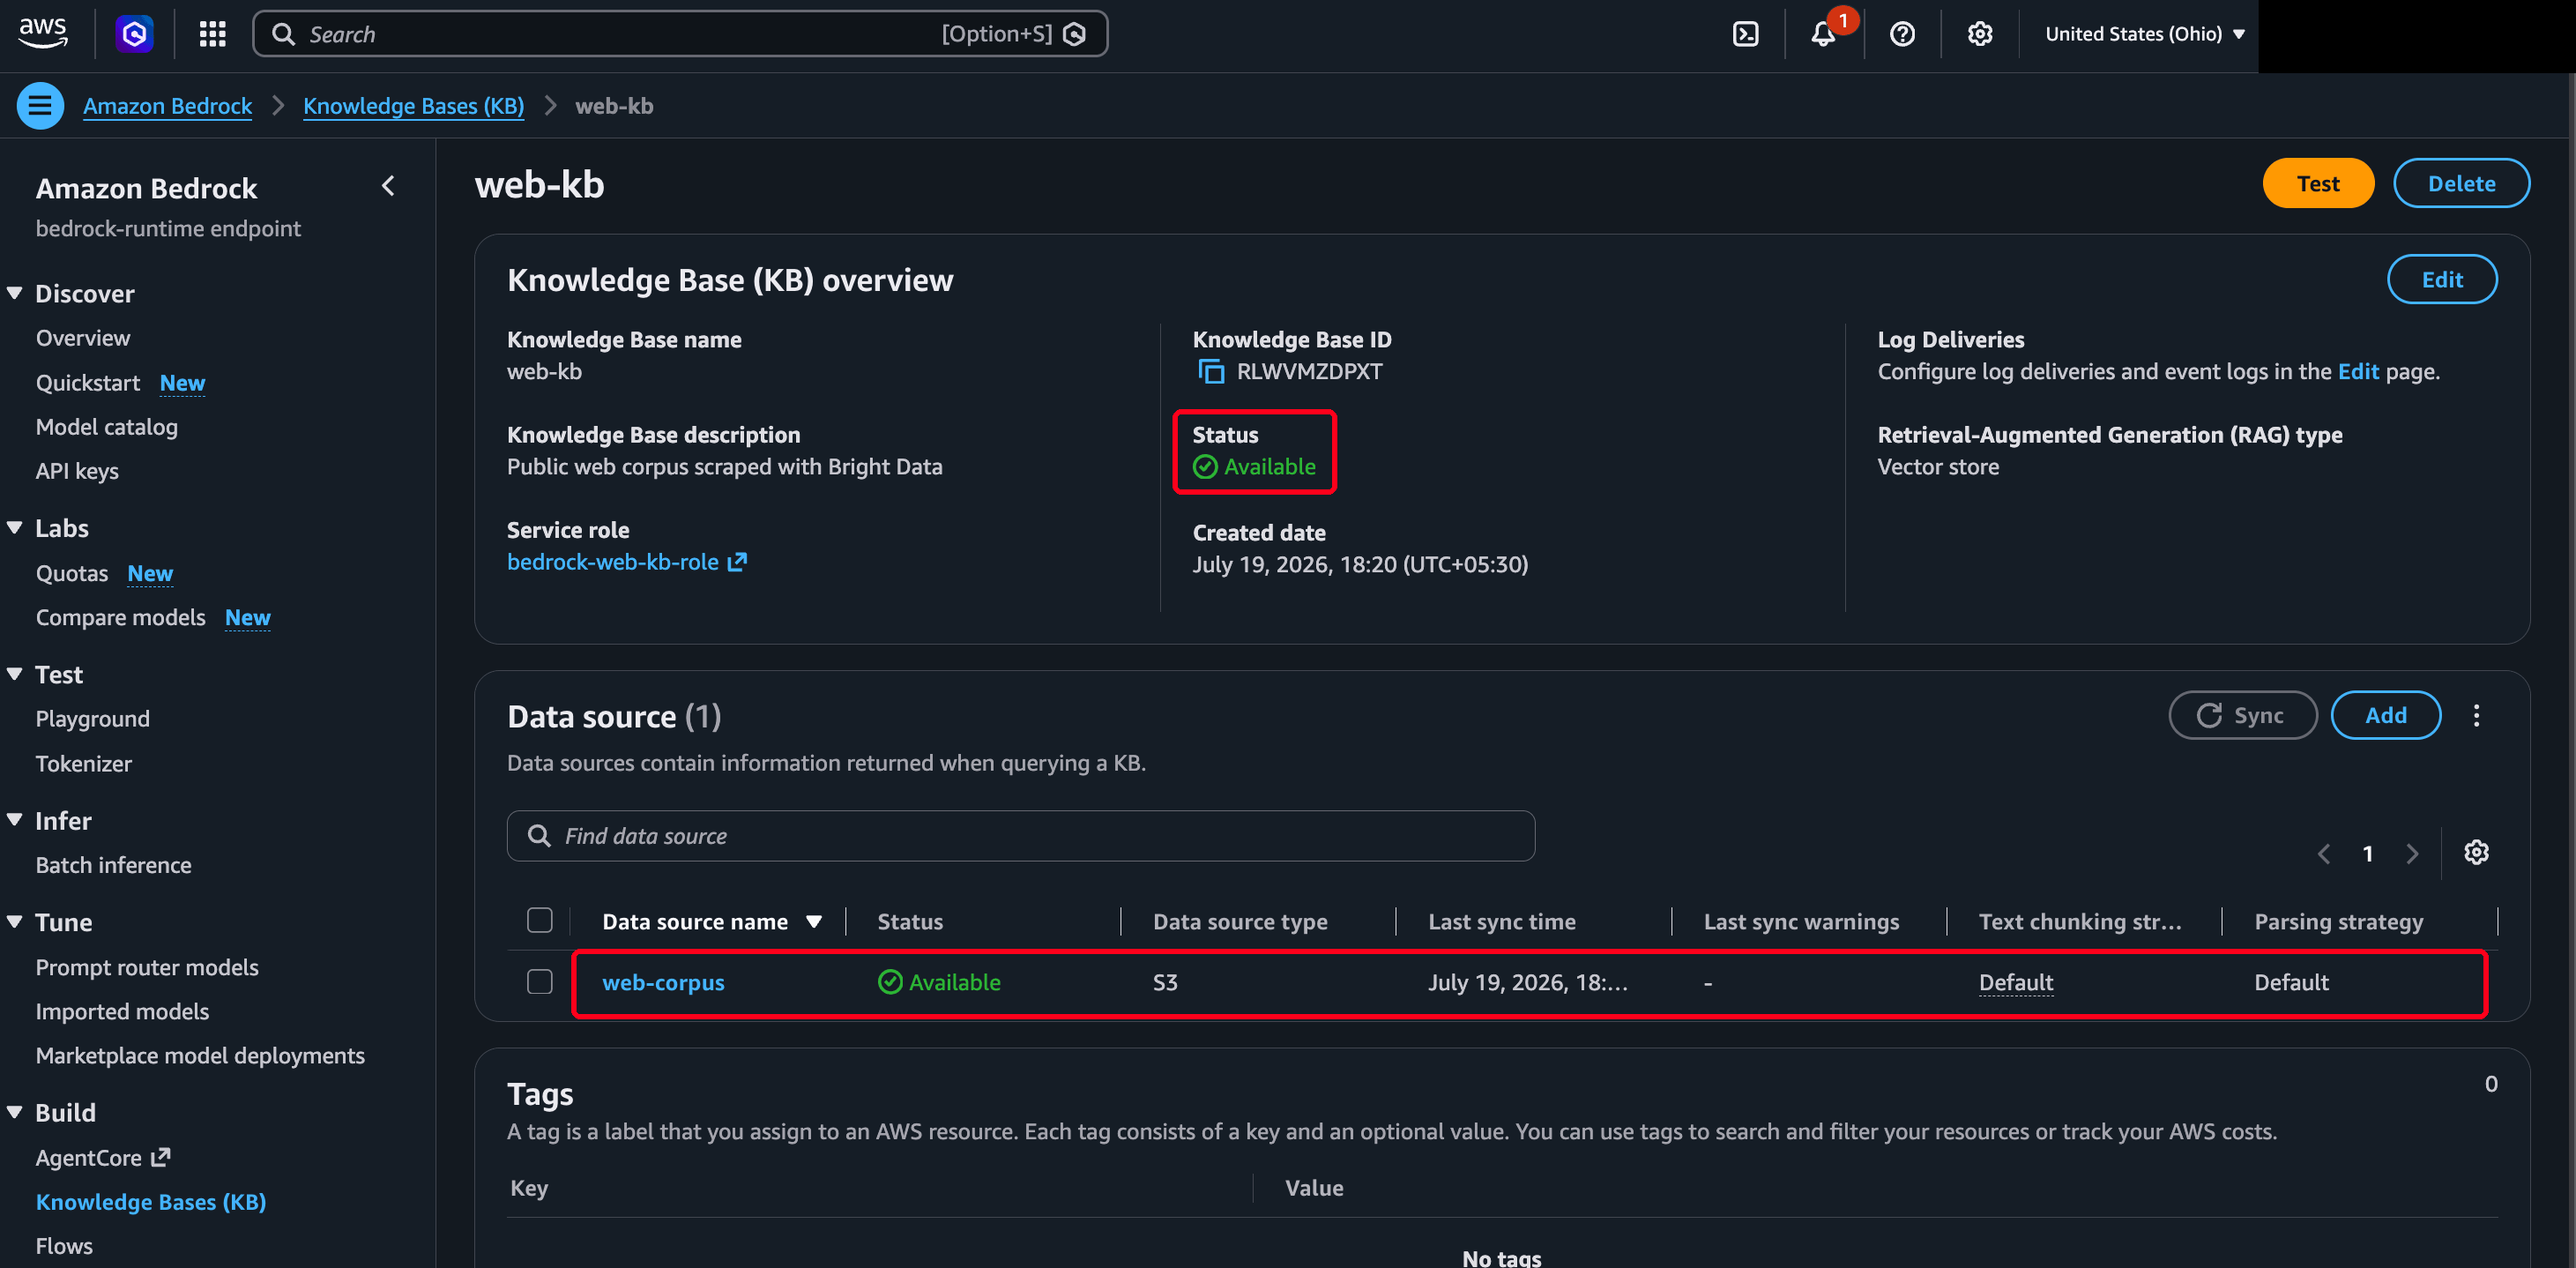
Cuando termina el flujo de creación, la página de detalles de la base de conocimiento muestra lo que construiste:
Paso 4 – Ingerir y mantener los datos actualizados
Crear la base de conocimiento no lee tus datos. La ingesta sí. Una sincronización, llamada trabajo de ingesta, lee el bucket, fragmenta e incrusta los documentos, y escribe los vectores. Inicias una después de la primera carga y de nuevo después de cada actualización:
bedrock_agent = boto3.client("bedrock-agent", region_name=REGION)

def sync(knowledge_base_id: str, data_source_id: str) -> str:
    job = bedrock_agent.start_ingestion_job(
        knowledgeBaseId=knowledge_base_id,
        dataSourceId=data_source_id,
    )
    return job["ingestionJob"]["ingestionJobId"]
Después de la primera sincronización completa, las sincronizaciones posteriores son incrementales. Bedrock ingiere archivos nuevos y modificados y elimina los vectores de cualquiera que haya salido del bucket, así que una actualización solo vuelve a incrustar las páginas que tu cargador reescribió. Ese comportamiento hace esencial la comprobación de hash del Paso 2, ya que un objeto que reescribes con bytes idénticos aún puede contar como modificado. La clave slugify es determinista, así que una nueva extracción de la misma URL sobrescribe el mismo objeto en lugar de crear un duplicado.
Eso gestiona las páginas nuevas y cambiadas, pero nada elimina las que retiras. El cargador solo escribe, así que quitar una URL de tu lista no borra su objeto. Ese contenido obsoleto permanece en el corpus, donde puede aparecer en cualquier respuesta posterior. Retirar una página es un paso de reconciliación separado que lista el bucket, encuentra objetos cuya URL ya no existe, y los elimina para que la siguiente sincronización limpie sus vectores. El repositorio complementario incluye esto como 7_reconcile.py, un script que por defecto es de simulación. Compara contra la lista completa de URLs, así que nunca confunde una página que simplemente falló al extraerse con una que eliminaste.
Ajusta el programa de resincronización al contenido que cambia más rápido en tu corpus. Las publicaciones sociales pueden quedar obsoletas en horas, las noticias en días, las páginas de precios y financieras en semanas, mientras que la documentación de referencia puede permanecer actual durante meses. Esos son puntos de partida, no mediciones. Una base de conocimiento de páginas de noticias podría resincronizarse diariamente, y una construida a partir de documentación de producto semanalmente. Una programación de Amazon EventBridge puede activar el scraping y la sincronización al intervalo que elijas, así que la actualización se ejecuta sin que un humano la inicie.
Lee las estadísticas, no el estado. Un trabajo de ingesta informa COMPLETE incluso cuando la mayoría de sus documentos fallaron. Una ejecución que indexó 1 página de 6 todavía parece un éxito solo por el campo de estado. El 3_sync.py del repositorio imprime esos conteos y sale con código distinto de cero en caso de fallos:
{"status": "COMPLETE",
 "statistics": {"numberOfDocumentsScanned": 6, "numberOfNewDocumentsIndexed": 6,
                "numberOfModifiedDocumentsIndexed": 0, "numberOfDocumentsDeleted": 0,
                "numberOfDocumentsFailed": 0}}
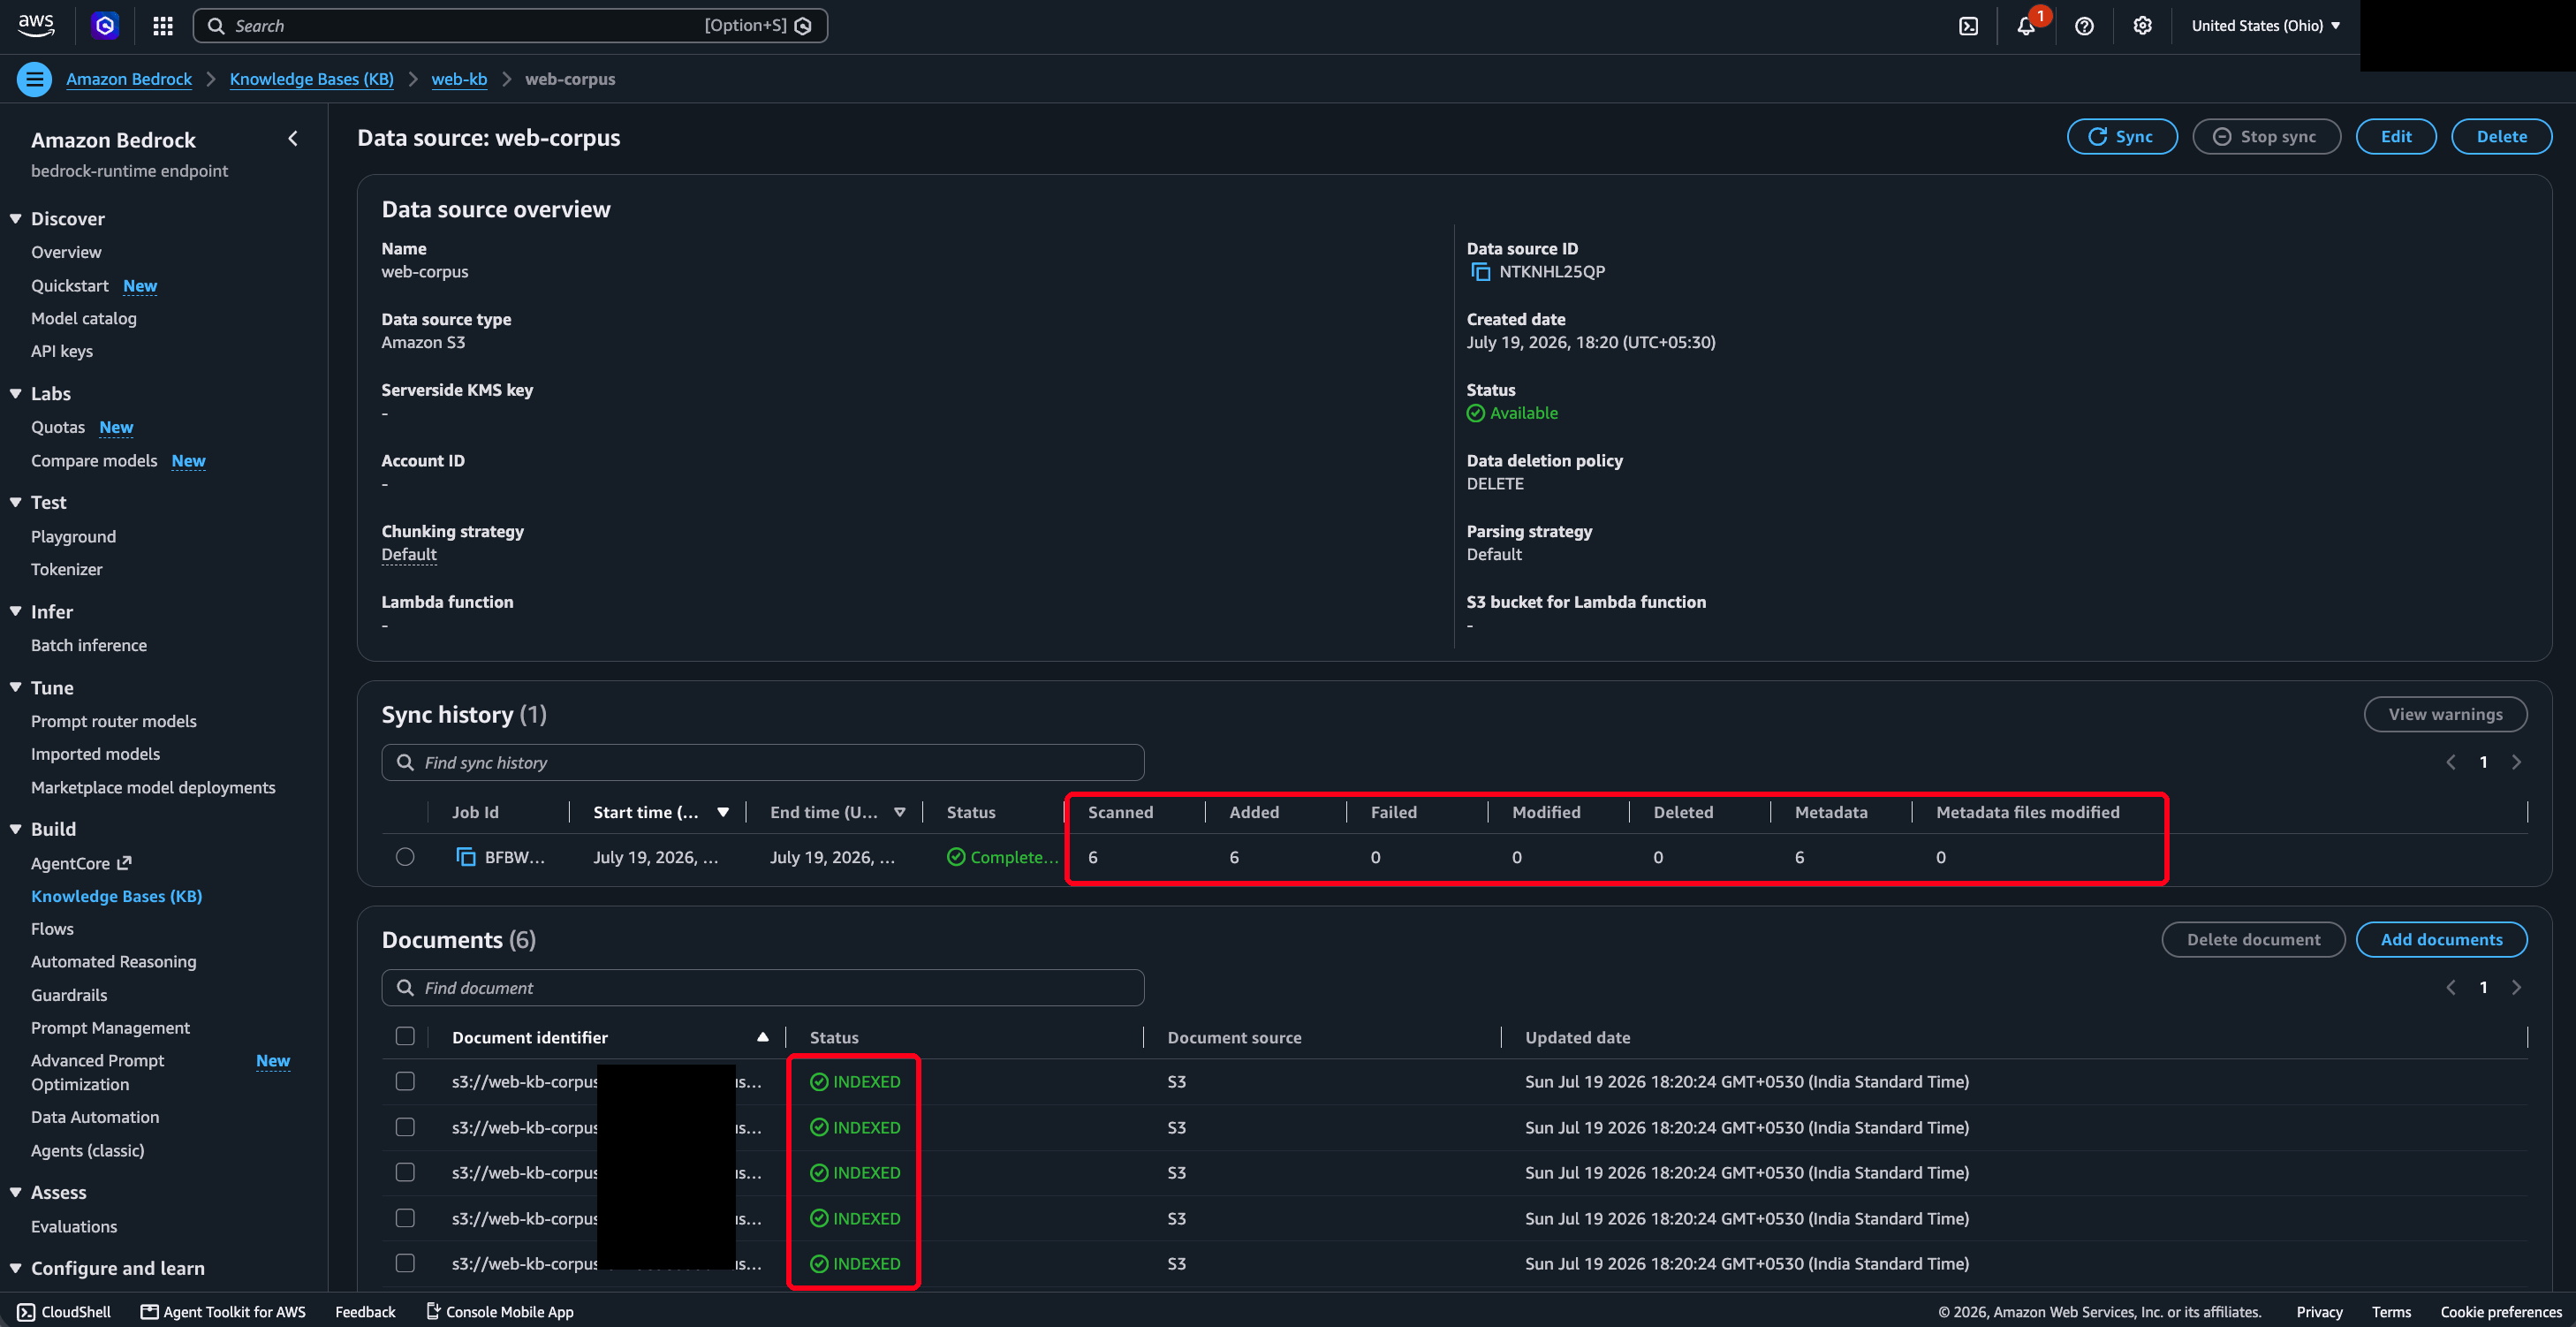
Ese es un resultado medido del corpus de 6 páginas, y tomó dos intentos llegar ahí. La primera ejecución informó COMPLETE con numberOfDocumentsFailed: 5, todos alcanzando el límite de metadatos de S3 Vectors descrito en el Paso 3. Cuando los documentos fallan, failureReasons en el trabajo lleva el error real y es lo primero que leer. Una cuota de incrustación en cero también aparece aquí, y parece un problema de permisos. La ingesta de 6 páginas tomó aproximadamente 25 segundos. El tiempo y los conteos de fragmentos escalan con tu corpus y cómo lo fragmentas, así que mídelos en tus propios datos.
La página de la fuente de datos enumera cada trabajo en su historial de sincronización con las estadísticas por documento:
Paso 5 – Consultar la base de conocimiento
Bedrock ofrece una llamada de recuperación y una llamada de generación. La que elijas depende de si quieres la evidencia en bruto o una respuesta escrita. Ambas están en el cliente bedrock-agent-runtime.
Retrieve devuelve los fragmentos de origen y nada más. Es la opción correcta cuando tu propio modelo o aplicación hace la redacción y solo necesitas contexto fundamentado y citas:
runtime = boto3.client("bedrock-agent-runtime", region_name=REGION)

def retrieve(kb_id: str, query: str, section: str | None = None,
             num_results: int = 5) -> list[dict]:
    config = {"vectorSearchConfiguration": {"numberOfResults": num_results}}
    if section:
        config["vectorSearchConfiguration"]["filter"] = {
            "equals": {"key": "section", "value": section}
        }
    resp = runtime.retrieve(
        knowledgeBaseId=kb_id,
        retrievalQuery={"text": query},
        retrievalConfiguration=config,
    )
    return resp["retrievalResults"]
Cada resultado lleva el texto del fragmento, una puntuación de relevancia score, la location del objeto de origen, y los metadata que escribiste en el Paso 2. En este corpus un resultado top correcto puntuó 0.67, un número que usas para fijar el piso de relevancia más adelante. Esos metadatos hacen funcionar el filter opcional, limitando la búsqueda a una section o a un rango de fechas:
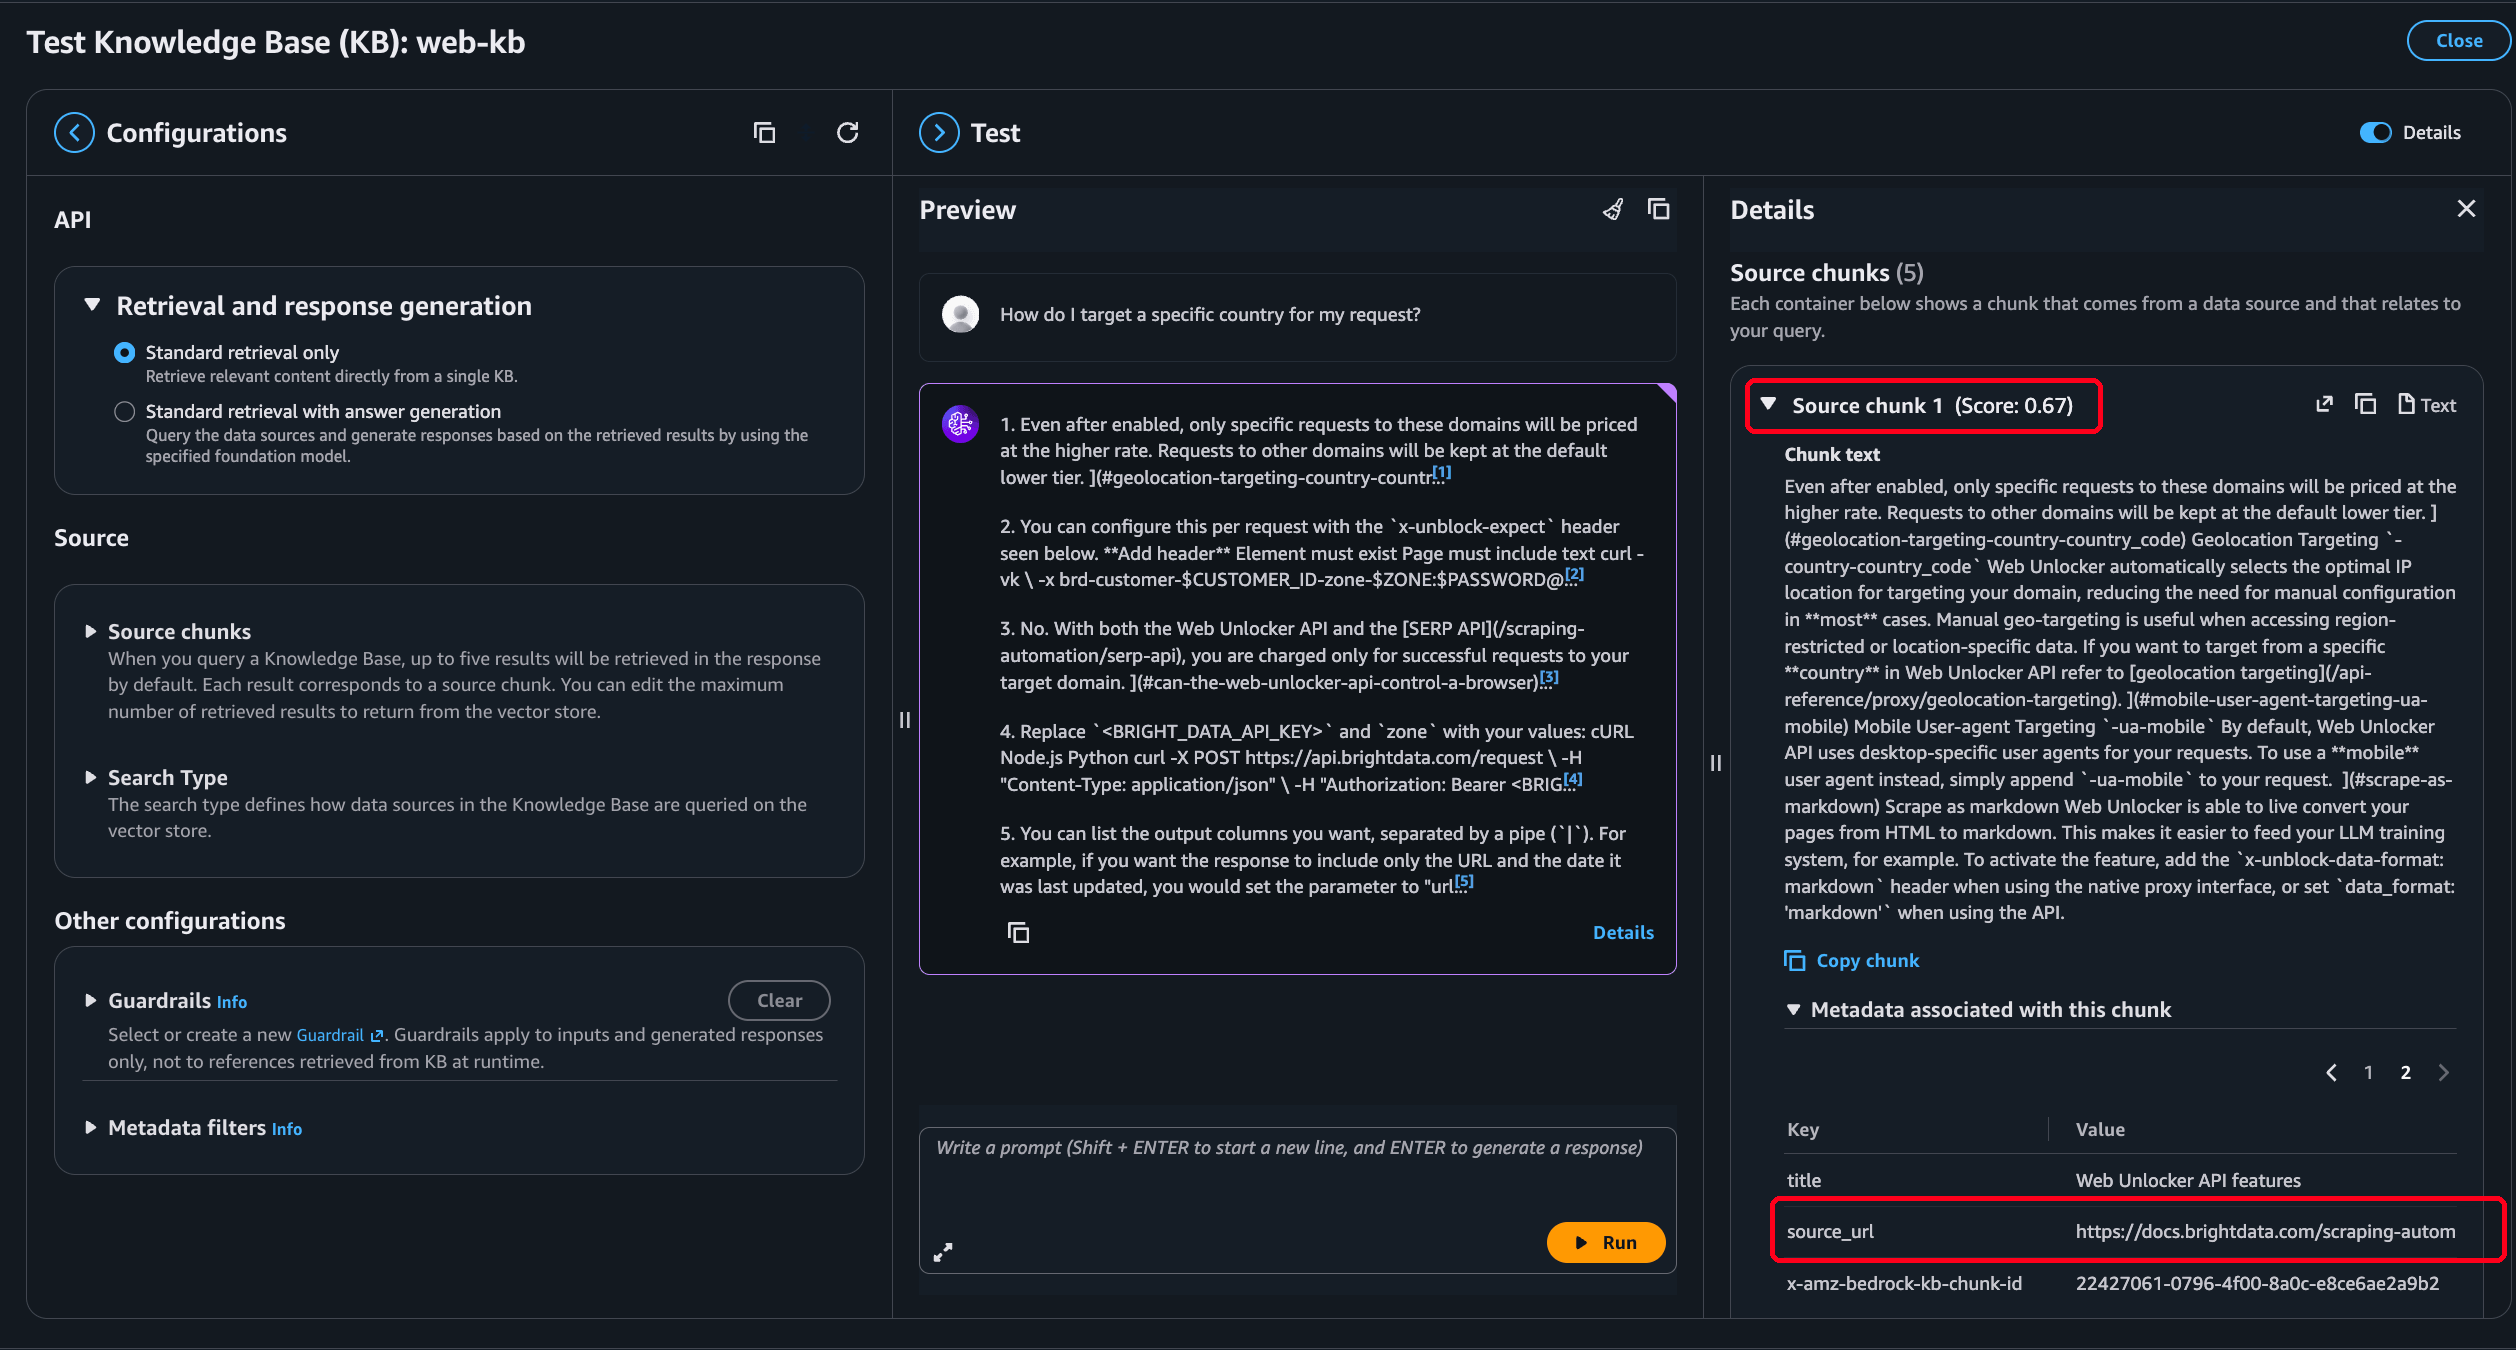
El crawler nativo ingiere HTML sin ningún paso de sidecar, así que esos atributos no tienen de dónde provenir.
RetrieveAndGenerate hace lo que hace Retrieve, luego escribe la respuesta. Fundamenta esa respuesta en los fragmentos recuperados y devuelve citas junto con ella:
def answer(kb_id: str, query: str, model_arn: str) -> dict:
    resp = runtime.retrieve_and_generate(
        input={"text": query},
        retrieveAndGenerateConfiguration={
            "type": "KNOWLEDGE_BASE",
            "knowledgeBaseConfiguration": {
                "knowledgeBaseId": kb_id,
                "modelArn": model_arn,
            },
        },
    )
    return resp   # resp["output"]["text"] más resp["citations"]
La respuesta contiene el texto generado y un arreglo citations que mapea tramos de la respuesta a los fragmentos de los que provinieron. Debido a que estableciste source_url en el sidecar, cada cita se resuelve a la página que extrajiste. Una respuesta sobre el precio de un producto entonces cita la página de precios que obtuvo Bright Data.
Si construyes una base de conocimiento totalmente gestionada, usa managedSearchConfiguration en lugar de vectorSearchConfiguration, ya que las bases de conocimiento gestionadas ejecutan búsqueda híbrida con reranking activado por defecto. El retrieve() del repositorio complementario marca dónde intercambiarlo.
Paso 6 – Medir si la recuperación funciona
Nada en el pipeline hasta ahora te dice si la base de conocimiento devuelve la página correcta para las preguntas que hacen tus usuarios. Corregir un tamaño de fragmento equivocado significa recrear la fuente de datos, así que descúbrelo con 20 páginas en lugar de 20,000.
La herramienta para eso es un conjunto de referencia, una lista de preguntas, cada una con las páginas que deberían responderla. El conjunto de este pipeline contiene 6 preguntas, y está en el repositorio como eval/golden.json, junto a eval/golden-v1-mislabeled.json, la primera versión cuya etiqueta incorrecta explica esta sección:
[
  {"question": "¿Cómo obtengo la página de vuelta como markdown en lugar de HTML?",
   "expect": ["https://docs.brightdata.com/scraping-automation/web-unlocker/features"]},
  {"question": "¿Cómo orientar mi solicitud a un país específico?",
   "expect": ["https://docs.brightdata.com/scraping-automation/web-unlocker/features",
              "https://docs.brightdata.com/scraping-automation/web-unlocker/configuration"]}
]
Luego ejecutas cada pregunta a través de Retrieve y registras dónde aparece la página esperada en los resultados:
def evaluate(kb_id: str, golden: list[dict], k: int = 5):
    ranks = []
    for item in golden:
        chunks = retrieve(kb_id, item["question"], num_results=k)
        got = [c.get("metadata", {}).get("source_url", "") for c in chunks]
        # rango basado en 1 de la primera página esperada, o None si nunca apareció
        ranks.append(next((i + 1 for i, u in enumerate(got) if u in item["expect"]), None))

    hit_rate = sum(r is not None for r in ranks) / len(ranks)
    mrr = sum(1 / r if r else 0 for r in ranks) / len(ranks)
    missed = [g["question"] for g, r in zip(golden, ranks) if r is None]
    return hit_rate, mrr, missed
La tasa de aciertos es la proporción de preguntas donde apareció la página esperada en absoluto. Te dice si el corpus puede fundamentar una respuesta en primer lugar. El rango recíproco medio promedia 1 dividido entre el rango de esa página. Cae cuando la página correcta aparece pero está en el rango 5, y una tasa de aciertos sola lo oculta.
La lista de fallos es la parte sobre la que actúas. Un fallo generalmente significa una de cuatro cosas. La página nunca llegó al corpus, así que revisa la salida del cargador por una obtención fallida. Los fragmentos son demasiado grandes, así que el texto circundante diluye el pasaje relevante. Los fragmentos son demasiado pequeños, así que el pasaje perdió el contexto que lo hacía coincidir. O tu conjunto de referencia está equivocado.
La primera ejecución de evaluación puntuó 83% de hit@5, con un fallo en “¿Cómo orientar mi solicitud a un país específico?” El conjunto de referencia esperaba la página de configuración. Leer la recuperación de fragmentos devuelta en su lugar resolvió la cuestión. El pasaje de la página de características contenía la documentación de orientación por país textualmente. La recuperación había sido correcta y la etiqueta había estado mal. Corregirla dio 100% de hit@5 con un MRR de 0.88, y 83% de hit@3 con un MRR de 0.83. Esas son 6 preguntas contra 6 páginas, así que léelas como un punto de dato medido y no como una referencia.
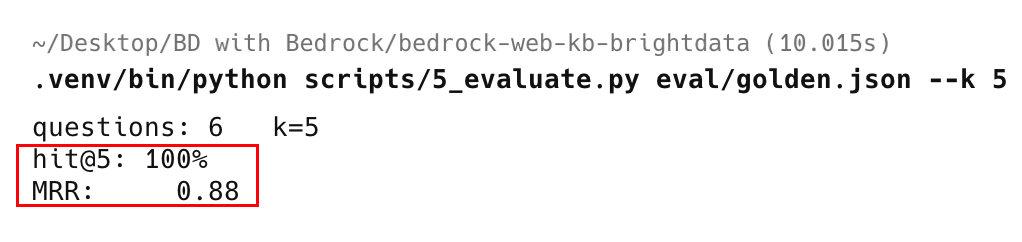
Lee siempre lo que devolvió la recuperación en un fallo antes de cambiar algo en el pipeline. Solo el texto recuperado te dice si la recuperación o la etiqueta están equivocadas. Un problema de pipeline te envía al cargador, un problema de fragmentación te envía de vuelta a la fuente de datos, y una pregunta mal etiquetada solo necesita un mejor conjunto de referencia.
Ejecuta esto antes de escalar el corpus, y sigue ejecutándolo. Una vez que tengas una tasa de aciertos con la que estés satisfecho, trátala como una puerta de lanzamiento. El script de evaluación del repositorio complementario toma una bandera --min-hit-rate precisamente para eso. Una actualización programada que degrada silenciosamente la recuperación entonces falla ruidosamente en lugar de entregar respuestas peores.
Bedrock también incluye evaluación gestionada que puntúa la recuperación y generación con un modelo juez. Úsalo para estudiar la calidad, y mantén el conjunto de referencia como la puerta de lanzamiento. El conjunto es determinista, cuesta solo las llamadas de recuperación, y se ejecuta en segundos a este tamaño.
Cuándo ir más allá de la base de conocimiento
Una base de conocimiento es una instantánea de páginas que elegiste. Las incrustas una vez y las consultas muchas veces. Esa instantánea hace que cada consulta sea barata, y también pone dos tipos de preguntas fuera de su alcance. Las preguntas sobre hechos que cambian más rápido que tu programa de sincronización obtienen respuestas obsoletas. Las preguntas sobre páginas que nunca estuvieron en el corpus no tienen nada contra qué comparar.
Enruta por consulta en lugar de elegir una vez entre una base de conocimiento persistente y recuperación en vivo. Pregunta primero a la base de conocimiento, y cuando no pueda fundamentar la pregunta, recurre a una búsqueda en vivo de Bright Data:
def route_answer(kb_id: str, query: str, min_score: float = 0.4):
    chunks = retrieve(kb_id, query, num_results=5)
    top = max((c.get("score", 0.0) for c in chunks), default=0.0)

    if chunks and top >= min_score:
        return "knowledge_base", chunks

    # nada en el corpus cubre esto, así que busca y obtenlo en vivo
    return "live_web", live_context(query)      # Bright Data SERP + Web Unlocker
live_context es el helper de búsqueda-y-obtención del repositorio en src/web_kb/live_tool.py, y necesita una zona SERP de Bright Data junto a la zona de Web Unlocker del Paso 1. Creas la zona SERP de la misma manera y la llamas a través del mismo endpoint api.brightdata.com/request. Devuelve la página de resultados como JSON, así que el respaldo puede elegir qué URLs obtener.
El piso de relevancia es la señal de enrutamiento. Bedrock devuelve una puntuación con cada fragmento, y cuando el mejor cae por debajo del piso, el corpus probablemente no cubre la pregunta. Responder desde el corpus de todos modos es el modo de fallo a evitar, porque el resultado es una respuesta segura que cita una página que no la respalda.
El 0.4 anterior es un punto de partida, no un valor medido. Está por debajo del 0.67 que puntuó un resultado top correcto en el Paso 5. Ajústalo contra el conjunto de referencia del Paso 6, junto con algunas preguntas que sabes que el corpus no cubre. 5_evaluate.py imprime la banda que vio, la puntuación más baja en un acierto y la más alta en un fallo. El piso pertenece entre ambos. Mantén esas preguntas adicionales en un archivo separado, ya que una pregunta sin página esperada cuenta como fallo contra la puerta de lanzamiento.
Las bases de conocimiento gestionadas toman internamente una versión de esta decisión, llamada recuperación agéntica. Mantener esa decisión en tu propio código significa que puedes inspeccionar la señal, el piso, y el respaldo, y la ruta en vivo puede llegar fuera de AWS. Conéctalo como un grupo de acciones de agente de Bedrock, como una herramienta en un framework como Strands Agents, o como el servidor MCP de Bright Data.
Ese servidor le da a cualquier agente compatible con MCP la misma búsqueda, desbloqueo, y rastreo en vivo. En una Puerta de Enlace AgentCore, se sitúa junto a una herramienta que llama a Retrieve. La regla de enrutamiento no cambia, solo dónde se ejecuta el respaldo.
Una base de conocimiento es la opción correcta cuando consultas las mismas páginas repetidamente, cuando necesitas citas, filtros, y control de acceso, y cuando el corpus cambia más lentamente de lo que lo consultas. La recuperación en vivo gana cuando un hecho se mueve más rápido que tu sincronización, cuando el espacio de preguntas es abierto, o cuando incrustarías muchísimo más de lo que alguna vez recuperarás. La señal más clara de que el equilibrio está mal es sincronizar tan a menudo que vuelves a incrustar la mayoría de las páginas antes de que alguien las consulte. Entonces estás pagando por mantener un índice en lugar de usarlo.
El almacenamiento en caché de prompts cambió una parte de esa regla. Con un corpus lo suficientemente pequeño y estable para caber en la ventana de contexto de un modelo, puedes omitir la recuperación por completo. Este pipeline vale la pena construirlo una vez que el corpus supera la caché, o cuando las respuestas deben citar páginas exactas, los filtros deben limitar las consultas, o las páginas se actualizan en programas distintos. Sin ninguna de esas condiciones, almacenar en caché todo el corpus es más simple.
Cobertura de sitio completo con la Crawl API y entrega nativa a S3
El pipeline hasta ahora toma una lista conocida de URLs. Cuando el corpus crece, es posible que no conozcas cada URL de antemano, y preferirías no ejecutar tú mismo el bucle de obtención. La Crawl API de Bright Data gestiona ambos casos. Descubre y rastrea las páginas internas de un sitio a partir de una URL semilla, devolviendo cada página como Markdown. También puede entregar la salida directamente a tu bucket de S3.
Esta ruta se ensambló a partir de la documentación en lugar de ejecutarse. La secuencia de llamadas y los nombres de campos a continuación siguen la referencia de API de Bright Data, así que verifícalos contra la documentación de la Crawl API antes de depender de esta ruta.
Este fragmento continúa desde los pasos anteriores: reutiliza BRIGHTDATA_TOKEN del Paso 1 y REGION del Paso 2. Los trabajos de rastreo son asíncronos, y la entrega es una llamada propia en lugar de una opción en el disparador. Disparas un rastreo y recibes un ID de instantánea, sondeas hasta que esa instantánea esté ready, luego la entregas al endpoint de entrega con un objetivo s3. La llamada de entrega escribe la salida en tu bucket sin paso de descarga en tu código:
import requests, time

BD = "https://api.brightdata.com"
HEADERS = {"Authorization": f"Bearer {BRIGHTDATA_TOKEN}"}
CRAWL_DATASET_ID = "..."   # el ID de dataset de Crawl API de tu panel de control de Bright Data
AWS_KEY, AWS_SECRET = "...", "..."   # credenciales de entrega. Prefiere un ARN de rol IAM con un ID externo

def _call(method: str, path: str, **kw):
    resp = requests.request(method, f"{BD}{path}", headers=HEADERS, timeout=60, **kw)
    resp.raise_for_status()
    return resp.json()

def crawl_to_s3(seed_url: str, bucket: str, directory: str) -> str:
    # 1. Disparar. El cuerpo es un arreglo simple de objetos de entrada, no un objeto envoltorio.
    snapshot = _call("POST", "/datasets/v3/trigger",
                     params={"dataset_id": CRAWL_DATASET_ID,
                             "custom_output_fields": "markdown|url|page_title"},
                     json=[{"url": seed_url}])["snapshot_id"]

    # 2. Sondear. La entrega solo acepta una instantánea ya en estado `ready`.
    while (state := _call("GET", f"/datasets/v3/progress/{snapshot}")["status"]) != "ready":
        if state == "failed":
            raise RuntimeError(f"crawl {snapshot} failed")
        time.sleep(15)

    # 3. Entregar. Devuelve un ID de trabajo de entrega, que sondeas en
    #    GET /datasets/v3/delivery/{id} hasta que su estado sea "done".
    return _call("POST", f"/datasets/v3/deliver/{snapshot}",
                 json={"type": "s3",
                       "bucket": bucket,
                       "directory": directory,
                       "region": REGION,
                       "credentials": {"aws-access-key": AWS_KEY,
                                       "aws-secret-key": AWS_SECRET},
                       "filename": {"template": "crawl", "extension": "json"}})["id"]
Bright Data entrega registros como JSON, NDJSON, o CSV en lugar de un archivo Markdown por página, así que hay un paso de normalización entre la entrega y la ingesta. Una función Lambda activada por S3 lo gestiona, disparándose cuando la entrega escribe la salida en un prefijo de aterrizaje. La función divide cada registro en un documento <slug>.md y su sidecar .metadata.json bajo el prefijo de origen de la base de conocimiento. Esa es exactamente la forma que escribiste a mano en el Paso 2. La fuente de datos de S3 de Bedrock entonces ingiere esos en la siguiente sincronización.
El ejemplo anterior pasa un par de claves. Prefiere un ARN de rol IAM con un ID externo, para que no haya una clave de larga duración en la solicitud.
El intercambio entre las dos rutas es control contra escala. Web Unlocker con tu propio cargador te da control exacto sobre cada nombre de archivo y campo de metadatos. Eso es ideal para una lista curada. La Crawl API con entrega a S3 y una Lambda de normalización te da amplia cobertura y sin bucle de obtención propio. Eso es ideal cuando el corpus es una sección completa de sitio que quieres mantener sincronizada.
Consideraciones de costo
Trata las cifras a continuación como una plantilla para tus propios números y no como una cotización, y calcula el precio de tu propio corpus contra los precios de Bright Data y los precios de Amazon S3 antes de comprometerte.
| Componente | Cómo se cobra | Qué lo determina |
|---|---|---|
| Bright Data Web Unlocker | $1.50 por 1,000 solicitudes exitosas con pago por uso, con una tarifa premium de $2.50. Los fallos no se facturan | 1 solicitud por página extraída |
| Bright Data Crawl API | $1.50 por 1,000 registros con pago por uso | Páginas descubiertas y rastreadas por trabajo |
| Incrustaciones de Bedrock (Titan V2) | Por token de entrada | Tokens totales en todos los fragmentos en la ingesta, más cada consulta |
| Almacén de vectores | S3 Vectors pago por uso, u OpenSearch Serverless por hora-OCU | Tamaño del corpus y volumen de consultas |
| Amazon S3 | Almacenamiento y solicitudes, unos pocos centavos a esta escala | 1 .md más 1 sidecar por página |
| RetrieveAndGenerate | Por token en el modelo de generación | Volumen de respuestas y elección de modelo |
Esto es lo que cuesta una actualización del corpus de 6 páginas, en la ruta de Web Unlocker a la tarifa estándar.
- Extracción. 6 solicitudes de Web Unlocker, $0.009 a $1.50 por 1,000.
- Incrustación. 60,846 caracteres limpiados, aproximadamente 15,000 tokens a 4 caracteres cada uno, cerca de tres centésimas de centavo a $0.00002 por 1,000.
- Almacenamiento de vectores. Alrededor de 50 fragmentos de tamaño predeterminado, muy por debajo de un megabyte, demasiado pequeño para importar a $0.06 por GB-mes.
Una actualización semanal de este piloto cuesta aproximadamente 4 centavos al mes, casi todo en solicitudes de Web Unlocker. La comprobación de hash mantiene la incrustación en cero cuando nada cambió. Si escalas linealmente, 500 páginas que actualizas semanalmente cuestan alrededor de $3.25 al mes en extracción y menos de un centavo en almacenamiento.
Los tokens de generación por consulta y el almacén de vectores que elegiste son los dos costos que pueden crecer más allá de esas cifras. Una colección clásica de Amazon OpenSearch Serverless tiene un costo base incluso en reposo. Eso es aproximadamente $175 al mes en el mínimo reducido de desarrollo-prueba, y aproximadamente el doble en el piso estándar de 2-OCU. AWS también ofrece un tipo de colección que escala a cero, con precio en la página de precios de OpenSearch Service. Contra las colecciones clásicas, S3 Vectors cambia la aritmética para actualizaciones programadas con volumen de consultas moderado.
Limitaciones y fortalecimiento para producción
Este pipeline es una arquitectura de referencia, no un producto listo para producción.
- La actualidad es un programa que tú posees. Una base de conocimiento es una instantánea de su última sincronización, y entre sincronizaciones se vuelve obsoleta al ritmo que decae su dato fuente. Activa una alerta cuando falla una sincronización, porque una ejecución omitida deja datos obsoletos en su lugar.
- Un scraping fallido se oculta detrás de buenos datos. Cuando no puedes obtener una página, su versión anterior sigue sirviendo como actual. El cargador en el repositorio nombra las URLs fallidas y sale con código distinto de cero para que una ejecución programada las informe. Detectar una página que dejó de actualizarse silenciosamente es una pregunta separada.
scraped_dateno puede responderla, ya que una página puede obtenerse limpiamente durante meses sin cambiar. El repositorio marca una fecha de última vista en cada obtención exitosa e informa las URLs que no ha visto desde una fecha límite. - No puedes cambiar la fragmentación o incrustación después. Prueba ambas en una muestra de tus páginas antes de la primera sincronización completa. Corregir el modelo significa recrear la base de conocimiento, y corregir la fragmentación significa recrear la fuente de datos.
- El contenido recuperado solo es tan bueno como la página. Bright Data devuelve lo que sirvió la página y lo convierte a Markdown. No verifica que la página sea correcta. Para cualquier cosa sobre la que vayas a actuar, mantén a un humano en el ciclo, y usa la cita
source_urlpara hacer que la verificación sea un clic y no una suposición. - El token en los fragmentos es un marcador de posición. Cualquier cosa programada debería leerlo de AWS Secrets Manager. Nunca debería llegar a un repositorio.
- Las cifras están medidas, pero no de tu corpus. Reprodúcelas en tus propias cuentas y datos antes de confiar en algún número específico.
Reflexiones finales
Amazon Bedrock Knowledge Bases gestiona la fragmentación, incrustación, y recuperación citada, y sus conectores nativos cubren los datos que ya posees y las páginas estáticas que te pertenecen. La web pública que cambia, se renderiza del lado del cliente, y se defiende a sí misma queda fuera de ese alcance, y a menudo contiene los datos que hacen que valga la pena construir una base de conocimiento. Bright Data cierra ese vacío, y los dos se encuentran en S3.
Para extender el pipeline, agrega programación de EventBridge para actualización automática, usa la Crawl API de Bright Data para cobertura de sitio completo, o habilita el reranking de Bedrock una vez que fijes la fragmentación.
El Web Unlocker de Bright Data incluye un nivel gratuito para comenzar, la Crawl API cubre rastreos de sitio completo, y configuras Amazon Bedrock Knowledge Bases desde la consola de Amazon Bedrock. El proyecto completo y ejecutable, con el cargador, el script de configuración de la base de conocimiento, y las políticas de IAM, está en el repositorio complementario.
Preguntas frecuentes
¿Puede Amazon Bedrock Knowledge Bases rastrear la web por sí solo?
Tiene un Web Crawler nativo en vista previa, una buena opción para páginas estáticas que te pertenecen. Hoy gestiona solo sitios estáticos, no permite un sitio sin robots.txt, tiene un límite de 25,000 páginas por sincronización, y necesita OpenSearch Serverless. Para páginas con JavaScript o protegidas por bots, usa Bright Data para renderizar y desbloquear el contenido, luego ingiere desde S3.
¿Por qué almacenar los datos en S3 en lugar de recuperarlos de la web en el momento de la consulta?
Una base de conocimiento persistente incrusta cada página una vez y sirve muchas consultas desde una búsqueda vectorial de baja latencia, con citas, filtrado de metadatos, y control de acceso. La recuperación en vivo a través de Bright Data se ajusta a búsquedas que cambian rápido o únicas. Muchos sistemas de producción usan ambos, y enrutan por consulta según la puntuación.
¿En qué formato deben estar las páginas extraídas para Bedrock?
Markdown. El Web Unlocker de Bright Data devuelve la página como Markdown cuando estableces data_format en markdown, y Bedrock la ingiere como un tipo de documento compatible. La conversión elimina el marcado HTML pero no la navegación del sitio, así que elimina el chrome repetido antes de escribir en S3.
¿Cómo funcionan las citas en las respuestas?
Escribes un atributo source_url en el sidecar .metadata.json de cada documento. Bedrock lleva esos metadatos a la recuperación, así que Retrieve lo devuelve en cada fragmento y RetrieveAndGenerate incluye un arreglo de citas que resuelve cada tramo de la respuesta de vuelta a la página de la que provino.
¿Por qué mi trabajo de ingesta dice COMPLETE cuando no se indexó nada?
Porque status no es una señal de éxito. Un trabajo puede informar COMPLETE cuando la mayoría de sus documentos fallaron, y en este pipeline informó COMPLETE con 5 de 6 fallidos. Lee statistics para los conteos por documento y failureReasons para el error, que aquí era el límite de metadatos filtrables de S3 Vectors.
¿Cómo mantengo actualizada la base de conocimiento?
Vuelve a extraer según un programa, escribe solo los objetos cuyo hash de contenido cambió, e inicia un trabajo de ingesta. Esa comprobación de hash evita que Bedrock vuelva a incrustar una página sin cambios. Ajusta el programa a cuán rápido decaen tus fuentes, desde diario para noticias hasta semanal o más lento para documentación.
¿Cuántas preguntas necesita un conjunto de referencia?
Menos de lo que la gente espera, y las preguntas tienen que ser reales. Las preguntas que tomas de lo que realmente preguntan los usuarios superan a las inventadas, porque el objetivo es encontrar lo que tu corpus no puede fundamentar y no producir un número. Agrega una cada vez que alguien reporte una mala respuesta, y el conjunto se convierte en un conjunto de regresión.
¿Cuánto cuesta ejecutar esto?
Los costos principales son las solicitudes de Bright Data, que escalan con páginas multiplicadas por frecuencia de actualización, más el almacén de vectores, y la incrustación y generación por token. S3 Vectors es de pago por uso y se ajusta a una actualización programada, mientras que una colección clásica de OpenSearch Serverless cuesta incluso en reposo. El piloto de 6 páginas aquí costó aproximadamente 4 centavos al mes para actualizarse semanalmente.