DSPy es un framework de Python que mejora los programas de modelos de lenguaje con datos. DSPy carga herramientas de agente desde servidores Model Context Protocol (MCP). Con el servidor MCP de Bright Data, un agente busca en Google y lee páginas como Markdown, mientras el servidor gestiona la protección antibots.
El patrón del tutorial MCP de DSPy funciona bien para una sola ejecución de agente. El evaluador de DSPy y GEPA, su optimizador de prompts, ejecutan agentes en hilos de trabajo, donde las llamadas a herramientas asíncronas fallaron silenciosamente en las pruebas y el agente respondió desde memoria.
Esta guía te muestra cómo construir ese agente, ejecutar sus herramientas en paralelo y medir lo que aportan los datos web.
Resumen
- Los datos web elevaron la precisión. Con el servidor MCP de Bright Data,
gpt-5.4-minirespondió correctamente 54-58 de 60 preguntas, frente a 14, y las 8 sobre eventos posteriores a su corte de conocimiento, frente a 0. - Elige 2 herramientas y añade un callback de elicitación. Menos herramientas mantienen los prompts pequeños. El callback aprueba páginas marcadas como posible inyección de prompts.
- Dale herramientas síncronas a las ejecuciones con hilos. Las herramientas asíncronas fallaron silenciosamente o se colgaron en
dspy.Evaluatey GEPA. Un bucle de eventos en segundo plano resolvió ambos casos. - Arregla las herramientas primero. GEPA copió respuestas de entrenamiento en sus instrucciones sin elevar la puntuación. En 6 preguntas de páginas largas, un argumento
findredujo a la mitad los tokens del prompt.
Lo que necesitas
El agente se conecta por HTTP al Web MCP de Bright Data, el servidor MCP alojado de Bright Data, por lo que Python es el único runtime a instalar. El servidor se ejecuta sobre la API Web Unlocker, que gestiona la rotación de proxies y la protección antibots para el agente. Para el código, el repositorio de GitHub complementario tiene todos los scripts y archivos de datos, incluyendo evaluate.py y post_cutoff_questions.csv para los pasos de evaluación. Necesitas:
- Python 3.10 o posterior, y uv para instalar paquetes
- Una cuenta gratuita de Bright Data y su clave de API desde Configuración de la cuenta
- Una clave de API de OpenAI, o una clave de otro proveedor compatible con llamadas a herramientas en
dspy.LM
Copia la clave de Bright Data desde la tabla Claves de API en la pestaña Usuarios y claves de API:
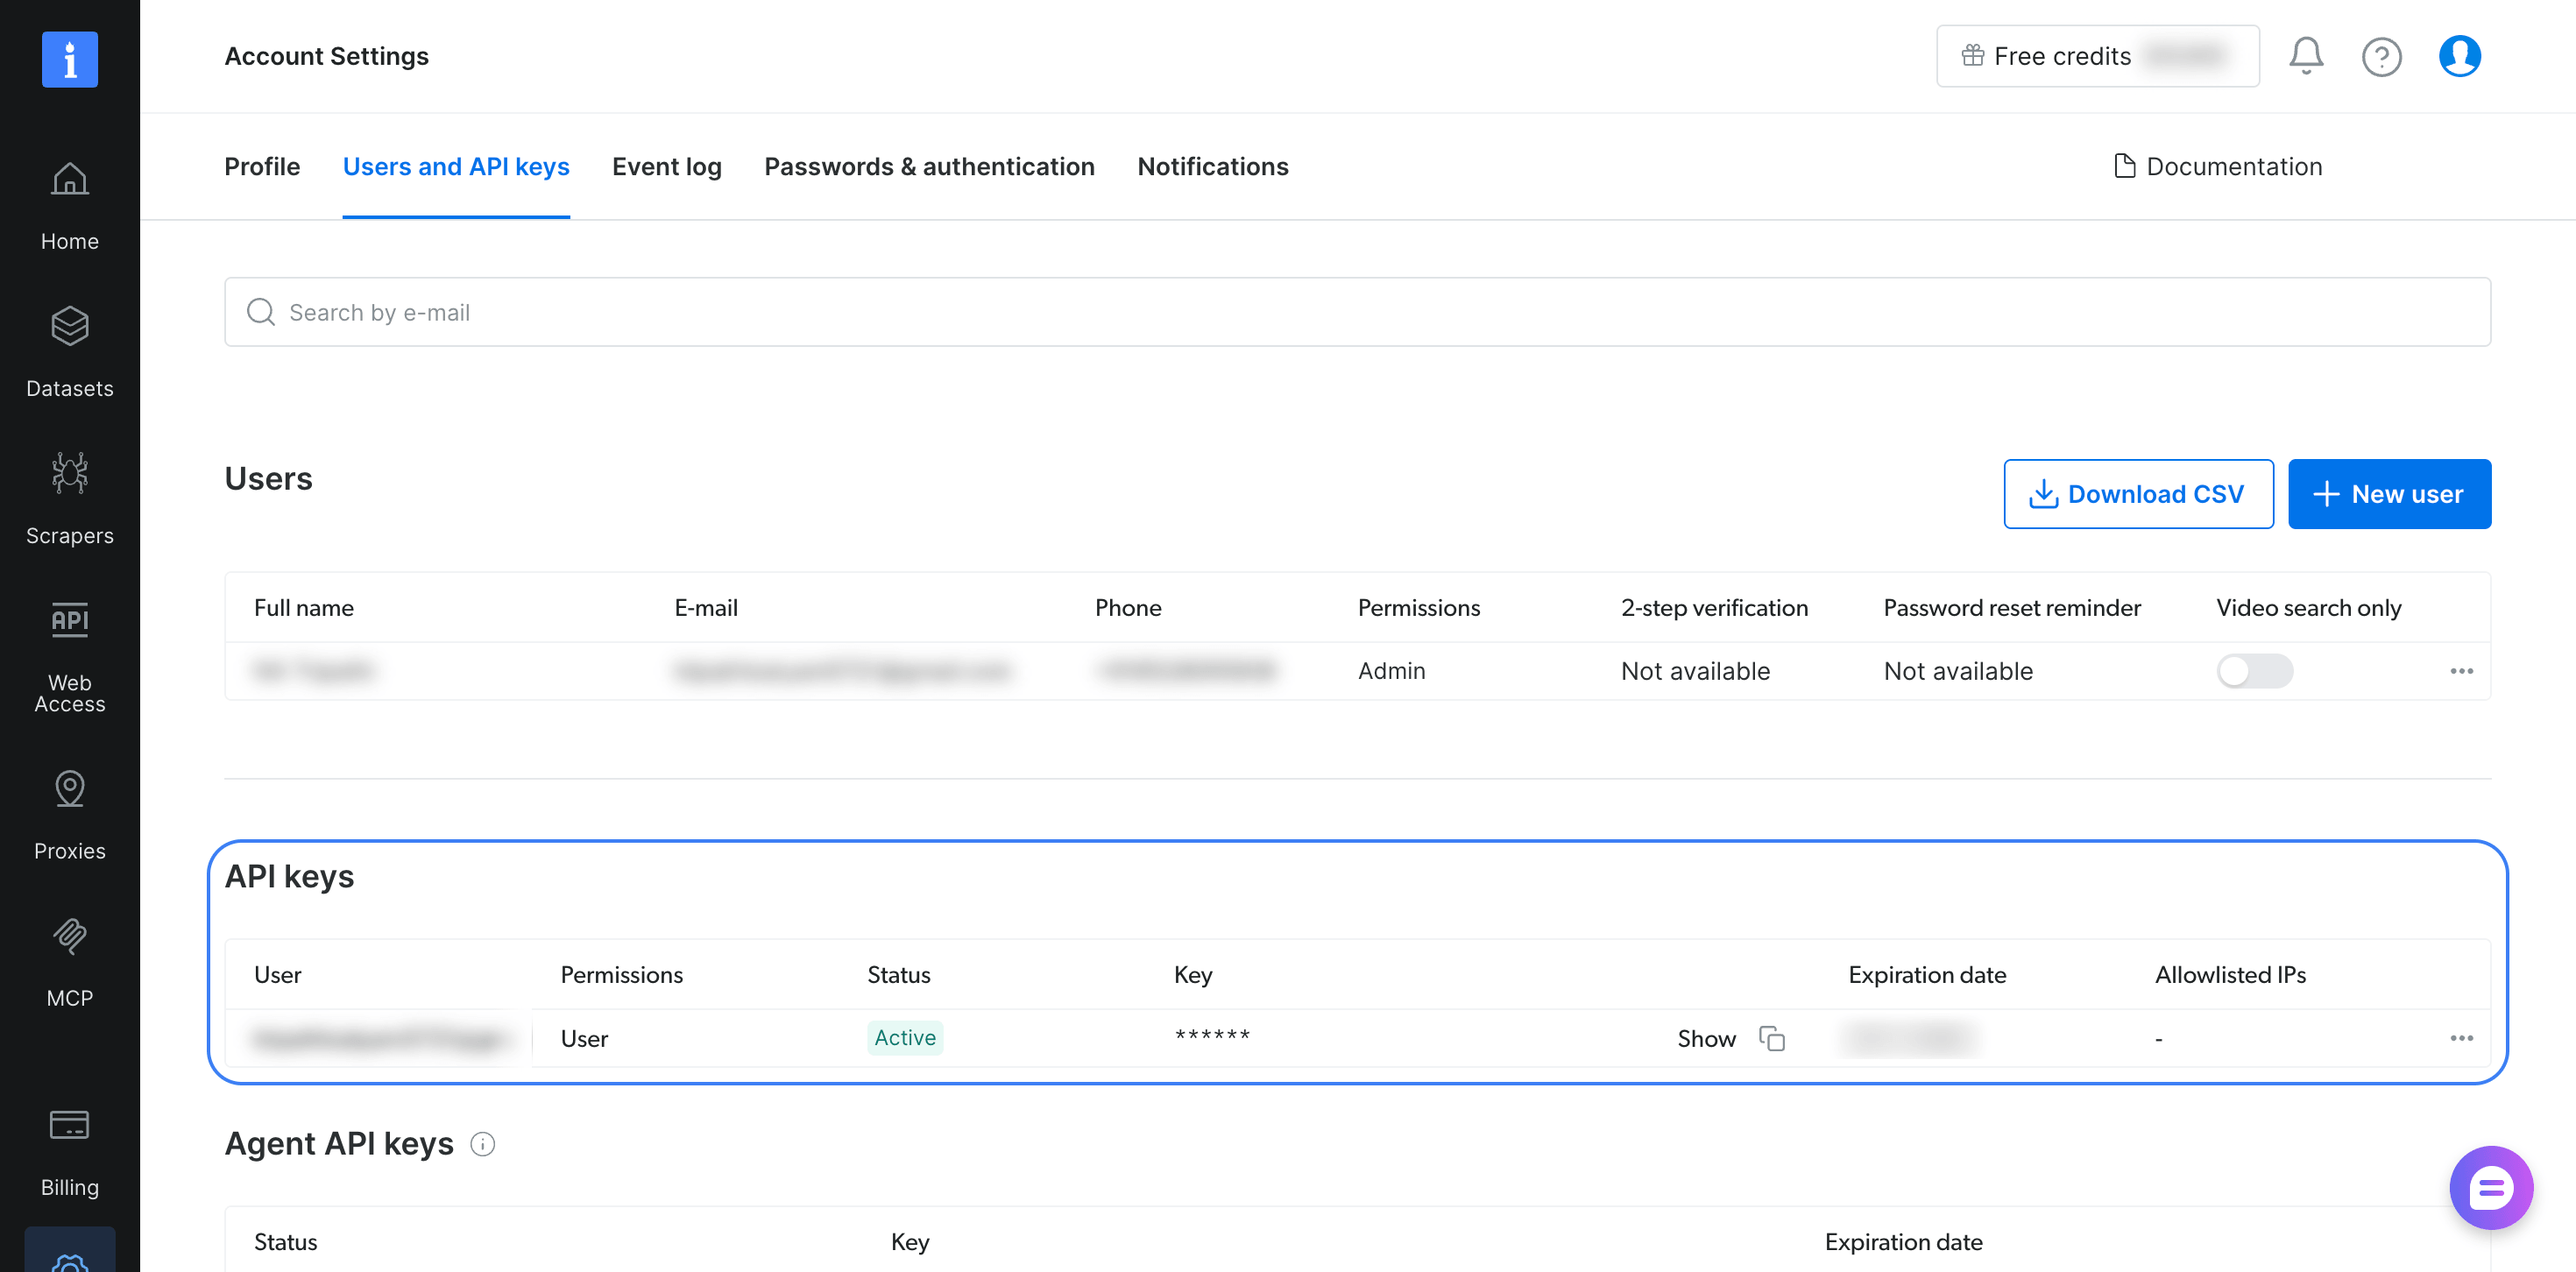
La misma clave funciona con el servidor alojado y el servidor local.
Clona el repositorio, instala DSPy con su extra MCP, fijado a las versiones probadas, y exporta ambas claves:
git clone https://github.com/triposat/dspy-bright-data-research-agent && cd dspy-bright-data-research-agent
uv venv && source .venv/bin/activate
uv pip install "dspy[mcp]==3.4.1" "mcp==2.3.0"
export BRIGHTDATA_API_TOKEN="your-bright-data-api-key"
export OPENAI_API_KEY="your-openai-api-key"
El comando fija el SDK de Python de MCP a la versión probada 2.3.0, porque el extra dspy[mcp] en DSPy 3.4.1 no fija la versión del SDK. Puedes comenzar con solicitudes mensuales gratuitas, y la página de precios del servidor MCP detalla el límite actual.
Conecta el servidor MCP de Bright Data a DSPy
dspy.Tool.from_mcp_tool convierte cada herramienta que lista un servidor MCP en una herramienta DSPy, de modo que el agente ve el nombre, la descripción y el esquema de argumentos de cada herramienta. El siguiente script, agent.py en el repositorio, se conecta al servidor MCP alojado de Bright Data y carga sus herramientas de búsqueda y extracción. Luego pregunta sobre un evento posterior al corte de conocimiento del modelo:
import asyncio
import os

import dspy
from mcp import types
from mcp.client import Client
from mcp.client.streamable_http import create_mcp_http_client, streamable_http_client

dspy.configure(
    lm=dspy.LM("openai/gpt-5.4-mini", temperature=1.0, max_tokens=16000),
    adapter=dspy.ChatAdapter(use_native_function_calling=True),
)

SERVER_URL = "https://mcp.brightdata.com/mcp?tools=search_engine,scrape_as_markdown"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_TOKEN']}"}


async def approve_page(context, params):
    # El servidor pregunta antes de devolver una página que contenga
    # instrucciones de configuración MCP. Las herramientas de este agente
    # solo leen la web, así que se devuelve.
    return types.ElicitResult(action="accept", content={"return_content": True})


class ResearchQuestion(dspy.Signature):
    """Responde la pregunta con datos encontrados en la web."""

    question: str = dspy.InputField()
    answer: str = dspy.OutputField(desc="una respuesta corta y directa")
    sources: list[str] = dspy.OutputField(desc="URLs de las páginas que respaldan la respuesta")


async def main():
    async with create_mcp_http_client(headers=HEADERS) as http:
        transport = streamable_http_client(SERVER_URL, http_client=http)
        async with Client(transport, elicitation_callback=approve_page) as client:
            mcp_tools = (await client.list_tools()).tools
            tools = [dspy.Tool.from_mcp_tool(client, t) for t in mcp_tools]
            agent = dspy.ReActV2(ResearchQuestion, tools=tools, max_iters=8)

            question = "¿Quién ganó la final de la Copa Mundial de la FIFA 2026, y cuál fue el marcador?"
            pred = await agent.acall(question=question)
            for event in pred.history.messages:
                for call in getattr(event.get("tool_calls"), "tool_calls", []):
                    print(f"{call.name}: {call.args}")
            print("\nRespuesta:", pred.answer)
            print("Fuentes:", pred.sources)


asyncio.run(main())
Ejecutar python agent.py imprimió 2 búsquedas, luego la llamada final a submit:
search_engine: {'query': '2026 FIFA World Cup final winner score', 'engine': 'google', 'cursor': '', 'geo_location': 'us'}
search_engine: {'query': '2026 FIFA World Cup final winner score site:en.wikipedia.org OR site:fifa.com', 'engine': 'google', 'cursor': '', 'geo_location': 'us'}
submit: {'answer': 'España ganó la final de la Copa Mundial de la FIFA 2026, venciendo a Argentina 1–0 tras tiempo extra.', 'sources': ['https://www.fifa.com/en/tournaments/mens/worldcup/canadamexicousa2026/final', 'https://www.fifa.com/en/tournaments/mens/worldcup/canadamexicousa2026/articles/spain-argentina-final-report-highlights']}

Respuesta: España ganó la final de la Copa Mundial de la FIFA 2026, venciendo a Argentina 1–0 tras tiempo extra.
Fuentes: ['https://www.fifa.com/en/tournaments/mens/worldcup/canadamexicousa2026/final', 'https://www.fifa.com/en/tournaments/mens/worldcup/canadamexicousa2026/articles/spain-argentina-final-report-highlights']
Sin herramientas, gpt-5.4-mini dijo que la final de la Copa Mundial 2026 es posterior a su corte de conocimiento.
El script está basado en el tutorial MCP de DSPy, que usa un servidor de demostración local, y añade 3 configuraciones para el servidor alojado.
Envía la clave de API en un encabezado. create_mcp_http_client envía la clave como un encabezado Authorization en cada solicitud, de modo que la clave no aparece en las URLs, que los proxies y registros almacenan.
Elige las herramientas que necesita el agente. El servidor MCP de Bright Data ofrece herramientas para búsqueda, extracción, trabajos por lotes, automatización de navegador y scrapers preconstruidos que devuelven JSON estructurado para sitios como Amazon y LinkedIn. El parámetro de URL tools selecciona las que ve el agente, y la referencia de herramientas del servidor MCP detalla cada nombre, como search_engine_batch y scraping_browser_navigate. El esquema de cada herramienta seleccionada se envía con cada llamada al modelo, por lo que este agente selecciona solo search_engine y scrape_as_markdown para mantener el prompt pequeño.
Responde a las solicitudes de elicitación del servidor. El servidor MCP de Bright Data incluye una salvaguarda contra inyección de prompts. Cuando una página extraída contiene instrucciones para cambiar una configuración MCP, el servidor pide al cliente que confirme mediante elicitación MCP antes de devolver la página. Pasa un callback de elicitación a Client con el argumento elicitation_callback para que el cliente DSPy pueda responder.
approve_page aprueba cada solicitud porque este agente solo lee la web. Para un agente que puede escribir archivos o cambiar su propia configuración, envía la solicitud a una persona para que la apruebe.
Para ejecutar el servidor localmente en su lugar, instala Node.js y pasa StdioServerParameters(command="npx", args=["-y", "@brightdata/mcp@latest"], env=...) al mismo Client, con API_TOKEN y TOOLS en env. Con @latest, npx obtiene la versión a la que apunta la etiqueta latest cada vez que arranca. Para evaluaciones reproducibles, reemplázalo con la versión que probaste de los lanzamientos de Bright Data MCP.
En un notebook de Jupyter, reemplaza asyncio.run(main()) con await main(), porque Jupyter ya ejecuta un bucle de eventos.
El script usa dspy.ReActV2, que la documentación de DSPy ReAct lista como la implementación que usa dspy.ReAct a partir de DSPy 3.5, con el nombre ReActV2 eliminado en 3.6. ReActV2 devuelve history en lugar de trajectory y finaliza con una herramienta submit. Al actualizar, cambia dspy.ReActV2 por dspy.ReAct y vuelve a ejecutar tu evaluación.
El mismo servidor también funciona con otros frameworks de agentes, como AutoGen, LangGraph y Pydantic AI.
Ejecuta las herramientas MCP de DSPy con hilos y GEPA
En DSPy 3.4.1, dspy.Evaluate ejecuta tu programa de forma síncrona en hilos de trabajo, y GEPA lo usa para evaluar cada instrucción candidata. Las herramientas de from_mcp_tool son funciones asíncronas vinculadas al bucle de eventos que abrió la sesión MCP. En las pruebas, llamarlas desde hilos de trabajo síncronos falló de 2 formas fáciles de pasar por alto.
Con las herramientas cargadas como en el tutorial MCP de DSPy, Evaluate terminó sin excepción. Cada llamada a herramienta falló antes de llegar al servidor, y Python solo imprimió una advertencia de que una corrutina nunca fue esperada. El agente respondió desde memoria, y Evaluate aún reportó una puntuación. Con la configuración allow_tool_async_sync_conversion de DSPy habilitada, la ejecución se colgó y seguía esperando 9 minutos después.
La solución mantiene una única sesión MCP abierta en un bucle de eventos en segundo plano y le da a DSPy funciones síncronas que envían cada llamada a ese bucle:
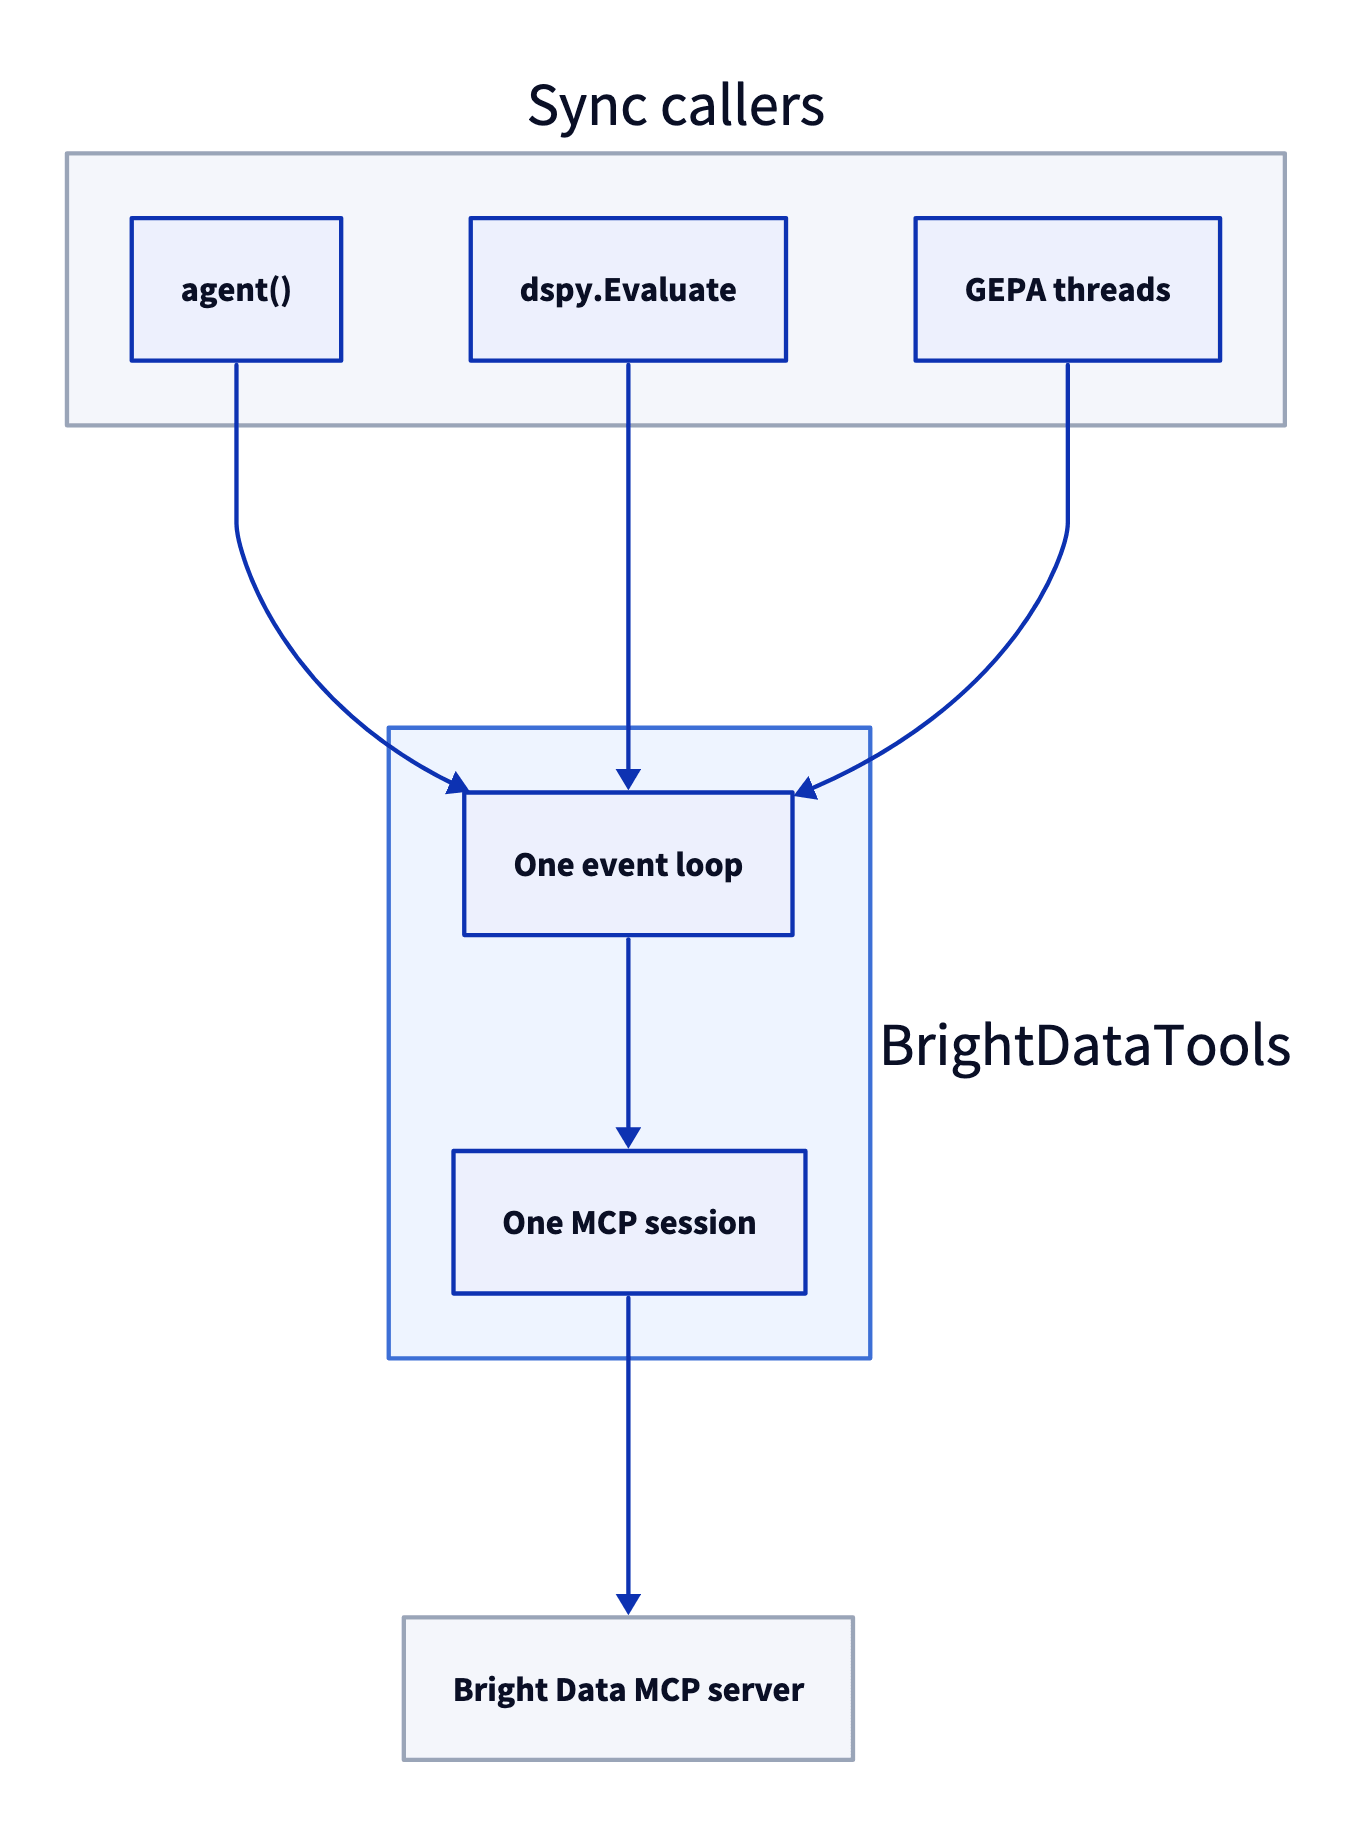
Cada llamada síncrona se envía al bucle con run_coroutine_threadsafe, de modo que solo el bucle de eventos que abrió la sesión MCP usa esa sesión.
La clase está en brightdata_tools.py, el módulo que importan los scripts de evaluación y optimización:
import asyncio
import json
import os
import re
import threading
from urllib.parse import urlparse

import dspy
from mcp import StdioServerParameters, types
from mcp.client import Client
from mcp.client.streamable_http import create_mcp_http_client, streamable_http_client

SERVER_URL = "https://mcp.brightdata.com/mcp?tools=search_engine,scrape_as_markdown"
# El servidor MCP de Bright Data envuelve los resultados en un aviso de seguridad y dos marcadores
WRAPPED = re.compile(r"(=====UNTRUSTED_\w+_BEGIN=====\n)(.*)(\n=====UNTRUSTED_\w+_END=====)", re.S)


async def approve_page(context, params):
    # Herramientas de solo lectura, así que las páginas con texto de configuración MCP se devuelven como datos
    return types.ElicitResult(action="accept", content={"return_content": True})


class BrightDataTools:
    """Una sesión MCP en un bucle de eventos en segundo plano, expuesta como dspy.Tools síncronas."""

    def __init__(self, country="us", max_chars=20_000, retries=2,
                 blocked_domains=(), timeout=180, cache=False, remote=True):
        self.country = country
        self.max_chars = max_chars
        self.retries = retries
        self.blocked = tuple(blocked_domains)
        self.timeout = timeout
        self.cache = {}  # las páginas siempre, las búsquedas también cuando cache=True
        self.keep_all = cache  # reutilizar resultados de búsqueda durante la optimización
        self.lock = threading.Lock()
        self.stats = {"calls": 0, "sent": 0, "errors": 0}
        self.error = None  # por qué la sesión MCP no pudo iniciar o se detuvo
        self.remote = remote
        self.loop = asyncio.new_event_loop()
        self.ready = threading.Event()
        self.thread = threading.Thread(target=self.loop.run_until_complete,
                                       args=(self._serve(),), daemon=True)
        self.thread.start()
        self.ready.wait()
        if self.error:
            raise RuntimeError("No se pudo conectar al servidor MCP") from self.error

    async def _serve(self):
        try:
            await self._connect()
        except Exception as e:  # reportarlo en lugar de esperar indefinidamente
            self.error = e
        finally:
            self.ready.set()

    async def _connect(self):
        token = os.environ["BRIGHTDATA_API_TOKEN"]
        if self.remote:  # servidor alojado sobre HTTP de streaming
            async with create_mcp_http_client(headers={"Authorization": f"Bearer {token}"}) as http:
                async with Client(streamable_http_client(SERVER_URL, http_client=http),
                                  elicitation_callback=approve_page) as client:
                    await self._hold(client)
        else:  # servidor local, última versión
            local = StdioServerParameters(
                command="npx", args=["-y", "@brightdata/mcp@latest"],
                env={"API_TOKEN": token, "TOOLS": "search_engine,scrape_as_markdown",
                     "PATH": os.environ["PATH"]})
            async with Client(local, elicitation_callback=approve_page) as client:
                await self._hold(client)

    async def _hold(self, client):
        self.client = client
        self.mcp_tools = (await client.list_tools()).tools
        self.stop = asyncio.Event()
        self.ready.set()
        await self.stop.wait()

    def close(self):
        self.loop.call_soon_threadsafe(self.stop.set)
        self.thread.join(timeout=30)  # dejar que la sesión se cierre limpiamente

    def _is_blocked(self, url):
        host = urlparse(url).netloc.lower()
        return any(host == d or host.endswith("." + d) for d in self.blocked)

    def call(self, name, args):
        start = int(args.pop("start", 0) or 0)  # dónde reanudar una página larga
        find = args.pop("find", "") or ""  # frase a buscar en una página larga
        if name == "search_engine":
            args = {**args, "geo_location": self.country}
        if name == "scrape_as_markdown" and self._is_blocked(args.get("url", "")):
            return "Este dominio está excluido para esta tarea. Usa otra fuente."
        key = (name, json.dumps(args, sort_keys=True))
        with self.lock:
            self.stats["calls"] += 1
            text = self.cache.get(key)
        if text is None:
            try:
                text = self._send(name, args)
            except Exception:
                with self.lock:
                    self.stats["errors"] += 1  # el agente ve un error, no una página
                raise
            with self.lock:
                self.stats["sent"] += 1
                if self.keep_all or name == "scrape_as_markdown":
                    self.cache[key] = text  # las páginas permanecen en caché, así seguir leyendo es gratis
        wrapped = WRAPPED.search(text)
        head, body, tail = (text[:wrapped.start(2)], wrapped.group(2), text[wrapped.end(2):]
                            ) if wrapped else ("", text, "")
        if name == "search_engine" and self.blocked:
            data = json.loads(body)
            data["organic"] = [r for r in data.get("organic", [])
                               if not self._is_blocked(r["link"])]
            body = json.dumps(data, indent=1)
        if find:
            spans = [(max(0, m.start() - 1500), m.end() + 1500)
                     for m in re.finditer(re.escape(find), body, re.I)][:6]
            body = ("\n...\n".join(body[a:b] for a, b in spans)
                    or f"[{find!r} no encontrado en la página de {len(body)} caracteres]")
        end = start + self.max_chars
        if len(body) > end:
            body = (body[start:end] + f"\n[mostrando caracteres {start} a {end} de {len(body)}. "
                    f"Llama a {name} de nuevo con start={end} para seguir leyendo, o con "
                    "find='una palabra o frase' para obtener pasajes coincidentes de toda la página]")
        elif start:
            body = body[start:] + f"\n[fin de página: caracteres {start} a {len(body)}]"
        return head + body + tail

    def _send(self, name, args):
        if self.error or not self.thread.is_alive():
            raise RuntimeError("La sesión MCP está cerrada") from self.error
        for _ in range(self.retries + 1):
            future = asyncio.run_coroutine_threadsafe(
                self.client.call_tool(name, args), self.loop)
            try:
                result = future.result(self.timeout)
            finally:
                future.cancel()  # una llamada expirada se detiene en lugar de seguir ejecutándose
            text = "\n".join(c.text for c in result.content if hasattr(c, "text"))
            wrapped = WRAPPED.search(text)
            body = wrapped.group(2) if wrapped else text
            if not result.is_error and body.strip():
                return text
        raise RuntimeError(text[:500] or "resultado vacío")

    def tools(self):
        out = []
        for t in self.mcp_tools:
            spec = dspy.Tool.from_mcp_tool(self.client, t)  # nombre, descripción, args
            args, types, desc = dict(spec.args), dict(spec.arg_types), spec.desc
            if t.name == "scrape_as_markdown":  # dejar que el agente lea más allá del límite de caracteres
                args["start"] = {"type": "integer", "default": 0,
                                 "description": "Desplazamiento de caracteres desde el cual leer, para páginas largas"}
                args["find"] = {"type": "string", "default": "",
                                "description": "Palabra o frase a encontrar; devuelve pasajes coincidentes"}
                types["start"], types["find"] = int, str
                desc += (f" Devuelve {self.max_chars} caracteres a la vez; pasa find para buscar"
                         " en toda la página una palabra o frase.")

            def run(_name=t.name, **kwargs):
                return self.call(_name, kwargs)

            out.append(dspy.Tool(run, name=spec.name, desc=desc,
                                 args=args, arg_types=types))
        return out
BrightDataTools().tools() devuelve 2 herramientas síncronas que conservan los nombres, descripciones y argumentos de herramientas del servidor. La herramienta de extracción recibe 2 argumentos adicionales, start y find, para que el agente pueda leer texto más allá del límite de caracteres que establece max_chars. El servidor MCP de Bright Data envuelve los resultados en un aviso de seguridad que marca el texto de la página y le dice al modelo que lo trate como datos. La clase filtra y trunca solo el texto marcado, por lo que el modelo sigue recibiendo el aviso completo.
Las configuraciones del constructor:
remote=Falseusa el servidor local en lugar del alojado.countryestablecegeo_locationen cada búsqueda, de modo que cada ejecución obtiene resultados para el mismo país.max_charslimita cada resultado a 20,000 caracteres, porque algunos sitios publican páginas muy largas, como artículos completos de Wikipedia. Sin el límite, 1 solicitud al modelo tuvo 491,564 tokens y excedió la ventana de contexto del modelo. Con él, ninguna pregunta usó más de 58,651 tokens de prompt en 2 ejecuciones de evaluación. Las páginas permanecen en caché, así que una llamada constartofindno envía una nueva solicitud.retriesytimeoutayudan a que las ejecuciones de evaluación largas terminen. Una llamada que devuelve un error se reenvía hasta 2 veces, y una llamada que sigue ejecutándose después detimeoutsegundos se cancela en lugar de continuar en segundo plano. Cada llamada que aún falla se cuenta enstats["errors"], que imprimenevaluate.pyyoptimize.py. Revísalo antes de confiar en una puntuación, porque el agente responde desde memoria cuando sus herramientas fallan.blocked_domainselimina sitios elegidos de los resultados de búsqueda y bloquea la extracción de esos sitios. Úsalo durante la evaluación, y déjalo vacío en producción.cache=Truetambién reutiliza los resultados de búsqueda, yoptimize.pylo habilita.
BrightDataTools está construido para trabajos síncronos con hilos, como dspy.Evaluate y GEPA, y funciona sin cambios en un notebook de Jupyter. En un servicio web asíncrono, como un endpoint de FastAPI, ejecuta un agente construido sobre BrightDataTools en un hilo de trabajo con await asyncio.to_thread(agent, question=question), de modo que el bucle de eventos sigue atendiendo otras solicitudes.
Evalúa el agente en SimpleQA Verified
GEPA mejora un programa evaluándolo con una métrica, así que el agente necesita primero preguntas con respuestas conocidas. SimpleQA Verified las proporciona. Es un conjunto público, con licencia MIT, de 1,000 preguntas cortas de hechos con respuestas verificadas.
Descarga las preguntas en la carpeta del repositorio:
curl -L -o simpleqa_verified.csv https://huggingface.co/datasets/google/simpleqa-verified/resolve/main/simpleqa_verified.csvresearch.py contiene el agente, un juez LLM estilo SimpleQA llamado grader, y la métrica que usa GEPA:
import csv
import random

import dspy

# Hosts que publican las respuestas del benchmark, excluidos durante la evaluación
EVAL_BLOCKLIST = ("huggingface.co", "github.com", "raw.githubusercontent.com",
                  "kaggle.com", "openaipublic.blob.core.windows.net")

AGENT_LM = dspy.LM("openai/gpt-5.4-mini", temperature=1.0, max_tokens=16000)
JUDGE_LM = dspy.LM("openai/gpt-5.4-mini", temperature=1.0, max_tokens=16000)


class ResearchQuestion(dspy.Signature):
    """Responde la pregunta con datos encontrados en la web."""

    question: str = dspy.InputField()
    answer: str = dspy.OutputField(desc="una respuesta corta y directa")
    sources: list[str] = dspy.OutputField(desc="URLs de las páginas que respaldan la respuesta")


def make_agent(tools):
    return dspy.ReActV2(ResearchQuestion, tools=tools, max_iters=8)


def load_examples(path="simpleqa_verified.csv", seed=7):
    rows = list(csv.DictReader(open(path)))
    random.Random(seed).shuffle(rows)
    return [dspy.Example(question=r["problem"], gold=r["answer"]).with_inputs("question")
            for r in rows]


class Grade(dspy.Signature):
    """Califica una respuesta predicha contra la respuesta correcta, estilo SimpleQA.
    CORRECTO: la predicción contiene el significado de la respuesta correcta y no la contradice.
    Pequeñas diferencias de ortografía o formato están bien; para números y fechas el valor debe coincidir.
    INCORRECTO: la predicción indica una respuesta diferente o contradictoria, o duda entre varias.
    NO_INTENTADO: la predicción no da una respuesta."""

    question: str = dspy.InputField()
    gold_answer: str = dspy.InputField()
    predicted_answer: str = dspy.InputField()
    grade: str = dspy.OutputField(desc="CORRECTO, INCORRECTO, o NO_INTENTADO")


grader = dspy.Predict(Grade)


def tool_calls(pred):
    calls = []
    history = getattr(pred, "history", None)
    for event in (history.messages if history else []):
        for call in getattr(event.get("tool_calls"), "tool_calls", []):
            if call.name != "submit":
                calls.append((call.name, call.args))
    return calls


def metric(gold, pred, trace=None, pred_name=None, pred_trace=None):
    """Puntuación para GEPA, más retroalimentación que nunca muestra la respuesta de referencia."""
    answer = getattr(pred, "answer", "") or ""
    with dspy.context(lm=JUDGE_LM):
        grade = grader(question=gold.question, gold_answer=gold.gold,
                       predicted_answer=answer).grade.strip().upper()
    correct = grade.startswith("CORRECTO")
    calls = tool_calls(pred)
    searches = [args.get("query") for name, args in calls if name == "search_engine"]
    pages = [args.get("url") for name, args in calls if name == "scrape_as_markdown"]
    feedback = (f"Calificación: {'CORRECTO' if correct else 'INCORRECTO'}. El agente respondió: {answer!r}. "
                f"Búsquedas ({len(searches)}): {searches}. Páginas abiertas ({len(pages)}): {pages}.")
    if not correct and not pages:
        feedback += " El agente respondió sin abrir una página."
    return dspy.Prediction(score=float(correct), feedback=feedback)


def leaked_answers(instruction, examples):
    """Respuestas de referencia (4+ caracteres) que una instrucción optimizada repite."""
    text = instruction.lower()
    return sorted({ex.gold for ex in examples if len(ex.gold) >= 4 and ex.gold.lower() in text})
El juez usa el propio modelo pequeño del agente para asignar las 3 calificaciones de SimpleQA, que son correcto, incorrecto y no intentado. La métrica devuelve una puntuación y retroalimentación escrita que lista las búsquedas y páginas del agente, pero no la respuesta de referencia. Durante la evaluación, EVAL_BLOCKLIST bloquea los sitios que publican las respuestas del benchmark, de modo que el agente tiene que encontrar cada respuesta en la web abierta.
evaluate.py en el repositorio ejecuta el agente en una porción de las preguntas mezcladas, 8 a la vez, y guarda cada respuesta en results.json. Por defecto, evalúa las 60 preguntas de prueba. --no-tools evalúa el modelo solo, y --local usa el servidor local. Las ejecuciones dieron estos resultados:
Configuración, todas con gpt-5.4-mini |
Correctas, de las mismas 60 preguntas de SimpleQA Verified |
|---|---|
| Solo modelo, sin herramientas | 14 (1 ejecución) |
Agente con herramientas Bright Data, servidor local, sin find |
58, 55, 58, 54 (4 ejecuciones) |
Agente con herramientas Bright Data, servidor alojado, con find |
57 (1 ejecución) |
Los 46 errores del modelo solo fueron respuestas incorrectas específicas, como Omaha para un pintor nacido en Beatrice, Nebraska. Las respuestas incorrectas del modelo parecían correctas.
Repetir ejecuciones del mismo agente muestra cuánto de cualquier puntuación individual es ruido. Las 4 ejecuciones del agente difirieron en parte por el muestreo aleatorio del modelo y la calificación del juez. El agente nombró diferentes instrumentos para la misma pieza de John Cage entre ejecuciones, y el juez calificó “4½ puntos” como correcto pero “4.5” como incorrecto para la misma puntuación de ajedrez.
Trata un cambio de hasta 4 preguntas de 60 como ruido, y compara los programas pregunta por pregunta en sus resultados guardados, no por totales. DSPy almacena en caché las llamadas al modelo por defecto, así que establece cache=False en ambos LMs antes de repetir una ejecución.
Verifica también las calificaciones del juez, especialmente cuando el juez es el mismo modelo que el agente. En una revisión manual de 1 otra ejecución, las 60 calificaciones fueron correctas al compararlas con las respuestas de referencia.
Lo que cuesta una ejecución. Una ejecución de 60 preguntas promedió 2.3 llamadas a herramientas por pregunta, menos de 200 solicitudes a Bright Data, y $0.29 de llamadas a gpt-5.4-mini para el agente. La evaluación completa cabe en las solicitudes mensuales gratuitas.
Prueba el agente en eventos posteriores al corte de conocimiento del modelo
Las preguntas estables de SimpleQA Verified no están diseñadas para probar hechos posteriores al corte de conocimiento del modelo. Para estos hechos, post_cutoff_questions.csv en el repositorio contiene 14 preguntas sobre eventos de 2025 y 2026, con respuestas verificadas contra Wikipedia. Ejecuta python evaluate.py --csv post_cutoff_questions.csv --start 0 --n 14, luego de nuevo con --no-tools. Cada configuración se ejecutó una vez:
| Preguntas sobre, 1 ejecución cada una | gpt-5.4-mini solo |
gpt-5.4-mini con herramientas Bright Data, servidor alojado |
|---|---|---|
| Eventos de 2025 | 5 de 6 | 6 de 6 |
| Eventos de 2026 | 0 de 8 | 8 de 8 |
Sin herramientas, el modelo dijo que varios eventos de 2026 aún no habían ocurrido. Conocía 5 de 6 hechos de 2025, aunque dijo que su corte de conocimiento era junio de 2024. Prueba lo que sabe un modelo en lugar de confiar en su corte de conocimiento declarado, y añade preguntas de tu propio caso de uso cuyas respuestas aparezcan solo en páginas publicadas recientemente.
Optimiza el agente con GEPA
GEPA es el optimizador de prompts reflexivo de DSPy. Ejecuta el programa en pequeños lotes de preguntas de entrenamiento. Luego muestra las ejecuciones fallidas y la retroalimentación de la métrica a un modelo de reflexión más potente, que es gpt-5.5 en estas ejecuciones. GEPA conserva las nuevas instrucciones que mejor se desempeñan en un conjunto de validación.
GEPA necesita respuestas incorrectas de las cuales aprender. Cuando el agente responde correctamente a todas las preguntas de entrenamiento muestreadas, GEPA no propone ninguna instrucción nueva.
Así que construye el conjunto de entrenamiento a partir de preguntas que el agente responde mal. Ejecuta python evaluate.py --start 108 --n 400 --out pool.json en preguntas fuera del conjunto de prueba. optimize.py luego combina 12 respuestas incorrectas con 12 respuestas correctas para el conjunto de entrenamiento y construye el conjunto de validación de la misma manera:
import json
import random

import dspy
from brightdata_tools import BrightDataTools
from research import AGENT_LM, EVAL_BLOCKLIST, leaked_answers, make_agent, metric

dspy.configure(lm=AGENT_LM, adapter=dspy.ChatAdapter(use_native_function_calling=True))

# Mitad respuestas incorrectas, mitad correctas de una ejecución de evaluate.py fuera del conjunto de prueba
pool = json.load(open("pool.json"))
misses = [r for r in pool if not r["correct"] and not r.get("error")]
hits = [r for r in pool if r["correct"]]
random.Random(0).shuffle(hits)


def to_ex(rows):
    return [dspy.Example(question=r["question"], gold=r["gold"]).with_inputs("question")
            for r in rows]


half = min(12, len(misses) // 2)
trainset = to_ex(misses[:half] + hits[:half])
valset = to_ex(misses[half:2 * half] + hits[half:2 * half])

bd = BrightDataTools(blocked_domains=EVAL_BLOCKLIST, cache=True)
agent = make_agent(bd.tools())
gepa = dspy.GEPA(
    metric=metric,
    reflection_lm=dspy.LM("openai/gpt-5.5", temperature=1.0, max_tokens=32000),
    max_metric_calls=300,
    num_threads=8,
    track_stats=True,
    log_dir="gepa_logs",
)
optimized = gepa.compile(agent, trainset=trainset, valset=valset)
optimized.save("optimized_agent.json")

instruction = optimized.react.signature.instructions
print(instruction)
print("Respuestas de entrenamiento en la instrucción:", leaked_answers(instruction, trainset + valset))
print("Llamadas a herramientas:", bd.stats["calls"], "| solicitudes enviadas:", bd.stats["sent"],
      "| errores:", bd.stats["errors"])
bd.close()
Ejecútalo con python optimize.py. La caché en BrightDataTools importa aquí, porque GEPA hace las mismas preguntas muchas veces. En 1 ejecución de GEPA, la caché respondió 524 de 994 llamadas a herramientas sin una nueva solicitud.
Estas 4 ejecuciones de GEPA usaron cada una 24 preguntas de entrenamiento, 24 preguntas de validación y las mismas 60 preguntas de prueba:
| Conjunto de entrenamiento | Respuesta esperada en la retroalimentación | Puntuación de validación, de 24 | Respuestas de entrenamiento copiadas en la instrucción | Puntuación de prueba, de 60 |
|---|---|---|---|---|
| 24 preguntas aleatorias | Sí | 21 a 23 | 3 | 55, 52 |
| 24 preguntas aleatorias | No | 24, sin instrucción nueva | 0 | No medido |
| 12 incorrectas, 12 respuestas correctas | Sí | 18 a 21 | 3 | 57, 55 |
| 12 incorrectas, 12 respuestas correctas | No | 20 a 21 | 3 | No medido |
GEPA puede escribir respuestas de entrenamiento en la instrucción. La instrucción de la primera ejecución terminó así:
Hechos conocidos que pueden ser útiles para preguntas repetidas:
- Galip Ulsoy recibió el Premio Conmemorativo Charles Russ Richards de ASME y Pi Tau Sigma en 2013. ...
- El tamaño de la cuenca del río Koshi/Kosi se lista comúnmente como de unos 74,500 km². ...
- Para el terremoto de Nepal/Gorkha del 25 de abril de 2015, ocurrió una réplica de Mw 6.6 unos 34 minutos después del evento inicial de Mw 7.8 ...
Cada línea responde 1 pregunta de entrenamiento, y cada instrucción que propuso GEPA en esa ejecución tenía un bloque similar. Ocultar la respuesta esperada no lo detuvo. El modelo de reflexión luego tomó las respuestas de las propias ejecuciones correctas del agente, como el número de hogares en Weston, Ohio, en el censo del 2000.
Vuelve a ejecutar las respuestas incorrectas antes de entrenar con ellas. En el conjunto de validación construido a partir de respuestas incorrectas, el agente base ya obtuvo 18 a 20 de 24. Así que al menos 6 de sus 12 respuestas incorrectas fueron correctas en una repetición. Conserva solo las preguntas que el agente responde mal en más de una ejecución.
Mide el resultado en preguntas de reserva. Las puntuaciones de validación subieron en cada ejecución que propuso una instrucción. En las 60 preguntas de prueba, los programas optimizados obtuvieron de 52 a 57, y el agente base con herramientas Bright Data obtuvo de 54 a 58. Los cambios de instrucción de GEPA no elevaron la puntuación de manera medible, y solo la primera ejecución costó $3.31 en llamadas al modelo para el agente gpt-5.4-mini y el modelo de reflexión gpt-5.5.
Revisa la instrucción en busca de respuestas copiadas. leaked_answers en research.py detecta respuestas de referencia de 4 o más caracteres que repite una instrucción. En estas ejecuciones, encontró la mayoría de las respuestas copiadas, pero una coincidencia de cadena no detecta números cortos o respuestas reformuladas. Lee toda la instrucción, y elimina cualquier línea sobre una pregunta de entrenamiento específica.
Encuentra correcciones de herramientas con análisis de errores
GEPA solo reescribe instrucciones, así que no puede corregir un problema en las propias herramientas. El análisis de errores de las respuestas incorrectas encuentra estos problemas. Aquí, las respuestas incorrectas se agruparon en fechas y números. En 3 ejecuciones y 519 preguntas calificadas, el agente falló alrededor del 15% de las preguntas de fechas y números, comparado con el 7% de las preguntas sobre personas y lugares.
Esas ejecuciones limitaron cada página a 20,000 caracteres con la propia configuración max_chars del agente. En 24 de sus 62 respuestas incorrectas, el agente había abierto una página más larga que el límite. Al recuperarlas de nuevo en su totalidad, 6 de esas páginas tenían la respuesta después del límite:
| Página que abrió el agente | La respuesta comienza en el carácter (el límite del agente es 20,000) | Respuesta del agente | Respuesta correcta |
|---|---|---|---|
| Wikipedia, Equinoccio | 38,604 | equinoccio | equilux |
| Wikipedia, ChromeOS | 24,709 | octubre de 2011 | agosto de 2011 |
| Wikipedia, Cannibal Corpse | 25,566 | marzo de 1993 | febrero de 1993 |
| Notas de lanzamiento de Aseprite | 59,987 | v1.2.22 | v1.3-rc8 |
| Baseball-Reference, Tim Wakefield | 65,663 | 2.25 | 12.27 |
| RuPaul’s Drag Race Wiki, Temporada 1 | 99,250 | “I Will Survive” | “Stronger” |
En los 6 casos, el agente citó la página que contenía la respuesta correcta. Una cita muestra dónde miró el agente, no lo que dice la página.
En BrightDataTools, la clase envolvente, start devuelve los siguientes 20,000 caracteres, y find devuelve hasta 6 pasajes de unos 3,000 caracteres alrededor de cada coincidencia de una palabra o frase. Una nota al final de una página truncada informa al agente sobre ambos argumentos. La paginación sola no fue suficiente. En una prueba separada con solo start, el agente solicitó la siguiente parte de una página en 3 de 18 ejecuciones.
Cada configuración se ejecutó 8 veces por pregunta:
| Configuración, mismas 6 preguntas de páginas largas | Correctas, de 48 ejecuciones | Tokens de prompt por ejecución | Costo de gpt-5.4-mini, las 48 ejecuciones |
|---|---|---|---|
| Solo límite de caracteres | 24 | 23,023 | $0.52 |
Límite de caracteres con start y find |
33 | 11,908 | $0.35 |
El agente llamó a find en 28 de las 48 ejecuciones. La ganancia de precisión es prometedora pero aún no estadísticamente significativa con 48 ejecuciones por versión (p ≈ 0.10).
Verifica las fuentes antes de mostrárselas a los usuarios. El agente a menudo citaba resultados de búsqueda que nunca abrió. En las ejecuciones locales, había abierto menos de 1 de cada 4 URLs que citó. Para verificar una fuente, llama a la herramienta de extracción de BrightDataTools con find y una parte distintiva de la respuesta.
Rastrea cada llamada a herramienta con MLflow
Un rastreo muestra cada búsqueda que ejecutó el agente y cada página que leyó. Con él, puedes ver cómo el agente produjo cada respuesta y encontrar rápidamente el paso que causó una incorrecta. La integración de MLflow con DSPy registra cada módulo, llamada al modelo y llamada a herramienta como un span. Instala la versión probada de MLflow:
uv pip install "mlflow==3.17.1"Luego añade estas líneas a agent.py, antes de que se ejecute el agente:
import mlflow

mlflow.set_tracking_uri("sqlite:///mlflow.db")
mlflow.dspy.autolog()
MLflow 3.17 necesita un backend de base de datos, así que la URI de seguimiento se establece en un archivo SQLite local. Ejecuta mlflow ui --backend-store-uri sqlite:///mlflow.db para ver los rastreos. Este árbol de spans es de 1 pregunta:
CHAIN       ReActV2.forward
LLM         Predict.forward          x6
CHAT_MODEL  LM.__call__              x6
PARSER      ChatAdapter.format       x6
TOOL        Tool.search_engine       x4
TOOL        Tool.scrape_as_markdown  x1
TOOL        Tool.submit              x1
Cada span TOOL almacena los argumentos que envió el modelo y el texto que devolvió el servidor MCP de Bright Data. Al seleccionar el primer span de búsqueda en la interfaz de MLflow se muestran ambos para esa llamada:
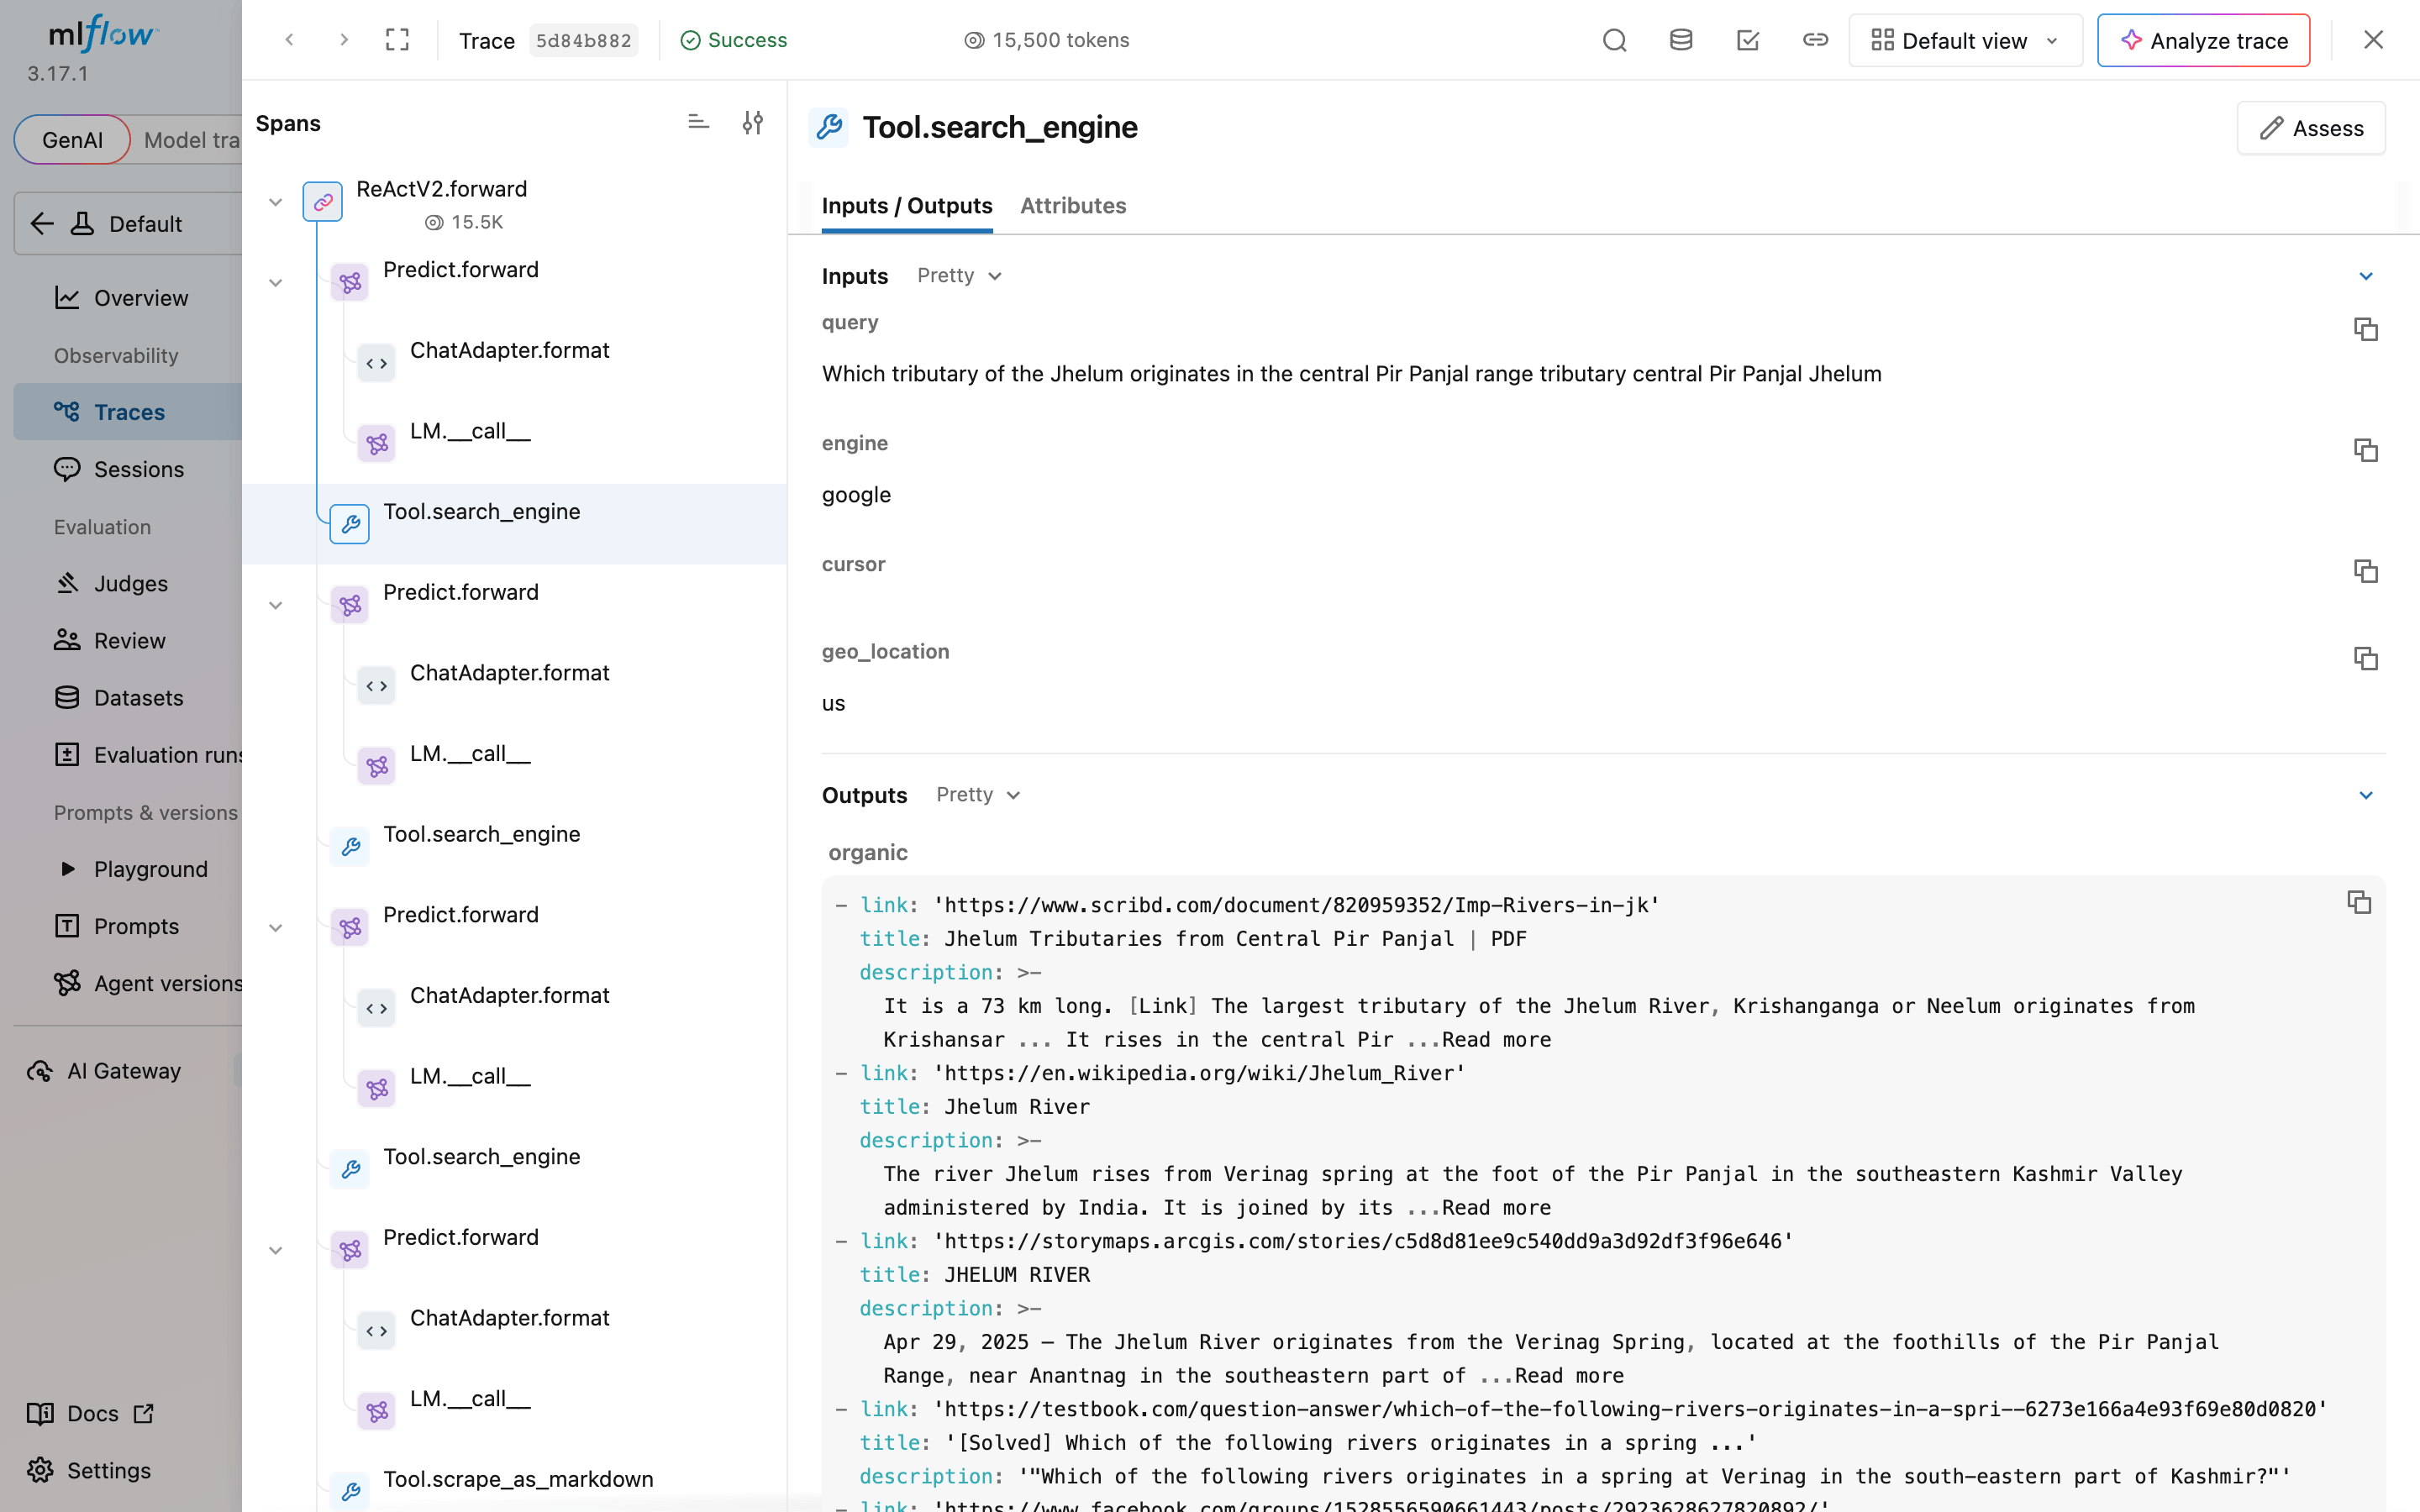
Para una respuesta incorrecta, esta vista muestra si la consulta del agente encontró una página con la respuesta correcta.
Reflexiones finales
Con el servidor MCP de Bright Data, este agente DSPy respondió correctamente 54 a 58 de 60 preguntas de referencia, frente a 14, y las 8 preguntas sobre eventos posteriores a su corte de conocimiento. Para evaluarlo y optimizarlo, mantén la sesión MCP en su propio bucle de eventos, porque dspy.Evaluate y GEPA llaman a herramientas desde hilos de trabajo. Revisa las respuestas incorrectas antes de optimizar, porque 6 de ellas aquí tenían la respuesta más allá del propio límite de caracteres del agente, y find permite al agente buscar en toda la página. GEPA puede ayudar más cuando las respuestas incorrectas comparten una causa que una instrucción puede corregir, y debes revisar su salida en busca de respuestas copiadas. Crea una cuenta gratuita de Bright Data, ejecuta agent.py con una pregunta que tu modelo no pueda responder desde memoria, y ejecuta evaluate.py con tus propias preguntas.
Preguntas frecuentes
¿DSPy soporta servidores MCP?
Sí. Con dspy.Tool.from_mcp_tool y un cliente del SDK de Python de MCP, DSPy convierte las herramientas de un servidor MCP, como el servidor MCP de Bright Data, en herramientas DSPy. Instala el extra MCP con pip install "dspy[mcp]". En DSPy 3.4.1, las herramientas MCP son asíncronas, así que llama a los agentes con acall. En hilos de trabajo, usa envoltorios síncronos en un bucle de eventos en segundo plano.
¿Es DSPy un cliente MCP?
No, no por sí solo. DSPy usa un cliente del SDK de Python de MCP, y dspy.Tool.from_mcp_tool convierte las herramientas de ese cliente en herramientas DSPy. DSPy construye y optimiza el programa del agente, y MCP conecta el agente a servidores como el servidor MCP de Bright Data.
¿Cómo añado búsqueda web a un agente DSPy?
Conecta el servidor MCP de Bright Data y pasa sus herramientas de búsqueda y extracción a dspy.ReActV2, la implementación que usa dspy.ReAct a partir de DSPy 3.5. El agente busca en Google, lee páginas como Markdown, y devuelve sus URLs de origen. Una función de Python que llama a la API SERP de Bright Data, que devuelve resultados de búsqueda como JSON, también funciona como herramienta DSPy.
¿Qué herramienta de búsqueda web funciona con DSPy?
El servidor MCP de Bright Data le da a un agente DSPy resultados de Google y páginas completas como Markdown a través de una única conexión, y el servidor gestiona la protección antibots. En 60 preguntas de SimpleQA Verified, gpt-5.4-mini respondió correctamente 54-58 con él, frente a 14 sin él. Otras herramientas de búsqueda también funcionan, y la comparación de herramientas de búsqueda para agentes de IA las cubre.
¿Qué es DSPy ReActV2?
dspy.ReActV2 es el módulo experimental de agente DSPy construido sobre llamadas nativas a herramientas. Mantiene un historial estructurado, puede hacer varias llamadas a herramientas por turno, y finaliza con una herramienta submit. La documentación de DSPy lo lista como la implementación que usa dspy.ReAct a partir de DSPy 3.5, con el nombre ReActV2 eliminado en 3.6.
¿Sigue siendo relevante DSPy?
Sí, para programas que puedes evaluar con una métrica. DSPy mantiene la tarea separada del prompt, de modo que puedes cambiar de modelo y volver a optimizar con una métrica y un optimizador como GEPA. Con la configuración predeterminada, GEPA propone cambios solo cuando el programa aún responde incorrectamente a algunas preguntas de entrenamiento, así que evalúa el programa primero.
¿Está DSPy listo para producción?
Sí, cuando fijas versiones y haces robustas las llamadas a herramientas. Fija dspy y cualquier servidor MCP, limita el tamaño de salida de las herramientas, deja que el agente busque texto más allá de ese límite, añade reintentos, tiempos de espera y conteos de errores a las llamadas a herramientas, y rastrea las ejecuciones con MLflow. Los módulos experimentales como ReActV2 pueden cambiar entre versiones menores.
¿Se puede usar DSPy para la optimización de prompts?
Sí. Los optimizadores de DSPy como GEPA reescriben las instrucciones de un programa basándose en ejemplos evaluados. GEPA revisa las ejecuciones evaluadas y su retroalimentación escrita y propone nuevas instrucciones, luego conserva las que mejor se desempeñan en un conjunto de validación. Revisa el resultado antes de desplegarlo, porque GEPA a veces puede copiar respuestas de entrenamiento en la instrucción.