Esta guía cubre las diez herramientas de línea de comandos que vale la pena instalar junto a Codex. La primera es la Bright Data CLI. Soluciona un punto ciego con el que Codex viene por diseño: el sandbox no tiene acceso a la red.
Cada herramienta aquí se ejecuta de forma no interactiva, imprime algo que un modelo puede analizar y es segura para ejecutar sin supervisión. Las herramientas que necesitan a un humano en el teclado están excluidas. Una sección al final explica por qué varios favoritos populares de Codex no llegaron a la lista. Si usas ambos agentes, la lista complementaria para Claude Code cubre el mismo terreno para ese entorno.
TL;DR: las 10 CLIs y qué soluciona cada una
| # | CLI | Qué soluciona para Codex | Instalación |
|---|---|---|---|
| 1 | Bright Data CLI | Acceso web real: desbloqueo, SERP, más de 40 pipelines estructurados, control de navegador y scraping con IA mediante Scraper Studio | npm i -g @brightdata/cli |
| 2 | ripgrep | La búsqueda que Codex ya prefiere y aprueba automáticamente | brew install ripgrep |
| 3 | fd | Encontrar archivos por nombre sin la sintaxis manual de find |
brew install fd |
| 4 | ast-grep | Refactorizaciones que coinciden con la sintaxis en lugar de regex | brew install ast-grep |
| 5 | jq | Filtrar codex exec --json y cualquier otro JSON |
brew install jq |
| 6 | gh | PRs, issues, ejecuciones de CI y la API de GitHub | brew install gh |
| 7 | uv | Instalaciones, ejecuciones y lockfiles de Python en segundos | curl -LsSf https://astral.sh/uv/install.sh | sh |
| 8 | mise | Toolchains fijados que sobreviven a una fase de agente sin conexión | curl https://mise.run | sh |
| 9 | gitleaks | Bloquea secretos antes de que el agente los confirme | brew install gitleaks |
| 10 | Firecrawl CLI | Una segunda CLI web, con un índice de búsqueda de documentación para desarrolladores | npm i -g firecrawl-cli |
Qué hace que una CLI sea buena para Codex específicamente
La mayoría de las listas de “mejores herramientas de terminal” están optimizadas para humanos. Los agentes tienen requisitos diferentes, y la discrepancia importa más de lo que parece. Una herramienta que amas en una sesión interactiva puede ser inútil para Codex. Un binario simple y aburrido puede ser transformador. Verifica cualquier cosa que estés a punto de instalar con estos criterios primero.
- Debe ejecutarse de forma no interactiva. Codex no puede responder a un prompt de confirmación ni manejar una interfaz de pantalla completa. Cualquier cosa que espere una pulsación de tecla detiene el turno hasta que se agota el tiempo.
- Debe emitir salida estructurada. Un indicador
--jsonconvierte un muro de texto en algo que el agente puede filtrar y razonar con precisión. La salida en prosa invita a errores de parseo que aparecen tres pasos después. - Debe ser eficiente en tokens. Cada byte que imprime la herramienta es un byte en la ventana de contexto. Los modos silenciosos, la selección de campos y la paginación mantienen las sesiones económicas y largas.
- Debe devolver códigos de salida honestos. Codex decide qué hacer a continuación en parte por el estado de salida. Una herramienta que sale con 0 en caso de fallo envía al agente confiadamente por un camino equivocado.
- Debe sobrevivir al sandbox. Este es el específico de Codex. Los comandos se ejecutan dentro de un sandbox impuesto por el sistema operativo sin acceso a la red por defecto. Una herramienta que accede a internet en cada llamada activa un prompt de aprobación cada vez. La configuración deliberada lo soluciona, y la última sección de esta guía muestra cómo.
Hay un detalle relacionado que vale la pena conocer antes de instalar cualquier cosa. Codex no tiene una lista integrada de comandos que trate como seguros. El conjunto que se ejecuta fuera del sandbox sin solicitar permiso proviene enteramente de reglas que tú escribes: archivos .rules que Codex escanea al inicio desde ~/.codex/rules/, y desde <repo>/.codex/rules/ en proyectos de confianza. Ese conjunto comienza vacío, por lo que cada herramienta a continuación solicita permiso hasta que una regla la cubra. Cuando apruebas un comando en el TUI, Codex escribe la regla en ~/.codex/rules/default.rules por ti, razón por la cual la aprobación previa de tu toolchain es parte de su instalación.
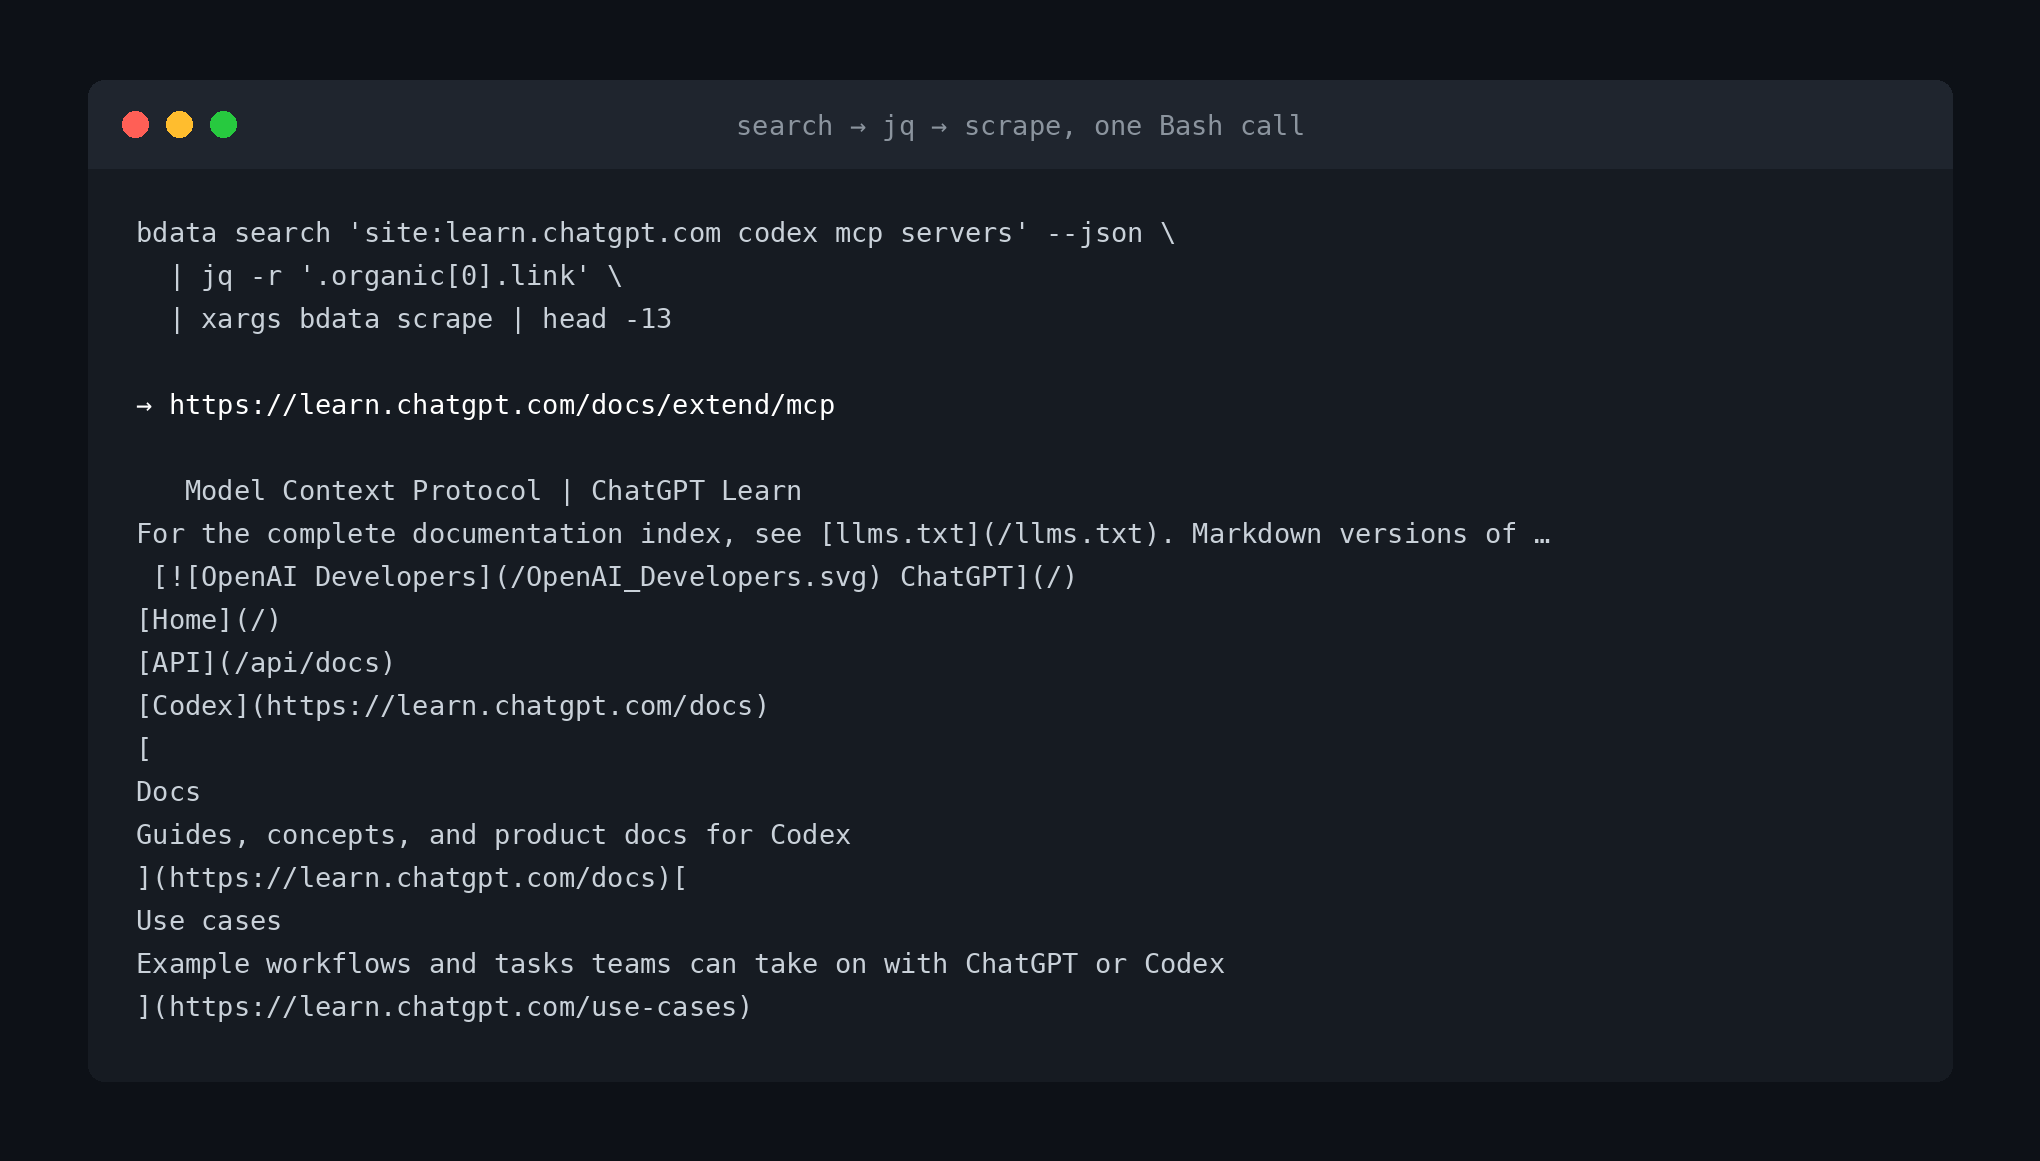
El vacío que ninguna otra lista cubre: Codex no puede acceder a la web abierta por defecto
Codex está deliberadamente aislado de la red, y la mayoría de las guías omiten esto por completo. La propia documentación de seguridad de OpenAI es clara al respecto: por defecto, el agente se ejecuta con el acceso a la red desactivado. El sandbox predeterminado workspace-write lo mantiene desactivado hasta que lo habilitas en la configuración. Cuando el agente necesita llegar a un host, se detiene y solicita aprobación en su lugar. Ese es un valor predeterminado de seguridad sólido. También es el mayor límite en lo que Codex puede investigar por su cuenta.
La búsqueda web integrada es más limitada de lo que la gente asume. Codex habilita la búsqueda en caché por defecto, que responde desde un índice mantenido por OpenAI en lugar de obtener páginas arbitrarias en vivo. Puedes pasar --search para una ejecución, o establecer web_search = "live" en config.toml, para cambiar a resultados en vivo. Incluso entonces, la búsqueda es una herramienta alojada. Devuelve resultados, no una página autenticada, no una aplicación renderizada con JavaScript, y no una página detrás de Cloudflare.
El mismo límite aplica en la nube. En un entorno de nube de Codex, la fase de configuración puede acceder a la red para instalar dependencias. La fase del agente luego se ejecuta sin conexión a menos que habilites el acceso a internet para ese entorno. Por lo tanto, el patrón se mantiene local y remotamente. Codex puede razonar sobre la web, pero no puede obtenerla de manera confiable.
Nada de esto es un defecto en Codex. El acceso web confiable es un problema de infraestructura más que un problema de modelo. Se resuelve con proxies, gestión de huellas digitales del navegador y manejo de CAPTCHAs. Ese es exactamente el trabajo para el que fue creada la primera herramienta de esta lista.
1. Bright Data CLI: acceso web real desde dentro del sandbox
La Bright Data CLI pone una pila completa de datos web detrás de un solo binario. Un único brightdata login autentica la herramienta y aprovisiona las zonas proxy que necesita. Después de eso, el scraping, la búsqueda, la extracción estructurada y el control del navegador funcionan sin más configuración. Es la única herramienta aquí que cambia lo que Codex puede hacer. Las demás solo cambian la velocidad con la que trabaja. El comando es brightdata, con bdata disponible como alias abreviado.
npm install -g @brightdata/cli      # o ejecútalo sin instalación:
npx -p @brightdata/cli brightdata --version
brightdata login                    # OAuth en el navegador, o --device en un servidor sin pantalla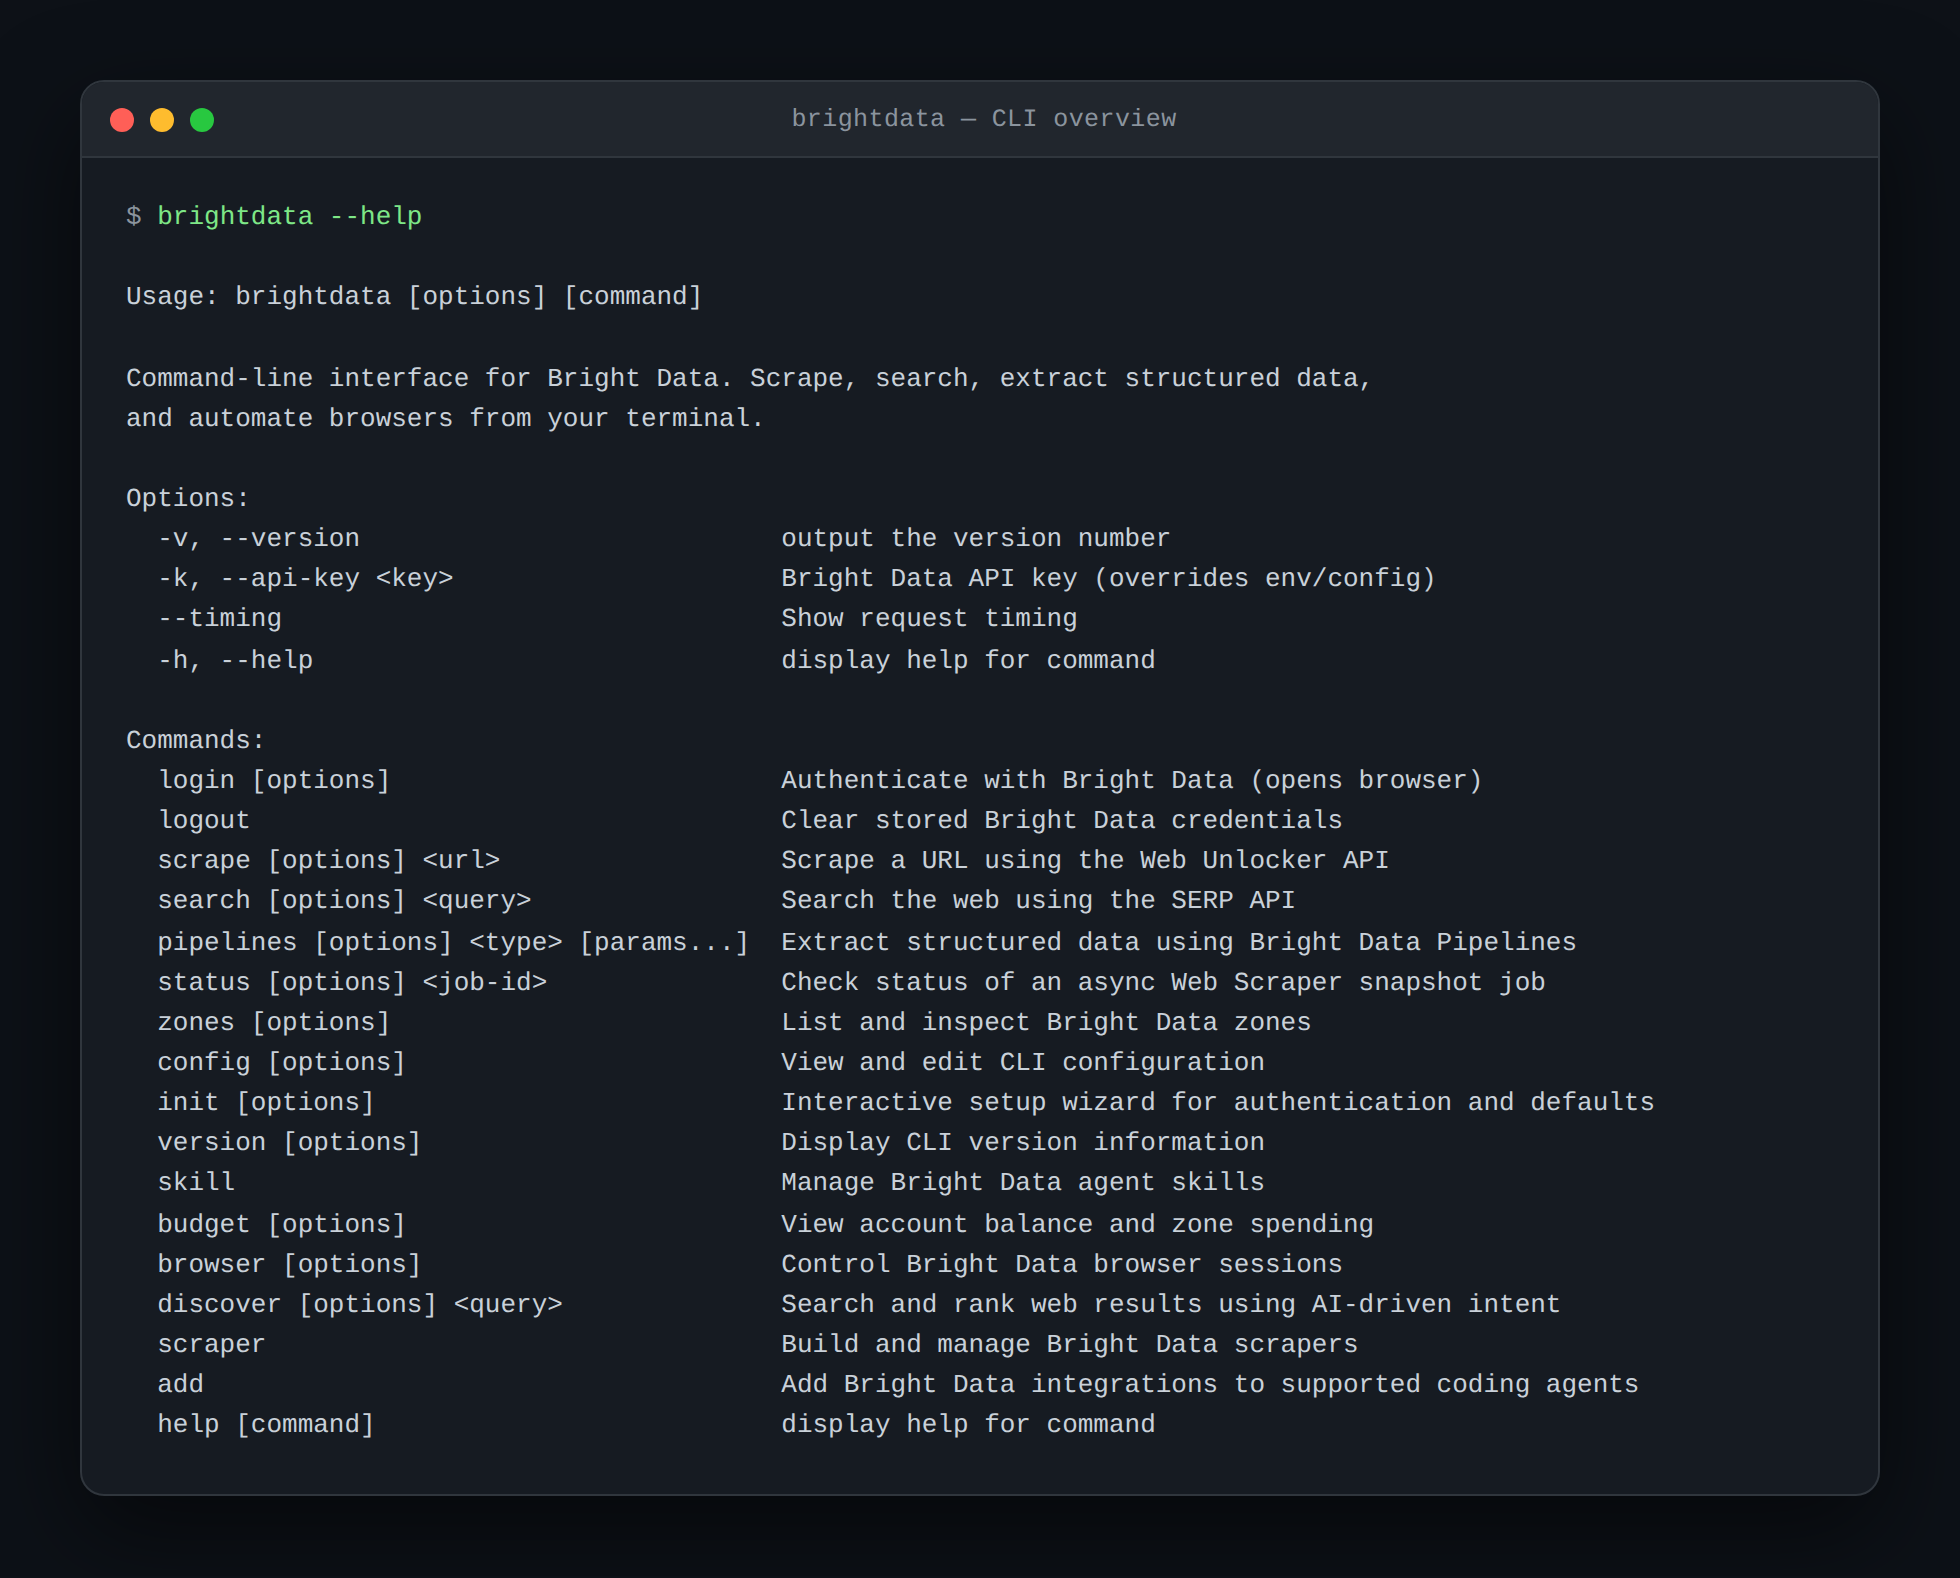
Scraping de cualquier cosa, incluidas páginas protegidas. brightdata scrape se ejecuta a través de Web Unlocker, que maneja CAPTCHAs mediante su solución de resolución de CAPTCHA, renderizado de JavaScript y sistemas anti-bot automáticamente. La salida puede ser markdown, HTML, JSON o una captura de pantalla. Las solicitudes pueden ser geoorientadas por país o enviadas con un agente de usuario móvil. Eso importa cuando una página difiere según la región.
brightdata scrape https://example.com                          # markdown limpio
brightdata scrape https://example.com --country de --mobile    # orientación geográfica y de dispositivo
brightdata scrape https://example.com -f json --pretty -o page.json
Búsqueda sin el límite del índice en caché. brightdata search consulta Google, Bing o Yandex a través de la API SERP. Google devuelve JSON estructurado con resultados orgánicos, anuncios y Personas también preguntan. Los resultados pueden ser localizados por país e idioma, lo que la búsqueda integrada no puede hacer. Canaliza la salida directamente a jq y el agente obtiene una lista limpia de enlaces para trabajar.
brightdata search "typescript best practices" --json | jq -r '.organic[].link'
brightdata search "restaurants berlin" --country de --language de
brightdata search "AI regulation" --type news
Omite el parseo completamente para plataformas conocidas. brightdata pipelines devuelve registros estructurados a través de más de cuarenta extractores listos para usar, mediante la API Web Scraper. Productos de Amazon, perfiles de LinkedIn, comentarios de YouTube, listados de Zillow y archivos de repositorios de GitHub tienen un extractor mantenido. El agente solicita un tipo de registro y una URL, y recibe JSON de vuelta. Sin selectores que escribir, y nada que corregir cuando el sitio rediseña.
brightdata pipelines list                                          # ver cada tipo
brightdata pipelines amazon_product "https://amazon.com/dp/B09V3KXJPB" --pretty
brightdata pipelines youtube_comments "https://youtube.com/watch?v=..." 50 --format csv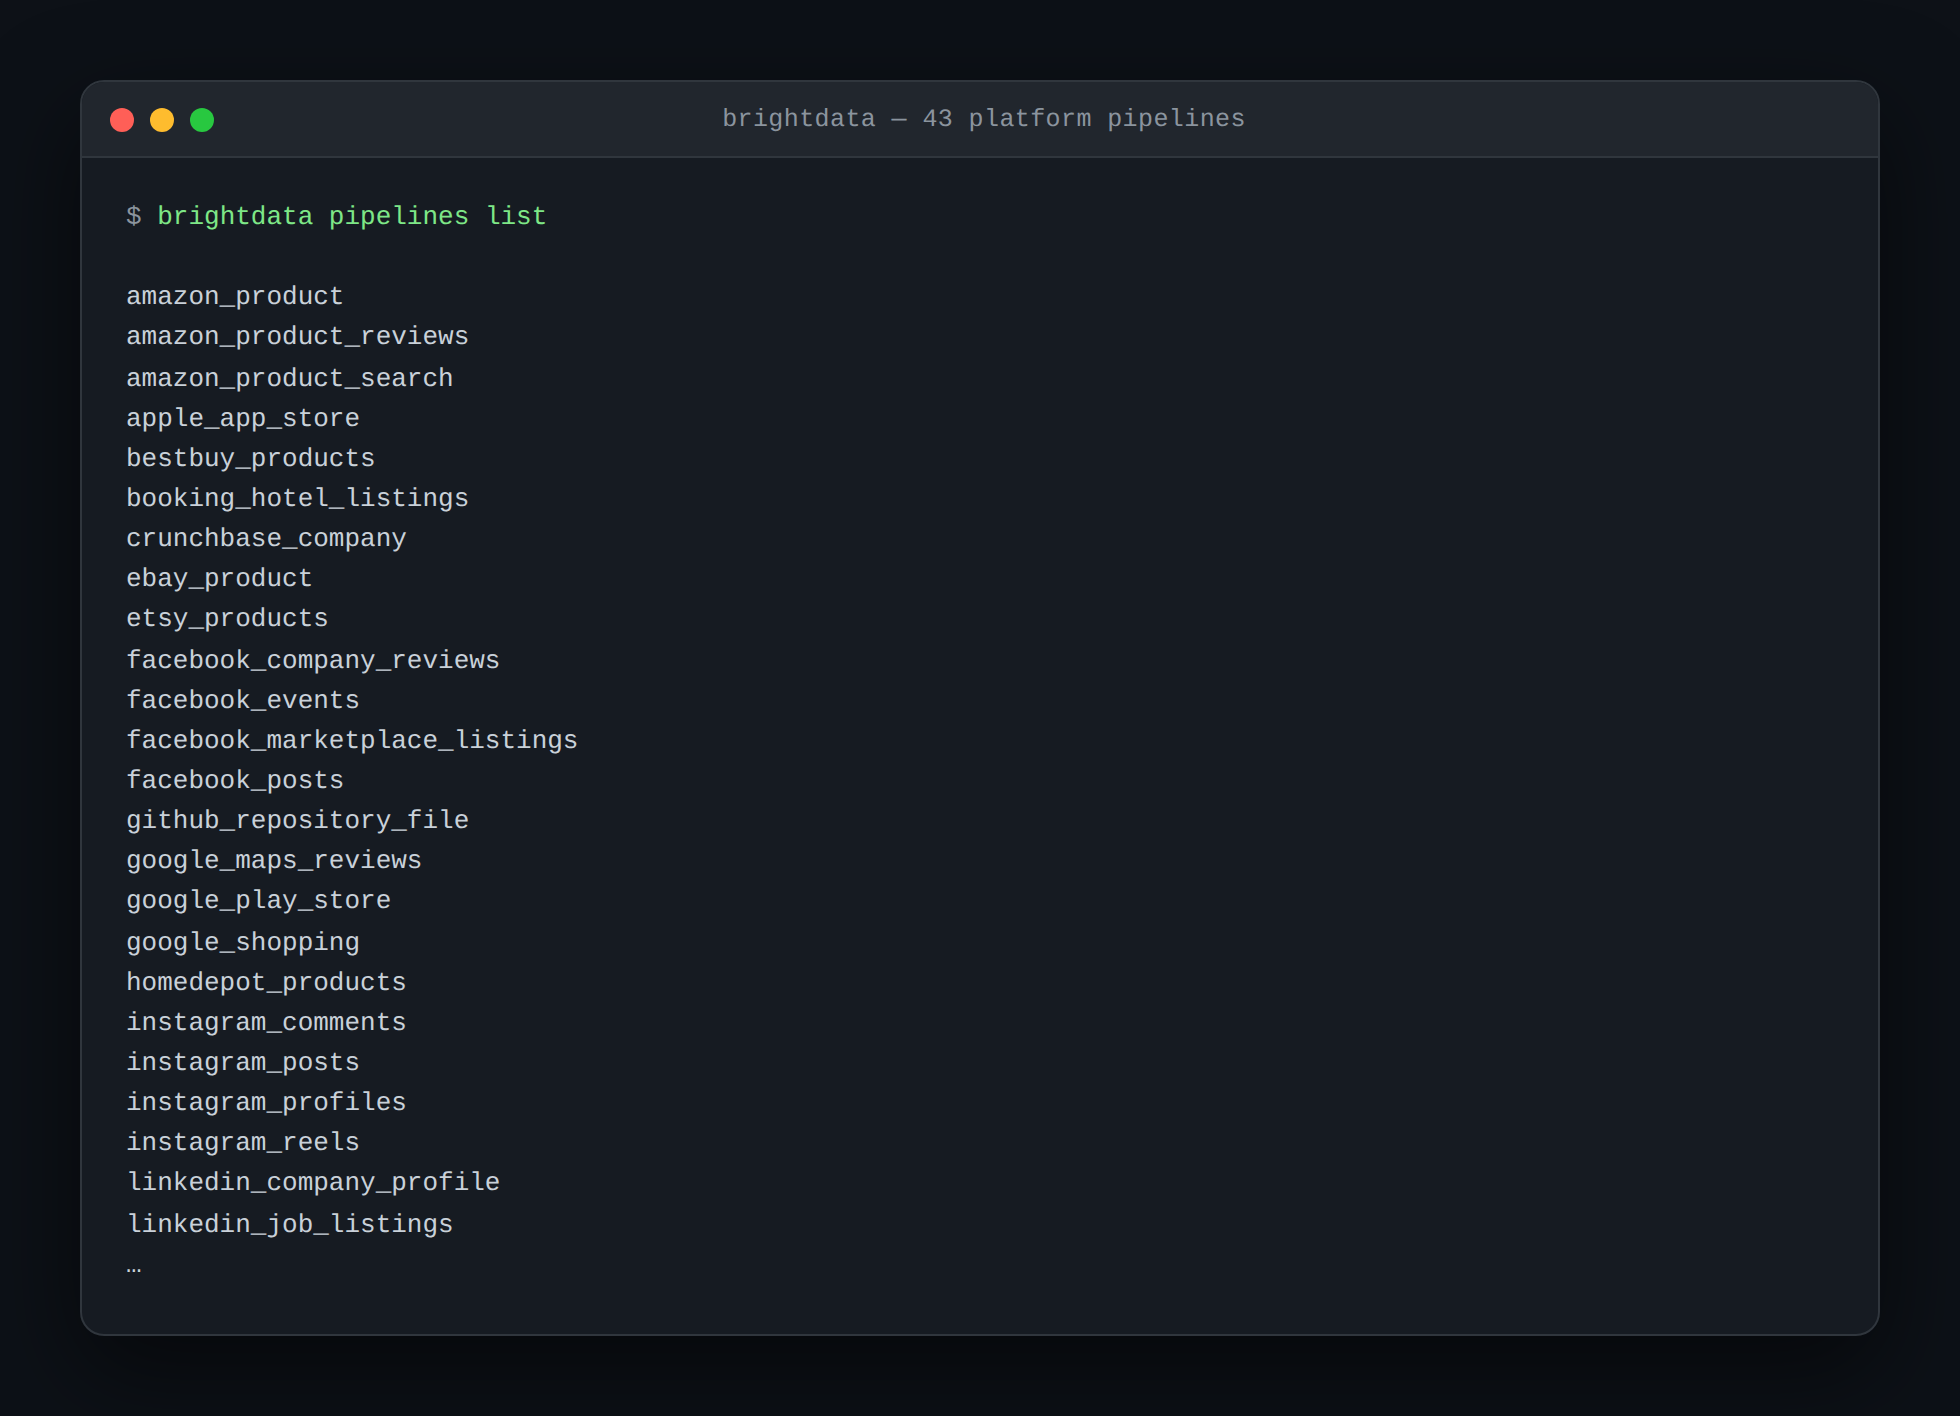
Controla un navegador real cuando una página necesita clics. Los subcomandos brightdata browser abren una sesión de navegador en la nube a través de la API del Navegador, luego navegan, hacen clic, escriben y toman capturas de pantalla. Las sesiones tienen nombre, por lo que el agente puede mantener una abierta durante varios turnos. Esto cubre los flujos que ninguna solicitud única puede alcanzar, como formularios de varios pasos.
Hacerlo funcionar dentro del sandbox. Esta es la parte específica de Codex. La CLI necesita acceso de red saliente, que el sandbox predeterminado deniega. Actívalo, luego usa la función de proxy de red para mantener ese acceso limitado. El proxy aplica tus reglas de dominio, y agregar reglas por sí solo no lo inicia. El resultado es un agente que puede llegar a Bright Data y nada más.
# ~/.codex/config.toml
[sandbox_workspace_write]
network_access = true

[features.network_proxy]
enabled = true
domains = { "**.brightdata.com" = "allow" }
La CLI también instala el servidor Bright Data MCP en Codex si prefieres llamadas de herramientas a comandos de shell. Ten en cuenta el alcance. Para Codex, la entrada se escribe en ~/.codex/config.toml bajo una tabla [mcp_servers], y también puedes limitar un servidor a un proyecto con .codex/config.toml en un proyecto de confianza.
brightdata add mcp --agent codex --globalEl precio comienza con un nivel gratuito de 5.000 créditos por mes, sin necesidad de tarjeta de crédito. Esos créditos son un grupo compartido único entre Web Unlocker, API SERP, API Web Scraper y Scraper Studio. Un crédito es una solicitud o un registro en los tres primeros. Los créditos se reinician el primero de cada mes y no se acumulan. Eso es suficiente para evaluar la herramienta correctamente en objetivos reales antes de gastar nada.
2. ripgrep: la búsqueda que Codex ya solicita
ripgrep es la herramienta menos opcional de esta lista, porque Codex ya está escrito para esperarla. La instrucción está integrada en el prompt central del agente. Ese prompt le dice que prefiera rg y rg --files sobre grep. La búsqueda es la acción más frecuente en un bucle de agente, y una única prefix_rule para rg la mantiene funcionando sin un prompt. Este único binario separa una sesión rápida de una lenta.
Respeta .gitignore por defecto y omite los binarios. También busca en un repositorio grande en una fracción del tiempo que necesita grep. Menos coincidencias desperdiciadas significa menos tokens gastados en leerlas.
rg -n "TODO" src/                      # números de línea, consciente de gitignore
rg --files -g '!dist'                   # listar archivos candidatos, sin la salida de compilación
rg -n --json "createUser" | head -20    # coincidencias estructuradas cuando necesitas parsear
Vale la pena conocer una advertencia. Las reglas coinciden en un prefijo de comando, no en indicadores, por lo que una regla que permite rg lo permite con cualquier argumento. Si deseas una regla más estricta, haz que el propio prefijo sea más específico en lugar de esperar que Codex inspeccione las opciones por ti. Usa codex execpolicy check para confirmar lo que una regla realmente decide antes de confiar en ella.
3. fd: encontrar archivos sin escribir la sintaxis de find
fd es el complemento de ripgrep y cubre la otra mitad de la pregunta. ripgrep encuentra texto dentro de los archivos, y fd encuentra los archivos en sí. Es rápido, respeta .gitignore y toma un patrón simple en lugar de la sopa de predicados que find espera. Ese último punto importa para un agente. Las invocaciones de find escritas a mano son una fuente común de resultados silenciosamente incorrectos. Un predicado mal colocado cambia el significado de toda la expresión.
fd -e ts UserProfile                # cada archivo TypeScript que coincida con el nombre
fd -H -t f '\.env'                  # incluir archivos ocultos, solo archivos
fd -e py -x wc -l                   # ejecutar un comando por resultado
Ten en cuenta que fd solicitará permiso la primera vez, como cualquier comando para el que Codex no tiene regla. Agrega una regla una vez, como se muestra al final de esta guía, y la fricción desaparece para siempre.
4. ast-grep: refactorización por sintaxis en lugar de regex
Las refactorizaciones con regex son donde los agentes hacen daño silenciosamente. Un patrón que parece seguro coincide con un comentario, un literal de cadena y un símbolo con nombre similar en una dependencia del proveedor. ast-grep analiza el archivo y coincide con el árbol de sintaxis en su lugar. Un patrón para una llamada de función entonces coincide solo con llamadas reales. Los patrones se escriben en el lenguaje que estás buscando, lo que significa que el agente no tiene que escapar nada. También se ejecuta sin un servidor de lenguaje, por lo que no hay costo de inicio y nada que configurar por proyecto.
ast-grep --lang ts -p 'useEffect($$$)'                    # encontrar cada llamada
ast-grep --lang py -p 'except: $$$'                       # encontrar excepts desnudos
ast-grep --lang ts -p 'foo($A)' -r 'bar($A)' --json       # reescribir, legible por máquina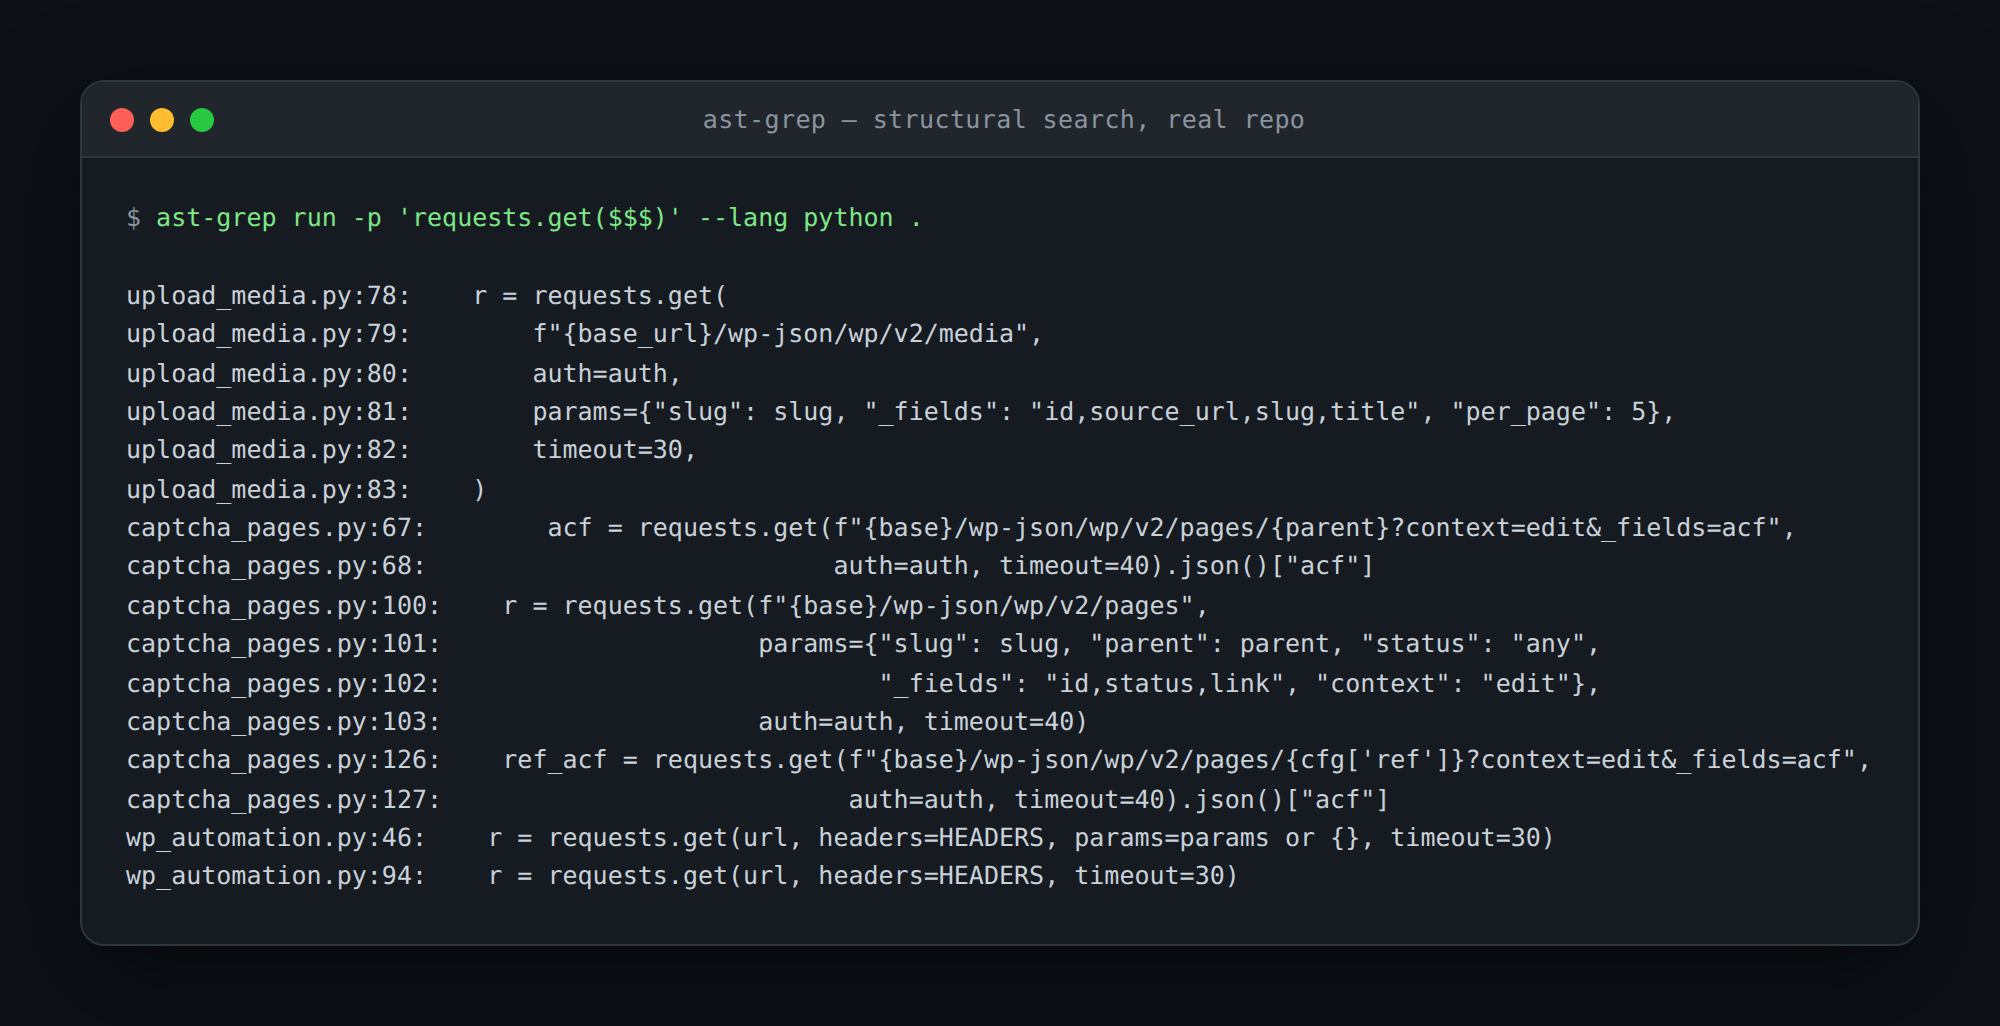
El proyecto documenta cómo lograr que un agente lo use. El enfoque recomendado es una línea en AGENTS.md. Dile al agente que ast-grep está instalado. Luego indica que las búsquedas estructurales deben usar por defecto ast-grep --lang [language] -p '<pattern>'. Sin ese empujón, la mayoría de los modelos recurren a regex por costumbre.
5. jq: manteniendo el JSON fuera de la ventana de contexto
jq gana su lugar en cualquier toolchain de agente, y en Codex lo gana dos veces. La primera razón es la ordinaria. Las respuestas de API, los archivos de bloqueo y la salida de CI son grandes, y el agente generalmente necesita tres campos de doscientos. Filtrarlos antes de que lleguen a la ventana de contexto mantiene las sesiones económicas y mantiene la atención del modelo en la tarea.
La segunda razón es que Codex habla JSON por sí mismo. Ejecutar codex exec --json convierte stdout en un flujo de JSON Lines. Cada evento llega allí, incluidas ejecuciones de comandos, cambios de archivos, llamadas MCP y búsquedas web. La propia documentación de OpenAI canaliza ese flujo directamente a jq. Si scripteas Codex en absoluto, esta combinación es cómo lees los resultados.
# extraer solo el mensaje final del agente de una ejecución no interactiva
codex exec --json "summarize the repo structure" \
  | jq -r 'select(.type=="item.completed") | .item | select(.type=="agent_message") | .text'

# filtrar una respuesta de API grande a lo que importa
cat response.json | jq '{id, status, items: [.items[] | .name]}'
6. gh: la mitad de GitHub del trabajo
Una gran parte del trabajo real no está en el editor en absoluto. Es leer un registro de CI fallido, o verificar lo que pidió un revisor. Luego es abrir el pull request. La GitHub CLI le da a Codex todo eso a través de un binario autenticado, con --json en los comandos que importan. Sin ella, el agente adivina el estado del repositorio a partir del historial local de git. Esa suposición se rompe una vez que el remoto avanza.
gh pr list --json number,title,headRefName
gh run view --log-failed                    # leer exactamente por qué falló CI
gh api repos/{owner}/{repo}/issues --paginate | jq -r '.[].title'
Este es el caso más claro de una herramienta que necesita la red, así que espera prompts de aprobación hasta que la configures. La documentación de reglas de OpenAI usa gh pr view como su ejemplo trabajado, lo que te dice cuán común es la fricción. Decide por prefijo qué llamadas quieres silenciosas y cuáles deben siempre preguntar. La lectura generalmente es segura de permitir, y cualquier cosa que escriba vale un prompt.
7. uv: Python sin la espera
Las herramientas de Python son lentas de una manera que se agrava dentro de un bucle de agente. Cada instalación, creación de entorno y resolución de dependencias es tiempo muerto. El agente hace las tres cosas con mucha más frecuencia que un humano. uv colapsa esos pasos a algo cercano al instante. También ejecuta un script con sus dependencias sin crear un proyecto. Esa es la forma de la mayoría de las tareas de agente únicas.
uv run --with httpx script.py       # entorno efímero, sin necesidad de proyecto
uv sync --frozen                    # instalar exactamente lo que fija el lockfile
uv add ruff && uv run ruff check .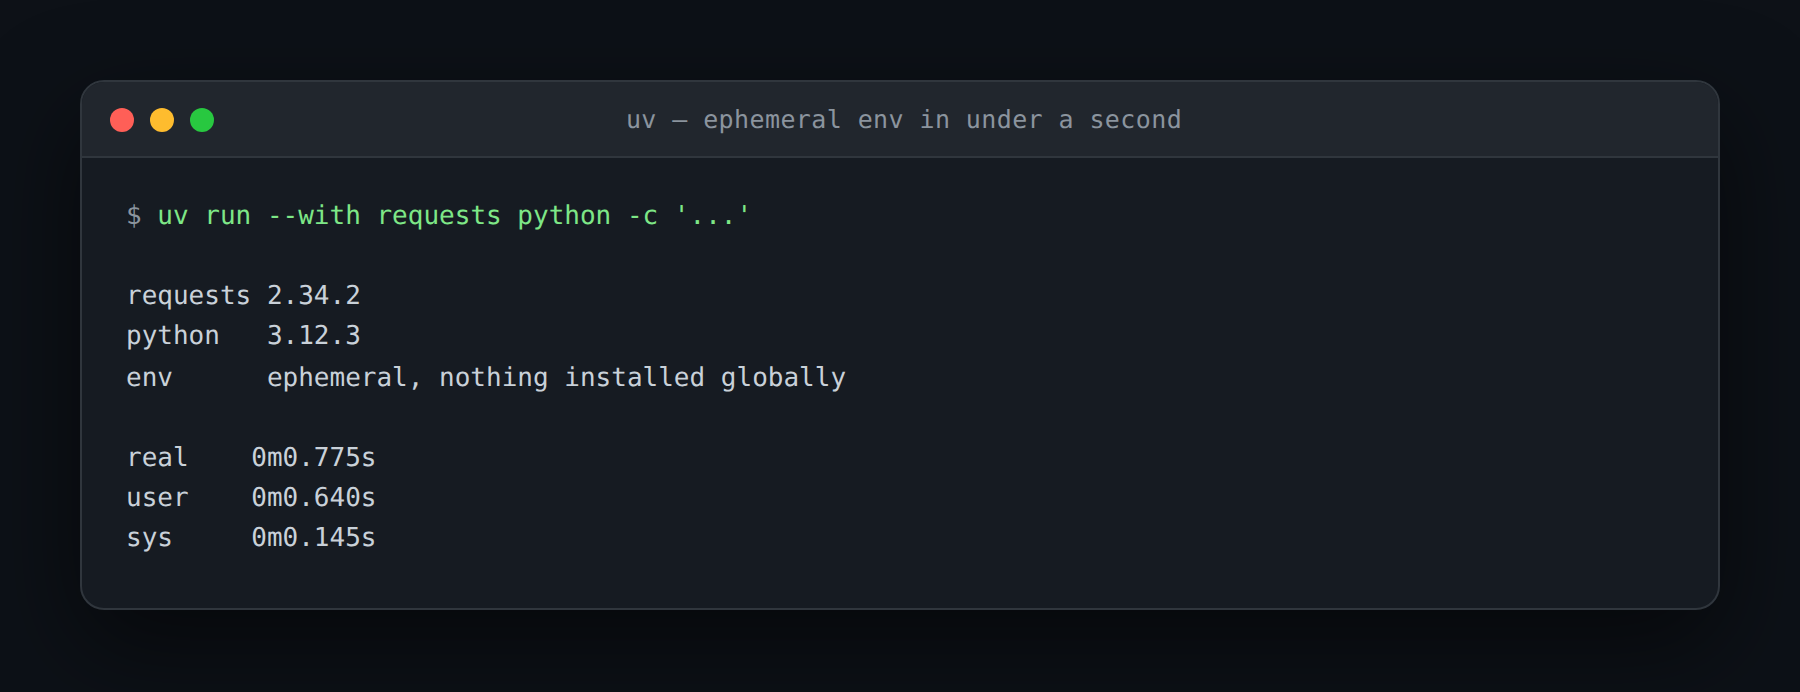
El hábito del lockfile importa más en Codex que en otros lugares. uv sync --frozen se niega a actualizar el lockfile, por lo que el agente instala las versiones exactas que fijaste. Eso detiene un paso de resolución de convertirse en una solicitud de red. También detiene que una actualización de dependencia se cuele bajo una tarea no relacionada.
8. mise: toolchains que sobreviven a una fase de agente sin conexión
mise es la entrada que existe por cómo se ejecuta Codex, en lugar de a pesar de ello. Fija tiempos de ejecución de lenguajes y herramientas CLI por proyecto en un archivo mise.toml, luego los instala todos con un comando. Node, Python, Go, Ruby y Rust están integrados. Cualquier cosa en npm, PyPI o versiones de GitHub se fija de la misma manera. Un archivo describe todo el entorno, y el agente puede recrearlo sin que se le indiquen las versiones.
mise use --global node@26 [email protected]    # fijar e instalar
mise install                             # instalar todo lo que fija mise.toml
mise exec -- npm test                    # ejecutar con el toolchain fijado en PATH
El beneficio aparece en la nube. Un entorno de nube de Codex puede acceder a la red durante su fase de configuración, luego ejecuta la fase del agente sin conexión por defecto. Por lo tanto, todo lo que el agente necesita debe existir antes de ese cambio. Poner mise install en el script de configuración significa que cada herramienta fijada ya está en disco cuando desaparece la red. La misma lógica aplica localmente, donde un tiempo de ejecución faltante de otro modo se convierte en un prompt de aprobación a mitad de una tarea.
9. gitleaks: la barrera antes del commit
Los agentes escriben código rápido, y a veces ese código contiene una clave. Podría ser un token pegado en un fixture de prueba. Podría ser una cadena de conexión en un archivo de configuración generado. gitleaks escanea el árbol de trabajo o el historial de git contra un gran conjunto de reglas y sale con un valor distinto de cero cuando encuentra algo. Ese código de salida es la parte importante, porque es la señal en la que Codex realmente actúa.
gitleaks dir . -v --redact                                  # escanear el árbol de trabajo
gitleaks git --report-format json --report-path leaks.json  # escanear historial, legible por máquina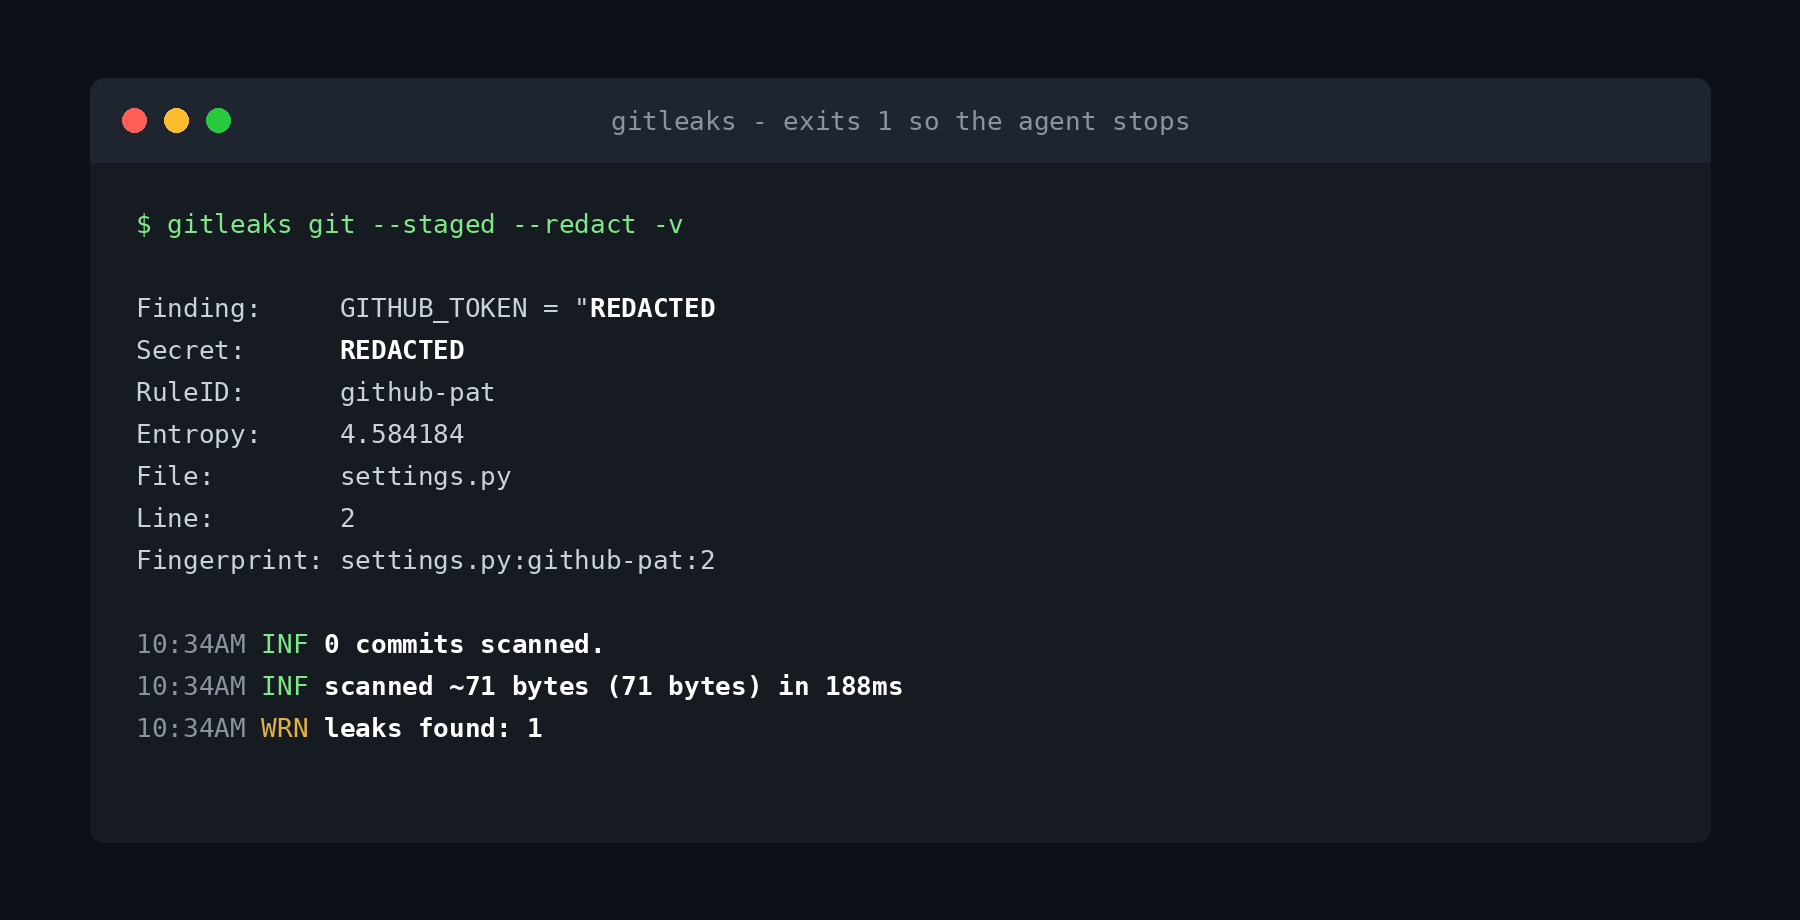
Conéctalo a un hook de pre-commit y la barrera se vuelve automática. El agente itera hasta que el hook pasa. Eso es más limpio que intentar bloquear la escritura en primer lugar. Una advertencia sobre el mantenimiento. El proyecto ahora se llama a sí mismo completo en funcionalidades, con versiones futuras limitadas a parches de seguridad. El autor se ha mudado a un sucesor llamado Betterleaks. Las reglas y el binario siguen funcionando bien. Instálalo hoy, y mantén un ojo en dónde aterriza el ecosistema.
10. Firecrawl CLI: la otra CLI web que vale la pena conocer
Firecrawl es el competidor más cercano a la primera herramienta de esta lista, y es genuinamente bueno. Su CLI cubre scrape, crawl, map y search, además de un comando agent para extracción impulsada por IA. Dos características destacan y no tienen equivalente en Bright Data hoy. firecrawl developer busca en un índice curado de issues de GitHub, pull requests fusionados, READMEs y sitios de documentación. Eso se adapta mejor a la pregunta más común de un agente de codificación que la búsqueda web general. firecrawl monitor programa scrapes recurrentes y compara cada resultado con la última instantánea.
npm install -g firecrawl-cli
firecrawl init --agent codex                        # instala sus habilidades en Codex
firecrawl developer "tokio select cancellation safety"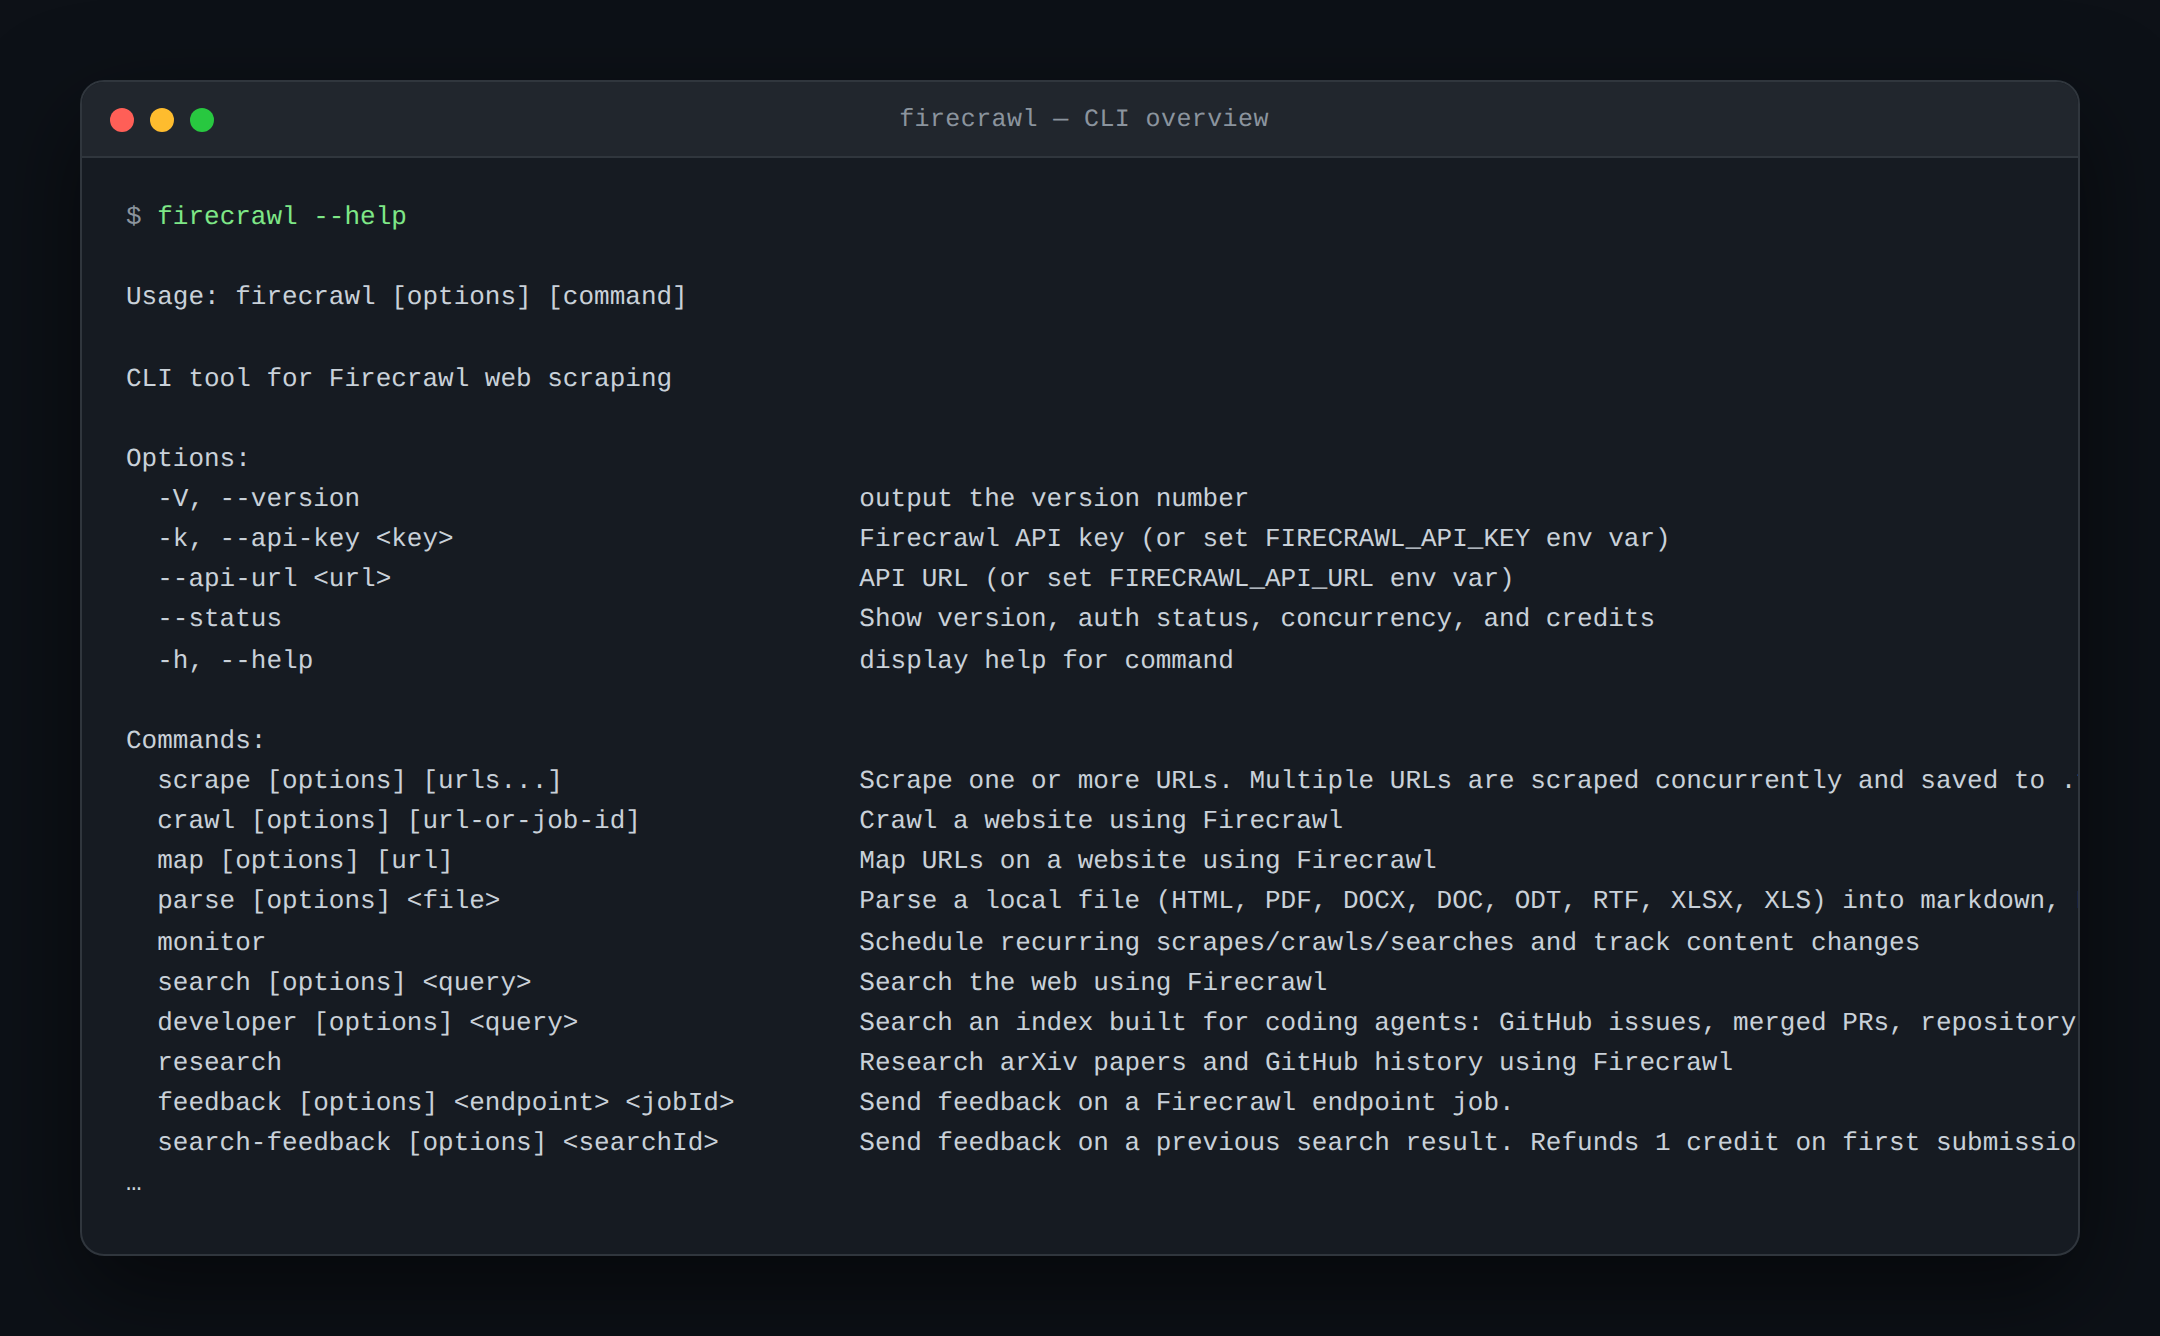
Donde los dos divergen es en la profundidad de adquisición. Firecrawl está ajustado para el bucle de investigación de un agente de codificación, y Bright Data está ajustado para la recolección de datos en producción. Los registros pre-analizados de Amazon o LinkedIn solo existen en el lado de Bright Data. También lo hacen las zonas proxy por solicitud, y los scrapers que sobreviven a un rediseño del sitio. Muchos equipos ejecutan ambos. Usan Firecrawl para investigación de desarrolladores, y Bright Data para cualquier cosa que deba mantenerse a volumen.
Qué no instalar: herramientas que tu agente no puede manejar
El conjunto de herramientas de Codex más compartido recomienda fzf, bat, eza, zoxide y git-delta junto a las herramientas anteriores. Cada una de ellas es excelente, y ninguna es para el agente. fzf es un selector difuso interactivo que espera un teclado. bat agrega colores de sintaxis y paginación a la salida que el modelo lee como texto plano. eza y zoxide mejoran cómo navegas un shell que Codex navega por ruta absoluta. git-delta renderiza diffs hermosamente para ojos humanos, y el agente recibe el mismo diff de cualquier manera.
El mismo razonamiento descarta lazygit y btop, que dibujan interfaces de pantalla completa que un agente no puede navegar en absoluto. También descarta cualquier cosa que solicite confirmación sin un indicador --yes. Lo mismo aplica para herramientas que paginan su propia salida.
La distinción no es que los TUIs sean malos. Es que la interfaz del agente es stdin, stdout y un código de salida. Si el valor de una herramienta está en su renderizado, es una herramienta para ti. Si su valor está en su salida, es una herramienta para el agente. Instala las interactivas para ti mismo. Luego asegúrate de que Codex tenga un equivalente no interactivo, como git log --oneline junto a lazygit.
Informar a Codex de que las herramientas existen
Instalar una herramienta no significa que el agente la usará. Codex trabaja a partir de lo que puede inferir sobre el entorno. Un binario no anunciado a menudo queda sin usar mientras el agente escribe a mano una alternativa peor. Solucionar eso requiere dos cosas. Dile que las herramientas están ahí, luego asegúrate de que usarlas no solicite permiso cada vez.
Lo primero es una sección corta en AGENTS.md en la raíz del repositorio. Mantenla factual y breve, porque se carga en cada sesión. Di qué herramienta preferir para qué trabajo, no cómo funciona cada una.
## Herramientas CLI disponibles
- `brightdata`: acceso web. Usar para cualquier URL que la búsqueda web no pueda obtener, y para SERP.
- `rg` / `fd`: buscar texto y encontrar archivos. Preferir sobre grep y find.
- `ast-grep`: búsqueda estructural y refactorización. Preferir sobre regex para ediciones de código.
- `uv`: Python. Usar `uv run` y `uv sync --frozen`, nunca pip directamente.
Lo segundo es un archivo de reglas, que es cómo Codex decide qué puede ejecutarse fuera del sandbox sin preguntar. Las reglas viven en un archivo .rules bajo una carpeta rules/ junto a una capa de configuración activa, generalmente ~/.codex/rules/default.rules. Cada prefix_rule() coincide con un prefijo de comando y devuelve allow, prompt o forbidden. La regla de coincidencia más estricta gana, y Codex valida los ejemplos en línea cuando carga el archivo.
# ~/.codex/rules/default.rules
prefix_rule(
    pattern = ["brightdata", ["scrape", "search", "pipelines"]],
    decision = "allow",
    justification = "Acceso web de solo lectura a través de Bright Data",
    match = ["brightdata scrape https://example.com", "brightdata search 'rust async'"],
)

prefix_rule(
    pattern = ["gh", "pr", ["view", "list"]],
    decision = "allow",
    justification = "Leer pull requests es seguro; las escrituras aún solicitan permiso",
)
Reinicia Codex después de editar el archivo, luego verifica tu trabajo antes de confiar en él. codex execpolicy check reporta la decisión más estricta para un comando dado y nombra las reglas que coincidieron. Ejecútalo una vez por cada regla que agregues. Un prefijo más amplio de lo previsto es fácil de escribir y difícil de notar.
codex execpolicy check --pretty \
  --rules ~/.codex/rules/default.rules \
  -- brightdata scrape https://example.com
Preguntas frecuentes
¿Necesito servidores MCP si tengo estas herramientas CLI para Codex?
A menudo no. Los esquemas de herramientas de un servidor MCP están en la ventana de contexto durante toda la sesión. Una CLI invocada a través del shell no cuesta nada hasta que se ejecuta. Para una herramienta con una gran superficie de comandos, una CLI más una línea en AGENTS.md suele ser la opción más económica. MCP aún gana cuando quieres llamadas de herramientas tipadas o cuando el servicio no tiene CLI en absoluto.
¿Por qué una herramienta de pago está clasificada primera en una lista de herramientas CLI para Codex?
Porque es la única entrada que agrega una capacidad que Codex no tiene. Todo lo demás hace que una capacidad existente sea más rápida. El sandbox desactiva el acceso a la red por defecto. La búsqueda integrada responde desde un índice en caché en lugar de obtener páginas en vivo. Llegar a sitios protegidos por bots necesita infraestructura proxy, que ninguna herramienta gratuita proporciona. El nivel gratuito es de 5.000 créditos por mes sin tarjeta requerida.
¿Instalar estas herramientas CLI hará que Codex sea más lento?
No. Nada aquí se carga al inicio. Cada herramienta se invoca solo cuando el agente la ejecuta. La mayoría existen específicamente para reducir el número de turnos que necesita una tarea.
¿Cuál es el conjunto mínimo útil de herramientas CLI para Codex?
ripgrep, gh y jq si solo quieres tres. ripgrep ya es asumido por el propio prompt del agente, y jq es cómo lees codex exec --json. Agrega la Bright Data CLI la primera vez que una tarea se detenga porque Codex no puede obtener una página.
¿Cómo detengo que Codex pida aprobación cada vez que ejecuta una nueva herramienta?
Agrega una entrada prefix_rule() a un archivo .rules bajo ~/.codex/rules/. Establece la decisión en allow para los prefijos de comando en los que confías. Verifícalo con codex execpolicy check antes de confiar en él. Para herramientas que necesitan la red, también establece network_access bajo sandbox_workspace_write, y limita el tráfico con una lista de dominios permitidos.
¿Estas herramientas CLI funcionan con Claude Code, Cursor y Gemini CLI?
Sí. Cada herramienta listada es un binario de línea de comandos estándar sin dependencia específica de Codex. Los instaladores de Bright Data y Firecrawl detectan varios agentes de codificación, por lo que la misma configuración se traslada entre entornos.