Si le pides a un agente de codificación que construya un rastreador de precios de la competencia, puedes tener código funcional en aproximadamente un minuto. Esa parte está casi resuelta para una tarea de esta forma. La siguiente parte es la que raramente se presupuesta. El rastreador funciona, la tabla se llena, y algunos de los números son silenciosamente incorrectos. Cuáles y cuántos depende de lo que pongas debajo del agente, y ejecutamos la tarea de ambas maneras.
No faltan. Están mal. Un precio que pertenece a un plan de protección. Una valoración tomada de otro minorista. Una fila que parece completa porque algo tenía que ir en la celda. Si eres desarrollador, ese es un error que encuentras semanas después, si es que lo encuentras. Si gestionas precios, merchandising o un feed de inteligencia de mercado, es una decisión que ya tomaste con datos incorrectos. Si estás construyendo un producto de IA sobre ello, es un número que tu modelo afirmará con total confianza.
La brecha no está en la codificación del agente. En los minoristas que defienden sus páginas, leer una significa lidiar con la gestión de bots de ese minorista, y más Python raramente es la solución.
Así que lo medimos. Una tarea de rastreador de precios, 41 páginas de productos de minoristas congeladas, 2 agentes de codificación, el mismo prompt y el mismo modelo, ejecutados con y sin una capa de datos web gestionada por debajo. Cada página, turno y valor incorrecto está publicado, junto con cada cifra de coste que reportaron las CLI, y un único comando en el repositorio rederiva los números principales a continuación y falla si el artículo se ha desviado de ellos.
Cursor CLI con el MCP de Bright Data leyó 40 de 41 páginas y obtuvo el 89% de los valores correctamente frente a una verdad fundamental que verificamos manualmente. La misma clase de agente sin capa de datos leyó 34 y obtuvo el 72%. En Best Buy, donde el brazo de Claude Code sin asistencia perdió la mayoría de sus páginas, leyó 9 de 9 frente a 4.
TL;DR
Ejecutamos una tarea de rastreador de precios a través de 2 agentes de codificación, con y sin una capa de datos web gestionada, y puntuamos cada valor manualmente.
- La precisión de campos alcanza el 89% con una capa de datos frente al 72% sin ella, en las mismas páginas y el mismo modelo.
- Una página fue rechazada en las 3 ejecuciones con capa de datos; las dos sin ella perdieron 5 páginas cada una.
- El precio es casi un empate. La valoración y la disponibilidad separan los brazos: 93% y 94% frente a 83% y 52%.
- El brazo de Cursor sin asistencia escribió 729 líneas de Python, y su User-Agent tenía 20 versiones de Chrome de antigüedad.
Qué ejecutamos y qué se mantuvo constante
Establecimos la tarea antes de cualquier ejecución: para una lista de SKU congelada en 5 minoristas, recopilar nombre del producto, precio, disponibilidad y valoración, agregar un feed de nuevos listados impulsado por búsqueda, y presentar el resultado en un pequeño panel. Usamos únicamente páginas públicas, nada detrás de un inicio de sesión.
La lista de SKU se congeló antes de la primera solicitud: 10 productos de electrónica de consumo en 5 minoristas, 41 páginas de productos en total, escritas en skus.json. Cada ejecución lee ese archivo, por lo que cada ejecución solicita objetivos idénticos.
Las 4 ejecuciones fueron no interactivas, y cada transcripción está guardada:
| Ejecución | Agente | Capa de datos | Rol |
|---|---|---|---|
| A | Cursor CLI (cursor-agent) |
MCP alojado de Bright Data | la configuración bajo prueba |
| B | Claude Code | ninguna | con qué se compara |
| Control | Cursor CLI, misma versión | ninguna | referencia, aísla la capa de datos |
| B+ | Claude Code | MCP alojado de Bright Data | referencia, aísla el agente |
Qué comparan A y B realmente
A frente a B es la comparación: un equipo que adopta Cursor con una capa de datos frente a uno que adopta un agente de codificación y escribe su propia obtención. Mantenido constante: las 41 URLs, los 4 campos, el texto del prompt, el modelo, el código de puntuación, la máquina y la tarde. El prompt nunca menciona Bright Data, Proxies ni proveedores de scraping.
Esa comparación mueve dos cosas a la vez, el agente y la capa de datos, que es por qué existen las dos referencias. El Control mantiene fijo el agente y elimina solo la capa de datos; B+ mantiene fijo el agente y la añade. Entre ellas, las dos referencias muestran qué variable produce el resultado, y esa variable no es el agente.
El único archivo que difiere
La única variable entre A y el Control es un archivo. El proyecto de la Ejecución A contiene un .cursor/mcp.json que nombra un servidor y lo apunta al endpoint MCP alojado de Bright Data. El archivo tiene menos de 10 líneas de JSON, y no instalamos ningún SDK ni biblioteca cliente. El proyecto del Control tiene el mismo archivo con un objeto mcpServers vacío. En su totalidad:
{ "mcpServers": { "brightdata": {
    "type": "http",
    "url": "https://mcp.brightdata.com/mcp?token=YOUR_BRIGHT_DATA_API_KEY" } } }
Claude Code recibió ese mismo archivo por ruta, con --strict-mcp-config para que nada más en la máquina pudiera conectarse. Ambos agentes se ejecutaron con una configuración byte a byte idéntica; solo difiere el nombre de archivo que cada agente busca.
El modelo y qué cuenta como recopilado
El modelo se mantiene constante. Las 4 ejecuciones estuvieron fijadas en Sonnet 5, claude-sonnet-5-high en el Cursor CLI y claude-sonnet-5 en Claude Code, el mismo modelo base bajo el nombre de dos proveedores. El alias de Cursor fija el esfuerzo de razonamiento en alto y el valor predeterminado de Claude Code es menor, que es la única configuración del modelo que difiere; la verificación con esfuerzo igualado más adelante controla esto.
Una página cuenta como recopilada solo cuando se pueden leer tanto el nombre del producto como el precio de lo que se devolvió. Un HTTP 200 que lleva un desafío de bot no es un éxito, ni tampoco un 200 que lleva una página de producto cuyo precio nunca se renderizó.
Con ese archivo en su lugar, el agente puede usar las herramientas sin que se le indique. Dada la tarea y sin mencionar ningún proveedor, el agente agrupó las URLs de los minoristas en una única llamada scrape_batch y solicitó aprobación antes de enviar esa llamada.
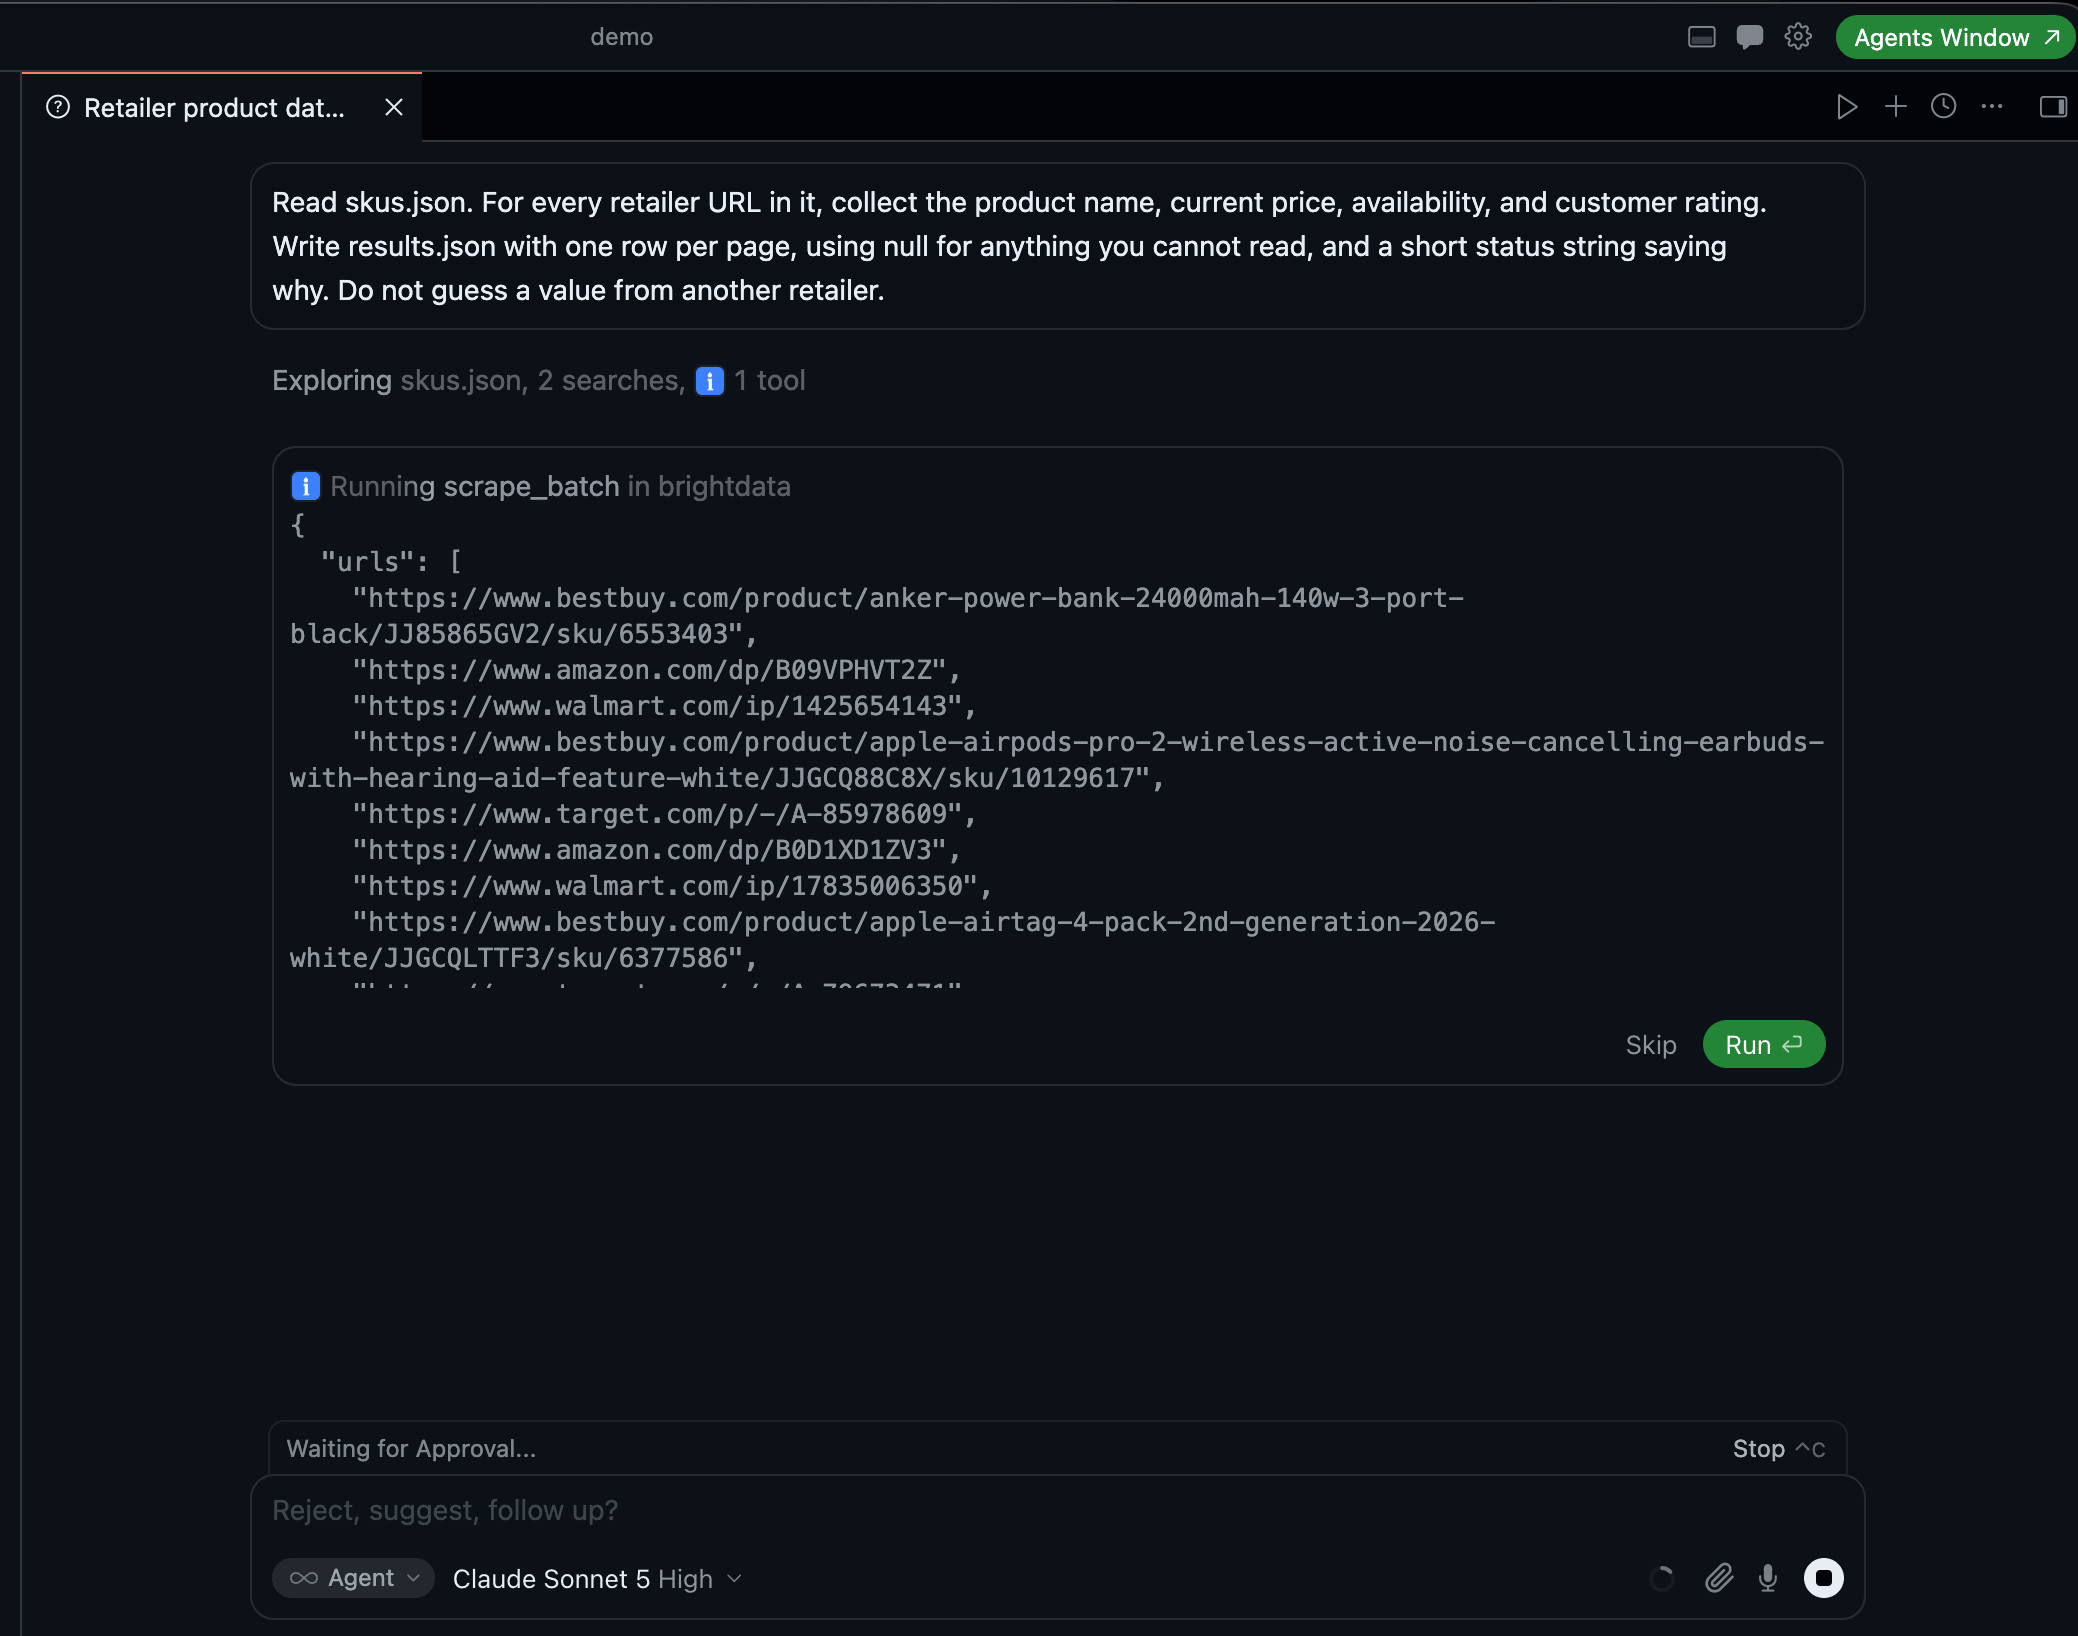
El recorrido en la lista real. El agente eligió scrape_batch, ensambló el conjunto de URLs él mismo, y Cursor lo retuvo en una puerta de aprobación antes de que nada saliera de la máquina.
Éxito de la tarea, la versión binaria
Las 4 ejecuciones produjeron results.json, new_listings.json, dashboard.html y un README, así que en la pregunta binaria de «¿funciona de principio a fin?» todas las ejecuciones pasan. Esa pregunta es la menos informativa que hicimos.
| Nombre + precio | Los 4 campos | Precisión de campos | |
|---|---|---|---|
| A. Cursor + Bright Data | 40 / 41 | 38 | 89% |
| B. Claude Code, sin capa de datos | 34 / 41 | 29 | 72% |
| B+. Claude Code + Bright Data | 34 / 41 | 34 | 78% |
| Control. Cursor, sin capa de datos | 28 / 41 | 28 | 74% |
La precisión se puntúa frente a una verdad fundamental adjudicada manualmente que cubre las 41 páginas, que describimos más adelante.
La verificación con esfuerzo igualado
Falta un brazo en esa tabla a propósito. Después de las 4 ejecuciones anteriores, volvimos a ejecutar B+ con el esfuerzo de razonamiento elevado a high, para igualar el nivel que ya usaba el brazo de Cursor. Leyó 35 de 41 con un 88%, frente a 34 y 78%. Ese único cambio importa: sin él, las 4 filas anteriores podrían leerse como un resultado de esfuerzo en lugar de un resultado de capa de datos.
| Con Bright Data | Sin ella | |
|---|---|---|
| Cursor | 89% | 74% |
| Claude Code, esfuerzo igualado | 88% | 72% |
Las brechas son de 15 y 16 puntos, en la misma dirección, de 2 agentes diferentes en el mismo modelo y el mismo esfuerzo. Ese par de filas separa un resultado de capa de datos de un resultado de agente, y es lo que permite leer el resto de estos números de esa manera.
La tabla admite 2 lecturas. La primera es el orden: ambos brazos con una capa de datos se clasifican por encima de ambos sin ella, tanto en las páginas que leyeron como en los valores que obtuvieron correctamente. La segunda es que el recuento de páginas leídas subestima la diferencia. A lee 40 frente a las 34 de B, una brecha de 6. En los valores dentro de esas páginas la brecha es de 17 puntos, 89% frente a 72%, porque una página que obtuviste mal sigue contando como una página. En un conjunto de páginas como este, un agente de codificación en un modelo actual escribe código de obtención competente y recopila la mayor parte del volumen. No llega al último tramo, y ese tramo contiene los minoristas difíciles y los campos difíciles.
Lo que muestran los paneles
Ambas ejecuciones construyeron el panel que pedía la tarea, que es la forma más rápida de ver la diferencia.
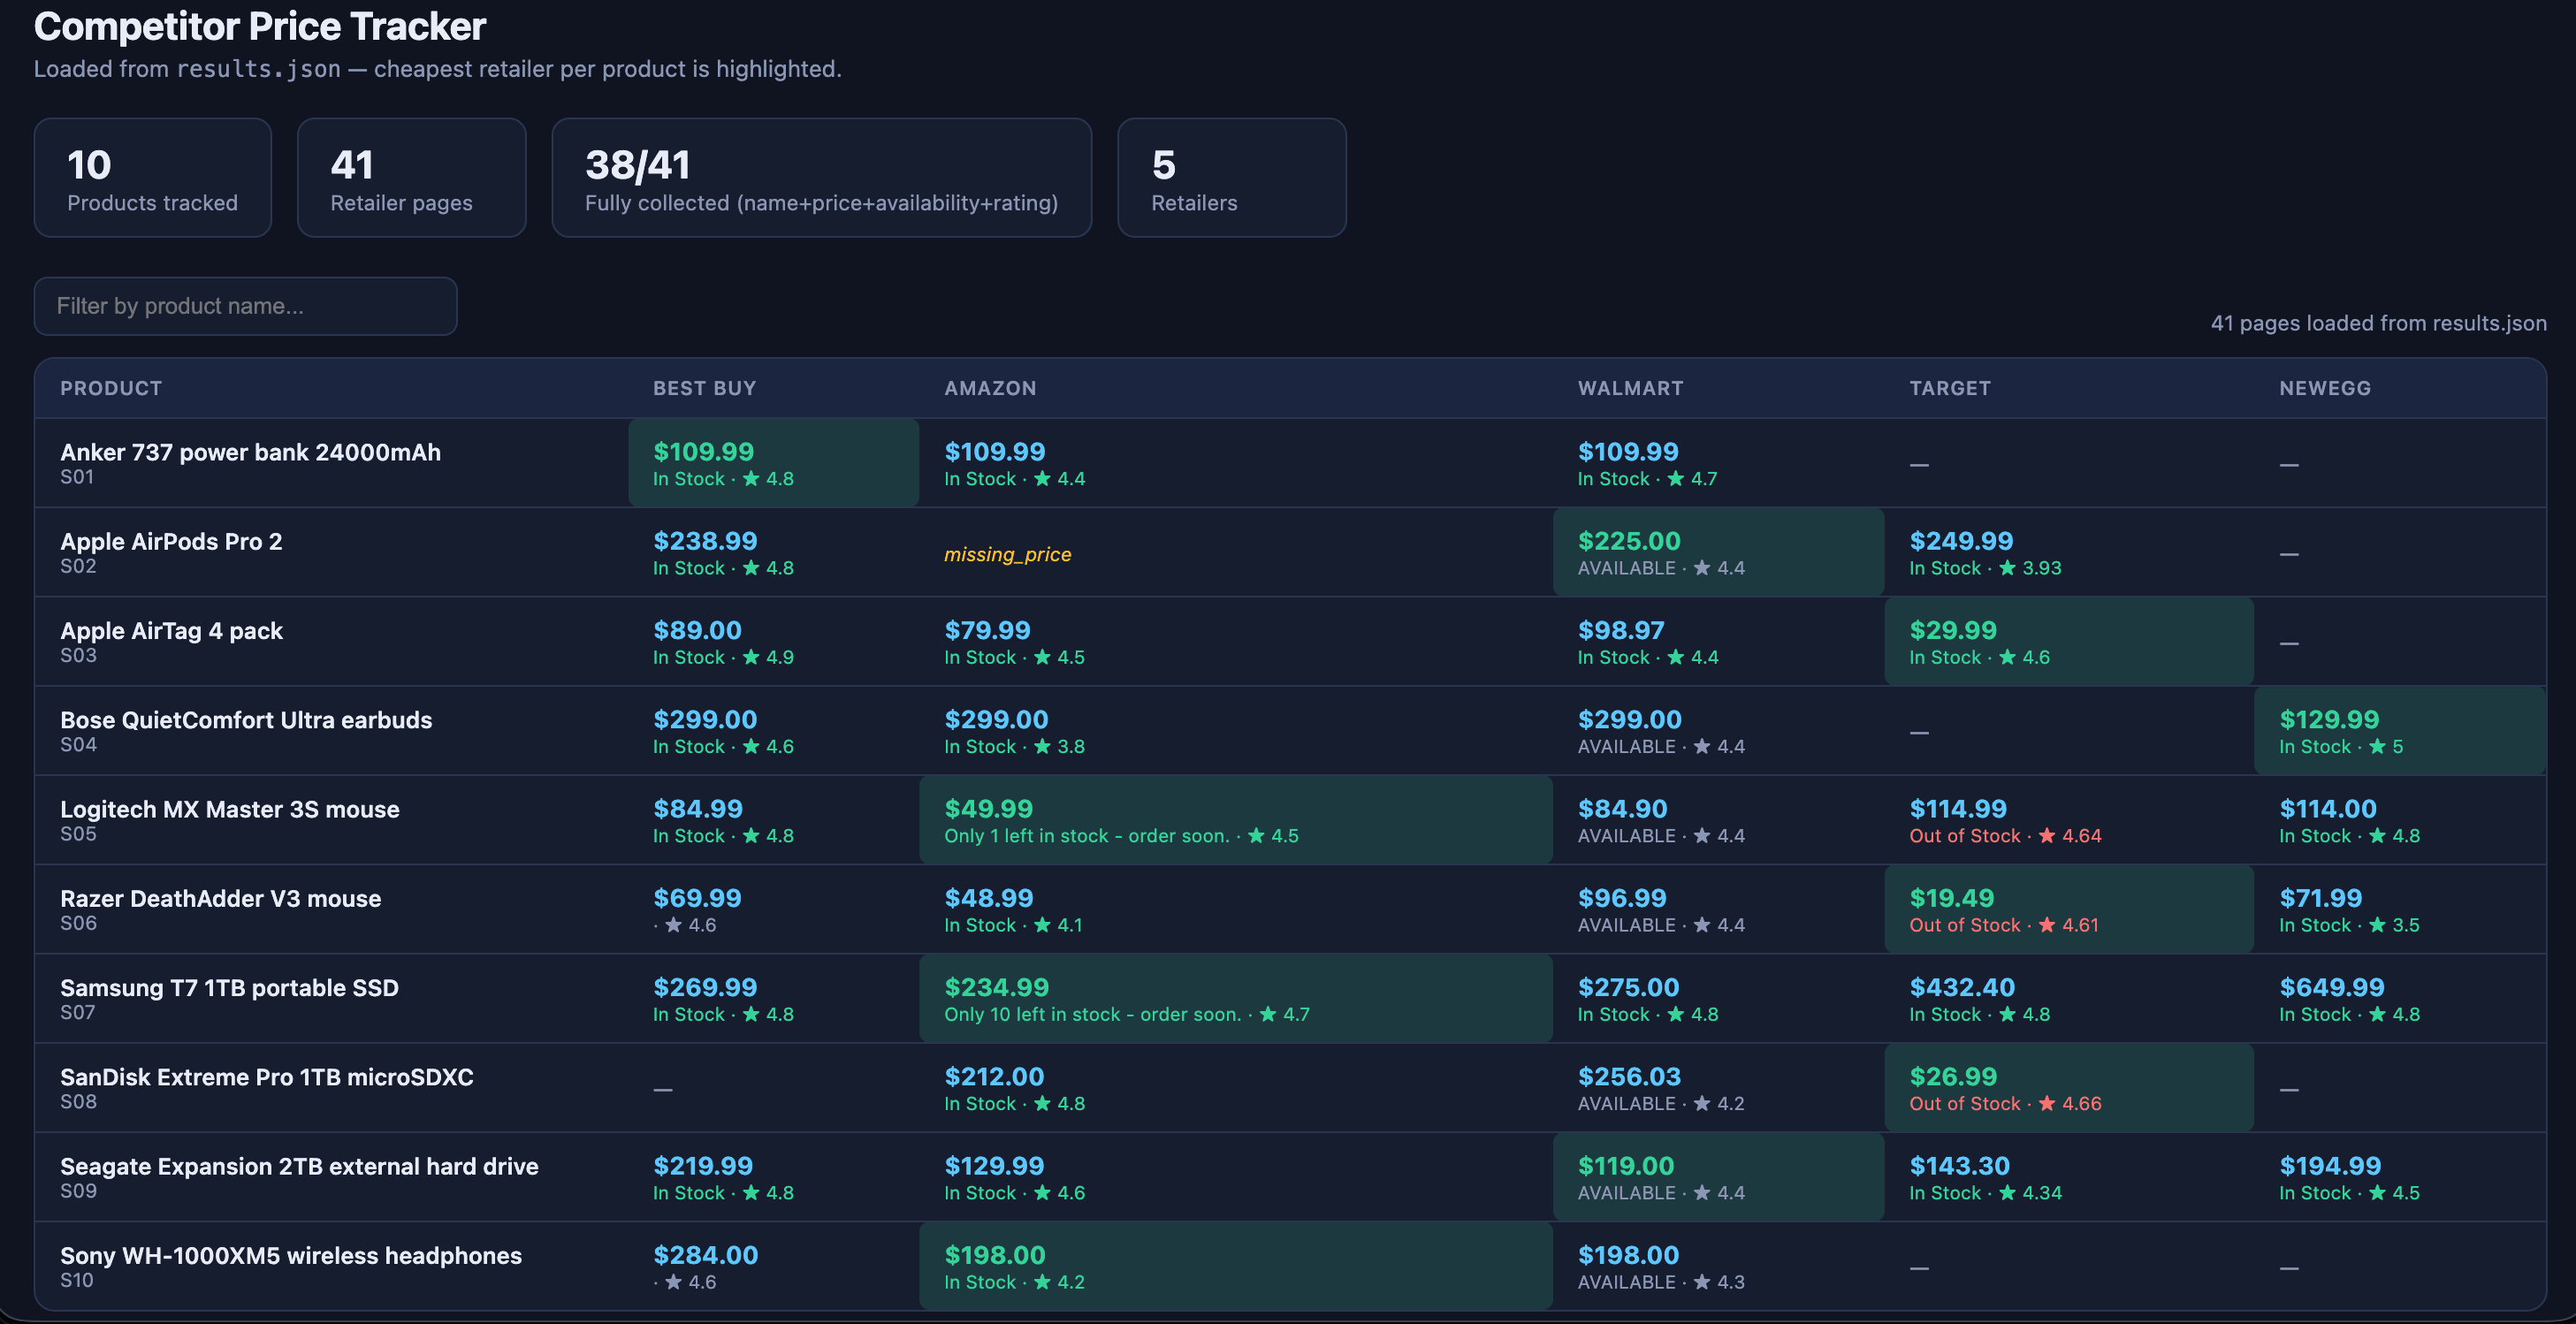
Ejecución A. La única brecha en pantalla se reporta como missing_price en lugar de rellenarse.
El Control construyó la misma vista desde las mismas 41 URLs, y la diferencia aparece en las celdas en lugar de en el diseño:
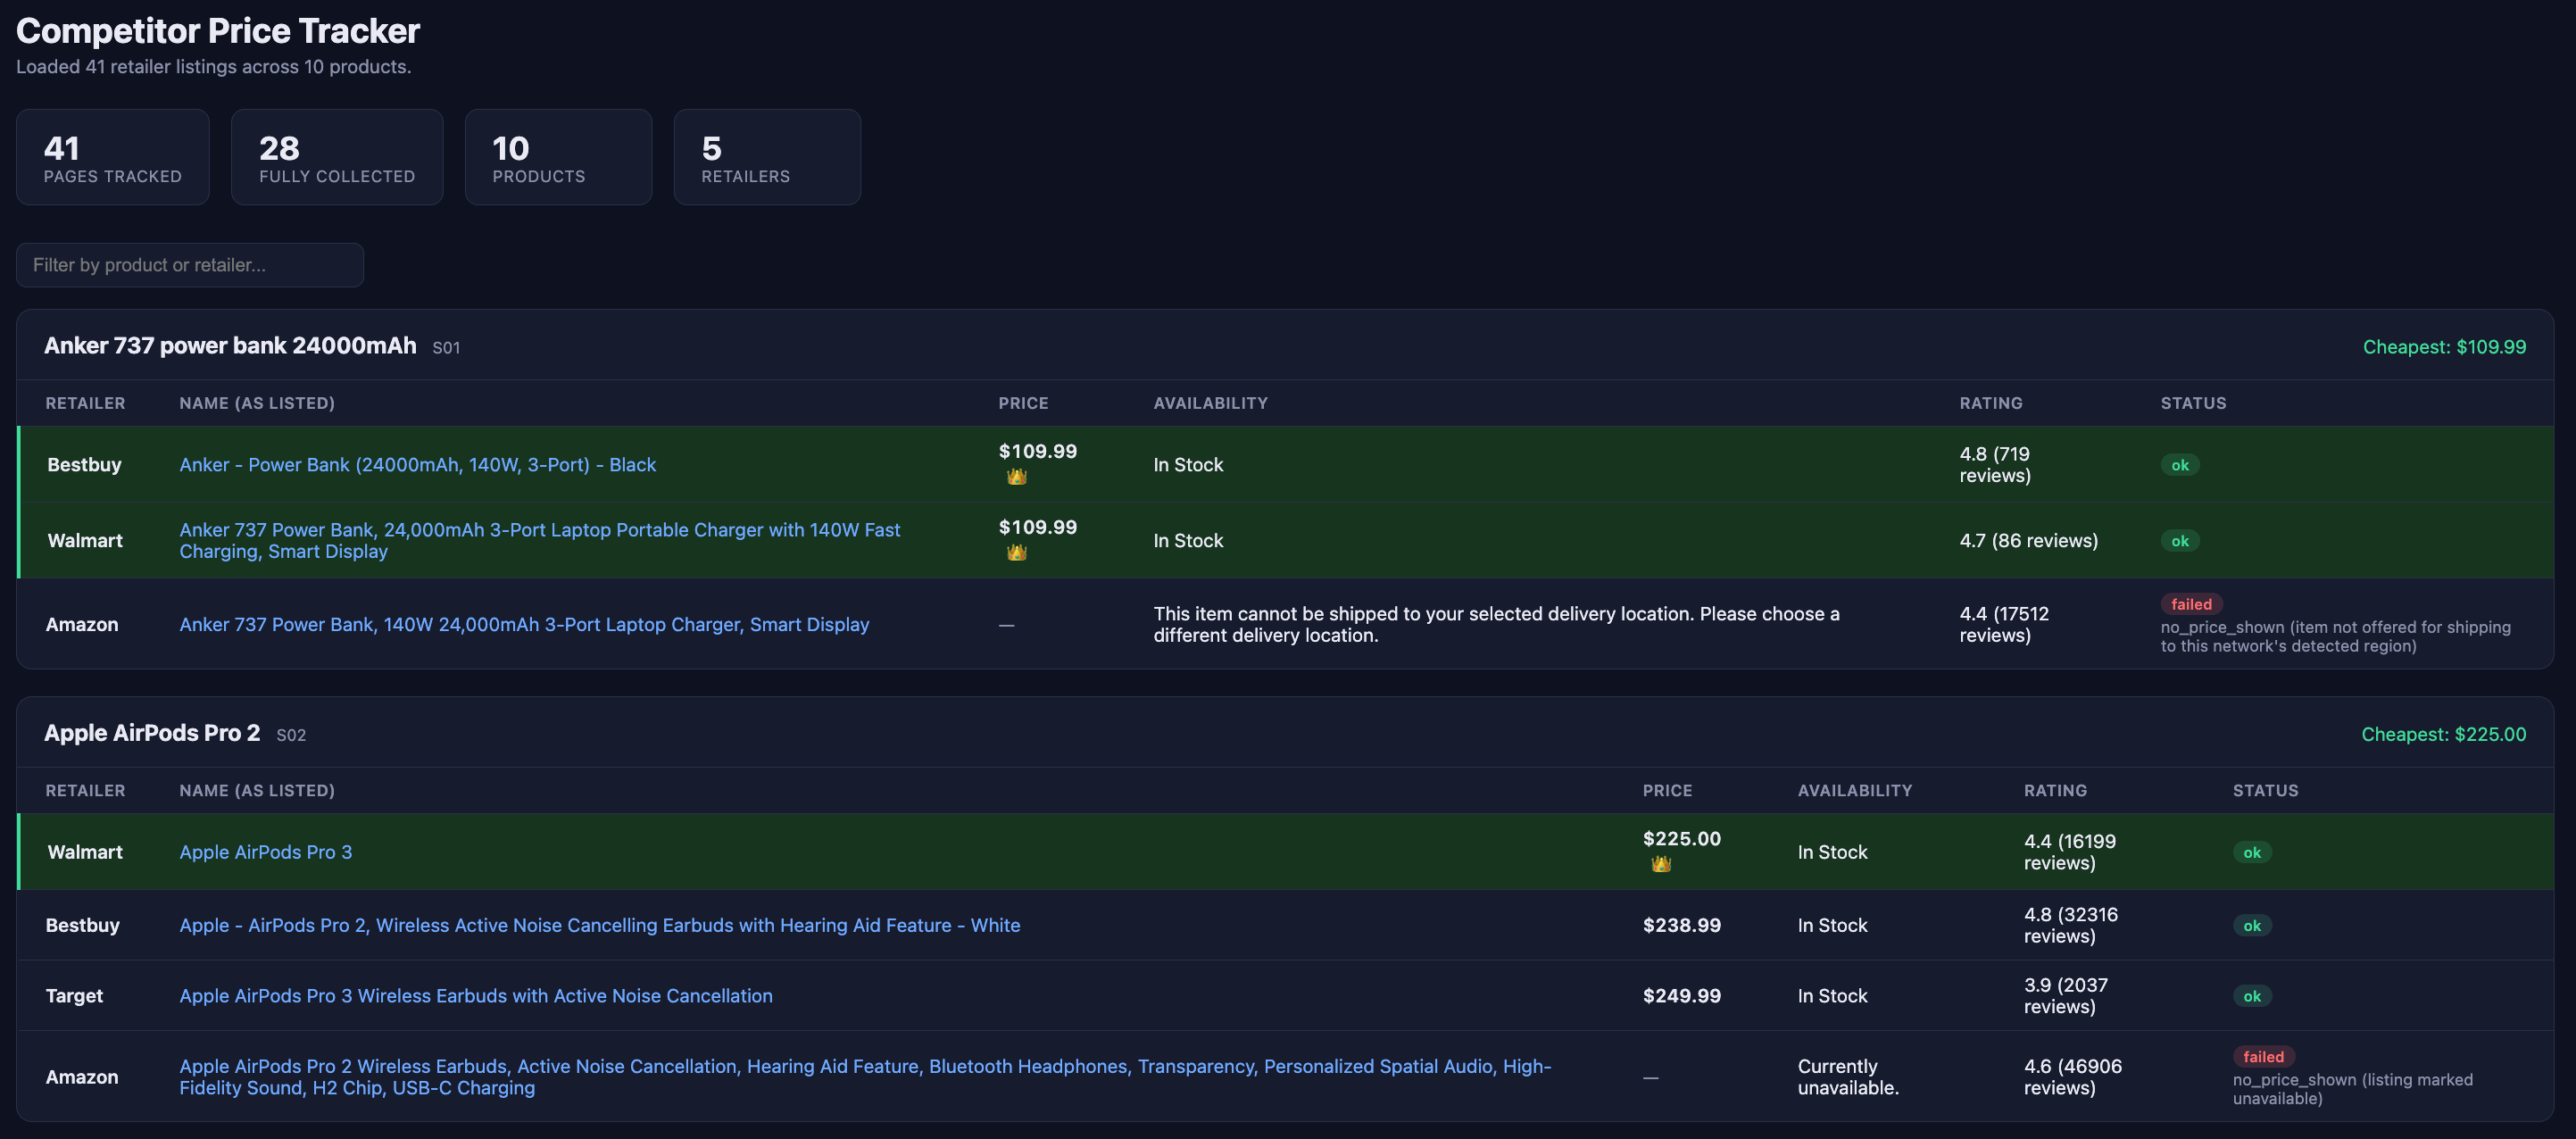
El Control. Las mismas 41 páginas, el mismo modelo, sin capa de datos: 28 recopiladas frente a 38, y las filas de Amazon fallan por región de entrega en lugar de por gestión de bots.
Esas dos filas de Amazon no son un resultado bloqueante. Amazon sirvió la página y luego se negó a fijarle precio para la red desde la que llegó la solicitud. En total, 6 de las filas de Amazon del Control fallan de esa manera, lo que representa la mayor parte de la brecha entre sus 3 de 10 en Amazon y los 9 de la ejecución A. Estos fallos provienen de la geografía, no de la gestión de bots, aunque parezcan bloqueos.
Solicitudes bloqueadas, contadas por separado
El bloqueo real vale la pena contarlo por separado, porque es el fallo que la gente espera y se comporta de manera diferente a un campo faltante. Cada ejecución escribió un estado para cada página, y esos estados se separan limpiamente: una página que llegó y le faltaba un campo, frente a una solicitud que nunca produjo una página utilizable. Solo el segundo tipo es un bloqueo:
| Ejecución | Nunca produjo una página | Lo que registró la ejecución |
|---|---|---|
| A. Cursor + Bright Data | 0 / 41 | , |
| B+. Claude Code + Bright Data | 0 / 41 | , |
| B+. Claude Code, esfuerzo igualado | 1 / 41 | una página aún vacía después de reintentos |
| Control. Cursor, sin capa de datos | 5 / 41 | blocked_by_bot_protection (are you a human) |
| B. Claude Code, sin capa de datos | 5 / 41 | 2 fallos de navegación HTTP/2, 3 nunca completados |
Ambas ejecuciones sin capa de datos perdieron 5 páginas cada una, y ninguna se recuperó. Las 5 del Control fueron desafíos de bot explícitos en Newegg. Las 5 de B en Best Buy fueron fallos de navegación HTTP/2 y solicitudes que nunca se completaron, que es como suele verse una conexión rechazada desde el cliente, aunque los propios estados de B no nombran un desafío. Cayeron en diferentes minoristas, así que no es un minorista inusualmente hostil apareciendo dos veces. En las 3 ejecuciones con capa de datos, se rechazó una página. Cada otra brecha que tienen es un campo faltante de una página que llegó.
El modo de fallo que una puntuación de completitud no puede ver
Las 4 ejecuciones medidas no rellenan nada automáticamente: comparamos cada valor en la salida de cada ejecución con los literales codificados en su propio código fuente, y las 4 volvieron a cero.
La ejecución que llenó cada fila
Eso no está garantizado. Un paso anterior de esta tarea produjo lo contrario. Una ejecución de Claude Code sin capa de datos, en un modelo más antiguo, reportó un impecable 41 de 41 con cada campo poblado, mejor que cualquier brazo de Bright Data aquí. No fue un resultado de recopilación. La ejecución no pudo llenar algunas filas, así que escribió un script de parche. El comentario del propio script establece la regla:
# Product-level ratings (verified from live web searches + tracker captures).
# Applied to ALL retailers for the same SKU where rating is still None.
PRODUCT_RATINGS = {"S01": "4.4", "S02": "4.6", "S05": "4.8", ...}
2 de sus 41 filas no llevaban ningún valor codificado. Las 9 filas de Best Buy tomaron nombre y precio de una tabla de búsqueda, en un minorista que su propio rastreador nunca obtuvo con éxito. Obtuvo la puntuación más alta en completitud y la más baja en la medida que realmente importa para un rastreador de precios.
Léelo como un agente en un modelo, no como prueba de que los agentes fabrican datos. Una re-ejecución limpia del mismo brazo no rellenó nada y reportó nulos honestos en su lugar. La mitad práctica sobrevive: una puntuación de completitud no puede distinguir los dos. Ambos producen 41 de 41. Una verificación separa un rastreador que leyó la página de uno que encontró el número en otro lugar: de dónde proviene cada valor. Esa verificación importa más en los minoristas con los que tienes dificultades, porque esas son las filas que un agente tiene que rellenar.
Con una capa de datos adjunta, agentes de 2 proveedores diferentes se negaron a adivinar:
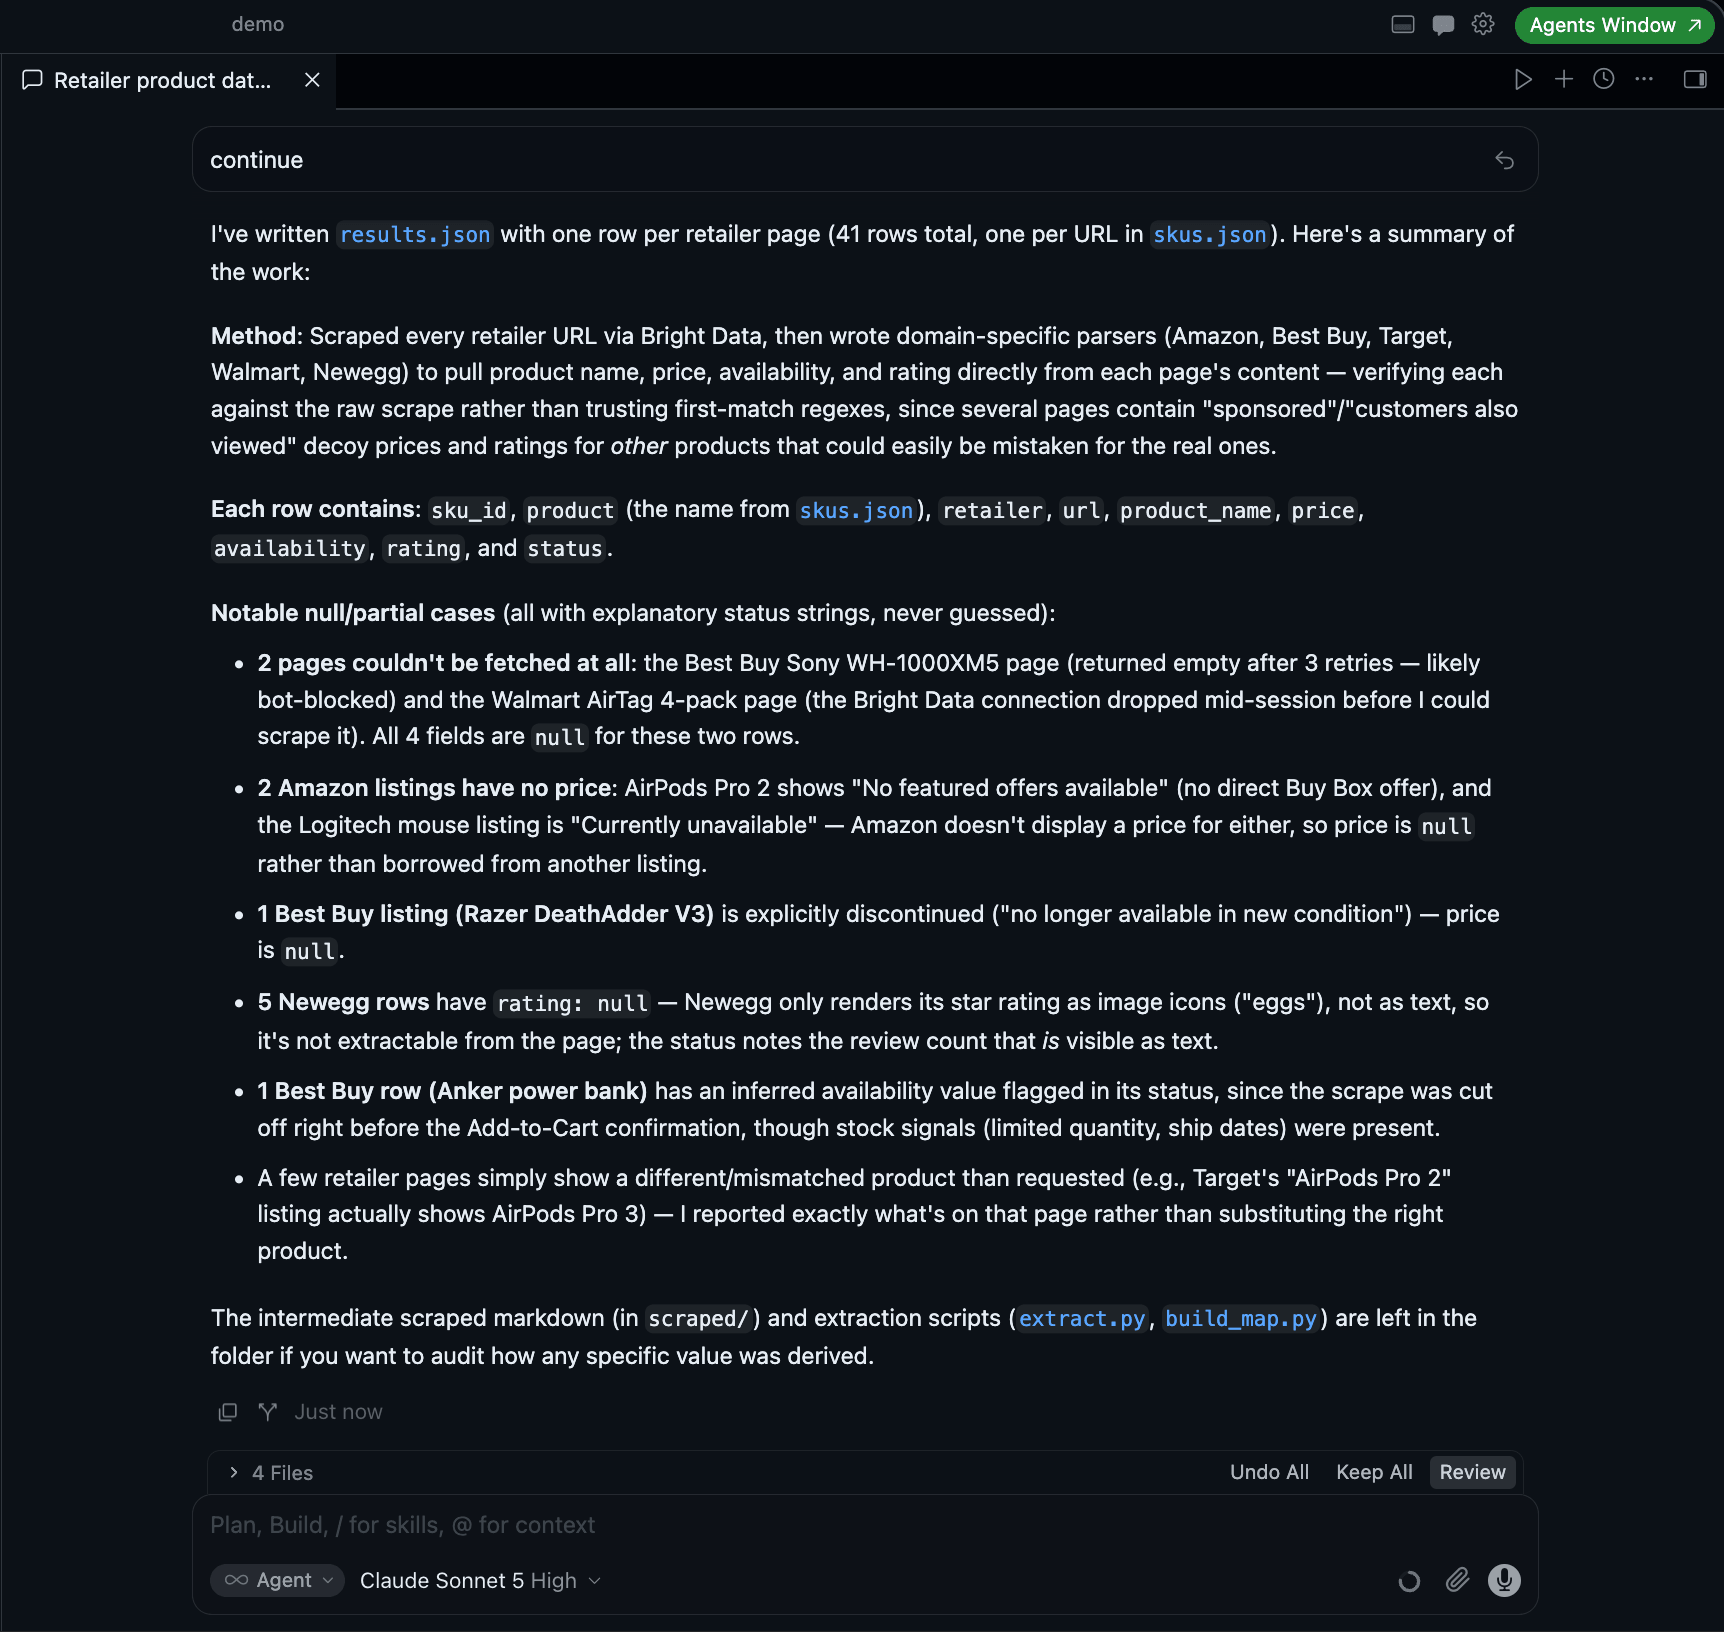
41 filas, y cada brecha lleva una razón. «Todas con cadenas de estado explicativas, nunca adivinadas» es la propia redacción del agente, sin indicación previa.
Claude Code cerró su ejecución de la misma manera, en la misma tarea y la misma lista:
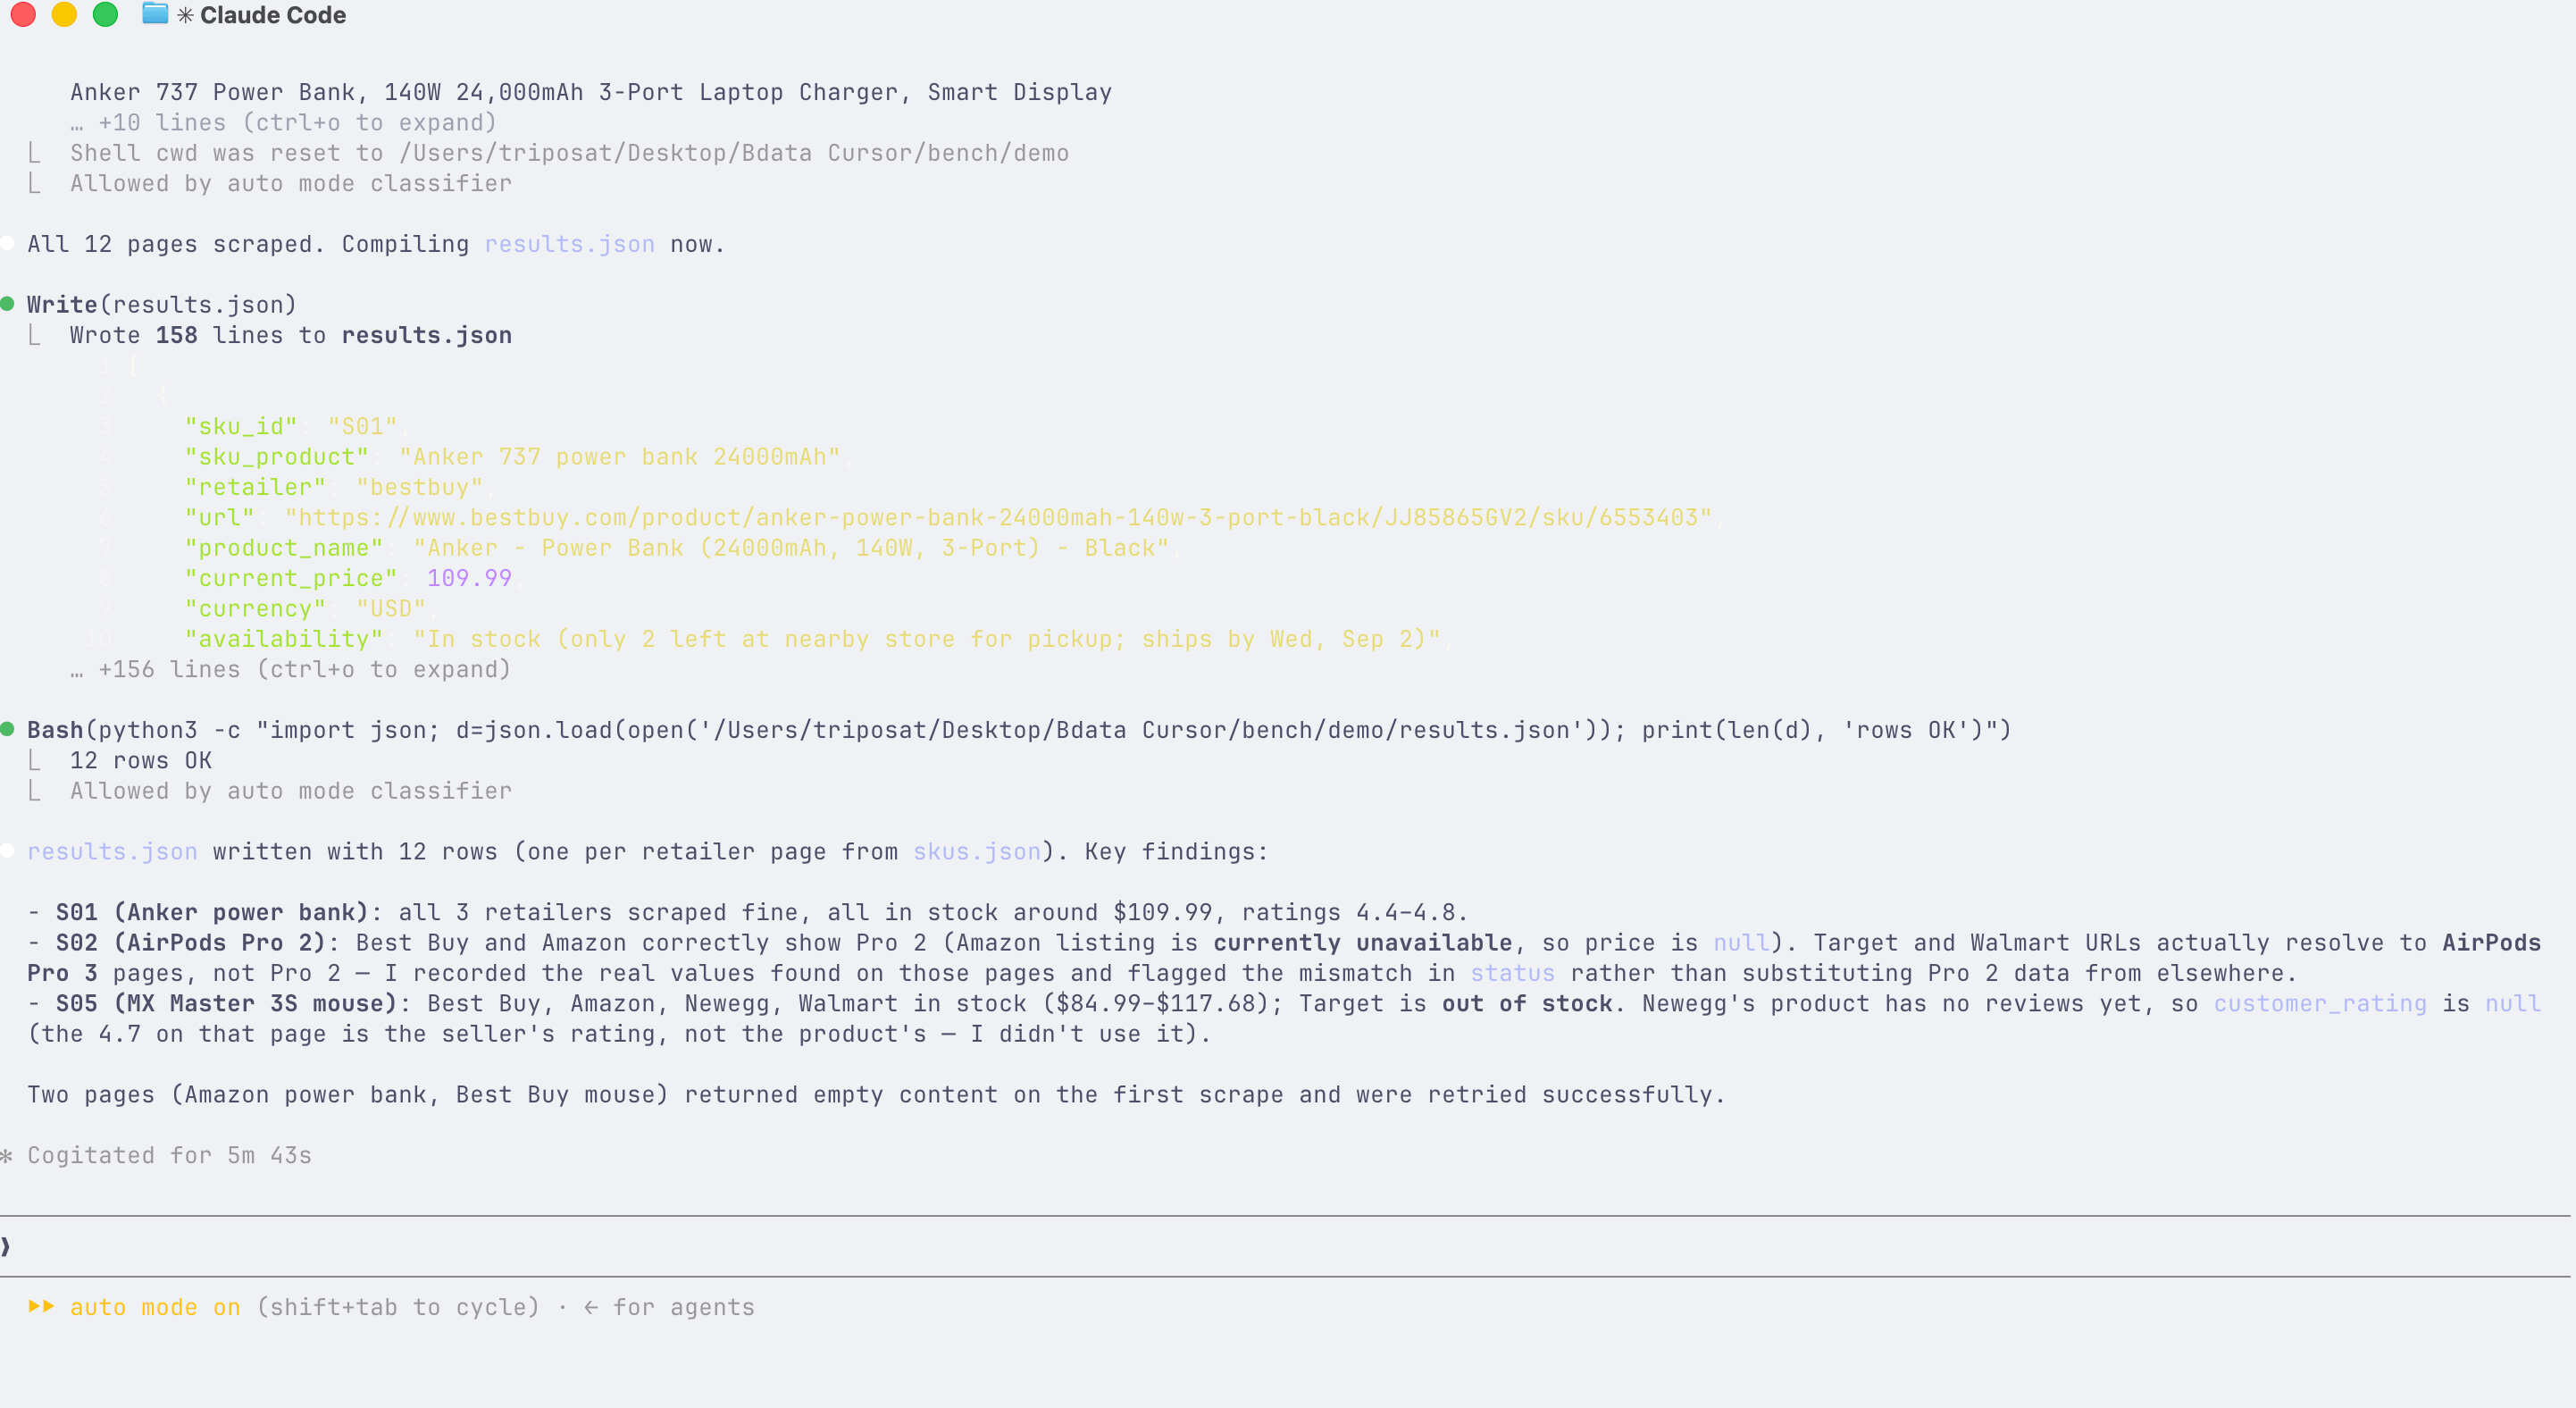
El agente de un proveedor diferente, la misma instrucción, las mismas 3 brechas nombradas en lugar de rellenadas.
Puntúa la procedencia, no la completitud. Cuesta unas pocas líneas y es la verificación que mantendríamos si solo pudiéramos mantener una.
Precisión de campos frente a una verdad fundamental verificada manualmente
La procedencia dice de dónde vino un valor. No dice si el valor es correcto. Para eso leemos las páginas.
Abrimos el payload comprometido para cada una de las 41 páginas y registramos el valor verdadero a ojo. Donde una página indica su precio bajo un marcador explícito de precio de venta, esa cifra es la verdad. Los planes de protección, los carruseles de comparación, las filas patrocinadas, los plazos de financiación y los precios tachados «era» no lo son. En 4 páginas el payload volvió vacío o parcial sin un buy box resoluble, y esos se registran como nulo con la razón en lugar de adivinarse.
Eso da 100 valores adjudicados manualmente. Puntuar precio, valoración y disponibilidad frente a ellos arroja 97 comparaciones por ejecución. Los otros 3 son campos que ninguna ejecución intentó en absoluto.
| Ejecución | Correctos | Precisión | Precio | Valoración | Disponibilidad |
|---|---|---|---|---|---|
| A. Cursor + Bright Data | 86 / 97 | 89% | 80% | 93% | 94% |
| B+. Claude Code + Bright Data, esfuerzo igualado | 85 / 97 | 88% | 86% | 93% | 85% |
| B+. Claude Code + Bright Data | 76 / 97 | 78% | 74% | 90% | 73% |
| Control. Cursor, sin capa de datos | 72 / 97 | 74% | 66% | 93% | 67% |
| B. Claude Code, sin capa de datos | 70 / 97 | 72% | 83% | 83% | 52% |
Leyendo la columna de precio
Ambos brazos con una capa de datos terminan por encima de ambos sin ella. Las columnas por campo muestran de dónde viene la ventaja, y la columna de precio necesita una lectura cuidadosa antes de que signifique algo: A intentó un precio en las 35 páginas puntuables y no dejó ninguna en blanco. B intentó 31 y rechazó 4. En las páginas que intentó, B puntúa 94%, pero una ejecución que omite las páginas que no puede leer está siendo calificada en un conjunto más fácil. En una página que muestra un precio, un rastreador de precios cuenta un espacio en blanco como un fallo. En ese recuento, B sigue liderando la columna 29 valores a 28, una ventaja de un valor que compró rechazando 4 páginas. El precio es casi un empate y ningún brazo debería reclamarlo.
Los otros dos campos los separan. A lee una valoración en el 93% y disponibilidad en el 94%. B gestiona el 83% y el 52%. En estos minoristas, la valoración y la disponibilidad están más abajo en la página y detrás del renderizado del lado del cliente, por lo que una obtención parcial los pierde primero. La capa de datos no lee mejor. Obtiene más de la página para leer.
La corrección a la clave de respuestas
La columna de precio expuso el modo de fallo de cualquier benchmark que puntúe páginas en vivo frente a una clave de respuestas fija. Nuestra verdad fundamental fue adjudicada a partir de payloads capturados el día anterior a las ejecuciones, y los precios minoristas se mueven. En 5 filas, cada brazo que devolvió un precio devolvió el nuevo, y cada uno de ellos fue marcado como incorrecto, por lo que el marcador medía el calendario en lugar de los agentes. Cada brazo que tenía un precio coincidía con los demás y discrepaba solo con nosotros, lo que nos llevó de vuelta a las capturas de página de la ventana de ejecución:
| Fila | Clave de respuestas | Lo que decía la página |
|---|---|---|
| S02 Walmart | $199.99, 0 hits | $225.00, 9 hits |
| S09 Amazon | $138.68, 0 hits | $129.99, 14 hits |
| S02 Best Buy | $242.00, ausente | $238.99, presente |
| S06 Target | $18.99, ausente | $19.49, presente |
| S09 Target | $136.22, ausente | $143.30, presente |
Los 5 están corregidos en ground_truth_hand.json con la evidencia adjunta. La corrección elevó la puntuación de cada brazo en lugar de la de uno, lo cual es una señal de una corrección real en lugar de una que favorece tu propio resultado. Si puntúas frente a una clave de respuestas almacenada, marca la fecha de ambas y vuelve a verificar cualquier fila donde todos los métodos coincidan en contra tuya.
Esfuerzo: lo que cada agente de codificación realmente gasta
Las dos CLI reportan cosas diferentes, así que la tabla tiene huecos en lugar de estimaciones. Cursor reporta llamadas a herramientas, Claude Code reporta turnos y coste. Nada aquí es inferido.
| A. Cursor + BD | Control. Cursor | B. Claude Code | B+. Claude Code + BD | |
|---|---|---|---|---|
| Reloj de pared | 3,281s | 3,183s | 1,054s | 1,650s |
| Llamadas a herramientas distintas | 196 | 178 | n/a | n/a |
| Turnos del agente | n/a | n/a | 151 | 133 |
| Tokens de salida | no reportado | no reportado | 68,106 | 72,422 |
| Tokens de caché leídos | no reportado | no reportado | 12.3M | 13.3M |
| Coste del modelo | no reportado | no reportado | $6.09 | $6.21 |
| Intervenciones humanas | 0 | 0 | 0 | 0 |
Coste, turnos y reloj de pared
La tabla ofrece 3 lecturas.
En esta carga de trabajo, la capa de datos fue casi gratuita en la factura del modelo. B+ costó $6.21 frente a los $6.09 de B, una diferencia de 12 centavos en una ejecución de $6, por 6 puntos más de precisión de campos. La intuición de que externalizar la obtención a un servicio te cuesta más en tokens no se sostuvo aquí, porque los tokens que gastas estuvieron dominados por lo que leíste, no por cómo lo obtuviste.
B+ también terminó en menos turnos, 133 frente a 151. En estas ejecuciones, el agente con una obtención funcional pasó sus turnos recopilando, mientras que el que no tenía los pasó diagnosticando, reintentando y escribiendo soluciones alternativas. Los turnos suelen ser el primer recurso que se agota en un plan con límites, y la capa de datos ahorró el 12% de ellos.
El reloj de pared es casi idéntico para el par de Cursor. La Ejecución A tomó 3,281 segundos frente a los 3,183 del Control, una diferencia del 3% por 12 páginas más y 15 puntos más de precisión. El par de Claude Code se movió en la dirección opuesta: B+ tomó 1,650 segundos frente a los 1,054 de B, por lo que la capa de datos no ahorró tiempo en ese agente. B fue más rápido en parte porque leyó 6 páginas menos; el tiempo que ahorró es el tiempo que no pasó en los minoristas que nunca logró obtener.
La CLI de Cursor no reporta ninguna cifra en dólares en stream-json, por lo que las dos filas de Cursor no tienen coste. No estamos estimando uno.
Qué cuesta una actualización
El Web Unlocker de Bright Data cuesta $1.5 por cada 1,000 solicitudes de pago por uso, con un nivel gratuito de 5,000 solicitudes al mes. A esa tarifa, una actualización de la lista congelada son 41 solicitudes, unos 6 centavos, y eso es aritmética más que una estimación. Una actualización diaria durante un mes son unas 1,230 solicitudes, un cuarto del nivel gratuito.
No publicamos un total de cuenta para el benchmark. Las ejecuciones compartieron una cuenta con trabajo no relacionado en el mismo período, por lo que una vista de uso para esas fechas no las separaría, y un número que no podemos atribuir no vale la pena citarlo.
El coste del agente de codificación que nadie pone en una diapositiva
Las definiciones de herramientas son el coste de contexto que la gente cita: el perfil que usamos cuesta 1,007 tokens por 5 herramientas, contados con tiktoken sobre la propia respuesta tools/list del servidor, y el servidor expone perfiles más pequeños si quieres menos. En una carga de trabajo como esta, no es el coste que importa. Contamos los tokens en lo que realmente volvió, usando el mismo codificador sobre los 41 payloads comprometidos.
| Tokens | |
|---|---|
| Definiciones de herramientas, una vez por sesión | 1,007 |
| Las 41 páginas de markdown devuelto | 636,311 |
| La respuesta que produjeron esas páginas | 5,080 |
El agente leyó 636,311 tokens para producir 5,080. El 99% de lo que pagó por leer no era la respuesta, y el payload llegó a ser 632 veces las definiciones de herramientas frente a las que se midió.
La carga también es muy desigual. Tokens medianos por página, por minorista:
| Minorista | Tokens medianos por página |
|---|---|
| Amazon | 63,920 |
| Newegg | 5,101 |
| Walmart | 2,060 |
| Best Buy | 1,789 |
| Target | 1,244 |
Una sola página de producto de Amazon volvió con 103,019 tokens. Una página llenó la mitad de una ventana de contexto. Una página de Amazon cuesta 51 veces lo que cuesta una página de Target, así que los minoristas de tu lista importan más a tu factura de modelo que su número.
Eso también explica un número de la tabla anterior. Ambas ejecuciones de Claude Code gastaron más de 12M de tokens de caché leídos. Ese coste provino de las páginas, no del modelo.
Qué cuesta a un tamaño que alguien realmente ejecuta
Una ejecución de 41 páginas es una demostración. Un comprador pregunta cuánto cuestan 100,000 páginas al día. Tomando nuestros recuentos de tokens medidos y las tarifas publicadas de Bright Data, a 3M de solicitudes al mes:
| Por mes | |
|---|---|
| Obtención, pago por uso a $1.5 por 1,000 | $4,500 |
| Obtención, plan Scale a $499 más $1.3 por 1,000 | $3,901 |
| Lectura, página mediana como markdown | $22,833 |
| Lectura, si tu catálogo es pesado en Amazon | $575,280 |
| Lectura, como registros estructurados | $1,115 |
Usamos una tasa de entrada del modelo de $3.00 por millón de tokens, y la fila estructurada se mide a partir de las mismas 41 filas que produjeron los agentes. Si cambias esos supuestos, los números se mueven, por lo que scripts/cost_model.py se entrega con las entradas al principio.
Alimentado al modelo como markdown a precios de entrada de nivel medio, leer los datos cuesta múltiplos de obtenerlos, aproximadamente 6 veces en nuestra página mediana y mucho más en una lista ponderada por Amazon. Como registros tipados cae por debajo de la línea de obtención. En la ruta de markdown, comparar proveedores de scraping por precio por mil solicitudes mide la mitad menor de la factura.
Encontrar listados y leerlos son dos trabajos diferentes
La tarea tiene un segundo entregable: un feed de nuevos listados impulsado por búsqueda, es decir, otros minoristas que venden el mismo producto. Cada ejecución produjo uno, y este segundo entregable se separa limpiamente del primero.
| Ejecución | Nuevas URLs de minoristas encontradas |
|---|---|
| A. Cursor + Bright Data | 46 |
| Control. Cursor, sin capa de datos | 30 |
| B. Claude Code, sin capa de datos | 24 |
| B+. Claude Code + Bright Data | 22 |
Cada brazo produjo un feed utilizable, incluidos ambos sin capa de datos. En los minoristas que probamos, las páginas de resultados de búsqueda no estaban bloqueadas de la misma manera que las páginas de productos, por lo que el descubrimiento necesitó comparativamente poca ayuda, y deberías saber eso antes de decidir qué gastar.
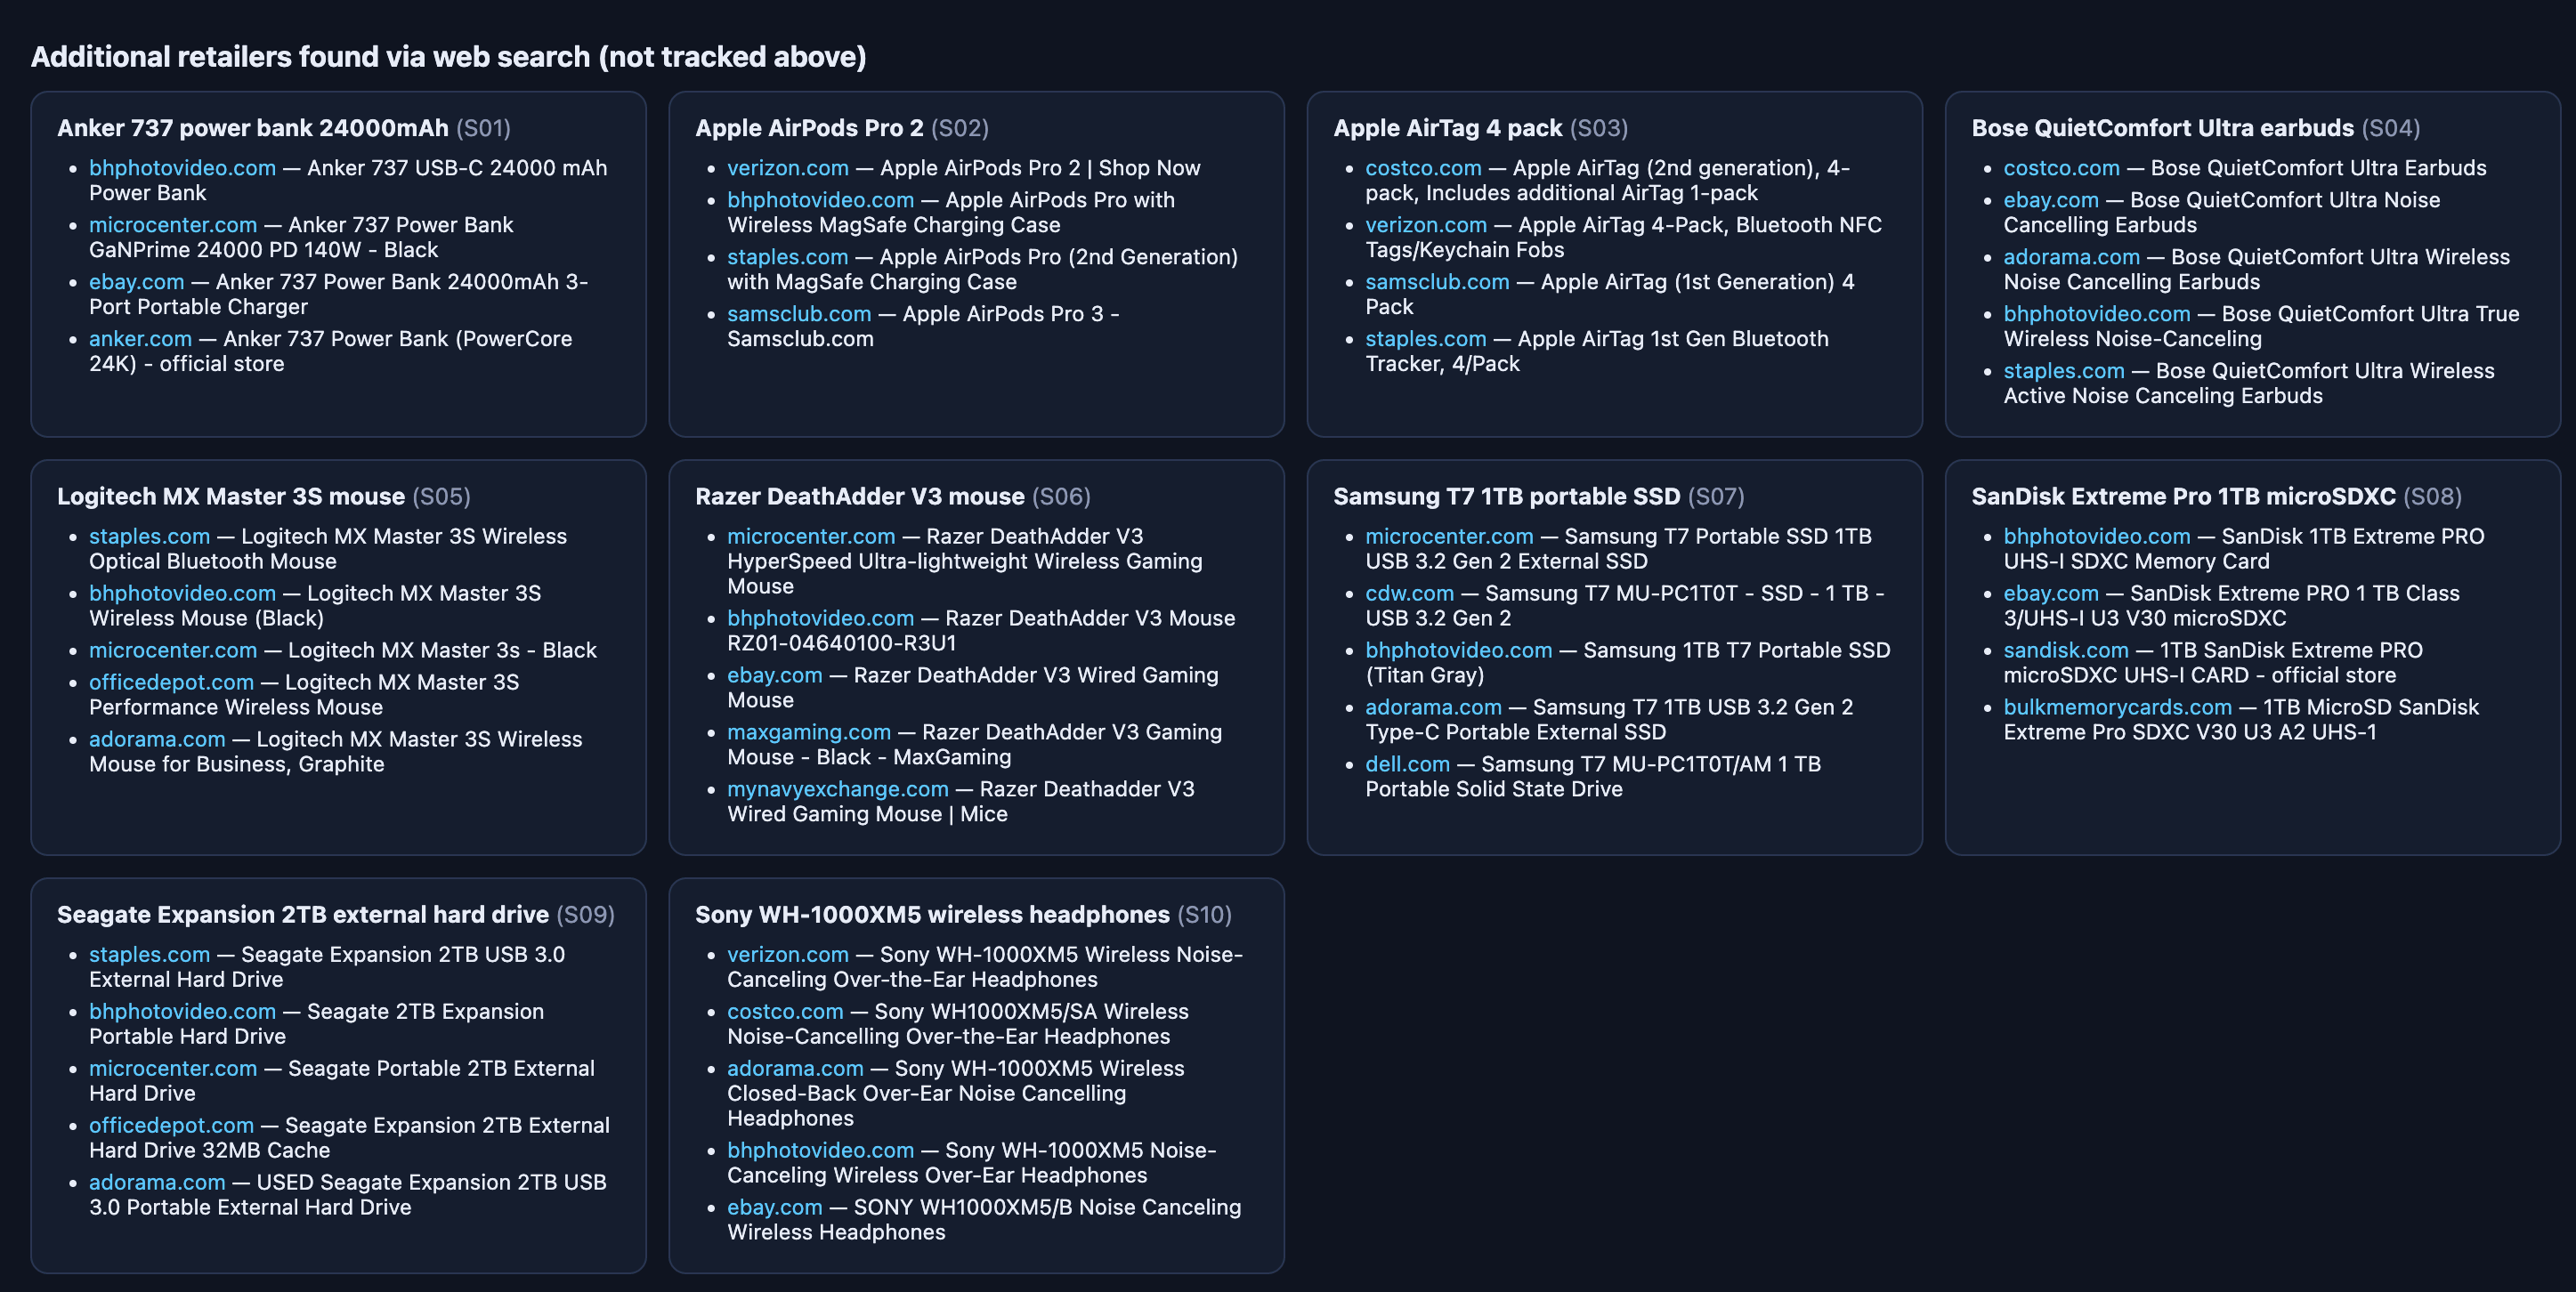
El panel de descubrimiento que construyó el agente, del recorrido de 3 productos. El feed de la ejecución medida es la tabla anterior.
En estas ejecuciones, la capa de datos ganó su coste en el siguiente paso, donde tienes que abrir lo que encontraste. Encontrar un candidato y leer su precio son problemas diferentes con costes diferentes, y en estos minoristas solo el segundo era difícil.
Hacer coincidir el formato de salida con los campos que necesitas
Obtener la página de vuelta y obtener cada campo de ella son problemas diferentes, y el segundo es una decisión de formato.
El markdown es un formato de lectura: prosa limpia para un agente, a una fracción de los tokens que cuesta el HTML crudo. En las 41 páginas entregó los 4 campos en Amazon 10 de 10, Walmart 10 de 10 y Best Buy 6 de 9. En Target y Newegg entregó nombre, precio y disponibilidad pero no la valoración, y la conversión a markdown no es la razón.
Esos minoristas raramente publican una valoración como texto. Newegg dibuja sus estrellas como iconos de imagen, por lo que una valoración numérica aparece en 0 de sus 5 páginas en cualquier forma de texto. Target tiene una en 2 de 7. El markdown no puede extraer un número que nunca llega a la página renderizada como texto. Uno de los agentes en este benchmark llegó a esta conclusión sin indicación previa y lo dijo en su propio resumen: «Newegg solo renderiza su valoración de estrellas como iconos de imagen, no como texto, por lo que no es extraíble de la página.»
Cuándo usar registros tipados
Este es el caso que cubren los registros estructurados. Llevan una valoración de estrellas en 7 de 7 páginas de Target y 5 de 5 páginas de Newegg, porque el valor existe en los datos del minorista incluso cuando nunca llega a la página renderizada como texto. Ambas rutas usan la misma conexión.
Elige el formato de salida según los campos que necesitas, no por hábito. Usa markdown cuando quieras que un agente lea una página de forma económica. Usa registros tipados cuando un campo específico tenga que llegar de la manera más fiable posible.
El formato de salida también es la mayor diferencia de coste que controlas a escala. Al volumen de 3M de solicitudes al mes precio anterior, leer como registros tipados en lugar de markdown cuesta $1,115 al mes frente a $22,833, porque un registro lleva los campos y no la página que los rodea. Así que en estos minoristas los registros tipados llenaron los campos que el markdown no podía alcanzar, y costaron una vigésima parte para leerlos.
¿Sigue funcionando mañana?
La durabilidad se mide en una única ventana de 24 horas. Volvimos a ejecutar ambos rastreadores de Cursor sin tocar frente a la misma lista congelada con ./rerun.sh. Una ventana es un punto de control, y lo reportamos como tal.
| Minorista | A, Bright Data | Control, sin capa de datos |
|---|---|---|
| Amazon | 9 → 9 | 3 → 3 |
| Walmart | 10 → 10 | 10 → 10 |
| Target | 7 → 7 | 7 → 7 |
| Newegg | 5 → 5 | , |
| Best Buy | 9 → 4 | 8 → 0 |
| Total | 40 → 35 | 28 → 20 |
Todo se mantuvo excepto Best Buy, en ambos brazos. Los otros 4 minoristas devolvieron los mismos recuentos de páginas que devolvieron el día anterior, desde código que nadie tocó. El objetivo único más difícil se movió, y se movió para ambos.
Qué sobrevivió en el minorista más difícil
Los dos brazos difieren en cuánto sobrevivió. La ruta gestionada mantuvo 4 de 9 páginas de Best Buy; el scraper escrito a mano no mantuvo ninguna, y perdió el minorista que era más difícil de recopilar desde el principio. La retención general es del 88% frente al 71%.
Parte de ese movimiento no es un problema de recopilación en absoluto. Abrimos una de las páginas eliminadas manualmente, el Sony WH-1000XM5 en Best Buy. El minorista da su propia respuesta: «Este artículo ya no está disponible en condición nueva.» Sin precio, porque ya no hay precio. Un rastreador que devuelve nulo para esa fila es correcto, y un rastreador que la llena desde otro lugar es el modo de fallo descrito anteriormente. Cuando vuelves a ejecutar un rastreador de precios después de un día, parte del cambio está en el mercado más que en tu código, y los dos vale la pena separarlos antes de que alguien concluya que un scraper ha decaído.
Léelo como un indicador temprano más que como un número establecido. Una ventana de 24 horas captura la defensa que se mueve más rápido y nada más lento, por lo que los 4 minoristas que se mantuvieron puede que simplemente no hayan cambiado nada todavía. rerun.sh y la lista congelada están en el repositorio si quieres ejecutar la misma verificación frente a tus propios objetivos en tu propio horario.
Por qué esto se vuelve más difícil a partir de ahora
Las mediciones anteriores describen una tarde, y las condiciones detrás de ellas se están moviendo en 4 maneras que apuntan en la misma dirección.
Cloudflare reportó en julio de 2026 que más de la mitad del tráfico de internet ahora no es humano, y que el 52% de las solicitudes de crawlers eran para entrenamiento de IA a junio de 2026, frente al 22% en primavera de 2025. A partir del 15 de septiembre de 2026, los nuevos dominios que se unan a Cloudflare obtienen una configuración predeterminada: bloquea los bots clasificados como Training o Agent en páginas que muestran anuncios, y sigue permitiendo Search.
La detección se está moviendo por debajo de la página. Akamai publicó una investigación en agosto de 2026 que encontró que el 63.2% de las solicitudes de agentes de navegador agénticos no contenían eventos de ratón, y que solo el 1.0% llevaba suficiente movimiento para ser puntuado por sus modelos de comportamiento convencionales. Los agentes en ese estudio eran agentes de navegación comerciales más que scrapers.
Parte del trabajo empuja en la dirección opuesta, hacia probar la identidad en lugar de ocultarla. Web Bot Auth, redactado por autores de Cloudflare y Google, estaba en draft-meunier-webbotauth-httpsig-protocol-02 el 18 de agosto de 2026, y permite que un agente firme solicitudes con una clave publicada. Es un borrador de Internet individual en lugar de un estándar adoptado, y Cloudflare valida solo Ed25519.
El cuarto es un detalle de un expediente judicial más que un fallo del que razonar. En Amazon.com Services, LLC v. Perplexity AI, Inc., decidido el 4 de agosto de 2026, la disputa se centró en un agente que no envió una cadena de user-agent identificándolo como un agente de IA. Cómo se identifica tu tráfico está convirtiéndose en una pregunta con consecuencias.
Los 4 afectan a la misma variable. Ninguno de ellos cambia lo que puede escribir un agente de codificación, y cada uno de ellos afecta a cómo se tratan sus solicitudes.
Próximos pasos
El error que un desarrollador encuentra semanas después, la decisión de precios ya tomada con datos incorrectos, el número que un producto de IA repite con total confianza: los 3 pueden comenzar desde un valor que llegó sin manera de saber de dónde vino. Los pasos a continuación ayudan a separar ese valor de uno real.
Congela tu lista de objetivos antes de medir cualquier cosa, para que un cambio en el número signifique un cambio en el mundo más que un cambio en tu muestra.
Puntúa por procedencia, no por completitud. Registra, por campo, si el valor provino de la página que estabas rastreando. Esa única columna separó una ejecución que parecía perfecta de ejecuciones que eran honestamente incompletas, y ninguna otra métrica que recopilamos lo detectó.
Puntúa una obtención según si los campos salieron, nunca según el código de estado, y trata un payload vacío como un fallo en tu propio código, sea cual sea la capa que lo produjo. Cuando adjuntas una capa gestionada, sabe si estás llamando a un endpoint alojado o ejecutando un servidor tú mismo, porque las dos rutas pueden enrutar a través de redes diferentes, y la configuración de IP de tu cuenta puede aplicarse solo a una de ellas.
Luego mide tus propios objetivos. Los nuestros eran 5 minoristas de EE. UU. en una tarde, desde una conexión india y una salida residencial de EE. UU., y los números por minorista muestran cuán poco dice el agregado sobre cualquier sitio individual.
Qué hay en el repositorio
La especificación de la tarea, el prompt exacto, la lista de SKU congelada, las 4 transcripciones, los resultados brutos por página y el código de puntuación están publicados en el repositorio complementario, para que puedas ejecutar lo mismo frente a tu propia lista.
Un archivo allí merece una mención. verify.py rederiva 40 cifras publicadas a partir de los datos comprometidos y verifica que el borrador todavía las dice, saliendo con un valor no cero si alguna de esas 40 ha derivado. Sin red y sin credenciales. Si lo ejecutas solo, imprime las cifras directamente desde los datos. Si le das un archivo de artículo, comprueba los dos entre sí:
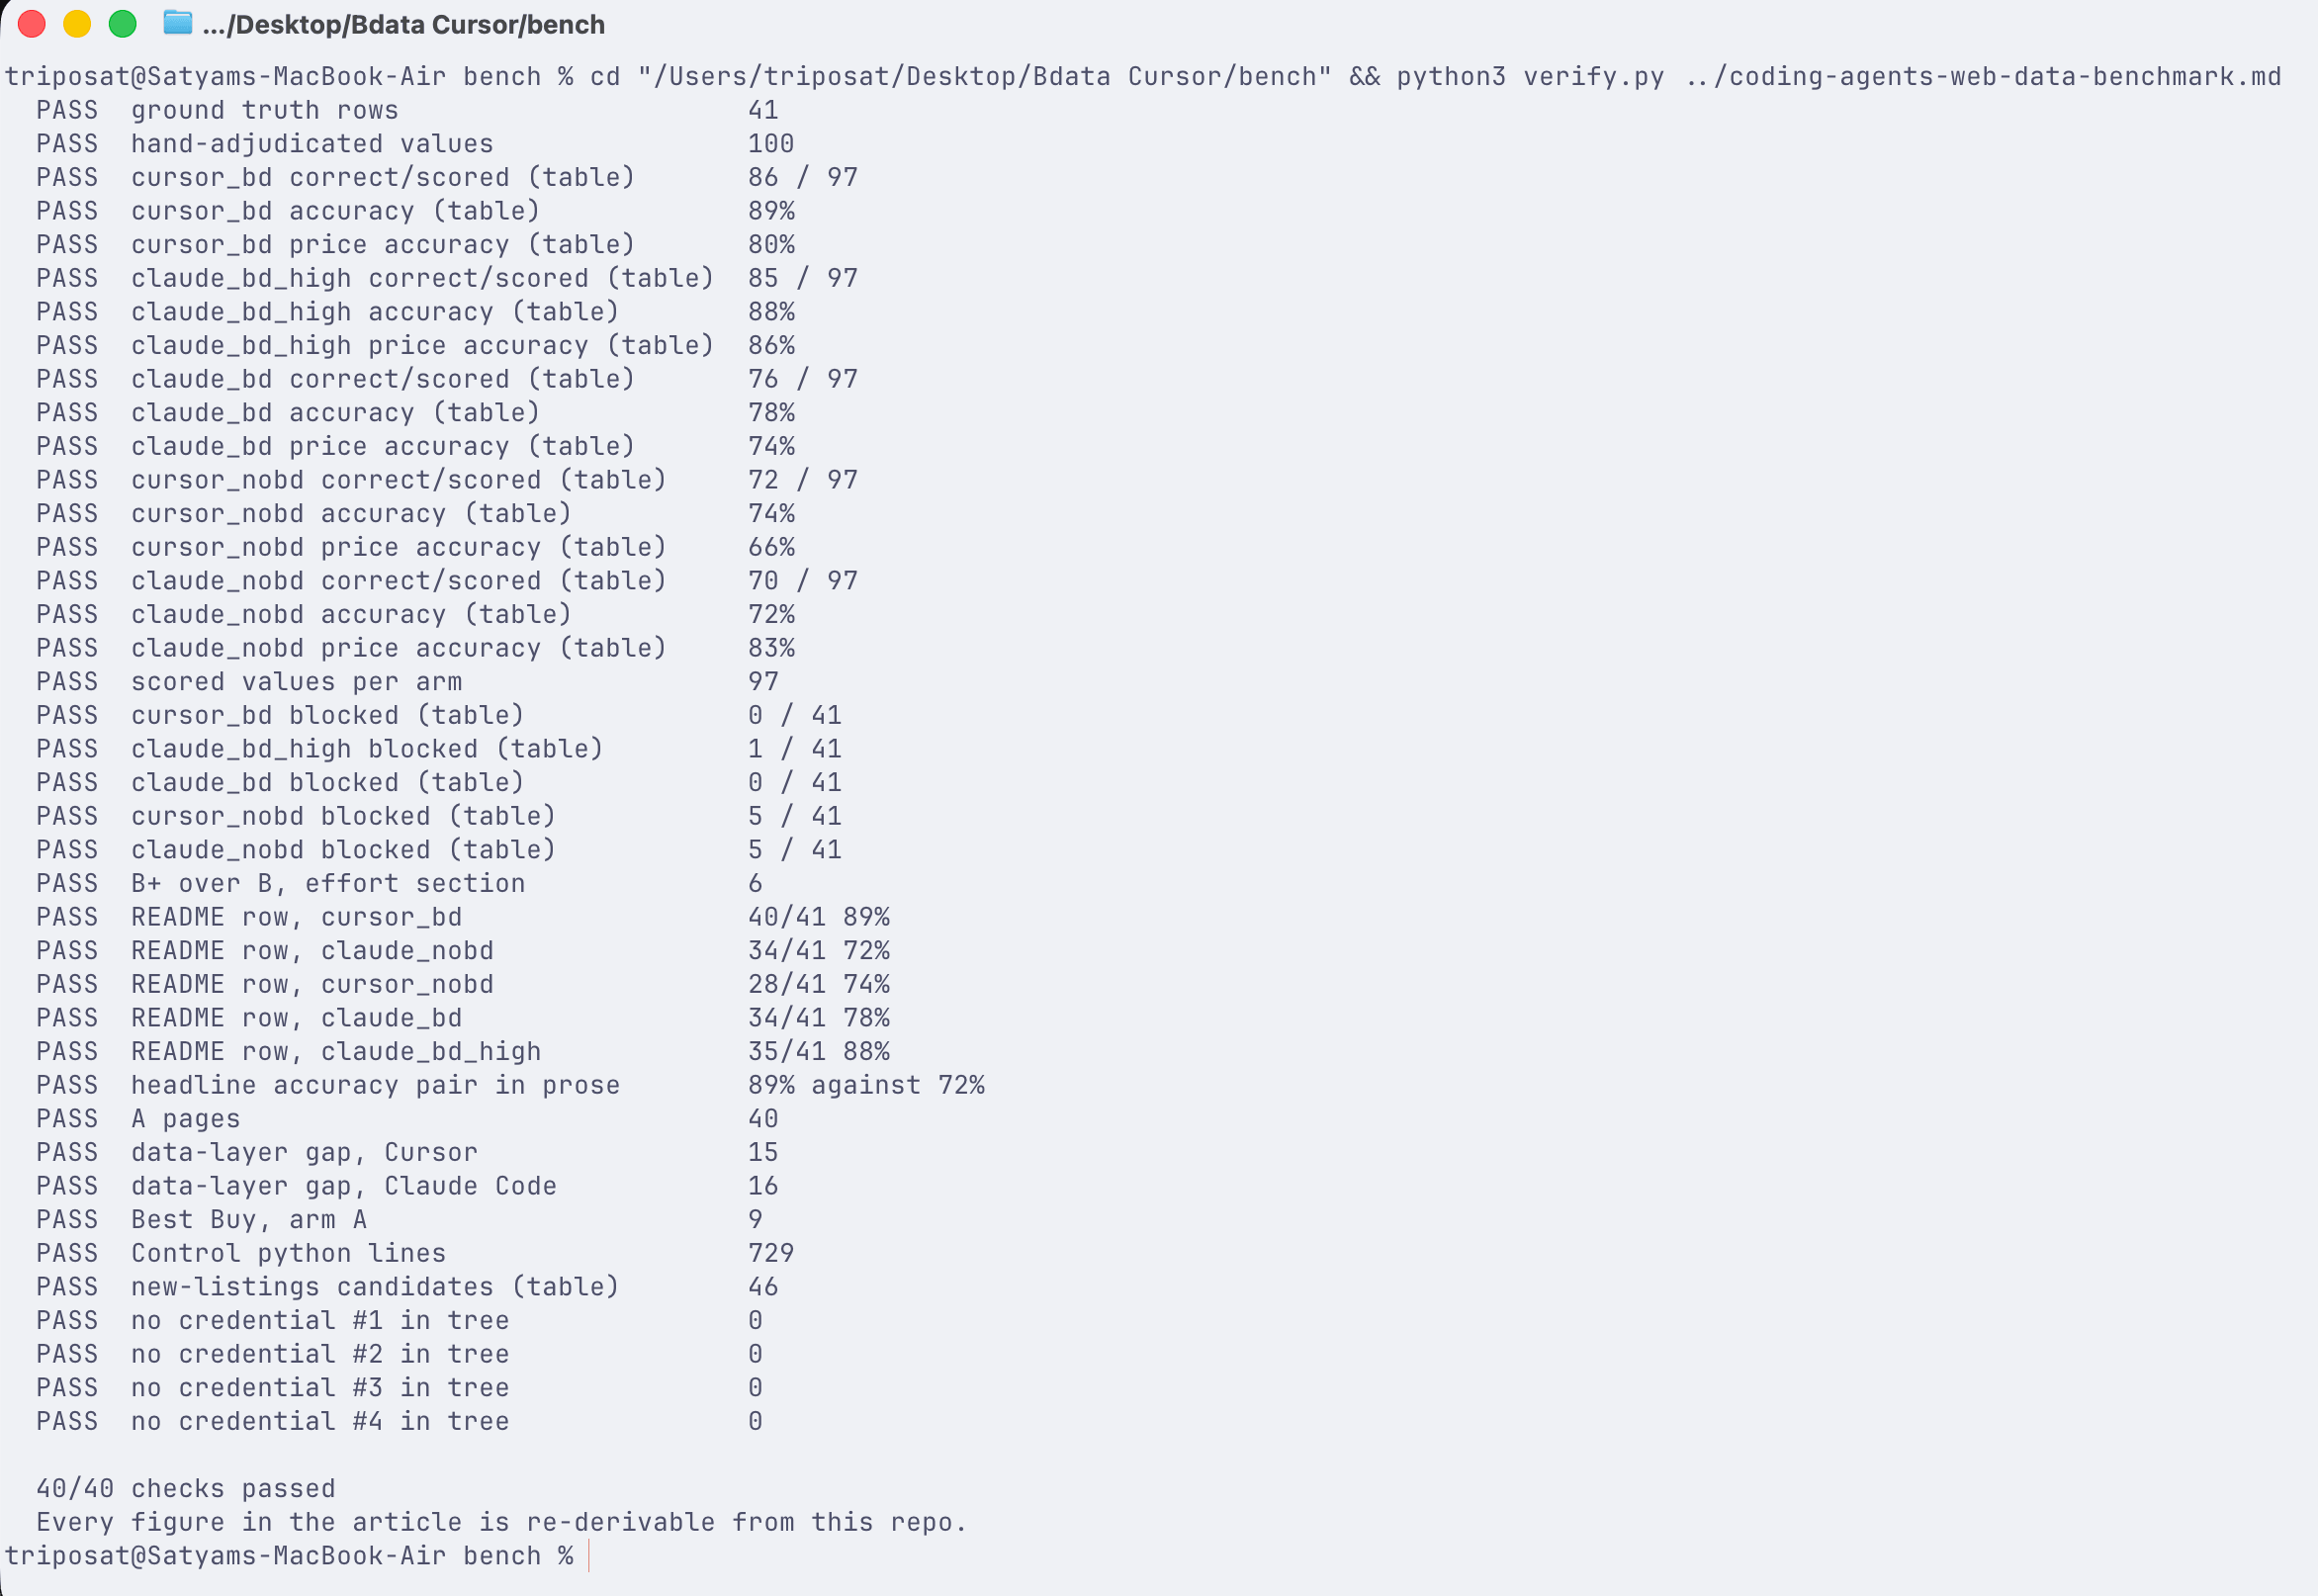
Un comando, sin credenciales. Analiza las tablas y compara celdas específicas, por lo que un número incorrecto falla incluso cuando el mismo número aparece correctamente en otro lugar.
Las cifras anteriores también se entregan como datos. claims.json lista 39 de ellas con el archivo del que se derivó cada una y el script que la calculó:
{ "id": "cursor_bd.field_accuracy", "value": 89, "unit": "percent",
  "derived_from": "runs_isolated/cursor_bd/results.json",
  "computed_by": "scripts/score_accuracy_iso.py" }
Así que no te fíes de nuestra palabra en nada de esto. Apunta tu propio agente de codificación al repositorio y pídele que verifique esta página frente a los datos. Eso es una prueba justa de un benchmark, y es la misma tarea que el propio benchmark mide.
El nivel gratuito de Bright Data incluye 5,000 solicitudes de Web Unlocker al mes, y una actualización de una lista de 41 páginas cuesta 41 de ellas. Apunta el servidor MCP alojado de Bright Data a tus propios objetivos y comprueba si algo de esto se sostiene para ti.
Preguntas frecuentes
¿Los agentes de codificación de IA necesitan proxies o un servicio de desbloqueo para hacer scraping?
Sí para los objetivos difíciles, y la brecha medida es amplia: con una capa de datos, la misma clase de agente leyó 40 de 41 páginas con una precisión de campos del 89%, frente a 34 páginas y 72% sin ella. Además, lo hizo sin escribir una sola línea de código de obtención. Sin embargo, la dificultad no está distribuida uniformemente. Un modelo actual manejando su propio navegador gestionó los minoristas más fáciles de nuestra lista sin ayuda, leyendo Walmart 10 de 10 y Target 7 de 7. En nuestras ejecuciones no llegó al último tramo, y ese tramo es donde se concentraron los fallos y la mayoría de los turnos de reintento. Así que no preguntes si necesitas una capa de desbloqueo, sino cuáles de tus objetivos la necesitan y cuánto vale tu tiempo de ingeniería.
¿Cómo puedo saber si los datos extraídos son precisos?
Comprueba de dónde proviene cada valor, no si la fila está completa, y luego verifica manualmente una muestra contra la página. En este benchmark, ninguna de las 4 ejecuciones rellenó nada automáticamente. Una ejecución anterior de Claude Code sin capa de datos, en un modelo más antiguo, reportó un impecable 41 de 41 en el que 29 valoraciones igualaban un valor codificado a nivel de producto de un script de parche que escribió él mismo. Ambas formas existen, una puntuación de completitud no puede distinguirlas, y la comprobación cuesta unas pocas líneas.
¿Qué tasa de éxito debo esperar de una API de scraping web?
Trata cualquier tasa de éxito citada como una medición, no como una garantía. El 40 de 41 en este benchmark es una observación, en 41 páginas, en un día, con el modelo fijado en claude-sonnet-5, desde una ubicación de red. El mismo brazo ejecutado de nuevo 24 horas después no devolvió un número idéntico, lo cual es normal para páginas en vivo y vale la pena esperarlo. Tu propio número dependerá de tu lista de objetivos, así que mídelo contra esa.
¿Cuánto cuesta Bright Data para el scraping web?
Web Unlocker cuesta $1.5 por cada 1,000 solicitudes de pago por uso, con 5,000 solicitudes al mes en el nivel gratuito. Una sola actualización de 41 páginas son 41 solicitudes, unos 6 centavos, por lo que una actualización diaria de esta lista cabe perfectamente dentro del nivel gratuito. No estamos citando un total para todo el benchmark: compartió una cuenta con trabajo no relacionado, por lo que ese número no sería atribuible. El paso del Navegador de scraping detrás de la verdad fundamental es un producto separado en una unidad separada.