En este artículo, descubrirás:
- Por qué GLM-5.3 y GLM-5.3-Flash representan un avance significativo para las tareas de scraping web impulsadas por LLM.
- Los principales obstáculos en la construcción de sistemas de extracción de datos web y cómo la API Web Unlocker de Bright Data los aborda.
- Una implementación paso a paso del scraping web impulsado por IA usando GLM en Python.
- Cómo realizar scraping web basado en visión con las capacidades multimodales de GLM-5.3.
¡Comencemos!
Ventajas de los modelos GLM para la extracción de datos web
Los LLM modernos han revolucionado el enfoque del scraping web. En lugar de implementar rutinas de parseo manual para procesar el marcado HTML sin procesar, puedes aprovechar un modelo de IA para gestionar la extracción automáticamente. Esto elimina la fragilidad inherente en los enfoques basados en selectores CSS y la coincidencia de expresiones XPath.
Todo lo que necesitas es un prompt bien elaborado que especifique los elementos de datos que necesitas recuperar. Con solo unas pocas líneas de código, puedes indicarle al LLM que identifique y extraiga datos organizados de cualquier página web. Esta metodología impulsada por IA produce scrapers web sustancialmente más robustos cuando cambian las estructuras de las páginas.
En este contexto, GLM-5.3 es excepcionalmente competente en la recuperación de información basada en texto y la generación de datos estructurados. Por su parte, GLM-5.3-Flash incluye funcionalidad de visión, lo que permite analizar capturas de pantalla de páginas web y elementos gráficos.
Para contexto adicional, consulta estos recursos relacionados:
- Principios generales de la metodología de scraping web impulsada por IA.
- Aplicación de IA para la extracción de datos visuales mediante GPT Vision.
Principales desafíos en el scraping web con IA
La extracción basada en IA reduce la sensibilidad a los cambios en el marcado de las páginas. Sin embargo, los principales desafíos técnicos encontrados en el scraping web con IA son en gran medida consistentes con los del scraping web tradicional.
Los principales problemas siguen siendo el renderizado de JavaScript, los sistemas de detección anti-bot, las técnicas de fingerprinting de dispositivos, las limitaciones de velocidad de solicitudes, los CAPTCHAs y los problemas de reputación de IP. Al fin y al cabo, antes de que un LLM pueda procesar una página web, primero debes obtener su contenido. Esto requiere gestionar las diversas medidas de protección diseñadas para evitar el acceso programático.
Por tanto, la extracción impulsada por IA no elimina la dificultad fundamental de obtener contenido de páginas web a escala. Lo que es cierto es que añadir IA al proceso introduce consideraciones adicionales. En particular, el consumo de tokens se convierte en un factor crítico.
Transmitir extensos documentos HTML a modelos avanzados como GLM-5.3 puede acumular costes considerables rápidamente. La solución óptima implica transformar el HTML sin procesar en un formato Markdown optimizado para LLM.
Convertir páginas web en Markdown estructurado preserva la información esencial y la jerarquía de diseño mientras reduce drásticamente el consumo innecesario de tokens. Esta transformación mantiene encabezados, listas numeradas, URLs e imágenes con sus leyendas e hipervínculos en un formato que los LLM pueden procesar eficientemente. Para más detalles, lee nuestro tutorial sobre conversión de HTML a Markdown.
API Web Unlocker de Bright Data: La solución
La API Web Unlocker de Bright Data ofrece una solución todo en uno para los desafíos subyacentes del scraping web. Esto es válido tanto si deseas aplicar parseo tradicional como parseo impulsado por IA.
La API Web Unlocker funciona como un endpoint que acepta una URL de destino y devuelve su contenido renderizado, gestionando todas las protecciones anti-bot. En particular, evita las protecciones CAPTCHA, procesa páginas con uso intensivo de JavaScript, sortea la detección de fingerprinting de navegadores, rota las IPs por ti y mucho más. Obtén más información sobre el enfoque de Bright Data para eludir anti-bots.
Además, la API Web Unlocker ofrece la flexibilidad de devolver los datos recuperados en múltiples formatos de salida, incluyendo:
Como resultado, los datos de respuesta de las solicitudes a la API Web Unlocker sirven como entrada ideal para la posterior extracción de datos basada en texto o en visión con LLMs, como GLM-5.3 y GLM-5.3-Flash.
Nota: La API Web Unlocker está incluida en el nivel gratuito de Bright Data, que otorga 5.000 solicitudes de extracción gratuitas por mes calendario.
Lo que distingue a la API Web Unlocker de otras APIs de scraping web es la infraestructura de nivel empresarial que ofrece Bright Data. Esto incluye más de 400 millones de IPs residenciales, concurrencia ilimitada, tiempo de actividad del 99,99% y una tasa de éxito del 99,95%. Dicha infraestructura permite una extracción de datos programática fiable y altamente escalable.
Cómo construir un scraper web impulsado por IA con GLM-5.3 en Python
En esta sección guiada, aprenderás a desarrollar un script de Python que aprovecha GLM-5.3 para el parseo de datos impulsado por IA.
El script se centra en recopilar datos de esta página de producto específica de IKEA:
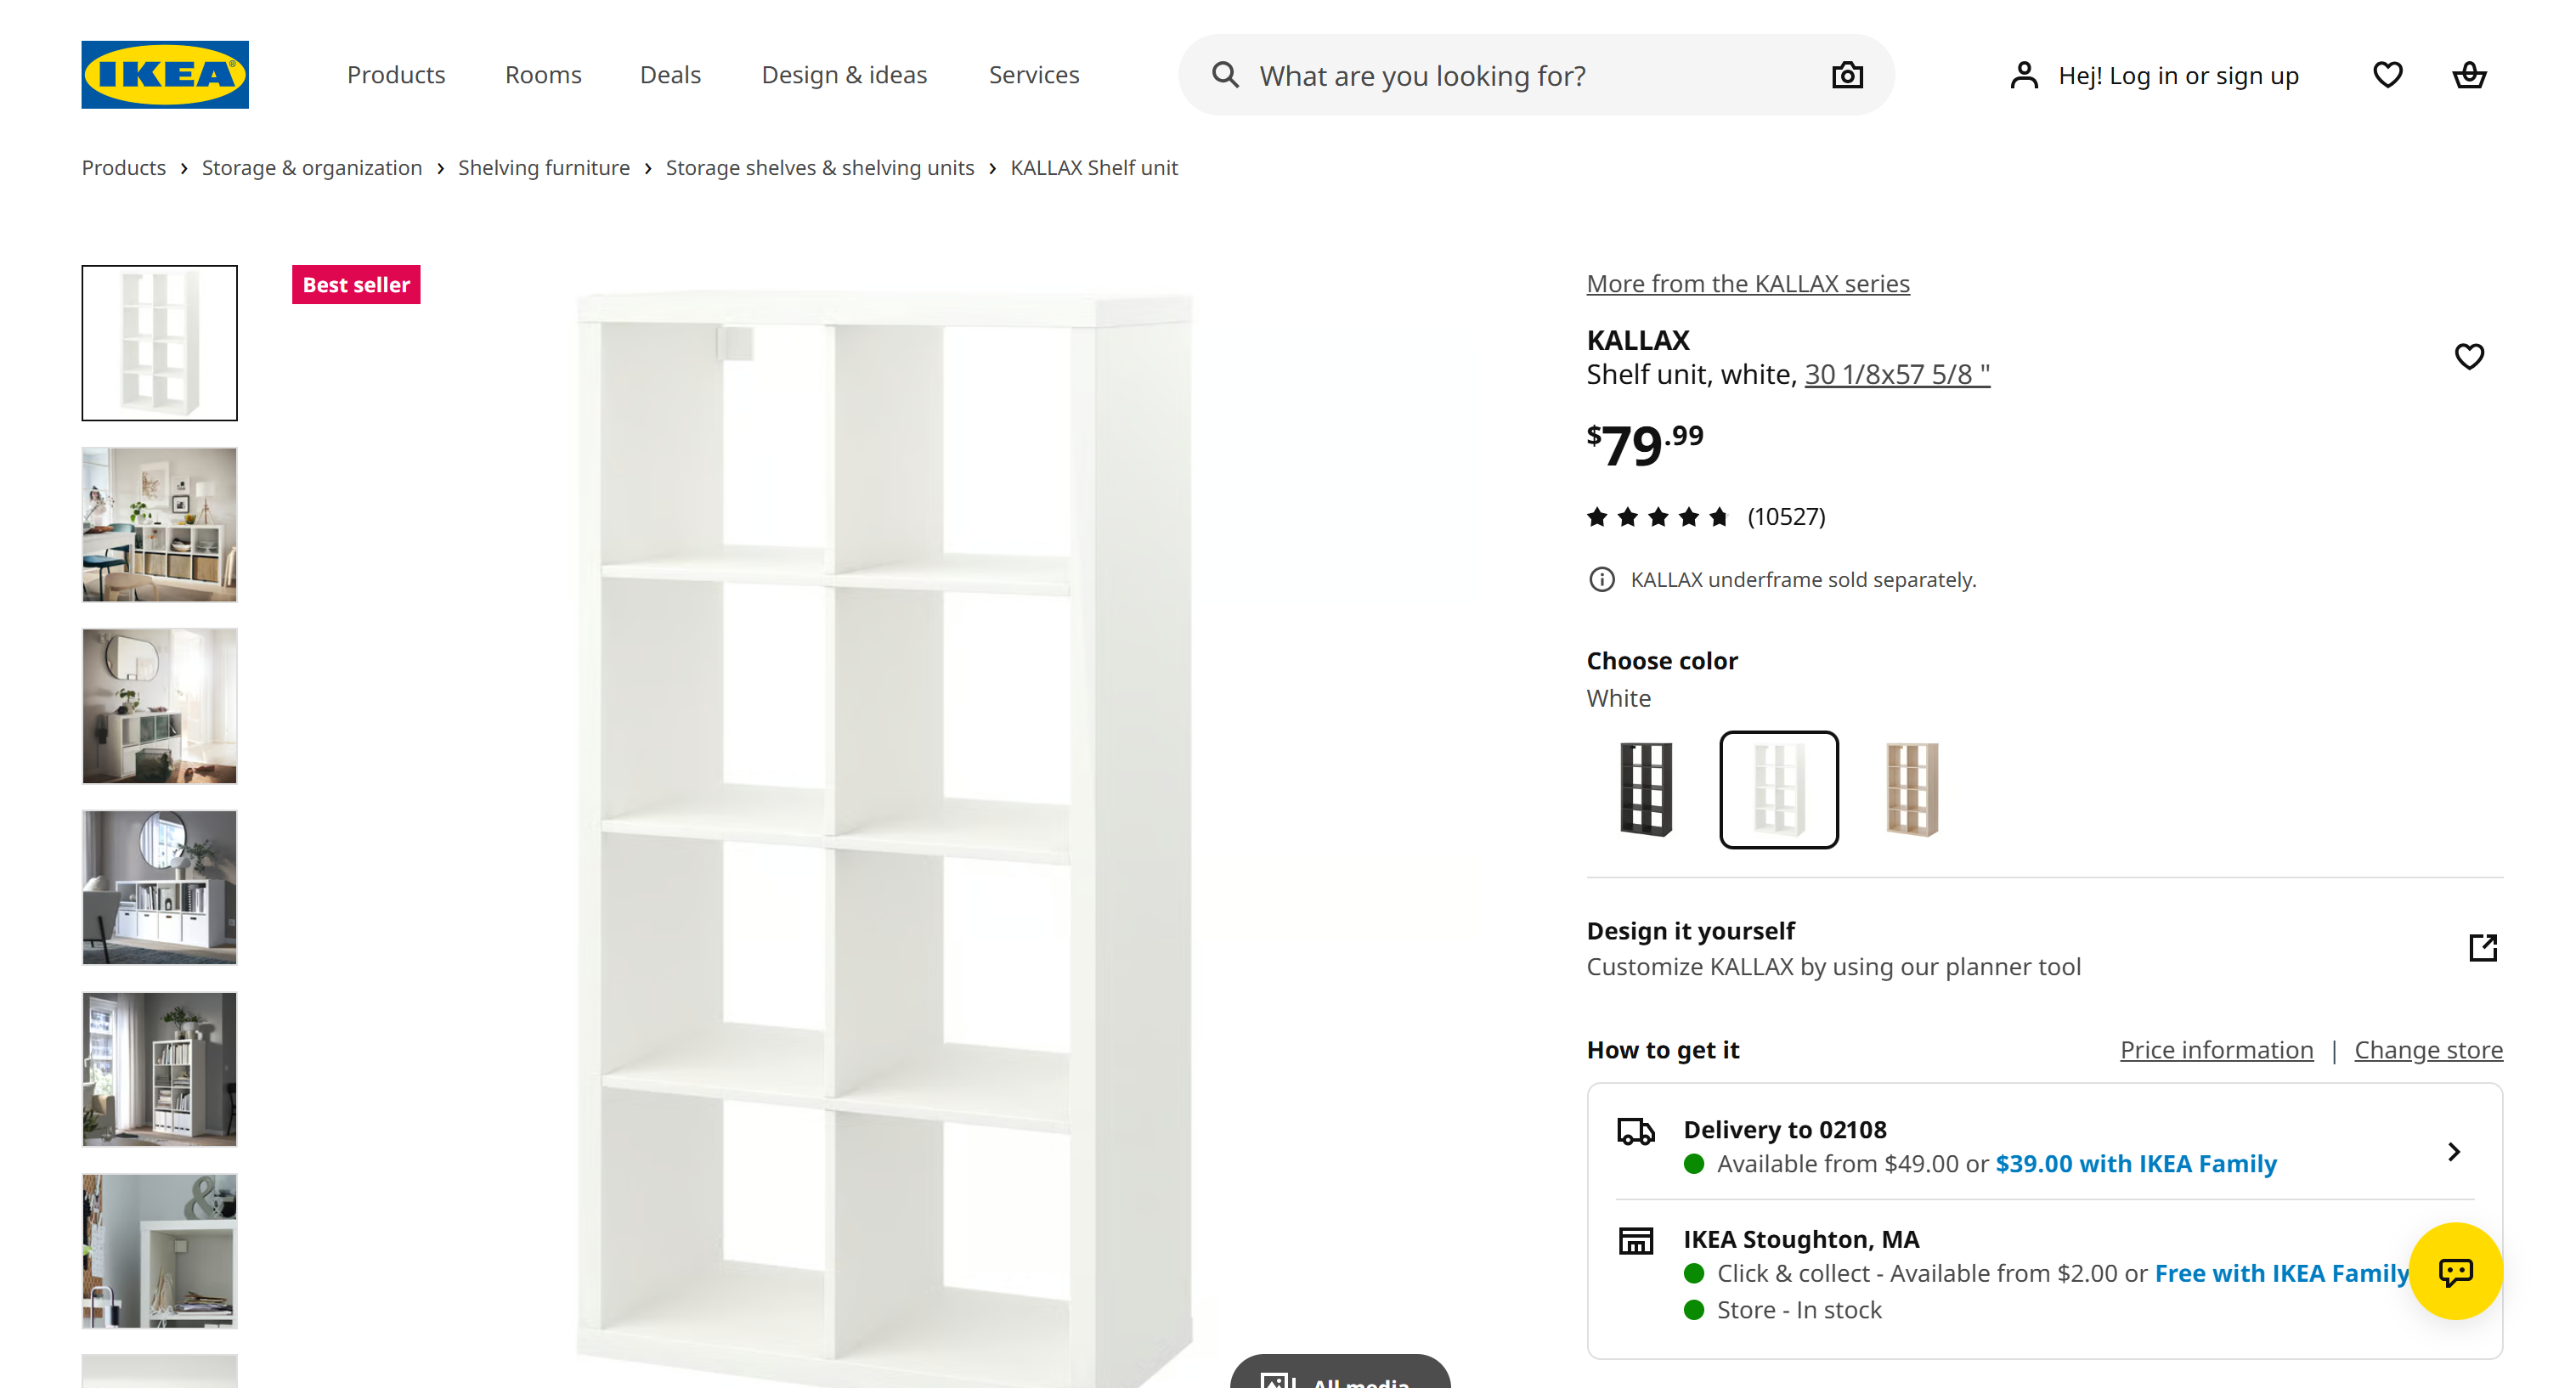
Sin embargo, la principal ventaja del parseo de datos basado en IA es que el mismo código puede aplicarse a todas las páginas de productos de IKEA, independientemente de sus diseños individuales o variaciones de diseño.
El flujo de trabajo será:
- La API Web Unlocker de Bright Data recupera la página de producto de IKEA objetivo y devuelve su contenido como Markdown optimizado para LLM.
- GLM-5.3 recibe el contenido Markdown a través de la API Z.ai compatible con OpenAI y extrae la información del producto.
- El resultado, que se ajusta a un esquema JSON predefinido, se exporta al disco.
Nota: Para sistemas de producción que requieren datos estructurados de productos de IKEA a escala, considera usar la API Scraper de IKEA de Bright Data.
¡Sigue las instrucciones a continuación!
Requisitos previos
Asegúrate de tener disponible:
- Python 3.10 o posterior instalado en tu sistema.
- Una cuenta GLM con fondos y una clave API configurada.
- Una cuenta de Bright Data con una API Web Unlocker y una clave API configuradas.
– Consulta la documentación de configuración de Web Unlocker.
– Sigue la guía oficial para obtener tu clave API de Bright Data.
A lo largo de esta guía, asumiremos que tu zona de API Web Unlocker se llama web_unlocker:
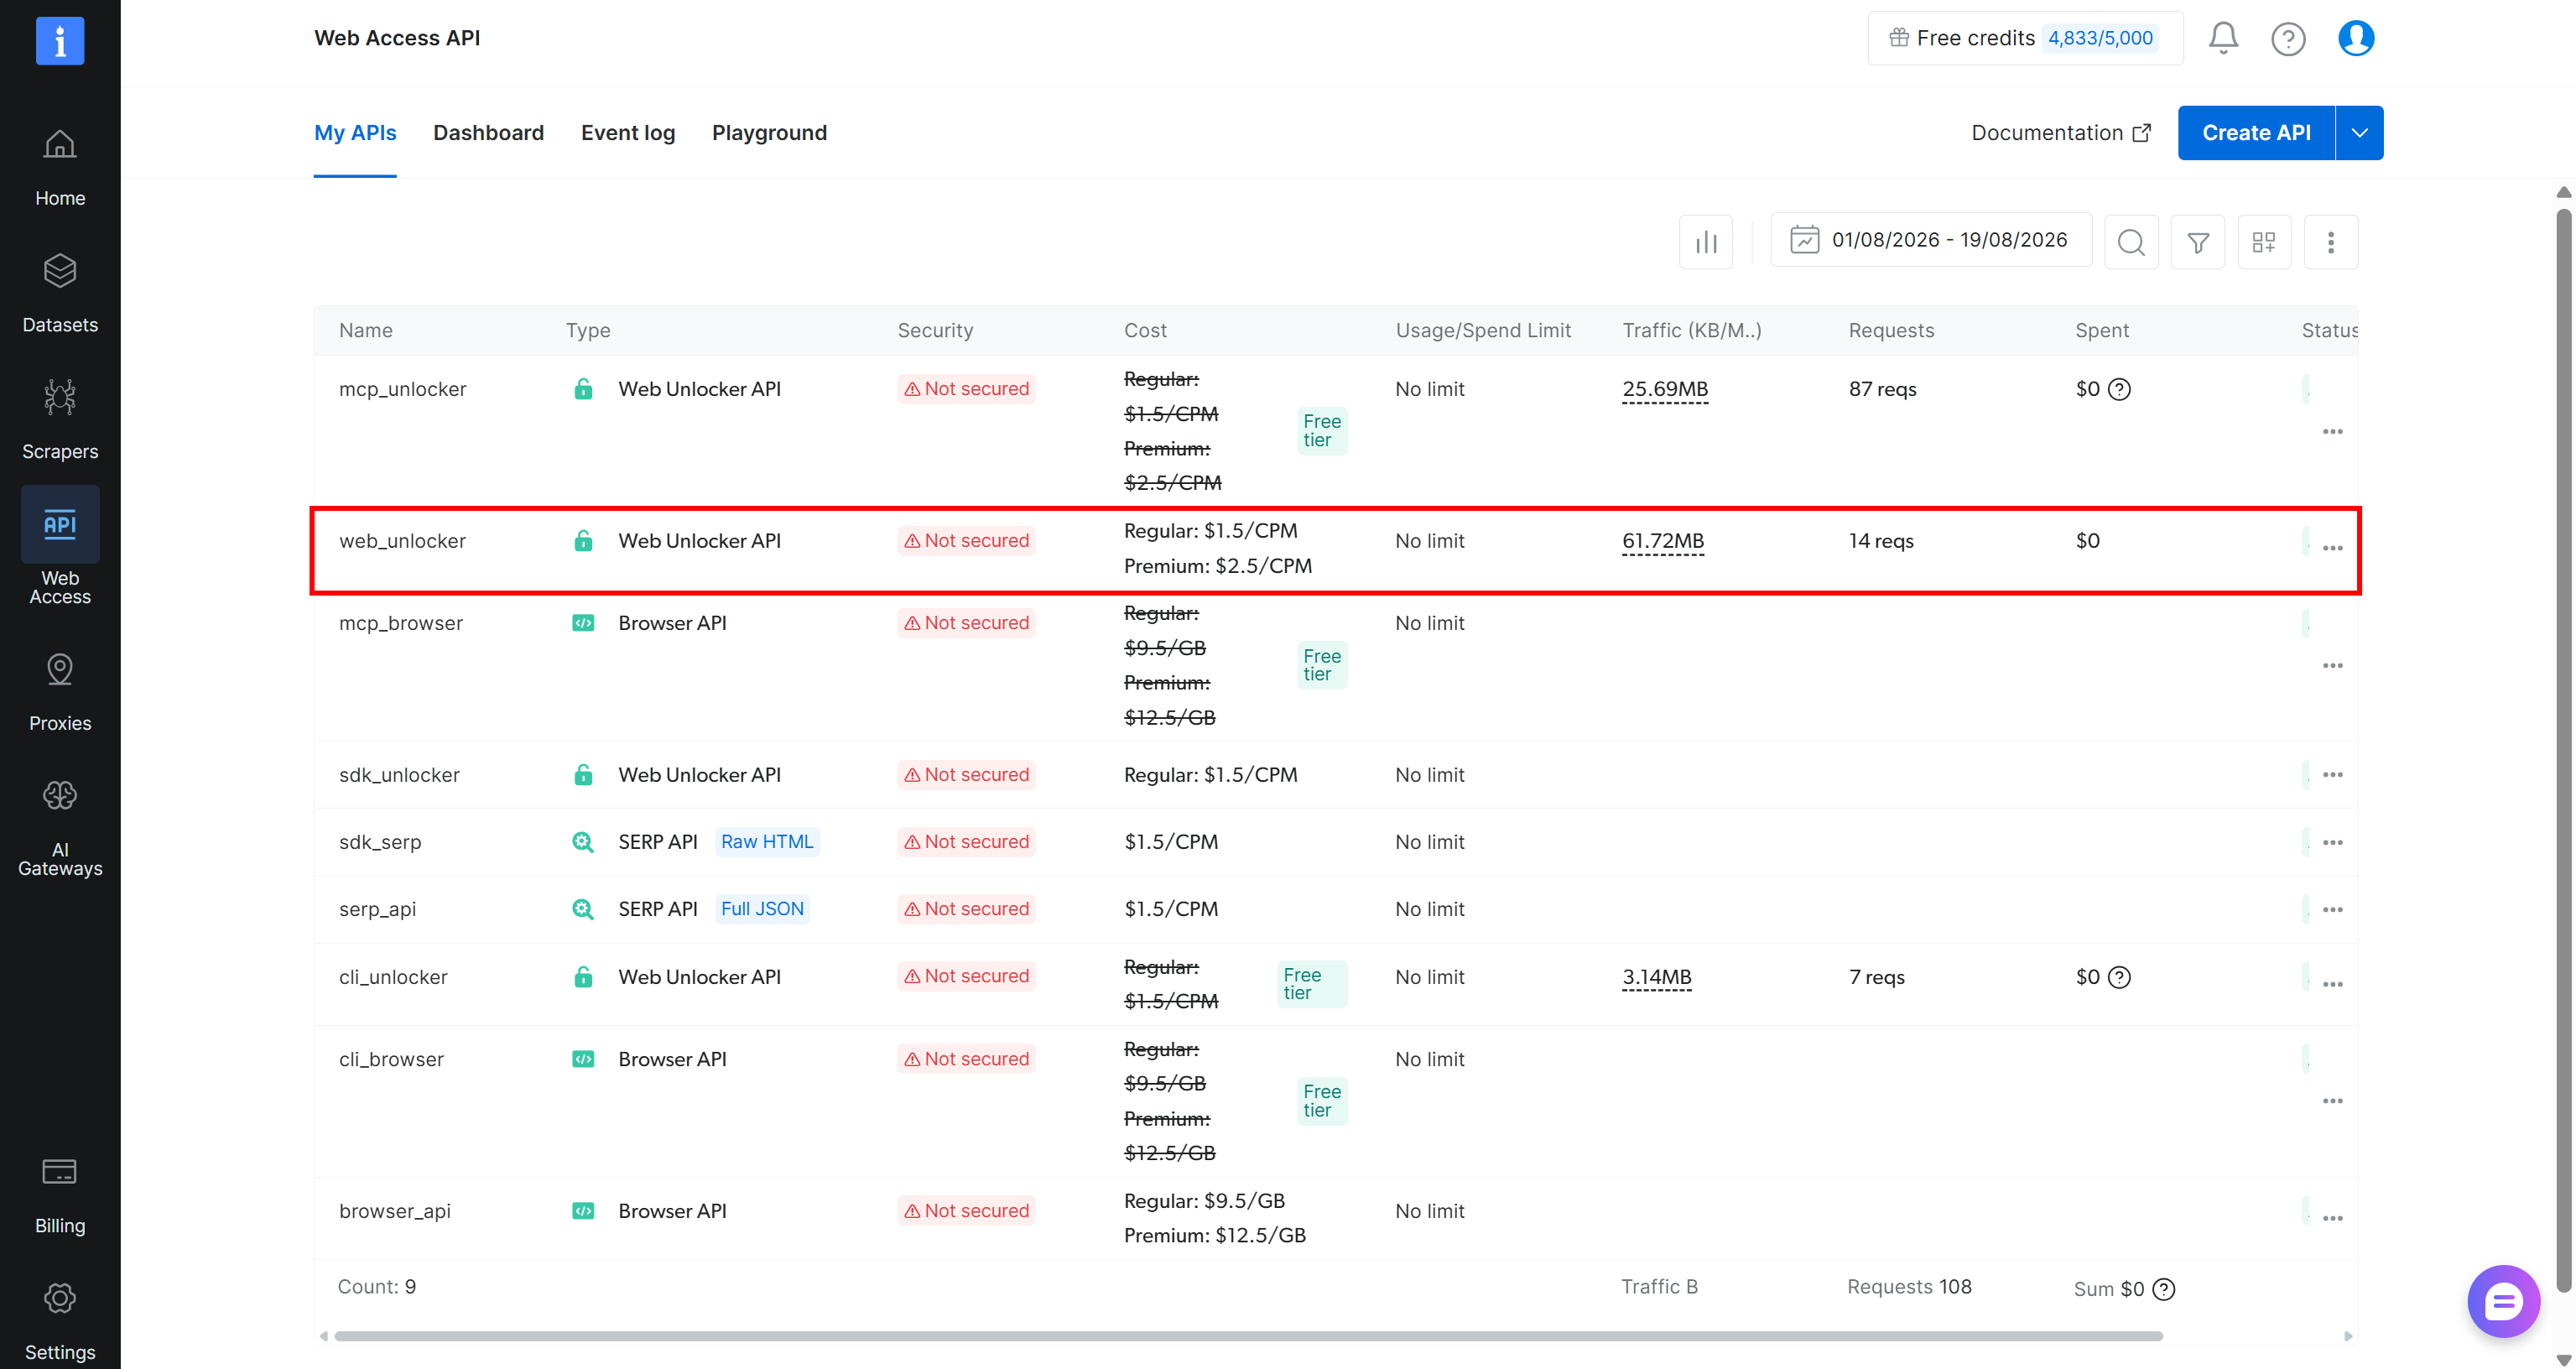
Además, tu clave API de Z.ai tendrá este aspecto:
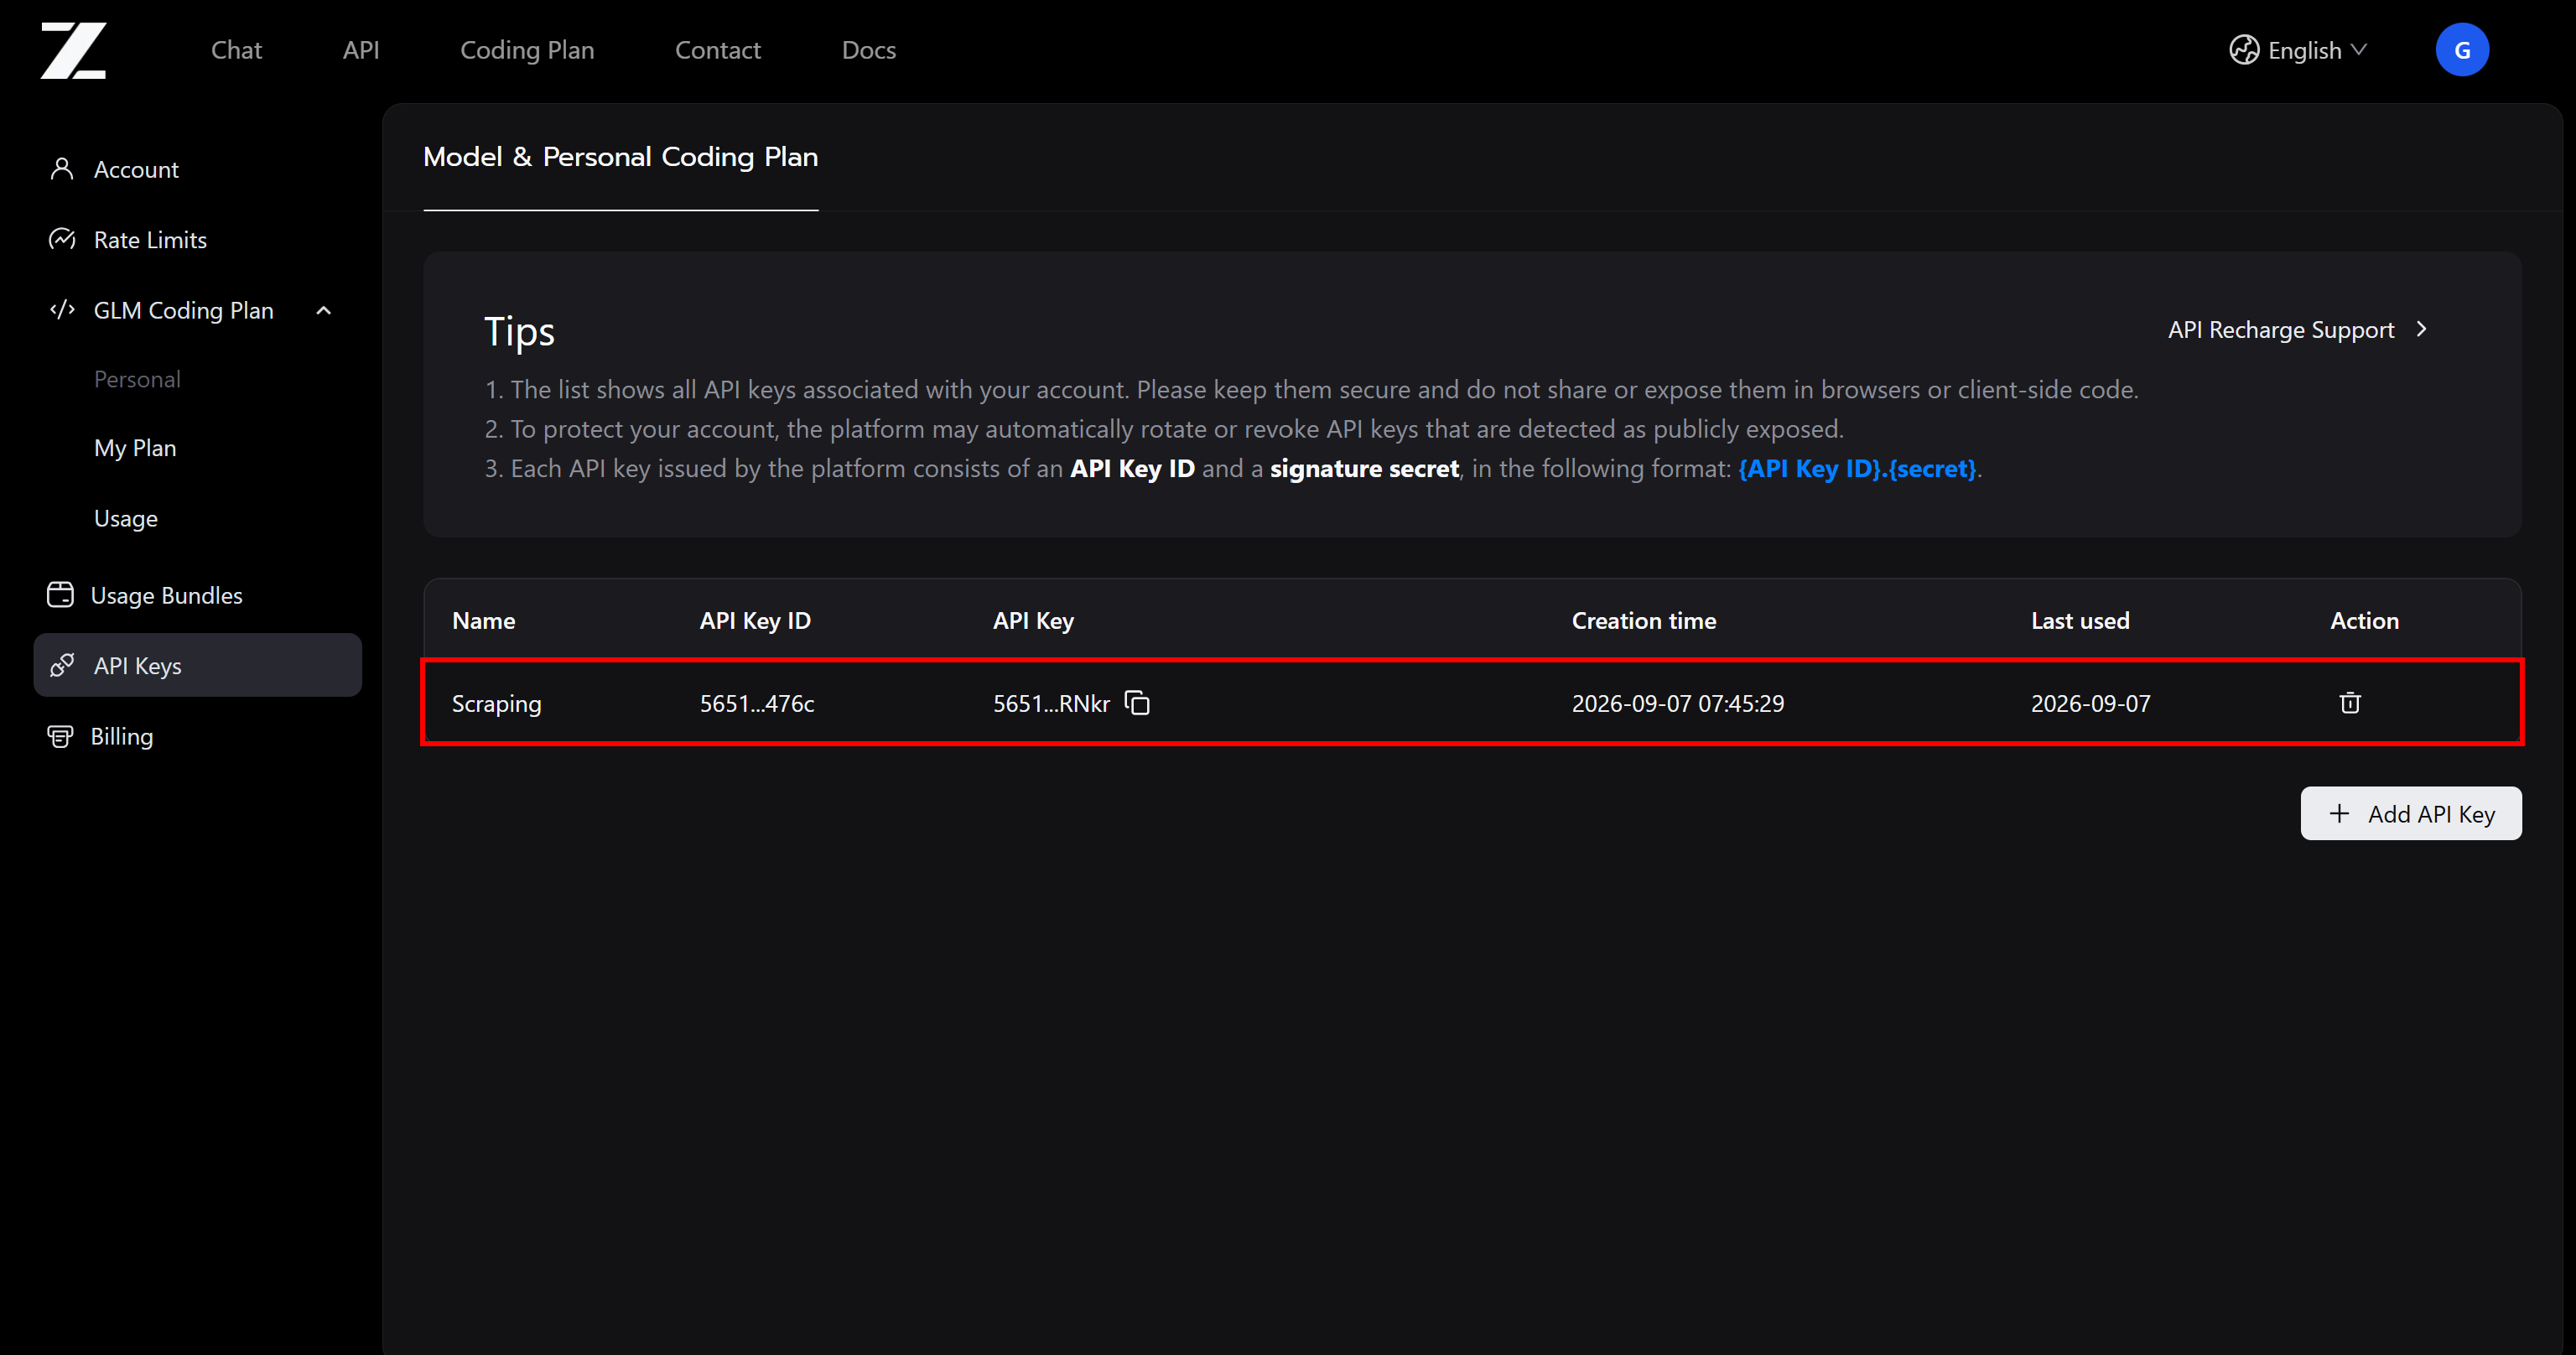
Paso #1: Inicializar un proyecto de Python
Crea un nuevo directorio para tu proyecto de scraping con GLM:
mkdir glm-scraperEntra en este directorio y agrega un entorno virtual de Python dentro de él:
cd glm-scraper
python -m venv .venv
Carga el directorio del proyecto en tu editor de Python preferido, como Visual Studio Code o PyCharm.
En la raíz del proyecto, agrega un archivo scraper.py:
glm-scraper
├─── .venv/
└─── scraper.py # <-----
Este archivo contendrá el código Python para la extracción de datos impulsada por IA usando modelos GLM.
A continuación, activa el entorno virtual. En sistemas Linux o macOS, ejecuta:
source .venv/bin/activateEn plataformas Windows, ejecuta:
.venv\Scripts\activateCon la activación completa, instala todas las dependencias necesarias del proyecto:
pip install dotenv requests openai pydanticLos paquetes requeridos son:
dotenv: Gestión de variables de entorno para almacenar claves API.requests: Cliente HTTP para comunicarse con la API Web Unlocker de Bright Data.openai: Cliente compatible con OpenAI para acceder a las APIs Z.ai compatibles con OpenAI para el acceso a GLM.pydantic: Framework de definición y validación de modelos de datos para el esquema de salida.
¡Bien hecho! Tu proyecto de Python ya está listo para el scraping web con GLM.
Paso #2: Agregar lectura de variables de entorno
Tu scraper GLM requiere autenticación con servicios externos, incluidas las APIs de Bright Data y Z.ai. Estas integraciones exigen claves API, que nunca debes exponer dentro de tu código fuente por razones de seguridad.
En cambio, mantén tus claves API en un archivo de configuración de entorno y cárgalas durante la ejecución. El paquete python-dotenv simplifica este proceso permitiéndote leer variables de entorno desde un archivo .env.
Para comenzar con python-dotenv, agrega este código al inicio de scraper.py:
from dotenv import load_dotenv

# Load the environment variables from the .env file
load_dotenv()
Luego, crea un archivo .env en la raíz del proyecto:
glm-scraper
├─── .venv/
├─── .env       # <-----
└─── scraper.pyConsejo: En un repositorio real, incluye .env en tu configuración de .gitignore para evitar la exposición accidental de credenciales.
Complétalo con tus credenciales de API:
BRIGHT_DATA_API_KEY="<YOUR_BRIGHT_DATA_API_KEY>"
ZAI_API_KEY="<YOUR_ZAI_API_KEY>"
Reemplaza:
<YOUR_BRIGHT_DATA_API_KEY>con tus credenciales de API de Bright Data.<YOUR_ZAI_API_KEY>con tu clave API de Z.ai.
A continuación, carga estas variables de entorno en tu script usando os.getenv() de Python:
import os

# Loading the required secrets from the envs
ZAI_API_KEY = os.environ.get("ZAI_API_KEY")
BRIGHT_DATA_API_KEY = os.environ.get("BRIGHT_DATA_API_KEY")
¡Fantástico! Ahora tienes acceso seguro a tus claves API en tu script de Python.
Paso #3: Obtener la página web objetivo en formato Markdown con la API Web Unlocker
La primera fase del scraping impulsado por IA implica obtener la página objetivo, idealmente en formato Markdown listo para LLM. La API Web Unlocker de Bright Data ofrece la forma más sencilla de lograrlo.
Para más orientación sobre la integración de Web Unlocker, consulta la documentación oficial o examina los ejemplos de integración de Python de Bright Data.
Utiliza la biblioteca requests para enviar una solicitud HTTP POST a Web Unlocker y recuperar la página objetivo renderizada como Markdown:
import requests

# Set up the authentication headers for Web Unlocker
headers = {
    "Content-Type": "application/json",
    "Authorization": f"Bearer {BRIGHT_DATA_API_KEY}"
}

# Define the request payload for the Web Unlocker API call
payload = {
    "zone": "web_unlocker", # Replace with your Web Unlocker zone name
    "url": "https://www.ikea.com/us/en/p/kallax-shelf-unit-white-20631663/", # The IKEA product page URL you want to scrape
    "format": "raw",
    "country": "us",
    "data_format": "markdown" # Request Markdown-formatted output
}

# Retrieve the unlocked content of the target page
web_unlocker_response = requests.post(
    "https://api.brightdata.com/request",
    json=payload,
    headers=headers
)
markdown_page = web_unlocker_response.text
Si no estás familiarizado con la sintaxis HTTP de Python, revisa nuestra guía completa de Requests.
Observa el parámetro data_format="markdown" en el cuerpo. Esta configuración indica a la API Web Unlocker que devuelva la página web en formato Markdown en lugar de proporcionar HTML sin procesar.
Imprime markdown_page y verás:
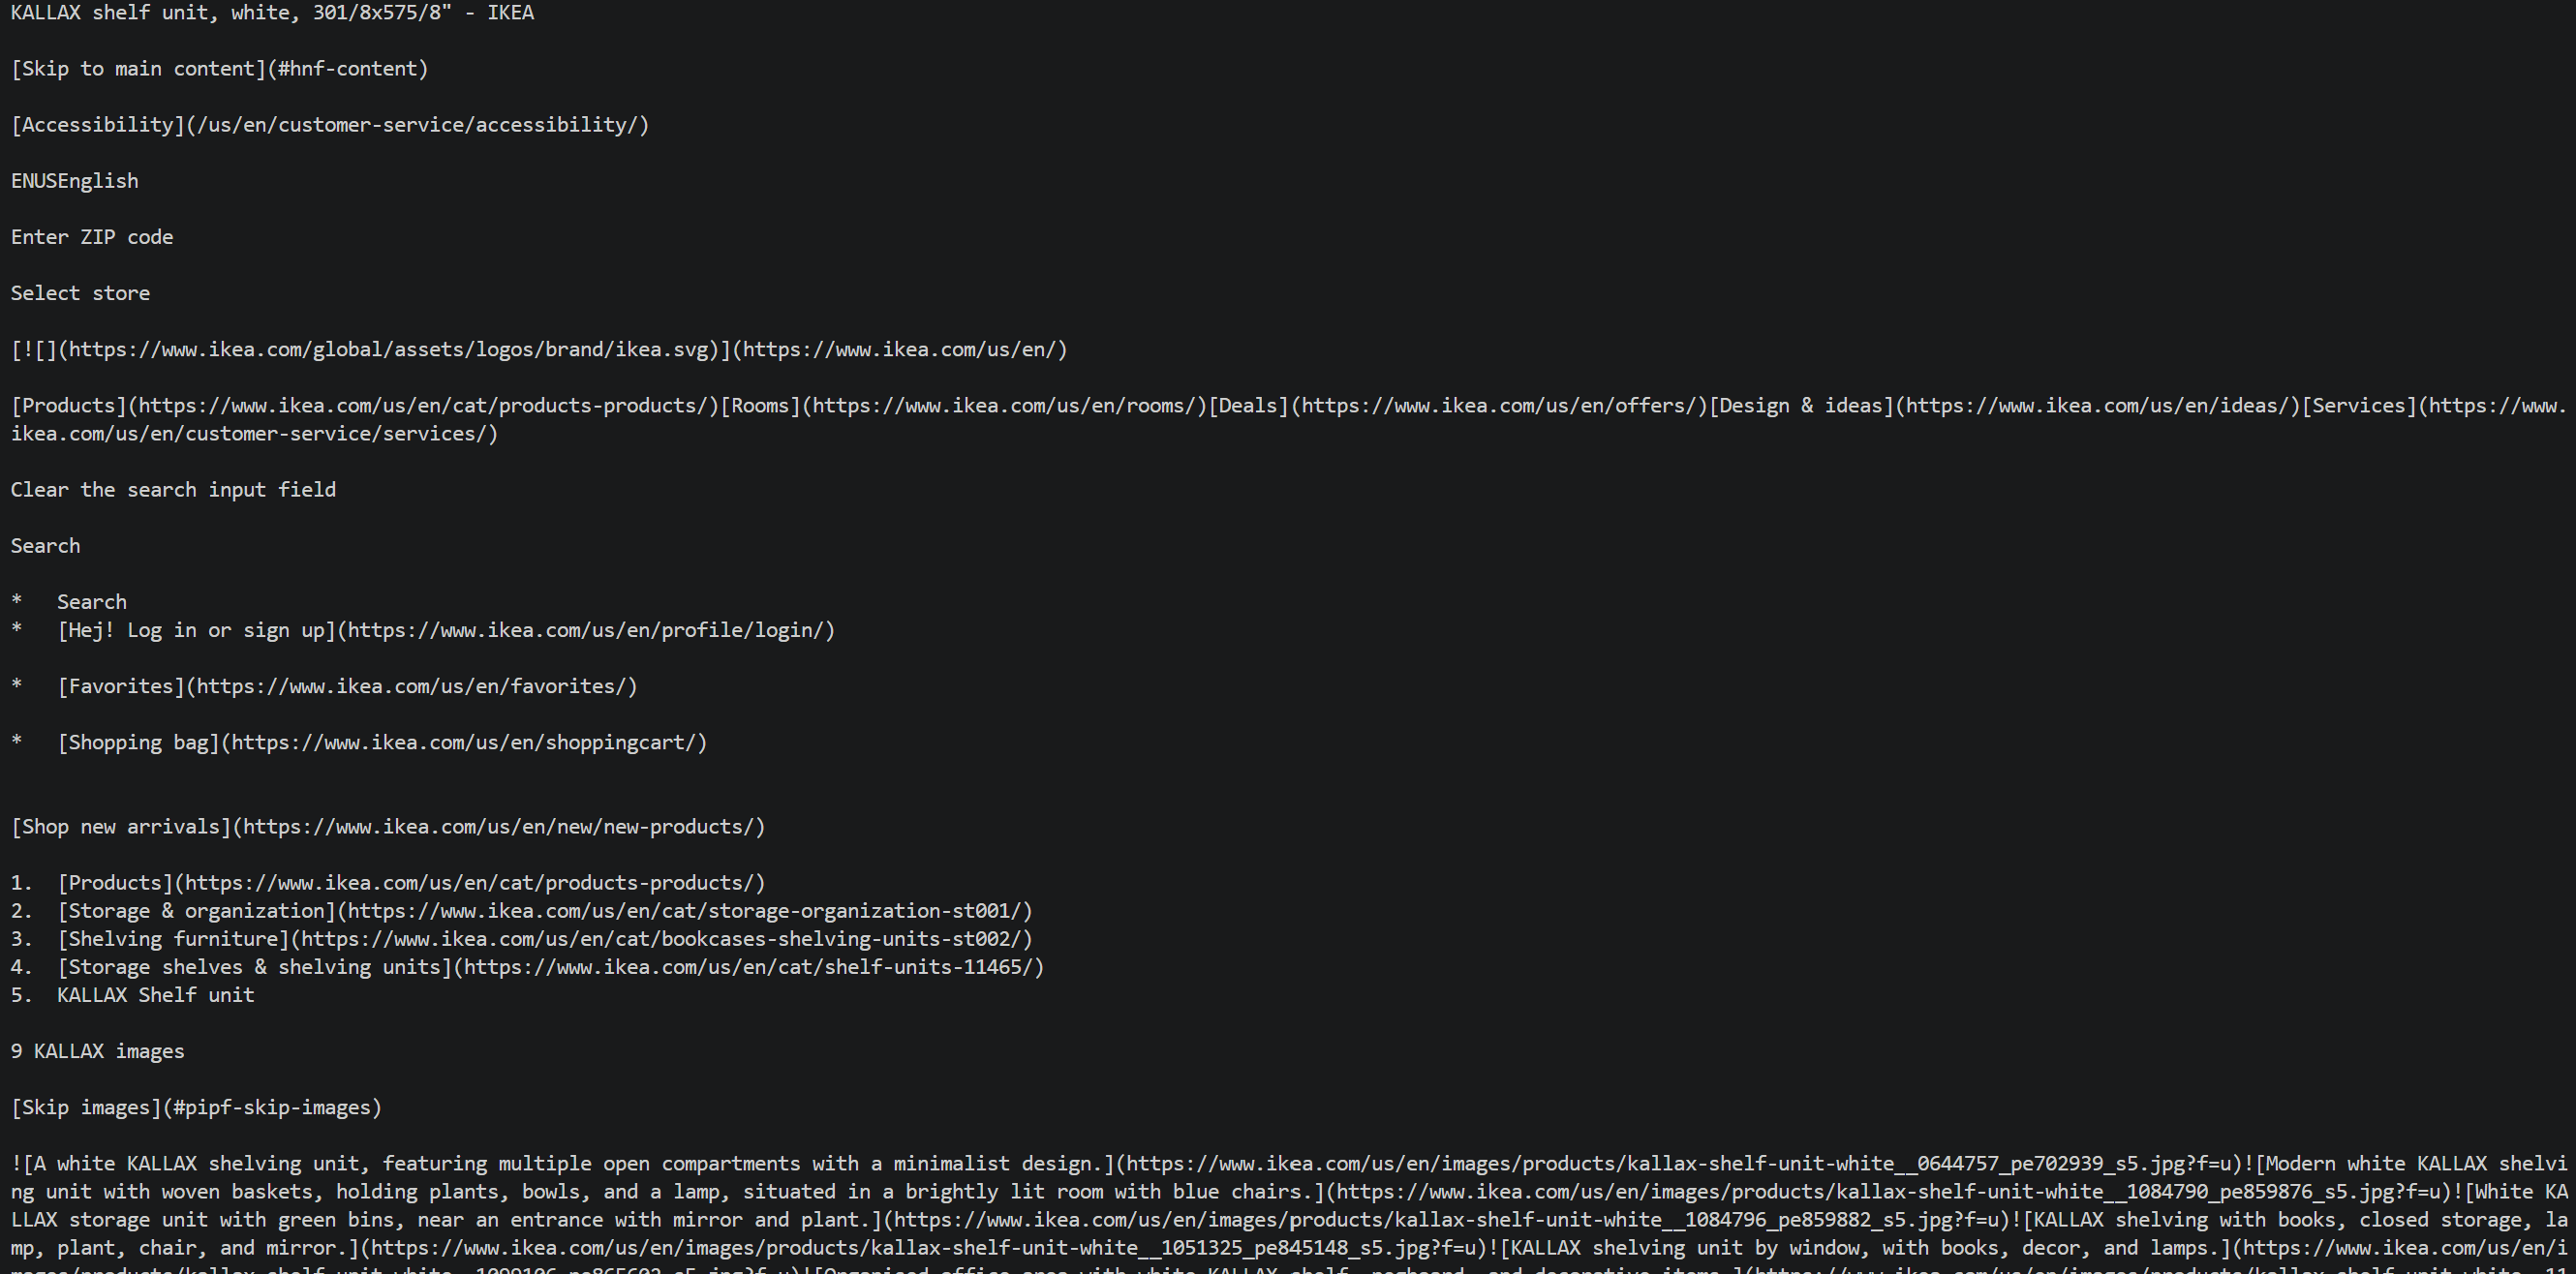
La salida devuelta representa la versión convertida a Markdown de tu página de producto de IKEA objetivo.
Observa cómo la API Web Unlocker se encarga de los obstáculos de la recuperación de páginas web:
- Acceder a la infraestructura de IKEA objetivo a través de la red de proxies residenciales de Bright Data.
- Gestionar las contramedidas anti-bot típicas, como los sistemas anti-scraping de IKEA.
- Obtener el marcado de la página completamente renderizada.
- Transformar el HTML en Markdown optimizado para LLM y devolver el resultado.
Ahora tienes la información de la página en un formato perfecto para el parseo de datos basado en texto con GLM-5.3. ¡Antes de continuar, establece la estructura de salida que GLM generará!
Paso #4: Definir el esquema JSON de salida
GLM-5.3, como la mayoría de los LLM, produce salida de texto de forma predeterminada. Esto es subóptimo para los flujos de trabajo de extracción de datos, donde el objetivo es convertir el contenido web sin procesar en datos estructurados.
Afortunadamente, la API de GLM-5.3 admite salida estructurada a través del modo JSON. Esta funcionalidad permite que el modelo devuelva una cadena JSON simple.
Nota: Si bien no puedes especificar el esquema directamente en el argumento json_schema como puedes hacerlo con las salidas estructuradas de OpenAI, puedes mencionar la estructura de respuesta deseada en el prompt. Esto obligará al modelo a producir una cadena JSON que se ajuste a ese formato.
El método más conveniente para definir esquemas JSON estructurados en Python es a través de Pydantic, el framework de modelado de datos más popular. Pydantic te ayuda a representar estructuras de datos mediante clases de Python, que pueden convertirse en formato JSON Schema para la API Z.ai.
Comienza examinando la página de IKEA objetivo para identificar los campos de información requeridos. Para este ejemplo, define un modelo Pydantic que capture los detalles del producto de IKEA:
from pydantic import BaseModel, Field
from typing import List, Optional

class IkeaProduct(BaseModel):
    title: Optional[str] = Field(None, description="Full product title as displayed on the IKEA website")
    product_number: Optional[str] = Field(None, description="IKEA product article number, such as 304.247.75")
    product_type: Optional[str] = Field(None, description="General type of IKEA product, such as armchair, shelf unit, cabinet, or table")
    price: Optional[float] = Field(None, description="Current one-time purchase price")
    currency: Optional[str] = Field(None, description="Currency used for the displayed price, such as USD")
    color: Optional[str] = Field(None, description="Product color or finish, such as birch veneer or dark gray")
    dimensions: Optional[str] = Field(None, description="Overall product dimensions as displayed by IKEA, including width, depth, and height")
    materials: Optional[List[str]] = Field(None, description="Main materials used to manufacture the product")
    rating: Optional[float] = Field(None, description="Average customer rating, typically on a 5-point scale")
    review_count: Optional[int] = Field(None, description="Total number of customer reviews")
    series: Optional[str] = Field(None, description="IKEA product series the item belongs to, such as POÄNG")
    assembly_required: Optional[bool] = Field(None, description="Whether the product requires assembly")
    is_in_stock: Optional[bool] = Field(True, description="Whether the product is currently available for purchase")
Este modelo organiza la información del producto de IKEA en campos Pydantic con tipado explícito. GLM-5.3 recuperará los valores coincidentes del contenido de la página y los entregará como una respuesta en cadena JSON que respeta este esquema.
Consejo profesional: Pasa el Markdown recuperado de la página por la API Web Unlocker a un LLM y pídele que genere un modelo Pydantic que contenga todos los puntos de datos que te interesan.
¡Excelente! Ahora tienes todos los componentes necesarios para el scraping web con GLM.
Paso #5: Usar GLM-5.3 para el parseo automatizado de datos
La API Z.ai es compatible con las interfaces OpenAI Chat Completions y Responses, lo que permite el acceso a través del SDK de Python de OpenAI. Configura el cliente OpenAI con tus credenciales de API de Z.ai y la URL base de API apropiada.
from openai import OpenAI

# Initialize the OpenAI client for interacting with Z.ai API
glm_client = OpenAI(
    api_key=ZAI_API_KEY,
    base_url="https://api.z.ai/api/paas/v4/", # OpenAI Chat Completions-compatible GLMM API base URL
)
Luego, emplea el endpoint de Chat Completions para transmitir el Markdown extraído a GLM-5.3:
import json

# Prepare the scraping prompt with the output schema
scraping_prompt = f"""
Extract the IKEA product information from the given Markdown document and
return it as structured data that conforms to the provided JSON schema.

SCHEMA:
{json.dumps(IkeaProduct.model_json_schema(), indent=2)}

MARKDOWN:
{markdown_page}
"""

# Perform web data parsing with GLM-5.3
response = glm_client.chat.completions.create(
    model="glm-5.3",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "text",
                    "text": scraping_prompt,
                },
            ],
        }
    ],
    response_format={"type": "json_object"}
)

# Get the parsed data in a string matching the defined schema format
product_data = response.choices[0].message.content
Ten en cuenta que el prompt debe incluir:
- Tus instrucciones de extracción de datos web.
- El esquema JSON objetivo.
- El contenido Markdown de la API Web Unlocker de Bright Data.
El parámetro response_format habilita el modo JSON con {"type": "json_object"}. Recuerda que GLM-5.3 admite el formato json_object en lugar de json_schema. Esa es una distinción crítica respecto a algunos modelos alternativos, como cuando se realiza scraping web con Kimi.
Nota: Los parámetros opcionales thinking y reasoning_effort activan las capacidades de razonamiento extendido de GLM-5.3. Establece reasoning_effort en "max" para habilitar el razonamiento profundo en tareas de parseo de datos muy complejas. Esto es particularmente valioso cuando las páginas contienen diseños ambiguos o no estándar.
El resultado es product_data, que contiene una cadena JSON con la información extraída estructurada según tu modelo IkeaProduct. Imprímelo y verás:
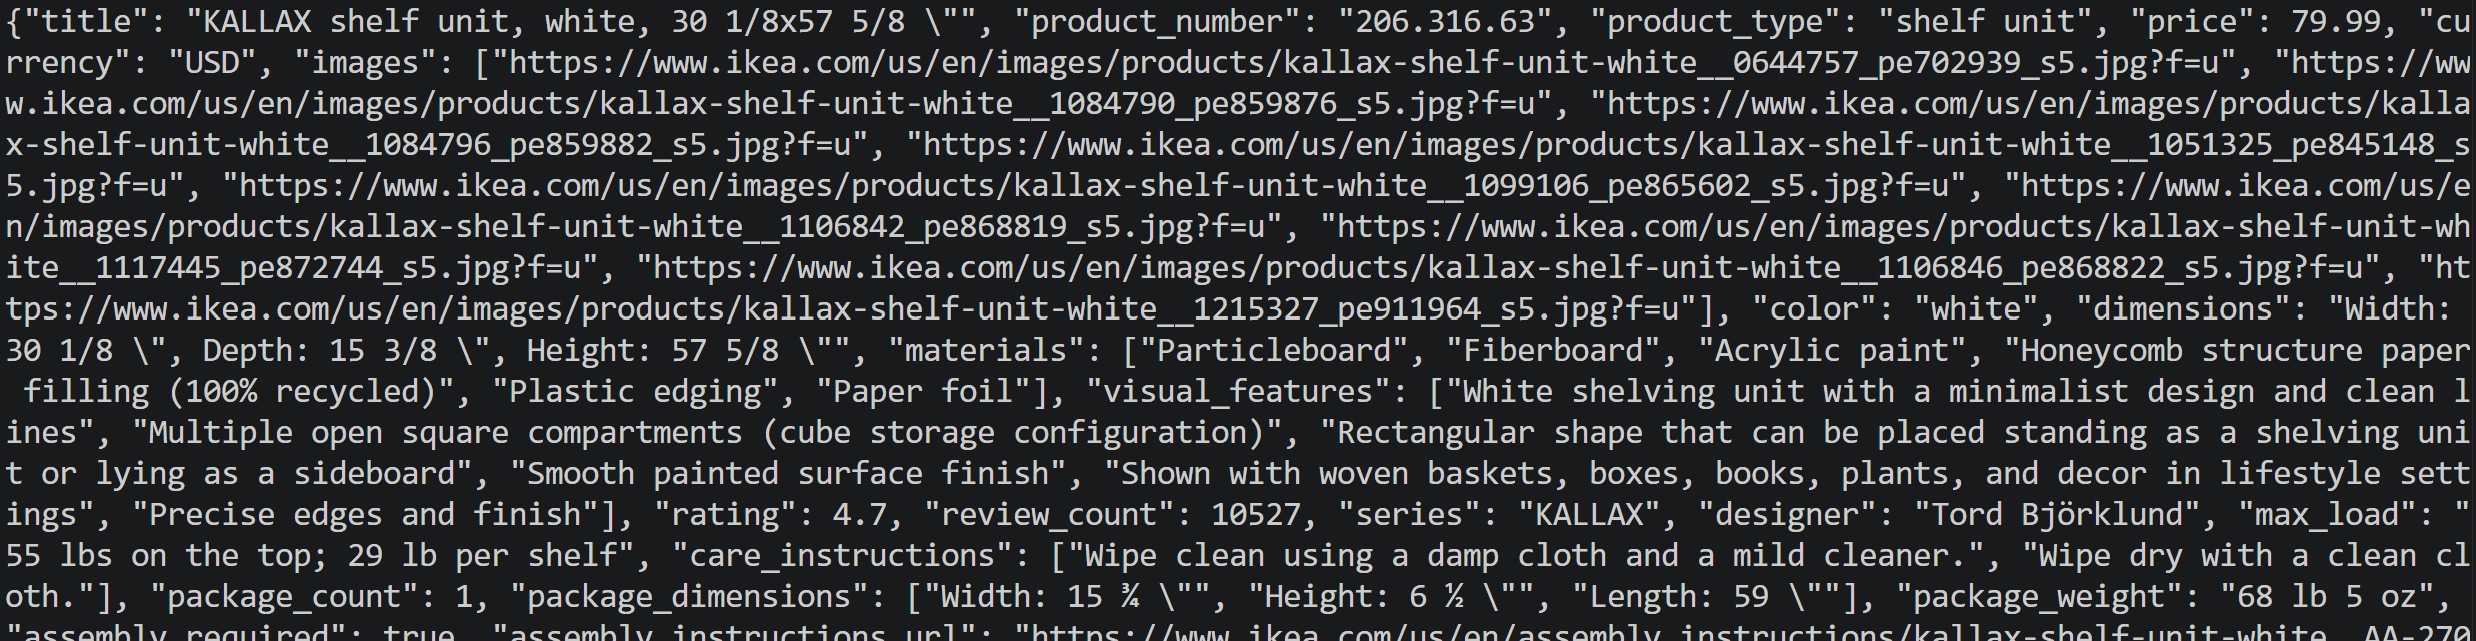
¡Genial! El único paso restante es persistir estos datos JSON en el disco.
Paso #6: Guardar los datos extraídos en el disco
Antes de almacenar product_data en un archivo product.json, valida la respuesta con el modelo Pydantic IkeaProduct:
# Get the parsed data in the defined schema format
product_data = response.choices[0].message.content

# Validate the JSON string against the IkeaProduct schema
product = IkeaProduct.model_validate_json(product_data)
El método model_validate_json() verifica que la respuesta del LLM se ajuste al esquema Pydantic esperado. Si la respuesta contiene datos inválidos o no coincide con los tipos de campo definidos, Pydantic genera un error de validación en lugar de guardar silenciosamente datos malformados.
Luego, persístelo en el disco:
# Export the validated IkeaProduct object to a JSON file
with open("product.json", "w", encoding="utf-8") as f:
    f.write(product.model_dump_json(indent=2))
Este fragmento usa product.model_dump_json() para serializar el objeto IkeaProduct validado y luego lo escribe en product.json. El archivo resultante contendrá los datos estructurados del producto de IKEA extraídos por GLM-5.3. ¡Misión cumplida!
Paso #7: Unir todo
A continuación se muestra la implementación completa de tu scraper web GLM para páginas de productos de IKEA:
# pip install dotenv requests openai pydantic

from dotenv import load_dotenv
import os
import requests
from pydantic import BaseModel, Field
from typing import List, Optional
from openai import OpenAI
import json

# Load the environment variables from the .env file
load_dotenv()

# Loading the required secrets from the envs
BRIGHT_DATA_API_KEY = os.environ.get("BRIGHT_DATA_API_KEY")
ZAI_API_KEY = os.environ.get("ZAI_API_KEY")

# The output schema for the product information
class IkeaProduct(BaseModel):
    title: Optional[str] = Field(None, description="Full product title as displayed on the IKEA website")
    product_number: Optional[str] = Field(None, description="IKEA product article number, such as 304.247.75")
    product_type: Optional[str] = Field(None, description="General type of IKEA product, such as armchair, shelf unit, cabinet, or table")
    price: Optional[float] = Field(None, description="Current one-time purchase price")
    currency: Optional[str] = Field(None, description="Currency used for the displayed price, such as USD")
    images: Optional[List[str]] = Field(None, description="URLs of product images from the IKEA website")
    color: Optional[str] = Field(None, description="Product color or finish, such as birch veneer or dark gray")
    dimensions: Optional[str] = Field(None, description="Overall product dimensions as displayed by IKEA, including width, depth, and height")
    materials: Optional[List[str]] = Field(None, description="Main materials used to manufacture the product")
    visual_features: Optional[List[str]] = Field(None, description="Physical characteristics visible in the supplied product images, such as shape, components, finish, or configuration")
    rating: Optional[float] = Field(None, description="Average customer rating, typically on a 5-point scale")
    review_count: Optional[int] = Field(None, description="Total number of customer reviews")
    series: Optional[str] = Field(None, description="IKEA product series the item belongs to, such as POÄNG")
    designer: Optional[str] = Field(None, description="Designer credited by IKEA for the product")
    max_load: Optional[str] = Field(None, description="Maximum supported load, such as maximum load on a seat, shelf, or tabletop")
    care_instructions: Optional[List[str]] = Field(None, description="IKEA-recommended care and cleaning instructions")
    package_count: Optional[int] = Field(None, description="Number of packages included with the product")
    package_dimensions: Optional[List[str]] = Field(None, description="Dimensions of the product packaging")
    package_weight: Optional[str] = Field(None, description="Weight of the packaged product")
    assembly_required: Optional[bool] = Field(None, description="Whether the product requires assembly")
    assembly_instructions_url: Optional[str] = Field(None, description="URL to the official IKEA assembly instructions")
    safety_information: Optional[List[str]] = Field(None, description="Important safety information, such as wall anchoring or tipping requirements")
    good_to_know: Optional[List[str]] = Field(None, description="Additional IKEA product information and usage recommendations")
    compatible_series: Optional[List[str]] = Field(None, description="IKEA product series or furniture lines that the product is described as coordinating with")
    accessories: Optional[List[str]] = Field(None, description="Accessories or complementary IKEA products shown or recommended on the product page")
    category_path: Optional[List[str]] = Field(None, description="IKEA category breadcrumb path leading to the product")
    available_colors: Optional[List[str]] = Field(None, description="Other color or finish options available for the same product")
    is_in_stock: Optional[bool] = Field(True, description="Whether the product is currently available for purchase")

# Set up the authentication headers for the Web Unlocker API
headers = {
    "Content-Type": "application/json",
    "Authorization": f"Bearer {BRIGHT_DATA_API_KEY}"
}

# Define the request payload for the Web Unlocker API scraping request
payload = {
    "zone": "web_unlocker", # Replace with your Web Unlocker zone name
    "url": "https://www.ikea.com/us/en/p/kallax-shelf-unit-white-20631663/", # The IKEA product page URL you want to scrape
    "format": "raw",
    "country": "us",
    "data_format": "markdown" # To get the web page in Markdown
}

# Retrieve the Markdown content of the unlocked target page
web_unlocker_response = requests.post(
    "https://api.brightdata.com/request",
    json=payload,
    headers=headers
)
markdown_page = web_unlocker_response.text

# Initialize the OpenAI client for Z.ai models
glm_client = OpenAI(
    api_key=ZAI_API_KEY,
    base_url="https://api.z.ai/api/paas/v4/",
)

# Prompt to LLM-powered web data parsing
scraping_prompt = f"""
Extract the IKEA product information from the given Markdown document and
return it as structured data that conforms to the provided JSON schema.

SCHEMA:
{json.dumps(IkeaProduct.model_json_schema(), indent=2)}

MARKDOWN:
{markdown_page}
"""

# Perform web data scraping with GLM-5.3
response = glm_client.chat.completions.create(
    model="glm-5.3",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "text",
                    "text": scraping_prompt,
                },
            ],
        }
    ],
    response_format={"type": "json_object"},
)

# Get the parsed data in the defined schema format
product_data = response.choices[0].message.content

# Convert the JSON string into a validated IkeaProduct object
product = IkeaProduct.model_validate_json(product_data)

# Export the IkeaProduct object to a JSON file
with open("product.json", "w", encoding="utf-8") as f:
    f.write(product.model_dump_json(indent=2))
En tu entorno virtual activado, ejecuta el script de Python con:
python scraper.pyLa recuperación de la página a través de la API Web Unlocker y el posterior procesamiento a través de GLM-5.3 llevan tiempo. Ten paciencia mientras se produce el archivo product.json.
Una vez que aparezca en la carpeta de tu proyecto, ábrelo y verás:
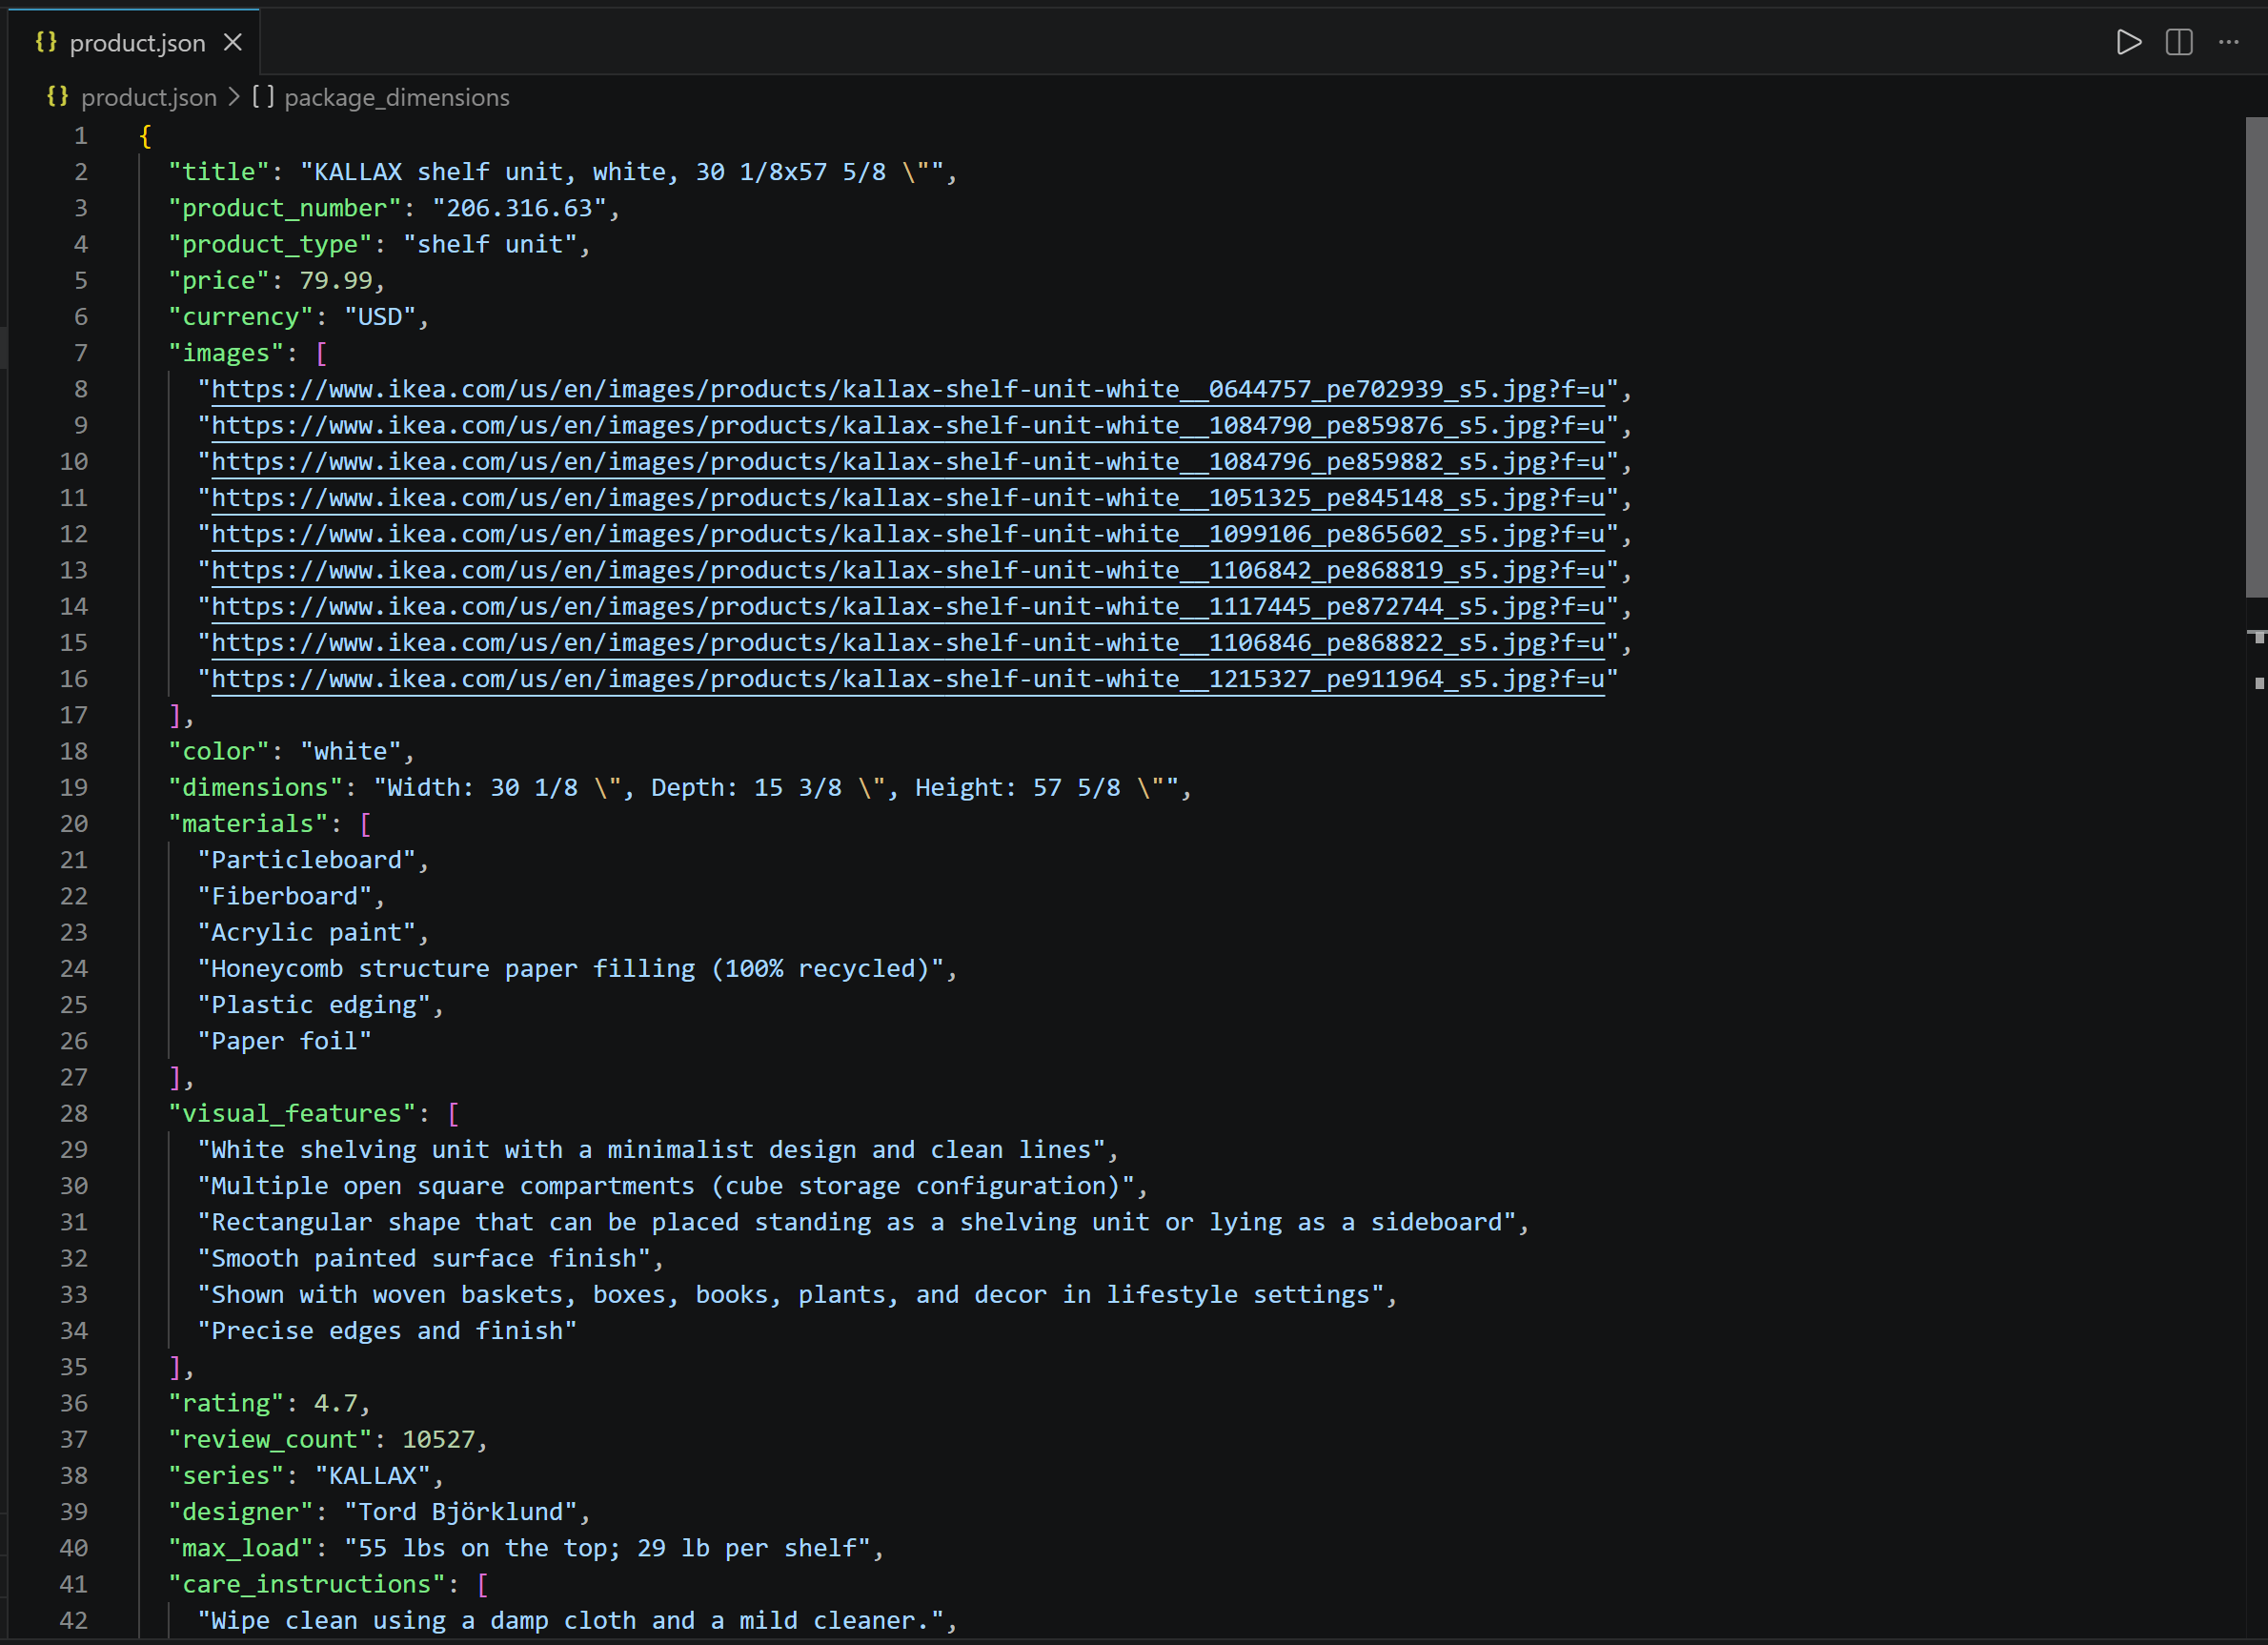
Observa la alineación entre los datos extraídos y la información disponible en la página de producto original de IKEA.
¡Et voilà! La API Web Unlocker gestionó las protecciones anti-bot de IKEA y entregó el contenido Markdown optimizado para LLM, mientras que GLM-5.3 procesó exitosamente ese contenido y lo transformó en datos bien organizados y estructurados.
Cómo realizar la extracción de datos web basada en visión con GLM-5.3-Flash
GLM-5.3 no admite de forma nativa la entrada multimodal, lo que significa que solo puede procesar entradas basadas en texto. Sin embargo, otros modelos de la familia GLM admiten entrada multimodal, incluido GLM-5.3-Flash (así como GLM-4.6V y otros).
En lugar de proporcionar al LLM contenido textual de la página, puedes proporcionar una captura de pantalla o imagen y pedirle a GLM-5.3-Flash que extraiga información estructurada de ella.
El procedimiento de scraping sigue siendo en gran medida el mismo:
- La API Web Unlocker de Bright Data captura una captura de pantalla de la página de IKEA objetivo.
- GLM-5.3-Flash recibe la captura de pantalla a través de las APIs de Z.ai y extrae información del producto según un esquema predefinido.
- Los datos extraídos se validan y se guardan como JSON estructurado.
Nota: El flujo de trabajo principal cambia muy poco, por lo que esta sección se centra en las modificaciones necesarias para la extracción de datos visuales. Todos los pasos de requisitos previos y configuración descritos anteriormente siguen siendo válidos.
Paso #1: Recuperar la captura de pantalla de la página
Ajusta la solicitud a la API Web Unlocker para obtener una captura de pantalla de la página en lugar de Markdown:
# Set up the authentication headers for Web Unlocker
headers = {
    "Content-Type": "application/json",
    "Authorization": f"Bearer {BRIGHT_DATA_API_KEY}"
}

# Define the request payload for the Web Unlocker API call
payload = {
    "zone": "web_unlocker", # Replace with your Web Unlocker zone name
    "url": "https://www.ikea.com/us/en/p/kallax-shelf-unit-white-20631663/", # The IKEA product page URL you want to visually scrape
    "format": "raw",
    "country": "us",
    "data_format": "screenshot" # Get a screenshot of the web page
}

# Retrieve the screenshot of the unlocked target page
web_unlocker_response = requests.post(
    "https://api.brightdata.com/request",
    json=payload,
    headers=headers
)

page_screenshot = web_unlocker_response.content
La modificación esencial es el campo data_format, ahora configurado como "screenshot". Esto indica a Web Unlocker que devuelva una captura de pantalla de la página. La respuesta de la API contendrá datos de imagen de captura de pantalla en formato PNG, representando la página completamente renderizada.
Exporta la captura de pantalla al disco:
with open("screenshot.png", "wb") as f:
    f.write(page_screenshot)
Este paso opcional resulta beneficioso para la inspección visual de la página recuperada y la resolución de problemas en los flujos de trabajo de extracción.
La salida será un archivo screenshot.png:
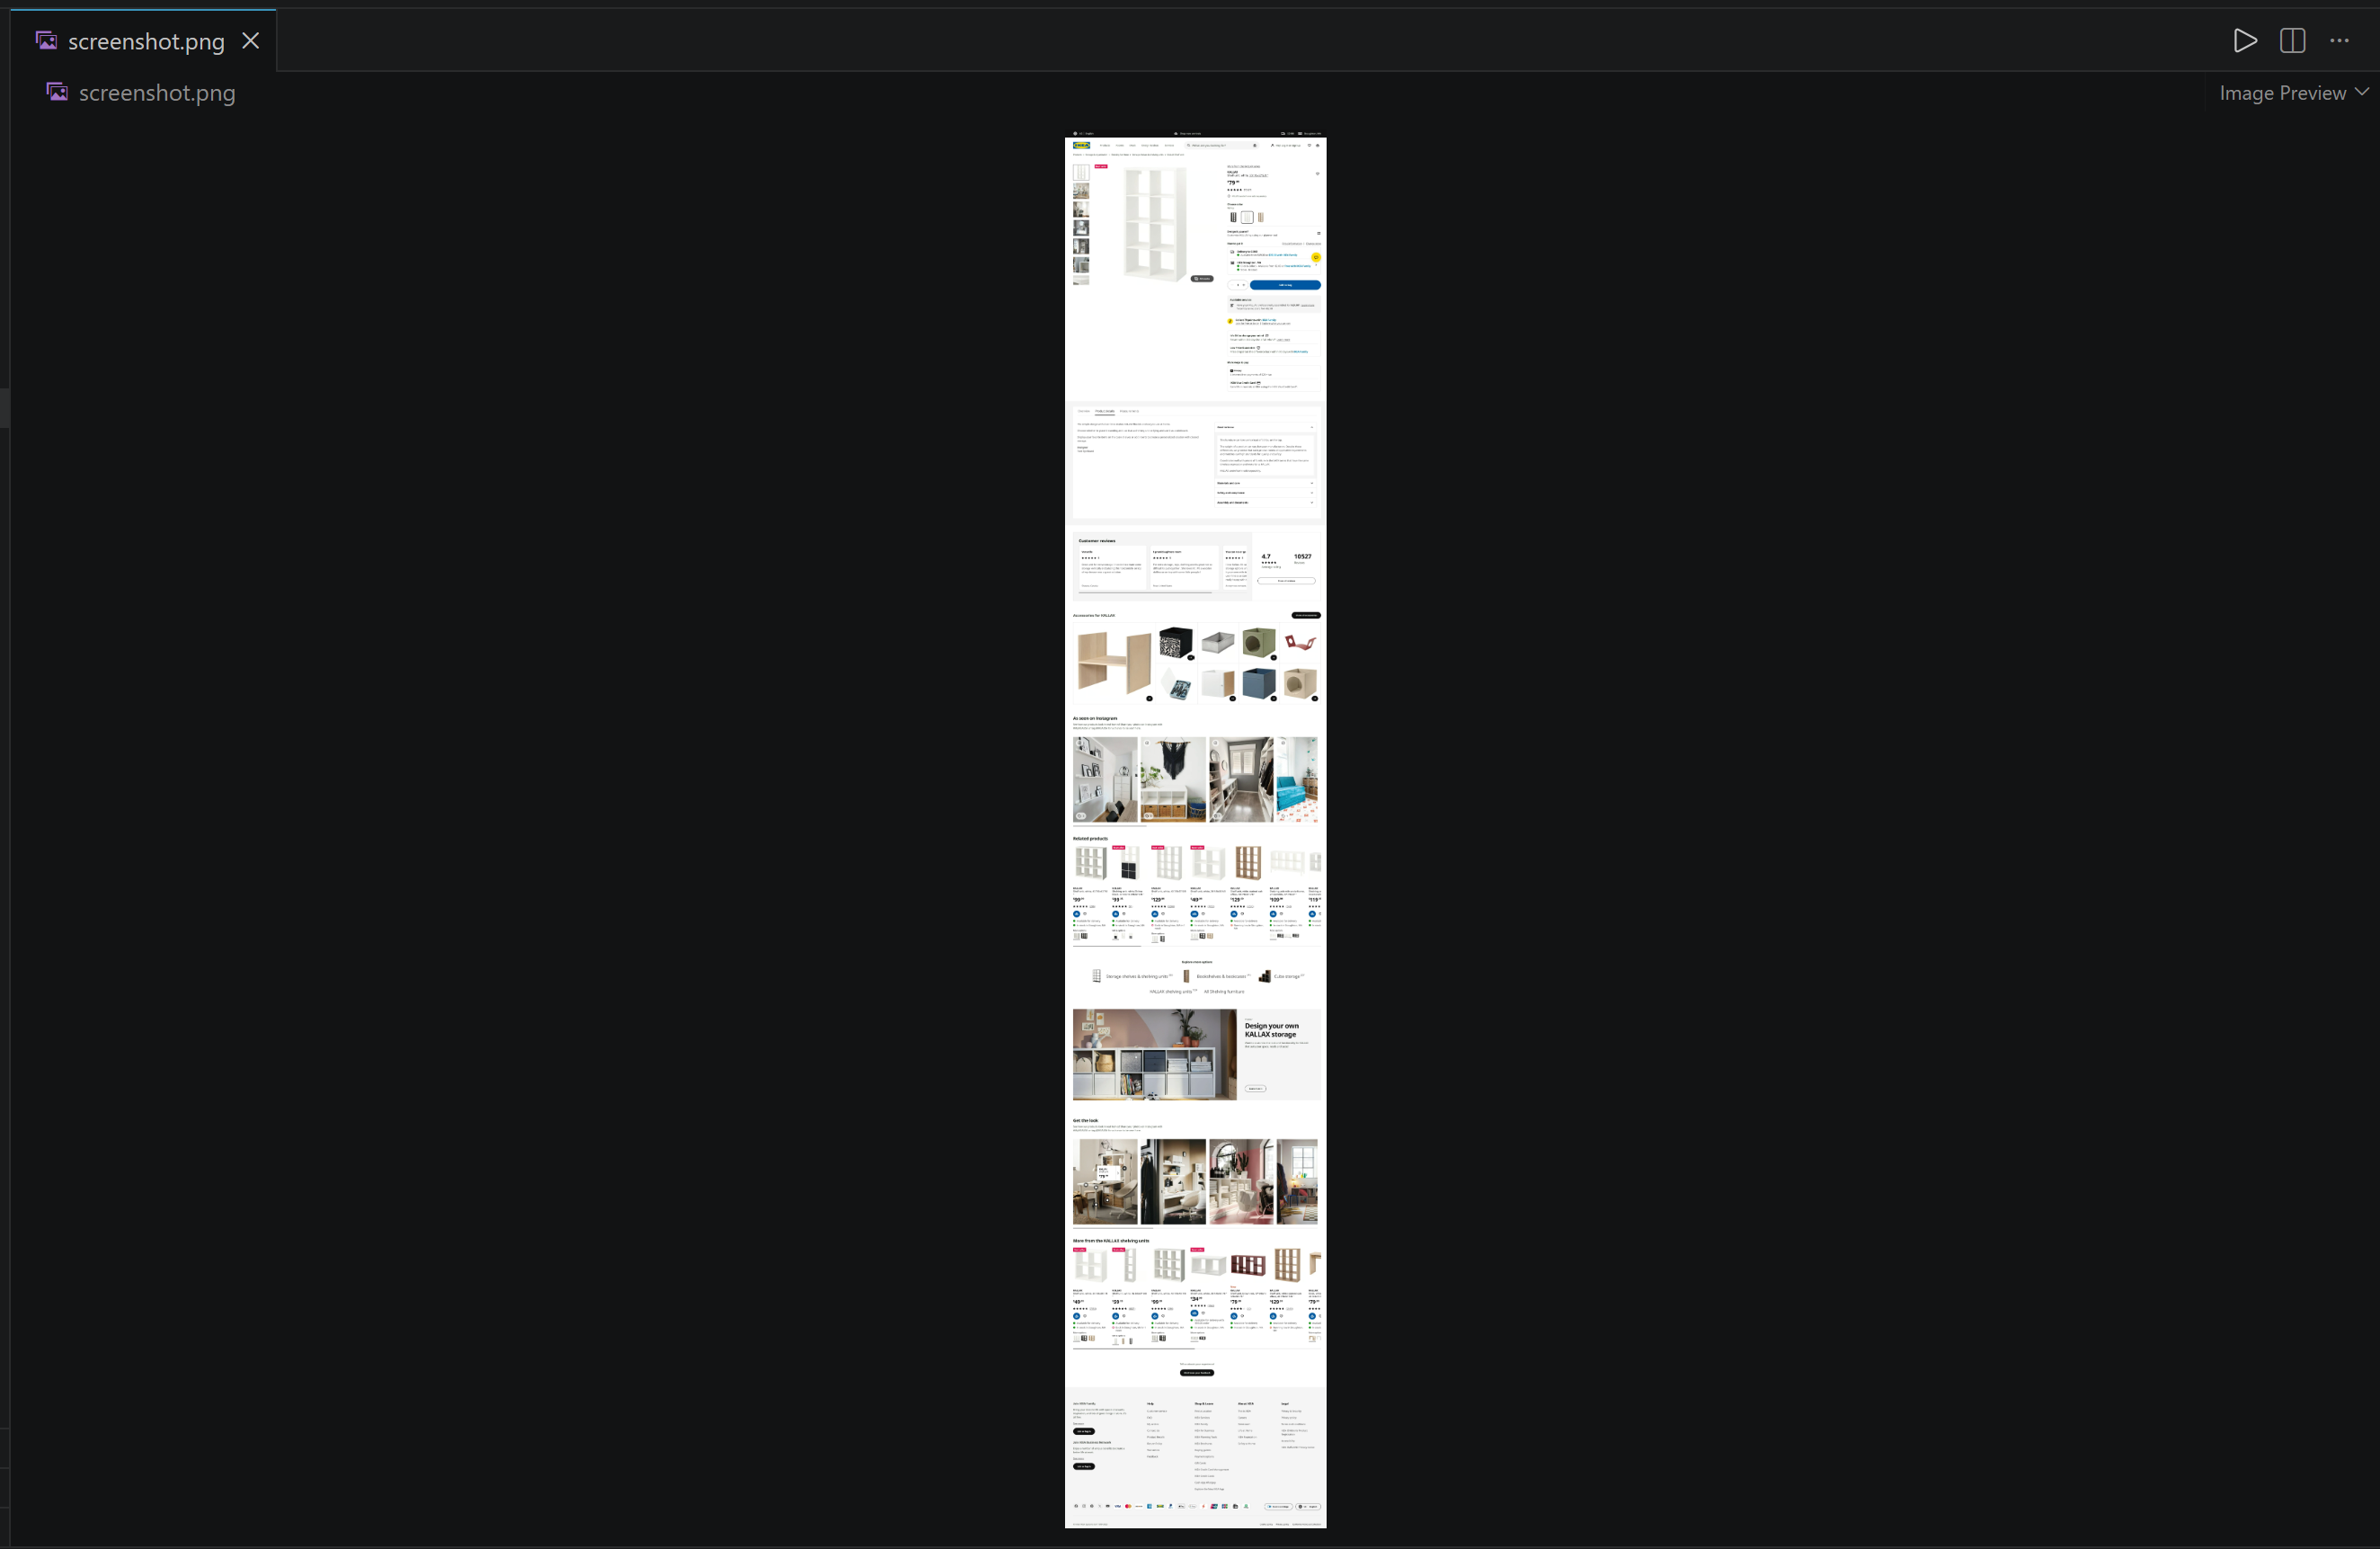
Observa cómo la API Web Unlocker de Bright Data capturó una captura de pantalla de la página completa del producto de IKEA. ¡Continuamos!
Paso #2: Actualizar el modelo Pydantic
Mediante el análisis de una captura de pantalla de la página, GLM-5.3-Flash puede identificar información visual no disponible en la representación Markdown de la página. Por ejemplo, puede interpretar texto incrustado en etiquetas visuales (por ejemplo, la etiqueta “Best seller”):
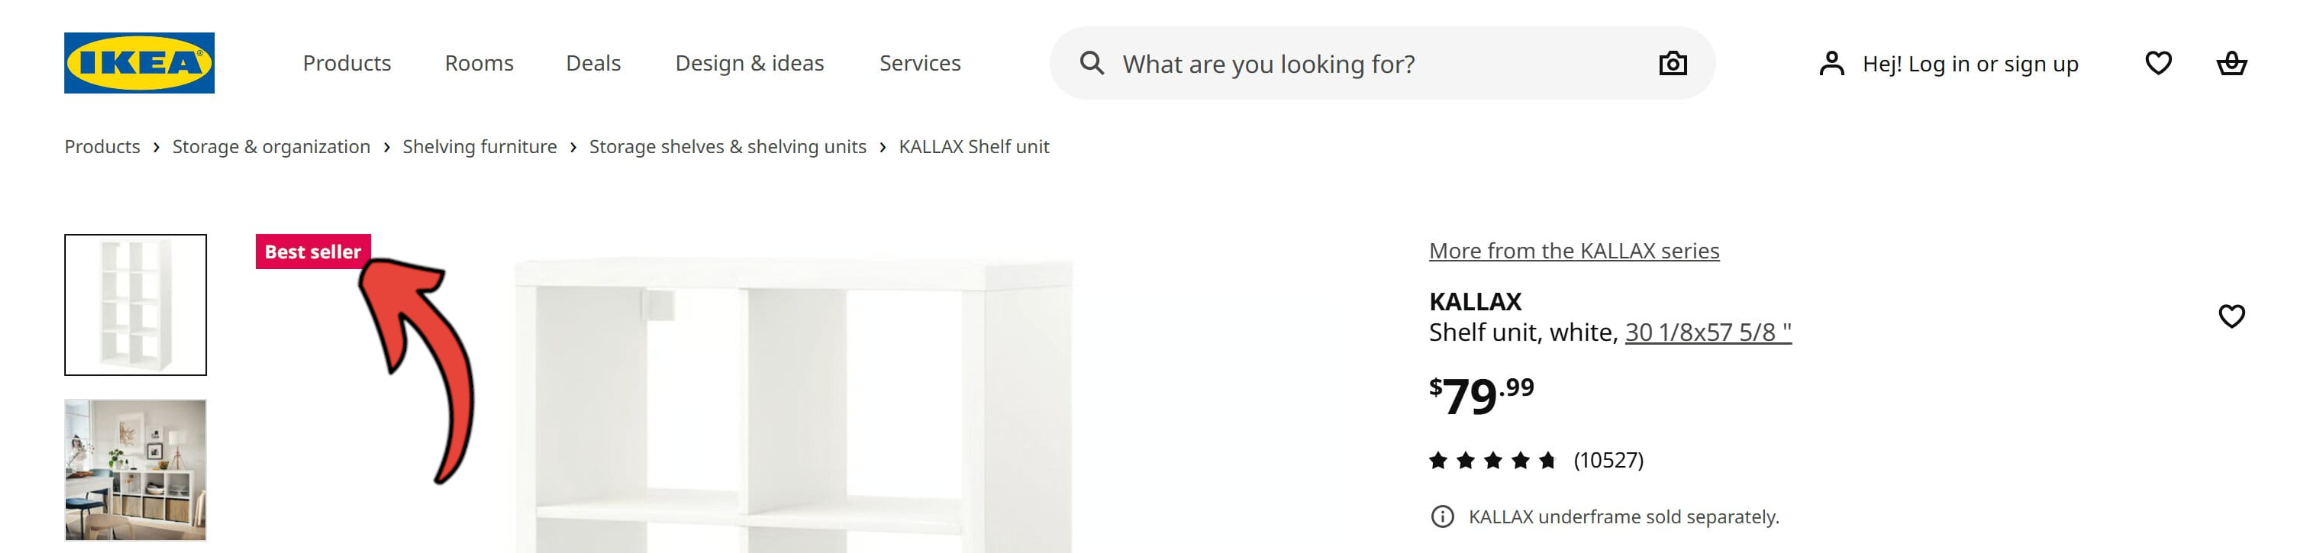
Al mismo tiempo, una captura de pantalla no entrega toda la información de la página. Por ejemplo, campos como images o assembly_instructions_url, que eran accesibles a través del flujo de trabajo de extracción basado en Markdown, no pueden ser completados a partir de datos visuales.
Por consiguiente, adapta el modelo Pydantic IkeaProduct para el procesamiento visual:
class IkeaProduct(BaseModel):
    title: Optional[str] = Field(None, description="Full product title as displayed on the IKEA website")
    product_type: Optional[str] = Field(None, description="General type of product, such as an armchair, shelf unit, cabinet, or table")
    price: Optional[float] = Field(None, description="Current displayed numerical price")
    currency: Optional[str] = Field(None, description="Currency used for the displayed price, such as USD")
    is_best_seller: Optional[bool] = Field(False, description="Whether a best-seller or top-seller badge is displayed")
    badge_label: Optional[str] = Field(None, description="Promotional or product badge displayed on the page, such as Top Seller")
    delivery_options: Optional[List[str]] = Field(None, description="Delivery or fulfillment options displayed on the page")
    color: Optional[str] = Field(None, description="Selected product color or finish, such as white or birch veneer")
    visual_aspects: Optional[str] = Field(None, description="Description of the physical characteristics visible in the product images, such as shape, components, finish, or configuration")
    dimensions: Optional[str] = Field(None, description="Overall product dimensions as displayed on the IKEA website")
    rating: Optional[float] = Field(None, description="Average customer rating, typically on a 5-point scale")
    review_count: Optional[int] = Field(None, description="Total number of customer reviews displayed")
Observa la introducción del campo visual_aspects. Este campo dirige a GLM a documentar las características físicas visibles en las imágenes del producto, permitiendo extraer información no disponible a través del parseo basado en texto. También presta atención a los nuevos campos is_best_seller y badge_label.
¡Genial! Envía el modelo Pydantic actualizado y la captura de pantalla de la página web a la API Z.ai para el scraping web visual con GLM-5.3-Flash.
Paso #3: Extraer datos de una imagen con la visión de GLM-5.3
Al igual que los modelos de OpenAI con capacidades de visión, GLM-5.3-Flash acepta imágenes a través del campo image_url. Este acepta URLs de imágenes accesibles públicamente o representaciones de imágenes codificadas en Base64.
Dado que la captura de pantalla existe localmente como bytes de imagen, es necesario codificarla en Base64. Para ello, emplea el módulo base64 de Python:
import base64

screenshot_base64 = base64.b64encode(page_screenshot).decode("utf-8")
Ahora, transmite la captura de pantalla codificada en Base64 a GLM-5.3-Flash junto con tus instrucciones de extracción:
# Perform visual web data parsing with GLM-5.3-Flash
response = glm_client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:image/png;base64,{screenshot_base64}"
                    },
                },
                {
                    "type": "text",
                    "text": f"""
Extract the IKEA product information from the provided webpage screenshot
and return it as structured data that conforms to the provided JSON schema.

SCHEMA:
{json.dumps(IkeaProduct.model_json_schema(), indent=2)}
""",
                },
            ],
        }
    ],
    response_format={"type": "json_object"},
)

# Get the parsed data in the defined schema format
product_data = response.choices[0].message.content
La solicitud a la API Z.ai comprende dos componentes:
- La imagen de captura de pantalla de la página.
- Una instrucción de texto que indica a GLM-5.3 que recupere información del producto usando el esquema Pydantic designado.
Nota: Esta vez, el modelo objetivo es glm-5.3-flash, no glm-5.3 como antes. Este cambio es necesario ya que GLM-5.3 no tiene capacidades de visión.
El resultado es una variable product_data que almacena una cadena JSON con los datos extraídos visualmente. Guárdala en el disco como se describió anteriormente. ¡Impresionante!
Paso #4: Probar el script de scraping GLM basado en visión
El código final de tu script de scraping web visual con GLM será:
# pip install dotenv requests openai pydantic

from dotenv import load_dotenv
import os
import requests
import base64
import json
from pydantic import BaseModel, Field
from typing import List, Optional
from openai import OpenAI

# Load the environment variables from the .env file
load_dotenv()

# Loading the required secrets from the envs
BRIGHT_DATA_API_KEY = os.environ.get("BRIGHT_DATA_API_KEY")
ZAI_API_KEY = os.environ.get("ZAI_API_KEY")

class IkeaProduct(BaseModel):
    title: Optional[str] = Field(None, description="Full product title as displayed on the IKEA website")
    product_type: Optional[str] = Field(None, description="General type of product, such as an armchair, shelf unit, cabinet, or table")
    price: Optional[float] = Field(None, description="Current displayed numerical price")
    currency: Optional[str] = Field(None, description="Currency used for the displayed price, such as USD")
    is_best_seller: Optional[bool] = Field(False, description="Whether a best-seller or top-seller badge is displayed")
    badge_label: Optional[str] = Field(None, description="Promotional or product badge displayed on the page, such as Top Seller")
    delivery_options: Optional[List[str]] = Field(None, description="Delivery or fulfillment options displayed on the page")
    color: Optional[str] = Field(None, description="Selected product color or finish, such as white or birch veneer")
    visual_aspects: Optional[str] = Field(None, description="Description of the physical characteristics visible in the product images, such as shape, components, finish, or configuration")
    dimensions: Optional[str] = Field(None, description="Overall product dimensions as displayed on the IKEA website")
    rating: Optional[float] = Field(None, description="Average customer rating, typically on a 5-point scale")
    review_count: Optional[int] = Field(None, description="Total number of customer reviews displayed")

# Set up the authentication headers for Web Unlocker
headers = {
    "Content-Type": "application/json",
    "Authorization": f"Bearer {BRIGHT_DATA_API_KEY}"
}

# Define the request payload for the Web Unlocker API call
payload = {
    "zone": "web_unlocker", # Replace with your Web Unlocker zone name
    "url": "https://www.ikea.com/us/en/p/kallax-shelf-unit-white-20631663/", # The IKEA product page URL you want to visually scrape
    "format": "raw",
    "country": "us",
    "data_format": "screenshot" # Get a screenshot of the web page
}

# Retrieve the screenshot of the unlocked target page
web_unlocker_response = requests.post(
    "https://api.brightdata.com/request",
    json=payload,
    headers=headers
)

page_screenshot = web_unlocker_response.content

# Export the screenshot to a PNG file
with open("screenshot.png", "wb") as f:
    f.write(page_screenshot)

# Convert the screenshot to Base64 for vision processing
screenshot_base64 = base64.b64encode(page_screenshot).decode("utf-8")

# Initialize the OpenAI-compatible client for Z.ai
glm_client = OpenAI(
    api_key=ZAI_API_KEY,
    base_url="https://api.z.ai/api/paas/v4/",
)

# Perform visual web data parsing with GLM-5.3-Flash
response = glm_client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:image/png;base64,{screenshot_base64}"
                    },
                },
                {
                    "type": "text",
                    "text": f"""
Extract the IKEA product information from the provided webpage screenshot
and return it as structured data that conforms to the provided JSON schema.

SCHEMA:
{json.dumps(IkeaProduct.model_json_schema(), indent=2)}
""",
                },
            ],
        }
    ],
    response_format={"type": "json_object"},
)

# Get the parsed data in the defined schema format
product_data = response.choices[0].message.content

# Convert the JSON string into a validated IkeaProduct object
product = IkeaProduct.model_validate_json(product_data)

# Export the IkeaProduct object to a JSON file
with open("visual_product.json", "w", encoding="utf-8") as f:
    f.write(product.model_dump_json(indent=2))
Lanza el script y esto generará un archivo visual_product.json que contiene:
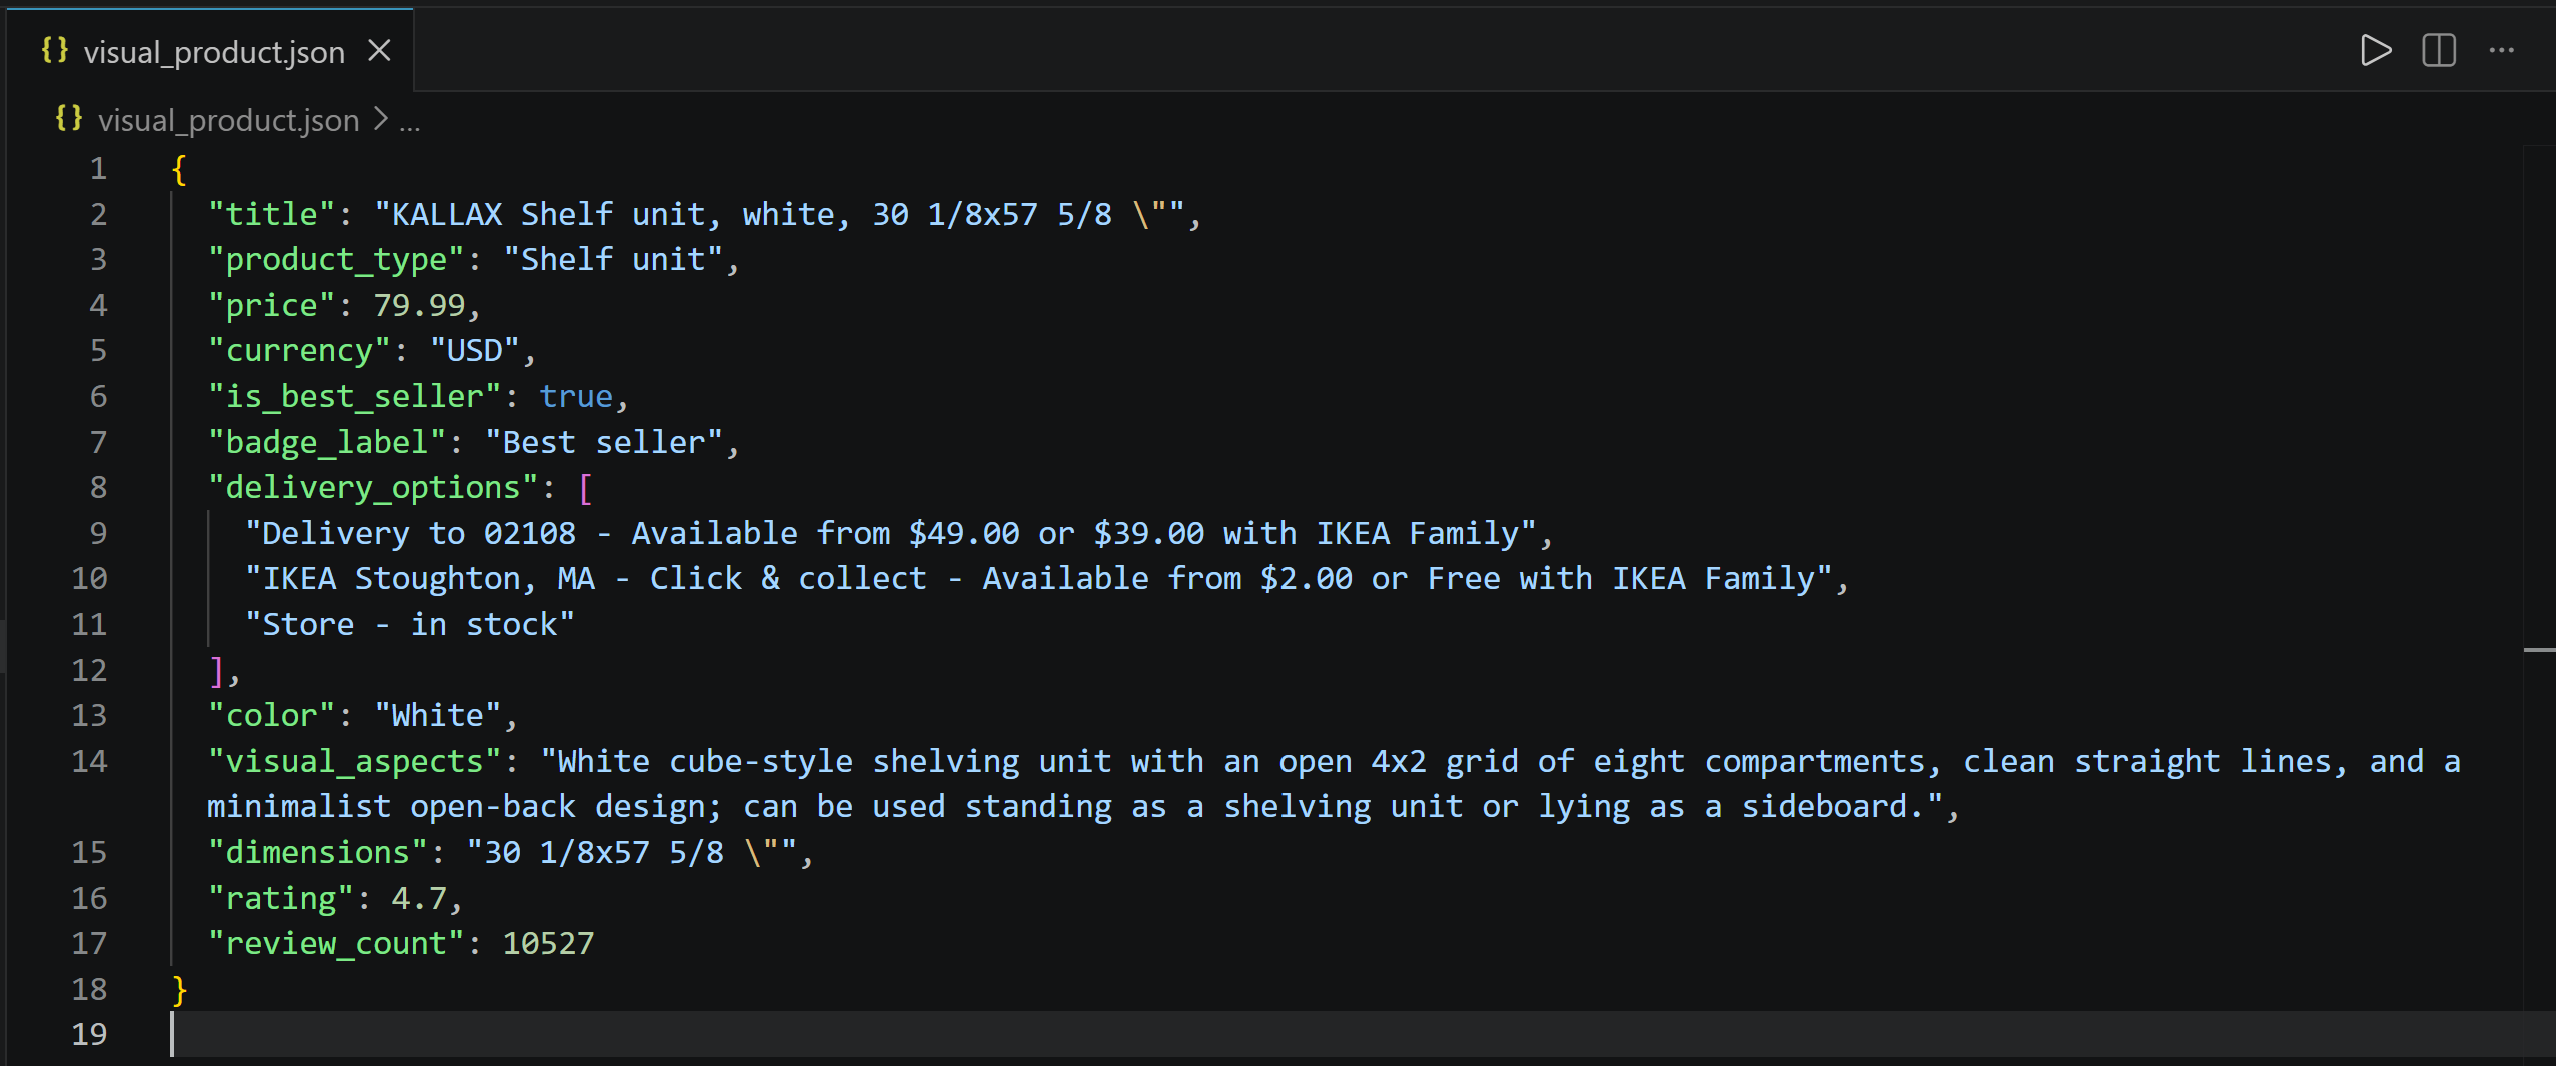
Observa la recuperación exitosa de información del producto a partir de la captura de pantalla de la página, incluyendo los aspectos visuales y la etiqueta “Best seller”. ¡Increíble!
Conclusión
En este tutorial, aprendiste a construir un sistema de extracción de datos web impulsado por LLM usando GLM-5.3 y GLM-5.3-Flash. Los principales desafíos del scraping web con IA (es decir, acceder al contenido web sin ser bloqueado y convertirlo en un formato listo para LLM) se han abordado fácilmente con la API Web Unlocker de Bright Data.
Como se demostró aquí, combinar GLM-5.3 y GLM-5.3-Flash con la API Web Unlocker te permite extraer información estructurada tanto de páginas web como de sus representaciones visuales. Este es solo uno de los muchos casos de uso compatibles con las soluciones de acceso web compatibles con IA de Bright Data.
¡Regístrate en Bright Data hoy y comienza a experimentar con nuestras APIs de scraping web de forma gratuita!