En esta guía, verás:
- Qué es Contenedores como Servicio y qué gestiona por ti.
- Cómo funciona CaaS y la importancia de la orquestación de contenedores en este modelo.
- Las principales ventajas y desventajas de este enfoque de servicio en la nube.
- Por qué CaaS es adecuado para cargas de trabajo de recuperación de datos web.
- Cómo construir un pipeline de datos web escalable con CaaS y Bright Data.
¡Comencemos!
CaaS (Contenedores como Servicio) Explicado
Antes de ver cómo CaaS puede respaldar los pipelines de datos web y los agentes de IA, debes entender qué es y qué gestiona realmente.
¿Qué Es CaaS?
CaaS, abreviatura de Containers as a Service, es un modelo de servicio en la nube que proporciona un entorno gestionado para desplegar, ejecutar y escalar aplicaciones en contenedores. Se sitúa entre los servicios de infraestructura y los de nivel de aplicación.
Para entender dónde encaja CaaS, considera qué ocurre cuando construyes un contenedor. Una imagen de contenedor representa una unidad portable de tu aplicación que puede ejecutarse de forma consistente en distintos entornos.
La imagen se utiliza para crear contenedores en ejecución. Operar esos contenedores de forma fiable en producción requiere infraestructura para el despliegue, la red, el escalado, la monitorización y la gestión del ciclo de vida.
CaaS cierra la brecha entre una imagen de contenedor terminada y un entorno de ejecución listo para producción. En lugar de configurar servidores manualmente y gestionar contenedores individuales, puedes desplegar tus imágenes en una plataforma CaaS, que define cómo deben ejecutarse y los orquesta.
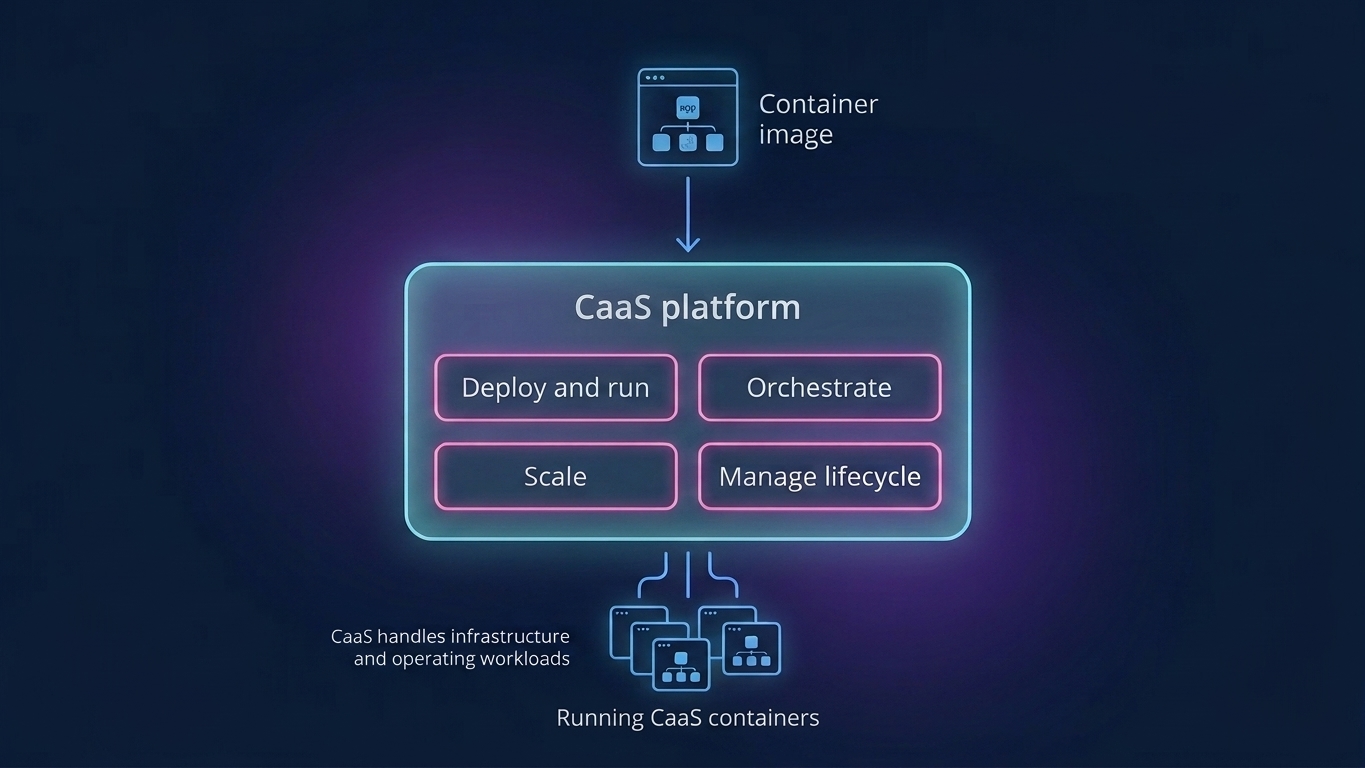
En otras palabras, este modelo es más que simplemente ejecutar Docker en una máquina virtual. Solo con Docker, aún necesitas gestionar la infraestructura subyacente y coordinar los contenedores tú mismo. Una solución CaaS ofrece las características adicionales necesarias para operar cargas de trabajo en contenedores a escala.
¿Qué Gestiona CaaS?
Una plataforma CaaS generalmente gestiona el despliegue de contenedores, la orquestación, el escalado, la red, el descubrimiento de servicios, las comprobaciones de estado y las operaciones del ciclo de vida.
En términos prácticos, defines tu carga de trabajo deseada, como cuántas instancias de contenedor deben ejecutarse y qué recursos requieren. Luego, la plataforma gestiona gran parte de la ejecución por ti.
Este enfoque reduce la carga operativa y facilita la ejecución fiable de aplicaciones distribuidas, especialmente cuando las cargas de trabajo necesitan escalar o cambiar con frecuencia.
¿Cómo Funciona CaaS?
Ahora que sabes qué es CaaS, es momento de entender cómo funciona.
De la Imagen de Contenedor a la Carga de Trabajo en Producción
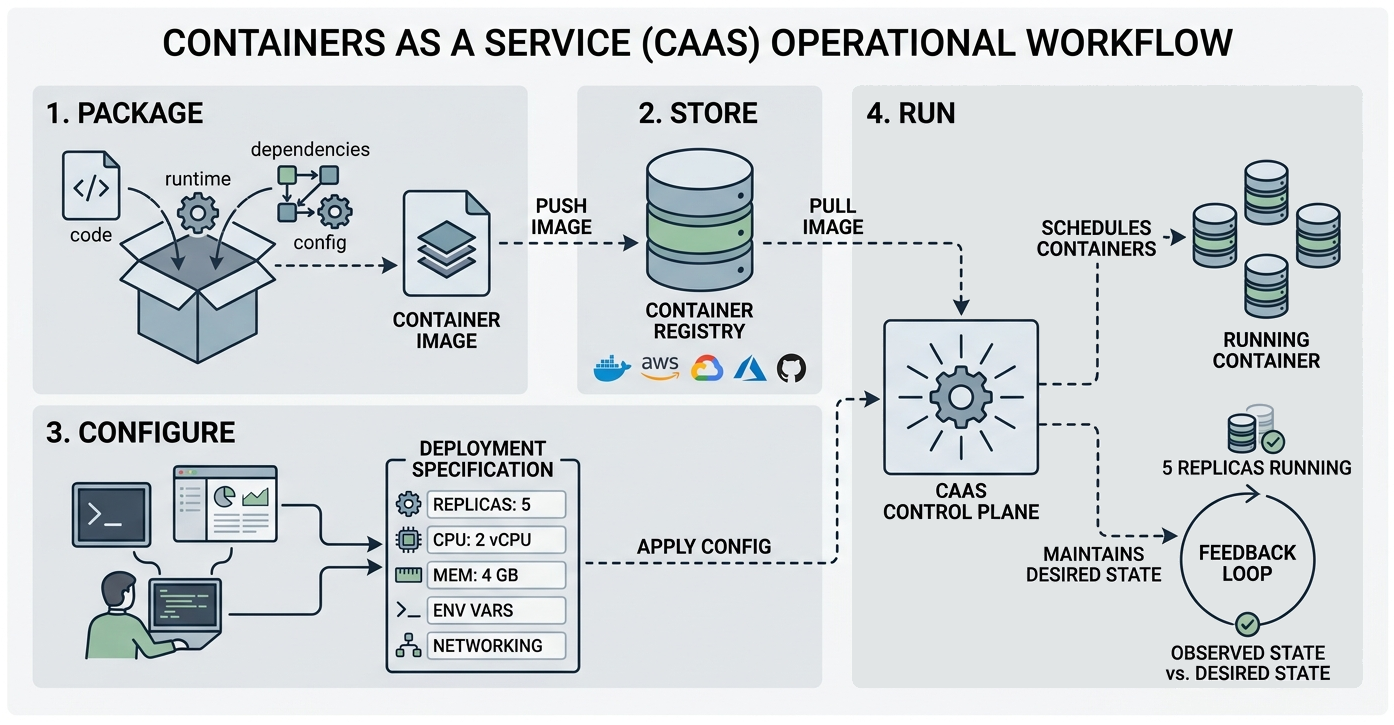
El primer paso para desplegar una aplicación con CaaS es empaquetar la aplicación y todo lo que necesita para ejecutarse en una imagen de contenedor. Esto incluye el código de la aplicación, las dependencias, el entorno de ejecución, la configuración y otros componentes necesarios.
La imagen generalmente se almacena en un registro de contenedores, como Docker Hub, Amazon ECR, Google Artifact Registry, Azure Container Registry o GitHub Container Registry. Un registro actúa como un sistema centralizado para almacenar, gestionar y distribuir imágenes de contenedores. Al desplegar una aplicación, la imagen requerida se recupera del registro y se usa para crear contenedores.
Luego especificas cómo debe ejecutarse la aplicación. Según la solución CaaS, esto puede incluir el número de instancias de contenedor, los requisitos de CPU y memoria, las reglas de red, las variables de entorno y otros parámetros de configuración. Estos parámetros generalmente se pueden proporcionar a través de una interfaz web, una herramienta de línea de comandos, un archivo de configuración o una API.
El servicio CaaS convierte esta configuración en una carga de trabajo en ejecución. Programa los contenedores en la infraestructura subyacente disponible y trabaja continuamente para mantener el estado deseado.
El Papel de la Orquestación de Contenedores
Ejecutar un solo contenedor es relativamente sencillo. Sin embargo, a medida que una aplicación crece, es posible que necesites ejecutar decenas o incluso cientos de contenedores. En la mayoría de los casos, estos contenedores necesitan comunicarse entre sí, escalar según la demanda o recuperarse automáticamente cuando algo falla. Gestionar todo esto manualmente se vuelve rápidamente un desafío.
Aquí es donde entra la orquestación de contenedores. La orquestación automatiza las tareas necesarias para ejecutar y coordinar múltiples contenedores. Puede añadir o eliminar contenedores automáticamente según cambia la demanda, verificar si están en buen estado, reemplazar instancias fallidas y permitir que los servicios se encuentren y se comuniquen entre sí.
Kubernetes es la tecnología más reconocida para la orquestación de contenedores y se usa comúnmente como base para las soluciones CaaS modernas. Expone los mecanismos necesarios para desplegar, programar, escalar y mantener cargas de trabajo en contenedores en un clúster de máquinas.
Sin embargo, ten en cuenta que CaaS y Kubernetes no son lo mismo. Kubernetes es la tecnología principal para orquestar contenedores, mientras que CaaS ofrece una forma gestionada de usar infraestructura de contenedores sin tener que operarlo todo tú mismo.
Ventajas y Desafíos de CaaS
El modelo de Contenedores como Servicio puede simplificar el despliegue y la operación de aplicaciones en contenedores, pero también introduce nuevas consideraciones.
Principales ventajas:
- Las aplicaciones se ejecutan de forma idéntica en entornos de desarrollo, pruebas y multi-nube, evitando errores de despliegue causados por discrepancias de configuración.
- El escalado horizontal automatizado ajusta instantáneamente el número de contenedores para adaptarse a picos de tráfico, optimizando el consumo de recursos del servidor.
- Delegar la gestión del clúster y el aprovisionamiento del SO anfitrión elimina las cargas de mantenimiento de infraestructura para los equipos de ingeniería internos.
- El aislamiento granular de componentes permite el despliegue, escalado y recuperación de fallos independientes para arquitecturas modulares basadas en microservicios.
- La integración nativa con pipelines de despliegue continuo acelera los ciclos de lanzamiento automatizando las pruebas y la creación de contenedores.
Principales desafíos:
- La arquitectura de kernel de SO compartido introduce vulnerabilidades de escape de contenedores, ampliando la superficie de ataque general en comparación con las máquinas virtuales.
- Las configuraciones complejas de red, almacenamiento y orquestación crean curvas de aprendizaje pronunciadas y requieren experiencia operativa especializada.
- Las APIs específicas del proveedor y las herramientas de orquestación propietarias complican la migración de cargas de trabajo entre distintos proveedores de servicios en la nube.
CaaS para Datos Web y Flujos de Trabajo de IA
Descubre por qué los Contenedores como Servicio son especialmente adecuados para la recopilación de datos web y los flujos de trabajo que preparan datos frescos para aplicaciones de IA.
Aplicaciones Comunes
Uno de los escenarios más populares para CaaS es ejecutar microservicios. Cada servicio puede ejecutarse en su propio contenedor, lo que permite desplegar, actualizar y escalar componentes individuales por separado.
El modelo también es útil para la modernización de aplicaciones, el despliegue continuo, la infraestructura híbrida y las cargas de trabajo con requisitos de recursos variables. Los contenedores proporcionan entornos de ejecución consistentes, mientras que la capa CaaS proporciona la infraestructura necesaria para ejecutarlos y escalarlos.
Otro encaje natural es cualquier carga de trabajo que implique tareas repetidas o paralelas. En lugar de procesar todo de una en una, puedes distribuir trabajos individuales entre múltiples workers en contenedores. Ese enfoque funciona especialmente bien para pipelines de datos, donde los workers pueden recuperar, transformar, validar, enriquecer o procesar datos de forma independiente.
CaaS para la Recopilación de Datos Web
El scraping web es un buen ejemplo de carga de trabajo que puede beneficiarse de la ejecución en contenedores. Imagina que necesitas recuperar datos de miles de URLs. En lugar de procesarlas secuencialmente en una sola aplicación, puedes distribuir las URLs entre múltiples workers en contenedores.
Cada worker puede procesar sus tareas asignadas de forma autónoma, lo que te permite aumentar la capacidad de recopilación ejecutando más contenedores. Una cola de tareas puede mejorar aún más esta arquitectura distribuyendo trabajos dinámicamente a medida que los workers estén disponibles.
CaaS para Flujos de Trabajo de Procesamiento de Datos de IA
La arquitectura mencionada puede extenderse más allá de la recopilación de datos. Los workers en contenedores pueden recuperar datos web frescos, procesarlos y enriquecerlos, y enrutar la información resultante hacia sistemas de análisis, bases de datos, pipelines RAG o aplicaciones de IA.
En detalle, una cola podría distribuir miles de tareas de recopilación de datos entre workers. Una vez recopilados, otro conjunto de workers podría limpiar y estructurar los resultados antes de pasarlos a un agente de IA o LLM.
Escalando la Recopilación de Datos Web con CaaS y Bright Data
CaaS proporciona la infraestructura de ejecución para workers de scraping en contenedores, pero no resuelve los desafíos de acceder a sitios web a escala. La automatización del navegador, la gestión de proxies, la rotación de IPs, el bloqueo de sitios web y los mecanismos anti-bot requieren infraestructura adicional.
Aquí es donde Bright Data encaja en la arquitectura. Su infraestructura de datos web proporciona acceso a una gran red de proxies y APIs gestionadas para acceso web, búsqueda, automatización de navegador y extracción de datos estructurados.
Bright Data está respaldado por una red de proxies de más de 400 millones de IPs, concurrencia ilimitada, un tiempo de actividad del 99,99% y una tasa de éxito del 99,95% en toda su red.
La idea es separar las dos capas:
- CaaS proporciona cómputo escalable para tu aplicación.
- Bright Data aporta la infraestructura necesaria para acceder y recopilar datos web.
¡Aprende más sobre cómo combinar CaaS y Bright Data para construir pipelines de datos y flujos de trabajo de IA listos para producción!
Paso #1: Elige la API de Bright Data Adecuada
El primer paso es elegir los productos de Bright Data que se adapten al tipo de datos que necesitas recopilar. Estos incluyen:
- API de Web Scraping: Extrae datos estructurados de más de 800 dominios compatibles usando más de 1.500 scrapers predefinidos.
- API Web Unlocker: Recupera contenido de páginas web gestionando muchos desafíos de acceso, incluidos proxies, bloqueos y CAPTCHAs.
- API SERP: Recupera resultados de búsqueda estructurados de motores como Google, Bing, Yandex y más.
- API de Navegador: Ejecuta sesiones de navegador gestionadas para sitios web que requieren ejecución de JavaScript, clics, desplazamiento u otra automatización del navegador.
Nota: Todos estos están incluidos en el nivel gratuito mensual recurrente de Bright Data, por lo que puedes usarlos de forma gratuita.
Paso #2: Construye un Worker de Scraping en Contenedor
Después de seleccionar la API de datos web adecuada, puedes empaquetar tu aplicación como un contenedor. Solo necesita enviar solicitudes a las APIs de Bright Data elegidas y, opcionalmente, procesar los datos devueltos.
Por ejemplo, un worker de Python puede usar la API Web Unlocker para recuperar contenido Markdown listo para LLM de una página web:
# worker.py

import os
import requests

def fetch_page(url):
    response = requests.post(
        "https://api.brightdata.com/request",
        headers={
            "Authorization": f"Bearer {os.environ['BRIGHTDATA_API_KEY']}",
            "Content-Type": "application/json",
        },
        json={
            "zone": os.environ["BRIGHTDATA_WEB_UNLOCKER_API"], # Replace with your Bright Data Web Unlocker API name
            "url": url,
            "format": "raw",
            "data_format": "markdown",
        },
    )

    response.raise_for_status()

    return response.text
Para más orientación sobre la integración, consulta la documentación de Web Unlocker de Bright Data.
Ten en cuenta que no hay nada específico de Docker en esta solicitud. La aplicación usa una solicitud HTTP estándar a través de la biblioteca requests de Python. Por lo tanto, el mismo código puede ejecutarse localmente, en una máquina virtual o dentro de un contenedor gestionado por un servicio CaaS.
Luego, puedes listar las dependencias requeridas en un archivo requirements.txt. Este contendrá:
requests==2.34.2Para contenerizar el worker, puedes escribir un Dockerfile sencillo:
FROM python:3.14-slim

WORKDIR /app

COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

COPY . .

CMD ["python", "worker.py"]
También necesitas proporcionar la clave API de Bright Data y el nombre de la API Web Unlocker por separado del código de tu aplicación. Durante el desarrollo local, puedes usar un archivo .env:
BRIGHTDATA_API_KEY=<BRIGHTDATA_API_KEY>
BRIGHTDATA_WEB_UNLOCKER_ZONE=<BRIGHTDATA_WEB_UNLOCKER_API>
Para despliegues en producción, debes usar la funcionalidad de gestión de secretos de tu proveedor CaaS para inyectar la clave API en el contenedor.
¡Bien hecho! De manera similar, puedes contenerizar aplicaciones que llamen a otros productos basados en la API de Bright Data.
Paso #3: Distribuye el Trabajo Entre Contenedores
Una vez que el worker de scraping funciona correctamente, la arquitectura puede escalar el número de instancias de worker según la carga de trabajo.
Ahora, imagina una cola de scraping con 100.000 URLs. El servicio CaaS puede ejecutar múltiples instancias del worker y distribuir las tareas entre ellas. A medida que crece la carga de trabajo, se añadirán más workers para procesar solicitudes de forma concurrente. Esto es mucho mejor que procesarlas secuencialmente en una sola aplicación.
Recuerda que la API Web Unlocker, al igual que cualquier otro producto de Bright Data, está diseñada para la recopilación de datos a gran escala. Esto significa que puedes escalar el número de workers en contenedores sin preocuparte por problemas de concurrencia.
Paso #4: Procesa y Usa los Datos Devueltos
La arquitectura final tiene este aspecto:
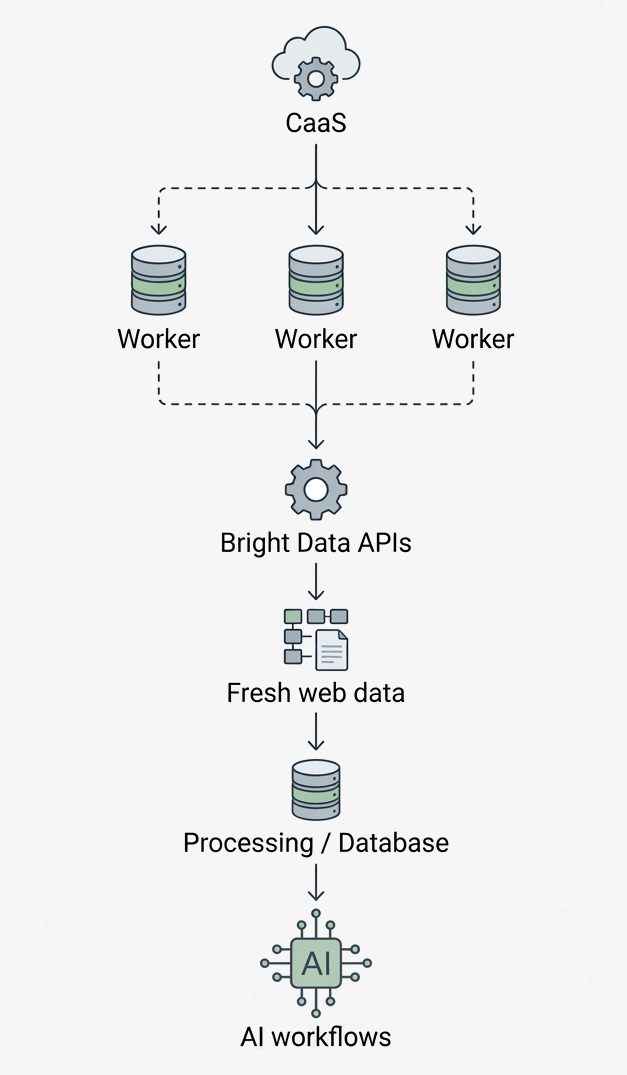
Una cola de tareas puede situarse entre la aplicación y los workers, permitiendo que los trabajos se distribuyan dinámicamente a medida que los contenedores estén disponibles. Si la carga de trabajo aumenta, puedes ejecutar más workers. Cuando la demanda disminuye, puedes reducirlos.
Esto crea una separación clara de responsabilidades:
- CaaS: Proporciona el entorno de cómputo y escala los workers en contenedores.
- Docker: Empaqueta la aplicación y sus dependencias en un entorno de ejecución portable.
- Bright Data: Proporciona la infraestructura especializada para acceder y recopilar datos web a escala.
- Tu aplicación: Procesa los datos devueltos y los envía a bases de datos, sistemas basados en ML o agentes de IA.
Ten en cuenta que CaaS no facilita la recuperación web por sí mismo. Hace que el scraping web de las aplicaciones sea más fácil de desplegar y escalar. Combinado con infraestructura de datos web gestionada como Bright Data, te permite construir pipelines de datos web escalables para análisis e IA sin gestionar cada capa del stack de acceso web tú mismo. ¡Increíble!
Conclusión
En este artículo, aprendiste cómo usar Contenedores como Servicio (CaaS) para construir pipelines de datos web escalables y flujos de trabajo de IA. Como se muestra aquí, combinar CaaS con Bright Data te permite escalar tanto las capas de cómputo como de datos web de tu arquitectura.
Esta integración te permite distribuir la recopilación de datos entre workers en contenedores, recuperar datos web frescos a través de las APIs de Bright Data y enviar los resultados a componentes posteriores.
¡Crea una nueva cuenta de Bright Data y comienza a usar nuestras APIs para construir pipelines de datos escalables y de procesamiento de IA!
Preguntas Frecuentes
¿Cuál es la diferencia entre CaaS y una infraestructura de contenedores DIY?
Con CaaS, el proveedor de nube gestiona gran parte de la infraestructura subyacente y las operaciones de contenedores. Con un enfoque DIY, eres responsable de configurar, mantener, escalar y proteger el entorno de contenedores.
| CaaS | DIY | |
|---|---|---|
| Infraestructura | Gestionada por el proveedor | Gestionada por tu equipo |
| Orquestación | Gestionada o integrada | Configurada y mantenida por tu equipo |
| Escalado | Automatización integrada | Configura y mantén tú mismo |
| Mantenimiento | Menor | Mayor |
| Control | Menor control a nivel de infraestructura | Mayor control |
| Experiencia | Menos requerida | Más requerida |
En resumen, CaaS reduce la carga operativa, mientras que DIY ofrece mayor control y personalización. Descubre más sobre el debate entre servicios gestionados y DIY.
CaaS vs IaaS vs PaaS vs FaaS vs SaaS: ¿Cuál es la diferencia?
Los modelos de servicio en la nube difieren principalmente en cuánta gestión de infraestructura y aplicaciones dejan al usuario:
| Modelo | Qué proporciona | Tú gestionas | El proveedor gestiona | Uso típico |
|---|---|---|---|---|
| IaaS (Infraestructura como Servicio) | Cómputo virtualizado, almacenamiento y red | SO, middleware, entorno de ejecución, aplicaciones y datos | Infraestructura física y virtualización | Infraestructura y aplicaciones personalizadas |
| CaaS (Contenedores como Servicio) | Entorno gestionado para aplicaciones en contenedores | Imágenes de contenedores, aplicaciones y configuraciones | Infraestructura, orquestación de contenedores y escalado | Aplicaciones en contenedores y microservicios |
| PaaS (Plataforma como Servicio) | Plataforma de aplicaciones y entorno de ejecución gestionados | Código de aplicación y datos | Infraestructura, SO, entorno de ejecución y plataforma | Desarrollo y despliegue de aplicaciones |
| FaaS (Función como Servicio) | Ejecución de funciones serverless basadas en eventos | Funciones individuales y su código | Servidores, entorno de ejecución, escalado e infraestructura | Tareas de corta duración basadas en eventos |
| SaaS (Software como Servicio) | Software completo listo para usar | Configuración y datos | Todo el stack de aplicaciones e infraestructura | Aplicaciones para el usuario final |
CaaS se sitúa entre IaaS y PaaS, dándote control sobre las aplicaciones en contenedores mientras el proveedor gestiona gran parte de la infraestructura subyacente y la orquestación.
¿Admite Bright Data el modelo de servicio en la nube CaaS?
Bright Data complementa CaaS proporcionando la infraestructura de datos web necesaria para la recopilación de datos a gran escala, mientras que CaaS proporciona la infraestructura de cómputo para ejecutar y escalar tus workers en contenedores.