Hacer scraping de Etsy significa recopilar datos de listados, tiendas y reseñas de las páginas públicas de Etsy. Etsy reportó más de 100M de artículos y 5.6M de vendedores activos en el informe anual de 2025. Etsy usa DataDome. Una solicitud directa devuelve un 403 y una página de bloqueo. Las 2 soluciones que suelen probarse primero son un User-Agent de Chrome y la suplantación de TLS. Ambas siguen recibiendo un 403. Esta guía muestra qué cambia el 403, qué bloquea robots.txt, y qué problemas de extracción corrompen un dataset de Etsy sin generar un error.
TL;DR
- Etsy usa DataDome detrás de Fastly. DataDome pone una puntuación de riesgo en su propio encabezado de respuesta. Puedes calificar una solicitud antes de escribir un crawler.
- Etsy rechazó los 9 transportes que probamos. Un navegador con interfaz cargó la primera página en 2.2 segundos. Etsy rechazó la segunda solicitud.
- robots.txt prohíbe la búsqueda por palabras clave y el historial de ventas, y declara no tener sitemap. Las páginas de listados y tiendas permanecieron abiertas. Pero los términos de Etsy son más estrictos.
- La moneda y el precio dependen de la IP de salida. Nuestra muestra de datos tenía 19 monedas. Un promedio sin filtrar de esa columna fue 227 veces demasiado alto.
Qué devuelve Etsy a una solicitud automatizada
Lee primero el rechazo. No reintentes la solicitud. Una solicitud simple te dice qué proveedor funciona en el borde y cómo te calificó ese proveedor. Cualquier URL de listado funciona. Esta pertenece a un vendedor, así que puede que ya no exista:
curl -sD - -o /dev/null https://www.etsy.com/listing/753913297/smoky-quartz-ring-rose-gold-ring-womenEl servidor devuelve un 403 con estos encabezados:
HTTP/2 403
server: DataDome
x-datadome: protected
x-datadome-riskscore: 0.9230727100377928
accept-ch: Sec-CH-UA,Sec-CH-UA-Mobile,Sec-CH-UA-Platform,Sec-CH-UA-Arch,Sec-CH-UA-Full-Version-List,Sec-CH-UA-Model,Sec-CH-Device-Memory
set-cookie: datadome=ovuDEZ4S0taK1jDAOvZ9W3Uq2qUujN_iPPE3uXp7~r3msKXSvMFPp4j30em5IvR0...
via: 1.1 varnish
x-served-by: cache-del-vibw2260027-DEL
Ese bloqueo contiene 3 datos. Etsy usa DataDome, no el Akamai Bot Manager que las guías antiguas aún reportan, así que planifica contra las capas de detección de DataDome. Fastly funciona delante de Etsy, y los encabezados Via y X-Served-By muestran ese salto. X-DataDome-riskscore es la puntuación de DataDome sobre cuán parecida a un bot parecía la solicitud, en una escala donde 1.0 es el peor caso. Etsy puede cambiar de proveedor, así que vuelve a ejecutar el comando antes de planificar en base a estos 3 datos.
Ese encabezado te da un número con el cual medir. En nuestras pruebas, la puntuación fue determinista. Las 6 muestras intercaladas de la misma solicitud devolvieron 0.9230727100377928. La puntuación sigue la firma de la solicitud, la IP que llama, y la cookie datadome una vez que empiezas a devolver una, no un conteo acumulado de solicitudes. Así que tus propios números pueden diferir, y en una dirección distinta el orden entre configuraciones de cliente también puede diferir.
El cuerpo, de 776 bytes en nuestras ejecuciones, es una página de bloqueo de DataDome que carga ct.captcha-delivery.com/c.js. Esa página de bloqueo contiene un script de desafío, no datos de listado, así que un parser que la lea devuelve campos vacíos en lugar de un error. La configuración incrustada contenía 't':'fe', la verificación de dispositivo de DataDome, así que esa solicitud recibió un desafío que un navegador real puede responder en lugar de un bloqueo permanente. El campo 't' muestra la calificación actual y toma otros valores según cambia esa calificación, así que lee tu propio valor en lugar de asumir 'fe'.
Enviamos cada solicitud desde 1 cliente mínimo de 3 encabezados y variamos solo la ruta. Cada ruta de contenido que probamos devolvió el mismo 403 y la misma puntuación de 0.482, mientras que /robots.txt y una URL que no resuelve nada fueron a Apache sin protección:
path                                       HTTP server     riskscore
/                                          403  DataDome   0.482
/listing/753913297/smoky-quartz-ring...    403  DataDome   0.482
/shop/AnemoneJewelry                       403  DataDome   0.482
/legal/terms/                              403  DataDome   0.482
/robots.txt                                200  Apache     -
/nonexistent-path-xyz                      404  Apache     -
Así que en las rutas que protege DataDome, califica al que llama en lugar de a la URL.
Una solicitud con un User-Agent de Googlebot evitó DataDome y llegó a un limitador de tasa en su lugar. Apache respondió 429 Too Many Requests con una cadena de referencia nicki_. Al menos 1 agente de motor de búsqueda declarado llega a un limitador de tasa propio, separado de DataDome.
Por qué las huellas de encabezados y TLS no son suficientes
La puntuación de riesgo permite probar el consejo habitual sobre encabezados, donde un número más bajo significa menos parecido a un bot. Mantuvimos la IP y la URL constantes, variamos solo los encabezados de solicitud en un cliente requests, y registramos la puntuación que devolvió DataDome:
headers sent                                         score    HTTP
requests, library default headers                    0.977    403
+ Chrome User-Agent only                             0.923    403
full 12-header Chrome set                            0.503    403
User-Agent + accept + sec-fetch-site (3 headers)     0.482    403
Esa tabla contiene 2 resultados. Agregar un User-Agent de Chrome apenas movió la calificación, porque todo lo demás en la solicitud seguía viniendo de requests. Y el conjunto de 3 encabezados puntuó mejor que el conjunto completo de 12 encabezados, así que en este objetivo la consistencia importó más que la cantidad de encabezados.
Estos 3 encabezados puntuaron 0.482, así que copia el valor de accept exactamente:
User-Agent:      Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36
                 (KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36
accept:          text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,
                 image/webp,image/apng,*/*;q=0.8,application/signed-exchange;v=b3;q=0.7
sec-fetch-site:  none
Quitamos 1 encabezado a la vez del conjunto completo y registramos cada cambio, donde un signo más significa que la puntuación empeoró:
run                              score     change
full set (baseline)              0.503
minus accept                     0.845     +0.342
minus user-agent                 0.784     +0.281
minus sec-fetch-site             0.669     +0.166
minus every sec-ch-ua* header    0.503      0.000
DataDome anuncia 7 client hints en su propio encabezado de respuesta Accept-CH. Nuestro conjunto completo tenía 3 de ellos, pero eliminar cada encabezado sec-ch-ua no cambió nada. El encabezado accept movió la puntuación más que el User-Agent.
La suplantación de TLS es el siguiente paso habitual, así que lo probamos por separado. Cada ejecución envió los mismos 3 encabezados, y solo cambió la huella TLS y HTTP/2. Los valores JA4 de abajo provienen de curl_cffi y no de Etsy, así que cambian cada vez que esa librería actualiza un perfil:
transport                             JA4                      riskscore  HTTP
python requests (OpenSSL, HTTP/1.1)   t13d1712h1_ab0a1bf427ad  0.482      403
curl_cffi impersonate=chrome110       t13d1516h2_8daaf6152771  0.663      403
curl_cffi impersonate=chrome116       t13d1516h2_8daaf6152771  0.663      403
curl_cffi impersonate=chrome124       t13d1516h2_8daaf6152771  0.503      403
curl_cffi impersonate=chrome131       t13d1516h2_8daaf6152771  0.503      403
curl_cffi impersonate=chrome133a      t13d1516h2_8daaf6152771  0.503      403
curl_cffi impersonate=firefox133      t13d1716h2_5b57614c22b0  0.503      403
curl_cffi impersonate=safari17_0      t13d2014h2_a09f3c656075  0.663      403
curl_cffi impersonate=safari17_2_ios  t13d2014h2_a09f3c656075  0.663      403
Esa tabla contiene 3 huellas diferentes, una para Chrome, Firefox y Safari. El requests simple en HTTP/1.1 aún puntuó mejor que las 3. Esa columna muestra solo las primeras 2 partes de un JA4. La tercera parte codifica la lista de extensiones y difiere entre los perfiles de Chrome que comparten un prefijo aquí.
El transporte movió la puntuación en 0.181 entre la mejor y la peor ejecución, pero ninguna devolvió una página. Ninguna huella que probamos fue suficiente por sí sola.
Así que las huellas TLS no valen el esfuerzo en este objetivo. Leímos los frames HTTP/2 de vuelta de cada perfil, incluyendo el orden de pseudo-encabezados que difiere por motor:
profile      SETTINGS                       | window   | pri | pseudo-header order
chrome131    1:65536;2:0;4:6291456;6:262144 | 15663105 | 0   | m,a,s,p
firefox133   1:65536;2:0;4:131072;5:16384   | 12517377 | 0   | m,p,a,s
safari17_0   2:0;4:4194304;3:100            | 10485760 | 0   | m,s,p,a
Esos 3 handshakes son copias correctas, y Etsy rechazó los 3. Así que DataDome decide en base a algo distinto del handshake.
Qué ejecuta realmente la verificación
En un navegador con interfaz, el desafío de DataDome se renderiza como un control deslizante, y 2 de sus 4 razones son la IP que llama y el uso de herramientas de desarrollador:
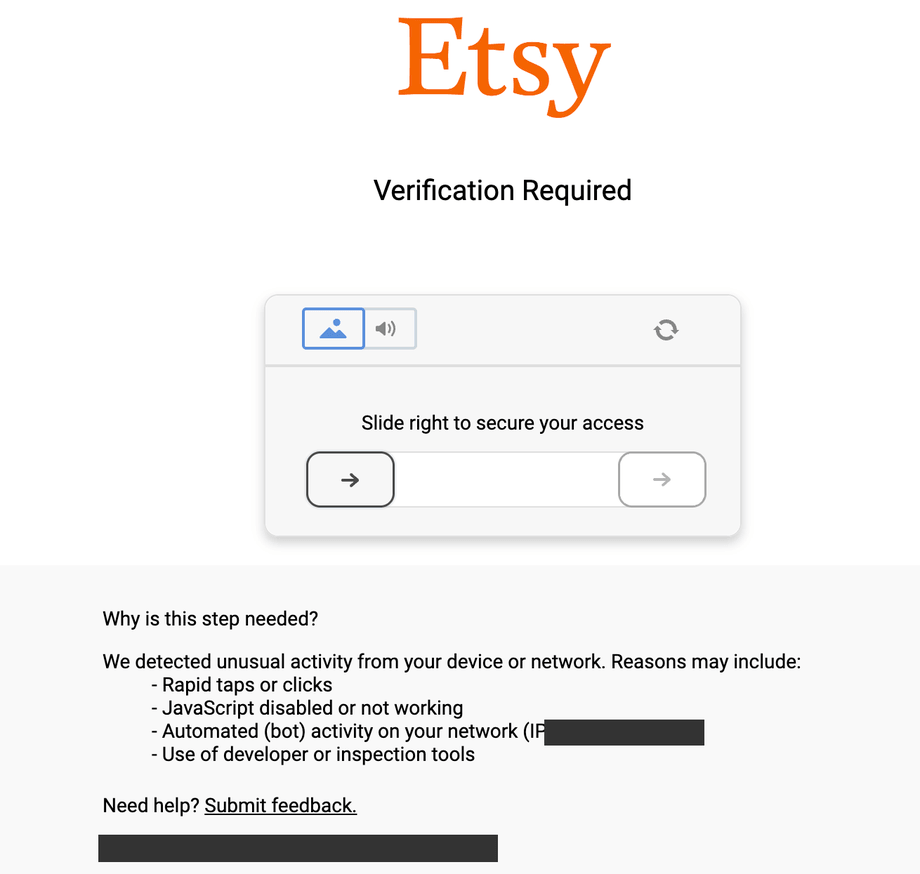
Ese cargador c.js pesa 14 KB, construye una URL de iframe, y obtiene una segunda página. Esa segunda página contenía un script en línea de 596 KB el día que lo revisamos, y los nombres de sus módulos muestran lo que tendrías que reimplementar:
detection-js/dist/vm-obf.js     the detection engine, VM-obfuscated
detection-js/dist/captcha.js    challenge coordination
./picasso                       canvas-based device-class fingerprinting
./mouseMaths                    pointer-movement analysis
./slidercaptcha  ./hash  ./helpers  ./bean
El módulo de detección se almacena como bytecode para un intérprete incluido en el mismo archivo. Por eso una búsqueda de texto en el paquete no encuentra webdriver, ni cdc_, ni headless ni _phantom. Un paquete de bytecode oculta esas cadenas sin importar si las pruebas se ejecutan o no, así que el resultado de la búsqueda no te dice nada.
La compilación que revisamos se identificó como 1.34.0, cronometró su propia ejecución, y envió esa duración como señal. Esa compilación también registró una advertencia en consola pidiendo cerrar DevTools antes de continuar. Espera una versión distinta y una lista de módulos distinta cuando lo revises, ya que este motor sigue el ciclo de lanzamiento de DataDome y no el de Etsy. La arquitectura detrás de esos nombres cambia mucho más lentamente.
La solicitud de verificación tiene 16 campos y codifica el entorno del navegador en userEnv, ddCaptchaEnv y plv3.
Así que hay 2 conclusiones prácticas. Reproducir esa salida desde requests significa reimplementar una VM ofuscada contra una cadena de versión que se incrementa. Y DataDome recopila salida de canvas y movimiento del puntero, que solo existen después de que un motor de navegador real ha renderizado la página. El desbloqueo específico de DataDome ejecuta ese motor de navegador como servicio y está construido para devolver la página renderizada en lugar del bloqueo.
Esa segunda conclusión es comprobable, así que ejecutamos un Chromium de Playwright simple sin parches stealth y sin proxy. Cada modo se ejecutó 3 veces desde la misma dirección en la que todos los transportes anteriores fueron rechazados:
headless=True (default)        403  403  403     1,530 B    0.5s
headless=True --headless=new   403  403  403     1,530 B    0.4s
headless=False (headed)        200  200  200   532,049 B    2.2s   Product JSON-LD present
Ambas ventanas se ejecutaron desde 1 máquina sin proxy, así que la ventana con interfaz muestra precios en la moneda local:
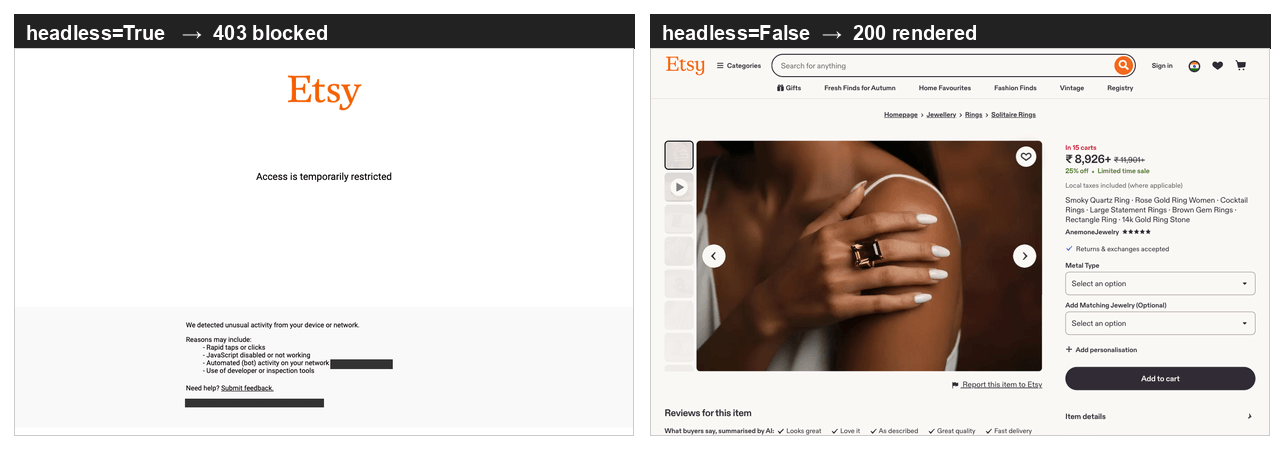
Chromium headless incluye HeadlessChrome en su propio User-Agent, así que esas filas difieren en más que la ventana. Para revisar una página manualmente, o extraer unas pocas páginas, un navegador con interfaz es la respuesta más simple. La infraestructura de desbloqueo está construida para las solicitudes posteriores a la primera, y para una sola extracción un proceso con interfaz es aproximadamente 10 veces más rápido que pasar por ella.
Por qué un solo navegador no es un crawler
Cargamos 12 listados de uno en uno en una sola página de navegador, con 2 segundos de separación, y obtuvimos 1 éxito y 11 rechazos:
#1   200   444,123 B
#2   403     1,527 B
#3-12 403   ~1,530 B each
Descartar el contexto de navegación entre navegaciones restauró el 200, así que los rechazos venían del estado de sesión y no de la dirección. Más tarde en el mismo período de pruebas, esa solución dejó de funcionar. Etsy entonces rechazó toda solicitud desde esa dirección, sin importar cuán nuevo fuera el contexto.
La puntuación de riesgo no se movió mientras la tasa de éxito pasó de todas las solicitudes a ninguna. La ejecución de 3 encabezados aún medía 0.4822 con 4 decimales, horas y varios cientos de solicitudes después de la primera lectura.
El encabezado X-DataDome-riskscore califica 1 solicitud a la vez, así que es útil para probar 1 cambio, pero no para monitorear un crawl. Una canalización que lo observe reportará éxito mientras no recopila nada.
Recopilar más de unas pocas páginas necesita 2 cosas, un nuevo contexto de navegación y una dirección que DataDome no haya rechazado ya. Descartar el contexto entre navegaciones es barato, así que empieza por ahí, pero esa solución dura solo hasta que DataDome rechace la dirección. Los proxies residenciales te dan un grupo de direcciones por las que rotar.
Web Unlocker ejecuta ambas cosas, y el script más adelante se mantiene dentro de la cuota gratuita. Browser API maneja ambas dentro de un navegador alojado que tu código de Playwright controla.
Qué no permiten robots.txt y los términos de Etsy
Antes de construir nada, lee tú mismo el robots.txt de Etsy, porque el archivo prohíbe la búsqueda por palabras clave y Etsy lo reescribe sin aviso. Cuando lo leímos, ese archivo tenía 1,818 líneas y declaraba solo 3 grupos de user-agent, *, AdsBot-Google-Mobile y Spinn3r:
User-agent: *
Disallow: /search?*q=
Disallow: /search/?*q=
Disallow: */shop/*/sold*
Disallow: */listing/*/favoriters*
Disallow: /api/
Allow:    /search/shops
El grupo comodín prohíbe los resultados de búsqueda por palabras clave en cada variante de idioma. Ese grupo cubre todo crawler que los otros 2 grupos no nombren. El historial de listados vendidos y el conteo de favoritos también están prohibidos, y están entre las señales de demanda más claras que publica Etsy. Las páginas de listados y de tiendas no tienen regla Disallow, así que ambas permanecen abiertas.
El archivo no declara directiva Sitemap:, y /sitemaps.xml responde 403 con un cuerpo vacío. Esas 2 ausencias importan tanto como las reglas Disallow anteriores. Ambas son verificaciones de 1 línea que vale la pena repetir, porque Etsy puede volver a agregar cualquiera de las dos sin aviso. Mientras sigan ausentes, tienes que descubrir los listados a partir de las páginas que Etsy deja abiertas.
Etsy no nombró ningún crawler de IA en ninguna parte del archivo cuando lo leímos, y no publicó llms.txt ni ai.txt. Esa ausencia es lo más probable que haya cambiado en esta sección desde que lo verificamos.
DataDome rechaza esos crawlers en el borde de todos modos. GPTBot y ClaudeBot recibieron ambos un 403, y ambos puntuaron 0.9814 en nuestra prueba, más alto que el 0.923 que puntuó la misma dirección con un User-Agent de Chrome. Cadenas de User-Agent sin sentido con los mismos encabezados obtuvieron la misma puntuación, así que DataDome califica la ausencia de un navegador conocido en lugar del nombre del crawler.
Los Términos de Uso de Etsy, actualizados por última vez el 26 de agosto de 2025, establecen que aceptas “no rastrear, hacer scraping ni usar spiders en ninguna página de los Servicios” sin permiso expreso.
Verifica si tu capa de recopilación aplica robots.txt por ti, y en qué momento decide. El endpoint de desbloqueo residencial decide por solicitud. En una cuenta sin KYC completado, una solicitud a la ruta de búsqueda prohibida devuelve la regla y el formulario de KYC:
Residential Failed (bad_endpoint): Requested site is not available for immediate
residential (no KYC) access mode in accordance with robots.txt. To get full
residential access for targeting this site, fill in the KYC form:
https://brightdata.com/cp/kyc
La misma cuenta obtuvo /shop/AnemoneJewelry sin error, y la respuesta fue de 983,937 bytes. El endpoint lee el mismo robots.txt que tú leíste, luego sirve las rutas permitidas y dirige las rutas prohibidas a una revisión de cumplimiento en lugar de a un proxy. Decide si tu caso de uso necesita las rutas prohibidas antes de empezar a construir.
Si construyes tú mismo la capa de obtención, tomas esa decisión en código, y eres responsable de mantener el manejo de robots.txt por cada objetivo.
Qué devuelve la API oficial de Etsy, y qué omite
La API es la vía autorizada, así que revisa qué hace antes de descartarla. La elección entre una API oficial y el scraping es general, y en Etsy depende de los campos que la especificación omite. Extrajimos directamente la especificación OpenAPI y contamos 76 rutas, de las cuales 31 operaciones GET necesitan solo una clave de aplicación y ningún OAuth de vendedor. Esos totales cambian cada vez que Etsy agrega o elimina un endpoint, así que vuelve a contar desde ese archivo y no desde este párrafo.
Las afirmaciones comunes sobre la API v3 son incorrectas en 3 puntos. findAllListingsActive no fue eliminado, y acepta keywords, min_price, max_price, taxonomy_id, shop_location, currency y buyer_country, con un limit máximo de 100 por llamada. getReviewsByListing y getReviewsByShop devuelven el texto de la reseña solo con una clave de aplicación. getShop devuelve transaction_sold_count, review_count, review_average, num_favorers y listing_active_count para cualquier tienda.
La especificación lleva 1 campo de demanda y omite el resto. getListing necesita solo una clave de aplicación y devuelve views, un conteo de vistas acumulado que se actualiza una vez al día, en el esquema ShopListingWithAssociations. Buscar en todo el documento no devuelve ningún campo para volumen de búsqueda, impresiones, tasa de conversión o ventas por listado. El esquema ShopListing tenía 50 propiedades cuando las contamos, incluyendo num_favorers, quantity y price, y ninguna de ellas era un conteo de ventas. Vuelve a verificar el conteo contra la especificación, pero aún no ha aparecido ningún campo de ventas.
Las transacciones por listado sí tienen un endpoint, getShopReceiptTransactionsByListing, pero necesita el scope de OAuth transactions_r, que solo el dueño de la tienda puede conceder para su propia tienda. Para cualquier tienda que no operes, Etsy publica las ventas totales a nivel de tienda como un total actual sin historial, y nada por listado.
Esa brecha explica el mercado de herramientas de terceros alrededor de Etsy. Algunos productos venden estimaciones de ventas por listado o volumen de búsqueda de palabras clave para tiendas que no operan. Nada en la especificación que leímos devuelve esos números para una tienda que no te pertenece, así que esos datos deben provenir de fuera de esta API.
Etsy aplica límites de tasa por clave de aplicación, por segundo y por día. Los encabezados de respuesta x-limit-per-second y x-limit-per-day reportan ambos, y Etsy devuelve un 429 con un retry-after cuando excedes cualquiera de los dos.
La página de límites de tasa etiqueta sus cifras como “Valor de ejemplo” en lugar de valores predeterminados. El par anterior “10,000 por día, 10 por segundo” había desaparecido de esa página cuando la leímos. Lee tus propios límites desde el Portal de Desarrolladores.
Haz scraping de páginas de listados y tiendas de Etsy con Python
Las páginas de listados de Etsy incrustan JSON-LD de schema.org, así que el paso de extracción no necesita selectores CSS y no se rompe cuando Etsy rediseña el marcado alrededor. El paso de obtención necesita infraestructura, y tienes 2 formas de hacerlo. Una API desbloqueada funciona en cualquier lugar y necesita una cuenta. Un navegador local no necesita cuenta y sirve para unas pocas páginas.
El script de abajo necesita 1 librería y 2 variables de entorno:
python3 -m venv .venv && source .venv/bin/activate
pip install requests
export BRIGHTDATA_API_KEY="your-api-token"
export BRIGHTDATA_ZONE="web_unlocker"
El token proviene del panel de control de Bright Data. Cada solicitud con ese token gasta el saldo de tu cuenta, así que guárdalo en una variable de entorno y no en un script publicado.
El segundo valor lo creas en Web Access → Add API → Web Unlocker API. La carga de la solicitud lo llama zone, pero el panel de control lo etiquetó como una API cuando lo configuramos, así que buscar “zone” en el panel no encontró nada. BRIGHTDATA_ZONE tiene que coincidir con el nombre que escribas ahí, ya que el script usa por defecto web_unlocker. El formulario advierte que el nombre es permanente:
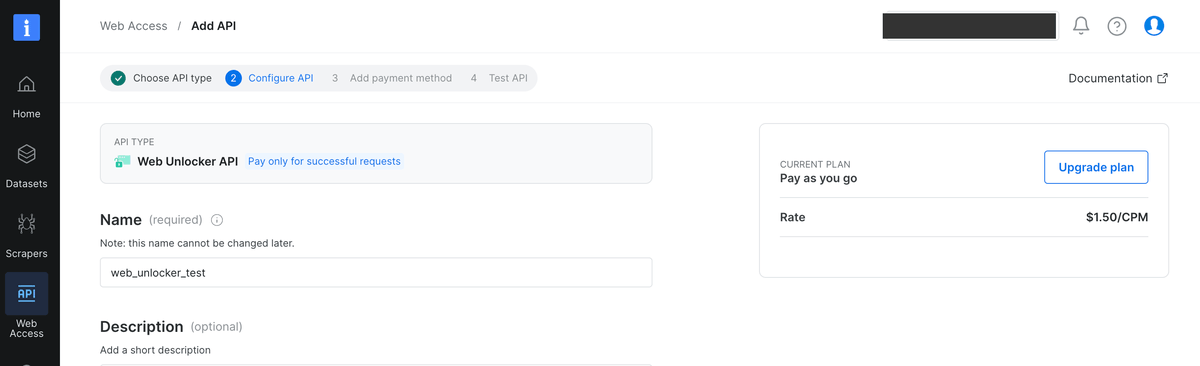
La zona en esa captura se llama web_unlocker_test, así que el valor predeterminado del script no la encontraría. Establece BRIGHTDATA_ZONE con el nombre que escribiste, o usa web_unlocker y deja el predeterminado tal cual. La guía rápida de Web Unlocker documenta ambos casos, y empezamos con la cuota gratuita sin tarjeta cuando lo configuramos. La página de precios de Web Unlocker lista la cuota gratuita actual y la tarifa de pago por uso más allá de ella, cotizada por cada 1K solicitudes exitosas. El panel escribe esa tarifa como un CPM.
Este script envía la solicitud a través del endpoint de Web Unlocker y analiza el resultado:
import json
import os
import re
import requests

API_KEY = os.environ.get("BRIGHTDATA_API_KEY")
ZONE = os.environ.get("BRIGHTDATA_ZONE", "web_unlocker")
ENDPOINT = "https://api.brightdata.com/request"

LD_JSON = re.compile(
    r'<script[^>]*type\s*=\s*[\'"]application/ld\+json[\'"][^>]*>(.*?)</script\s*>',
    re.S | re.I,
)


def fetch_html(url, country="us"):
    """Return the rendered HTML for an Etsy URL, or raise on failure."""
    # Checked here rather than at import, so the browser path below runs
    # without an account.
    if not API_KEY:
        raise SystemExit("BRIGHTDATA_API_KEY is not set, see the exports above")
    response = requests.post(
        ENDPOINT,
        headers={"Authorization": f"Bearer {API_KEY}"},
        json={"zone": ZONE, "url": url, "format": "raw", "country": country},
        timeout=90,
    )
    response.raise_for_status()
    body = response.text
    # A quota error arrives as HTTP 200 with a short text body, and a block page
    # arrives as HTTP 200 of valid HTML. Neither contains ld+json, which is the
    # content this actually wants, so test for that rather than for either error.
    if not LD_JSON.search(body):
        raise RuntimeError(f"no ld+json in response, most likely blocked: {body[:200]!r}")
    return body


def product_jsonld(html):
    """Pick the Product block by @type. Every listing we opened had four."""
    for block in LD_JSON.findall(html):
        try:
            parsed = json.loads(block.strip())
        except json.JSONDecodeError:
            continue
        for node in parsed if isinstance(parsed, list) else [parsed]:
            if node.get("@type") == "Product":
                return node
    return None


def parse_listing(node):
    """Flatten a Product node, keeping the offer's range rather than its lowest price."""
    offer = node.get("offers", {})
    # schema.org allows a list of offers and a single priceSpecification object,
    # and Etsy serves both, so normalize before indexing into them.
    if isinstance(offer, list):
        offer = offer[0] if offer else {}
    specs = offer.get("priceSpecification", [])
    if isinstance(specs, dict):
        specs = [specs]
    base = next((s for s in specs if "priceType" not in s), {})
    was = next(
        (s for s in specs if "Strikethrough" in str(s.get("priceType", ""))), {}
    )
    # Not every listing carries a priceSpecification. Without this fallback a
    # single-variant listing records a null price and raises nothing.
    # A range arrives three ways: nested in priceSpecification, as AggregateOffer's
    # own lowPrice and highPrice, or not at all. Try them in that order.
    low = base.get("minPrice") or offer.get("lowPrice") or offer.get("price")
    high = base.get("maxPrice") or offer.get("highPrice") or offer.get("price")
    # availability is the only field that marks a dead listing, and JSON-LD lets it
    # arrive as a bare term, an array, or an @id object. Normalize before comparing.
    avail = offer.get("availability") or ""
    if isinstance(avail, list):
        avail = avail[0] if avail else ""
    if isinstance(avail, dict):
        avail = avail.get("@id", "")
    rating = node.get("aggregateRating", {})
    return {
        "sku": node.get("sku"),
        "title": node.get("name"),
        # Etsy serves a dead listing as a full HTTP 200 page that still
        # carries a price, so availability is the only field that says so.
        "availability": str(avail).rsplit("/", 1)[-1],
        "currency": offer.get("priceCurrency"),
        "price_min": low,
        # high can be a bundle maximum rather than the item's, where a listing
        # has an add-on axis. Count the axes before trusting it as a maximum.
        "price_max": high,
        "list_price": was.get("price"),
        # True only where the variations differ in price. Same-price variants
        # read false, so this is a price-spread test, not a variation test.
        "has_variations": None if low is None else low != high,
        "rating": rating.get("ratingValue"),
        "review_count": rating.get("reviewCount"),
        "shop": node.get("brand", {}).get("name"),
    }


if __name__ == "__main__":
    url = (
        "https://www.etsy.com/listing/753913297/"
        "smoky-quartz-ring-rose-gold-ring-women"
    )
    node = product_jsonld(fetch_html(url, country="us"))
    if node is None:
        raise SystemExit("no Product block on page: blocked, or the layout changed")
    print(json.dumps(parse_listing(node), indent=2))
Ejecutamos el script contra un listado en vivo, y devolvió un registro plano. El rango de precios viene de 1 listado con muchas variaciones con precios distintos:
{
  "sku": "753913297",
  "title": "Smoky Quartz Ring · Rose Gold Ring Women · Cocktail Rings · ...",
  "availability": "InStock",
  "currency": "USD",
  "price_min": "89.25",
  "price_max": "5613.75",
  "list_price": "119.00",
  "has_variations": true,
  "rating": "4.5",
  "review_count": 99,
  "shop": "AnemoneJewelry"
}
En 3 ejecuciones contra el mismo listado, las obtenciones tardaron entre 23 y 27 segundos y devolvieron entre 540 KB y 750 KB. Esas cifras son el costo del paso de desbloqueo. Presupuesta latencia en ese rango en lugar del tiempo de menos de un segundo de un bloqueo.
Si solo necesitas unas pocas páginas y prefieres no abrir una cuenta, un navegador local llega al mismo resultado con aproximadamente la misma cantidad de código. Ese navegador funciona desde una dirección que DataDome aún no ha rechazado. Necesita una pantalla, así que en un servidor ejecútalo con interfaz bajo una pantalla virtual como Xvfb en lugar de en modo headless. Instala Playwright y Chromium una vez:
python3 -m venv .venv && source .venv/bin/activate   # skip if already active
pip install playwright requests
playwright install chromium
Luego cambia la obtención, manteniendo las mismas 2 funciones de análisis. Coloca esto arriba del bloque __main__, con las otras funciones:
from playwright.sync_api import sync_playwright


def fetch_html_browser(url):
    """Fetch one page with a visible browser, since headless returns a 403."""
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=False)
        context = browser.new_context(locale="en-US")
        page = context.new_page()
        page.goto(url, wait_until="domcontentloaded", timeout=45000)
        html = page.content()
        browser.close()
        # Same rule as the guard above: test for the content you want. A block
        # page is valid HTML, so only the missing ld+json shows it.
        if not LD_JSON.search(html):
            raise RuntimeError("no ld+json on page, most likely a block page")
        return html
Cambia 1 línea dentro del bloque __main__, y nada más:
node = product_jsonld(fetch_html_browser(url)) # was: fetch_html(url, country="us")Nuestra ejecución devolvió 535,247 bytes y se analizó correctamente con las mismas 2 funciones. La página también tenía precios en INR, porque un navegador en tu máquina sale desde tu propia dirección, y la ruta del navegador no acepta un argumento country. Sin ese argumento no puedes fijar el país de salida, así que esta ruta sirve para unas pocas páginas en lugar de para un dataset.
El código anterior analiza la página en lugar de enviarla a un modelo. Etsy publica los campos como datos estructurados, así que leerlos es determinista y prácticamente gratis. En el listado que medimos, seleccionar el bloque Product y aplanarlo toma una mediana de 0.3 milisegundos.
Entregar la misma página a un modelo de lenguaje en su lugar significa 179,599 tokens de HTML sin procesar, la mayor parte de una ventana de contexto de 200K tokens para 1 producto. Eliminar primero el marcado reduce eso a 5,352 tokens, una reducción del 97%. Esa proporción importa más que la elección del modelo.
Pero un parser que deja de coincidir devuelve un campo vacío en lugar de un error, mientras que un modelo al menos produciría algo incorrecto y visible. Así que toma la ruta determinista en un sitio que publica schema.org. Usa el tiempo que ahorras para verificar que el parser aún devuelva los campos que esperas.
Las páginas de tiendas también tienen 4 de estos bloques, bajo tipos diferentes, y uno de ellos muestra de dónde vienen las URLs de los listados. /shop/{shop_name} devuelve un nodo Organization que describe la tienda y un nodo ItemList cuyo itemListElement contiene URLs completas de listados. shop_itemlist selecciona el ItemList por @type, así que la misma función con Organization en su lugar devuelve los campos propios de la tienda. En la tienda que probamos, numberOfItems marcaba 1,842 mientras una sola página devolvía 36 URLs, y ?page=2 devolvía 36 más sin superposición.
El enumerador toma un nombre de tienda como entrada, así que necesitas una fuente de nombres de tienda, y 3 fuentes funcionan sin tocar la ruta de búsqueda prohibida. Puedes usar tiendas que ya sigas, el endpoint findAllListingsActive anterior, o un dataset preparado. Ese endpoint acepta keywords solo con una clave de aplicación, e incluye un shop_id en cada listado que devuelve.
Obtuvimos páginas a lo largo del rango y más allá del final declarado:
page  2    36 items
page 25    36 items
page 51    36 items
page 52     6 items      51 x 36 + 6 = 1,842
page 53    no ItemList block
page 60    no ItemList block
El total coincide con los 1,842 que declara la tienda. Más allá del final, Etsy sigue respondiendo con una página completa de aproximadamente 420 KB y sin ItemList.
Etsy no da error ni un array vacío en el cual terminar, así que un bucle que espere cualquiera de los dos seguirá paginando para siempre contra páginas que parecen correctas. Termina en el bloque faltante en su lugar, y deja que el conteo declarado verifique tu trabajo. Los patrones habituales para la recopilación paginada asumen una de esas 2 señales, así que no aplican aquí.
Ambas funciones van en el mismo archivo que las funciones anteriores, ya que usan LD_JSON y fetch_html. Comenta el punto de entrada que no estés ejecutando, ya que el enumerador tarda 20 minutos:
def shop_itemlist(html):
    """Pick the ItemList block. The first block on a shop page is a video."""
    for block in LD_JSON.findall(html):
        try:
            parsed = json.loads(block.strip())
        except json.JSONDecodeError:
            continue
        for node in parsed if isinstance(parsed, list) else [parsed]:
            if node.get("@type") == "ItemList":
                return node
    return None


def enumerate_shop(shop_name, country="us"):
    """Page a shop until the ItemList stops appearing, and hand back the declared
    count so the caller can check it."""
    base = f"https://www.etsy.com/shop/{shop_name}"
    urls, declared, page = [], None, 1
    while True:
        suffix = "" if page == 1 else f"?page={page}"
        try:
            node = shop_itemlist(fetch_html(base + suffix, country=country))
            if node is None:
                break
            declared = node.get("numberOfItems", declared)
            urls += [item["item"]["url"] for item in node["itemListElement"]]
        except (RuntimeError, requests.RequestException, KeyError, TypeError,
            AttributeError) as err:
            print(f"stopped at page {page}: {err}", flush=True)
            break
        print(f"page {page}: {len(urls)} of {declared}", flush=True)
        # Breaking on the declared count here would make the comparison below
        # vacuous, so page until the ItemList block stops appearing.
        page += 1
    return urls, declared


if __name__ == "__main__":
    urls, declared = enumerate_shop("AnemoneJewelry")
    print(len(urls), "collected,", declared, "declared")
El enumerador hace 53 obtenciones contra las páginas medidas arriba, devuelve 1,842 URLs, y verifica el total contra el conteo que declara la tienda. Compara esos 2 números en cada ejecución, porque una lectura corta devuelve menos URLs y no genera error.
El try tiene que cubrir el análisis además de la obtención. Un bucle de 53 solicitudes es lo bastante largo para recibir la respuesta de límite de tasa, y un solo itemListElement malformado causa el mismo daño que una solicitud fallida. Sin la protección, cualquiera de los dos genera error en la página 30 y descarta todas las URLs recopiladas hasta ese momento. Capturar ambos te deja con una lectura corta en lugar de una ejecución perdida, y la comparación de conteo lo muestra. El manejo de solicitudes fallidas en Python sigue un patrón estándar, y la única parte específica de Etsy es poner el análisis dentro de la protección.
Con la latencia medida arriba, 53 obtenciones son de 20 a 24 minutos y 53 solicitudes de la cuota mensual gratuita, para 1 tienda. Ejecuta el enumerador primero en una tienda pequeña y observa cómo aumenta el conteo de páginas antes de usarlo en una tienda con 1,842 listados. Establece también un límite de uso en la zona, para que una ejecución que falle se detenga en un tope en lugar de en tu saldo.
Ejecutamos el mismo descubrimiento a través del endpoint de tienda de Etsy del Web Scraper API como trabajo por lotes. Ejecutamos el trabajo en la tienda en lugar de en URLs de listados, y lo limitamos a 50 registros para la comparación. Devolvió 50 listados en 168.9 segundos, o aproximadamente 3.4 segundos por registro, sin duplicados y sin URLs con prefijo de idioma en esa ejecución.
Recopilar toda esa tienda toma 53 obtenciones de enumeración más 1,842 obtenciones de listados, o 1,895 solicitudes y aproximadamente 13 horas en un solo hilo. Verifica esas 1,895 contra la cuota gratuita actual antes de empezar. Más allá de esa cuota, el mismo trabajo se factura a la tarifa de pago por uso por cada 1K solicitudes exitosas.
Fija también country aquí. Obtuvimos la misma tienda sin eso y recibimos URLs /de/listing/ y títulos en alemán. Esas URLs entrarían en un dataset como claves distintas para artículos ya almacenados bajo su forma /listing/.
Problemas de extracción que corrompen silenciosamente un dataset de Etsy
Cada problema aquí devuelve HTTP 200 y no genera excepción. De los 5, 4 escriben una fila plausible pero incorrecta y el quinto escribe una fila vacía. En cambio, encuentras un número incorrecto meses después. Las métricas de calidad de datos detectan ese tipo de fallo después de que los datos están almacenados, y no escribir la fila mala es más barato.
Una página de listado tiene 4 bloques JSON-LD, no 1. Etsy incluyó Product, VideoObject, BreadcrumbList y FAQPage en 4 etiquetas de script separadas en cada listado que abrimos, todas con el tipo application/ld+json. El código fuente de la página las muestra en 4 líneas consecutivas:
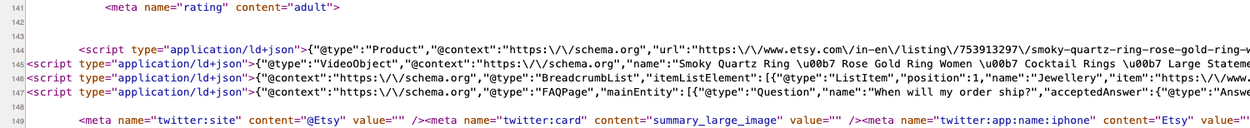
Un código que llame a find() y tome la primera coincidencia funciona en páginas de listados y devuelve silenciosamente el bloque de video en páginas de tiendas. Selecciona por @type en lugar de por posición. Nada más de la mecánica de analizar JSON en Python cambia.
Una página de tienda tiene 4 bloques propios, en un orden diferente:
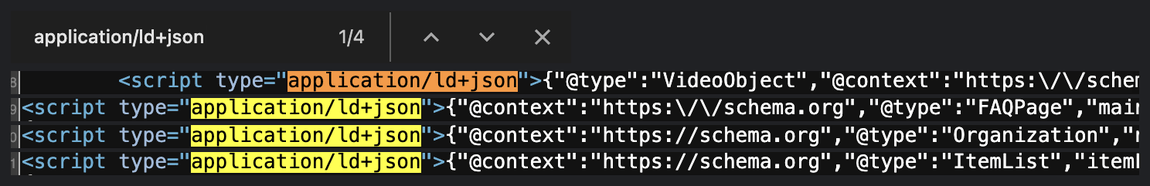
En la tienda que probamos, el primer bloque es un video y el ItemList que quieres es el último, así que tomar la primera coincidencia falla. El script anterior selecciona por @type en su lugar.
En un listado con variaciones, offers.price es el precio más bajo del rango, no el rango completo. En el listado que probamos, offers.price marcaba 89.25 mientras la entrada priceSpecification anidada dentro de offers declaraba minPrice 89.25 y maxPrice 5613.75. Un parser que lea offers.price registra la variación más barata y descarta el rango. Almacenar maxPrice en su lugar tampoco es la solución, porque en este listado maxPrice es el precio de un paquete y no solo del artículo.
Recopilamos la misma URL con las variaciones activadas y obtuvimos 61 registros separados, 1 por variante, con precios desde 89.25 hasta 1,871.25. Una sola fila de listado en tu tabla representa 61 SKUs comprables en un rango de precios de 21 veces.
Un segundo menú desplegable en la página multiplica ese rango:
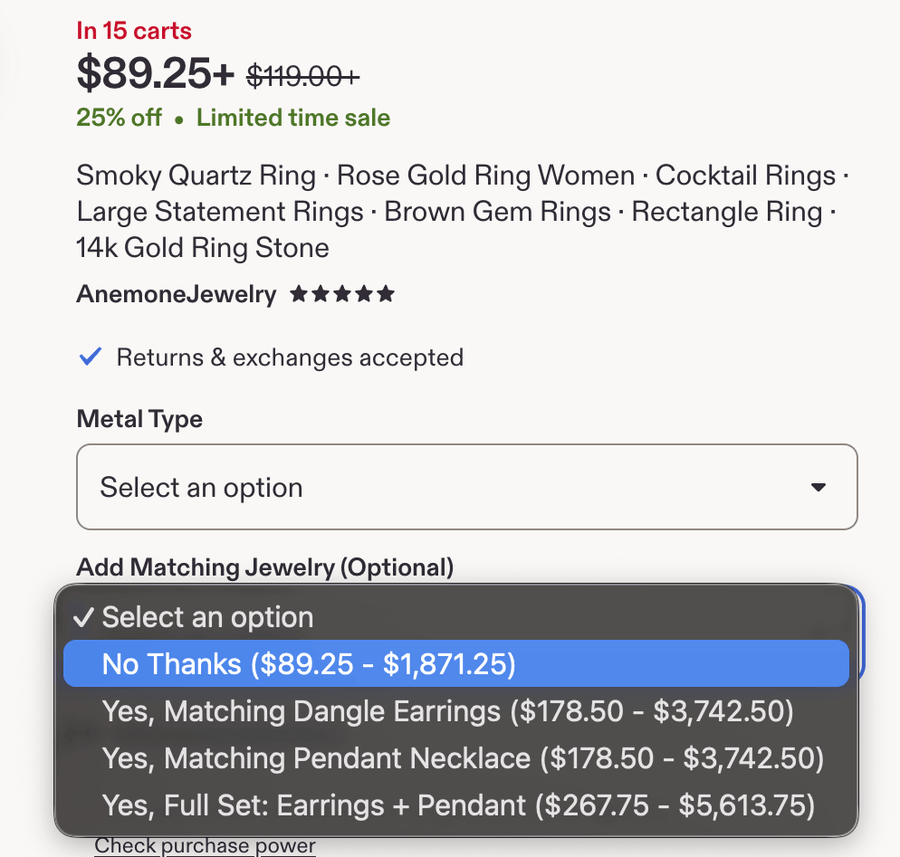
Esos 2 máximos miden cosas distintas, y este listado tiene 2 ejes de variación. Metal Type va desde 14k Gold Filled a 89.25 hasta las 3 opciones de oro sólido a 1,871.25. Add Matching Jewelry (Optional) multiplica después ese rango. No Thanks va de 89.25 a 1,871.25, cualquier pieza individual a juego va de 178.50 a 3,742.50, y Full Set: Earrings + Pendant va de 267.75 a 5,613.75.
El maxPrice declarado es el anillo de oro sólido más ambas piezas a juego, 3 artículos a 1 precio. El extracto de variación devolvió el anillo solo y coincidió exactamente con la fila No Thanks.
Así que siempre que un listado tenga un eje de complementos, maxPrice es el máximo de un paquete y no del artículo. Una serie de precios construida sobre eso sigue silenciosamente paquetes. Cuenta los ejes de variación antes de almacenar un rango como propio del producto. No están en el JSON-LD, así que léelos de la página renderizada o extrae el extracto de variación.
El mismo array priceSpecification también contiene una segunda entrada etiquetada StrikethroughPrice, así que el precio de oferta y el precio de lista aparecen lado a lado, diferenciados solo por una URL de schema.org. Esa entrada tiene su propio minPrice y maxPrice. El list_price que registra el script es el precio más bajo del rango de precio de lista, igual que offers.price es el más bajo del rango actual.
El idioma sigue la IP de salida, y cambia más que el símbolo de moneda. Obtuvimos 1 listado 3 veces en la misma hora, cambiando solo el país de salida:
country   currency   price    variation range      title
us        USD        89.25    89.25 - 5613.75      Smoky Quartz Ring, Rose Gold Ring Women
de        EUR        95.71    95.71 - 5058.76      Rauchquarzring, Damenring aus Roségold
gb        GBP        82.77    82.77 - 4338.22      Smoky Quartz Ring, Rose Gold Ring Women
El mismo listado se renderiza de forma diferente desde cada país de salida:
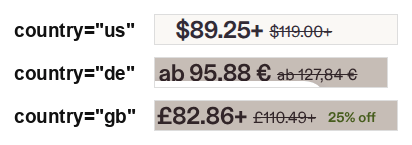
Esas capturas vienen de una obtención posterior a las 3 filas, y solo la cifra en dólares se mantuvo igual. La página alemana también escribe su precio más bajo como ab, o “desde”, y el + marca lo mismo en las otras 2 páginas.
Las 3 obtenciones devolvieron el mismo SKU, calificación y conteo de reseñas, a 3 precios diferentes en 3 monedas. La proporción entre el precio más bajo y el más alto difiere entre las 3 filas, 62.9x en la fila de EE.UU. contra 52.9x y 52.4x, así que más que el tipo de cambio cambió entre esas obtenciones. La salida alemana también devolvió un título traducido automáticamente, mientras que los 2 idiomas ingleses mantuvieron el original.
Un grupo rotativo que ignora la geografía produce una serie de precios que mezcla 3 monedas y un corpus de texto que mezcla idiomas, y nada en la canalización reporta un problema. Fija el país de salida por cada ejecución de recopilación y almacena la moneda junto a cada precio.
El mismo problema aparece en datos preparados. La muestra de 1,000 registros que descargamos tenía 19 monedas, con 109 filas en una moneda distinta de USD, 14 de ellas con precio en dong vietnamita. Esa muestra se actualiza, así que tu copia diferirá de estos totales. Ejecuta la misma comparación en tu propia copia.
Promediar la columna de precio sin leer la columna de moneda infla la media:
mean(final_price), all rows          31,238.84   n=991
mean(final_price), currency = USD       137.57   n=882
                                        ~227x
median(final_price), all rows            26.00
En esa columna, 14 filas de 991 contribuyen con el 87% del total, pero 109 filas no son USD y todas necesitan manejo. La consulta se ejecuta, la columna es un float limpio, y la respuesta es incorrecta en 2 órdenes de magnitud. La mediana apenas se mueve, porque las filas no-USD son una pequeña proporción de la columna. Una media y una mediana que discrepan tanto solo te dicen que hay una cola pesada presente. Agrupar por la columna de moneda separa unidades mezcladas de un sesgo ordinario.
Un artículo de arXiv de marzo de 2026 sobre listados de marketplace, citado de nuevo más abajo, restringió su muestra a listados con precio en USD antes de ejecutar cualquier análisis. Eso resuelve el problema después de la recopilación en lugar de durante ella. Filtrar de esa manera también cambia la población que describe el promedio, ya que descarta listados en otras monedas en lugar de convertirlos.
Este problema es más difícil de ver en la ruta de agentes. Obtuvimos este listado a través de un servidor MCP cuyo esquema acepta solo una URL, y obtuvimos la tienda checa con precio en CZK. La llamada REST con país fijado reporta el mismo listado a 89.25 USD.
La causa es la interfaz de la herramienta, no la obtención. Sin un parámetro de país o idioma que establecer, tomas cualquier salida que esté usando el servidor. Verifica ese comportamiento en cualquier servidor así antes de conectarlo a un agente, porque la salida decide la moneda de cada respuesta posterior.
Así que recopila los datos de Etsy en tu propio almacén con un idioma fijado, y haz que el agente lea ese almacén en lugar de obtener datos en vivo por cada pregunta. Un agente que responde silenciosamente en una moneda diferente cada vez es peor que un agente que no puede responder.
Un listado muerto es una página completa con un precio en ella. Etsy no devuelve un 404 para un listado expirado o agotado. Extrajimos un listado de 2007 y obtuvimos HTTP 200, 465,563 bytes, un bloque Product completo, y price 13.00 USD.
La página se renderiza por completo, y muestra tanto el banner de agotado como el precio:
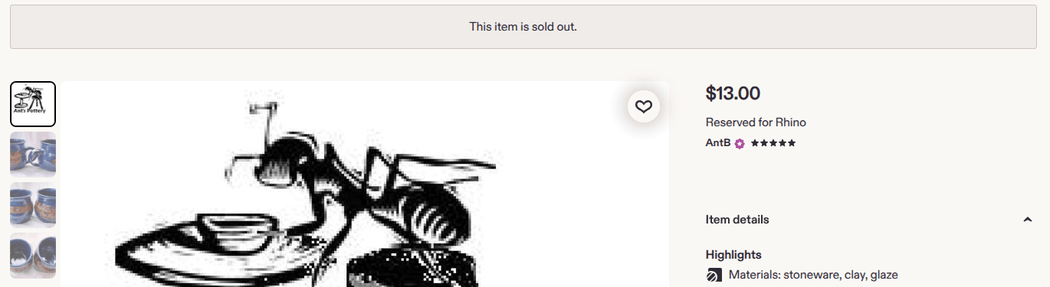
offers.availability es el único campo que contradice el precio, y marca schema.org/OutOfStock. Un parser que lo omita registra un artículo muerto a precio completo, así que el script anterior lee ese campo.
Ese campo es menos confiable en datos preparados que en la página. En esa misma copia, 74 de 1,000 filas eran listados agotados, availability estaba vacío en las 74, y 65 aún mostraban un precio numérico. La señal ahí es un parámetro show_sold_out_detail en la URL almacenada. Mantener solo las filas cuyo availability marca InStock descartaría 798 filas activas, porque el campo también está ausente en la mayoría de ellas.
Una respuesta 2xx no significa que tengas datos. Este problema está en la capa de recopilación y no en el contenido, y lo vimos con el script anterior durante las pruebas. El endpoint de desbloqueo se explica en el cuerpo. Cuando la cuenta alcanzó un límite de tasa de solicitudes, respondió 200 con un cuerpo de texto plano de 111 bytes que decía Your system is sending too many of this type of request. La línea de estado sigue siendo un éxito, así que raise_for_status() pasa, el parser no encuentra ningún bloque Product, y un bucle escribe filas vacías sin una sola excepción.
El Web Scraper API maneja ese mismo caso por diseño. Su endpoint síncrono de recopilación devuelve registros en menos de 1 minuto, y los trabajos más largos continúan de forma asíncrona. El mismo endpoint responde 202 con un snapshot_id y un retry-after cuando un trabajo supera ese minuto, así que puedes recopilar el resultado una vez que esté listo, como documenta la referencia de la API. Ambas respuestas son estados de éxito, así que ramifica según el código de estado antes de indexar en una lista de registros.
La protección en fetch_html tiene 2 líneas y prueba si la página contiene ld+json en lugar de probar contra cualquiera de los errores. Ejecutar el enumerador contra una tienda en vivo encontró un tercer caso, un 200 con un cuerpo vacío, y la misma protección lo capturó sin ningún cambio. Así que prueba la respuesta contra el contenido que quieres en lugar de contra los errores que ya viste, ya que el texto de error del proveedor no es una interfaz estable. Escribe el equivalente para cualquier capa de obtención que uses, porque un estado de éxito no garantiza el contenido.
Un ejemplo resuelto demuestra que un problema existe, no que sea común. Verificamos los problemas de rango de precios y tachado contra 100 listados de ambas rutas de descubrimiento. Las variaciones están presentes en 98 de 100, y initial_price difiere de final_price en esos mismos 98. Ninguno de los dos problemas es un caso extremo que puedas posponer. Esos 100 vinieron por las 2 rutas de descubrimiento anteriores en lugar de una muestra aleatoria de las categorías de Etsy. Así que lee 98 como un mínimo para listados de joyería y no como una tasa para el sitio.
La misma verificación muestra que el listado usado arriba es inusual en un aspecto. Ese listado tiene 99 reseñas, mientras que la mediana es 1 en ese rastreo y 0 en la muestra del dataset publicado.
Cuándo comprar un dataset gestionado en lugar de mantener un scraper
Puedes construir el scraper, y el código anterior es la mayor parte. La decisión es qué fallos quieres manejar tú mismo.
Ejecutamos el mismo listado a través del Web Scraper API de nuevo, esta vez recopilando por URL en lugar de descubriendo desde una tienda. Devolvió 58 campos frente a los 14 del bloque Product sin procesar, y los campos adicionales manejan la mayoría de los problemas anteriores:
raw JSON-LD (geo=us)          Web Scraper API
-----------------------------------------------------
price 89.25 (range minimum)   final_price 89.25
119.00 (StrikethroughPrice)   initial_price 119
not present                   discount_percentage 25
not present                   listing_has_variations true
not present                   reviews_count_shop 15129
not present                   is_star_seller false
4 embedded reviews            6 top_reviews
14 fields                     58 fields
Configuras ese extractor por URL de entrada, y estableces all_variations en true para el problema de rango de precios:
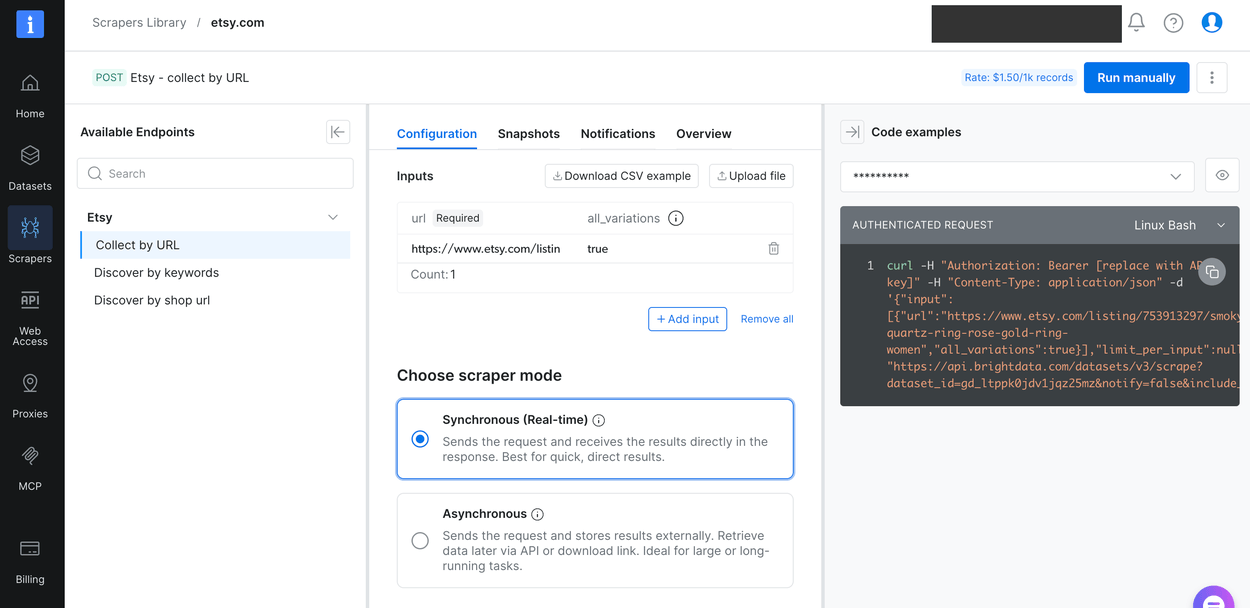
Los 6 campos que comparamos entre ambas rutas coincidieron exactamente, y fueron la moneda, el precio cobrado, el precio de lista, la calificación, el conteo de reseñas del artículo y el origen de envío. Ejecuta esa verificación antes de confiar en cualquiera de las dos rutas.
La comparación de tiempo se invierte, y el modo decide por cuánto. A través del endpoint síncrono, la extracción estructurada tomó cerca de 50 segundos para un solo registro, frente a 27 segundos para la obtención sin procesar. Renderiza y normaliza en lugar de simplemente devolver bytes. Los 50 segundos dejan cerca de 10 segundos dentro del límite de 1 minuto anterior. El endpoint está construido para 1 URL y una respuesta inmediata.
Ejecutamos el mismo scraper como trabajo por lotes en su lugar y obtuvimos los 50 registros anteriores a 3.4 segundos cada uno. Cada registro cuesta aproximadamente 1/8 de los 27 segundos que tarda una obtención sin procesar. En modo por lotes, el 202 es la respuesta esperada, no un error que manejar.
Para un rastreo recurrente, la ruta estructurada elimina de tu equipo el mantenimiento de selectores, la fijación de idioma y el manejo de rangos de precios, para los campos que devuelve. Para 1 listado, es más lenta sea cual sea el modo que elijas. La comparación anterior muestra el manejo de precios resuelto, y la ejecución de 50 registros no mostró URLs con prefijo de idioma. El mantenimiento de selectores es la única parte que ninguna ejecución sola puede probar. La ruta estructurada se factura de la misma forma que Web Unlocker, con la cuota gratuita actual y la tarifa por cada 1K registros en la página de precios del Web Scraper API.
La misma muestra contiene 2 tipos de registro en lugar de 1, así que planifica para ambos en el lado de compra. De las 1,000 filas, 128 tienen el conjunto completo de campos, y las otras 872 dejan 12 de sus campos vacíos, incluyendo description, product_category y store_country.
La división sigue la antigüedad del listado, con el registro completo en artículos listados desde finales de 2025 en adelante. Una extracción masiva que abarque años por lo tanto mezcla ambos tipos en 1 archivo. Esa proporción debería inclinarse hacia el registro completo a medida que el corpus envejece. Verifica la cobertura de campos contra tus propias columnas requeridas antes de decidir el tamaño del pedido, no después.
El volumen de reseñas necesita la misma verificación antes de pedir. En la copia que extrajimos, 753 de 1,000 listados no tenían reseñas, así que la mediana es cero. El 10% superior de los listados tiene el 98% de todas las reseñas. La media de 52.5 por listado describe el archivo en su conjunto y ningún listado que abrirás.
El sesgo de reseñas se parece al caso de la moneda, pero es un fallo diferente con una solución diferente. El caso de la moneda anterior es un error de unidad, y la media es incorrecta. El volumen de reseñas es sesgo, y ahí la media es correcta para un total. Una muestra aleatoria de 1,000 listados debería devolver cerca de 52,500 reseñas, así que usa la media cuando planifiques un corpus masivo. En una muestra de tamaño piloto, esa concentración hace que la estimación no sea confiable.
La cobertura es una pregunta distinta. Con 753 de las 1,000 en cero, solo cerca del 25% de las filas que compras tienen alguna reseña.
Si los datos que necesitas son históricos en lugar de en vivo, un dataset preparado se salta el rastreo. La página del dataset de Etsy lista el conteo de campos actual, el total de registros, el precio por registro y el pedido mínimo, y esos 4 números son la aritmética del lado de compra.
La cifra por registro en esa página es la tarifa única, y los calendarios de actualización desde semestral hasta diaria vienen como suscripciones que la descuentan. Qué tan reciente es el dato también importa. La página describe los registros pre-recopilados como de días a meses de antigüedad, mientras que la recopilación bajo demanda te permite fijar ese límite antes del pago. Seleccionas el calendario de actualización y el nivel de volumen en la misma página del dataset.
Esas cifras cambian sin aviso, así que léelas de la página antes de presupuestar, y trata las 2 páginas de precios de la misma manera. La página del dataset muestra una muestra de los registros bajo la fila de resumen, difuminada hasta que solicites acceso:
Una referencia externa vale más que una afirmación de proveedor aquí. Ese mismo artículo, Mecha-nudges for Machines, documenta de dónde vinieron sus datos en el Apéndice B. Los autores afirman que los datos sin procesar “se obtuvieron de la empresa Bright Data, que proporciona datasets estructurados de listados de productos de Etsy”. Su extracto “se recopiló el 12 de noviembre de 2025 y se entregó el mismo día”. Describen 2 instantáneas, de 5M y 1.06M listados. Ese apéndice es verificable, y un caso de estudio de un proveedor no lo es.
La regla aquí es estrecha. Construye el scraper cuando necesites unos pocos miles de listados que puedas enumerar por URL, y puedas aceptar fijar 1 idioma. Compra la capa de recopilación cuando la lista de URLs sea la parte difícil, o cuando el rastreo tenga que seguir funcionando. Cómpralo también cuando el dataset alimente trabajo de precios, porque los campos de rango de precio y tachado llegan ya separados. La columna de moneda aún necesita filtrado en cualquiera de las dos rutas.
En la tienda medida arriba, construir cuesta 1,895 solicitudes y aproximadamente 13 horas en un solo hilo para 1,842 listados. El lado de compra es un pedido mínimo de registros preparados. Esos 2 números no son directamente comparables, porque el costo de construir es por tienda y el costo de comprar es un mínimo que distribuyes entre tiendas.
Reflexiones finales
Etsy bloquea la obtención ordinaria mientras publica JSON-LD de schema.org en esas mismas páginas públicas, así que la extracción es un trabajo corto y el acceso es la mayor parte del trabajo. El transporte no decide el acceso, porque un navegador con interfaz cargó una página que 9 clientes HTTP ajustados no pudieron cargar, y Etsy rechazó ese mismo navegador en su segunda solicitud. Así que el problema de ingeniería es cómo seguir recopilando, no cómo parecer un navegador. Cualquiera sea la ruta que tomes, los fallos de datos cuestan más que los fallos de acceso, porque una columna de moneda mixta o un listado muerto a precio completo se analizan sin problemas y lo descubres meses después. Extrae 1 listado tanto con una obtención sin procesar como con un extractor estructurado, compara los campos, y deja que el resultado decida construir versus comprar antes de escribir el crawler.
Preguntas frecuentes
¿Existe una API para Etsy?
Sí. La Etsy Open API v3 listaba 76 rutas cuando las contamos, de las cuales 31 operaciones GET necesitan solo una clave de aplicación. Devuelve listados, tiendas, reseñas y taxonomía. Para tiendas que no operas, omite ventas por listado, volumen de búsqueda de palabras clave, tasa de conversión e historial, que muchos proyectos de datos necesitan.
¿Es gratuita la API de Etsy?
La API en sí no tiene precio publicado, pero el acceso depende de la aprobación y de los límites de tasa establecidos por clave de aplicación. Etsy decide quién obtiene límites más altos, y puede añadir términos o cargos adicionales. El costo práctico es el límite de tasa más que una tarifa.
¿Por qué mi scraper de Etsy está siendo bloqueado?
Etsy usa DataDome, que devuelve un 403 con una breve página de bloqueo y un encabezado X-DataDome-riskscore que califica tu solicitud, donde 1.0 es el peor. La puntuación sigue tu IP de llamada y la firma de la solicitud. En nuestras pruebas, las ediciones de encabezados bajaron la puntuación y la suplantación de TLS de Chrome la subió, y ninguna devolvió una página.
¿Permite Etsy el web scraping?
No sin permiso expreso de Etsy. Los términos son el documento más estricto. robots.txt prohíbe la búsqueda por palabras clave, el historial de ventas y los favoritos en cada variante de idioma, y deja abiertas las páginas de listados y tiendas. Etsy reescribe ese archivo sin aviso, así que lee la copia en vivo antes de construir.
¿Se puede hacer scraping de Etsy con Python?
Sí. Las páginas de listados incrustan JSON-LD de schema.org, así que la extracción no necesita selectores CSS. Elige el bloque application/ld+json cuyo @type sea Product, luego aplana el objeto offer. La obtención es la mitad difícil, y recopilar a volumen necesita nuevos contextos de navegación y direcciones rotativas.
¿Cómo obtengo datos de ventas de Etsy?
Las ventas son públicas solo a nivel de tienda. El endpoint getShop devuelve transaction_sold_count, una cifra vitalicia para toda la tienda. Nada lo divide por listado para una tienda que no operas, así que los números por listado de una herramienta vienen de otro lado. Trátalos como estimaciones y verifícalos contra los totales de la tienda.
¿Tiene Etsy un sitemap para el rastreo?
Ninguno en nuestra última verificación. El archivo robots.txt declara cero directivas Sitemap:, y /sitemaps.xml devuelve un 403 con un cuerpo vacío. Sin sitemap, tienes que descubrir URLs desde páginas de tiendas, el endpoint findAllListingsActive de la API, o un dataset preparado. Ninguna de esas 3 toca la ruta de búsqueda prohibida.
¿Bloquea Etsy a los crawlers de IA como GPTBot?
No por nombre cuando lo verificamos. El archivo robots.txt declara solo 3 grupos de user-agent, ninguno de ellos un crawler de IA, y Etsy no publica llms.txt ni ai.txt. DataDome igual rechazó a GPTBot y ClaudeBot, ambos con una puntuación peor de 0.9814 frente al 0.923 que puntuó un User-Agent de Chrome. Las cadenas sin sentido puntuaron igual.