Hacer scraping de Zillow significa recopilar listados, precios y registros de propiedades de las páginas públicas de Zillow para modelos de precios, herramientas de análisis de inversión y paneles de mercado. Cada página incrusta sus datos principales como JSON.
Zillow bloquea las solicitudes predeterminadas de Python, pero ese es el problema más fácil. El más difícil son los datos que tu scraper pierde sin avisarte. La mayoría de las páginas de listados no incluyen el historial de precios en su HTML, y una búsqueda se detiene en 984 listados, solo el 6% de las casas en venta en Houston.
Esta guía te muestra cómo hacer scraping de Zillow con Python, obtener cada listado con su historial de precios, y decidir cuándo un scraper gestionado cuesta menos.
Resumen
- Usa la huella TLS de un navegador. Zillow bloquea la huella TLS predeterminada de Python, incluso con cabeceras de Chrome.
curl_cffiimitando a Chrome obtuvo 429 de 430 páginas. - Lee el JSON incrustado en la página, y obtén el historial de precios por separado. La mayoría de las páginas de listados lo cargan con una segunda solicitud que los scrapers solo de HTML nunca hacen.
- Una búsqueda se detiene en 984 listados, así que divide las búsquedas grandes. O usa la API Scraper de Zillow de Bright Data, que encontró los 1,295 listados de Fort Wayne desde una sola URL.
- Verifica la integridad, no solo los códigos de estado. Compara tu conteo de filas con el total reportado por Zillow, reintenta las filas fallidas, y marca las casas vendidas anteriormente sin historial de precios.
Qué datos de Zillow puedes extraer y dónde encontrarlos
Tu scraper puede obtener datos de Zillow de 4 fuentes principales, y el robots.txt de Zillow trató a cada una de forma diferente:
| Datos | Fuente en Zillow | Lo que decía robots.txt |
|---|---|---|
| Campos de listado: precio, habitaciones, Zestimate, fotos, agente de listado | JSON __NEXT_DATA__ dentro del HTML de la página de listado |
Permitido para páginas /homedetails/ |
| Historial de precios, historial de impuestos, escuelas | Normalmente una solicitud /graphql/ que la página envía después de cargar |
No permitido para /graphql/ |
| Resultados de búsqueda, 41 listados por página | Páginas de ciudad como /fort-wayne-in/2_p/, o el endpoint interno async-create-search-page-state |
Permitido para páginas de ciudad, no permitido para el endpoint y URLs ?searchQueryState= |
| Listados modificados | Sitemaps enlazados desde robots.txt, como latest.xml.gz |
Publicado para rastreadores |
Las páginas de Zillow fueron construidas con Next.js, y cada página incrustó sus datos principales como JSON en una etiqueta de script __NEXT_DATA__. Puedes leer ese JSON sin renderizar la página. Nuestra guía sobre scraping de sitios Next.js explica cómo funcionan estos datos incrustados.
Tus solicitudes para un listado y una búsqueda siguen esta ruta:
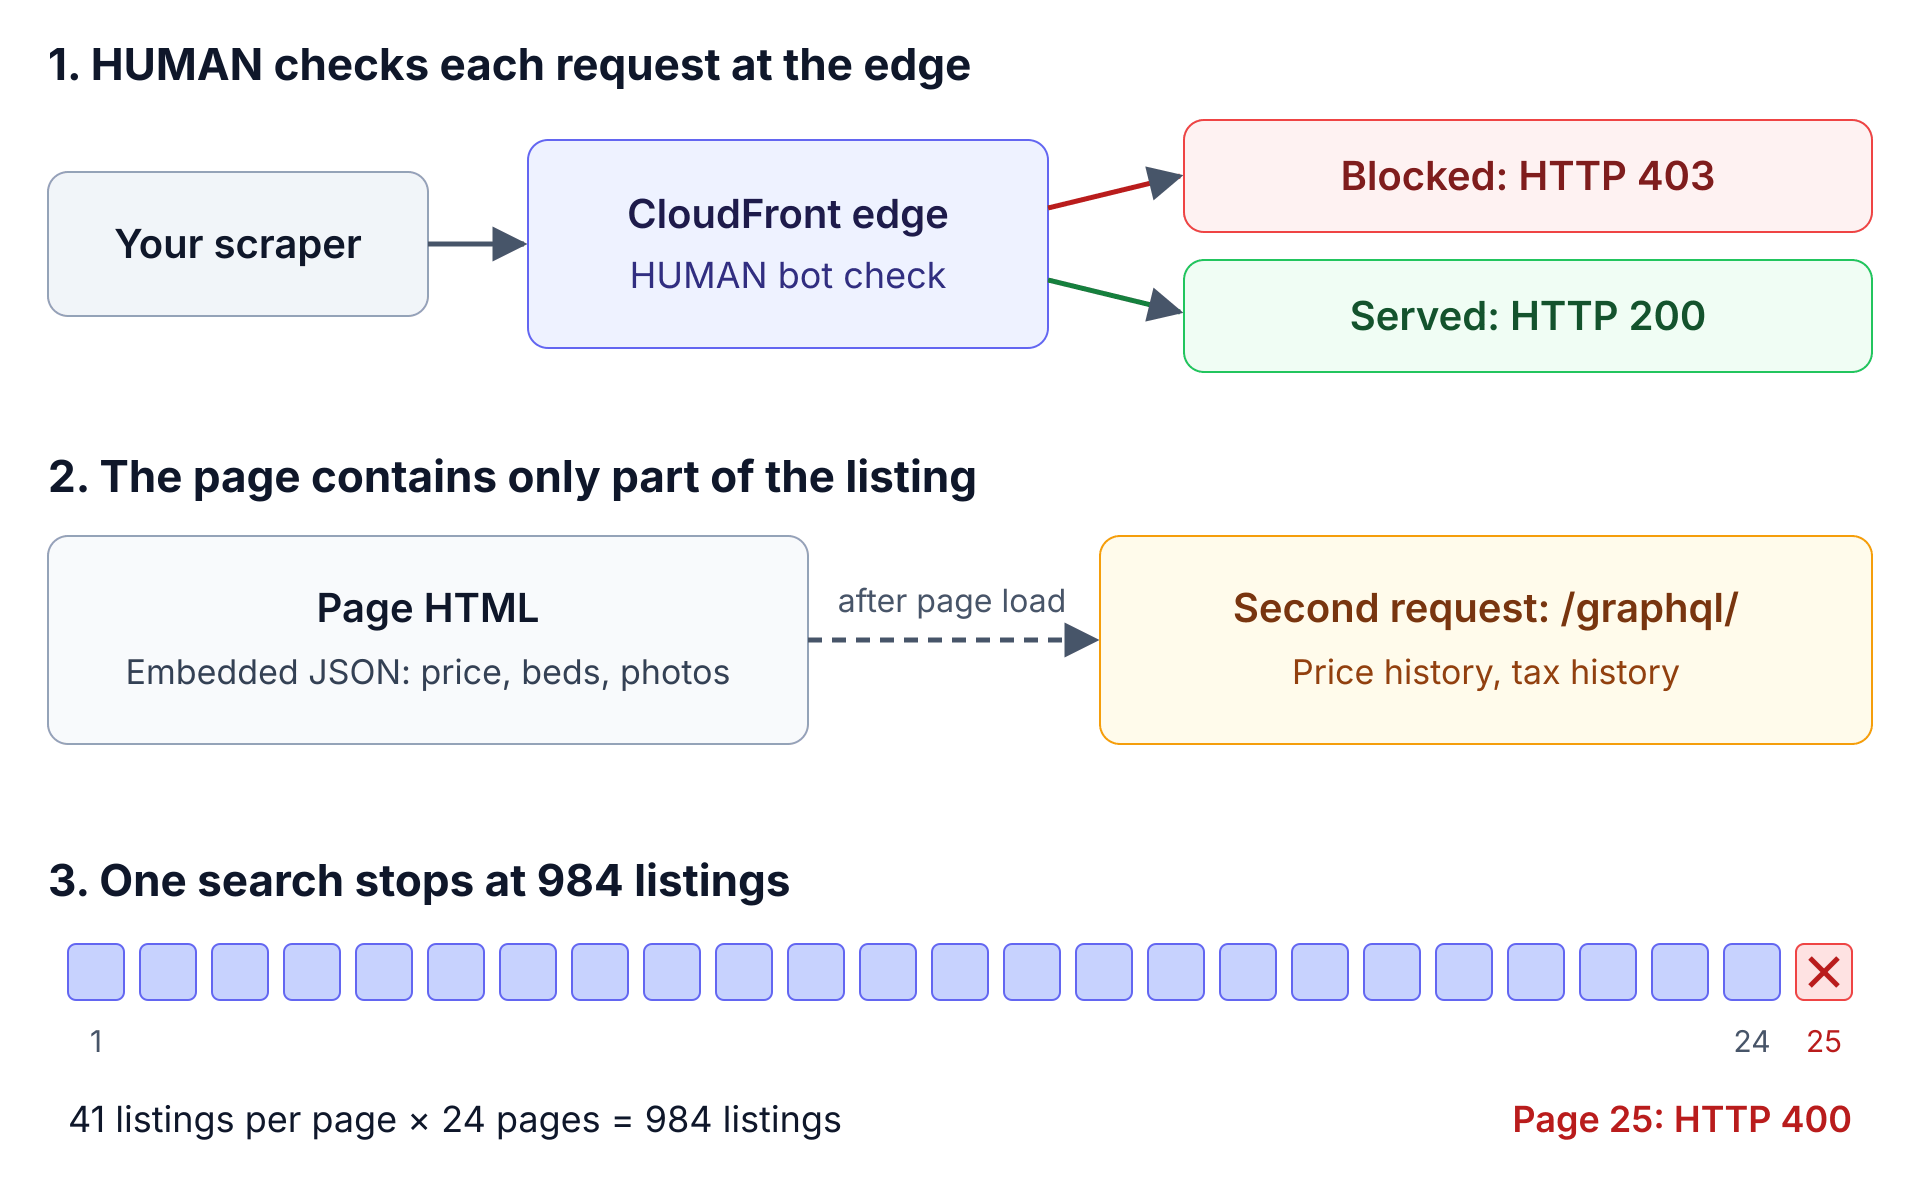
La verificación de bot de HUMAN se ejecuta en el borde antes de que exista cualquier HTML, y el historial de precios se carga después de que lo hace la página. Si tu parser solo lee el HTML, puede confundir un bloqueo con una página vacía, y pierde el historial de precios en la mayoría de los listados.
Páginas de listado e historial de precios
Necesitas parsear el JSON del listado dos veces, porque estaba doblemente codificado. El campo props.pageProps.componentProps.gdpClientCache tenía un valor de cadena, y esa cadena era a su vez un objeto JSON. Sus claves eran los nombres de las consultas GraphQL internas de Zillow.
Los listados en venta, fuera del mercado y de Zillow Showcase usaban cada uno su propio nombre de operación GraphQL. ForSalePriorityQuery tenía 101 campos, NotForSalePriorityQuery tenía 122, y ViewShowcasePriorityQuery tenía 78. Si tu parser espera un nombre de operación, falla en los demás. En su lugar, combina cada entrada en la caché, y un solo parser maneja los 3 tipos de listado.
El historial de precios e impuestos faltaba en ese JSON en la mayoría de los listados. Para 20 listados en venta, la API Scraper de Zillow de Bright Data devolvió entre 1 y 18 eventos de historial de precios cada uno. El HTML de las mismas páginas no contenía ninguno de esos eventos. Si tu scraper solo lee el HTML, registra estas casas como si no tuvieran historial de precios y no genera ningún error.
El navegador solicitó el historial después de que la página cargara. Para una casa en venta, esa solicitud (ForSaleNonPriorityQuery) devolvió 145 campos de la propiedad, incluyendo 21 años de historial de impuestos. Una página fuera del mercado usaba una solicitud diferente, una consulta GraphQL persistida que la página llamaba por su hash.
Páginas de búsqueda y el límite de 984 listados
Una página completa de resultados de búsqueda contenía 41 listados en su bloque __NEXT_DATA__, pero solo 9 de ellos se renderizaban como tarjetas HTML. Si parseas las tarjetas con selectores CSS, pierdes los otros 32. Los selectores de tarjetas de tutoriales antiguos de Zillow, como article.list-card, no coincidían con ningún elemento.
Zillow también limitaba cada búsqueda. Su propia paginación se detenía en la página 20, incluso para una búsqueda que reportaba más de 1K resultados:
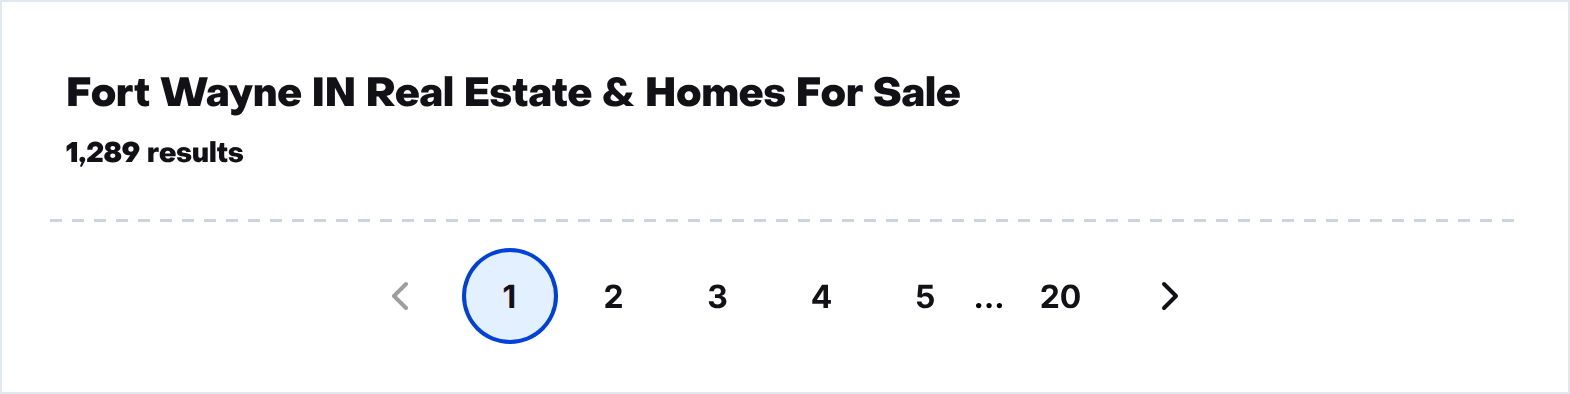
La parte superior e inferior de la lista de resultados de Fort Wayne de Zillow. El total (1,289 aquí) cambia a medida que se agregan y eliminan listados, pero los números de página aún se detenían en 20.
Veinte páginas de 41 listados dan 820, el límite que documentan algunas herramientas de scraping. Pero las páginas 21 a 24 aún devolvían 41 listados más cada una al solicitarlas por URL, y la página 25 devolvía un error HTTP 400. Por lo tanto, una búsqueda alcanzó 984 listados, lo que representaba el 76% de los 1,295 listados en venta de Fort Wayne y el 6% de los 15,410 en la ciudad de Houston. Cada respuesta seguía reportando el total completo, así que compara ese número con lo que recopilas.
Parsea el JSON en lugar del marcado, y obtienes los 41 listados por página en lugar de 9.
Por qué Zillow bloquea las solicitudes predeterminadas de Python
La protección contra bots de Zillow provenía de HUMAN Security, anteriormente PerimeterX. Dos detalles lo demostraban: la página de bloqueo nombraba el ID de la app de PerimeterX PXHYx10rg3, y robots.txt no permitía /captchaPerimeterX/ ni /HYx10rg3/.
El rechazo provenía de CloudFront, la red de entrega de contenido (CDN) frente a Zillow, no de los propios servidores de Zillow. Cada respuesta bloqueada era un HTTP 403 con x-cache: LambdaGeneratedResponse y x-px-blocked: 1. También carecía de la cabecera x-envoy-upstream-service-time que incluían las páginas normales. Tu scraper puede verificar esa cabecera x-px-blocked para detectar un bloqueo sin parsear la página.
Cómo se ve una solicitud bloqueada
Una solicitud curl con un User-Agent de Chrome fue rechazada:
curl -s -o /dev/null -D - \
  -A "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36" \
  "https://www.zillow.com/homedetails/25875-Fox-Tail-Trl-South-Bend-IN-46628/77039629_zpid/"
El borde respondió en 0.32 segundos con la página de “Press & Hold” de 5,952 bytes:
HTTP/2 403
server: CloudFront
content-length: 5952
x-px-blocked: 1
x-cache: LambdaGeneratedResponse from cloudfront
Un Chromium sin interfaz lanzado desde Playwright obtuvo el mismo bloqueo, HTTP 403 con x-px-blocked: 1, y renderizó el desafío de HUMAN:
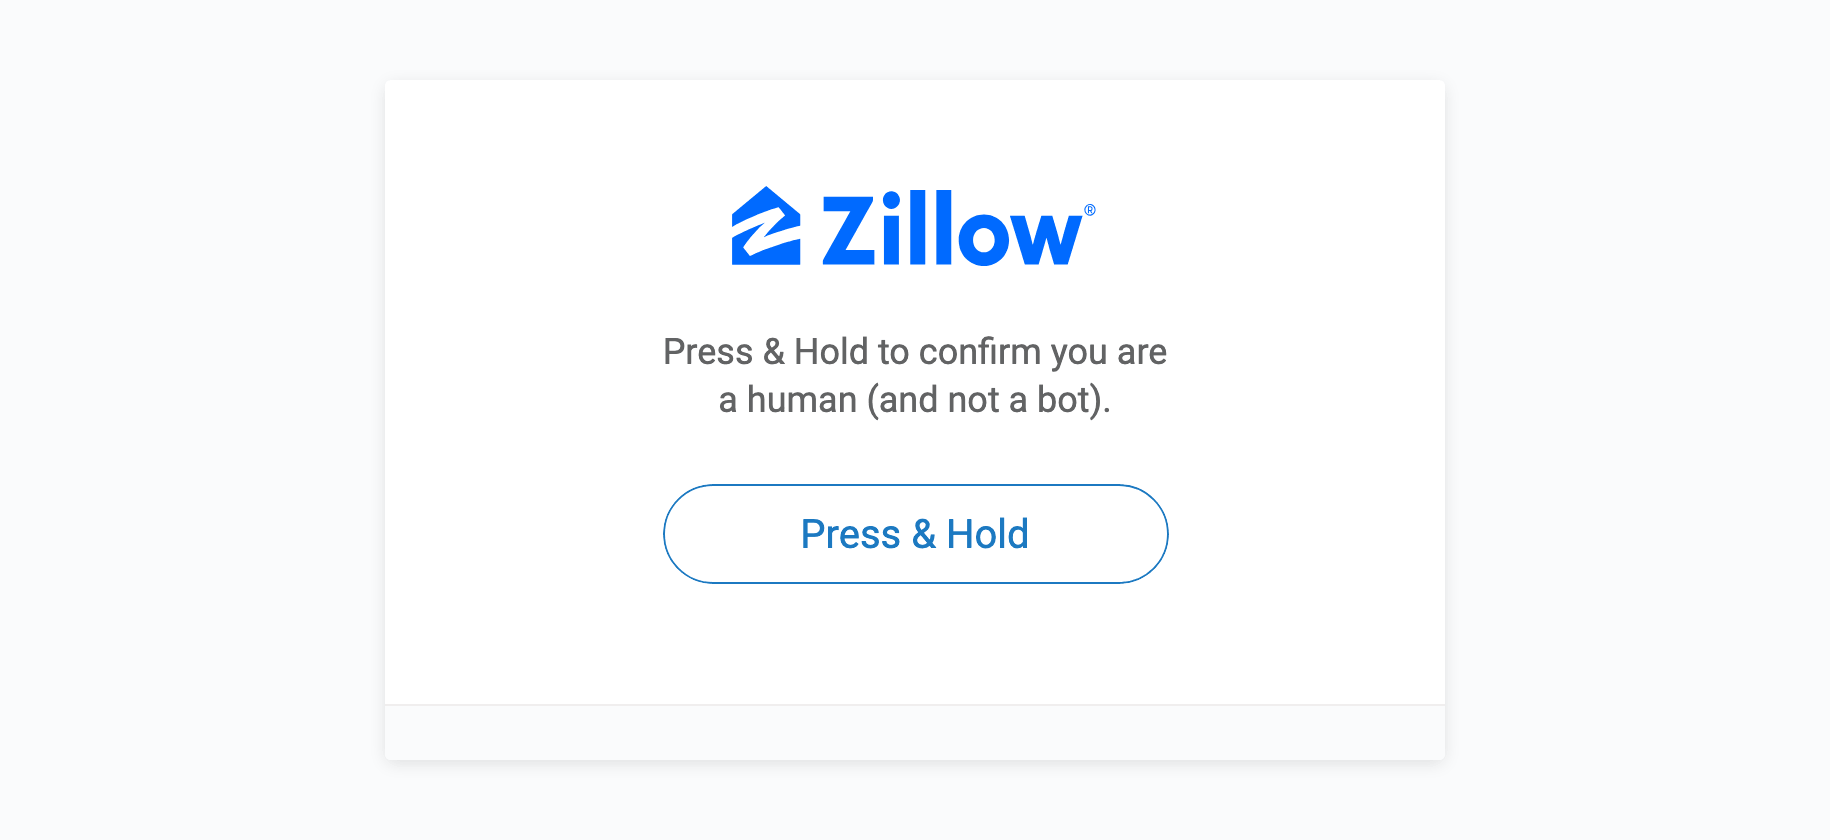
Si tu scraper recibe esta página, ha sido rechazado en el borde, y la página no contiene datos de listado.
Para manejar esta página sin tu propio código de evasión, usa el solucionador de CAPTCHA de Zillow de Bright Data.
Qué clientes Python pasan la verificación de bots de Zillow
Desde la misma IP, segundos después de que curl fuera rechazado, curl_cffi obtuvo el mismo listado. Esa librería imita el handshake TLS y las cabeceras de Chrome:
python - <<'EOF'
from curl_cffi import requests

url = "https://www.zillow.com/homedetails/25875-Fox-Tail-Trl-South-Bend-IN-46628/77039629_zpid/"
r = requests.get(url, impersonate="chrome")
print(r.status_code, len(r.content))
EOF
Imprimió un HTTP 200 y 730,803 bytes de HTML:
200 730803Esas 2 solicitudes diferían en sus cabeceras y en su huella TLS. Una huella TLS es el patrón de suites de cifrado y extensiones que un cliente ofrece al abrir una conexión. Nuestra guía sobre huellas TLS explica cómo los sitios usan estas huellas para detectar bots.
Desde una IP residencial que Zillow no había bloqueado, 6 clientes obtuvieron una página de listado y una de búsqueda cada uno, con el mismo resultado en ambas:
| Cliente | Huella TLS | Resultado |
|---|---|---|
Python requests, cabeceras predeterminadas |
Python (OpenSSL) | 403 |
Python requests, User-Agent de Chrome y cabeceras de navegador |
Python (OpenSSL) | 403 |
httpx, cabeceras de navegador |
Python (OpenSSL) | 403 |
curl_cffi, impersonate="chrome" |
Chrome | 200 |
curl_cffi, impersonate="firefox" |
Firefox | 200 |
curl_cffi, impersonate="safari" |
Safari | 403 |
Si tu cliente usa la huella TLS de Python, las cabeceras de navegador no ayudan. El perfil de Safari también fue rechazado en ambas páginas, así que prueba cada perfil de imitación contra Zillow antes de confiar en él. El perfil de Chrome también pasó cuando se forzó HTTP/1.1, por lo que la configuración de HTTP/2 no era el factor decisivo.
Por qué las cabeceras y la reputación de IP siguen importando
Zillow también verifica si las cabeceras HTTP de tu solicitud parecen las de un navegador real. Cuando un proxy usó la huella TLS de Chrome y una nueva IP de EE. UU. para cada solicitud, las cabeceras por sí solas decidieron el resultado.
El User-Agent predeterminado de Python fue rechazado 5 de 5 veces, y un User-Agent de Chrome solo pasó 5 de 5. El conjunto completo de cabeceras de Chrome sin sus client hints sec-ch-ua fue rechazado 4 de 10 veces. Esto sugiere que Zillow asigna una puntuación de riesgo a cada solicitud en lugar de aplicar una regla fija.
La reputación de tu IP también importa. Se enviaron aproximadamente 20 solicitudes desde una IP residencial, y la mayoría provenían de clientes que Zillow rechazó. Después de eso, Zillow rechazó incluso el perfil de Chrome que había pasado minutos antes, y el bloqueo terminó en 6 minutos.
Las sesiones con la huella TLS de Chrome y cookies reutilizadas se comportaron de manera diferente. En 5 de esas sesiones, 429 de 430 solicitudes de listado devolvieron la página. El único fallo fue un HTTP 502, no un bloqueo. HUMAN no rechazó ninguna de las 430, incluyendo 250 solicitudes desde una IP en 12 minutos.
Así que trata un rechazo como una señal para pausar esa IP, no para reintentar de inmediato. Mide la tasa de bloqueo por IP antes de decidir cuántas IPs proxy necesitas. Para la rotación de IP y otras formas de mantener baja la tasa de bloqueo, consulta nuestra guía sobre scraping web sin ser bloqueado.
Extrae datos de Zillow con Python y curl_cffi
El scraper a continuación lee el mismo JSON que usa la página. Necesita Python 3.10 o más reciente y curl_cffi, que presenta nuestra guía sobre scraping web con curl_cffi. Instala la librería en un entorno virtual:
python3 -m venv .venv
source .venv/bin/activate  # en Windows: .venv\Scripts\activate
pip install curl_cffi
Este script, zillow_diy.py, obtiene una página de búsqueda de Fort Wayne, y luego lee 3 listados de ella:
"""Extrae datos de Zillow con la huella TLS de un navegador y el JSON incrustado de la página."""
import json
import re
import time

from curl_cffi import requests

NEXT_DATA = re.compile(
    r'<script id="__NEXT_DATA__" type="application/json">(.*?)</script>', re.S
)
# TLS de Chrome + cabeceras coincidentes; mantén una sesión por IP
session = requests.Session(impersonate="chrome")


def next_data(url: str) -> dict:
    resp = session.get(url, timeout=30)
    match = NEXT_DATA.search(resp.text)
    # Un bloqueo puede ser un 403 o una página captcha con 200,
    # así que verifica los datos, no el estado
    if resp.headers.get("x-px-blocked") or not match:
        raise RuntimeError(f"sin datos de página para {url} (HTTP {resp.status_code})")
    resp.raise_for_status()  # la página 404 de Zillow también contiene __NEXT_DATA__
    return json.loads(match.group(1))


def search_page(city: str, page: int) -> tuple[list[dict], int]:
    """Una página de resultados renderizada por el servidor, más el total que reporta Zillow."""
    url = f"https://www.zillow.com/{city}/{page}_p/"
    cat1 = next_data(url)["props"]["pageProps"]["searchPageState"]["cat1"]
    return cat1["searchResults"]["listResults"], cat1["searchList"]["totalResultCount"]


def listing(url: str) -> dict:
    """La parte renderizada por el servidor de un listado: gdpClientCache es JSON doblemente codificado."""
    props = next_data(url)["props"]["pageProps"]["componentProps"]
    cache = json.loads(props["gdpClientCache"])
    record = {}
    for query_result in cache.values():  # p. ej. ForSalePriorityQuery{...}
        record.update(query_result.get("property") or {})
    return record


if __name__ == "__main__":
    cards, total = search_page("fort-wayne-in", 1)
    print(f"página 1: {len(cards)} listados de {total} reportados")
    for card in cards[:3]:
        time.sleep(2)
        home = listing(card["detailUrl"])
        history = home.get("priceHistory") or []
        print(home["zpid"], home["homeStatus"], home["price"], home["bedrooms"], "hab",
              home["livingArea"], "pies² | priceHistory:", len(history))
Al ejecutarlo con python zillow_diy.py, encontró 41 listados en la página 1, y 2 de los 3 listados que abrió no tenían historial de precios:
página 1: 41 listados de 1295 reportados
73145681 FOR_SALE 649900 4 hab 5124 pies² | priceHistory: 3
73159210 FOR_SALE 699900 4 hab 4132 pies² | priceHistory: 0
73110917 FOR_SALE 239900 3 hab 1468 pies² | priceHistory: 0
El primer listado era un listado Showcase, que incluía su historial de precios en el HTML. Para los otros 2, la API Scraper de Zillow devolvió 2 y 3 eventos de historial de precios, y el HTML tenía 0. Toda la ejecución tomó aproximadamente 11 segundos, incluyendo las pausas de 2 segundos.
Este enfoque tenía 2 límites. Primero, la página 24 de las páginas de ciudad de Fort Wayne aún devolvía 41 listados, pero la página 25 devolvía un error HTTP 400. Si tu ciudad tiene más listados de los que una búsqueda puede alcanzar, necesitas búsquedas más pequeñas. Segundo, el historial de precios faltante provenía únicamente de /graphql/.
Dividir una ciudad normalmente significa búsquedas por código postal o filtradas, que usan URLs /homes/ y ?searchQueryState=, y el historial de precios faltante necesita la solicitud /graphql/. El robots.txt de Zillow no permitía las tres, así que llamarlas es una decisión de cumplimiento para tu equipo. Nuestra guía sobre robots.txt para web scraping explica cómo leer y respetar esas reglas.
Para ejecutar este scraper desde muchas IPs, pasa un proxy residencial de Bright Data a la sesión. Para conexiones cifradas de extremo a extremo, carga el certificado de Bright Data para el puerto 44445 con verify="brightdata_root_ca_44445.crt".
Las IPs residenciales provienen de personas reales que dieron su consentimiento, así que los proxies residenciales de Bright Data necesitan primero una revisión de verificación KYC (conoce a tu cliente) de la empresa aprobada. La revisión aprueba casos de uso específicos, así que describe tu pipeline de Zillow al solicitarla. Sin verificación KYC, la API Web Unlocker se encarga del desbloqueo por ti, y la API Scraper de Zillow en la siguiente sección devuelve registros de listados con historial de precios.
Extrae datos de Zillow con la API Scraper de Zillow
La API Scraper de Zillow ejecuta la recopilación en la infraestructura de Bright Data, se encarga del desbloqueo y el parseo por ti, y devuelve registros JSON. Pagas por registro entregado, y las cuentas nuevas obtienen 5K créditos gratuitos que se renuevan cada mes. Incluye estos scrapers de Zillow, que las secciones siguientes llaman los scrapers de listado, historial de precios, página de búsqueda y Full Properties:
| Scraper | ID del conjunto de datos | Entrada | Salida |
|---|---|---|---|
| Información de listado de propiedades de Zillow | gd_lfqkr8wm13ixtbd8f5 |
URL de listado, URL de búsqueda, o filtros de ubicación | 1 registro por listado, hasta 139 campos |
| Historial de precios de Zillow | gd_lxu1cz9r88uiqsosl |
URL de listado | 1 fila por evento de historial de precios |
| Página de búsqueda de propiedades de Zillow | gd_m71oxpvxwr113ehqg |
URL de búsqueda con searchQueryState |
1 fila por resultado de búsqueda, 26 campos |
| Información completa de propiedades de Zillow | gd_m794g571225l6vm7gh |
URL de listado o URL de búsqueda | 1 registro por listado, con nombres de campo en snake_case como price_history |
Los 4 recopilan por URL a través de la misma solicitud API, así que solo cambias el ID del conjunto de datos. Bright Data también ofrece una API Scraper de Imágenes de Zillow y scrapers para otros sitios de propiedades en su gama de API Scraper de Bienes Raíces. En el Panel de Control, el scraper de listados muestra sus 3 métodos de entrada y los modos síncrono y asíncrono:
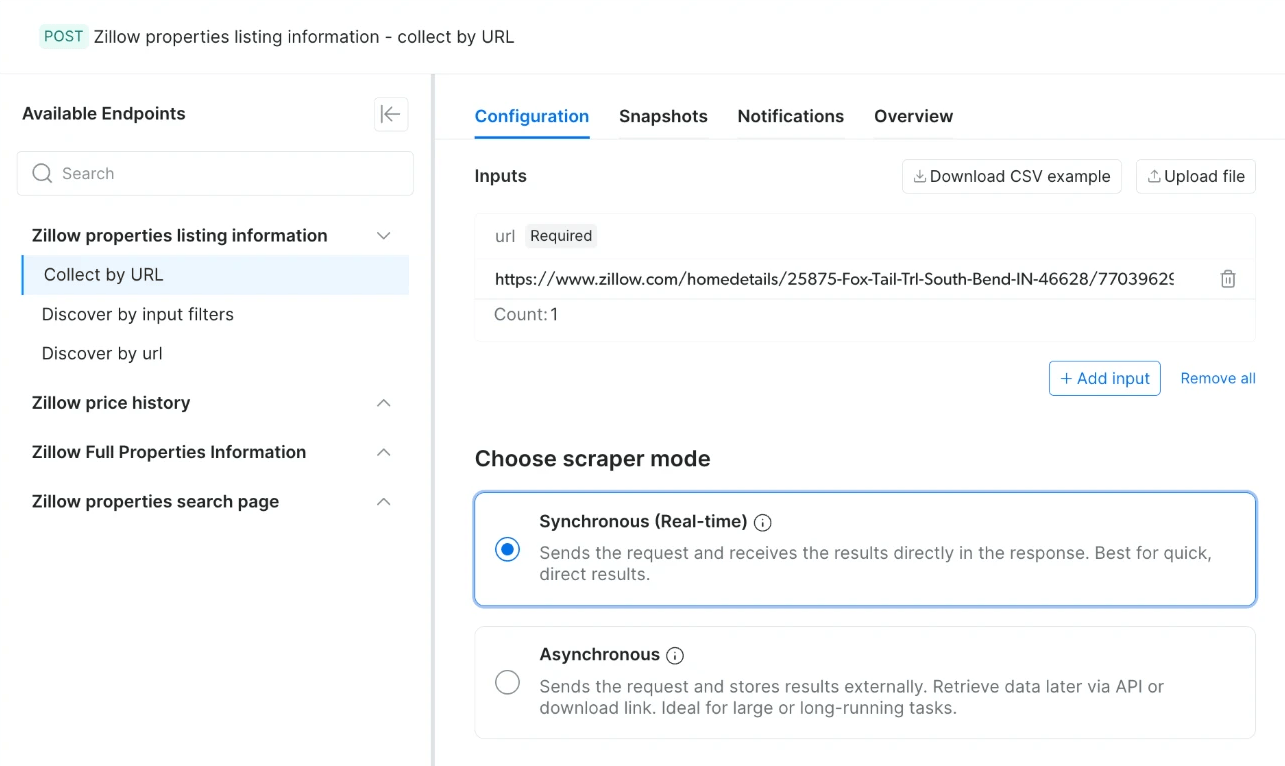
El panel izquierdo lista los mismos 4 scrapers que la tabla anterior.
Recopila listados e historial de precios
Para ejecutar el script a continuación, zillow_api.py, necesitas el paquete requests (pip install requests) y un token de API del Panel de Control. Su función collect() llama al endpoint síncrono y cambia a sondeo cuando un trabajo tarda más de 1 minuto:
"""Listados, historial de precios y descubrimiento con la API Scraper de Zillow de Bright Data."""
import os
import time

import requests

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_TOKEN']}"}
LISTINGS = "gd_lfqkr8wm13ixtbd8f5"       # Información de listado de propiedades de Zillow
PRICE_HISTORY = "gd_lxu1cz9r88uiqsosl"   # Historial de precios de Zillow, una fila por evento


def collect(dataset_id: str, urls: list[str]) -> list[dict]:
    """Hasta 20 URLs por llamada síncrona; un trabajo que pasa 1 minuto devuelve 202."""
    params = {"dataset_id": dataset_id, "include_errors": "true", "format": "json"}
    resp = requests.post(f"{API}/scrape", headers=HEADERS, params=params, timeout=120,
                         json={"input": [{"url": u} for u in urls]})
    if resp.status_code == 202:
        return wait_and_download(resp.json()["snapshot_id"])
    resp.raise_for_status()
    return resp.json()


def discover(search_url: str) -> list[dict]:
    """Cada listado en una búsqueda de Zillow, recopilado como registros completos (async)."""
    resp = requests.post(f"{API}/trigger", headers=HEADERS, timeout=60,
                         params={"dataset_id": LISTINGS, "include_errors": "true",
                                 "type": "discover_new", "discover_by": "url"},
                         json={"input": [{"url": search_url}]})
    resp.raise_for_status()
    return wait_and_download(resp.json()["snapshot_id"])


def wait_and_download(snapshot_id: str, poll_s: int = 15) -> list[dict]:
    while True:
        resp = requests.get(f"{API}/progress/{snapshot_id}", headers=HEADERS,
                            timeout=60)
        resp.raise_for_status()
        status = resp.json()["status"]
        if status == "ready":
            break
        if status in ("failed", "canceled"):
            raise RuntimeError(f"el snapshot {snapshot_id} terminó como {status}")
        time.sleep(poll_s)
    while True:  # la descarga devuelve 202 mientras el archivo aún se está preparando
        resp = requests.get(f"{API}/snapshot/{snapshot_id}", headers=HEADERS,
                            params={"format": "json"}, timeout=300)
        if resp.status_code != 202:
            resp.raise_for_status()
            return resp.json()
        time.sleep(10)


if __name__ == "__main__":
    homes = collect(LISTINGS, [
        "https://www.zillow.com/homedetails/25875-Fox-Tail-Trl-South-Bend-IN-46628/77039629_zpid/",
    ])
    for h in homes:
        print(h["zpid"], h["homeStatus"], h["price"], "| zestimate", h.get("zestimate"),
              "| priceHistory", len(h.get("priceHistory") or []),
              "| taxHistory", len(h.get("taxHistory") or []),
              "| recopilado", h.get("timestamp"))
    events = collect(PRICE_HISTORY, [
        "https://www.zillow.com/homedetails/2506-Gordon-Cir-South-Bend-IN-46635/77050198_zpid/",
    ])
    for e in events:
        print(e["zpid"], e["date"][:10], e["event"], e["price"], e["source"])
Con BRIGHTDATA_API_TOKEN exportado, las dos llamadas tomaron entre 35 y 65 segundos en total:
77039629 FOR_SALE 359000 | zestimate 351600 | priceHistory 1 | taxHistory 21 | recopilado 2026-09-27T11:30:53.846Z
77050198 2023-03-03 Sold 265000 IRMLS
77050198 2023-02-03 Pending sale 264900 IRMLS
77050198 2023-02-01 Listed for sale 264900 IRMLS
El registro del listado coincidía con lo que cargaba la propia página de Zillow, con 1 evento de historial de precios y 21 años de historial de impuestos. Su timestamp mostraba que Bright Data lo recopiló en vivo, durante la solicitud.
Los 3 eventos de la segunda casa, 2506 Gordon Cir, coinciden con la tabla de historial de precios en su página de Zillow:
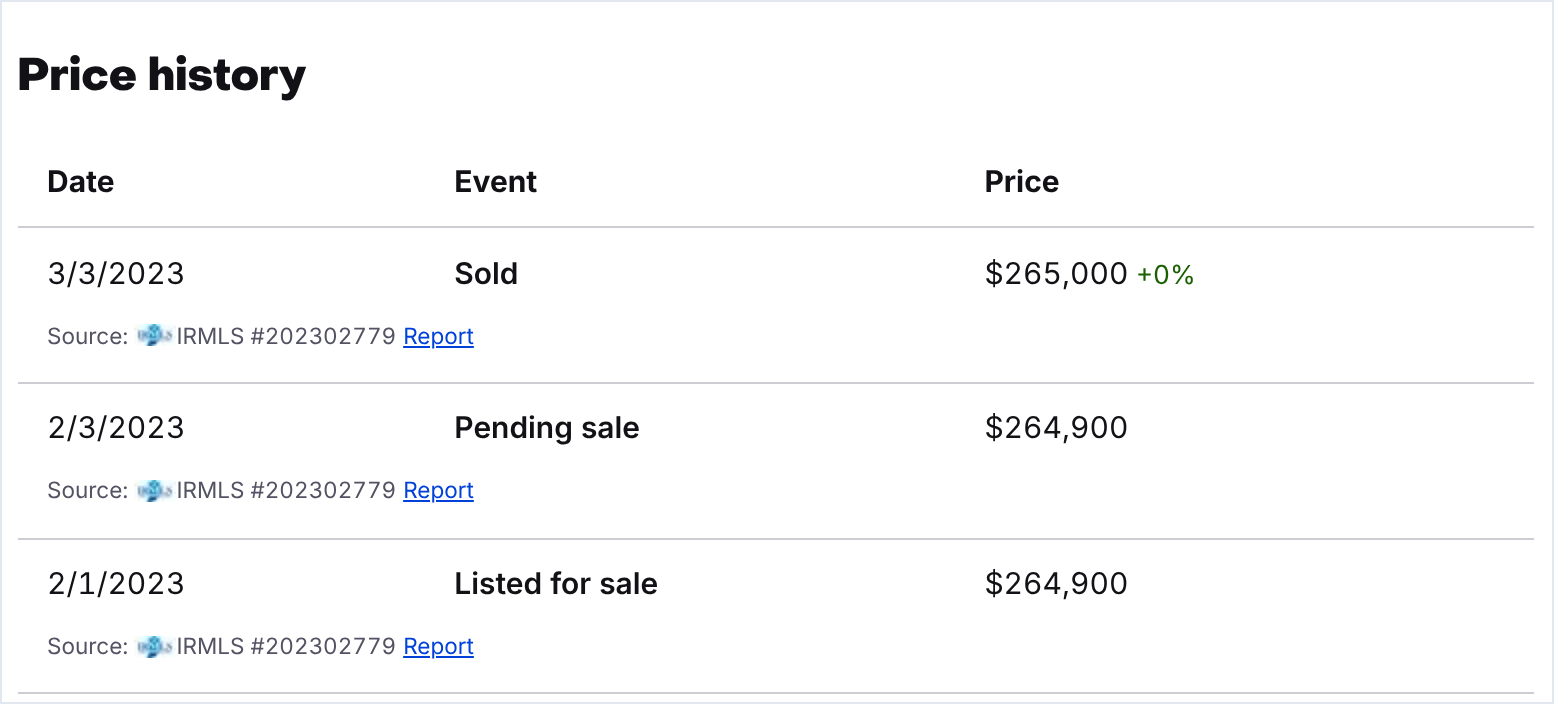
Cada fila nombra su fuente, un servicio de listado múltiple (MLS) local, que la salida de la API mantiene en el campo source.
El endpoint síncrono /scrape acepta hasta 20 URLs y devuelve los datos directamente si el trabajo termina en 1 minuto. Para un trabajo más largo, responde con HTTP 202 y un ID de snapshot en su lugar. Un lote de 20 listados de Fort Wayne tomó unos 4 minutos, así que espera unos minutos de sondeo antes de que tu script imprima algo. Para lotes más grandes, usa el endpoint asíncrono /trigger, que usa la siguiente sección para el descubrimiento.
Descubre cada listado en una búsqueda
El descubrimiento recopila registros de listado completos desde una URL de búsqueda y puede superar el límite de 984 listados que detuvo al scraper hecho por ti mismo (DIY). La función discover() anterior envía la URL de la ciudad de Fort Wayne, https://www.zillow.com/fort-wayne-in/, al método de entrada Discover by URL del scraper de listados en una solicitud asíncrona /trigger. En 13 a 17 minutos, devolvió 1,295 filas, una por cada listado que reportó Zillow. Para una muestra pequeña en su lugar, pasa hasta 20 URLs de listado de search_page() en zillow_diy.py a collect().
Para limitar cuántos registros devuelve cada URL de búsqueda, por ejemplo en una ejecución de prueba, envía {"input": [...], "limit_per_input": 50} como cuerpo JSON. En lugar de sondear, puedes hacer que /trigger entregue los resultados a un webhook o S3, y cada snapshot permanece descargable durante 30 días.
Cuando solo necesitas campos de resultado de búsqueda, como precio, habitaciones y dirección, el scraper de página de búsqueda es más rápido. Desde una URL de búsqueda de Fort Wayne con searchQueryState, devolvió 1,154 listados únicos en 65 segundos. Usa el descubrimiento cuando necesites cada listado.
Obtén el historial de precios para casas fuera del mercado
Para casas en venta, el priceHistory del scraper de listados coincidía con la propia página de Zillow en 4 de 4 listados. Para casas fuera del mercado, usa el scraper Full Properties. En 6 de 6 casas fuera del mercado, devolvió el historial de precios en un arreglo price_history en snake_case, 1 registro por casa.
Para las mismas 6 casas, el scraper de historial de precios devolvió 1 fila por evento: 28 filas en 37 segundos. Las dos salidas coincidían exactamente.
La facturación es por registro entregado, así que una casa con 5 eventos te cuesta 5 registros del scraper de historial de precios y 1 de Full Properties. Los listados de Fort Wayne promediaban 5 eventos, con un máximo de 29. Así que envía las URLs fuera del mercado al scraper Full Properties, y lee price_history en lugar de priceHistory. Usa el scraper de historial de precios cuando quieras 1 fila por evento.
Ejecuta el mismo scraper desde una terminal o un agente de IA
El CLI de Bright Data ejecuta el scraper de listados como un comando de pipeline, lo que conviene para trabajos puntuales y agentes de codificación. Después de instalarlo con npm install -g @brightdata/cli y ejecutar bdata login una vez, un comando devuelve un listado:
bdata pipelines zillow_properties_listing \
  "https://www.zillow.com/homedetails/25875-Fox-Tail-Trl-South-Bend-IN-46628/77039629_zpid/"
En 3 minutos, imprimió el mismo registro que la API, en una línea de JSON que comienza así:
[{"zpid":77039629,"city":"South Bend","state":"IN","homeStatus":"FOR_SALE","address":{"city":"South Bend","streetAddress":"25875 Fox Tail Trl","zipcode":"46628","state":"IN"},"bedrooms":3,"bathrooms":2,"price":359000,"yearBuilt":1996,Si tu asistente de IA usa el Protocolo de Contexto de Modelo (MCP), el servidor MCP de Bright Data expone el mismo scraper como la herramienta web_data_zillow_properties_listing. Para usar la herramienta, habilita el grupo de herramientas business del servidor. Cada registro incluye un timestamp, así que tu agente puede confirmar cuán actual es un precio antes de citarlo.
Para un agente completo construido sobre el mismo servidor, consulta nuestra guía sobre construir un agente de IA de bienes raíces con CrewAI.
Mantén los datos de Zillow completos y actualizados
Antes de que los registros lleguen a tu almacén de datos, verifica cada ejecución contra el total reportado por Zillow. Las verificaciones a continuación también marcan filas con errores, listados duplicados, e historial de precios faltante. Un sitemap de listados modificados mantiene entonces pequeñas tus ejecuciones repetidas.
Valida cada registro
Una respuesta 200 confirma que la solicitud tuvo éxito, no que los datos estén completos. Este validador, guardado como validate.py, separa las filas con errores, elimina los listados duplicados, y marca las casas que se vendieron antes pero no tienen historial de precios. También cuenta como obsoletos los registros recopilados hace más de 24 horas y compara tu conteo de registros con el total reportado por Zillow:
"""Verificaciones a ejecutar en registros de Zillow antes de que lleguen al almacén de datos."""
from datetime import datetime, timedelta, timezone


def validate(rows: list[dict], reported_total: int | None = None,
             max_age_h: int = 24) -> dict:
    errors = [r for r in rows if r.get("error_code") or r.get("error")]
    records, seen = [], set()
    for r in rows:
        if r in errors or r.get("zpid") in seen:
            continue
        seen.add(r.get("zpid"))
        records.append(r)
    # Una casa vendida antes tiene historial de precios, así que la falta de historial es un vacío, no un hecho.
    history_gaps = [r["url"] for r in records
                    if (r.get("lastSoldPrice") or r.get("dateSoldString"))
                    and not r.get("priceHistory")]
    cutoff = datetime.now(timezone.utc) - timedelta(hours=max_age_h)
    stale = [r["url"] for r in records
             if datetime.fromisoformat(r["timestamp"].replace("Z", "+00:00")) < cutoff]
    report = {"records": len(records), "error_rows": len(errors),
              "duplicates": len(rows) - len(errors) - len(records),
              "history_gaps": history_gaps, "stale": len(stale),
              "retry": [e.get("input", {}).get("url") for e in errors]}
    if reported_total:
        report["coverage"] = round(len(records) / reported_total, 3)
    return report
El script run_pipeline.py ejecuta el descubrimiento para Fort Wayne y luego valida las filas:
"""Descubre cada listado en una búsqueda de Zillow, luego valida el resultado."""
import json
import time

from validate import validate
from zillow_api import discover

start = time.time()
rows = discover("https://www.zillow.com/fort-wayne-in/")
report = validate(rows, reported_total=1295)  # total de Zillow, p. ej. de search_page()
print(f"{len(rows)} filas en {round((time.time() - start) / 60, 1)} min")
counts = {k: (len(v) if isinstance(v, list) else v) for k, v in report.items()}
print(json.dumps(counts))
json.dump(rows, open("fort_wayne.json", "w"))
El descubrimiento devolvió 1,295 filas, y el validador conservó 1,270 de ellas como registros:
1295 filas en 12.9 min
{"records": 1270, "error_rows": 25, "duplicates": 0, "history_gaps": 0, "stale": 0, "retry": 25, "coverage": 0.981}
La cobertura fue del 98.1% de los 1,295 listados que reportó Zillow. La ejecución no tuvo duplicados, y ningún registro falló la verificación de historial de precios. La verificación solo marca casas que se vendieron antes, así que ignora las casas que nunca tuvieron historial de precios, como planes de construcción nueva.
Un precio de venta faltante en tus datos no siempre es un error de scraping. En 8 listados de Houston, ninguno de los 2 eventos de venta tenía precio, como se esperaba en Texas, donde los precios de venta no son de registro público.
Envía cualquier URL que marque la verificación de historial de precios al scraper Full Properties, y vuelve a enviar las URLs de retry. Para cualquier listado que aún carezca de un registro completo, los resultados del scraper de página de búsqueda incluyen precio, habitaciones y dirección.
Actualiza solo los listados que cambiaron
El robots.txt de Zillow listaba un índice de sitemap para cada estado de listado. El índice de en-venta-por-agente incluía un sitemap latest.xml.gz. Este script, changed_listings.py, lo lee a través de la API Web Unlocker y conserva los listados de Indiana. Antes de ejecutarlo, crea una zona Web Unlocker en el Panel de Control y coloca su nombre en el script:
"""Lista los listados de Zillow modificados recientemente en un estado, desde un sitemap enlazado desde robots.txt."""
import gzip
import os
import re

import requests

SITEMAP = "https://www.zillow.com/xml/sitemaps/us/hdp/for-sale-by-agent/latest.xml.gz"
HEADERS = {"Authorization": f"Bearer {os.environ['BRIGHTDATA_API_TOKEN']}"}


def unlock(url: str, attempts: int = 2) -> bytes:
    # reemplaza "web_unlocker" con el nombre de tu zona Web Unlocker
    payload = {"zone": "web_unlocker", "url": url, "format": "raw", "country": "us"}
    for _ in range(attempts):  # reintenta una vez ante un error transitorio
        resp = requests.post("https://api.brightdata.com/request", headers=HEADERS,
                             json=payload, timeout=180)
        # Web Unlocker devuelve el propio código de estado del destino en esta cabecera
        if resp.headers.get("x-brd-status-code") == "200":
            return resp.content
    raise RuntimeError(f"{url}: {resp.headers.get('x-brd-status-code')} "
                       f"{resp.headers.get('x-brd-error')}")


body = unlock(SITEMAP)
# el archivo puede llegar ya descodificado
xml = (gzip.decompress(body) if body[:2] == b"\x1f\x8b" else body).decode()
entries = re.findall(r"<loc>([^<]+)</loc>\s*<lastmod>([^<]+)</lastmod>", xml)
indiana = [(url, mod) for url, mod in entries if re.search(r"-IN-\d{5}/", url)]
dates = [mod for _, mod in entries]
print(f"{len(entries)} listados modificados a nivel nacional, {len(indiana)} en Indiana")
print("cambio más antiguo:", min(dates), "| más reciente:", max(dates))
print(indiana[0][0])
El archivo listaba 50K listados modificados a nivel nacional, 1,014 de ellos en Indiana:
50000 listados modificados a nivel nacional, 1014 en Indiana
cambio más antiguo: 2026-09-24T14:08:00Z | más reciente: 2026-09-27T07:51:00Z
https://www.zillow.com/homedetails/600-W-Cyprus-Cir-Bloomington-IN-47403/94517948_zpid/
Un archivo sitemap puede listar como máximo 50K URLs, y estos 50K cambios abarcaron unos 3 días. Así que una ejecución diaria puede volver a recopilar solo los listados en tu área que cambiaron desde la última ejecución, lo que mantiene bajo su costo. Envíalos a collect() de 20 URLs a la vez, o en un solo trabajo /trigger. El archivo lista lo que cambió, no cada casa en Zillow.
Los sitemaps en los 4 índices de en-venta listaban 749 de los 1,154 listados de Fort Wayne que encontró el scraper de página de búsqueda, o el 65%. Ninguno de los 217 listados de construcción nueva apareció. Usa los sitemaps para decidir qué volver a recopilar, y usa el descubrimiento para encontrar qué existe.
Lo que cuesta cada enfoque a escala
La forma más barata de obtener una página a menudo no es la forma más barata de obtener un conjunto de datos completo. Cada enfoque a continuación devolvió datos de Zillow, pero difieren en cuán completos son y cuánto trabajo aún te queda. Los precios son las tarifas de lista al momento de la publicación, y nuestra página de precios tiene las tarifas actuales:
| Enfoque | Lo que pagas | Resultado | Trabajo que te queda |
|---|---|---|---|
curl_cffi en tus propias IPs |
Tus servidores y tráfico de proxy | 429 de 430 páginas servidas; búsquedas limitadas a 984 listados; normalmente sin historial de precios en el HTML | Actualizaciones de huella digital, reputación de IP, división de búsquedas, historial de precios |
| API Web Unlocker | $1.50 por 1K solicitudes exitosas | 10 de 10 páginas de listado, mediana de 4.5 s | Parseo, división de búsquedas, historial de precios |
| API de Navegador | $8 por GB | 3.97 MB por listado, aproximadamente $0.03; historial de precios renderizado | Scripts de navegador, parseo |
| API Scraper de Zillow | $1.50 por 1K registros | Los 1,295 listados de Fort Wayne encontrados desde una sola URL; historial de precios para casas tanto en venta como fuera del mercado | Validación |
| Conjuntos de datos de Zillow | Hasta $2.50 por 1K registros, pedido mínimo de $250 | 137.42M registros de propiedades en el mercado, principalmente casas fuera del mercado | Elegir un calendario de actualización |
Web Unlocker cobra solo por solicitudes exitosas y devuelve el código de estado del sitio objetivo en la cabecera x-brd-status-code, así que verifica esa cabecera en tu código. Una solicitud para un listado faltante, por ejemplo, devolvió x-brd-status-code: 404. La API de Navegador renderizó la tabla de historial de precios sin código adicional, lo que conviene para páginas que necesitan una sesión de navegador completa.
El enfoque DIY también tiene un costo de mantenimiento que ningún precio de la tabla muestra. Un desarrollador que ejecuta un scraper diario de Zillow para clientes reportó que se rompe cada trimestre cuando Zillow implementa actualizaciones. Las páginas de Zillow muestran por qué. Cada tipo de listado usaba su propio nombre de operación GraphQL en el JSON, y los selectores de tarjetas de tutoriales antiguos, como article.list-card, no coincidían con nada.
Los conjuntos de datos tienen un propósito diferente: el conjunto de datos de listados de Zillow de Bright Data contiene más de 137M registros de propiedades. La mayoría de esos registros son casas fuera del mercado, lo que conviene para modelos de valoración e investigación que necesitan cada propiedad, no solo casas en venta. Los compradores pueden obtener actualizaciones diarias, semanales, mensuales, o en un calendario personalizado, y la API Scraper recopila listados actuales bajo demanda.
Compara el costo de todo el pipeline, incluyendo descubrimiento, detalles de listado, historial de precios y reintentos, no el costo de obtener una sola página. Nuestra guía sobre scraping web gestionado vs. DIY estima el costo total de ejecutar scrapers internamente.
Reflexiones finales
Para obtener una página de Zillow, necesitas un cliente con la huella TLS de un navegador. Obtener datos completos es más difícil, porque cada búsqueda se detiene en 984 listados y la mayoría de las páginas de listado cargan el historial de precios en una segunda solicitud. Para un trabajo puntual en un área pequeña sin historial de precios, el scraper con curl_cffi es suficiente. Para cada listado con su historial de precios según un calendario, la API Scraper de Zillow de Bright Data se encarga de ambas cosas por ti.
Crea una cuenta gratuita de Bright Data, ejecuta el descubrimiento en una URL de búsqueda de tu mercado, y compara el conteo de filas con el total reportado por Zillow.
Preguntas frecuentes
¿Se pueden extraer datos de Zillow?
Sí, si tu cliente usa la huella TLS de un navegador. La librería requests de Python obtiene un HTTP 403, mientras que curl_cffi imitando a Chrome obtiene la página. Los campos de listado están en JSON incrustado en cada página, así que un parser puede leerlos sin depender del diseño HTML.
¿Por qué Zillow no muestra todos los listados?
Zillow limita cada búsqueda. Su paginación muestra 20 páginas, pero el sitio sirve 24 páginas de 41 listados cada una, así que una búsqueda alcanza 984 listados como máximo. Divide las áreas grandes en búsquedas más pequeñas, o usa la API Scraper de Zillow de Bright Data, que encontró los 1,295 listados de Fort Wayne desde una sola URL.
¿Cómo obtengo datos de historial de precios de Zillow?
Usa la API Scraper de Zillow de Bright Data. Sus registros de listados en venta incluyen historial de precios, y su scraper Full Properties lo devuelve para casas fuera del mercado. La mayoría de las páginas de listado cargan el historial de precios en una segunda solicitud, así que los scrapers solo de HTML lo pierden. Para tendencias de mercado por código postal, Zillow Research publica CSVs gratuitos.
¿Zillow tiene una API abierta?
No. Las APIs de Zillow Group para listados MLS, registros públicos y Zestimates requieren aprobación, limitan las llamadas diarias, y restringen el almacenamiento de datos. Zillow Research ofrece solo CSVs gratuitos de datos a nivel de mercado. Para datos a nivel de listado, la API Scraper de Zillow de Bright Data devuelve listados e historial de precios como JSON estructurado.
¿Cómo se puede extraer datos de Zillow gratis?
Usa curl_cffi, un cliente HTTP de Python gratuito que imita a Chrome, para obtener páginas de listado lentamente, y parsea el JSON incrustado. Ese método se detiene en 984 listados por búsqueda y pierde la mayor parte del historial de precios. Las cuentas nuevas de Bright Data obtienen 5K créditos gratuitos al mes sin tarjeta de crédito, suficiente para 5K registros de la API Scraper de Zillow.
¿Cómo se puede extraer datos de Zillow sin programar?
Usa el panel sin código de un scraper gestionado. En el Panel de Control de Bright Data, abre la API Scraper de Zillow, pega URLs de listado o búsqueda, e inicia la ejecución. Luego descarga los registros como JSON o CSV. Para un mercado completo, puedes comprar un conjunto de datos de Zillow ya elaborado en lugar de hacer scraping.
¿Puede ChatGPT hacer web scraping?
ChatGPT puede escribir código de scraper, pero no está diseñado para recopilar datos de Zillow a escala sin otras herramientas. Un agente de IA obtiene listados estructurados llamando a la herramienta de listados de Zillow en el servidor MCP de Bright Data, y luego trabaja con el JSON devuelto. Verifica la marca de tiempo de cada registro antes de que tu agente cite un precio.