En esta guía, verás:
- Qué es una herramienta de scraping web con IA
- Factores clave para elegir la mejor herramienta de scraping con IA para tu caso de uso
- Las 9 mejores herramientas de scraping web con IA disponibles en 2026
- Una tabla de comparación resumen para evaluar cada solución de un vistazo
¡Comencemos!
¿Qué Es una Herramienta de Scraping Web con IA?
Una herramienta de scraping web con IA utiliza inteligencia artificial para automatizar la extracción de datos de sitios web. Puede ser una plataforma en la nube que ofrece APIs de scraping impulsadas por IA, una biblioteca de Python o JavaScript, o un producto completo sin código construido en torno a un flujo de trabajo visual.
La ventaja del scraping impulsado por IA sobre los scrapers tradicionales es la capacidad de adaptarse a cambios de diseño sin actualizaciones constantes de código, reduciendo el mantenimiento y mejorando la precisión. La contrapartida es que el procesamiento de IA añade latencia y puede ocasionalmente producir resultados alucinados cuando se utiliza extracción basada en LLM.
En general, las herramientas modernas de scraping web con IA incluyen funciones como:
- Instrucciones en lenguaje natural para identificar campos de datos específicos
- Integración con proveedores de LLM (OpenAI, Anthropic, Gemini y otros)
- Conectores predefinidos para sitios web y marketplaces populares
- Renderizado de JavaScript para aplicaciones dinámicas de página única
- Evasión de anti-bots y gestión de proxies para evitar bloqueos de scraping
Cómo Seleccionamos las Mejores Herramientas de Scraping con IA
Al evaluar las principales soluciones de scraping web con IA, estos son los elementos clave a tener en cuenta:
- Capacidades: El rango de características y funcionalidades que admite la herramienta, desde la extracción simple de páginas hasta el rastreo completo de sitios y pipelines de datos estructurados.
- Naturaleza: Si la herramienta es un producto SaaS comercial, de código abierto o una oferta híbrida que combina ambos.
- Lenguajes de programación compatibles: Los lenguajes y frameworks con los que se integra la solución, y si existe una opción sin código.
- Proveedores de IA compatibles: Los modelos de IA a los que se conecta la herramienta, o si utiliza IA propia internamente.
- Precios: Planes y precios directamente del sitio web de cada herramienta, verificados en el momento de la publicación.
- Estrellas en GitHub: Adopción comunitaria para proyectos de código abierto, como señal de madurez e impulso.
Top 9 Herramientas de Scraping Web con IA
Aquí tienes una tabla de comparación resumida de las 9 mejores herramientas de scraping con IA, seguida de reseñas detalladas de cada una:
| Herramienta | Tipo | Código Abierto | Sin Código | Precio Inicial | Estrellas GitHub |
|---|---|---|---|---|---|
| Bright Data | Infraestructura completa | ✔️ (integraciones MCP, LangChain) | ✔️ | Desde $0.75/1k registros | N/A |
| Firecrawl | API para desarrolladores | ✔️ | ❌ | Gratis a $599/mes | 125k+ |
| Crawl4AI | Biblioteca de código abierto | ✔️ | ❌ | Gratis | 66.7k+ |
| Browse AI | Plataforma sin código | ❌ | ✔️ | $19/mes (anual) | N/A |
| Apify | Marketplace de Actors | ✔️ (actors) | ✔️ | Gratis a $999/mes | N/A |
| ScrapeGraphAI | Código abierto + API | ✔️ | ❌ | Gratis a $425/mes | 26.3k+ |
| Diffbot | IA empresarial | ❌ | ✔️ | Gratis a $899/mes | N/A |
| Browserbase | Infraestructura de navegador en la nube | ✔️ (Stagehand SDK) | ❌ | Gratis a $99/mes | N/A |
| Octoparse | Escritorio sin código + nube | ❌ | ✔️ | Gratis a $69/mes | N/A |
1. Bright Data
Bright Data es una infraestructura de datos web construida para el rendimiento, la escala y el cumplimiento normativo. Con la confianza de 50,000+ clientes, ofrece un conjunto completo de herramientas de scraping con IA respaldadas por una de las redes de proxies más grandes del mundo: más de 100 millones de IPs en grupos residenciales, de centros de datos e ISP.
La infraestructura está diseñada para entregar datos web en tiempo real y listos para LLM para agentes de IA, pipelines RAG, entrenamiento de modelos e inteligencia sectorial especializada. Cada producto de scraping está respaldado por tecnología líder en el sector de evasión de anti-bots, para que dediques tu tiempo a tu aplicación en lugar de gestionar bloqueos.
Las herramientas de scraping con IA disponibles en Bright Data incluyen:
- API SERP: Resultados de motores de búsqueda en tiempo real y listos para LLM en Google, Bing y otros, optimizados para agentes de IA y sistemas RAG.
- Unlocker API: Evita CAPTCHAs y sistemas de detección de bots a escala, permitiendo acceso fluido a cualquier página web pública.
- Agent Browser: Navegadores sigilosos sin servidor diseñados para flujos de trabajo de múltiples pasos basados en agentes con carga de contenido dinámico y desbloqueo integrado.
- AI Scraper Studio: Crea y despliega endpoints de scraping personalizados para cualquier sitio web con un constructor visual sin código, entregando datos estructurados bajo demanda a escala.
- Dataset Marketplace: Conjuntos de datos estructurados listos para usar y actualizados continuamente para entrenamiento de modelos, desarrollo de grafos de conocimiento y despliegue inmediato.
Las integraciones de código abierto incluyen langchain-brightdata para pipelines de LangChain y @brightdata/mcp para agentes de IA basados en el Protocolo de Contexto de Modelo.
Precios:
- AI Scraper Studio: Desde $0.75/1,000 registros (25% de descuento promocional, precio regular $1/1k)
- Unlocker API: Desde $1/1,000 solicitudes
- Agent Browser: Desde $5/GB
- Proxies residenciales: Desde $2.50/GB (50% de descuento promocional, precio regular $5/GB)
- Proxies de centro de datos: Desde $0.90/IP
- Prueba gratuita disponible sin necesidad de tarjeta de crédito
2. Firecrawl
Firecrawl es una API de scraping web orientada a desarrolladores que convierte cualquier URL en Markdown limpio listo para LLM o JSON estructurado. Con más de 125,000 estrellas en GitHub, se ha convertido en una de las herramientas de scraping con IA más adoptadas en la comunidad de desarrolladores desde su lanzamiento.
Firecrawl gestiona el renderizado de JavaScript, los desafíos CAPTCHA y el contenido dinámico automáticamente, lo que facilita su integración en pipelines de IA y aplicaciones LLM. Su API está disponible para Python, Node.js, Go, Rust y cualquier lenguaje vía REST. Para comparaciones con las herramientas de Bright Data, consulta Bright Data vs. Firecrawl.
Las capacidades clave incluyen:
- Scrape: Convierte cualquier URL individual a Markdown, HTML o JSON estructurado con una sola llamada a la API
- Crawl: Scraping recursivo de sitios web completos, siguiendo enlaces entre subpáginas
- Search: Búsqueda web con extracción instantánea de contenido de los resultados
- Extract: Extracción de datos estructurados impulsada por LLM usando esquemas en lenguaje natural
- Renderizado de JavaScript: Soporte completo de navegador headless para SPAs y páginas dinámicas
Precios:
- Gratis: 1,000 créditos/mes (1 crédito = 1 página)
- Hobby: $16/mes (facturado anualmente): 5,000 créditos/mes
- Standard: $83/mes (facturado anualmente): 100,000 créditos/mes
- Growth: $333/mes (facturado anualmente): 500,000 créditos/mes
- Scale: $599/mes: 1,000,000 créditos/mes
- Enterprise: Créditos y límites de tasa personalizados
3. Crawl4AI
Crawl4AI es una biblioteca Python de código abierto diseñada específicamente para el scraping web compatible con LLM. Con más de 66,700 estrellas en GitHub, es uno de los proyectos de scraping de código abierto de más rápido crecimiento disponibles hoy en día.
A diferencia de los scrapers de propósito general, Crawl4AI está construido desde cero para flujos de trabajo de IA: genera Markdown limpio optimizado para la eficiencia de tokens, admite estrategias de fragmentación para la ingesta RAG, y se integra directamente con proveedores populares de LLM a través de su pipeline de extracción.
Las capacidades clave incluyen:
- Arquitectura async-first: Construida sobre asyncio y Playwright para scraping concurrente de alto rendimiento
- Salida Markdown optimizada para LLM: Elimina navegación, anuncios y contenido repetitivo para producir contenido limpio para la ingesta de IA
- Estrategias de extracción: Selectores CSS, XPath, extracción basada en LLM y filtrado de contenido por similitud coseno
- Soporte multi-navegador: Chromium, Firefox y WebKit vía Playwright
- Ejecución de JavaScript: Ejecuta JS personalizado antes de la extracción, gestiona contenido dinámico y páginas con carga diferida
- Integraciones con proveedores de IA: OpenAI, Anthropic, Gemini, Ollama, Groq y otros a través del pipeline de extracción
Precios: Crawl4AI es completamente gratuito y de código abierto bajo la licencia Apache 2.0. Hay niveles opcionales de nube y soporte disponibles para equipos que deseen infraestructura gestionada o soporte dedicado.
4. Browse AI
Browse AI es una plataforma de scraping web y monitoreo sin código que permite a los usuarios extraer y rastrear datos de cualquier sitio web sin escribir una sola línea de código. Con la confianza de equipos en grandes empresas para automatizar flujos de trabajo repetitivos de recopilación de datos.
El modo de entrenamiento visual de Browse AI te permite señalar y hacer clic para enseñar a su IA qué campos de datos extraer. Una vez configurado, el robot se ejecuta según un calendario y envía los resultados directamente a Google Sheets, Airtable o cualquiera de sus más de 7,000 integraciones vía Zapier, Make y webhooks.
Las capacidades clave incluyen:
- Más de 250 robots predefinidos: Scrapers listos para usar para LinkedIn, Amazon, Twitter/X y otros sitios populares
- Monitoreo de sitios web: Detección de cambios impulsada por IA con notificaciones cuando el contenido se actualiza
- Más de 7,000 integraciones: Conexiones nativas a Google Sheets, Airtable, Zapier, Make, Slack y más
- Scraping masivo: Ejecuta múltiples URLs en una sola tarea usando una lista de URLs o entrada CSV
- Acceso a API: Activa y recupera ejecuciones de robots mediante programación vía API REST
Precios:
- Starter: $19/mes: 12,000 créditos/año
- Professional: $69/mes: 60,000 créditos/año
- Team: $500/mes: créditos personalizados y límites de equipo
- Facturación mensual disponible a tarifas ligeramente más altas
5. Apify
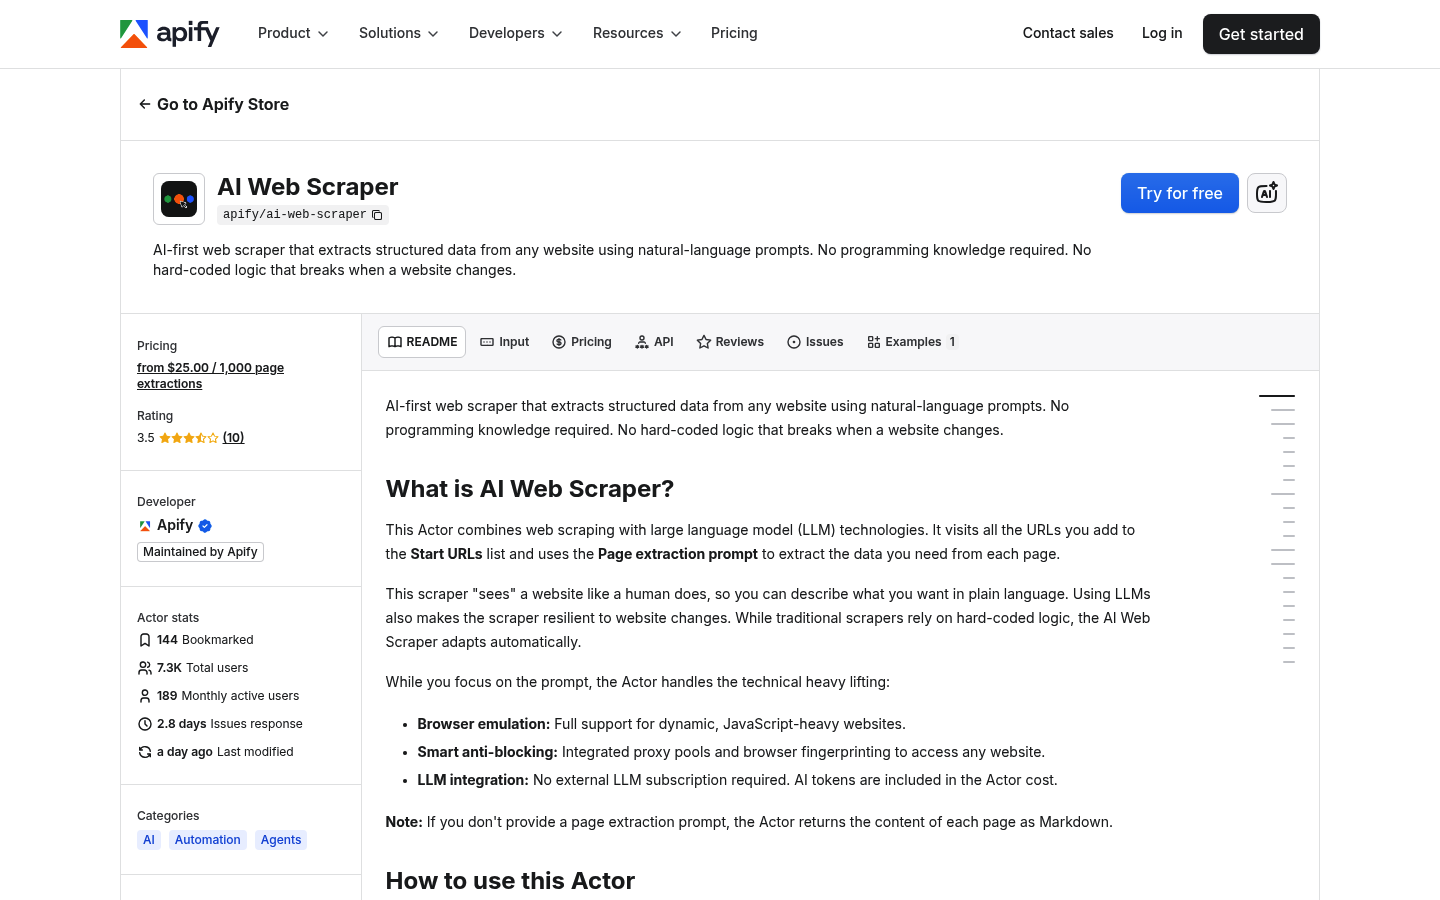
Apify es una plataforma completa de scraping web y automatización centrada en un marketplace de más de 33,000 “Actors” reutilizables (programas sin servidor que se ejecutan en la nube) que pueden programarse, activarse vía API o encadenarse en pipelines.
Su oferta de IA más destacada es el Actor AI Web Scraper, que acepta una instrucción en lenguaje natural (p. ej., “extrae nombres de productos y precios de esta página”) y devuelve JSON estructurado sin necesidad de código ni selectores CSS. Esto hace que Apify sea accesible para usuarios no técnicos, mientras sigue siendo muy extensible para desarrolladores que crean Actors personalizados en JavaScript o Python.
Las capacidades clave incluyen:
- Más de 33,000 Actors: Scrapers predefinidos para todas las plataformas principales, desde redes sociales hasta comercio electrónico y bienes raíces
- AI Web Scraper: Extracción mediante lenguaje natural sin necesidad de código
- Programador y webhooks: Ejecuta Actors según un calendario cron o actívalos mediante programación
- Almacenamiento de conjuntos de datos: Almacenes clave-valor y conjuntos de datos integrados para persistir y exportar resultados
- Gestión de proxies: Rotación integrada de proxies residenciales y de centros de datos en todas las ejecuciones
Precios:
- Gratis: $0: $5 en créditos de plataforma, $0.20/unidad de cómputo
- Starter: $29/mes: $29 en créditos de plataforma, $0.20/unidad de cómputo
- Scale: $199/mes: $199 en créditos de plataforma, $0.16/unidad de cómputo (tarifa con descuento)
- Business: $999/mes: $999 en créditos de plataforma
6. ScrapeGraphAI
ScrapeGraphAI es una biblioteca de scraping web nativa de IA y API en la nube que utiliza LLMs para extraer datos estructurados de cualquier página web mediante una instrucción en lenguaje natural. La biblioteca de código abierto ha acumulado más de 26,300 estrellas en GitHub y la API comercial cuenta con certificación SOC 2 Tipo II.
Una de las características distintivas de ScrapeGraphAI es su flexibilidad con proveedores de LLM: admite OpenAI, Anthropic, Google Gemini, Azure, Groq, Ollama (modelos locales) y varios otros. Esto lo hace práctico para equipos con preferencias específicas de modelos o requisitos locales.
Las capacidades clave incluyen:
- Scrape: Convierte cualquier URL a Markdown limpio, HTML o capturas de pantalla con modo sigiloso opcional
- Extract: Extracción de datos estructurados de páginas web impulsada por LLM usando esquemas en lenguaje natural
- Search: Búsqueda web con extracción de contenido integrada en una sola llamada
- Crawl: Rastreo de sitios completos con extracción por página a profundidad configurable
- Monitor: Rastrea páginas web en busca de cambios y recibe notificaciones vía webhook
- Múltiples proveedores de IA: OpenAI, Anthropic, Gemini, Azure, Groq, Ollama y otros
Precios:
- Gratis: $0: 500 créditos/mes
- Starter: $17/mes: 10,000 créditos/mes
- Growth: $85/mes: 100,000 créditos/mes
- Pro: $425/mes: 750,000 créditos/mes
- Enterprise: Créditos personalizados y soporte dedicado
7. Diffbot
Diffbot es una plataforma de extracción con IA de nivel empresarial que identifica automáticamente el tipo de cualquier página web (artículo, producto, persona, organización, reseña, evento) y devuelve JSON completamente estructurado, sin ninguna configuración de plantilla. Fundada en 2012, es una de las empresas de datos web con IA más consolidadas del mercado.
Más allá de la extracción a nivel de página, Diffbot opera un Knowledge Graph que contiene más de 31 mil millones de entidades del mundo real, lo que lo hace adecuado para casos de uso que involucran resolución de entidades, mapeo de relaciones y construcción de bases de conocimiento a gran escala.
Las capacidades clave incluyen:
- Detección automática de tipo: Identifica artículos, productos, personas, eventos y otros tipos de páginas sin configuración
- Knowledge Graph: Más de 31B entidades con datos de relaciones para resolución de entidades y consultas semánticas
- Crawl API: Rastrea dominios completos y aplica reglas de extracción en todas las páginas descubiertas
- Natural Language API: Extracción de hechos y relaciones de textos mediante PLN
- Sin necesidad de código: API REST sin configuración de selectores para tipos de páginas compatibles
Precios:
- Gratis: $0: 10,000 créditos/mes (1 crédito = 1 extracción de página)
- Startup: $299/mes: 250,000 créditos/mes ($0.001 por crédito)
- Scale: $899/mes: 1,000,000 créditos/mes ($0.0009 por crédito)
- Enterprise: Asignación de créditos y precios personalizados
8. Browserbase
Browserbase es una infraestructura de navegador headless alojada en la nube diseñada para agentes de IA y flujos de trabajo automatizados. En lugar de ser una API de scraping en el sentido tradicional, proporciona navegadores remotos escalables que tu agente o script controla vía Playwright, Puppeteer o Selenium, con modo sigiloso y rotación de proxies integrados a nivel de infraestructura.
Browserbase es especialmente útil para desarrolladores de agentes de IA que necesitan sesiones de navegador fiables y observables a escala. Sus herramientas de repetición de sesiones y depuración ofrecen visibilidad completa de lo que hizo cada sesión de navegador, lo cual es fundamental para diagnosticar fallos en flujos de trabajo complejos de múltiples pasos.
Las capacidades clave incluyen:
- Navegadores sigilosos: Navegadores en la nube con gestión integrada de huellas digitales y evasión de detección de bots
- Compatible con Playwright/Puppeteer/Selenium: Sustituto directo de navegadores headless locales, sin cambios de código necesarios
- Repetición de sesiones: Reproducción visual completa de cada sesión de navegador para depuración y auditoría
- Proxies integrados: Rotación de proxies residenciales con facturación por GB, incluida en todos los planes de pago
- Stagehand SDK: Framework de agente de IA de código abierto construido sobre Browserbase para automatización de navegador en lenguaje natural
Precios:
- Gratis: $0: sesiones limitadas para prototipos
- Developer: $20/mes: luego $0.12/hora de navegador
- Production: $99/mes: luego $0.10/hora de navegador, 5 GB de proxies incluidos
- Enterprise: Precios personalizados con infraestructura dedicada
9. Octoparse
Octoparse es una plataforma de scraping web sin código consolidada, disponible tanto como aplicación de escritorio para Windows/Mac como servicio en la nube. Presente en el mercado desde 2014, es ampliamente utilizada por analistas de negocio, investigadores de mercado y equipos de operaciones que necesitan datos estructurados sin escribir código.
Octoparse usa IA para detectar automáticamente campos de datos y patrones de paginación cuando cargas una página en su scraper visual, reduciendo significativamente el tiempo de configuración en comparación con la configuración manual de selectores. Su biblioteca de más de 250 plantillas cubre muchos sitios web y tipos de datos populares desde el primer momento.
Las capacidades clave incluyen:
- Scraper visual de apuntar y hacer clic: Sin selectores CSS ni XPath: haz clic en los datos que deseas en la página en vivo
- Más de 250 plantillas: Scrapers predefinidos para Amazon, LinkedIn, Tripadvisor y otros sitios principales
- Detección automática de paginación: La IA identifica y gestiona conjuntos de datos de múltiples páginas automáticamente
- Extracción en la nube: Ejecuta tareas en los servidores en la nube de Octoparse 24/7, exporta a Excel, CSV, JSON o bases de datos
- Rotación de IP: Rotación de proxies integrada para reducir bloqueos durante ejecuciones a gran escala
- Ejecuciones programadas: Configura scrapers para que se ejecuten según un calendario fijo sin intervención manual
Precios:
- Gratis: $0: 10 tareas de scraping, 50,000 filas/mes exportadas, ejecución local
- Standard: Desde $69/mes: 100 tareas, extracción en la nube, 3 ejecuciones en la nube simultáneas
- Enterprise: Desde $399: límites de tareas personalizados, recursos en la nube dedicados, soporte prioritario
- Garantía de devolución de dinero de 5 días en todos los planes de pago
Conclusión
El panorama del scraping web con IA en 2026 se ha diversificado significativamente, con opciones sólidas en todos los niveles: desde bibliotecas Python de código abierto como Crawl4AI y ScrapeGraphAI hasta plataformas empresariales completas como Bright Data y Diffbot, y herramientas sin código como Browse AI y Octoparse para usuarios no técnicos.
La herramienta adecuada depende de tus prioridades. Si necesitas máxima escala, fiabilidad y acceso a la infraestructura de proxies más amplia, el conjunto de Bright Data que incluye la Unlocker API, Agent Browser y Web Scraper API es la opción más completa disponible. Para pipelines LLM orientados a desarrolladores, Firecrawl y Crawl4AI ofrecen la mejor experiencia de integración con los frameworks de IA modernos. Para equipos que necesitan un marketplace de actors listo para usar, los más de 33,000 scrapers predefinidos de Apify reducen significativamente el tiempo hasta obtener datos.
Cualquiera que sea la herramienta que elijas, asegúrate de que gestione la rotación de proxies y la evasión de anti-bots de forma nativa: ya no son opcionales para ningún flujo de trabajo de scraping en producción.