Los portales de empleo solo buscan por palabras exactas, por lo que el puesto adecuado permanece oculto cuando tu redacción no coincide con la oferta. La búsqueda semántica coincide por significado. Lo construimos de principio a fin y medimos qué modo de búsqueda gana, en lugar de asumir que el más complejo lo hace.
TL;DR
Esta guía construye un motor de búsqueda de empleo semántico sobre 200 ofertas reales de LinkedIn usando Bright Data (scraping), Cohere (embeddings + reranking) y LanceDB (almacén de vectores local).
- La búsqueda por palabras clave coincide con términos exactos. La búsqueda vectorial coincide por significado. Una consulta como “engineer who works on LLMs” encuentra un puesto de “GenAI Developer” que la búsqueda por palabras clave no detecta.
- La Web Scraper API de Bright Data devuelve empleos estructurados de LinkedIn en formato JSON por $0.0015 por registro, sin necesidad de parsear HTML ni mantener scrapers.
- LanceDB se ejecuta localmente y combina búsqueda vectorial con filtros SQL (salario, nivel de experiencia) en una sola consulta, además de búsqueda de texto completo y reranking con Cohere.
- En 10 consultas de prueba, la búsqueda vectorial obtuvo un 70% de precisión@3 frente al 43% de la búsqueda por palabras clave. El modo híbrido + reranking no aportó mejora medible a esta escala, por lo que por debajo de ~10k filas, el vector solo es una opción predeterminada razonable.
- El proyecto completo consta de 9 archivos pequeños, incluido un arnés de evaluación, y el código completo está en GitHub. La ejecución completa cuesta ~$0.34.
El problema con la búsqueda por palabras clave
La búsqueda por palabras clave en un portal de empleo hace exactamente lo que pides. Devuelve ofertas cuyo título o descripción contiene los tokens literales de tu consulta. Si buscas “engineer who works on LLMs and prompt engineering”, te perderás puestos como “GenAI Developer” aunque sean perfectamente adecuados. La búsqueda léxica coincide con palabras exactas, no con significado.
La búsqueda vectorial coincide por significado. Cada descripción de empleo se convierte en un embedding (un vector de alta dimensión que captura su contenido semántico), y también lo hace tu consulta. Un empleo cuyo vector está cerca del de tu consulta es una buena coincidencia en significado, incluso cuando no comparte ninguna de las mismas palabras.
Convertir eso en un motor de búsqueda funcional requiere 3 componentes:
- Bright Data extrae 200 ofertas de empleo reales de LinkedIn en JSON estructurado y limpio.
- Cohere convierte las descripciones en embeddings y reordena los resultados finales.
- LanceDB almacena los embeddings localmente y sirve consultas híbridas (vector + texto completo) con filtros de estilo SQL.
El stack de un vistazo
Lo que hace cada capa y por qué la usamos:
| Capa | Herramienta | Por qué esta |
|---|---|---|
| Datos web | Bright Data Web Scraper API | El scraper preconfigurado de LinkedIn devuelve JSON estructurado con salario, nivel de experiencia y ubicación, sin parsear HTML ni mantener scrapers. |
| Embeddings | Cohere embed-english-v3.0 |
Codificación asimétrica (diferentes tipos de entrada para documentos vs. consultas). Cohere también ofrece embed-v4.0, que es multimodal. Usamos v3 aquí por su perfil de precio/latencia solo para inglés (planea reincrustar antes del fin de vida de v3). |
| Reranker | Cohere rerank-v3.5 |
Fijamos v3.5 por su perfil de precio/latencia. Cohere también ofrece rerank-v4.0 (-pro para calidad, -fast para latencia). |
| Almacén vectorial | LanceDB | Local, embebido, sin servidores. Soporta búsqueda híbrida (vector + BM25) y prefiltros SQL. |
| UI (opcional) | Streamlit | Interfaz web con código mínimo para una app de datos en Python. |
Este stack se ejecuta desde un único entorno virtual de Python en tu laptop. Bright Data y Cohere son los únicos servicios gestionados involucrados.
Configuración
El proyecto completo y ejecutable está en GitHub. Clónalo e instala las dependencias (Python 3.10 o superior):
git clone https://github.com/triposat/semantic-job-search.git
cd semantic-job-search
python -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
Copia el archivo de entorno de ejemplo y añade tus dos claves API: un token de Bright Data y una clave de Cohere desde dashboard.cohere.com (una clave de prueba funciona para toda la guía):
cp .env.example .env
# then edit .env with your keys:
#   BRIGHTDATA_API_TOKEN=...
#   COHERE_API_KEY=...
Con ambas claves configuradas, ejecuta python scrape.py para obtener los datos y python index.py para construir el índice.
Arquitectura
El sistema tiene dos flujos, no uno. Ingest construye el índice (se ejecuta una vez o de forma programada). Query se ejecuta en cada búsqueda. Ambos usan Cohere y LanceDB, pero para tareas diferentes.
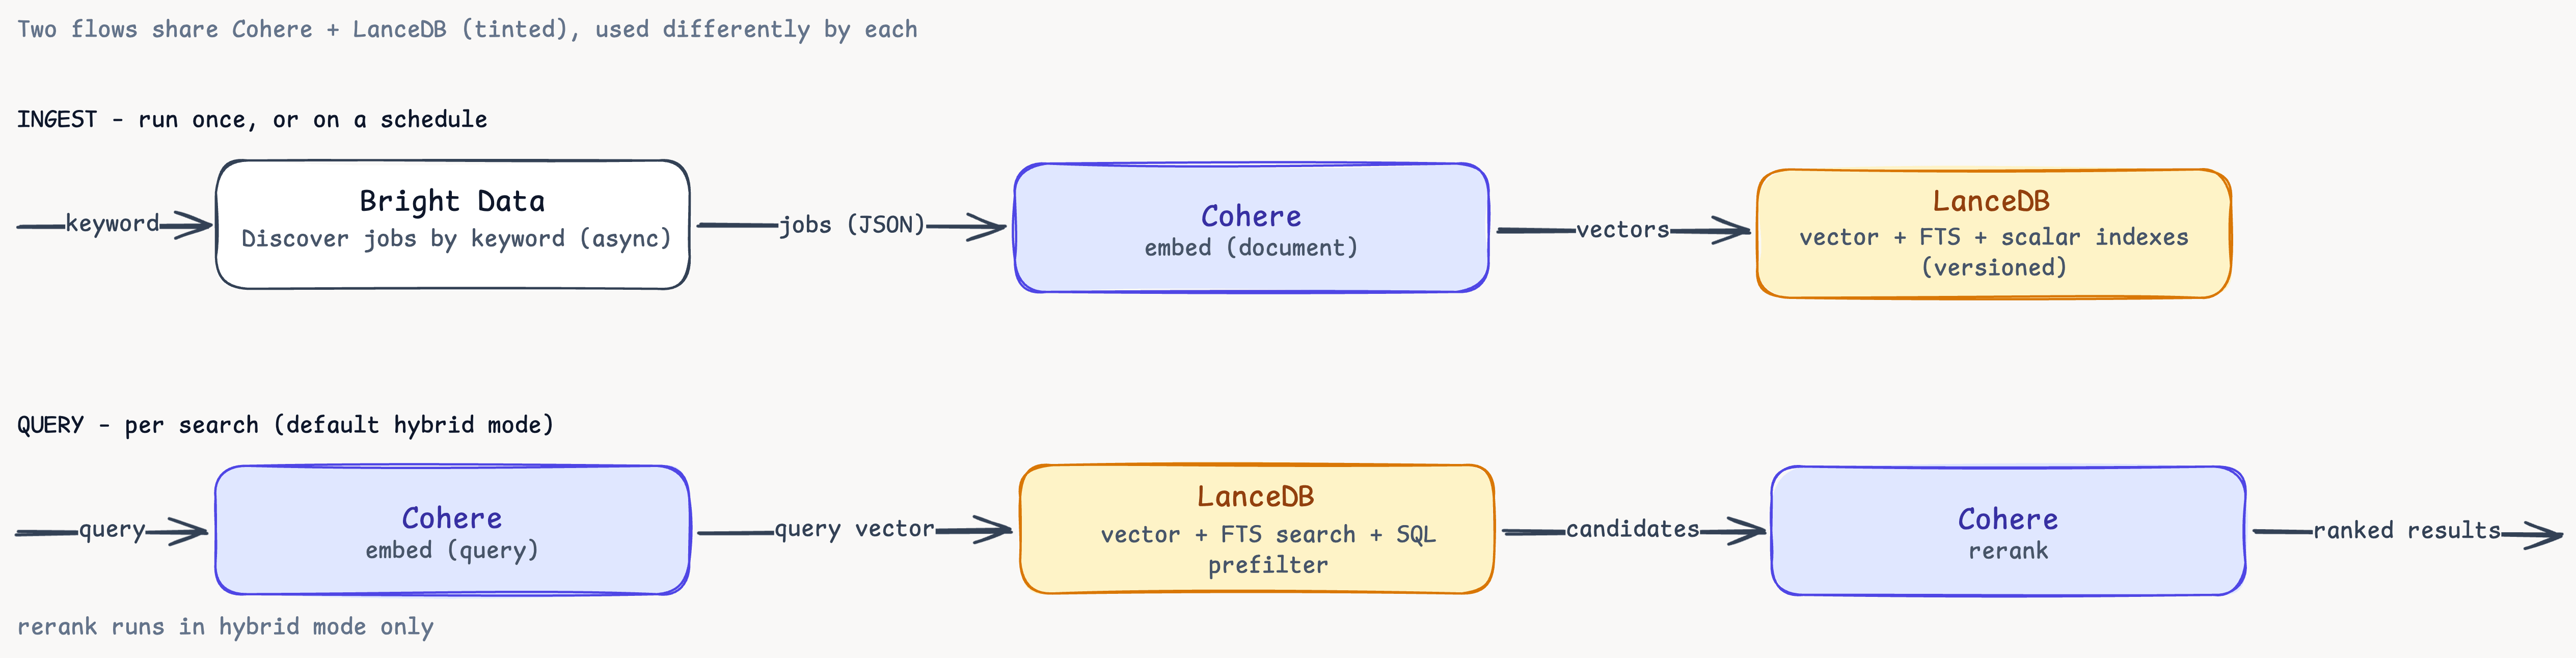
Los dos flujos en paralelo. Ingest incrusta documentos y los almacena. Query incrusta el texto de búsqueda, ejecuta búsqueda vectorial + texto completo con prefiltro SQL y luego reordena. Cohere y LanceDB aparecen en ambos flujos pero hacen trabajo diferente en cada uno, por eso el reranking nunca toca el flujo de ingest.
3 scripts ejecutan el pipeline: scrape.py, index.py, search.py. 6 ayudantes más: lib.py (backend de búsqueda compartido), compare.py (comparación de modos), eval.py (precisión@3), stats.py (resumen del conjunto de datos), versions.py (navegador de snapshots) y app.py (UI de Streamlit).
Extrae datos de LinkedIn con Bright Data
LinkedIn es una fuente principal de datos de empleo, pero es difícil de scrapear de forma fiable: límites de velocidad, marcado dinámico y HTML que cambia sin previo aviso. La Web Scraper API devuelve JSON estructurado y limpio desde endpoints preconfigurados, por lo que no necesitas mantener parsers.
Elige el endpoint correcto
Bright Data expone varios scrapers de LinkedIn:
- Perfiles de personas → perfiles de miembros individuales
- Información de empresas → páginas de empresas
- Ofertas de empleo → Collect by URL → URLs de empleo específicas que ya tienes
- Ofertas de empleo → Discover by keyword ← esto es lo que queremos
- Ofertas de empleo → Discover by URL → empleos desde una URL de resultados de búsqueda
- Publicaciones de LinkedIn y Búsqueda de personas → otros tipos de entidades
Discover by keyword es la opción correcta porque queremos descubrir empleos en masa a partir de una consulta de búsqueda. Una sola llamada a la API devuelve hasta 1,000 ofertas de empleo estructuradas por palabra clave, incluyendo título, empresa, ubicación, nivel de experiencia, tipo de empleo, rango salarial donde se indica y la descripción completa del puesto.
Cada scraper tiene su propio dataset_id. Para encontrarlo, abre la Biblioteca de Scrapers de Bright Data, busca el sitio (aquí, linkedin.com) y ábrelo. Selecciona el endpoint Job listings → Discover by keyword y su dataset_id (gd_lpfll7v5hcqtkxl6l) junto con una solicitud lista para ejecutar aparecerán en el panel de ejemplos de código. Un token válido es todo lo que scrape.py necesita para llamarlo.
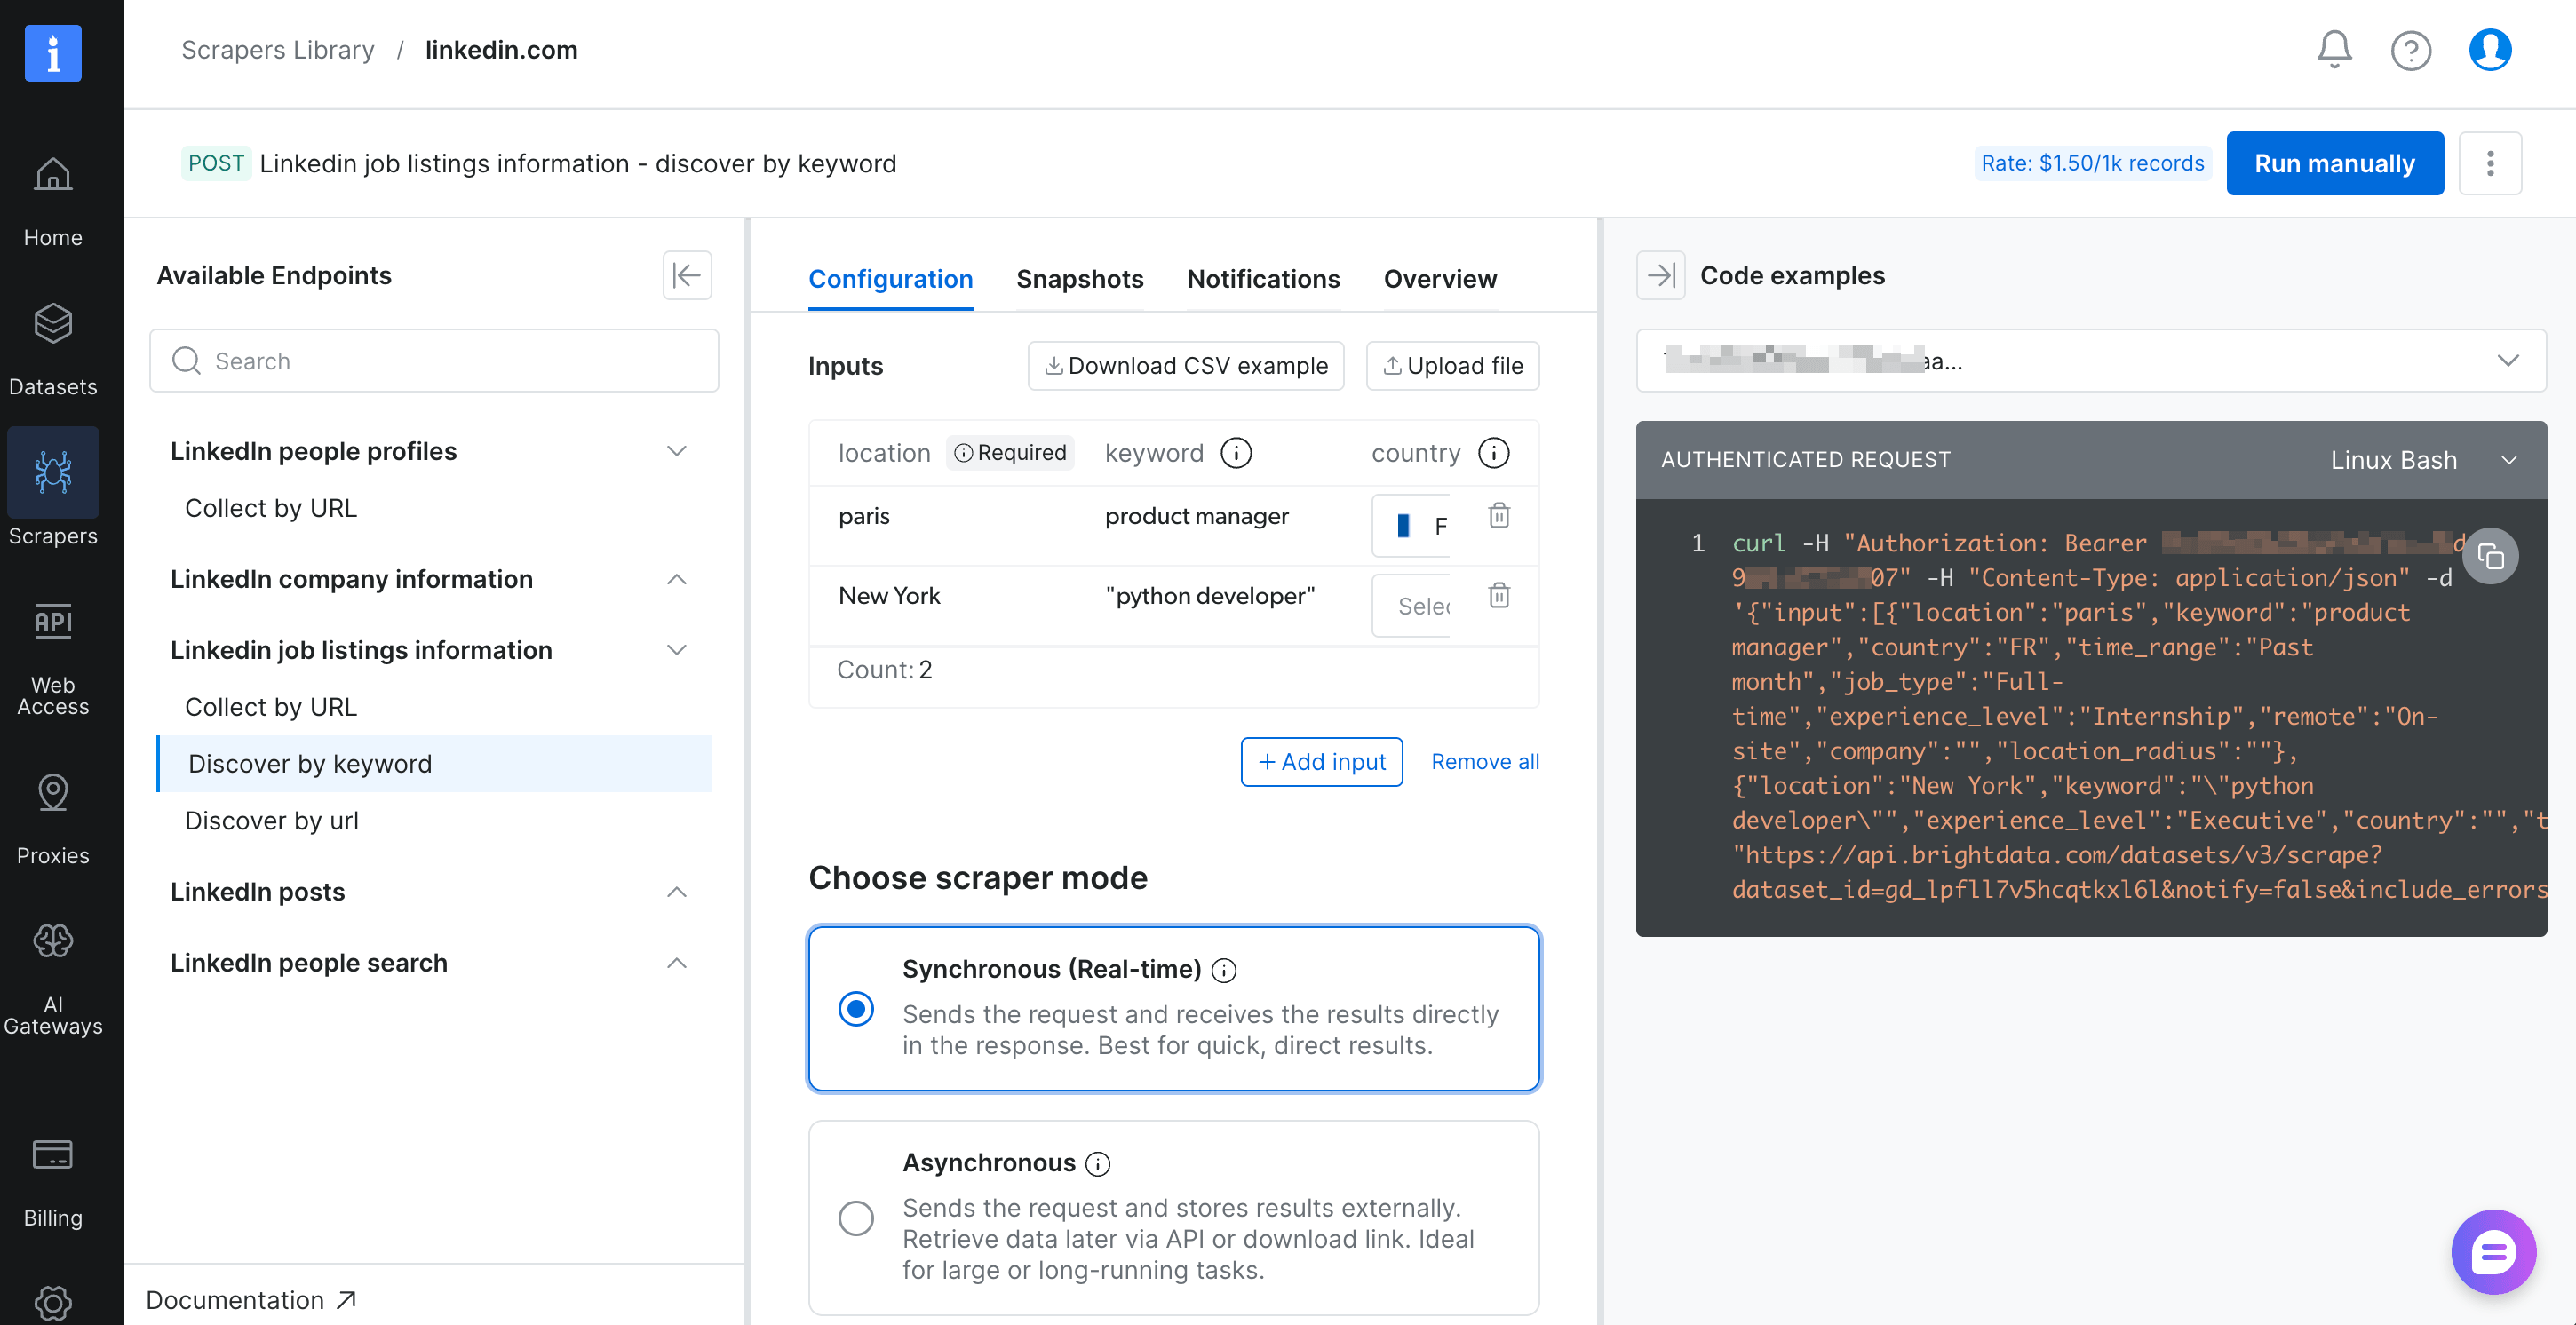
La página del scraper Discover by keyword. El panel de ejemplos de código a la derecha es donde encontrarás el dataset_id.
Síncrono vs. asíncrono
Bright Data ofrece 2 modos de entrega:
- Síncrono (
POST /datasets/v3/scrape) devuelve los datos en línea, ideal para lotes pequeños. - Asíncrono (
POST /datasets/v3/trigger) devuelve un ID de snapshot. Sondeas hasta que esté listo y descargas el resultado, ideal para cualquier cosa más grande.
En nuestras ejecuciones, el tiempo de respuesta promedió ~6 segundos por entrada. Para 2 palabras clave con limit_per_input=100 (200 empleos en total), una llamada síncrona debe mantener la conexión abierta durante todo el lote, lo que arriesga un timeout. El modo asíncrono es la opción segura por defecto.
Controla el costo con límites por entrada
El parámetro de consulta limit_per_input=N limita cuántos resultados devuelve cada búsqueda de entrada, que es exactamente el control que necesitas para un gasto predecible:
2 keywords × 100 jobs × $0.0015 = $0.30 per runAuméntalo para ejecuciones más grandes, hasta 1,000 empleos por palabra clave.
El código
El scraper activa un snapshot, sondea hasta que esté listo y descarga el JSON. El núcleo está a continuación (una versión de producción añadiría reintentos/backoff y manejo de errores más completo):
# scrape.py
import json, time, sys
from pathlib import Path
import requests
from lib import require_env

BD_TOKEN = require_env("BRIGHTDATA_API_TOKEN")
DATASET_ID = "gd_lpfll7v5hcqtkxl6l"  # LinkedIn jobs - discover by keyword
LIMIT_PER_INPUT = 100

SEARCHES = [
    {"location": "San Francisco", "keyword": "machine learning engineer",
     "country": "US", "time_range": "Past month", "job_type": "Full-time",
     "experience_level": "", "remote": "", "company": "", "location_radius": ""},
    {"location": "New York", "keyword": "python developer",
     "country": "US", "time_range": "Past month", "job_type": "Full-time",
     "experience_level": "", "remote": "", "company": "", "location_radius": ""},
]

API = "https://api.brightdata.com/datasets/v3"
HEADERS = {"Authorization": f"Bearer {BD_TOKEN}", "Content-Type": "application/json"}

def trigger_snapshot() -> str:
    r = requests.post(f"{API}/trigger", headers=HEADERS, json={"input": SEARCHES},
        params={"dataset_id": DATASET_ID, "type": "discover_new",
                "discover_by": "keyword", "include_errors": "true",
                "limit_per_input": str(LIMIT_PER_INPUT)})
    r.raise_for_status()
    return r.json()["snapshot_id"]

def wait_until_ready(snapshot_id: str) -> None:
    while True:
        status = requests.get(f"{API}/progress/{snapshot_id}", headers=HEADERS).json()["status"]
        if status == "ready": return
        if status == "failed": raise RuntimeError("snapshot failed")
        time.sleep(10)

def download(snapshot_id: str) -> list[dict]:
    return requests.get(f"{API}/snapshot/{snapshot_id}",
                        headers=HEADERS, params={"format": "json"}).json()
Ejecutándolo:
$ python scrape.py
→ scraping 2 keyword searches, max 100 jobs each
  estimated max cost: $0.30 (at $0.0015/record × 200 max records)
  triggered snapshot: sd_mojicp6g39xwbwqn2
  status: ready
✓ saved 204 jobs → data/raw_jobs.json
  actual cost: $0.31
Qué obtienes de vuelta
Cada empleo en el JSON tiene más de 25 campos. Aquí están los que importan:
{
  "job_posting_id": "<id>",
  "job_title": "Associate Machine Learning Engineer",
  "company_name": "ExampleCo",
  "job_location": "San Francisco, CA",
  "job_seniority_level": "Entry level",
  "job_employment_type": "Full-time",
  "job_industries": "Software Development",
  "job_summary": "About ExampleCo. ExampleCo is the career network for the AI economy...",
  "base_salary": {
    "min_amount": 115000,
    "max_amount": 144000,
    "currency": "$",
    "payment_period": "yr"
  },
  "job_posted_date": "2026-04-25T03:41:21.072Z",
  "url": "https://www.linkedin.com/jobs/view/<id>"
}
El campo estructurado base_salary es lo que hace posibles las consultas con filtro de salario en el siguiente paso.
Indexa con Cohere y LanceDB
Tenemos 204 registros de empleo sin procesar, 4 de ellos son filas de error que filtramos al cargar. Ahora hacemos que los 200 restantes sean buscables semánticamente.
Por qué Cohere
Elegimos Cohere sobre las alternativas (modelos de embedding de OpenAI, Voyage AI o sentence-transformers locales):
- Codificación asimétrica. Cohere te permite etiquetar la entrada como
search_documental indexar osearch_queryal buscar. El modelo codifica cada lado de forma diferente, lo que funciona mejor que tratarlos igual. - Embedding declarativo. El registro de LanceDB soporta Cohere de forma nativa (igual que OpenAI y sentence-transformers), por lo que el embedding ocurre al insertar y al consultar sin llamadas manuales a
embed(). - La API de Rerank. Es un modelo separado que toma una consulta más una lista de candidatos y reordena los candidatos por relevancia real. Es la segunda etapa que puede afinar el ranking de un pipeline híbrido, y añadimos esa etapa con una sola llamada a
.rerank().
El registro de embeddings de LanceDB
Los embeddings en LanceDB pasan por su registro de embeddings. Declaras tu esquema una vez y los embeddings ocurren automáticamente en cada inserción y cada consulta, cada uno con el input_type correcto.
# index.py
import lancedb
from lancedb.embeddings import get_registry
from lancedb.pydantic import LanceModel, Vector

cohere = get_registry().get("cohere").create(
    name="embed-english-v3.0",
    api_key=COHERE_API_KEY,
)

class Job(LanceModel):
    text: str = cohere.SourceField()              # ← qué incrustar
    vector: Vector(cohere.ndims()) = cohere.VectorField()  # ← embedding almacenado
    job_id: str
    title: str
    company: str
    location: str
    country_code: str
    seniority: str
    employment_type: str
    job_function: str
    industry: str
    posted_date: str
    apply_url: str
    search_keyword: str
    salary_min_annual: float
    salary_max_annual: float
    salary_currency: str
    salary_display: str
    description_snippet: str
Todo lo que está después de vector es una columna almacenada simple, usada para filtrado y visualización.
El truco de normalización de salarios
La mayoría de los empleos tienen salarios cotizados por año, pero algunos son por hora. Para que salary_min_annual >= 200000 funcione de manera consistente, normalizamos en la ingesta:
HOURS_PER_YEAR = 2080

def _normalize_salary(base):
    if not base:
        return 0.0, 0.0, "", ""
    lo = float(base.get("min_amount") or 0)
    hi = float(base.get("max_amount") or 0)
    if (base.get("payment_period") or "").lower() == "hr":
        lo *= HOURS_PER_YEAR
        hi *= HOURS_PER_YEAR
    currency = base.get("currency") or ""
    display = f"{currency}{int(lo):,}–{currency}{int(hi):,}/yr" if (lo and hi) else ""
    return lo, hi, currency, display
Almacenamos tanto los valores numéricos sin procesar (para filtros) como una cadena de visualización legible por humanos (para la UI).
Actualizaciones incrementales con upserts
La primera vez que se ejecuta index.py crea la tabla. Cada ejecución posterior es un upsert con clave en job_id:
result = (
    table.merge_insert("job_id")
         .when_matched_update_all()       # actualizar ofertas de empleo existentes
         .when_not_matched_insert_all()   # añadir las recién descubiertas
         .execute(rows)
)
print(f"inserted={result.num_inserted_rows}, updated={result.num_updated_rows}")
Las nuevas ofertas de empleo de un nuevo scrape de Bright Data se insertan, y las ofertas republicadas (mismo job_id) tienen sus salarios, descripciones y marcas de tiempo actualizados. Para eliminar completamente las ofertas obsoletas, encadena .when_not_matched_by_source_delete().
Todo el upsert es una única transacción atómica. Dado que Lance almacena datos de forma columnar con copy-on-write, reingestar es una escritura incremental en lugar de una reconstrucción completa de la tabla.
Índices escalares para filtros SQL rápidos
Cuando se ejecuta search.py, where "salary_min_annual >= 200000", LanceDB aplica el filtro antes del escaneo vectorial (prefilter=True). Con 200 filas eso es instantáneo de cualquier manera. Con 200,000 filas el filtro recorrería toda la columna a menos que le indiquemos a LanceDB cómo indexarla:
table.create_scalar_index("salary_min_annual", index_type="BTREE",  replace=True)
table.create_scalar_index("seniority",         index_type="BITMAP", replace=True)
table.create_scalar_index("search_keyword",    index_type="BITMAP", replace=True)
table.create_scalar_index("employment_type",   index_type="BITMAP", replace=True)
2 tipos de índice cubren lo que necesitamos:
- BTREE para columnas ordenables de mayor cardinalidad.
salary_min_annualse beneficia porque queremos consultas de rango (>=,BETWEEN). - BITMAP para enumeraciones de baja cardinalidad.
senioritytiene ~6 valores distintos,employment_typees casi siempreFull-time, ysearch_keywordes una de nuestras 2 entradas de scrape. Cada valor distinto obtiene su propio bitmap. Un filtro=se convierte en un único AND bit a bit.
Ambos se ejecutan con replace=True, por lo que volver a ejecutar index.py los reconstruye de forma idempotente. Después de la llamada, table.list_indices() reporta los 5 (los 4 escalares + el índice FTS):
text_idx               type=FTS      columns=['text']
salary_min_annual_idx  type=BTree    columns=['salary_min_annual']
seniority_idx          type=Bitmap   columns=['seniority']
search_keyword_idx     type=Bitmap   columns=['search_keyword']
employment_type_idx    type=Bitmap   columns=['employment_type']
Inspecciona los datos indexados
Después de ejecutar python index.py, nuestro script complementario stats.py resume lo que hay en la base de datos:
$ python stats.py

📊 LanceDB · table 'jobs'  ·  200 rows

by source keyword
  machine learning engineer  ████████████████████ 100
  python developer           ████████████████████ 100

by seniority
  Mid-Senior level  ████████████████████ 99
  Entry level       ████████████ 62
  Not Applicable    ████ 20
  Internship        ██ 14
  Associate          4
  Director           1

salary coverage: 43/200 jobs (22%)
  min  $   65,000
  med  $  150,000
  max  $1,000,000

  highest-paying jobs:
    • Quantitative Developer (Python)                  Fintal Partners       $400,000–$1,000,000/yr
    • Machine Learning Engineer                        Mercor                $130,000–$500,000/yr
    • Data Scientist                                   Triumph               $200,000–$400,000/yr
    • Senior Python Developer (Middle Office Tech)     Quantitative Systems  $200,000–$400,000/yr
    • ML Engineer (Infra & Distributed training)       techire ai            $250,000–$400,000/yr

top hiring companies (top 10)
  Turing          ████████████████████ 7
  Handshake       █████████████████ 6
  OpenAI          █████████████████ 6
  Meta            █████████████████ 6
  Jack & Jill     ██████████████ 5
  DataAnnotation  ██████████████ 5
  Catalyst Labs   ███████████ 4
  Notion          ███████████ 4
  LangChain       ███████████ 4
  Uber            ████████ 3
Ejecuta búsqueda híbrida con reranking
LanceDB soporta 3 modos de búsqueda, y nuestro lib.py expone los 3 detrás de una sola función:
# lib.py
from lancedb.rerankers import CohereReranker

reranker = CohereReranker(model_name="rerank-v3.5")  # fijado; el modelo más reciente de Cohere es rerank-v4.0

def search(query: str, mode: str = "hybrid", limit: int = 10, where: str | None = None):
    table = _table()
    if mode == "vector":
        q = table.search(query, query_type="vector")
    elif mode == "keyword":
        q = table.search(query, query_type="fts")
    elif mode == "hybrid":
        q = table.search(query, query_type="hybrid").rerank(reranker=reranker)
    if where:
        q = q.where(where, prefilter=True)
    return q.limit(limit).to_pandas()
Tres partes de search() merecen explicación:
query_type="hybrid"combina similitud vectorial y puntuaciones BM25 del índice de texto completo que construimos en el momento de indexación (FTS nativo de LanceDB). La unión de candidatos se reordena a continuación..rerank(reranker)envía la lista de candidatos a la API de Rerank de Cohere y devuelve su ordenación. Pasamosmodel_name="rerank-v3.5"explícitamente porque el valor predeterminado de LanceDB es más antiguo.prefilter=Trueaplica la cláusula SQLWHEREantes del escaneo vectorial, no después. Esto es más rápido (espacio de búsqueda más pequeño) y más preciso (no pierdes resultados por truncamiento).
Una consulta real
Aquí están los 2 mejores resultados para una consulta que no comparte muchas palabras literales con ningún título de empleo en el conjunto de datos:
$ python search.py "deep learning model training with GPUs"

  ▸ Training: ML Framework Engineer  ·  score 0.275
    OpenAI — San Francisco, CA
    Entry level · Full-time · 2026-04-22
    "About The Team Training Runtime designs the core distributed
     machine-learning training runtime that powers everything from early
     research experiments to frontier-scale model runs..."

  ▸ Machine Learning Engineer  ·  score 0.138
    Skild AI — San Mateo, CA
    Entry level · Full-time · 2026-04-15
    "Company Overview At Skild AI, we are building the world's first
     general purpose robotic intelligence that is robust and adapts to
     unseen scenarios without failing. We believe massive scale through
     data-driven machine learning..."
El título de ninguno de los empleos contiene “GPUs”, pero ambas descripciones tratan sobre entrenamiento distribuido de ML, que es de lo que trata la consulta. La búsqueda pura por palabras clave probablemente se perdería ambos.
Cada modo devuelve un tipo diferente de puntuación. El modo vectorial devuelve distancia coseno (menor = más cercano), el modo híbrido + reranking devuelve la puntuación de relevancia de Cohere (0 a 1, mayor = mejor), y el modo por palabras clave devuelve BM25 sin procesar (sin límite, mayor = más solapamiento de palabras clave). Los números no son comparables entre modos, solo dentro de un único modo.
Combina semántica con restricciones estrictas
La similitud semántica y los filtros SQL se combinan en una sola consulta en LanceDB:
$ python search.py "fintech python role with equity" \
    --where "salary_min_annual >= 250000"

  ▸ Quantitative Developer (Python)  ·  score 0.374
    Fintal Partners — New York, United States
    Mid-Senior level · Full-time · $400,000–$1,000,000/yr · 2026-04-22

  ▸ Senior Software Engineer (Python)  ·  score 0.272
    Fintal Partners — New York, NY
    Mid-Senior level · Full-time · $250,000–$400,000/yr · 2026-04-23
La parte vectorial coincide con la parte descriptiva (“fintech python with equity”). El filtro SQL impone la restricción numérica (>= $250k). Ambos resultados son puestos de Fintal Partners en la banda salarial correcta.
El mismo patrón híbrido + filtro se ejecuta en la UI de Streamlit, en un scrape posterior (las ofertas en vivo difieren de la ejecución CLI anterior):
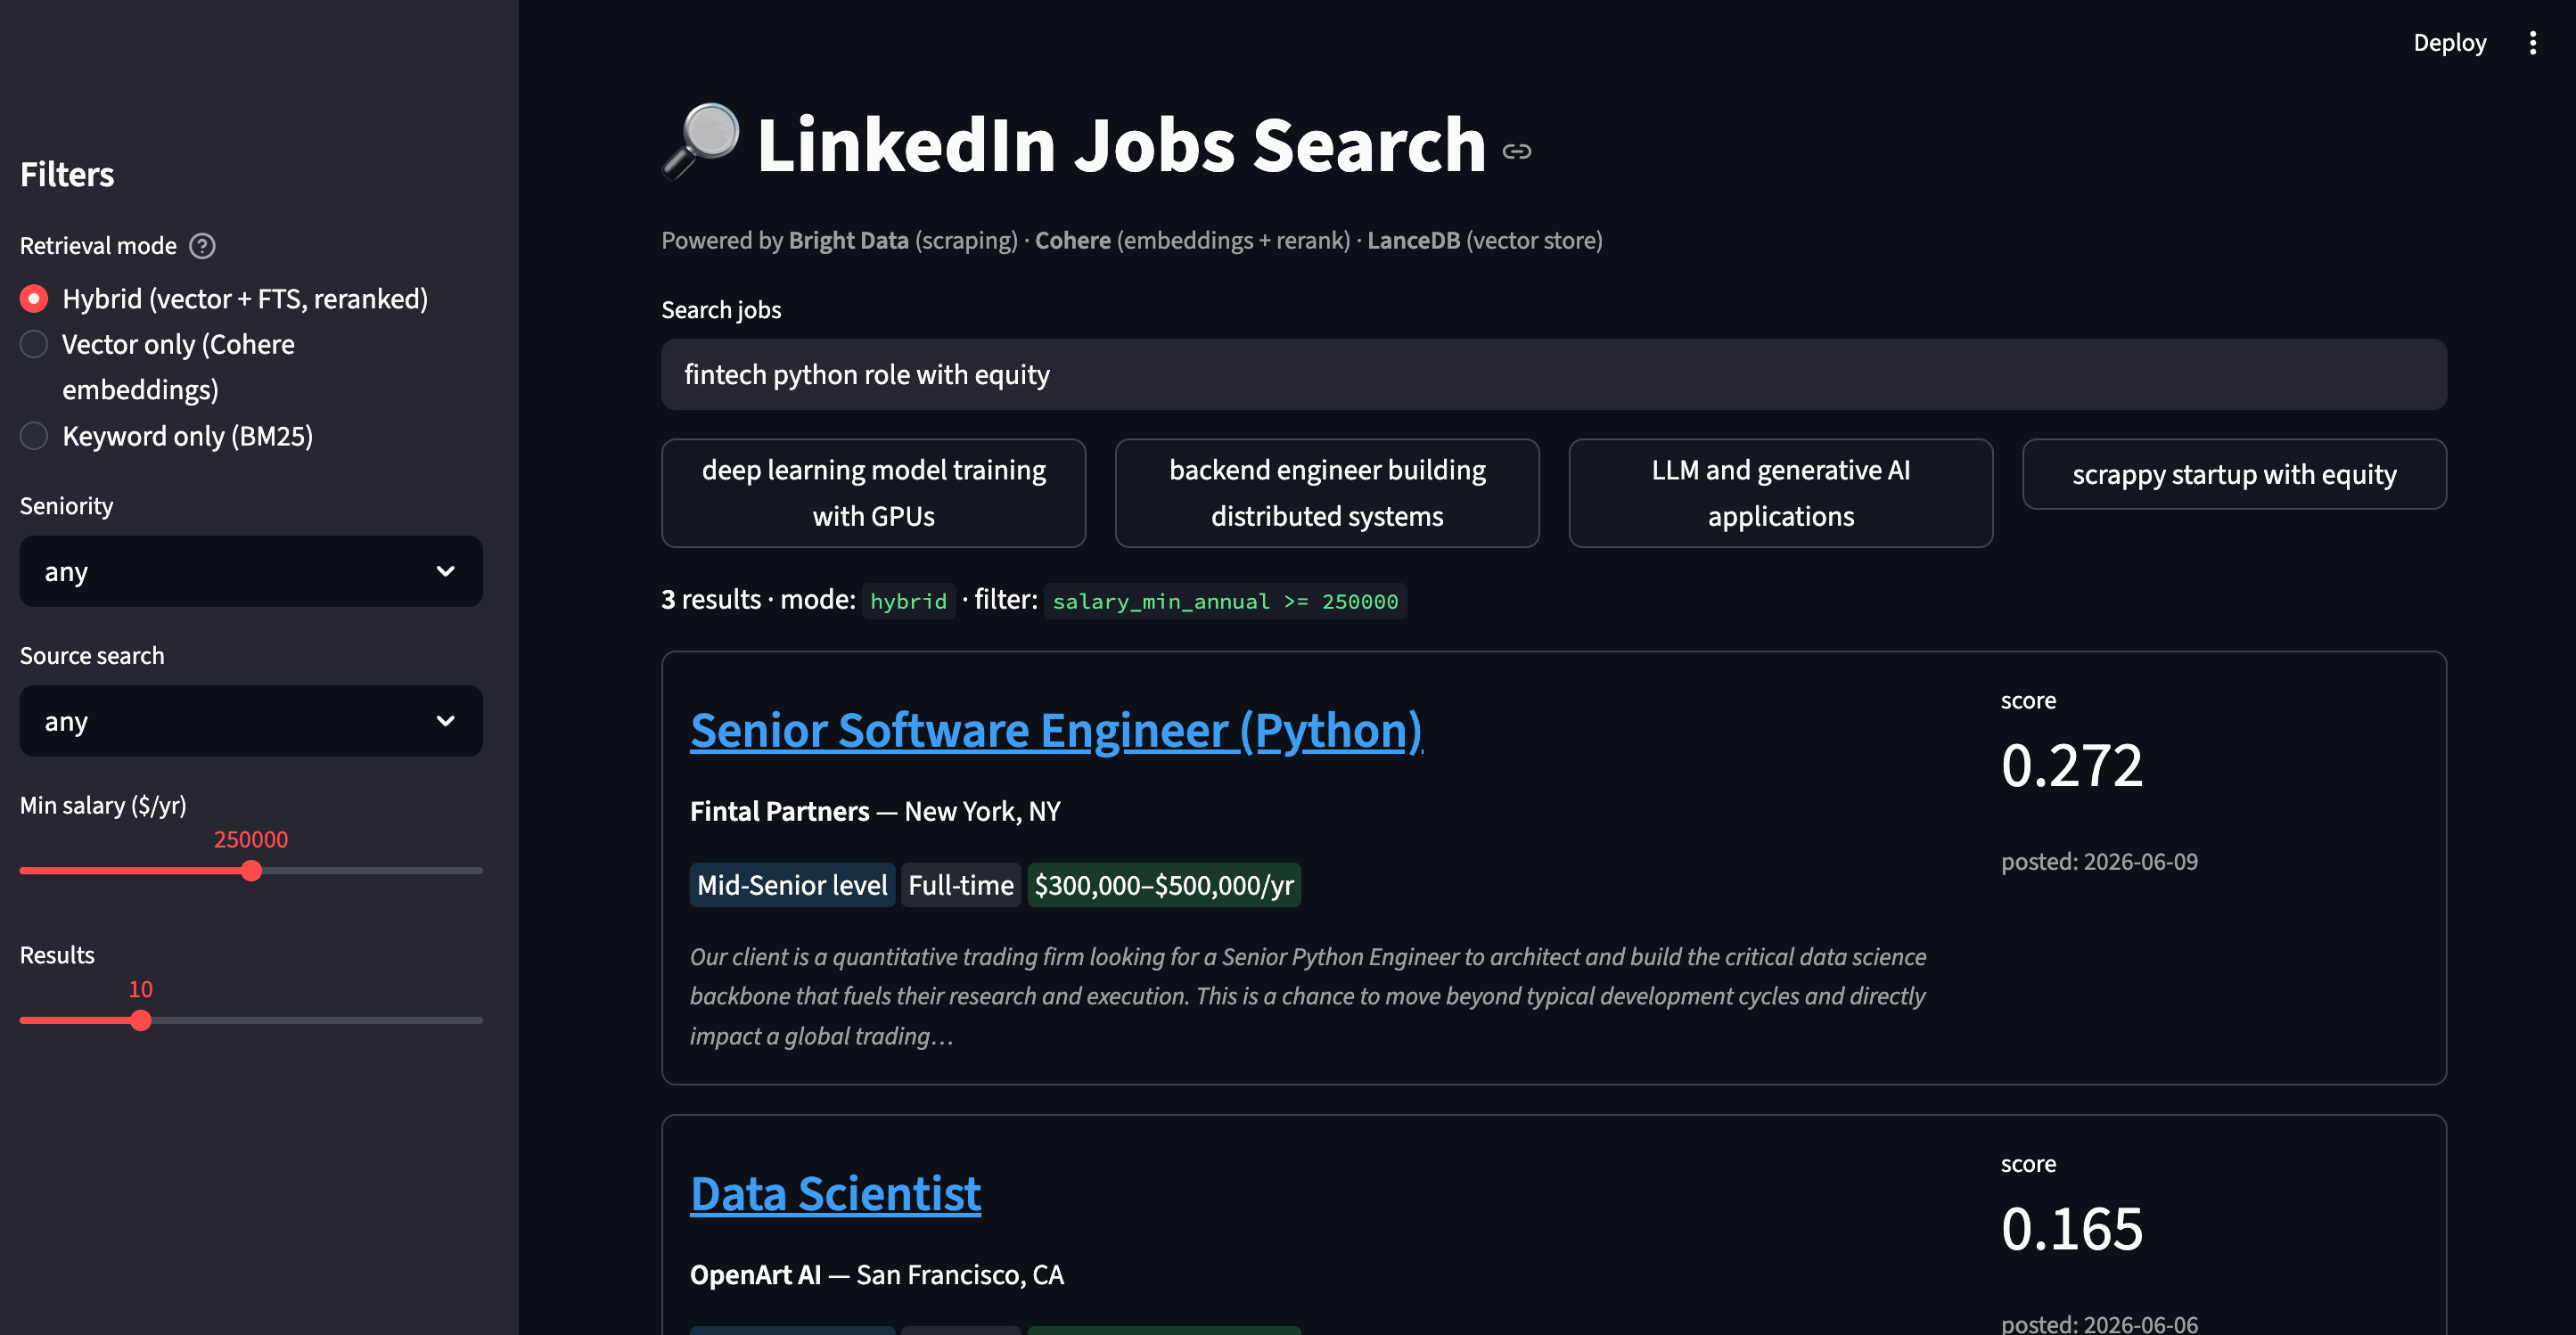 La app de Streamlit ejecutando una búsqueda híbrida con el deslizador de salario configurado, servida desde
app.py. El deslizador produce el prefiltro salary_min_annual >= 250000 mostrado en el banner de filtro verde sobre negro.
Dónde difieren la búsqueda por palabras clave, vectorial e híbrida
compare.py ejecuta la misma consulta a través de los 3 modos e imprime un informe en paralelo:
$ python compare.py "engineer working on LLMs and prompt engineering" --top 3

══════════════════════════════════════════════════════════════════════════
  query: engineer working on LLMs and prompt engineering
══════════════════════════════════════════════════════════════════════════

  ── keyword (BM25) ───────────────────────────────────────────────────────
  1. AI/ML Engineer                                          — Careerswift
  2. AI/ML Engineer                                          — Careerswift
  3. Applied AI Engineer                                     — Serval

  ── vector (Cohere) ──────────────────────────────────────────────────────
  1. Senior Software Engineer (Prompt Engineer Python/GenAI)        — Genpact
  2. 15+ Years exp/ Need f2f/ AI/ML Engineer or Python AI Engi...   — Jobs via Dice
  3. ML Engineer (Infra & Distributed training)                     — techire ai

  ── hybrid + rerank ──────────────────────────────────────────────────────
  1. Applied AI Engineer                                     — Serval
  2. Senior Software Engineer (Prompt Engineer Python/GenAI) — Genpact
  3. AI/ML Engineer                                          — Careerswift

  overlap: keyword∩vector=0/3 · hybrid∩vector=1/3 · hybrid∩keyword=2/3
En la fila de solapamiento, las búsquedas por palabras clave y vectorial encontraron 0 empleos iguales en el top 3. Buscan en espacios conceptuales diferentes.
- La búsqueda por palabras clave (BM25) encuentra ofertas donde los tokens literales “LLMs” y “prompt” aparecen con más frecuencia. Devuelve títulos genéricos de IA/ML.
- La búsqueda vectorial (Cohere) encuentra el puesto Senior Software Engineer (Prompt Engineer Python/GenAI) en el #1, aunque la consulta del usuario decía “prompt engineering” (gerundio) y el título dice “Prompt Engineer” (sustantivo). También devuelve un listado enfocado en LLM de Jobs via Dice que es una fuerte coincidencia semántica pero léxicamente distante de la consulta.
- El modo híbrido + reranking toma la unión, elimina duplicados y lo ejecuta a través de Cohere Rerank. El puesto Applied AI Engineer de Serval ($200k a $325k) sube al #1. Su descripción está llena de trabajo de ingeniería de prompts y agentes LLM, pero ni su título ni sus términos BM25 más ponderados habrían clasificado el puesto tan alto.
Para esta consulta específica, tanto la búsqueda vectorial como la híbrida funcionaron mejor que la búsqueda por palabras clave. El solapamiento de tokens sin procesar clasificó los resultados de Genpact y Serval por debajo de donde los colocó su relevancia semántica. Pero una sola consulta es una anécdota, no evidencia. Si ese patrón se mantiene en general es una pregunta que solo puede responder una evaluación real.
Mide la calidad con precisión@3
Para medir esto correctamente, eval.py puntúa 10 consultas escritas a mano contra los 3 modos y calcula la precisión@3, la fracción de los 3 primeros resultados que coinciden con un predicado de verdad fundamental transparente.
La verdad fundamental para cada consulta es un predicado de Python, no un número mágico, por lo que un lector puede decidir si calificaría los resultados de la misma manera.
Para “machine learning engineer at OpenAI”, un resultado cuenta como relevante solo si su campo company contiene “OpenAI”. Para “quantitative developer at trading firm”, la regla es más amplia. Un resultado cuenta si el título contiene “Quant” o “Trading”, o la empresa es una firma de trading conocida (Fintal Partners, DRW, Hudson River Trading, Tower Research, Mondrian Alpha). Estos predicados están ajustados al conjunto de datos de muestra, por lo que tus puntuaciones cambiarán con empleos nuevos. Ajústalos a tus propios datos. La brecha entre los modos se mantiene incluso cuando los porcentajes exactos no lo hacen.
Ejecutándolo:
$ python eval.py

precision@3 per query (hits/3)
────────────────────────────────────────────────────────────────────────
  query                                          keyword    vector     hybrid
────────────────────────────────────────────────────────────────────────
  machine learning engineer at OpenAI            1.00 (3/3)  1.00 (3/3)  1.00 (3/3)
  founding engineer at AI startup with equity    0.33 (1/3)  0.67 (2/3)  0.67 (2/3)
  prompt engineer working with LLMs              0.00 (0/3)  0.67 (2/3)  0.33 (1/3)
  quantitative developer at trading firm         0.67 (2/3)  1.00 (3/3)  1.00 (3/3)
  computer vision and robotics engineer          1.00 (3/3)  0.67 (2/3)  1.00 (3/3)
  data scientist role                            0.67 (2/3)  1.00 (3/3)  1.00 (3/3)
  distributed training infrastructure for ML     0.33 (1/3)  0.67 (2/3)  0.67 (2/3)
  backend engineer at AI company                 0.33 (1/3)  0.33 (1/3)  0.33 (1/3)
  python developer at fintech                    0.00 (0/3)  0.67 (2/3)  0.33 (1/3)
  high-paying machine learning role with equity  0.00 (0/3)  0.33 (1/3)  0.33 (1/3)
────────────────────────────────────────────────────────────────────────
  AVERAGE (10 queries)                           0.433       0.700       0.667
Los mismos números en un gráfico:
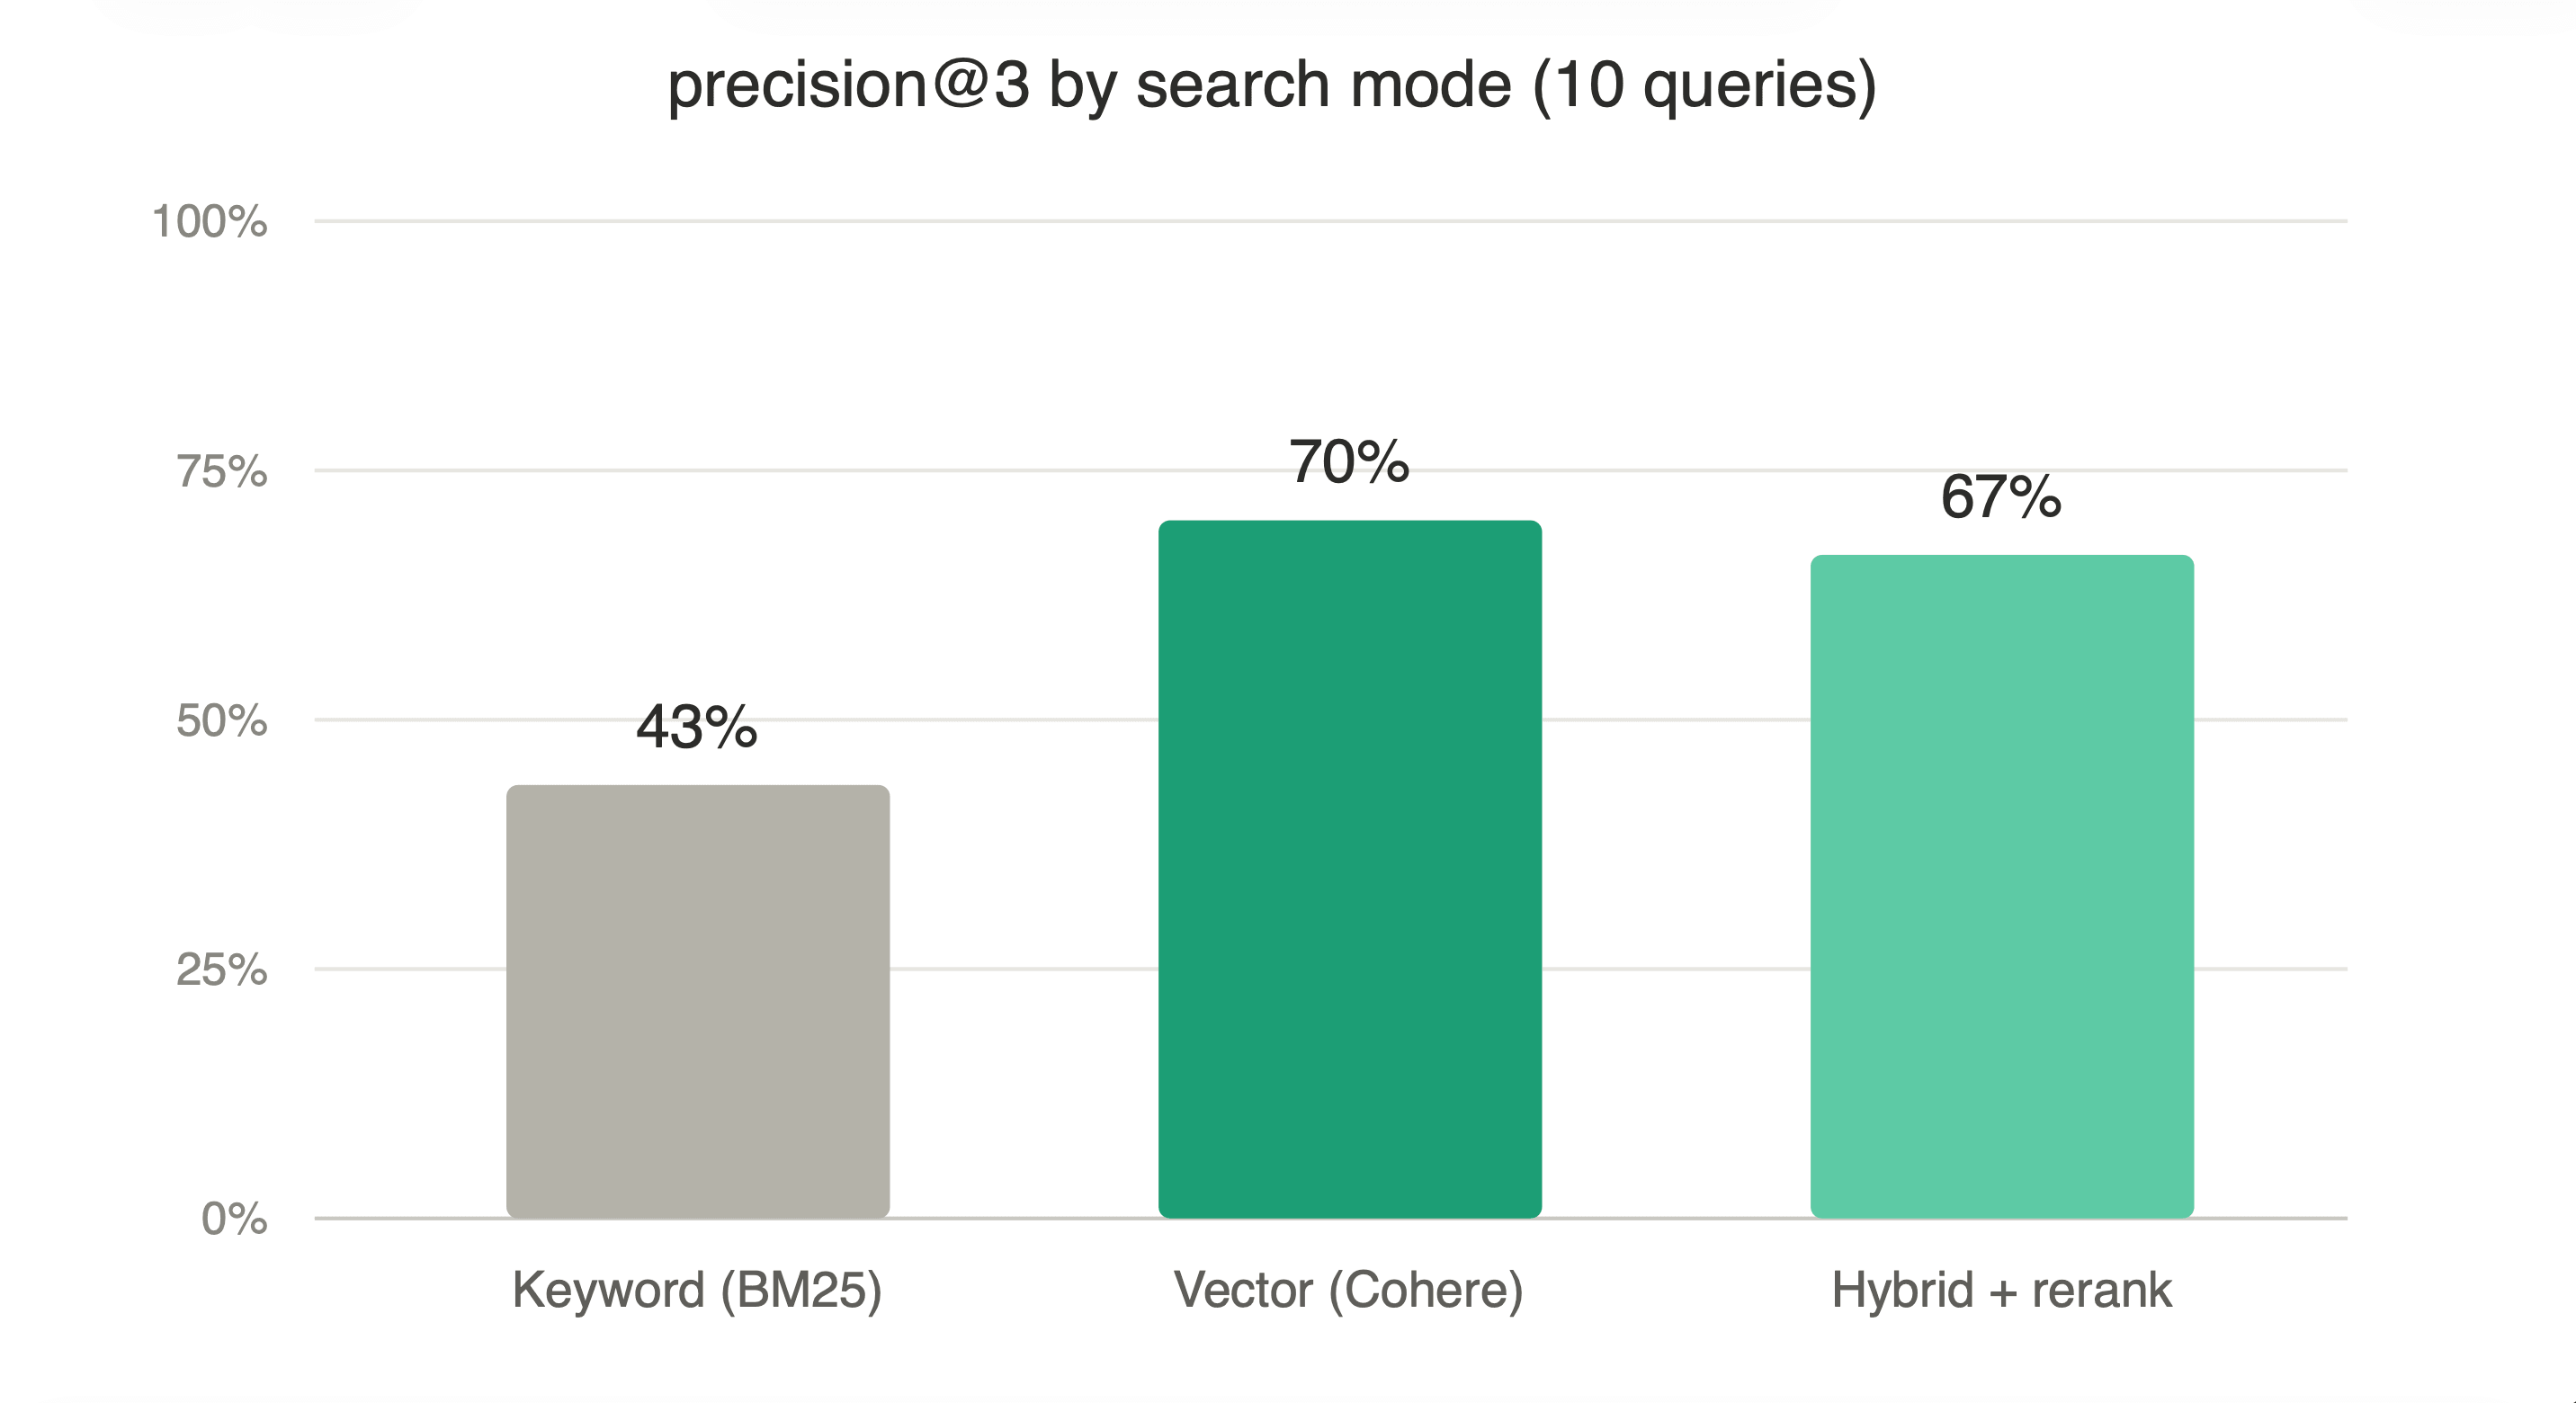
Precisión@3 promediada sobre las 10 consultas de evaluación. La búsqueda vectorial puntúa muy por encima de la búsqueda por palabras clave, y la híbrida está a pocos puntos de la vectorial.
Qué dicen los números
De la tabla:
- La búsqueda vectorial puntuó muy por encima de la búsqueda por palabras clave con un 70% vs 43% de precisión@3 promedio. Las 3 consultas donde la búsqueda por palabras clave obtuvo 0 (“prompt engineer”, “python developer at fintech”, “high-paying ML with equity”) tuvieron al menos 1 resultado relevante bajo la búsqueda vectorial.
- El modo híbrido + reranking no superó al vectorial a esta escala. La brecha del 67% vs 70% está dentro del ruido: el reranker añade una llamada a Cohere por consulta, y la parte FTS le alimenta cuasi-coincidencias léxicas que luego tiene que filtrar.
- Ningún modo está estrictamente dominado. “Computer vision and robotics” es la única consulta donde las palabras clave (1.00) puntúan por encima de la búsqueda vectorial (0.67), porque las empresas relevantes contienen términos literales de robótica en sus descripciones.
Cuándo habilitar híbrido + reranking
Depende de algunos factores:
- Tamaño del grupo de candidatos. Con unos pocos cientos de filas, la búsqueda vectorial sola suele ser suficiente. La recuperación en 2 etapas del modo híbrido necesita un grupo más grande (10k+) antes de que el paso de reranking valga su costo.
- Tipo de consulta. Las consultas con intención semántica y palabras clave distintivas (un nombre de marca, una tecnología específica) se benefician del modo híbrido. Las consultas puramente semánticas generalmente no.
- Calidad del reranker. El rerank-v3.5 de Cohere funcionó bien en nuestra evaluación. Si cambias a un reranker diferente, vuelve a ejecutar
eval.pyantes de confiar en él, ya que un reranker más débil puede reordenar buenos resultados vectoriales hacia abajo en un grupo de candidatos pequeño.
Ejecuta eval.py en tus propios datos para decidir. Añadir una consulta es una cadena más un predicado de verdad fundamental.
Nota: la evaluación híbrida se ejecuta bien con una clave gratuita de Cohere. El límite de velocidad de prueba hace que retroceda y termine en ~90s en lugar de ~15.
Añade una interfaz web con Streamlit
Streamlit convierte el mismo backend de búsqueda en una aplicación web interactiva. El núcleo de búsqueda y renderizado está a continuación:
# app.py
import streamlit as st
from lib import search

mode = st.sidebar.radio("Mode", ["hybrid", "vector", "keyword"])
seniority = st.sidebar.selectbox("Seniority", ["any", "Entry level", "Associate", "Mid-Senior level", "Director", "Internship", "Not Applicable"])
min_salary = st.sidebar.slider("Min salary ($/yr)", 0, 500_000, 0, step=10_000)

query = st.text_input("Search jobs", placeholder="e.g. remote ML engineer...")

if query:
    where_clauses = []
    if seniority != "any":
        where_clauses.append(f"seniority = '{seniority}'")
    if min_salary > 0:
        where_clauses.append(f"salary_min_annual >= {min_salary}")
    where = " AND ".join(where_clauses) or None

    df = search(query, mode=mode, where=where, limit=10)
    for _, row in df.iterrows():
        with st.container(border=True):
            st.markdown(f"### [{row['title']}]({row['apply_url']})")
            st.markdown(f"**{row['company']}** — {row['location']}")
            st.caption(row["description_snippet"] + "…")
Ejecútalo:
streamlit run app.pyObtienes una página de búsqueda completa en localhost:8501 con un cuadro de búsqueda, selector de modo, filtros de barra lateral para nivel de experiencia, palabra clave de origen y salario, además de tarjetas de resultados con insignias, puntuaciones y vistas previas de fragmentos.
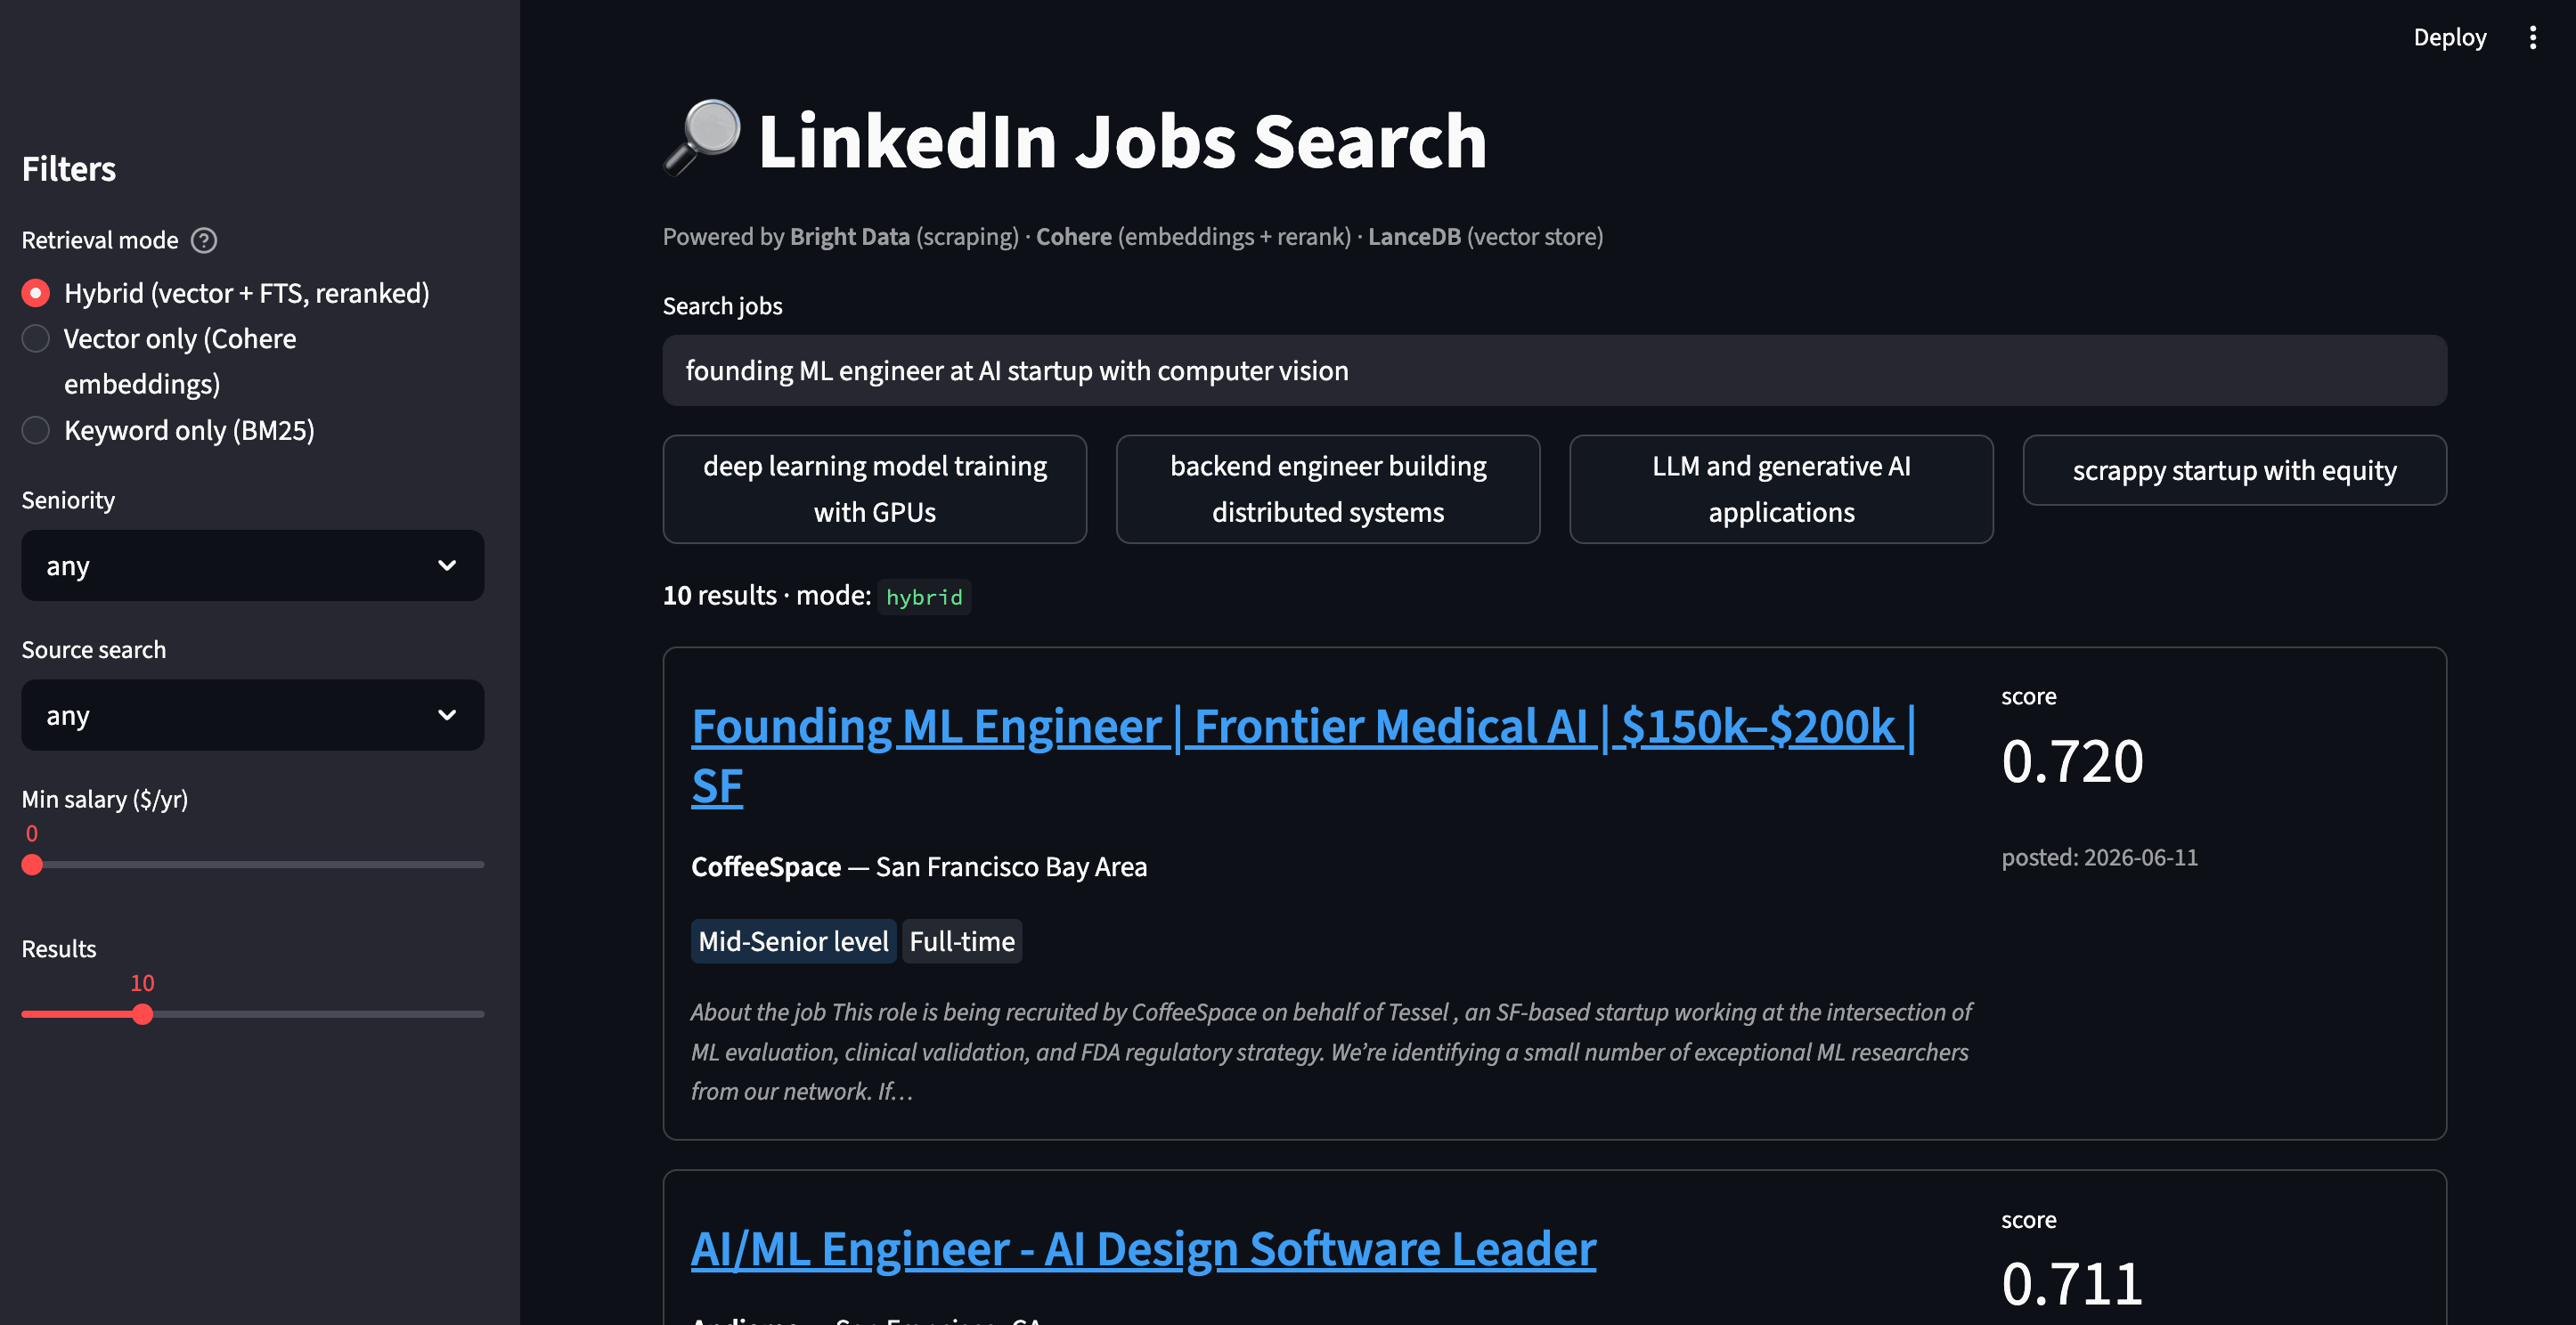
La app de Streamlit ejecutando una búsqueda híbrida. La insignia de puntuación en cada tarjeta es la puntuación de relevancia de Cohere, y el fragmento debajo de las insignias muestra por qué cada resultado llegó al top 3.
Viaje en el tiempo gratuito con LanceDB
Eso cubre la búsqueda y la UI. LanceDB tiene una característica más que vale la pena mostrar. Cada escritura en LanceDB crea una nueva versión automáticamente, sin costo adicional ni infraestructura. Así es como funciona el formato columnar Lance subyacente. Para que una versión sea fácil de encontrar más tarde, index.py la etiqueta después de cada ingesta:
table.tags.create(f"ingest-{datetime.now():%Y-%m-%d-%H%M}", table.version)Nuestro script complementario versions.py te permite explorar y abrir snapshots históricos. Después de ejecutar python index.py una vez verás 1 etiqueta. Después de una segunda ingesta (por ejemplo, volviendo a scrapear una semana después) verás 2:
$ python versions.py

📊 table 'jobs'  ·  current version: 13  ·  200 rows

🏷  tags (2):
  • ingest-2026-05-20-0905           → version 7
  • ingest-2026-05-20-0906           → version 13  ← current

  travel back with: `python versions.py --tag <name>`

$ python versions.py --tag ingest-2026-05-20-0905

📌 snapshot 'ingest-2026-05-20-0905'  ·  version 7  ·  200 rows
  • Associate Machine Learning Engineer  — Handshake
  • Machine Learning Engineer            — RZR
  • Machine Learning Engineer            — ChatGPT Jobs
El viaje en el tiempo es una sola llamada a table.checkout(tag_or_version). Para un producto de búsqueda de empleo responde preguntas como “¿qué puestos se publicaron el trimestre pasado?” o “¿está cambiando la distribución salarial con el tiempo?” sin una base de datos de series temporales separada. Esa es una razón por la que elegimos LanceDB aquí.
Costo y escala
Para la demo (200 empleos, ~5 consultas de ejemplo):
| Elemento | Costo |
|---|---|
| Scrape de Bright Data (204 registros @ $0.0015/registro) | $0.31 |
| Embeddings de Cohere (~228k tokens en total @ $0.10/1M) | ~$0.02 |
| Reranking de Cohere (~$0.002/consulta, Rerank v3.5 a $2 / 1k búsquedas) | ~$0.01 por 5 consultas |
| LanceDB | gratuito |
La demo completa cuesta ~$0.34 en total. Estos precios son de una ejecución de 2026, así que verifica las tarifas actuales de los proveedores.
Escala hacia arriba
La demo local maneja 200 empleos. Algunos controles cubren el camino desde aquí hasta un conjunto de datos a escala de producción:
- Más empleos. Cambia
LIMIT_PER_INPUT(máximo 1,000 por palabra clave) o añade más búsquedas de palabras clave. 10,000 empleos cuesta ~$15 en créditos de Bright Data. - Más palabras clave / ubicaciones. Añade entradas a la lista
SEARCHESenscrape.py. - Actualización programada. El upsert
merge_insertque construimos significa que volver a ejecutar el pipeline actualiza lo que ha cambiado. Bright Data soporta recolección y entrega programadas desde el panel de control. Combina eso con el upsert y tendrás un conjunto de datos que se actualiza solo. - Índice vectorial. A partir de ~10k filas, cambia la búsqueda por fuerza bruta por un índice HNSW o IVF_PQ mediante
table.create_index(vector_column_name="vector"). Se construye en CPU por defecto. Para una construcción en GPU, pasaaccelerator="cuda"(o"mps"en Apple Silicon) con PyTorch>2.0. La indexación automática en GPU es actualmente una característica de LanceDB Enterprise. - Almacén vectorial de producción. LanceDB OSS escala a millones de vectores en un solo nodo. Más allá de cientos de millones de vectores o terabytes de datos, LanceDB Cloud y Enterprise añaden indexación distribuida y ejecución de consultas (su documentación apunta a ~10 a 50B filas / ~10 a 30 TB).
Antes de cualquiera de esos movimientos de escalado, sin embargo, la propia demo tiene aristas afiladas.
8 bugs y problemas que encontramos
Por si te ahorra las horas que nos costaron a nosotros:
list_tables()no devuelve una lista. En LanceDB 0.30 devuelve un objetoListTablesResponseque parece iterable en el REPL peroif TABLE in db.list_tables()falla silenciosamente. Usatry: db.open_table(TABLE)y captura la excepción, o usa.tablesen la respuesta.table.checkout(tag)devuelveNoney muta el manejador de tabla en su lugar. Parece un bug, pero no lo es. Hazt = db.open_table(...); t.checkout(tag); use(t), not = db.open_table(...).checkout(tag).- El
CohereReranker()predeterminado usa un modelo antiguo (rerank-english-v3.0en las versiones que probamos). Pasa un modelo explícitamente, ya searerank-v3.5(lo que fijamos aquí) orerank-v4.0-propara mayor calidad. El predeterminado no te avisa. - Usa
/trigger+ polling, no/scrape, para lotes reales. El modo síncrono (/scrape) está diseñado para extracciones pequeñas. Mantener la conexión abierta paralimit_per_input=100× 2 palabras clave (~200 empleos) puede alcanzar un timeout, así que usa/trigger+ polling para más de ~50 registros. - Algunos registros scrapeados son filas de error. De 204 empleos, 4 tenían un campo
errorestablecido en lugar de unjob_title(por ejemplo,"Crawl aborted on job cancel"). Parecen registros normales superficialmente, así que fíltralos enindex.pyomerge_insertfallará con unjob_idvacío. - Los salarios vienen en 2 períodos (
yryhr) pero el campo del esquema es el mismo. Sin normalizar a anual (multiplicar por hora por 2080), un filtro comosalary_min_annual >= 200000silenciosamente se pierde contratos por hora bien pagados e incluye puestos asalariados con salarios implausiblemente bajos. - Las cadenas de ayuda de
argparsecon%sin escape fallan en Python 3.14. Escribir--where "salary > 200000 AND location LIKE '%SF%'"en tu texto de ayuda generaValueError: badly formed help stringporque argparse intenta formatearlo. Escapa como%%o reformula el ejemplo. - Streamlit renderiza el texto entre signos
$como matemáticas LaTeX. Un salario como$150k,$200kmostrado const.markdownost.captionse convierte en matemáticas distorsionadas. Escapa cada$en tus cadenas de visualización (elapp.pydel repositorio lo hace con unreplacede una línea), o las insignias de salario se renderizan como texto incomprensible.
Qué puedes construir a continuación
El patrón, Bright Data ⟶ embeddings ⟶ base de datos vectorial ⟶ búsqueda híbrida, se generaliza a casi cualquier dominio:
| Dominio | Producto de Bright Data | Qué consultarías |
|---|---|---|
| Acceso web agéntico | El MCP de Bright Data (nivel gratuito actualmente 5,000 solicitudes/mes) | “dar a un agente de IA herramientas de búsqueda y scraping en vivo, luego fundamentar sus respuestas en una caché respaldada por LanceDB de resultados anteriores” |
| Corpus de sitios completos | Crawl API | “indexar un sitio de documentación completo o base de conocimiento para recuperación híbrida” |
| Comercio electrónico | Web Scraper API (productos de Amazon) | “zapatillas para correr cómodas por menos de $100 con 4+ estrellas” |
| Bienes raíces | Web Scraper API (Zillow / Redfin) | “casa familiar tranquila cerca de buenas escuelas, 3+ habitaciones” |
| Inteligencia de noticias | API SERP + Web Unlocker | “artículos sobre seguridad de IA de esta semana, ordenados por relevancia para la alineación” |
| Prospección de ventas | Información de empresas de LinkedIn | “startups de Serie A en IA sanitaria con sede en Europa” |
| Restaurantes | Conjunto de datos de Yelp | “lugar italiano acogedor con terraza exterior” |
Algunas extensiones naturales de este proyecto exacto:
- Búsqueda multimodal. Cambia a Cohere
embed-v4.0(nativamente multimodal) e incrusta logotipos de empresas junto con las descripciones de empleo. - Filtros extraídos por IA. Permite que el usuario escriba “empleos de ML remotos pagando $200k+” y que una IA extraiga
remote=true, salary_min_annual >= 200000automáticamente. - Búsquedas guardadas con alertas por email. Vuelve a ejecutar una consulta contra el scrape más reciente y notifica sobre nuevas coincidencias.
- Coincidencia de currículum. Incrusta un currículum y busca empleos por similitud con el candidato. El asistente de IA para búsqueda de empleo en LinkedIn de Bright Data es un ejemplo más completo.
- Un scraper que se mantiene solo. Dale a un agente acceso al MCP de Bright Data y puede inspeccionar la página, escribir el scraper e intentar una corrección cuando cambie el diseño, en lugar de que tú parchees
scrape.pya mano. El Scraper Studio de Bright Data empaqueta esto como un producto gestionado, convirtiendo un prompt en lenguaje natural en un scraper que se repara solo.
Próximos pasos
La búsqueda por palabras clave se perdió los puestos correctos, y la búsqueda vectorial los encontró incluso cuando los títulos nunca coincidieron con la consulta. En la evaluación, la búsqueda vectorial obtuvo un 70% de precisión@3 frente al 43% de las palabras clave, sin que el modo híbrido añadiera mejora a esta escala.
El proyecto completo en GitHub consta de 9 archivos pequeños. Para usarlo en tus propios datos, ejecuta primero python eval.py, porque el mejor modo depende de los datos, no de cuál es más complejo. Luego decide una cadencia de actualización, donde los upserts de merge_insert solo actualizan lo que cambió y versions.py hace un snapshot de cada ingesta. Y antes de que cualquier cosa se publique, planifica una rutina de rotación de claves, porque tanto las claves de BD como las de Cohere van en .env.
El mismo patrón funciona para cualquier cosa que Bright Data pueda scrapear, no solo empleos. A partir de ahí, tienes un motor de búsqueda semántico que puedes reutilizar para cualquier conjunto de datos que extraigas.
FAQ
¿Puedo usar esto para sitios distintos a LinkedIn?
Sí. La Biblioteca de Web Scrapers de Bright Data cubre cientos de sitios (Amazon, Zillow, Yelp y más), cada uno con su propio dataset_id. Cambia el DATASET_ID en scrape.py y el mapeo to_row() en index.py para la nueva forma JSON. La lógica de búsqueda e indexación es agnóstica a los datos y se transfiere.
¿Necesito una cuenta de pago de Cohere para esto?
No, una clave de prueba ejecuta toda la demo. El endpoint de Rerank de prueba de Cohere está actualmente limitado a 10 llamadas/min, por lo que eval.py recibe un 429 y retrocede automáticamente (~90s en lugar de ~15s). El scraping, la indexación y la búsqueda ad-hoc se mantienen bien dentro de los límites. Actualiza solo si iteras en la evaluación con frecuencia.
¿Por qué LanceDB y no Pinecone, Weaviate o pgvector?
LanceDB es una biblioteca embebida sin servidor, sin base de datos separada y sin factura de servicio gestionado. Soporta búsqueda híbrida y reranking de Cohere de forma nativa, y cada escritura es un snapshot de versión. Para un pipeline de una sola máquina sin operaciones, eso es la menor sobrecarga. Las otras opciones son capaces pero añaden más infraestructura.
¿Con qué frecuencia debo volver a ejecutar el scraper?
Una vez al día es adecuado para un portal de empleo activo. Bright Data puede ejecutar recolección programada desde el panel de control, y el upsert merge_insert elimina duplicados en el lado de LanceDB, por lo que las re-ejecuciones son económicas. Las ofertas de más de ~30 días suelen estar cerradas, por lo que los snapshots antiguos se vuelven históricos, y versions.py los mantiene consultables.