En la nueva era de la ingeniería agéntica, el “contexto” ya no es solo datos; es el combustible de cada decisión que toma tu agente. Sin embargo, la mayoría de los equipos tratan el contexto como una entrada estática en lugar de un desafío de ingeniería dinámico. El verdadero cuello de botella no es solo el acceso a los datos, sino la capacidad de transformar esos datos en un estado que sea actualizado, verificado y suficientemente eficiente en tokens para un razonamiento confiable.
Context-as-a-Service ha surgido como una solución fundamental para proporcionar a los agentes el mejor contexto posible. CaaS ofrece la infraestructura para transformar esa gigantesca y desestructurada cantidad de datos web en una base de conocimiento lista para agentes. Invierten tiempo en diseñar el contexto y las fuentes desde las cuales los agentes reciben su información final conectada y estructurada.
CaaS conecta la base de conocimiento en bruto que los humanos han construido durante toda una vida (datos web) con la ejecución inteligente, ofreciendo capas de datos específicas por dominio; garantizando que los agentes no busquen información, sino que estén impulsados por un contexto enriquecido y verificado, adaptado para el razonamiento automatizado y la toma de decisiones.
Sin embargo, tiene un coste: estás alquilando constantemente el contexto diseñado por otros para potenciar tus agentes.
El coste oculto de alquilar contexto
Para entender los intercambios económicos de esta infraestructura, le pedimos a un agente de IA que enriqueciera 100 empresas con 25 campos de datos usando varios métodos de recuperación. Los campos incluían firmografías fáciles de obtener (sede, número de empleados, dominio) y otras más difíciles, como ingresos, finanzas, stack tecnológico, personas y señales de contratación.
La única variable que cambiaba era la herramienta de recuperación a la que tenía acceso la IA.
Harness shape
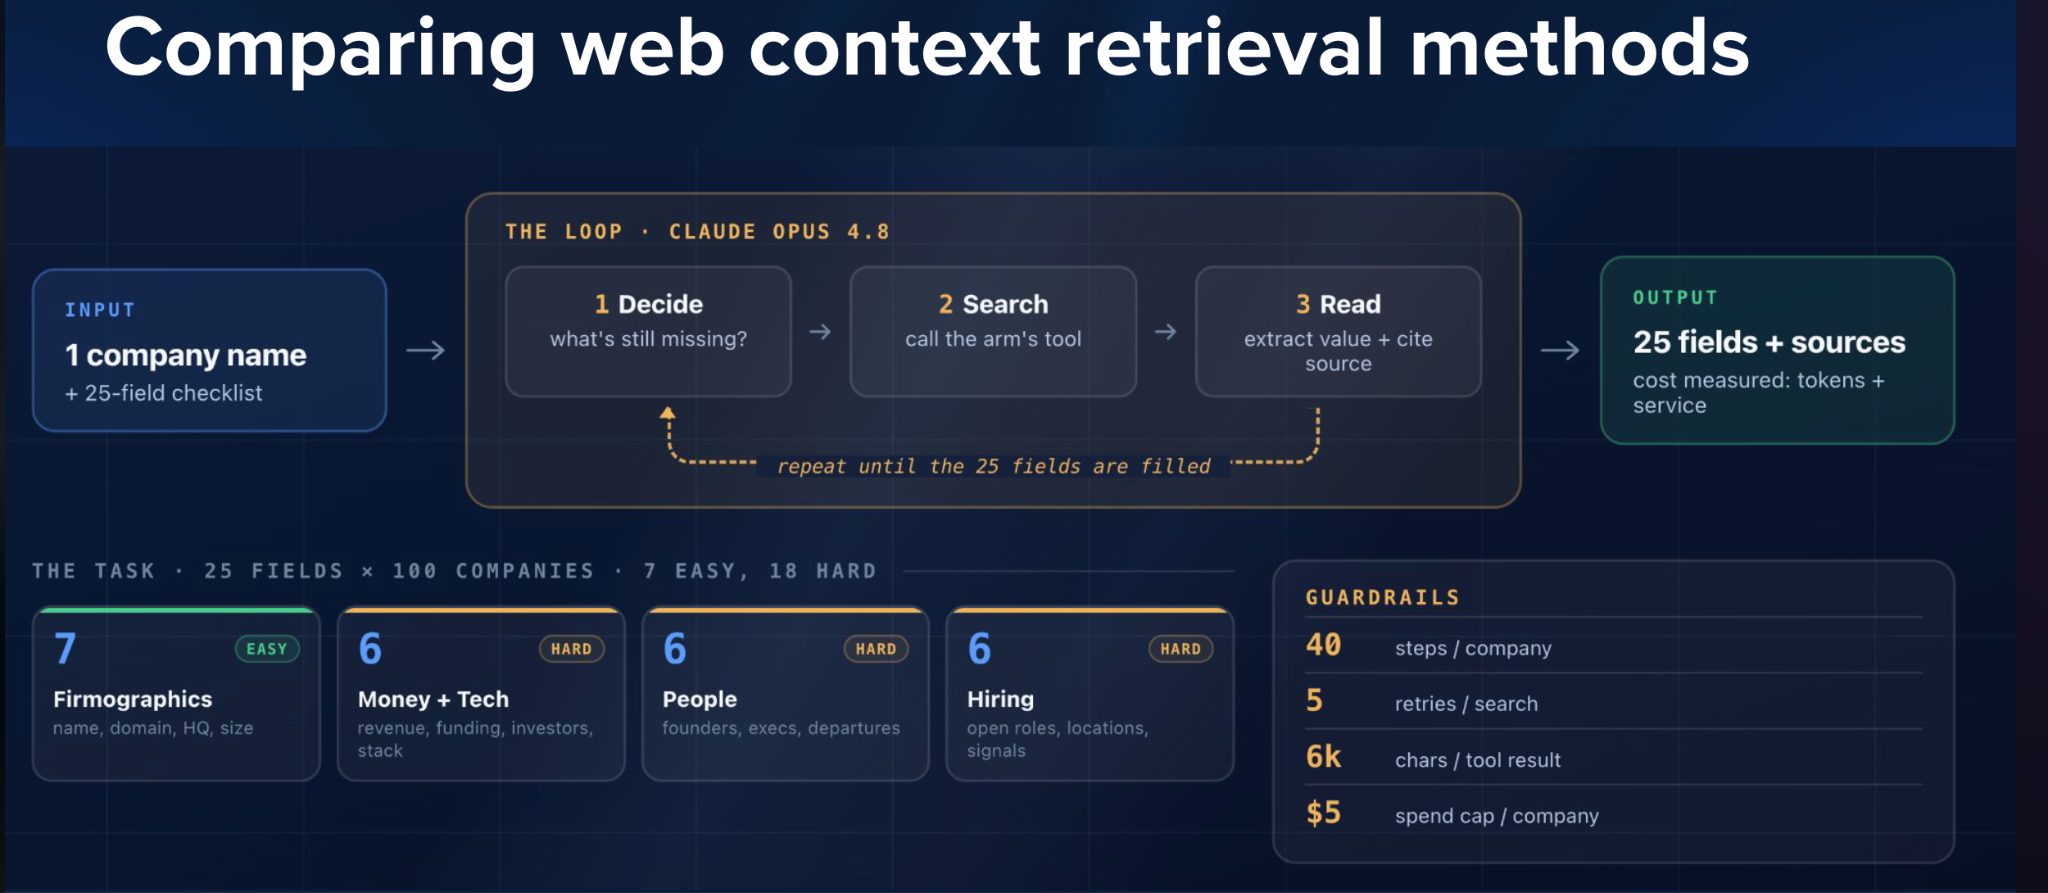
Métodos comparados
| Nombre público | Lo que representa |
|---|---|
| Search 1 / Search 2 / Search 3 | Herramientas de búsqueda de IA diseñadas para alimentar una ventana de contexto en lugar de una pestaña del navegador. |
| Native | Búsqueda nativa del modelo dentro del entorno del modelo. |
| CaaS 1 / CaaS 2 / CaaS 3 | Servicios de contexto y proveedores verticales. |
| Unlocker + SERP | Agente sobre infraestructura web en bruto: resultados de búsqueda más páginas desbloqueadas. |
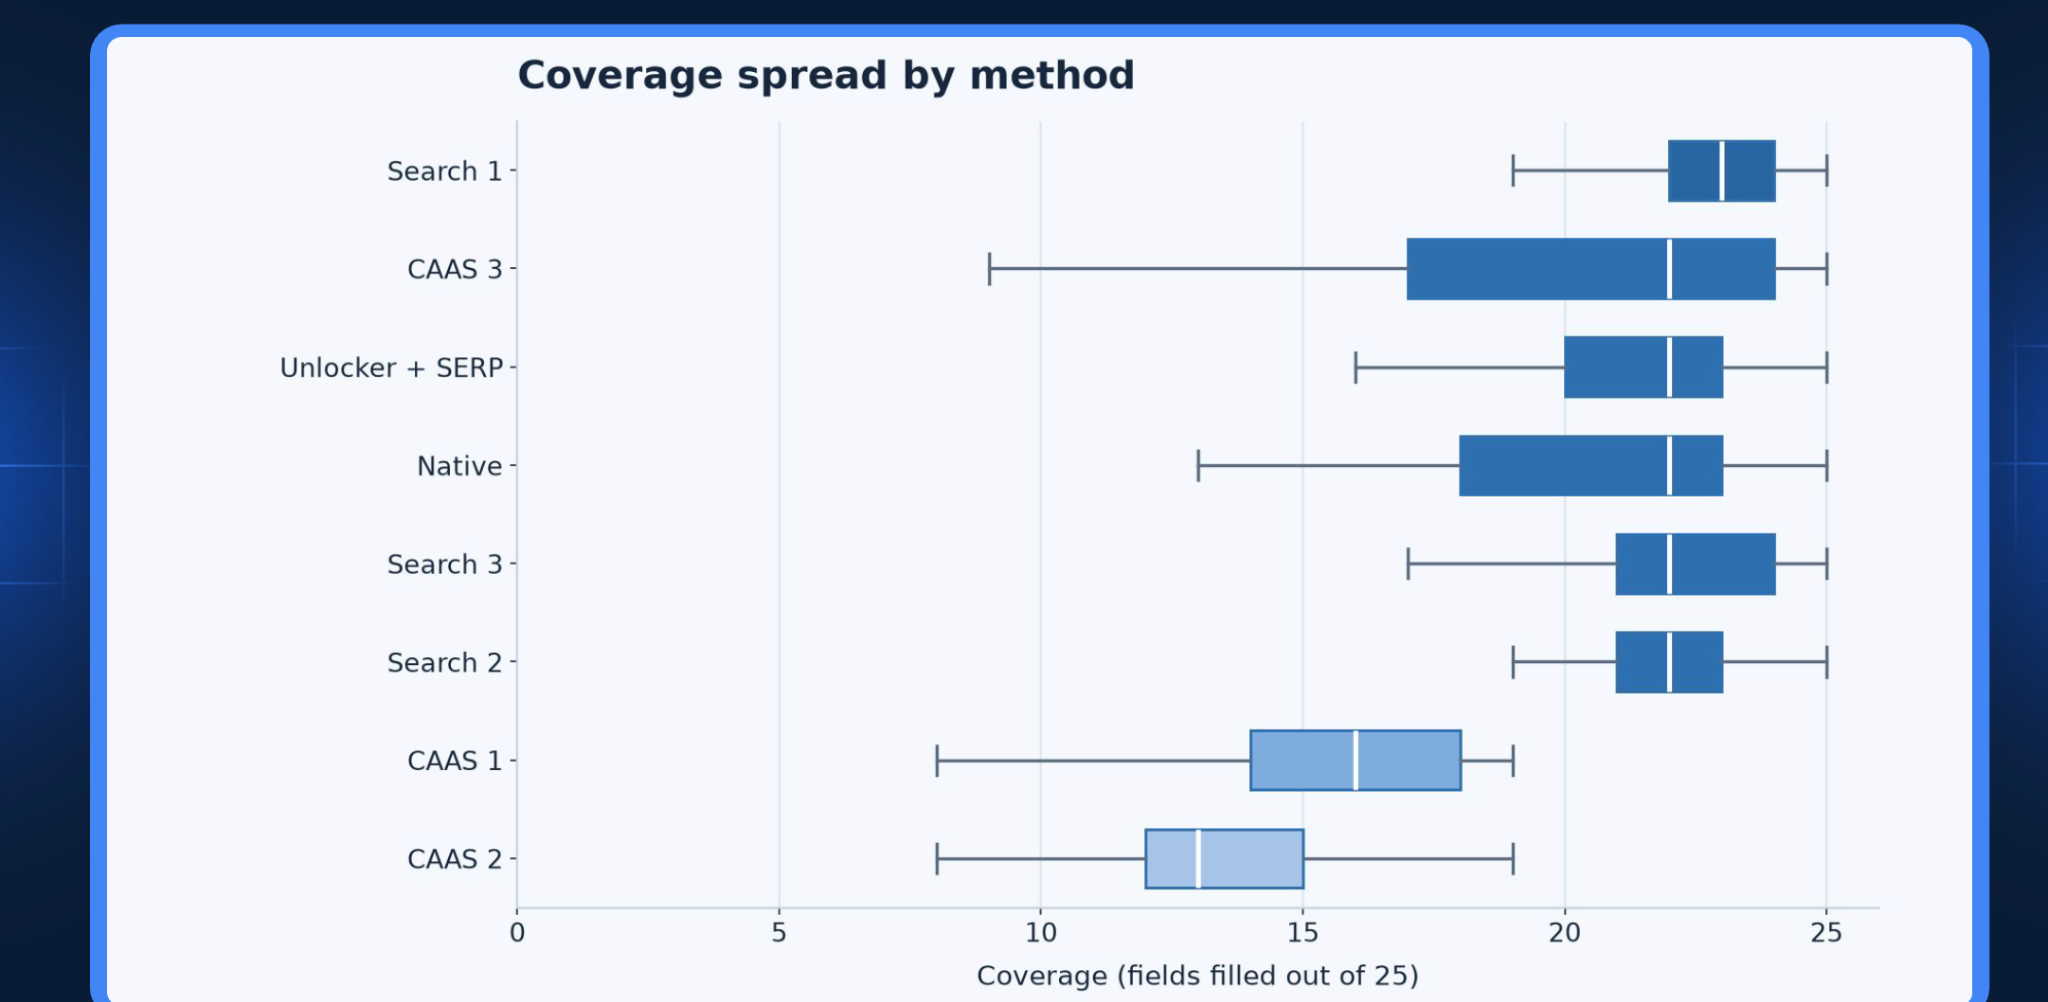
La cobertura es cuánto de los datos pudo completar cada método…
El coste se divide en dos partes: el precio del propio servicio y los tokens que la IA gasta en absorber y estructurar los datos.
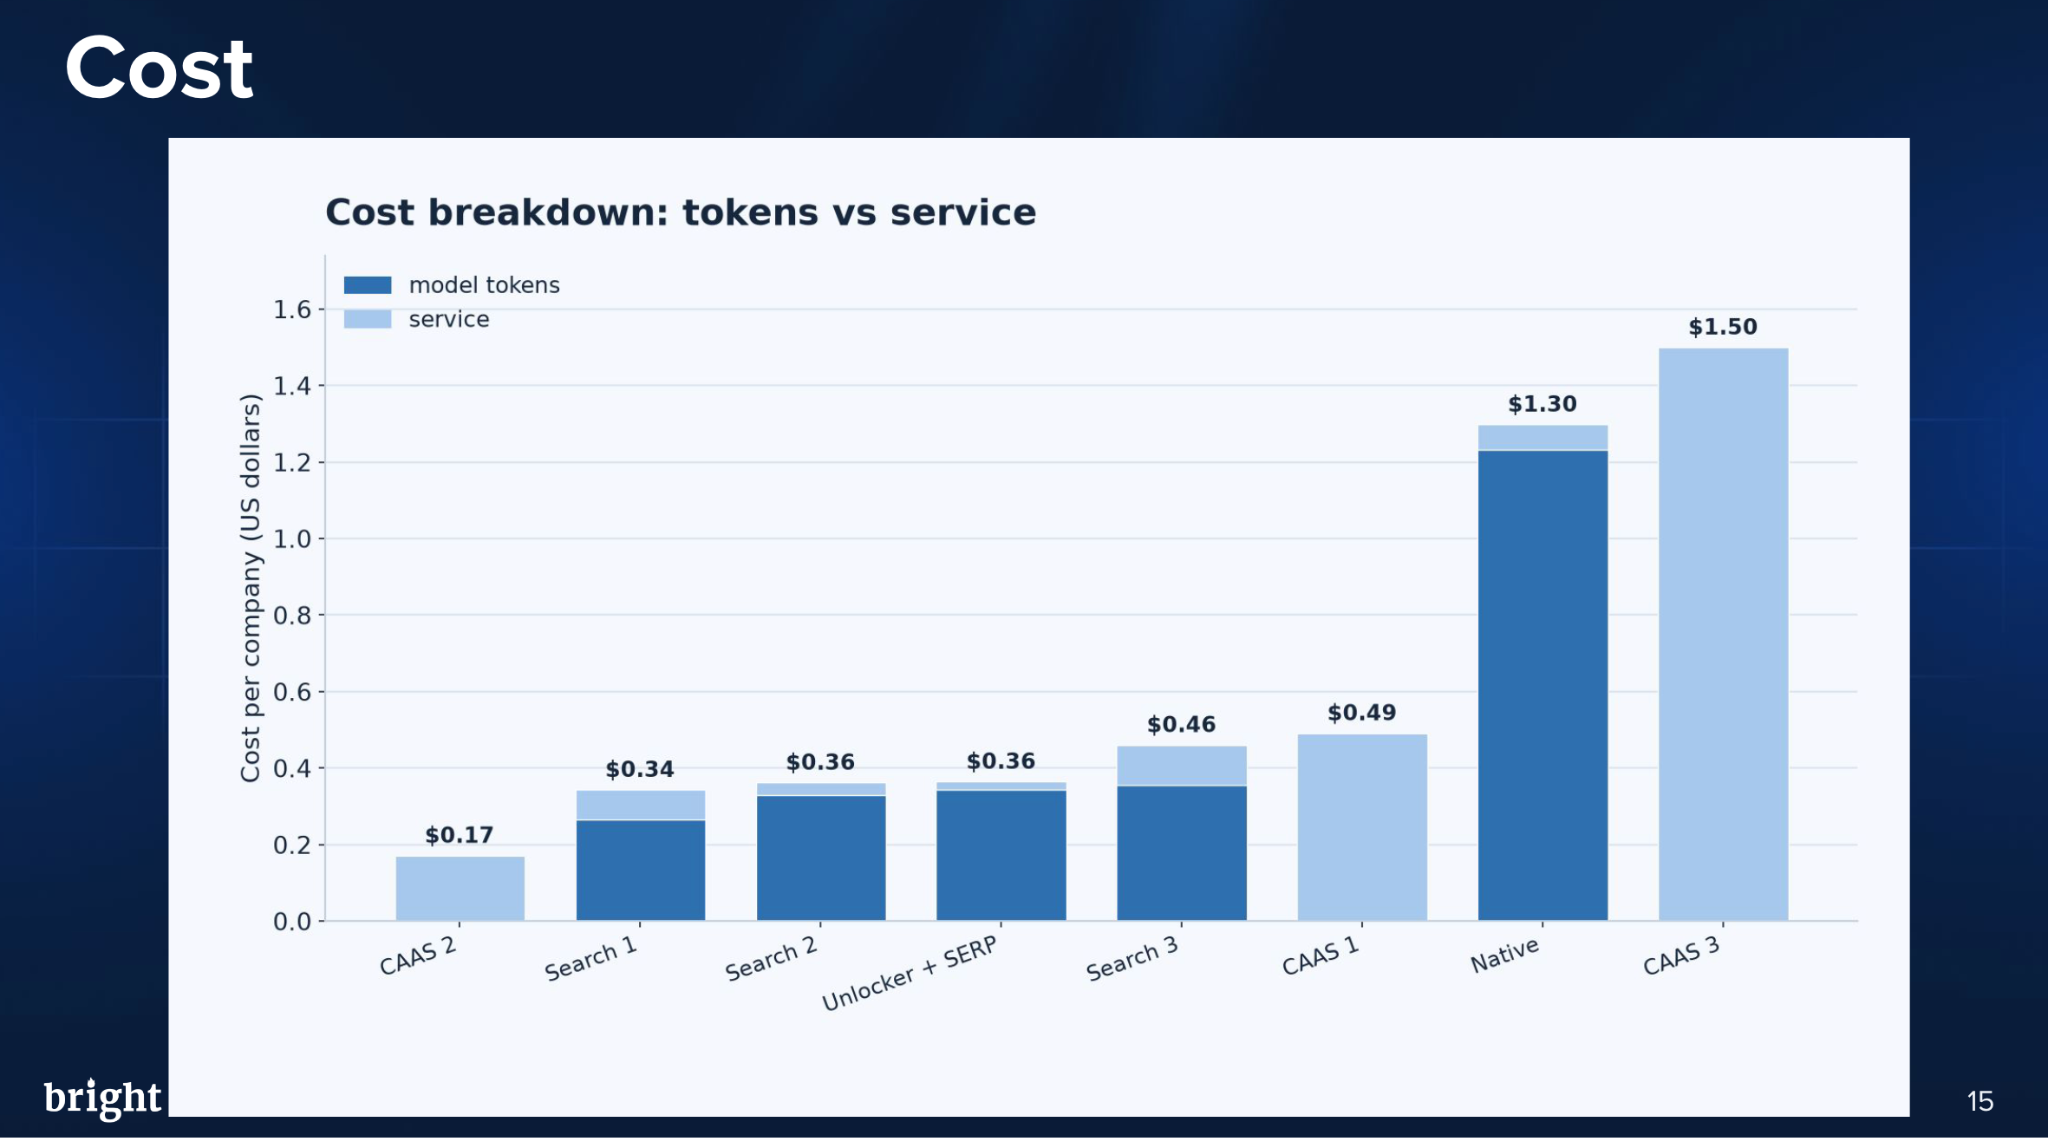
Las búsquedas y los CaaS son ideales para este caso de uso: cuando necesitas datos básicos rápidamente, exactamente como un coche de alquiler.
¿Pero escala esto?
Hay un patrón básico aquí: pagas cada vez que solicitas contexto. Tanto si pides 100 empresas, 1k, 100k o millones de empresas o datos, sigues «alquilando» tus datos.
- Cada entidad repetida cuesta lo mismo que la primera
- Ruido y falsos positivos que no puedes filtrar
- Los costes de tokens no se comprimen con el volumen
- Los equipos empiezan a recortar gastos para gestionar la factura
A escala, es bastante obvio que es mejor ser propietario del coche que alquilar uno cada día para ir al mismo sitio.
Entonces, ¿cómo lo posees? ¿Cómo te apropias de tu herramienta de búsqueda de IA o CaaS?
Ingeniería de contexto web
La ingeniería de contexto web consiste en arquitectar las diversas fuentes que tienes en un pipeline específico que puedas reutilizar y escalar, y traer la información de la mejor manera para la IA.
En lugar de pedirle a un agente que busque en la web en tiempo real para cada empresa, construimos un pipeline repetible respaldado por scrapers.
Utilizamos Scraper Studio de Bright Data, junto con algunos scrapers existentes de Bright Data, para recopilar las fuentes que sabíamos que importaban, y luego mapeamos esos registros en los mismos 25 campos.
El agente ya no hace todo el trabajo de recuperación en tiempo real. La capa de contexto hace más trabajo antes de que el modelo lo vea.
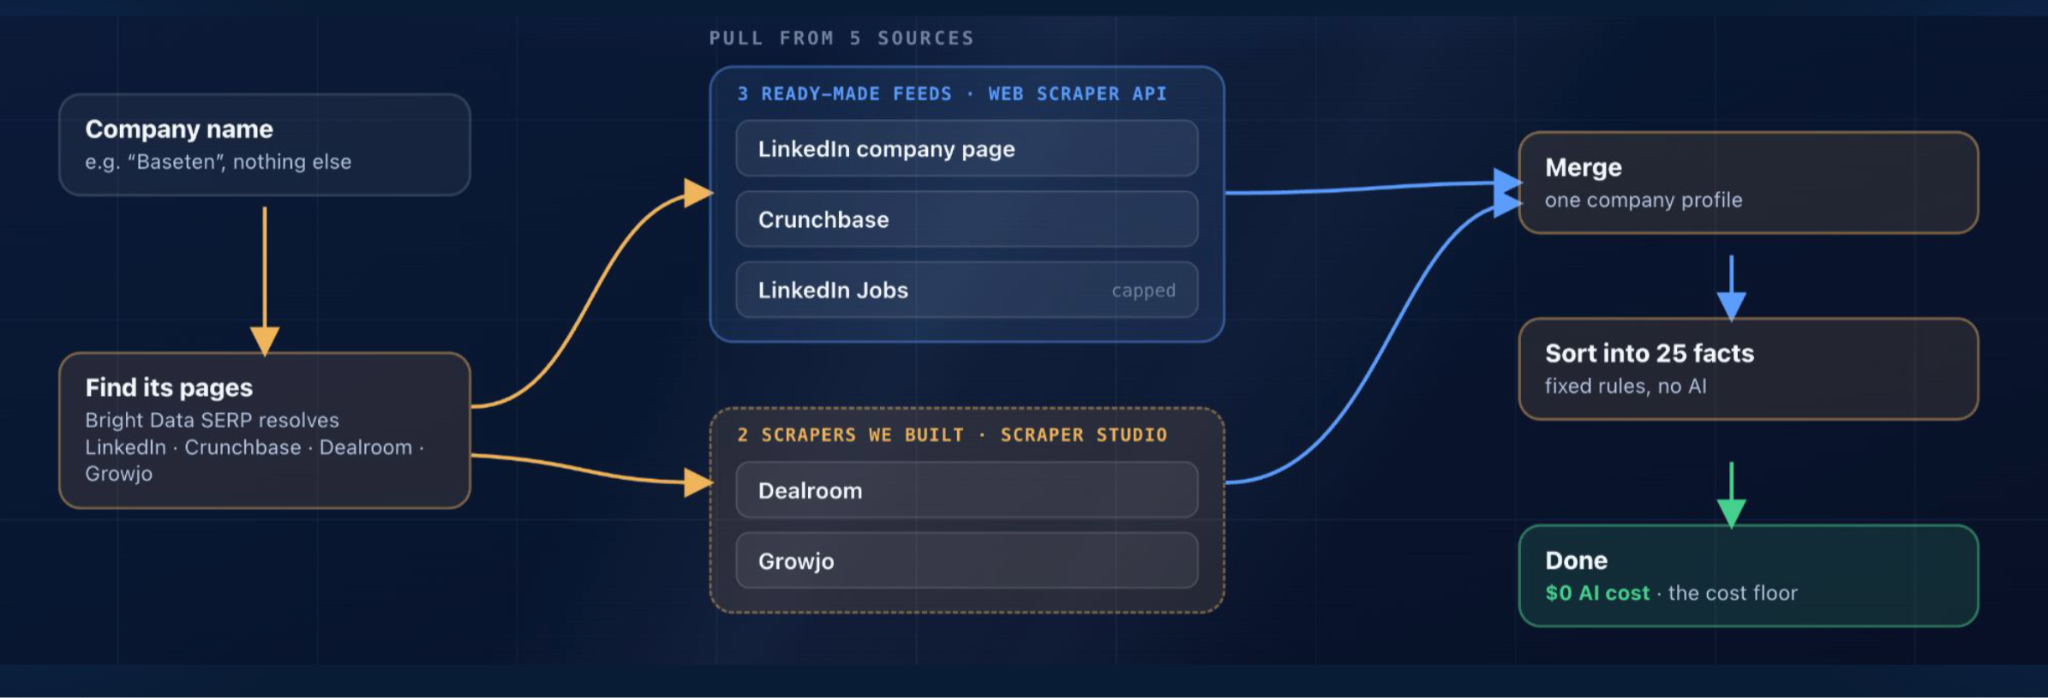
Figura: pipeline de contexto propio
Giro inesperado: el coste de configuración
Para hacer la comparación justa, también asignamos al pipeline propio un coste de configuración real.
Imagina que contraté a la persona más inteligente que conozco para construir este scraper y le pagué un exagerado precio de $5k para investigar y planificar qué fuentes usar, lo que en realidad llevó unas tres horas conversando con Claude.
Y llamamos a ese método DIY, que significa «Hazlo (o constrúyelo) tú mismo».
Después de eso, el número importante es el coste marginal cada vez que enriquecemos otra empresa.
La ventaja DIY: construir para escalar
La cobertura es aproximadamente la misma; aunque es ligeramente inferior, no hay una brecha significativa.
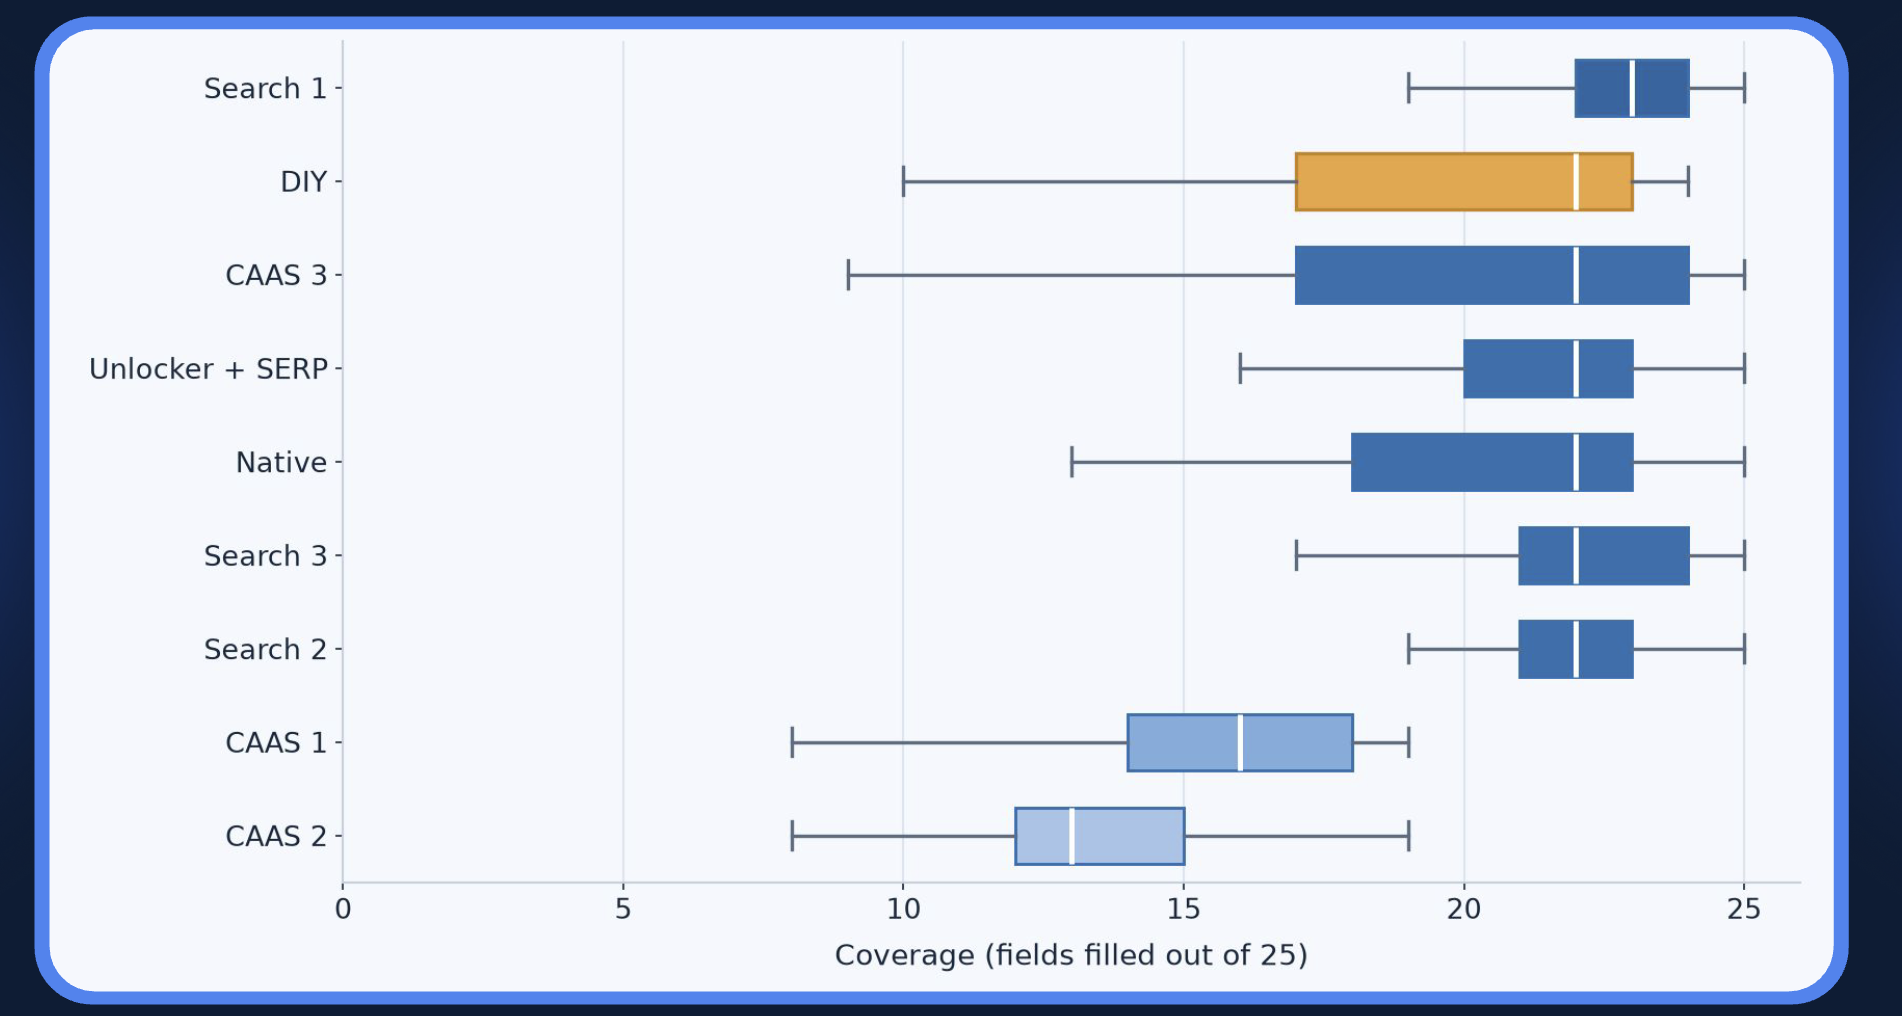
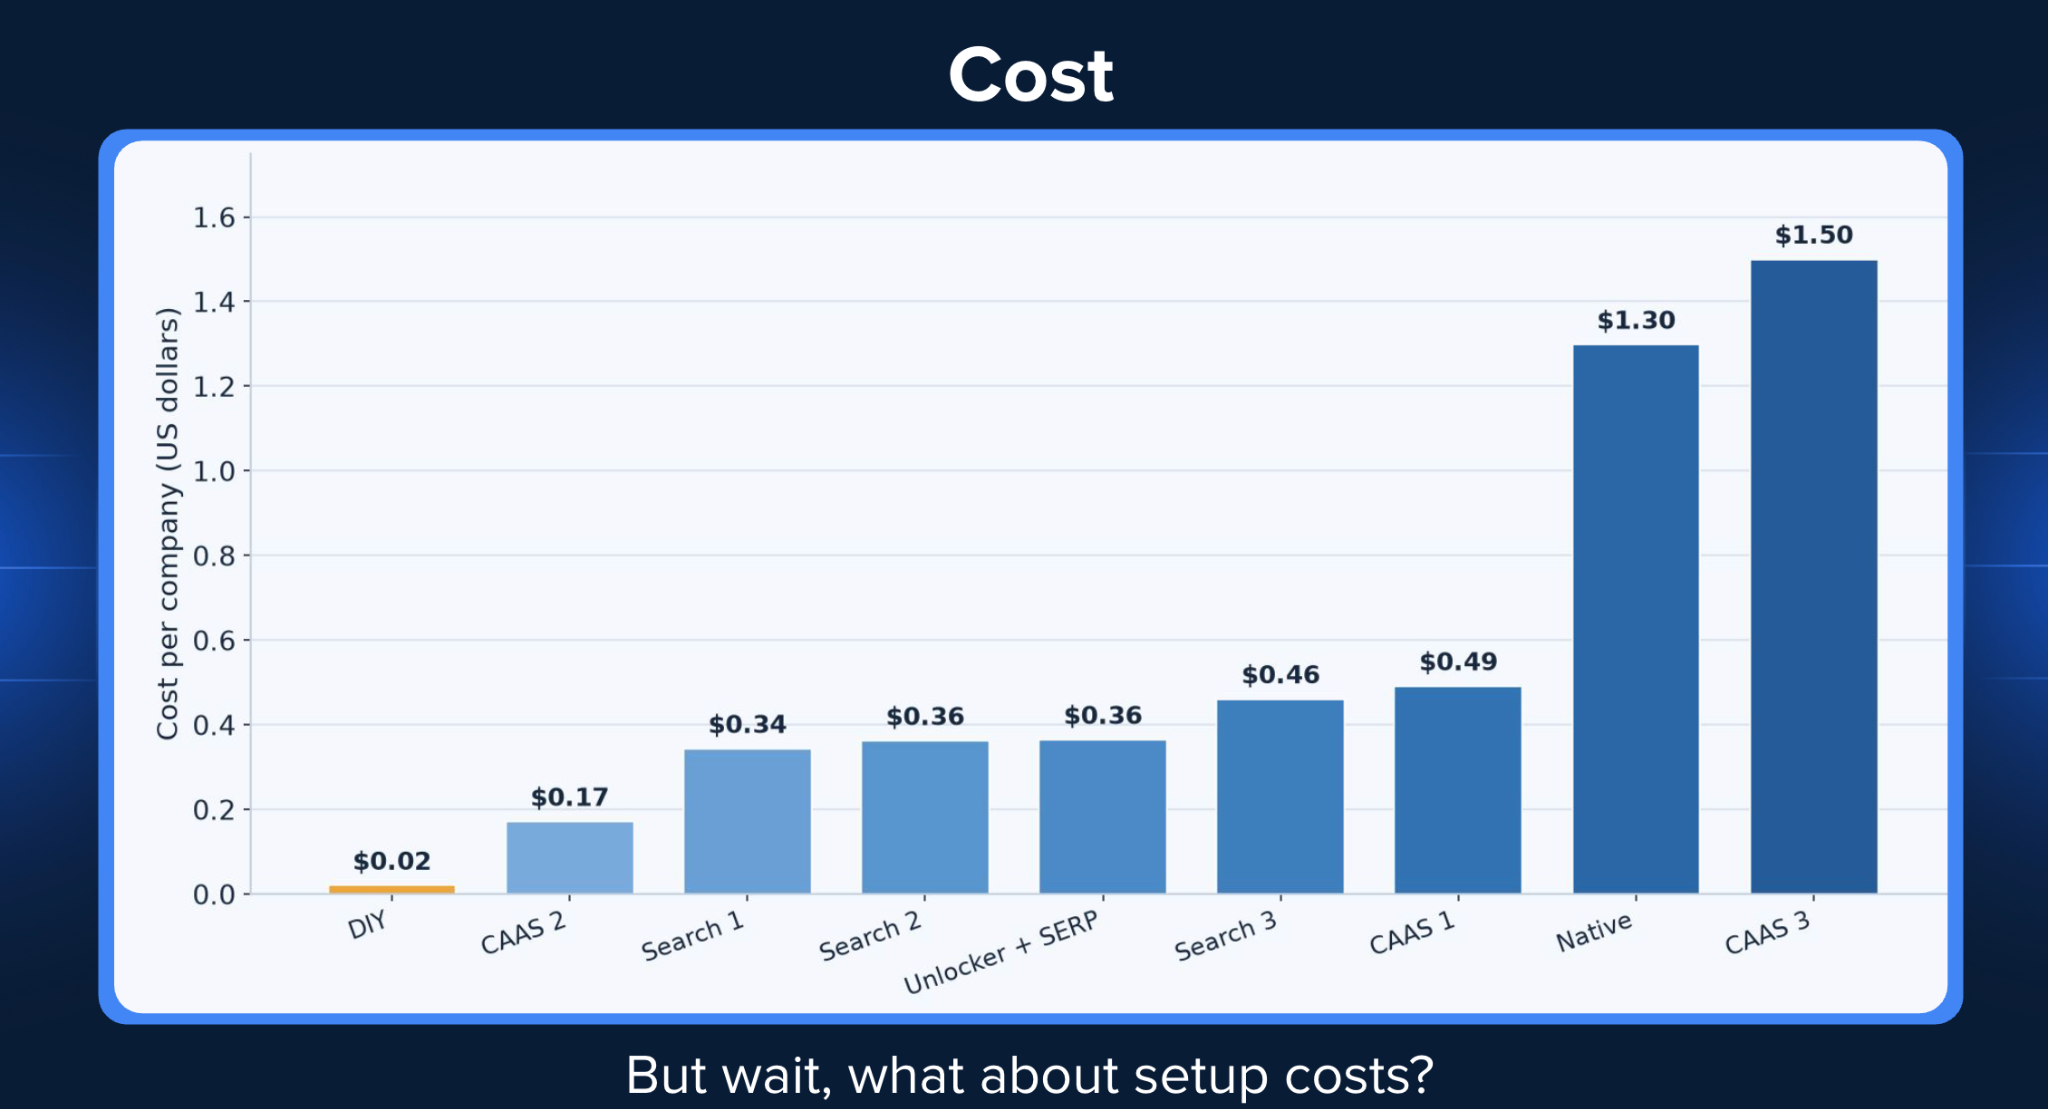
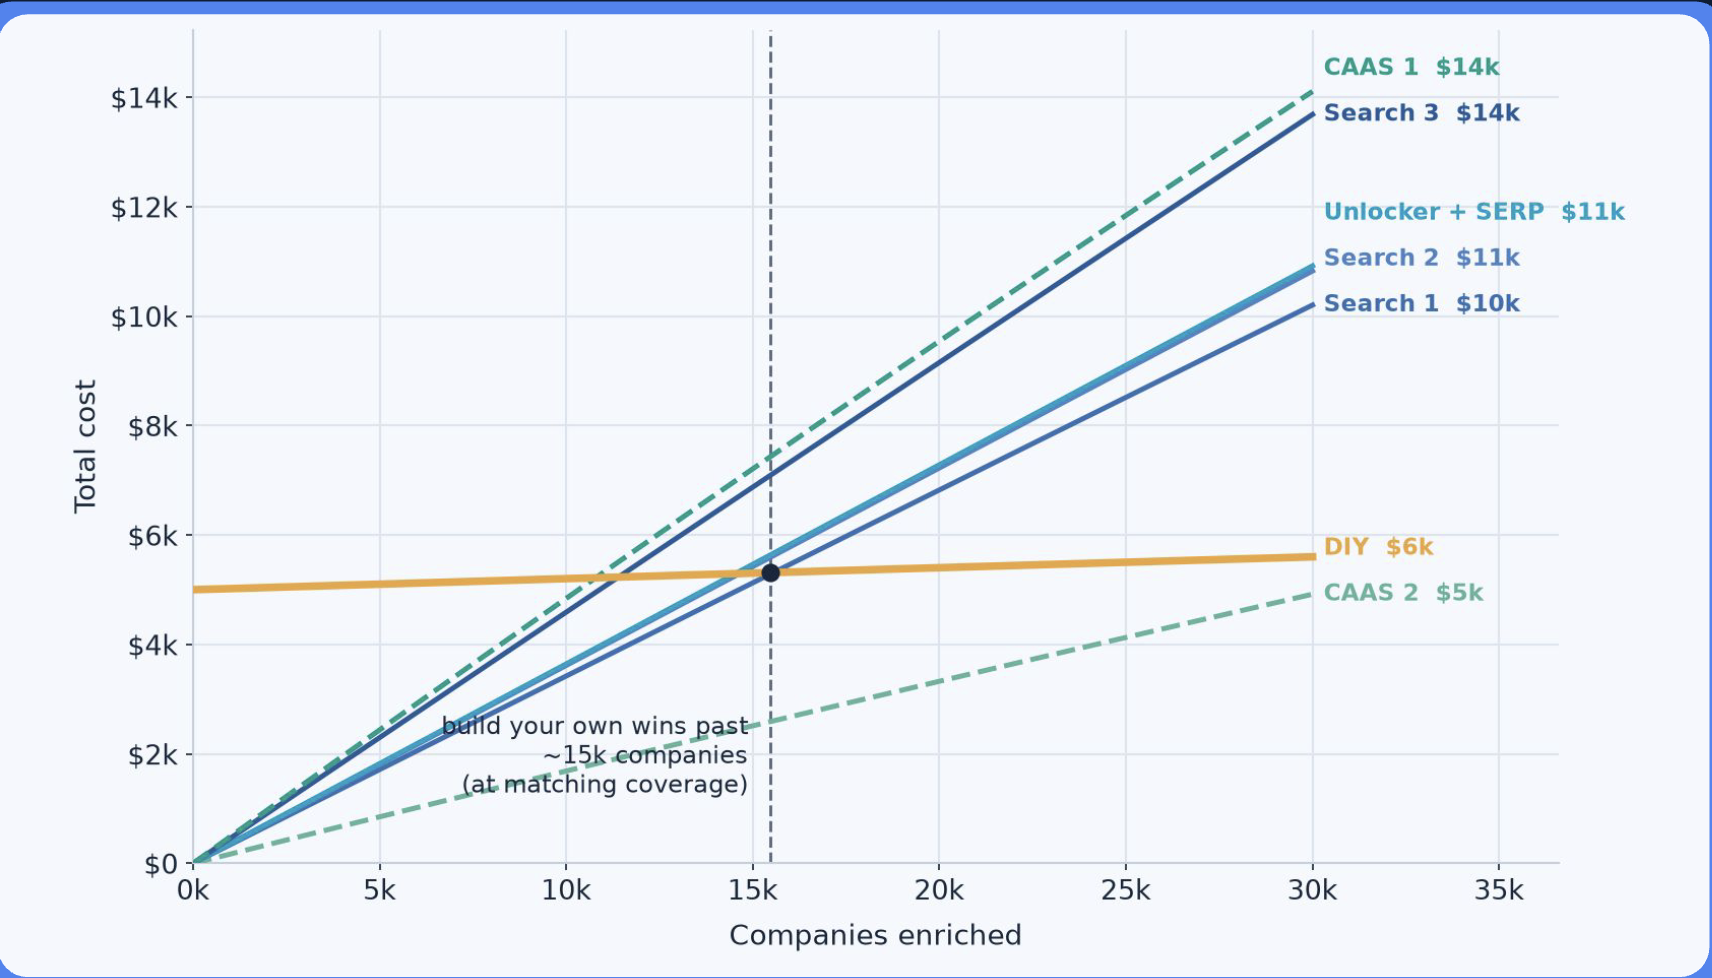
Figura: punto de inflexión entre construir y alquilar
A pequeña escala, alquilar puede seguir siendo la opción obvia. A mayor escala, el coste único de construcción se distribuye entre cada vez más enriquecimientos.
El punto de inflexión nos indica que más allá de cierta escala, tener tu propio pipeline se vuelve mucho más eficiente.
La economía de la ingeniería de contexto web
Como muestran los datos, el modelo de alquiler tiene un techo. A partir de cierto volumen, el coste de estos servicios supera la inversión inicial de construir tu propia infraestructura. Ampliemos la vista hacia una escala mayor…
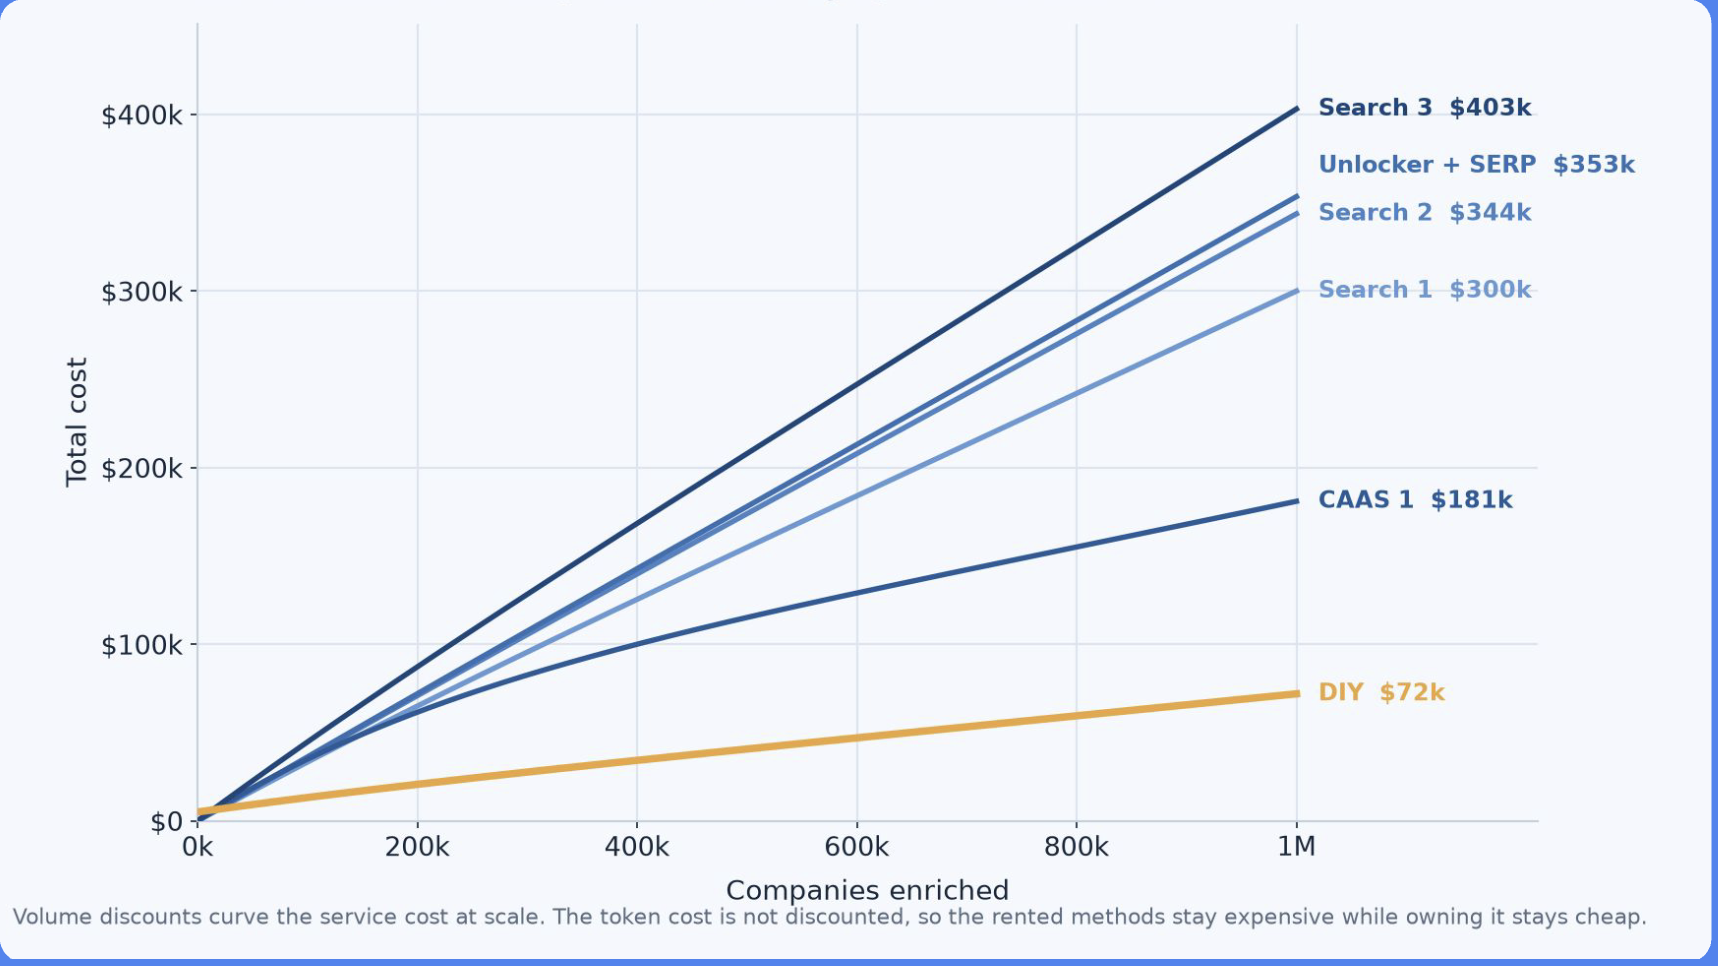
El caso está claro:
- Alquila cuando tus necesidades de conocimiento son pequeñas y diversas.
- Usa la búsqueda cuando la tarea es puntual y de alcance abierto.
- Usa CaaS cuando el dominio es recurrente y especializado, y quieres un contexto estructurado, verificado y listo para agentes.
Construye cuando el flujo de trabajo se repite, las mismas entidades reaparecen, la actualización importa y necesitas control sobre la lógica de negocio.
Ahí es donde la ingeniería de contexto web se convierte en una ventaja operativa real.
Y si eres un desarrollador, esta es también la oportunidad.
CaaS no es solo una categoría de proveedor. Es una señal de que los agentes necesitan una capa de contexto gobernada:
- Entidades controladas
- Esquemas controlados
- Reglas de actualización
- Verificación de fuentes
- Ontologías específicas por dominio
- Pipelines de contexto reutilizables
La era de los agentes convierte los datos web en infraestructura. Los ganadores son los equipos que pueden transformar datos web caóticos y en constante cambio en contexto confiable, estructurado y reutilizable.
¡Ve a construir el tuyo!