Tienes una URL de pin de Pinterest y quieres el título, la descripción y el número de guardados. No necesitas un navegador para extraerlo. Una página de pin sin sesión iniciada contiene los tres en un bloque JSON-LD, además del pinner y el enlace saliente. Los feeds RSS de perfil y tablero listan URLs de pines por HTTP simple.
Pero nada de eso llega a la búsqueda. Pinterest construye la cuadrícula de búsqueda en el navegador y pone un modal de inicio de sesión sobre ella para visitantes sin sesión. Los mosaicos que sí se renderizan no tienen títulos ni enlaces.
Esta guía explica cómo hacer correctamente scraping de Pinterest, y obtener todos los datos públicos que necesitas.
TL;DR
Un pin público se parsea por HTTP simple, mientras que la búsqueda por palabra clave y los rastreos completos de perfil necesitan una API gestionada.
- La barrera en la búsqueda lee el estado de la cuenta, no una puntuación de bot, así que un navegador sigiloso no cambia nada.
- Las guías antiguas fallan por dos razones:
pinWrapperno coincide con nada, y el registro no está en el store de Redux. - Una IP de centro de datos obtiene la página del pin sin su bloque JSON-LD, así que ejecuta desde una dirección residencial.
- Ambos métodos gratuitos sobre los tableros de una cuenta alcanzaron 435 pines únicos, de más de 9,000 almacenados allí.
Qué puedes extraer de Pinterest
Un registro de pin contiene título, descripción, URLs de imagen o video, hashtags, una categoría, un conteo de comentarios, y la URL del perfil del pinner. Los perfiles listan conteos de seguidores, nombres de tableros, y los pines que un usuario ha publicado.
La dificultad es el acceso, no el modelo de datos. Las directrices de desarrollador de Pinterest prohíben “cualquier medio automatizado o forma de scraping o extracción de datos para acceder a información de Pinterest”. El archivo robots es una lista blanca, no una lista negra: nombra cientos de crawlers uno por uno y le da a User-agent: * un Disallow: /. Cualquier cliente que no nombre no está permitido.
Así que recopila solo datos públicos, mantén las tasas de solicitud bajas, y no inicies sesión con una cuenta personal para automatizarlo. Los nombres de pinners y las URLs de perfil son datos personales bajo el GDPR, y las mismas directrices prohíben usar material de Pinterest para entrenar modelos de IA. Para cualquier cosa más allá de eso, consulta a un profesional.
Qué devuelve una página de pin a HTTP simple
Para una URL de pin que ya tienes, no necesitas un navegador. Una página de pin sin sesión incrusta un bloque JSON-LD SocialMediaPosting, y ese bloque es el registro.
Necesitas Python 3 y nada más para empezar: json, re y urllib son todos de la biblioteca estándar. El primer pip install viene después, cuando conviertas un perfil en feeds de tableros.
Parsea el bloque y obtienes los datos del pin en pocas líneas:
import json, re, urllib.request

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")
BOILERPLATE = "Discover (and save!) your own Pins"

def scrape_pin(url):
    req = urllib.request.Request(url, headers={"User-Agent": UA})
    resp = urllib.request.urlopen(req, timeout=30)
    html = resp.read().decode("utf-8", "ignore")
    block = re.search(
        r'<script[^>]*type="application/ld\+json"[^>]*>(.*?)</script>',
        html, re.S)
    if not block:            # pin eliminado: no hay bloque JSON-LD en la página
        return None
    data = json.loads(block.group(1))

    # Los pines de recetas usan name/description, el resto headline/articleBody
    description = data.get("articleBody") or data.get("description")
    if description and BOILERPLATE in description:
        description = None   # texto de relleno de Pinterest, no palabras propias del pin

    saves = next((s.get("userInteractionCount")
                  for s in data.get("interactionStatistic") or []), None)
    return {
        "schema": data.get("@type"),
        "title": data.get("headline") or data.get("name"),
        "description": description,
        "pinner": (data.get("author") or {}).get("name"),
        "image": data.get("image"),
        "date": data.get("datePublished"),
        "source_link": (data.get("sharedContent") or {}).get("url"),
        "saves": saves,
    }

if __name__ == "__main__":
    print(json.dumps(scrape_pin(
        "https://www.pinterest.com/pin/99360735523397542/"), indent=2))
Ejecútalo y un pin activo devuelve un registro completo:
{
  "schema": "SocialMediaPosting",
  "title": "12 Bombshell Hair Color Ideas To Try This Summer | Ecemella",
  "description": "A person with long, straight reddish-brown hair wearing a black leather jacket...",
  "pinner": "Sarah Komnick",
  "image": "https://i.pinimg.com/originals/0d/b9/56/0db956e2c07e1580514b1c19587b4152.jpg",
  "date": "2023-05-24T22:32:51.000Z",
  "source_link": "https://www.ecemella.com/summer-hair-color-ideas/",
  "saves": 196
}
Todo eso proviene de una sola solicitud.
El registro está en el bloque JSON-LD, no en el store de Redux de la página. Un segundo script, __PWS_INITIAL_PROPS__, establece initialReduxState.pins como un objeto vacío. Un scraper que lee el store no encuentra nada. Y un pin eliminado no tiene ningún bloque JSON-LD, así que scrape_pin devuelve None en lugar de un registro parcial.
Pinterest sirve más de un tipo JSON-LD, e ignorar schema rompe un scraper silenciosamente. En 105 pines, 100 devolvieron SocialMediaPosting y 5 devolvieron Recipe, y todos incluyeron un bloque JSON-LD.
Los 105 provinieron de dos fuentes: 90 de los feeds RSS de 10 cuentas, que no devolvieron ningún pin de video. Los otros 15 vinieron de una búsqueda por palabra clave a través del Scraper API, de los cuales 10 eran video. Los pines de video usan el mismo esquema SocialMediaPosting y se parsean sin error.
La división entre los dos esquemas es total en lugar de parcial, lo que facilita pasarla por alto. En la muestra de 90 pines del feed, los 85 posts sociales incluyeron headline, articleBody, datePublished, y sharedContent, y ninguna de las 5 recetas incluyó ninguno de ellos. Un pin de receta usa name y description en su lugar. Leer solo headline no devuelve nada para toda la categoría, y te deja sin fecha ni enlace saliente.
Los pines de video tienen un problema diferente. Su image JSON-LD es un fotograma fijo .jpg, y el bloque no contiene contentUrl, duration, ni embedUrl.
El video en sí es un manifiesto HLS, el formato de lista de reproducción HTTP Live Streaming, en v1.pinimg.com. Aparece en el HTML de la página en lugar del bloque estructurado, así que un pin de video se parsea correctamente y devuelve una miniatura. Los registros del Scraper API incluyen video_length y una URL de medio directamente, lo que identifica pines de video sin una segunda solicitud.
La mezcla depende de la cuenta, y puede invertirse. Muestreado por separado, el feed de una cuenta de comida devolvió 19 de 25 pines como Recipe. Un parseo solo de headline habría devuelto un título vacío para tres cuartas partes de ellos. Los pines de receta añaden recipeYield y aggregateRating si eso te resulta útil.
En los pines de receta, la description suele ser una cadena de relleno de Pinterest en lugar de algo que escribió el pinner. El código devuelve None en lugar de tratarlo como contenido.
Qué se rompe realmente a gran volumen
Pinterest pone Akamai delante de sus páginas de pin, pero nada en las respuestas sugiere que Bot Manager esté activo en ellas. Doce solicitudes rápidas enviadas con el User-Agent predeterminado de urllib devolvieron todas 200. Las respuestas establecieron solo csrftoken, _pinterest_sess, _auth, y _routing_id. Ninguna de las cookies de Akamai Bot Manager apareció, y no se sirvió ningún payload de sensor, así que no hubo ningún desafío TLS que resolver.
En seis identidades de cliente, el mismo pin sirvió su bloque JSON-LD cada vez. Esas incluyeron un User-Agent de Chrome, curl, Googlebot, y una cadena vacía. Así que el parseo no necesita un User-Agent falso.
Eso es cierto desde una dirección residencial. En cinco pines, una solicitud residencial incluyó el bloque JSON-LD cada vez y una solicitud de centro de datos nunca lo hizo. Ambas devolvieron la página correcta, el título correcto, y un número similar de scripts.
Pinterest declara la diferencia en la propia página, bajo el objeto context en __PWS_DATA__. is_hosting leía false en el lado residencial y true en el lado de hosting, con is_bot en false en ambos. Así que la prueba es reputación de red, no una puntuación de bot.
Ejecuta scrape_pin desde una VM en la nube y devolvió None en cada pin probado, sin nada en la página que explique por qué. Un cliente con fingerprinting no cambia la dirección desde la que ejecutas.
Tu elección de cliente HTTP importa más que todo esto una vez que pagas por tráfico. La urllib de la biblioteca estándar no envía encabezado Accept-Encoding, así que el servidor responde sin comprimir. El ejemplo stdlib descarga alrededor de 1.13 MB por pin.
La biblioteca requests negocia gzip por defecto y transfiere alrededor de 183 KB. Un navegador que ofrece Brotli obtiene alrededor de 124 KB. Esa es la misma página y los mismos datos, con una diferencia de 9x en bytes transferidos decidida por el cliente que elegiste.
Eso importa porque los proxies facturan los bytes transferidos. En 10,000 pines, el ejemplo stdlib mueve 11.3 GB, comparado con 1.83 GB para el mismo trabajo a través de requests. A la tarifa de lista residencial de $8/GB, eso es alrededor de $90 en lugar de $15. Usa la versión stdlib para aprender cómo funciona, luego cambia a requests o curl_cffi para cualquier cosa que realmente ejecutes.
La reputación de IP empeora con el volumen, no tu huella TLS. Así que rotar entre direcciones residenciales ayuda aquí, mientras que un cliente con fingerprinting mayormente no. Si luego encuentras una página de Pinterest que sí verifica el handshake, curl_cffi (documentación de la biblioteca) es el reemplazo estándar y deja el parseo intacto:
from curl_cffi import requests as cffi   # pip install curl_cffi

resp = cffi.get("https://www.pinterest.com/pin/99360735523397542/",
                impersonate="chrome", timeout=30)
html = resp.text                 # pasa esto al mismo parseo JSON-LD
Se aplican dos límites. No da acceso a los endpoints internos de Pinterest. PinResource devolvió 403 tanto a urllib simple como a un cliente que imita a Chrome, así que la huella no es el problema ahí. Y no puede responder un desafío de JavaScript si se sirve uno.
El endpoint oficial de oEmbed
Pinterest publica un endpoint oEmbed para pines públicos. Es la búsqueda de un solo pin más ligera aquí, y responde con JSON en lugar de una página de HTML. Esta llamada usa curl, que viene incluido con macOS, Linux y Windows 10 y posteriores. También puedes probarlo pegando la URL directamente en un navegador primero:
PIN="https://www.pinterest.com/pin/99360735523397542/"
curl "https://www.pinterest.com/oembed.json?url=$PIN"
Responde con atribución, una miniatura, y un embed ya preparado:
{"version":"1.0","type":"rich","provider_name":"Pinterest","title":" ",
 "author_name":"Sarah Komnick",
 "author_url":"https://www.pinterest.com/sarahkomnick/",
 "thumbnail_url":"https://i.pinimg.com/236x/0d/b9/56/0db956e2c07e1580514b1c19587b4152.jpg",
 "thumbnail_width":236,"thumbnail_height":314,
 "html":"<iframe src=\"https://assets.pinterest.com/ext/embed.html?id=99360735523397542\" ...></iframe>"}
De las rutas que ejecutas tú mismo, esta tiene la menor exposición. oEmbed es el formato estándar que los sitios publican para que terceros puedan incrustar su contenido. Es una interfaz publicada, no una API interna.
También acepta URLs de tableros y perfiles, no solo pines. Devolvió un título real para ambos, donde la llamada del pin lo dejaba vacío. Una descripción, un conteo de guardados, y un enlace de fuente saliente no están en la respuesta.
Pinterest devuelve 404 suaves para sus páginas de pin. Un pin eliminado, un ID numérico inexistente, y un slug mal formado devolvieron todos HTTP 200. Lo mismo ocurrió con un ID truncado y un ID numérico no usado, todos con el bloque JSON-LD ausente. Cualquier verificación basada en response.status no mide nada.
El endpoint oEmbed responde HTTP 400 en su lugar. Lo hizo en los 5 de esos casos, mientras que un pin activo devolvió 200.
Transfiere una mediana de 583 bytes en 19 pines, comparado con alrededor de 124 KB para la página. Eso lo convierte en la forma económica de filtrar una lista de URLs antes de parsear cualquier cosa. 80 llamadas consecutivas sin demora devolvieron todas 200, sin limitación de tasa y sin cambio en la latencia.
Descubre URLs de pines sin la cuadrícula de búsqueda
Tanto el parseo JSON-LD como oEmbed necesitan una URL de pin que ya tengas. Entonces, ¿de dónde vienen las URLs?
Una ruta parece obvia y no lo es. El archivo robots de Pinterest declaró 50 URLs de Sitemap: bajo /v3_sitemaps/ cuando se verificó. Los nombres describen exactamente lo que un recopilador querría: image_pin_sitemap_recent_engagement_tier_1, video_product_pin_sitemap, varios niveles de sitemap de enlaces de tablero. Las 50 devolvieron HTTP 404.
Un sitemap declarado vale una solicitud antes de confiar en él.
Para un perfil o un tablero, las URLs provienen de RSS. Pinterest todavía publica feeds sin autenticación en /<usuario>/feed.rss y /<usuario>/<slug-tablero>.rss:
import re, urllib.request
import xml.etree.ElementTree as ET

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")

def list_pins(feed_url):
    req = urllib.request.Request(feed_url, headers={"User-Agent": UA})
    xml = urllib.request.urlopen(req, timeout=30).read()
    pins = []
    for item in ET.fromstring(xml).findall(".//item"):
        desc = item.findtext("description") or ""
        thumb = re.search(r'src="([^"]+)"', desc)
        pins.append({
            "url": item.findtext("link"),
            "published": item.findtext("pubDate"),
            "thumbnail": thumb.group(1) if thumb else None,
        })
    return pins

if __name__ == "__main__":
    feed = list_pins("https://www.pinterest.com/boredpanda/animals.rss")
    print(f"found {len(feed)} pins")
    print(feed[0])
Un feed de tablero devolvió una lista utilizable de URLs de pines reales:
found 26 pins
{'url': 'https://www.pinterest.com/pin/150307706316766946/',
 'published': 'Thu, 23 Jul 2026 12:14:04 GMT',
 'thumbnail': 'https://i.pinimg.com/236x/18/a4/8b/18a48b04fbe868130b0a2ad14759fe87.jpg'}
Abre una de esas URLs de feed en un navegador y la estructura es fácil de leer. Cada <item> contiene el enlace del pin, una fecha de publicación, y una miniatura en la descripción:
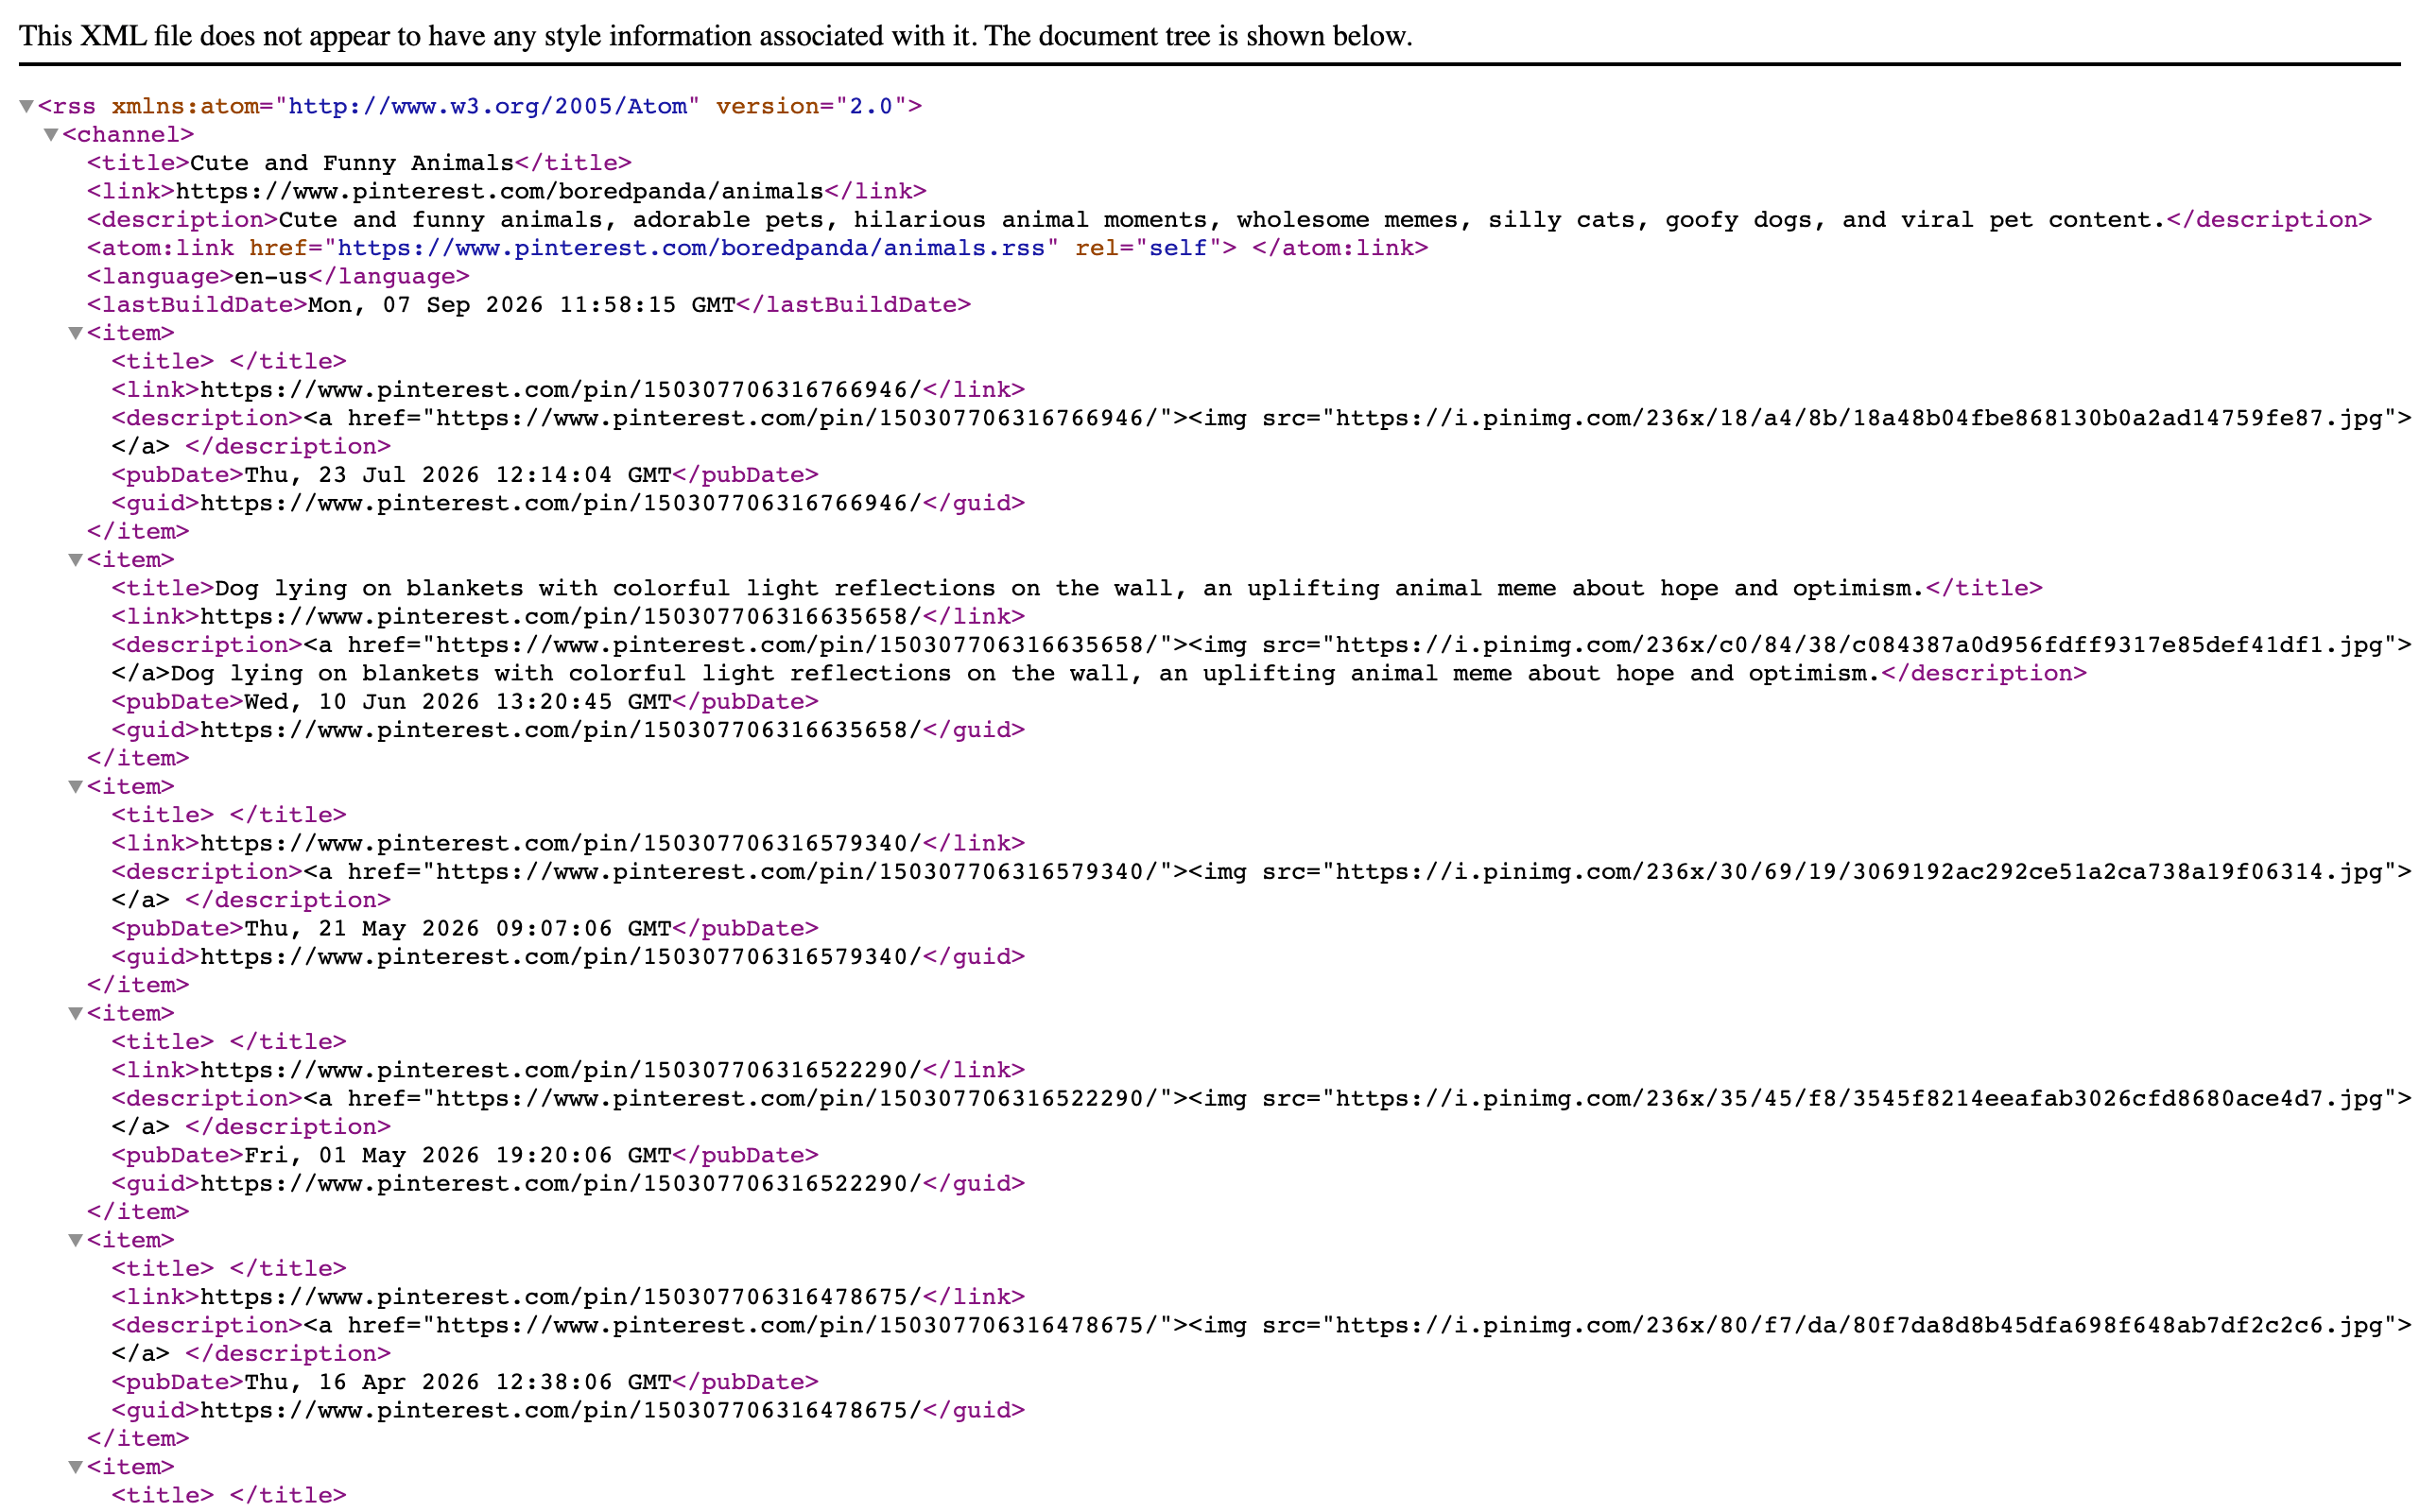
Las etiquetas <title> vacías son la razón por la que el feed es una fuente de URLs en lugar de metadatos. Un ítem en este feed tiene un título real; el resto están en blanco.
Encadenar eso con el parseo por pin te da una canalización completa que nunca carga un navegador. Guarda scrape_pin y list_pins juntos como pinterest.py, y esto los importa sin cambios:
import time, json
import xml.etree.ElementTree as ET
from pinterest import scrape_pin, list_pins   # desde pinterest.py

def collect_feed(feed_url, delay=0.5):
    records = []
    try:
        pins = list_pins(feed_url)
    except (OSError, ET.ParseError) as err:   # omite un feed defectuoso, continúa
        print(f"skipped feed {feed_url}: {err}")
        return records
    for pin in pins:
        time.sleep(delay)         # antes de la solicitud, para que los omitidos sean educados también
        try:
            record = scrape_pin(pin["url"])
        except (OSError, ValueError) as err:  # transitorio: mantén lo que tienes
            print(f"skipped {pin['url']}: {err}")
            continue
        if record is None:        # pin eliminado: la página devuelve 200 en un 404 suave
            continue
        record["url"] = pin["url"]
        record["feed_published"] = pin["published"]
        records.append(record)
    return records

rows = collect_feed("https://www.pinterest.com/foodnetwork/feed.rss")
print(f"{len(rows)} pins enriched")
with open("feed-pins.json", "w") as f:
    json.dump(rows, f, indent=2)
En una cuenta de comida imprimió 25 pins enriched en 46 segundos. Los 25 tenían título, y la mezcla de esquemas fue 19 recetas a 6 posts sociales. Los feeds estuvieron disponibles en las 12 cuentas probadas, desde creadores individuales hasta grandes marcas. Los feeds de perfil devolvieron de 22 a 25 ítems y los de tablero de 23 a 26.
El feed tiene un límite fijo en lugar de crecer con el tablero. Un tablero que reporta cerca de 6,000 pines devolvió 24 ítems, lo mismo que un tablero con 39. Por debajo de ese límite obtienes casi todo lo que hay: un tablero con 6 pines devolvió 5.
Convierte un perfil en un conjunto de feeds de tablero
Una cuenta tiene más de un feed, y la página de perfil los lista públicamente, con nombres y conteos de pines y sin necesidad de inicio de sesión:
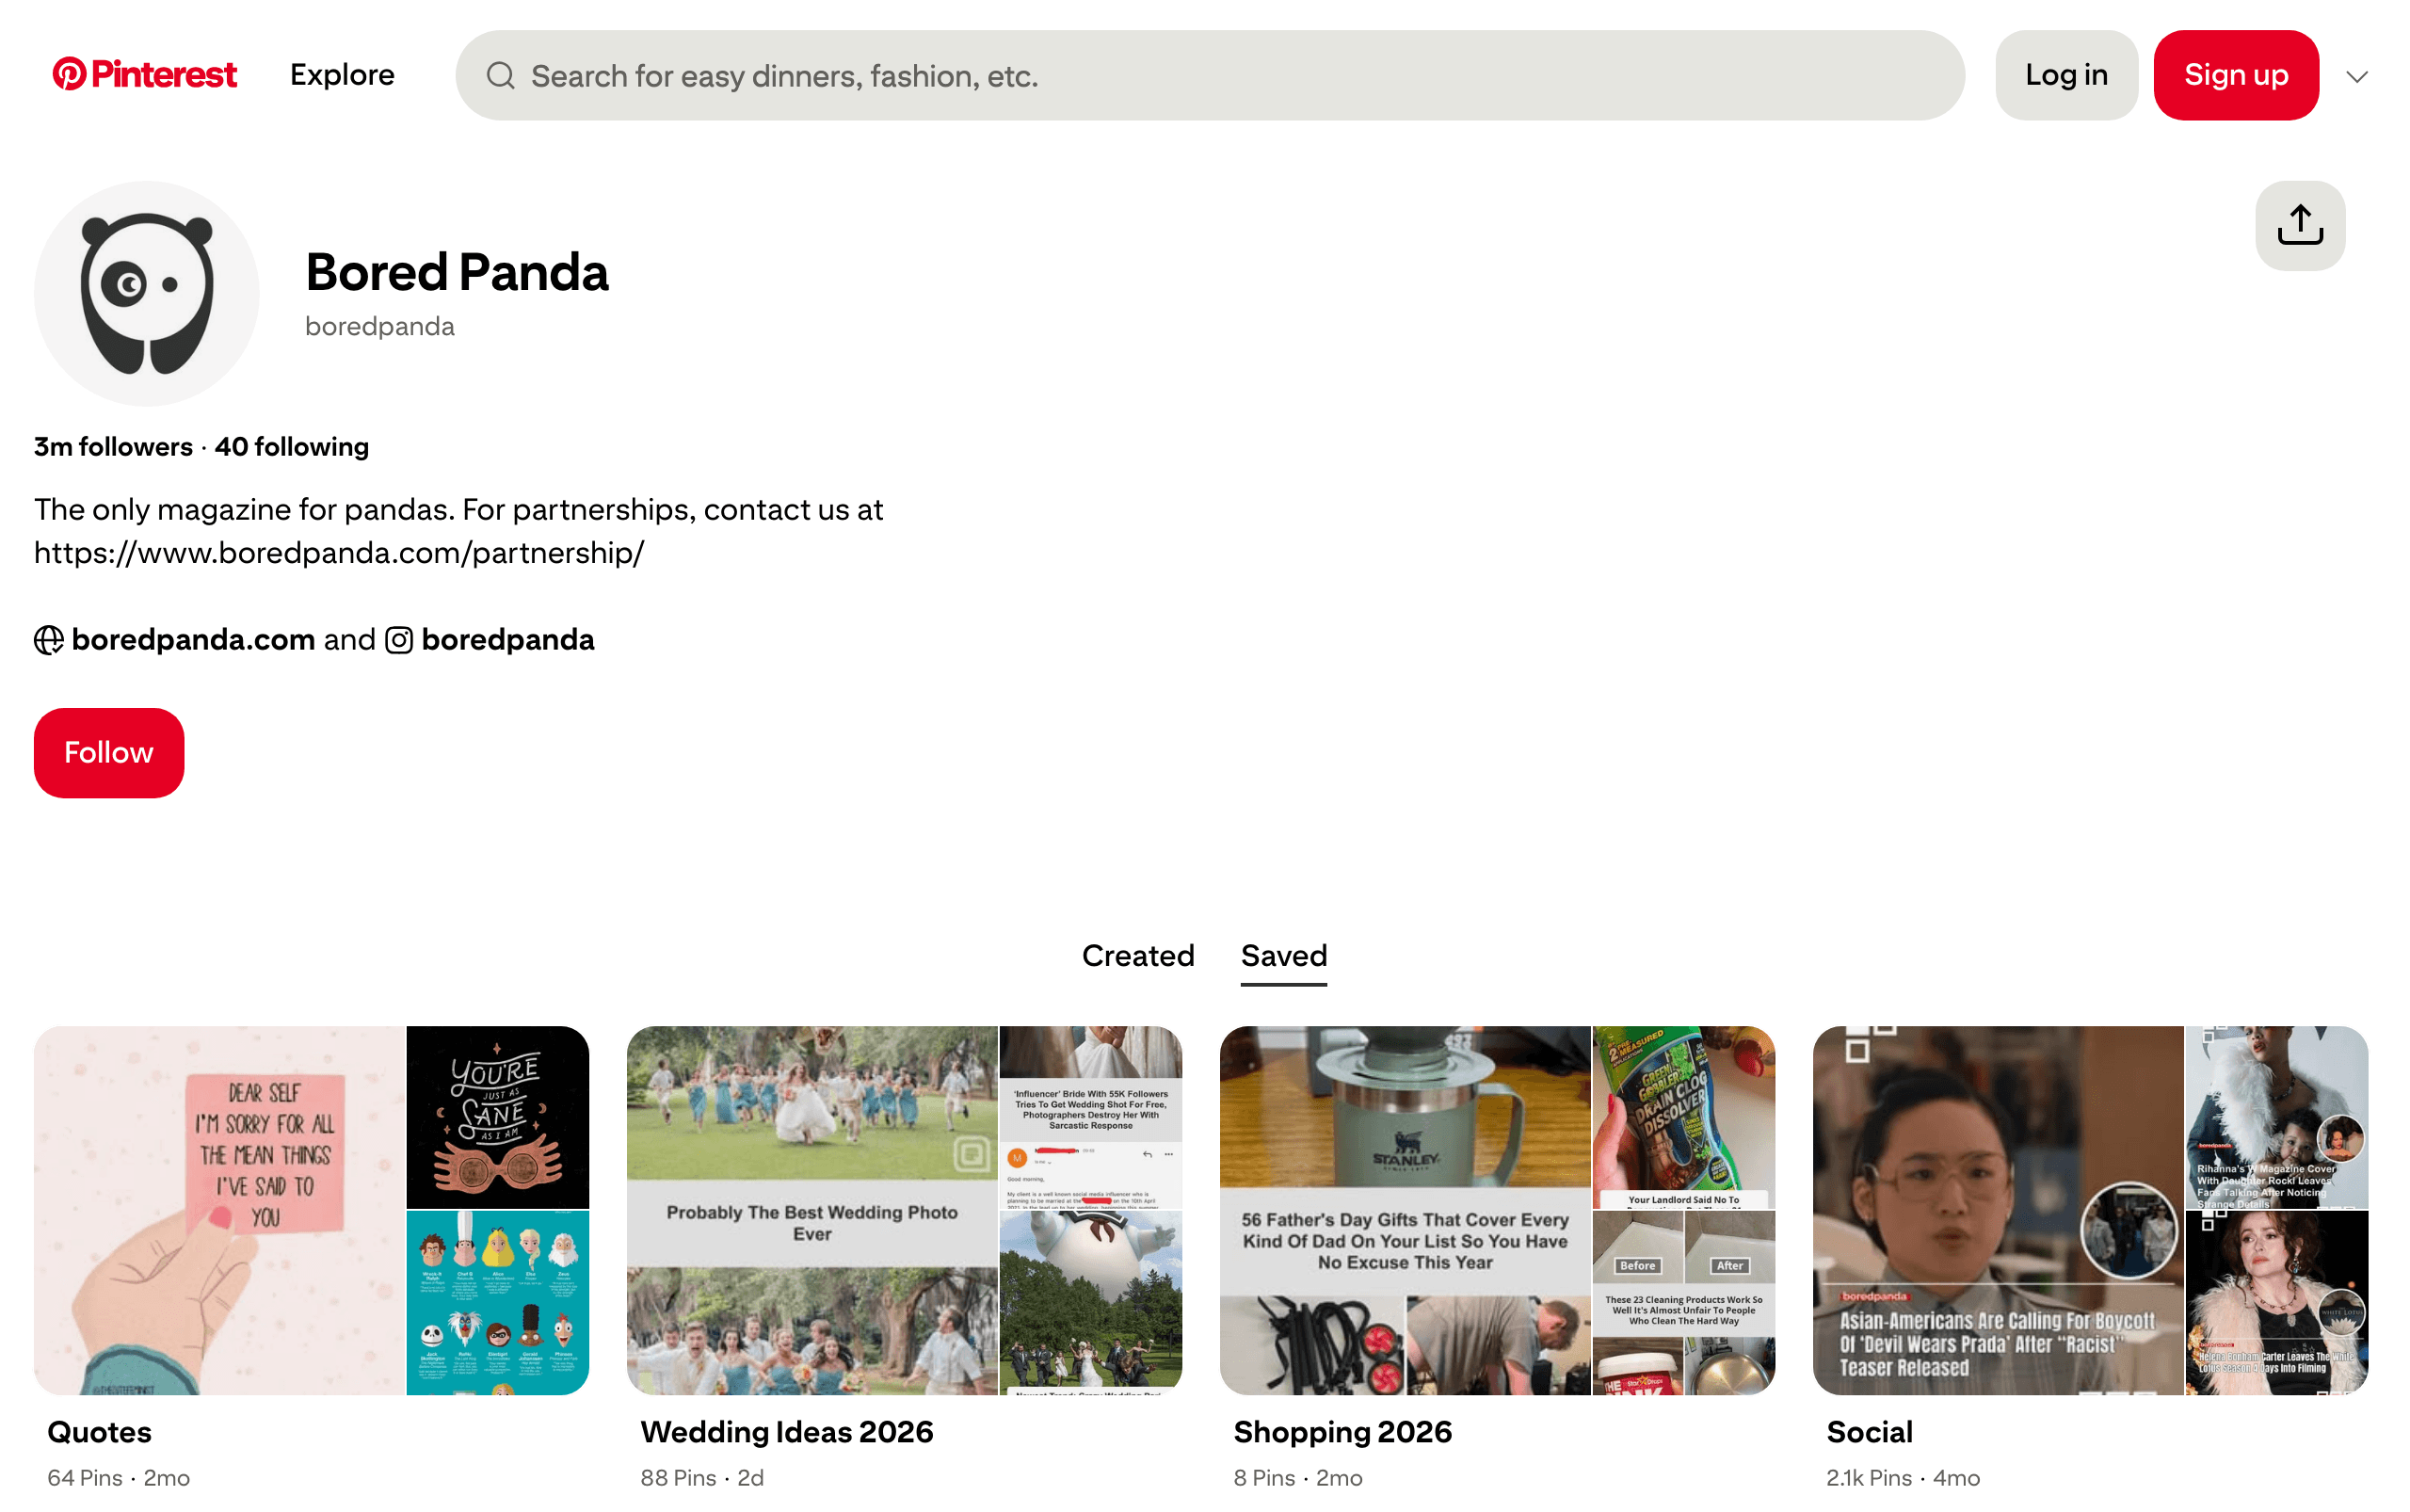
La búsqueda obtiene un modal de inicio de sesión; un perfil no. Estos nombres de tablero son los slugs que list_boards lee del HTML de la página. Los conteos de pines te dicen qué tableros alcanzarán el límite del feed y cuáles son lo suficientemente pequeños para que devuelva la mayoría de ellos.
Los slugs de tablero generalmente aparecen en el HTML del perfil por HTTP simple, así que una expresión regular convierte un nombre de cuenta en un conjunto de URLs de feed:
import re, requests            # pip install requests

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")
RESERVED = {"pins", "boards", "followers", "following"}   # rutas, no tableros

def list_boards(handle):
    html = requests.get(f"https://www.pinterest.com/{handle}/",
                        headers={"User-Agent": UA}, timeout=30).text
    found = re.findall(rf'"/{handle}/([A-Za-z0-9][A-Za-z0-9_-]*)/"', html)
    slugs = set(found) - RESERVED
    base = f"https://www.pinterest.com/{handle}"
    return [f"{base}/{s}.rss" for s in sorted(slugs)]

feeds = list_boards("boredpanda")
print(f"{len(feeds)} board feeds")
print(feeds[0])
Una cuenta devolvió nueve feeds de tablero:
9 board feeds
https://www.pinterest.com/boredpanda/animal-memes.rss
Junto con la lista de tableros, el HTML del perfil sin sesión incrusta un bloque JSON-LD ProfilePage. Se parseó en las 8 cuentas probadas.
Da el nombre de visualización, el handle, la biografía, la URL del avatar, y la fecha de creación de la cuenta. Un array sameAs apunta a otros perfiles del propietario, que en estas cuentas significaba Instagram y su propio dominio. Seis de las 8 también incluyeron un conteo de seguidores bajo interactionStatistic, el de Etsy leyendo más de 11 millones. Ese es el mismo parseo que la página del pin, dirigido a una URL diferente.
Ejecutar los 9 feeds de tablero a través de list_pins devolvió 208 URLs de pines únicas de boredpanda, comparado con los 25 que da un solo feed. Ningún pin apareció en dos feeds de tablero. Todas las cuentas probadas listaron sus tableros de esta forma: 10 de 10, entre 8 y 10 slugs cada una. El feed del primer tablero devolvió ítems en las 10.
Esos 9 son los tableros que muestra la página de perfil, no el conjunto completo de la cuenta. El registro de perfil de la API reporta 51 para la misma cuenta. El HTTP simple alcanza 9 de esos 51, cada uno a través del mismo límite de 25 ítems.
El feed animals usado antes es uno que se pierde, así que un tablero que ya conoces sigue valiendo la pena solicitarlo directamente. Un perfil activo también puede devolver ningún slug en absoluto. Trata una lista vacía como una señal para verificar el handle, no como prueba de que la cuenta no tiene tableros.
Los títulos de feed estaban vacíos en todos excepto un ítem en los feeds probados. Deja que el parseo por pin suministre el resto.
Dos rutas más allá del límite del feed
El scraper de perfiles en el Scraper API alcanza la lista de tableros desde la otra dirección. boards_num reportó 51 tableros para boredpanda, así que conoces el tamaño del conjunto antes de empezar.
Cada entrada en su array saved incluye un saved_collection_url, y esa URL más .rss devolvió un feed en los 6 tableros probados. El array en sí devolvió 10 de esos 51, otra lista parcial.
Elimina la barra final antes de agregar. saved_collection_url termina con una, y Pinterest trata las dos formas resultantes de manera muy diferente. Terminar en quotes.rss devuelve un feed de 13 KB.
Terminar en quotes/.rss devuelve HTTP 200 y la aplicación HTML en su lugar. Eso falla dentro de tu parser XML con un error de token inválido apuntando a una línea de JavaScript. Construye la URL con saved_collection_url.rstrip("/") + ".rss" y esa forma no puede llegar al parser.
El backend de widgets más antiguo en widgets.pinterest.com/v3/pidgets/ también responde a solicitudes sin autenticar, y en la mayoría de los tableros devolvió más que RSS. Su endpoint de tablero devolvió 50 pines donde el feed del mismo tablero devolvió 26, cada uno con una descripción. También reporta un pin_count a nivel de tablero, así que tienes una idea de lo que te estás perdiendo.
Cincuenta es un límite en lugar de un tamaño de página. page, offset, limit, count y page_size fueron todos ignorados, cada uno devolviendo los mismos 50. En nueve tableros de boredpanda, el backend de widgets alcanzó 362 pines únicos, comparado con 208 de los feeds de tablero. Los dos juntos alcanzaron 435, de más de 9,000 almacenados en esos tableros.
Tres cosas antes de confiar en ello. Su repin_count no es el conteo de guardados del JSON-LD. Leídos juntos en el pin usado a lo largo de esta guía, devolvió 77 donde el JSON-LD devolvió 196. Solo la cifra del JSON-LD es la que Pinterest etiqueta como Saves.
Los enlaces salientes varían según el tablero: 50 de 50 pines en uno, 5 de 43 en otro. Las descripciones llegaron en casi todos los pines. Y no siempre es mejor: en un tablero pequeño RSS devolvió 9 frente a sus 8. El endpoint no está documentado, no tiene búsqueda, y no tiene promesa de compatibilidad.
Más allá de ese pin cincuenta, o con un horario, el rastreo de perfil en el Scraper API se ejecuta en toda la cuenta como un trabajo en segundo plano. Devuelve un registro estructurado por cada pin que encuentra.
El descubrimiento en el Scraper API funciona a nivel de perfil, así que pasa la URL del perfil y filtra los registros al tablero que quieres. En dos tableros probados, una URL de tablero devolvió el perfil en lugar del tablero nombrado en la solicitud.
Por qué los métodos gratuitos se detienen en la búsqueda
Obtén una página de resultados de búsqueda y el HTML tiene cero bloques JSON-LD. La cuadrícula se construye mediante solicitudes posteriores del navegador, y esas están bloqueadas para sesiones sin iniciar sesión. A partir de septiembre de 2026, el bloque __PWS_DATA__ lista diez experimentos lop_unauth_lockdown_*, entre ellos _main, _closeup y _search.
Dos de los diez nombran las rutas que usa esta guía: lop_unauth_lockdown_profile y lop_unauth_lockdown_board. El bloqueo sin sesión es un experimento en curso, no una parte permanente del sitio. Así que trata el acceso a perfiles y tableros como algo que vigilar en lugar de asumir.
El mismo bloque muestra qué verifica la barrera, porque Pinterest registra su propia visión de tu cliente en él. Bajo context, las páginas de pin, búsqueda y perfil incluyen los mismos 15 campos de clasificación. Esos incluyen is_bot, is_proxy, is_vpn, is_tor, is_hosting, is_unauth_botspam_asn y is_authenticated.
Solicitado desde una dirección residencial ordinaria, is_bot devolvió "false" y cada bandera de proxy y hosting devolvió false. La cuadrícula de búsqueda estaba bloqueada de todos modos. Los experimentos de bloqueo leen el estado sin sesión, no una puntuación de bot.
is_hosting separó las solicitudes que devolvieron el JSON-LD de un pin de las que llegaron sin él. Así que lee context desde la etiqueta <script id="__PWS_DATA__"> en una sola página de pin. Esa es la forma más económica de confirmar que la dirección desde la que recopilas se ve como esperas. Hazlo antes de desperdiciar una ejecución culpando a tu parser por un conteo bajo de registros.
No está documentado y es interno, no una promesa que hace Pinterest, así que trátalo como una verificación que repites. El objeto también contiene un unauth_id y el país y región de tu IP. Enmascara eso antes de que los datos salgan de tu máquina.
Esa verificación es el parseo JSON-LD dirigido a la otra etiqueta de script:
import json, re, urllib.request

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")
FLAGS = ("is_bot", "is_proxy", "is_vpn", "is_tor", "is_hosting",
         "is_unauth_botspam_asn", "is_authenticated")

def how_pinterest_sees_you(url):
    req = urllib.request.Request(url, headers={"User-Agent": UA})
    resp = urllib.request.urlopen(req, timeout=30)
    html = resp.read().decode("utf-8", "ignore")
    block = re.search(
        r'<script id="__PWS_DATA__" type="application/json">(.*?)</script>',
        html, re.S)
    if not block:
        return None
    ctx = json.loads(block.group(1)).get("context") or {}
    # este objeto también contiene unauth_id y la geolocalización de tu IP: no devuelvas eso
    return {k: ctx.get(k) for k in FLAGS}

print(how_pinterest_sees_you(
    "https://www.pinterest.com/pin/99360735523397542/"))
Ejecútalo desde una conexión doméstica y desde una VM en la nube y un campo se mueve:
# residencial
{'is_bot': 'false', 'is_proxy': False, 'is_vpn': False, 'is_tor': False,
 'is_hosting': False, 'is_unauth_botspam_asn': False, 'is_authenticated': False}

# mismo pin, mismo parseo, rango de hosting
{'is_bot': 'false', 'is_proxy': False, 'is_vpn': False, 'is_tor': False,
 'is_hosting': True, 'is_unauth_botspam_asn': False, 'is_authenticated': False}
is_bot llega como la cadena "false" mientras que las otras banderas son booleanos reales, así que compáralo como una cadena. is_hosting es el campo que se mueve, y decide si la página del pin incluye un bloque JSON-LD.
Los endpoints JSON internos que las guías antiguas llamaban están cerrados como clase, no uno a la vez. PinResource, BoardFeedResource, UserResource, BaseSearchResource y RelatedModulesResource devolvieron todos HTTP 403 a solicitudes sin autenticar. Eso fue cierto con o sin una huella TLS que coincida con un navegador real.
Las solicitudes pasan a través de Akamai como CDN. La misma verificación de cookies en páginas de búsqueda y perfil no mostró marcadores de Bot Manager ahí tampoco.
Por qué la API oficial de Pinterest no es una herramienta de scraping
Pinterest sí ejecuta una API REST, y es tentador probarla primero. No recopilará contenido público a ninguna escala útil, y la razón es el alcance, no la calidad.
La API v5 está construida para gestionar tu propia cuenta: tus tableros, tus pines, tus anuncios, tus analíticas. La categoría org_read se aplica a “Obtener cuentas de usuario, tableros, secciones de tableros, o Pines” para la cuenta autenticada. Aparte de la beta de búsqueda para partners, ningún endpoint devuelve un pin público que no sea tuyo.
La única búsqueda por palabra clave es GET /v5/search/partner/pins, una beta “no disponible para todas las aplicaciones” que devuelve los 10 pines principales. Los datos que la mayoría de los proyectos de scraping quieren, los pines y perfiles públicos de otras personas, no son alcanzables a través de la API.
Esa misma página también publica los límites de tasa. A partir de septiembre de 2026, el acceso de prueba permitía 1,000 solicitudes por día en todos los endpoints. El acceso estándar permitía 100 solicitudes por segundo por usuario por aplicación. Pinterest señala ahí que todos están “sujetos a cambios sin previo aviso”.
Para datos públicos de terceros a gran escala, la API oficial es la herramienta equivocada. Así que la recopilación más allá de las rutas de HTTP simple necesita automatización de navegador o un scraper gestionado.
Haz scraping de Pinterest con Playwright
La búsqueda es la única ruta que necesita un navegador para renderizar la página, y Playwright maneja uno desde Python. Si no lo has usado antes, el blog de Bright Data tiene un recorrido más largo de Playwright cuya API funciona de la misma manera.
Conoce lo que devuelve esta ruta antes de instalarla: URLs de imagen y nada más, sin títulos, sin descripciones y sin enlaces de pin. Si eso no es suficiente para tu caso de uso, lee Dónde falla el enfoque del navegador y omite la instalación.
Instala la biblioteca y un navegador:
pip install playwright
playwright install chromium
Este script abre una página de búsqueda, hace scroll, y lee los mosaicos de pines. Un detalle importa primero: el selector de mosaico cambió. Las guías antiguas apuntan a div[data-test-id='pinWrapper'], que no coincide con nada en el sitio sin sesión hoy. La cuadrícula actual sin sesión usa gated-pin-rep para cada mosaico y gated-pin-image para su imagen:
import asyncio, json
from playwright.async_api import async_playwright

BROWSER_UA = ("Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
              "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")

async def scrape_pins(query, scrolls=6):
    url = f"https://www.pinterest.com/search/pins/?q={query}&rs=typed"
    seen = set()
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True)
        page = await browser.new_page(user_agent=BROWSER_UA,
                                      viewport={"width": 1280, "height": 900})
        await page.goto(url, wait_until="domcontentloaded")
        for _ in range(scrolls):
            await asyncio.sleep(1.5)
            images = await page.query_selector_all(
                "[data-test-id='gated-pin-image'] img")
            for img in images:
                src = await img.get_attribute("src")
                if src and "/236x/" in src:   # miniaturas de pin, no imágenes de UI
                    seen.add(src)
            await page.mouse.wheel(0, 4000)
        await browser.close()
    return sorted(seen)

async def main():
    results = await scrape_pins("minimalist%20office")
    print(f"collected {len(results)} thumbnail URLs")
    with open("office-pins.json", "w") as f:
        json.dump(results, f, indent=2)

if __name__ == "__main__":
    asyncio.run(main())
Establecer un User-Agent es el consejo de scraping de Pinterest más repetido, y no hace lo que la gente afirma. Ninguna sobreescritura, una cadena actual de Chrome, una cadena de Chrome de dos años, y un literal python-requests/2.32.3 devuelven todos HTTP 200 y el mismo conteo de mosaicos. Cada uno devolvió ningún enlace de pin y el mismo modal de inicio de sesión. Mantén uno sensato de todos modos, ya que no cuesta nada e identifica tu tráfico honestamente.
El conjunto importa porque Pinterest reutiliza nodos de mosaico mientras haces scroll. Ejecútalo y una sesión sin sesión imprime:
collected 16 thumbnail URLsAsí que Playwright devuelve URLs de miniaturas desde la búsqueda, y nada más allá de ellas.
Obtén la imagen a tamaño completo desde una miniatura de Pinterest
Las miniaturas que devuelven esas ejecuciones tienen 236 píxeles de ancho. Si ya tienes el JSON-LD del pin o un registro de la API, la URL de tamaño completo está en él y no se necesita reescritura. Trabajando desde una miniatura en su lugar, el archivo de tamaño completo está en la misma ruta con el segmento de tamaño reemplazado. Ese intercambio generalmente se escribe como un reemplazo de cadena de una línea, y eso solo mayormente falla.
En 40 miniaturas de feeds en vivo, reemplazar /236x/ con /originals/ y mantener la extensión .jpg funcionó 5 veces. Devolvió HTTP 403 las otras 35. Pinterest reconvierte: la miniatura se sirve como .jpg mientras que el original almacenado suele ser .png. Probar las extensiones una tras otra funcionó para las 40.
El archivo que descargas es la fotografía de otra persona, así que lo que hagas con él es una cuestión de licencia en lugar de una de scraping:
import re, urllib.request

UA = ("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 "
      "(KHTML, like Gecko) Chrome/140.0.0.0 Safari/537.36")

def full_size(thumb_url):
    """Pinterest reconvierte, así que la extensión del original suele diferir."""
    base = re.sub(r"/\d+x\d*/", "/originals/", thumb_url).rsplit(".", 1)[0]
    for ext in ("jpg", "png", "webp", "gif"):
        candidate = f"{base}.{ext}"
        req = urllib.request.Request(candidate, method="HEAD",
                                     headers={"User-Agent": UA})
        try:
            if urllib.request.urlopen(req, timeout=15).status == 200:
                return candidate
        except Exception:
            continue
    return None
No cambies el orden, sin embargo, porque qué extensión funciona varía según la cuenta. Una muestra de 40 devolvió .png 35 veces y .jpg 5. Una muestra posterior de 40 en cuatro cuentas devolvió .webp 19, .jpg 15 y .png 6. Dentro de eso, una cuenta era enteramente .jpg, otra enteramente .webp, y una tercera mayormente .png.
Planifica alrededor de dos solicitudes HEAD por imagen: en esa muestra de cuatro cuentas, el bucle promedió 2.1 búsquedas antes de encontrar el archivo.
Dónde falla el enfoque del navegador
Playwright se pierde el resto del registro. El texto alt de cada mosaico es la cadena literal Pin, así que los mosaicos no tienen títulos. Ninguno de ellos envuelve un enlace /pin/ tampoco, así que la cuadrícula no te da nada que seguir.
Obtienes una lista corta de URLs de imagen y nada más: sin descripciones, sin pinner, sin guardados, sin hashtags. Cargar la misma búsqueda en un navegador normal sin sesión muestra por qué:
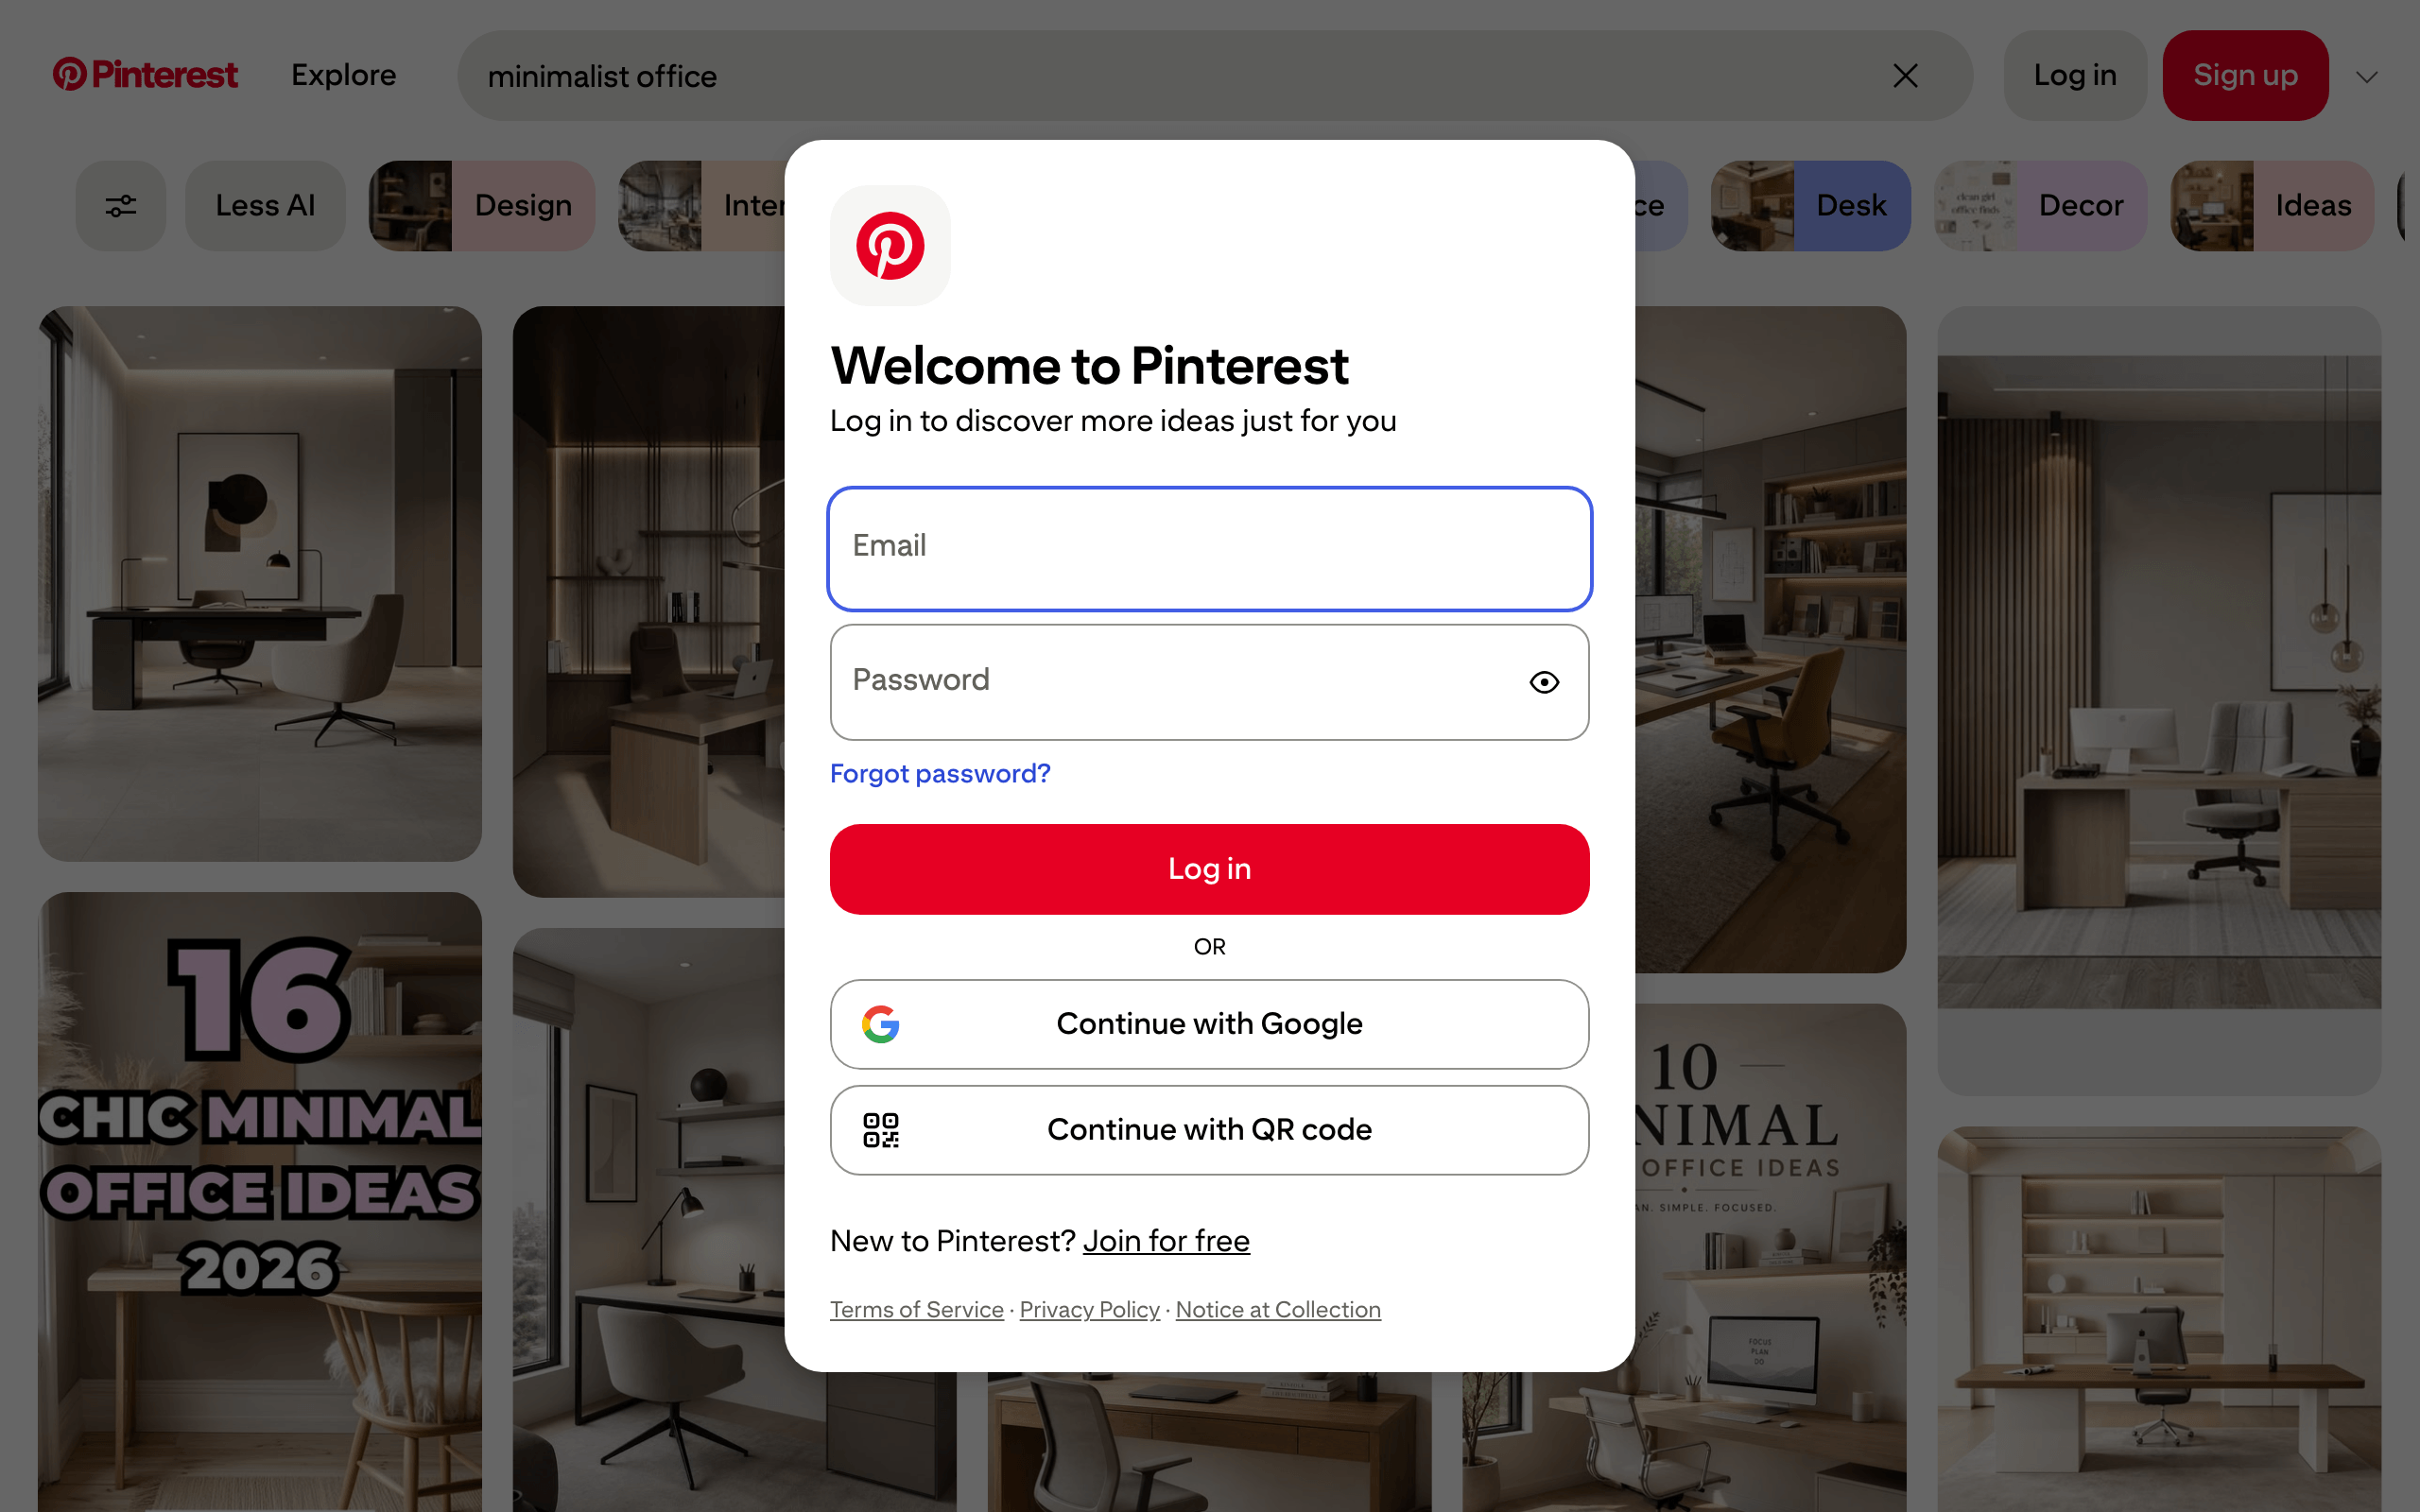
Los mosaicos alrededor del modal son los mismos elementos gated-pin-rep que lee el script. Cada uno contiene una imagen y nada más, por lo que la ejecución devuelve URLs y sin títulos.
Hacer más scroll no cambia nada. La cuadrícula mantiene el mismo conteo después de 3 scrolls que después de 25, y el conjunto de URLs de miniaturas nunca crece más allá de eso.
Ese conteo es estable dentro de una sesión y varía entre ellas. Ejecuciones repetidas en una sesión devolvieron 17 cada vez para minimalist office y 15 cada vez para fall fashion. Sesiones separadas en esas mismas dos consultas devolvieron 16, 17 y 18.
Espera un conteo fijo en algún lugar entre la media y alta adolescencia. Trata el número exacto como específico de la sesión en lugar de un número en el que confiar. Un modal de inicio de sesión cubre el feed y bloquea el scroll infinito que obtiene una sesión con sesión iniciada, con un campo de contraseña real justo ahí en el DOM.
Por qué un navegador sigiloso no lo soluciona
El siguiente movimiento natural es un navegador sigiloso, y es el diagnóstico equivocado para una cuadrícula bloqueada. Playwright sin modificar sí muestra señales de automatización a nivel de protocolo, más visiblemente la llamada Runtime.enable en el Chrome DevTools Protocol, y las versiones parcheadas las ocultan. Patchright es un reemplazo directo del paquete Playwright, y está construido para ocultar esas señales sin tocar tu script. Camoufox es una compilación de Firefox separada en lugar de un parche a Playwright.
Apuntado a la misma consulta con un navegador de renderizado y su propio grupo de proxies, un desbloqueador comercial devolvió la página sin sesión completa. Eso significó los mensajes de registro, los botones de categoría, la barra de filtros, y ni un solo título de pin ni enlace /pin/.
Ejecuta Patchright junto a Playwright sin modificar en las mismas dos consultas en una sesión y nada se mueve. Ambos devolvieron 16 mosaicos para minimalist office y 15 para fall fashion. Ambos devolvieron cero enlaces /pin/, Pin como el texto alt de cada mosaico, y el mismo campo de contraseña en el DOM.
Una barrera de estado de cuenta limita el feed sin sesión, no una puntuación de bot. Ninguna cookie de Bot Manager aparece en páginas de búsqueda o perfil. Los diez experimentos lop_unauth_lockdown están activos en __PWS_DATA__ a partir de septiembre de 2026, y el conteo de mosaicos no cambia en cuatro User-Agents.
Lo que se necesita para ir más allá
Para llegar a descripciones, enlaces, y engagement a través de una búsqueda con tu propio navegador, necesitas una sesión que Pinterest trate como un usuario real con sesión iniciada. Eso significa iniciar sesión y mantener cookies. Automatizar un inicio de sesión personal rompe los términos de la plataforma, que prohíben acceder a datos de Pinterest “usando medios automatizados (sin nuestro permiso previo expreso)”.
El volumen es la otra restricción, y en este objetivo es la reputación de IP en lugar del fingerprinting. Alrededor de 250 solicitudes desde una dirección no produjeron limitación de tasa ni desafío, así que el límite es más alto de lo que sugiere un primer intento. Ejecutar continuamente desde una sola dirección cambia eso, y es el primero de tres problemas que un scraper duradero debe manejar.
Lo que necesita un scraper duradero
Obtener una pantalla de miniaturas es una demostración. Recopilar miles de registros de pines completos con un horario es un problema de infraestructura.
- Diversidad de IP. Los proxies residenciales distribuyen el mismo trabajo entre muchas IPs de consumidores en lugar de una dirección de centro de datos. De los tres, la evidencia aquí hace que este sea el que vale la pena pagar, y no solo a escala. Una dirección clasificada como hosting obtiene páginas de pin con el bloque JSON-LD ausente, así que el parseo solo funciona desde IPs de consumidores. La rotación importa más allá de eso, una vez que una sola dirección funciona continuamente.
- Manejo de huellas y desafíos. Un navegador gestionado como el Browser API está construido para presentar una huella real consistente. También responde los desafíos que Chromium sin cabeza deja sin responder, lo cual una canalización necesita en el momento en que apunta a un sitio que impone uno. Las páginas públicas de Pinterest son el caso fácil: sin cookies de Bot Manager, sin payload de sensor, y sin desafío en seis identidades de cliente.
- Mantenimiento. Los selectores y el bloqueo cambian sin previo aviso, como muestran el cambio de
pinWrapperagated-pin-repy el experimento de bloqueo. Scrapling está construido para encontrar elementos de nuevo por similitud cuando los nombres de clase cambian con frecuencia, lo cual ayuda con la mitad de parser del problema.
Puedes construir todo esto, y los patrones generales para evitar que un scraper sea bloqueado aplican aquí igual que en cualquier otro lugar.
La compensación es que esto se convierte en trabajo de ingeniería continuo, no un script que escribes una vez. Cuando el costo de mantenimiento supera el valor de poseer la canalización, puedes moverlo a una Scraper API gestionada.
Haz scraping de Pinterest con la Scraper API de Bright Data
La Pinterest Scraper API de Bright Data mueve la capa de navegador, proxy, y desbloqueo a un servicio gestionado. Envías una URL de pin, una palabra clave, o una URL de perfil, y devuelve un registro estructurado. Es parte de la Web Scraper API, con una asignación mensual gratuita y luego pago por uso por registro entregado. Cada ejemplo de Scraper API en esta guía se ejecutó dentro de esa asignación.
Usa el scraper de Pinterest aquí en lugar de un desbloqueador de propósito general: devuelve registros parseados en lugar de HTML sin procesar. Los modos de acceso de propósito general son una ruta separada para cualquier URL en todos los sitios. Cuáles de ellos están disponibles varía según la cuenta. También varía según la zona, la configuración nombrada que creas para cada producto.
Bright Data aplica la lista blanca de robots descrita antes en esta guía en esa capa. Uno de esos modos rechazó una solicitud de Pinterest por completo precisamente por esa razón.
La configuración son dos pasos. La cuenta de Bright Data se abre sin tarjeta, y creas la clave API tú mismo en tu configuración de cuenta. Una cuenta nueva no tiene claves todavía, así que la tabla de claves API comienza vacía:
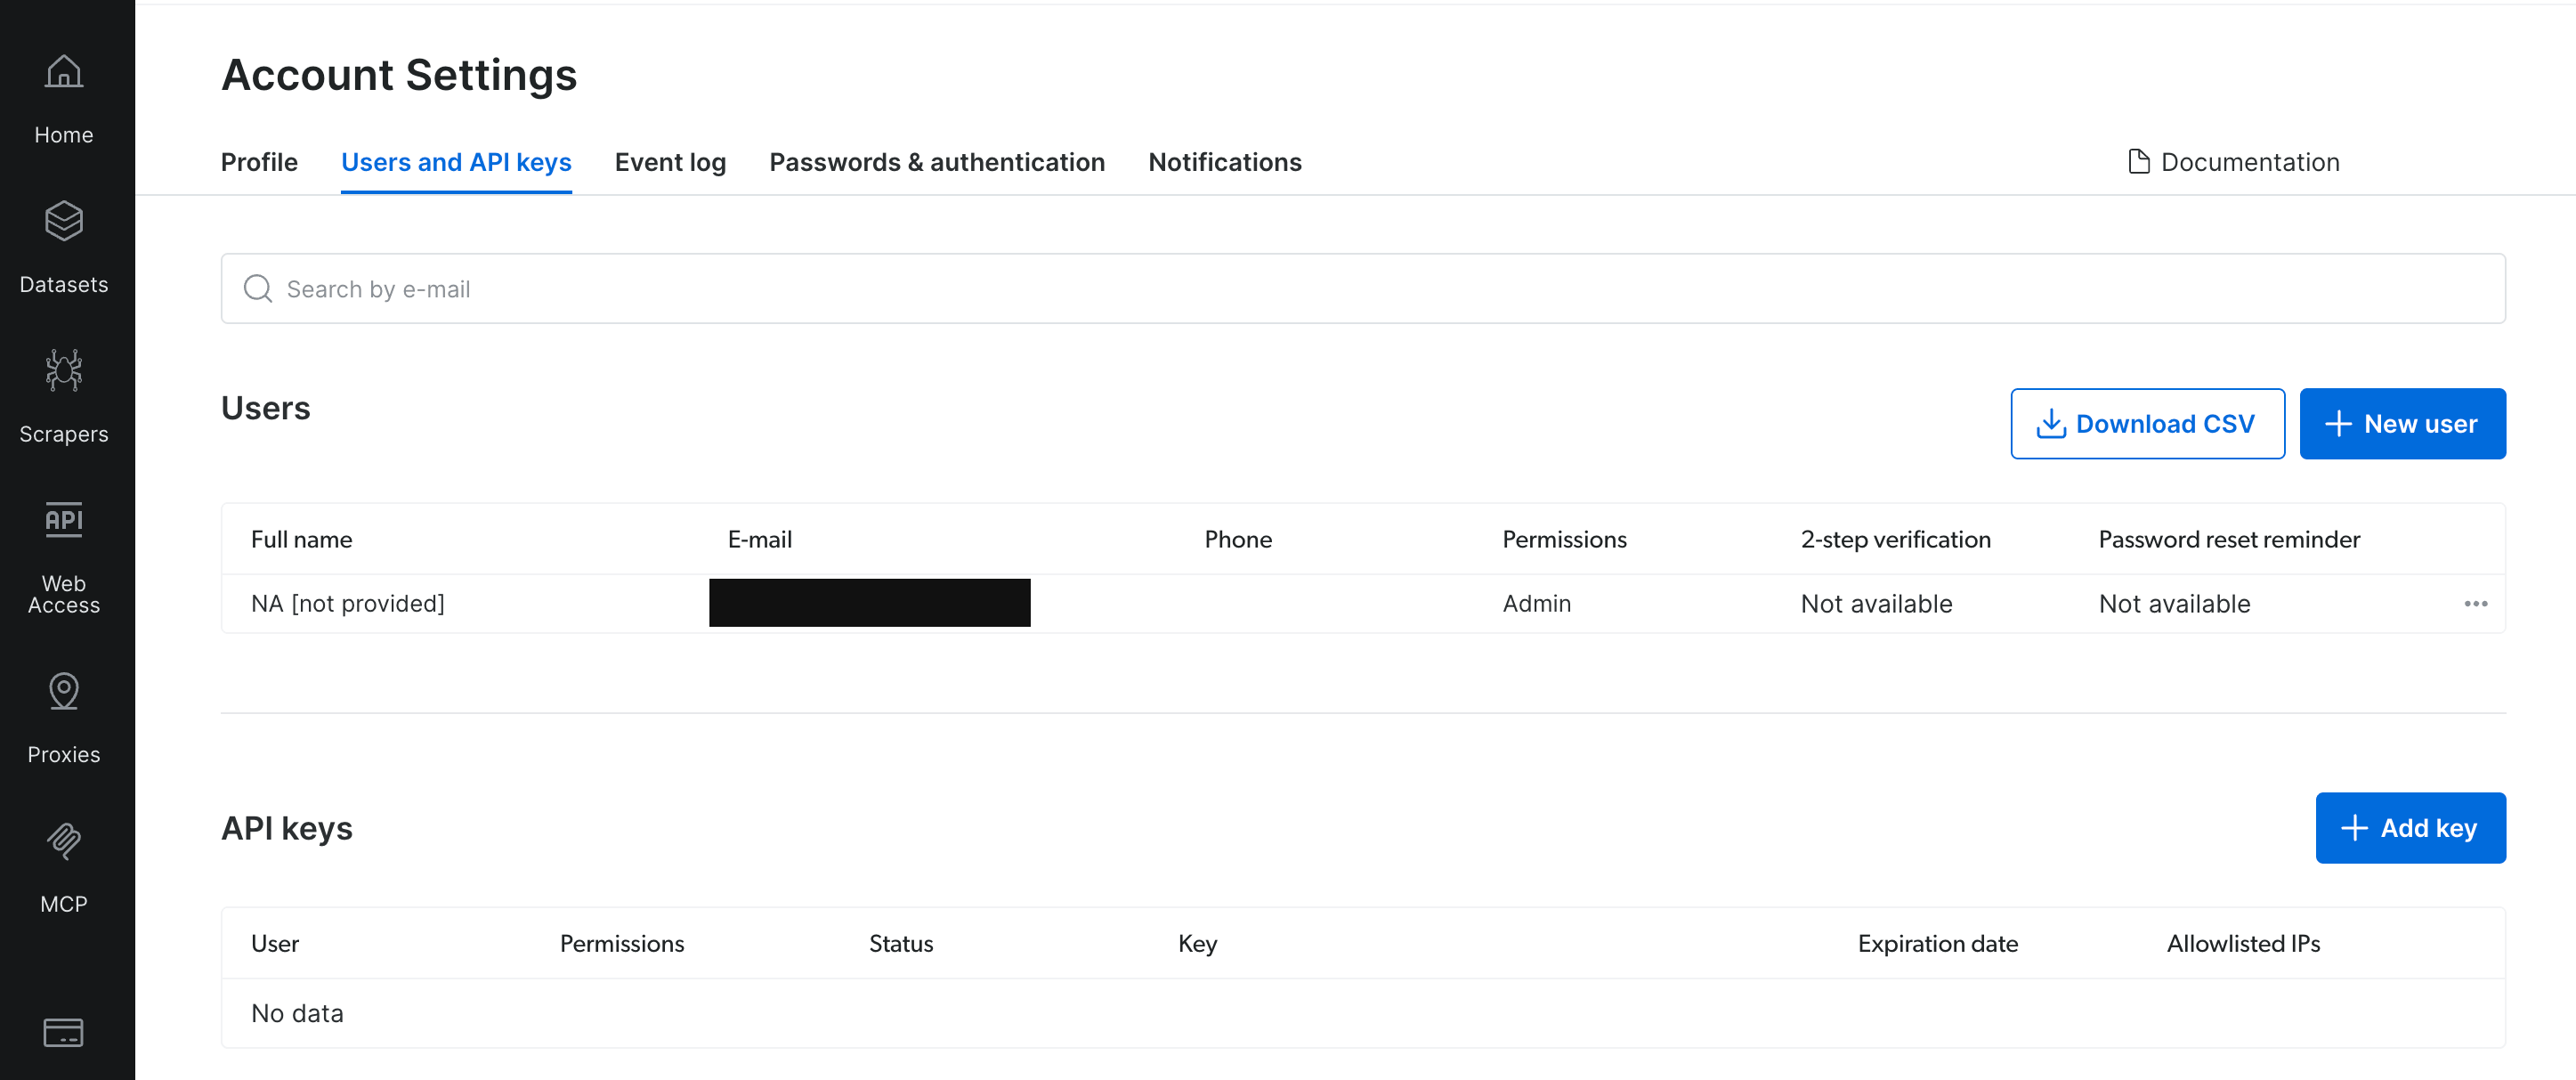
Añade una clave y el diálogo pide un usuario, un nivel de permiso, y una expiración.
Elige el nivel de permiso destinado para acceso API en lugar de facturación o administración. La documentación de autenticación de Bright Data lo describe como el que “habilita el uso de API a nivel de proxy/API”. Para la expiración, elige una fecha posterior al final de tu proyecto para que la clave no expire a mitad de la ejecución.
Los ejemplos usan el paquete requests, el mismo usado antes para los feeds de tablero:
pip install requestsEse único paquete es toda la lista de dependencias. Cada modo de recopilación comparte esta configuración, y la consola los lista juntos para que puedas ver qué hace cada uno antes de escribir nada:
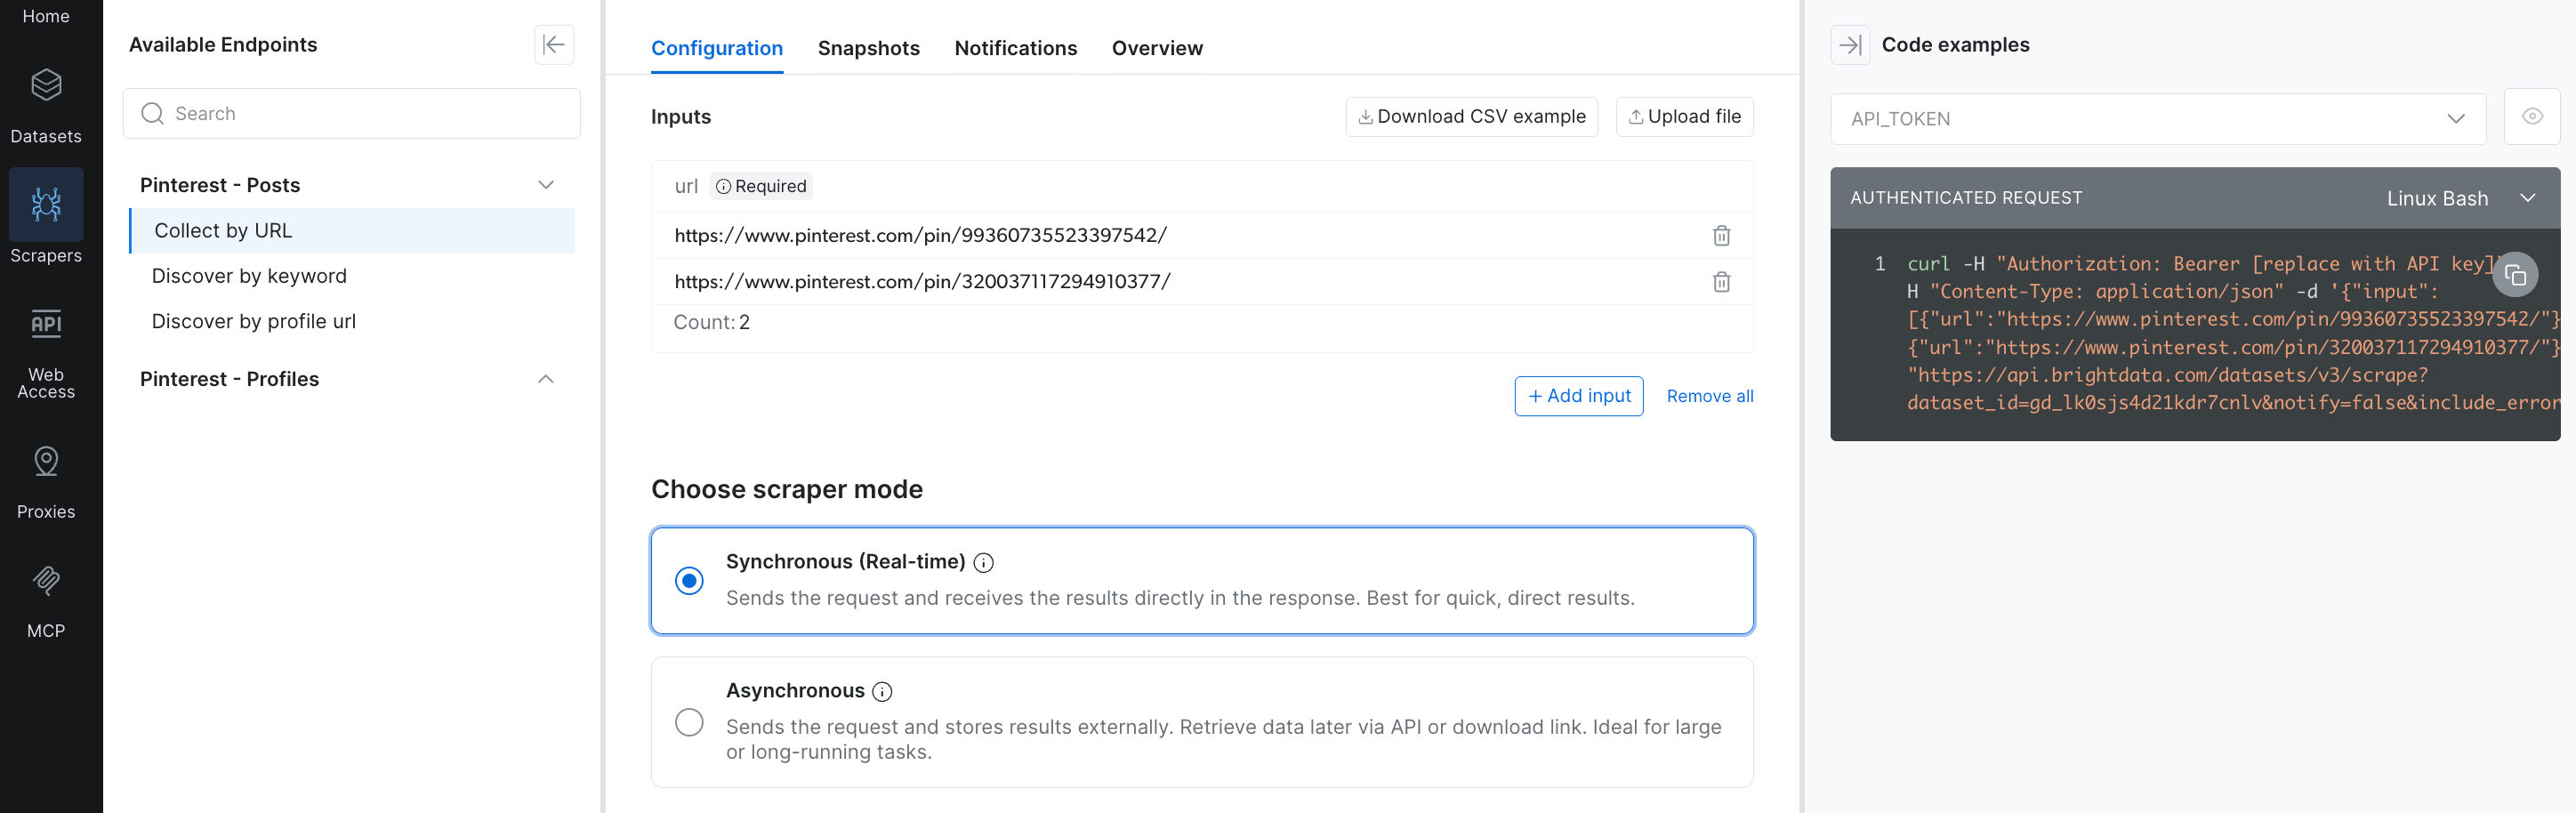
El panel lista los endpoints de este scraper. Los tres usados aquí son collect by URL, discover by keyword, y discover by profile.
Recopilar pines por URL
Envía una o más URLs de pin y lee los registros desde la respuesta. La bandera include_errors=true hace que la API reporte entradas fallidas en lugar de eliminarlas. Filtras los errores tú mismo, y a cambio ves el resultado de cada entrada:
import requests

API_KEY = "YOUR_API_KEY"  # crea esto en la configuración de tu cuenta de Bright Data
# copia el ID actual del conjunto de datos desde la página del scraper
DATASET_ID = "gd_lk0sjs4d21kdr7cnlv"

resp = requests.post(
    "https://api.brightdata.com/datasets/v3/scrape",
    headers={"Authorization": f"Bearer {API_KEY}",
             "Content-Type": "application/json"},
    params={"dataset_id": DATASET_ID, "include_errors": "true"},
    json={"input": [
        {"url": "https://www.pinterest.com/pin/99360735523397542/"},
        {"url": "https://www.pinterest.com/pin/3166662230556591/"},
    ]},
    timeout=60,
)

# un error HTTP se lanza aquí, así que resp contiene registros
resp.raise_for_status()
for line in resp.text.strip().splitlines():
    print(line)
La respuesta es JSON delimitado por líneas nuevas, un objeto por entrada. La URL activa devolvió un registro de alrededor de veinte campos, acortado aquí a los relevantes. El pin eliminado devolvió un error:
{"url": "https://www.pinterest.com/pin/99360735523397542/", "post_id":
"99360735523397542", "title": "12 Bombshell Hair Color Ideas To Try This
Summer | Ecemella", "content": "Copper Red",
"date_posted": "2023-05-24T22:32:51.000Z", "user_name": "ecemella",
"user_url": "https://www.pinterest.com/ecemella", "likes": 2,
"categories": ["Beauty", "Hair"], "hashtags": ["Casual Fall Outfit
Inspiration", "Fall Fashion Outfit Ideas"], "image_video_url":
"https://i.pinimg.com/originals/0d/b9/56/0db956e2c07e1580514b1c19587b4152.jpg",
"video_length": 0, "post_type": "image", "comments_num": 0}
{"input": {"url": "https://www.pinterest.com/pin/3166662230556591/"},
"error": "Bad input. Page does not exist.", "error_code": "dead_page"}
El registro coincide con el parseo JSON-LD en título, fecha, e imagen, y añade el handle del pinner, categorías, y hashtags en una sola llamada. El conteo de guardados y el enlace de fuente saliente provienen del JSON-LD de la página del pin en su lugar.
La URL fallida es un ID de pin real que Pinterest ha eliminado desde entonces. La API devuelve un error dead_page para ello en lugar de un fallo, así que puedes registrarlo y continuar. Bright Data cobra la Scraper API por registro entregado con éxito, así que bajo esa base un pin muerto no debería añadirse a la factura.
Los pines se eliminan con frecuencia, así que planifica para ese error en cualquier lote. Compara respuestas con entradas usando el propio campo url o input de cada objeto en lugar de por posición. En tres ejecuciones idénticas, la fila de error llegó primero dos veces y segunda una vez.
El endpoint scrape usualmente responde en línea. Cuando un trabajo necesita más tiempo, devuelve un snapshot_id y un mensaje de en progreso, con los registros esperando bajo ese ID. Verifica si hay un snapshot_id antes de parsear la respuesta como registros, sea cual sea el modo que solicitaste.
Descubrir pines por palabra clave
El modo de descubrimiento es la ruta a la búsqueda por palabra clave, la única área donde la barrera de inicio de sesión cierra el acceso a HTTP simple. Este es el modo a usar cuando tienes un tema en lugar de una lista de URLs. Añade type=discover_new y discover_by=keyword, y limita el volumen por palabra clave con limit_per_input:
import requests

API_KEY = "YOUR_API_KEY"
# copia el ID actual del conjunto de datos desde la página del scraper
DATASET_ID = "gd_lk0sjs4d21kdr7cnlv"

resp = requests.post(
    "https://api.brightdata.com/datasets/v3/scrape",
    headers={"Authorization": f"Bearer {API_KEY}",
             "Content-Type": "application/json"},
    params={"dataset_id": DATASET_ID, "include_errors": "true",
            "type": "discover_new", "discover_by": "keyword"},
    json={"input": [{"keyword": "minimalist office"},
                    {"keyword": "fall fashion"}],
          "limit_per_input": 4},
    timeout=180,
)
# un error HTTP se lanza aquí, así que resp contiene registros
resp.raise_for_status()
print(resp.text)
Cada palabra clave devuelve hasta el límite que establezcas. Cada registro añade un campo discovery_input que nombra la palabra clave que lo encontró. Donde el pin tiene una descripción, un campo content contiene el texto completo. Un registro de la ejecución de minimalist office, con la descripción recortada:
{"url": "https://www.pinterest.com/pin/320037117294910377", "title":
"Minimal Cream Office With Ultrawide Monitor, Wood Desk and Natural Window
Light", "content": "A pale wood desk sits beside a bright window with an
ultrawide monitor... #MinimalCreamOffice #PaleWoodWorkspace",
"user_name": "theSetupDistrict", "categories": ["Home Decor"],
"date_posted": "2026-08-25T15:59:51.000Z",
"discovery_input": {"keyword": "minimalist office"}}
Así que una sola palabra clave es suficiente para obtener registros de pines estructurados. La mayoría incluyen una descripción y categorías, ninguna de las cuales aparece en la cuadrícula de búsqueda sin sesión.
Rastrea un perfil completo con la API asíncrona
Rastrear cada pin en un perfil es más de lo que puede contener una sola respuesta, así que la API lo ejecuta como un trabajo en segundo plano. Inicias el trabajo, recibes un ID, y recopilas los registros cuando termina. Cambiar el modo en la consola muestra la diferencia en la solicitud misma:
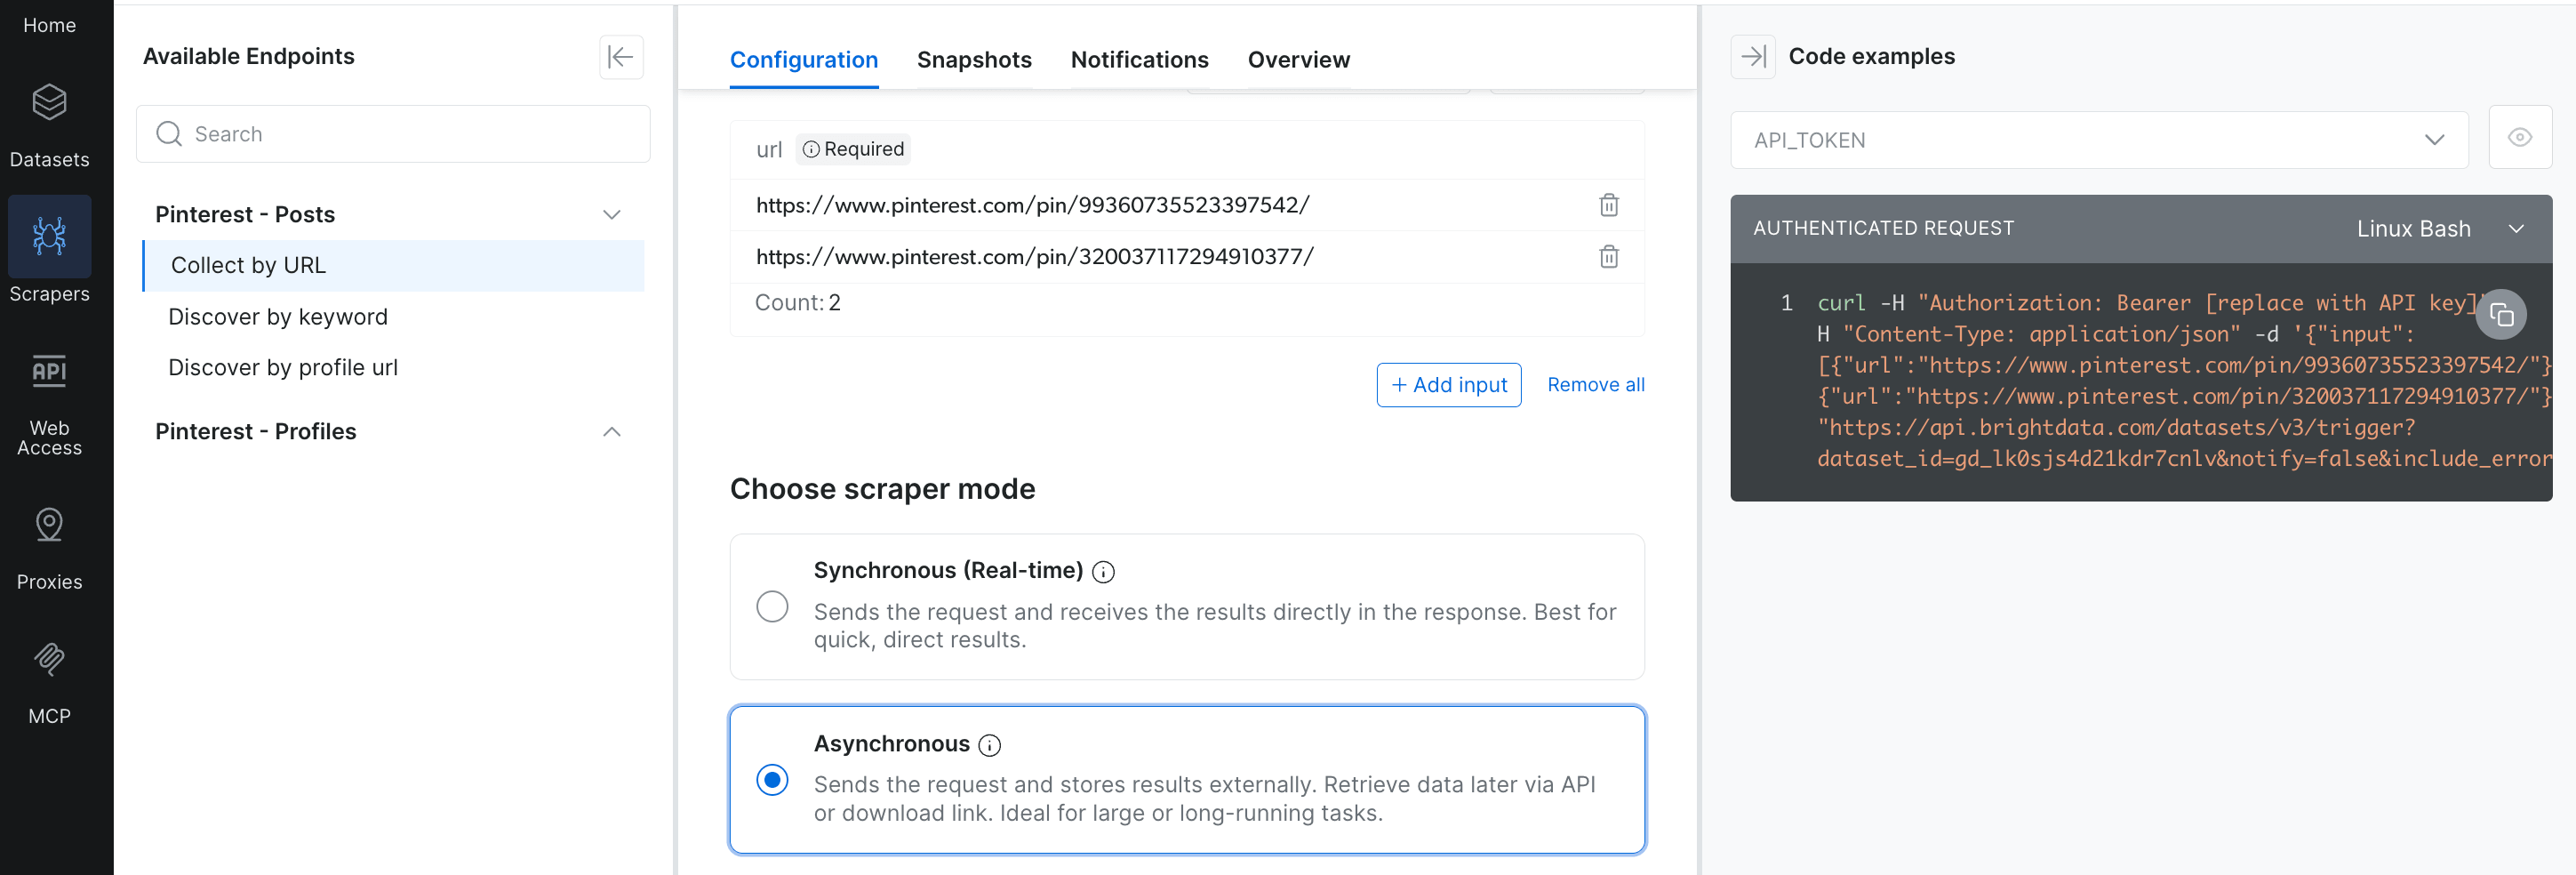
Seleccionar el modo asincrónico reescribe la ruta por ti: el endpoint scrape se convierte en trigger. La ejecución entonces devuelve un snapshot_id para consultar, en lugar de mantener una conexión abierta.
Usa el endpoint trigger, que devuelve un snapshot_id de inmediato:
import requests

API_KEY = "YOUR_API_KEY"
# copia el ID actual del conjunto de datos desde la página del scraper
DATASET_ID = "gd_lk0sjs4d21kdr7cnlv"
HEADERS = {"Authorization": f"Bearer {API_KEY}",
           "Content-Type": "application/json"}

start = requests.post(
    "https://api.brightdata.com/datasets/v3/trigger",
    headers=HEADERS,
    params={"dataset_id": DATASET_ID, "include_errors": "true",
            "type": "discover_new", "discover_by": "profile_url"},
    json={"input": [{"url": "https://www.pinterest.com/boredpanda/",
                     "start_date": "", "end_date": ""}],
          "limit_per_input": 4},
    timeout=60,
)
# un error HTTP se lanza aquí, así que start.json() contiene un snapshot_id real
start.raise_for_status()
snapshot_id = start.json()["snapshot_id"]
print("snapshot:", snapshot_id)
Los campos vacíos start_date y end_date son opcionales, y dejarlos en blanco recopila sin un filtro de fecha. Luego consulta el endpoint de progreso hasta que el trabajo esté listo y descarga el snapshot. La respuesta de progreso reporta conteos y cualquier código de error, así que sabes qué estás obteniendo antes de buscarlo:
import requests, time

API_KEY = "YOUR_API_KEY"
HEADERS = {"Authorization": f"Bearer {API_KEY}",
           "Content-Type": "application/json"}
# impreso por el bloque trigger; consérvalo para volver a descargar una ejecución fallida
snapshot_id = "sd_..."

progress_url = f"https://api.brightdata.com/datasets/v3/progress/{snapshot_id}"
while True:
    poll = requests.get(progress_url, headers=HEADERS, timeout=30)
    # un error HTTP se lanza aquí, así que poll.json() es un objeto de progreso real
    poll.raise_for_status()
    progress = poll.json()
    if progress["status"] in ("ready", "failed"):
        break
    time.sleep(10)

# records y error_codes dicen qué produjo la ejecución; status solo dice que se detuvo
codes = progress.get("error_codes") or {}
if progress["status"] == "failed" or not progress.get("records"):
    raise RuntimeError(
        f"{snapshot_id} finished with no records to download: "
        f"{progress['status']}, {codes}")

data = requests.get(
    f"https://api.brightdata.com/datasets/v3/snapshot/{snapshot_id}",
    headers=HEADERS, params={"format": "json"}, timeout=120,
).json()

# include_errors=true reporta entradas fallidas como filas, así que filtra antes de contar
records = [row for row in data if not row.get("error_code")]
if codes:
    print(f"skipped {sum(codes.values())} failed inputs: {codes}")
print(f"downloaded {len(records)} records")
Ese bucle maneja la mecánica. Lo que dice la respuesta sobre la ejecución necesita más cuidado.
Lee la respuesta de progreso antes de descargar
La respuesta de progreso incluye errors y error_codes junto a status, y los tres importan. ready por sí solo significa que el trabajo se detuvo, no que cada entrada tuvo éxito. Una ejecución puede terminar ready con records: 0 y un conteo de errors distinto de cero.
Un bucle que solo prueba status imprimirá downloaded 0 records y continuará como si hubiera tenido éxito. Lanzar un error en una ejecución de cero registros es el valor predeterminado correcto. Lanzar un error solo por errores no lo es: un rastreo que omite algunos pines eliminados y aún devuelve registros está funcionando exactamente como se pretendía.
La descarga necesita el mismo cuidado, porque include_errors=true pone entradas fallidas en el snapshot como filas junto a registros reales. El conteo de filas en bruto puede por lo tanto ser más alto que los registros que conservas. Una ejecución que reporta un registro puede devolver tres filas: dos entradas dead_page sin url, y un pin completo. Filtra por error_code antes de contar o almacenar cualquier cosa.
Una ejecución de perfil en boredpanda regresa en unos 21 segundos con los 4 registros que permitió el límite, cada uno etiquetado con su discovery_input. Los rastreos de perfil se ejecutan de forma asíncrona por diseño, incluso cuando llamas al endpoint síncrono scrape.
Un rastreo de palabra clave o perfil también reporta pines muertos como entradas dead_page en los error_codes de progreso. Una ejecución que devuelve menos registros válidos que tu límite generalmente ha encontrado pines eliminados, no un error en tu código.
Verifica una ejecución y recopila el registro de perfil
Cada ejecución se registra en la consola, así que obtienes un historial de ejecuciones sin construir uno:
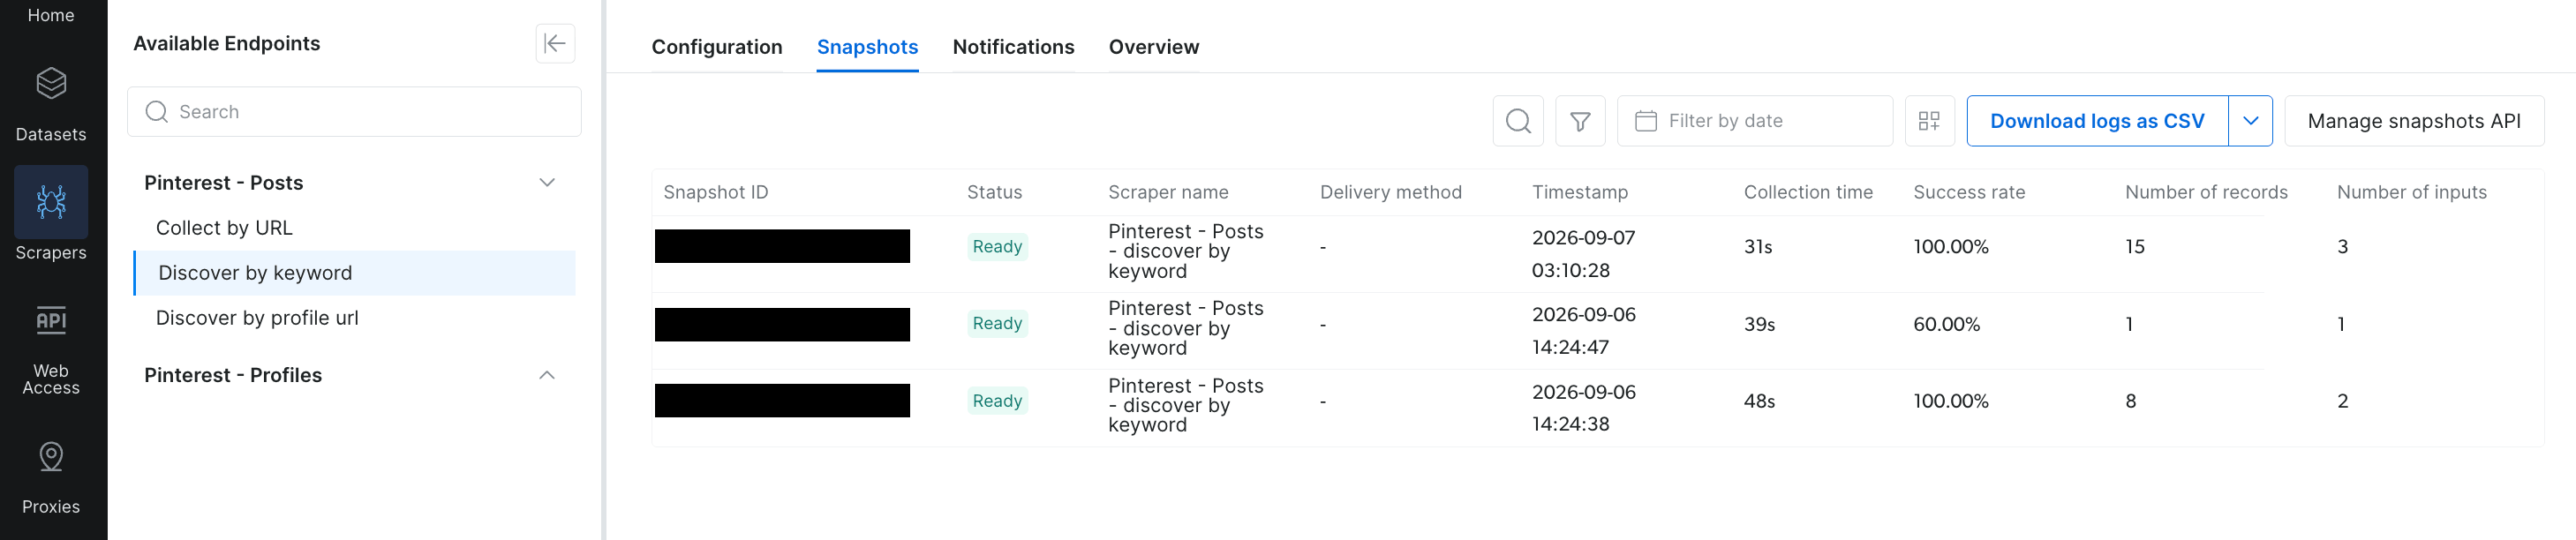
Una ejecución cuyo ID nunca registraste sigue aquí para volver a descargar. Dos de estas se ejecutaron sin errores al 100%; la tercera marca 60%, con dos pines eliminados registrados en su columna de error.
Esa ejecución intermedia devolvió un solo registro porque dos de los pines que encontró habían sido eliminados. La consola lo registra como dead_page: 2 bajo una columna de error que este recorte no alcanza. Verifica esa columna en tus propias ejecuciones antes de tratar unos pocos registros como una solicitud rota. La tasa de éxito es la cifra propia de la consola para las páginas que visitó un rastreo, así que léela junto con los conteos de registros y errores.
Un segundo scraper devuelve el registro de perfil en sí, junto con los pines que recopila el rastreo de perfil. Cambia el ID del conjunto de datos al de la página del scraper de perfiles de Pinterest, y publica la URL del perfil sin discover_by. Para la misma cuenta devolvió un follower_count de alrededor de 3 millones y un boards_num de 51 en el momento de la prueba. También devolvió un array saved de tableros con sus conteos de pines, 10 de los 51.
Ese scraper devuelve un snapshot_id en lugar de registros en línea, así que consúltalo de la misma manera. Tomó poco menos de cuatro minutos en pruebas, comparado con los aproximadamente veinte segundos del rastreo de pines, así que establece el intervalo de consulta en minutos.
Qué contienen los registros
Diez campos aparecieron en los 30 registros probados: url, post_id, date_posted, user_name, user_url, post_type, image_video_url, video_length, likes, y comments_num. Esos fueron el núcleo estable en el momento. Cuatro más son comunes en lugar de garantizados: title en 27 de los 30, categories en 24, content en 22, y hashtags en 16. Lee ese segundo grupo con .get() en lugar de indexación directa.
Los conteos de guardados son el número de engagement que la mayoría del análisis de Pinterest quiere, y los obtienes de una unión de dos fuentes en post_id. La API suministra el descubrimiento y el registro estructurado. El JSON-LD de la página del pin suministra el conteo de guardados, que devolvió en 5 de los 6 pines verificados.
Verifica los números reales antes de construir una métrica con ellos. Muestrear ocho pines recientes de cada una de tres cuentas devolvió medianas de 1, 1 y 2, mientras que pines individuales alcanzaron los cientos. Así que el contador es por pin en lugar de por imagen. likes devolvió 0 en 5 de esos mismos 6, lo cual coincide con que Pinterest eliminó los likes como una métrica pública hace años.
En los mismos 6 pines, los títulos concordaron entre las dos fuentes cada vez, y las fechas en 3 de 6. Los nombres de pinner generalmente también concuerdan, pero son el campo en el que no confiar. El pin usado a lo largo de esta guía es un caso donde difieren: su respuesta oEmbed y su registro de API nombran a personas diferentes.
El registro de la API nombra la cuenta detrás del sitio al que enlaza el pin, mientras que el JSON-LD y oEmbed nombran al individuo que lo guardó. Cuando un pin se vuelve a guardar desde otra cuenta, las dos fuentes pueden nombrar personas diferentes. Une los dos conjuntos de datos en la URL del pin o post_id, nunca en el pinner.
Donde las fechas diferían, el date_posted de la API estaba en o cerca del día en que el pin apareció en el feed. El datePublished de JSON-LD era más antiguo, en un caso por varios años. Decide qué definición necesita tu análisis antes de mezclar las dos.
¿Qué método de scraping de Pinterest deberías usar?
La elección depende de con qué estás empezando y cuánto del registro necesitas:
| Factor | HTTP simple (JSON-LD, oEmbed, RSS) | Playwright (DIY) | Bright Data Scraper API |
|---|---|---|---|
| Configuración | requests y la biblioteca estándar |
Instalar Playwright y un navegador | Clave API más requests |
| Datos devueltos | Registro completo para un pin conocido, además de un registro de perfil estructurado | Solo URLs de imagen desde búsqueda o un perfil | Título, descripción, pinner, hashtags, categorías, medios; los guardados provienen de la página del pin, unidos por post_id |
| Descubrimiento | Feeds de tablero y el backend de widgets, sin búsqueda | Mosaicos bloqueados en una búsqueda | Pines por URL, palabra clave, o perfil completo |
| Bloqueo | Tus propias IPs, sin desafío TLS observado | Tú gestionas proxies y mantenimiento | Capa de proxy y desbloqueo gestionada |
| Mantenimiento | Tuyo cuando un feed o el bloque JSON-LD cambia | Tuyo cuando Pinterest cambia el marcado o el bloqueo | Del proveedor, a través de los mismos cambios de marcado y bloqueo |
| Costo | Gratis desde una IP, 1.24 GB en 10,000 páginas de pin y mucho menos a través de oEmbed | Gratis, más 43.5 GB de tráfico de proxy en 10,000 pines | Una asignación mensual gratuita, luego precio por registro entregado con éxito |
El HTTP simple alcanza más de lo que sugieren la mayoría de las guías. Devuelve cualquier pin activo que nombres, un registro de perfil estructurado, y pines recientes de cada tablero que muestra una cuenta. Ejecutar ambos métodos gratuitos en todos los tableros de una cuenta devolvió 435 pines únicos.
La restricción es cuánto puedes alcanzar, y es más estrecha de lo que parece. Esos 435 son de más de 9,000 pines almacenados en los nueve tableros de los que provinieron, menos del 5%. Ningún método gratuito alcanza la búsqueda por palabra clave, y Playwright solo añade miniaturas bloqueadas. La Scraper API es para descubrimiento por palabra clave, rastreos completos de perfil, y recopilación recurrente.
Lo que cuesta cada método en 10,000 pines
El tamaño de la carga útil determina la factura, medido por los bytes realmente transferidos. La tabla asume un cliente que negocia compresión. Una página de pin que mide alrededor de 1.13 MB descomprimida transfiere alrededor de 124 KB con Brotli, o 183 KB con el encabezado gzip que envía requests. Ejecuta el ejemplo stdlib en su lugar y cada cifra en la fila de HTML de página de pin se multiplica por aproximadamente 9.
Los bytes se miden aquí; las tarifas no. Dos tarifas establecen cada dólar en la tabla. Ambas son precios de lista de Bright Data de septiembre de 2026, así que las filas de ancho de banda y la fila de registros usan una base:
- Ancho de banda residencial, $8/GB. La tarifa de lista de pago por uso en la página de precios de red de proxies, que baja en el plan de compromiso publicado más grande.
- Scraper API, $1.50 por cada 1,000 registros entregados. La tarifa de lista de pago por uso en la página de precios de Web Scraper API, que baja con el volumen en los planes publicados más altos. La misma página lista una asignación mensual gratuita; la tabla usa el precio de lista para cada registro.
Ambas páginas también muestran promociones, y ambas cambian sin que este post cambie. Lee las tarifas actuales en esas dos páginas antes de estimar costos. Pon lo que te cotizan en la multiplicación en la última columna.
| Método | Medido en | Bytes transferidos por pin | Volumen para 10,000 | Costo a esas tarifas |
|---|---|---|---|---|
| Feed RSS, por pin listado | ancho de banda | 147 B | 0.0015 GB | × $8/GB = $0.01 |
| JSON oEmbed | ancho de banda | 583 B | 0.006 GB | × $8/GB = $0.05 |
| HTML de página de pin | ancho de banda | 124 KB | 1.24 GB | × $8/GB = $9.92 |
| Scraper API | registros entregados | igual a cualquier tamaño de página | 10,000 registros | × $1.50/1k = $15.00 |
| Página de pin vía Playwright | ancho de banda | 4.35 MB | 43.5 GB | × $8/GB = $348.00 |
Las filas difieren en lo que cuesta un fallo. Un pin eliminado todavía responde HTTP 200 con una página completa, así que las filas de ancho de banda pagan por sus bytes. La fila de registros tiene precio por registro entregado.
Lo que no muestran las cifras en dólares
Cargar el mismo pin en Chromium sin cabeza descarga 4.35 MB en alrededor de 180 respuestas. Eso es aproximadamente 35 veces lo que mueve una obtención simple para el mismo registro.
Alrededor de 3.1 MB de eso es JavaScript, por lo que la forma habitual de ahorrar bytes apenas ayuda. Bloquear imágenes, fuentes, y hojas de estilo lo reduce a 3.8 MB y no más bajo, porque la página todavía necesita sus scripts para renderizar.
El tiempo es el otro costo. Una obtención de página de pin tuvo una mediana de 0.8 a 1.0 segundos en dos ejecuciones de 15 solicitudes desde una sola máquina. Las ejecuciones completas terminan más lento de lo que sugiere esa mediana.
Tres pasadas sobre un feed de 25 pines con una demora de medio segundo terminaron a 21 a 33 pines por minuto. Ejecutando uno a la vez, eso es de 5 a 8 horas para 10,000 pines. Ejecutarlos en paralelo acorta eso y concentra tu tasa de solicitud en una dirección al mismo tiempo.
Lo que realmente comparan las cifras de costo
oEmbed mueve 583 bytes comparado con los 124 KB de la página del pin. Obtener una página completa para leer un nombre de autor es un desperdicio.
Una API gestionada compra dos cosas: alcance, y que alguien más haga el mantenimiento. Alcanza los tipos de página más allá de HTTP simple, búsqueda por palabra clave y rastreos completos de perfil. El ahorro viene de ahí, no de los bytes transferidos.
Sobre la misma base, la fila de página de pin y la fila de Scraper API están cerca una de otra, dentro de alrededor de 1.5x. Ambos lados tienen promociones que las bajan aún más. Cuál es más barata depende de tarifas que ni este post ni tú controlan.
La comparación con un navegador sin cabeza no está cerca. En cada tarifa publicada en esa misma página de precios de proxy, 43.5 GB de tráfico cuesta un múltiplo de lo que cuestan 10,000 registros.
Las dos cifras no miden lo mismo, así que lee lo que incluye cada una. La línea de tráfico es ancho de banda y nada más. Excluye los mínimos del plan de proxy y las horas dedicadas a construir y mantener la canalización. También asume que ya tienes 10,000 URLs de pin, lo cual ningún método gratuito suministra a esa escala.
La cifra de registro es más amplia: incluye el descubrimiento que produjo la lista de URLs, y su tarifa mejora con el volumen. Los mínimos del plan aplican en ambos lados, así que confírmalos para un trabajo grande de la misma manera que verificarías una cotización de proxy.
Próximos pasos
Comienza con la herramienta más ligera para los datos que necesitas. Si tienes las URLs de pin, el parseo JSON-LD devuelve registros completos por HTTP simple, y oEmbed por sí solo da atribución. Si estás siguiendo a un creador o un tablero, encadena el feed RSS a ese parseo y nunca cargas un navegador.
La búsqueda por palabra clave y los rastreos completos de perfil son los casos más allá de esas rutas. La Pinterest Scraper API toma una palabra clave o una URL de perfil y devuelve registros estructurados, con una asignación mensual gratuita para probar.
Para cualquier cosa que planees mantener ejecutando, establece tres valores predeterminados desde el principio:
- Maneja los pines eliminados en cada lote. Eso significa un
Nonedel parseo JSON-LD, o una entradadead_pagede la API. - Mantén alrededor de medio segundo entre solicitudes. Ese ritmo corrió a 21 a 33 pines por minuto en ejecuciones completas, y no produjo limitación de tasa en alrededor de 250 solicitudes.
- Registra el
snapshot_idpara trabajos asíncronos. Una ejecución fallida puede entonces volver a descargarse.
Para ir más allá de una sola dirección, enruta a través de proxies residenciales y mantén el parseo que ya tienes. Si prefieres comprar los datos en lugar de recopilarlos, el conjunto de datos de Pinterest ya está construido y listo para descargar
Preguntas frecuentes
¿Se puede hacer scraping de Pinterest?
Sí. Una URL de pin generalmente devuelve título, descripción, conteo de guardados, pinner y enlace saliente desde un bloque JSON-LD por HTTP simple, sin necesidad de navegador. Los feeds RSS de perfil y tablero listan URLs de pines recientes. La búsqueda por palabra clave es la excepción y necesita una Scraper API.
¿Pinterest bloquea a los scrapers?
No, no en páginas públicas de pin desde una dirección residencial. Doce solicitudes con el User-Agent predeterminado de urllib devolvieron todas HTTP 200, sin cookies de Akamai Bot Manager. Una IP de centro de datos es la excepción: la página todavía devuelve 200, pero sin su bloque JSON-LD.
¿Por qué no funciona mi scraper de Pinterest?
El registro está en un bloque JSON-LD, no en el store de Redux, así que initialReduxState.pins lee vacío. En cuadrículas de búsqueda el antiguo selector pinWrapper no coincide con nada, ya que los mosaicos sin sesión ahora usan gated-pin-rep. Un pin eliminado todavía responde HTTP 200 sin ningún bloque JSON-LD.
¿Pinterest tiene una API pública?
Sí, pero está limitada a tu propia cuenta. La API v5 de Pinterest gestiona tus tableros, pines, y anuncios, no pines públicos de otros usuarios. El acceso de prueba tiene un límite diario de solicitudes. La única búsqueda por palabra clave es una beta no disponible para todas las aplicaciones, limitada a los 10 resultados principales.
¿Pinterest tiene un feed RSS?
Sí. Pinterest publica feeds sin autenticación en /<usuario>/feed.rss y /<usuario>/<slug-tablero>.rss. En 12 cuentas devolvieron de 22 a 26 ítems recientes, con URLs de pines, marcas de tiempo, y miniaturas pero casi ningún título. Los feeds listan solo pines nuevos, sin búsqueda por palabra clave y sin profundidad histórica.
¿Cómo descargo imágenes de Pinterest a tamaño completo?
Reemplaza el segmento de tamaño en la URL de miniatura con originals, luego prueba .jpg, .png, .webp y .gif en orden. Mantener el propio .jpg de la miniatura devolvió 403 en 35 de 40 pines, porque Pinterest reconvierte. Planifica alrededor de dos solicitudes HEAD por imagen.
¿Cómo hago scraping de un tablero de Pinterest?
Elimina cualquier barra final de la URL del tablero y añade .rss. Una barra final devuelve la página HTML en lugar del feed. El feed se detiene cerca de 25 ítems sin importar cuán grande sea el tablero. El backend de widgets en widgets.pinterest.com/v3/pidgets/ devuelve hasta 50, y más allá de eso rastreas todo el perfil.