El scraping web tradicional a menudo implica escribir código intrincado y que consume mucho tiempo, adaptado a diseños de sitios web específicos, que puede romperse fácilmente cuando los sitios cambian. ScrapeGraphAI utiliza modelos de lenguaje grande (LLMs) para extraer información e interpretarla como lo haría un humano, permitiéndote enfocarte en los datos en lugar del diseño. Integrar LLMs con ScrapeGraphAI mejora la extracción de datos, automatiza la agregación de contenido y permite el análisis en tiempo real.
En este artículo, aprenderás cómo usar ScrapeGraphAI para hacer scraping web. Pero antes, déjanos presentarte las soluciones de Bright Data que pueden ahorrarte tiempo y dinero.
Soluciones de Web Scraping de Bright Data
Bright Data ofrece un conjunto integral de soluciones de scraping web, optimizadas para una extracción de datos eficiente, escalable y conforme a la normativa:
- Web Scraper API
- Conjuntos de datos listos para usar
- Conjuntos de datos personalizados
Estas soluciones permiten una recopilación de datos rápida, precisa y escalable, perfecta para proyectos de cualquier alcance, desde aplicaciones a pequeña escala hasta necesidades de nivel empresarial.
Implementando Web Scraping con LLM usando ScrapeGraphAI
Antes de comenzar este tutorial, necesitas los siguientes requisitos previos:
- Python 3.x instalado.
- Una cuenta de OpenAI. Este tutorial utiliza LLMs de OpenAI para hacer scraping de datos con ScrapeGraphAI. Aunque es posible usar otros modelos, como Anthropic, Google, o modelos de código abierto, como Llama y Mistral AI, este tutorial utiliza GPT-4 por su popularidad y facilidad de configuración.
Si no estás familiarizado con el scraping web en Python, consulta este tutorial de scraping web para comenzar.
Configura tu Entorno
Lo primero que debes hacer es crear un entorno virtual. Abre tu terminal y navega hasta el directorio de tu proyecto:
python -m venv venv
Luego, activa el entorno virtual. En macOS y Linux, puedes hacerlo con el siguiente comando:
source venv/bin/activate
En Windows, puedes usar este comando:
venvScriptsactivate
Una vez que hayas activado el entorno virtual, necesitas instalar ScrapeGraphAI y sus dependencias:
pip install scrapegraphai
playwright install
El comando playwright install configura los navegadores necesarios para Chromium, Firefox y WebKit.
Para gestionar las variables de entorno de forma segura, instala python-dotenv:
pip install python-dotenv
Es importante proteger información sensible, como las claves de API. Se recomienda almacenar las variables de entorno en un archivo .env para mantenerlas separadas de los archivos de código.
Crea un nuevo archivo llamado .env en el directorio del proyecto y añade la siguiente línea especificando tu clave de OpenAI:
OPENAI_API_KEY="your-openai-api-key"
Este archivo no debe incluirse en sistemas de control de versiones como Git. Para evitarlo, añade .env a tu archivo .gitignore.
Extrae Datos con ScrapeGraphAI
En este tutorial, comenzarás extrayendo datos de productos de Books to Scrape, un sitio web de demostración diseñado específicamente para practicar técnicas de scraping web. Este sitio web simula una librería en línea, ofreciendo una variedad de libros de diferentes géneros, con precios, calificaciones y estado de disponibilidad:
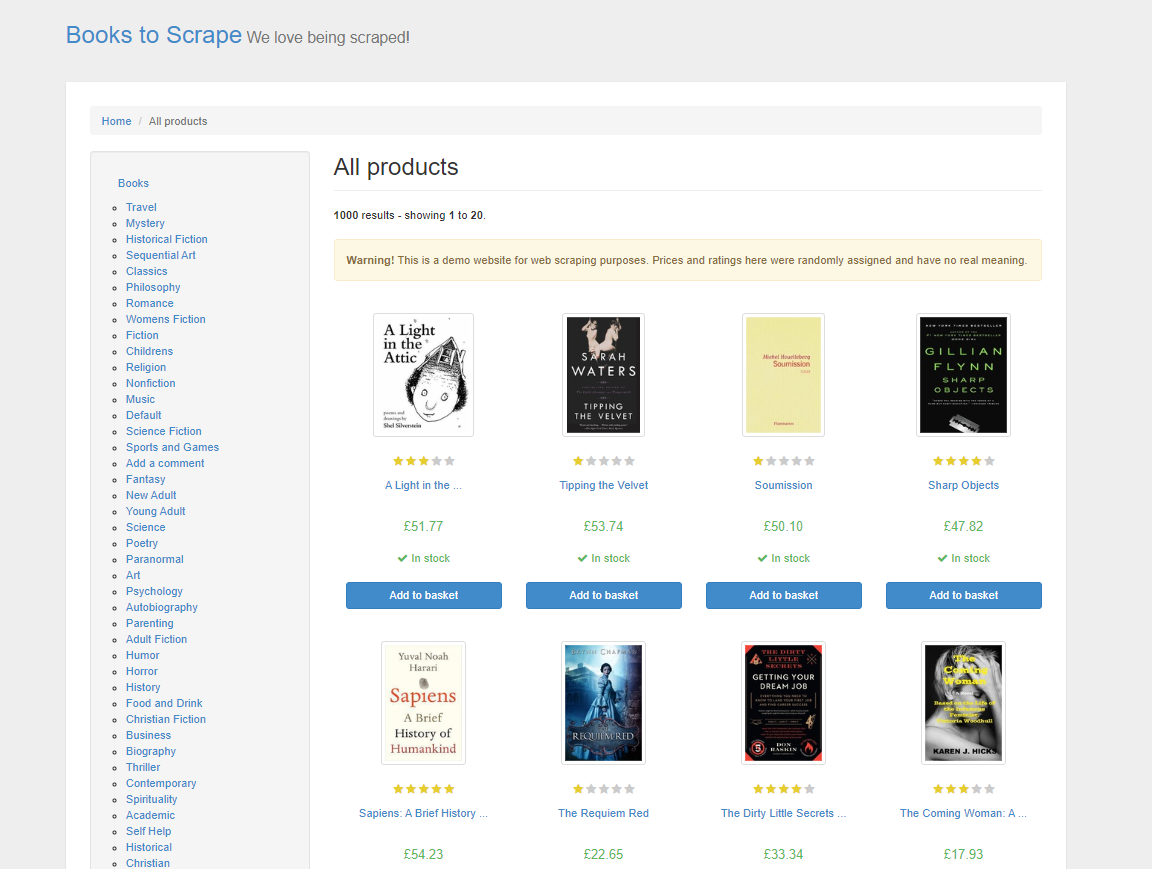
En el scraping web HTML tradicional, necesitarías analizar el HTML de la página, inspeccionando manualmente los elementos y etiquetas para localizar los datos que deseas. Este proceso consume mucho tiempo y requiere un sólido entendimiento de las estructuras web. Con ScrapeGraphAI, solo necesitas especificar los datos que deseas mediante un prompt, y el LLM es lo suficientemente inteligente como para extraerlos.
ScrapeGraphAI ofrece diferentes tipos de gráficos para distintas necesidades de scraping. Estos gráficos definen cómo se estructura el proceso de scraping y qué pretende lograr. Aquí tienes una breve descripción de algunos de los diferentes gráficos:
- SmartScraperGraph es un scraper de una sola página donde proporcionas un prompt y una URL o archivo local. Utiliza un LLM para extraer la información que especifiques.
- SearchGraph es un scraper multipágina que extrae información de los resultados de motores de búsqueda según tu prompt.
- SpeechGraph amplía SmartScraperGraph añadiendo una función de texto a voz, generando un archivo de audio del contenido extraído.
- ScriptCreatorGraph toma un prompt y una URL, y en lugar de generar resultados, produce un script de Python capaz de hacer scraping de la URL dada.
Si estos gráficos no se ajustan exactamente a tus necesidades, ScrapeGraphAI también te permite crear gráficos personalizados combinando diferentes nodos y adaptando el proceso de scraping a tus requisitos específicos.
Además de elegir el tipo de gráfico adecuado, también necesitas configurar correctamente tu scraper, especialmente en lo que respecta al prompt y la selección del modelo. El prompt guía al LLM para que entienda exactamente qué datos extraer, así que asegúrate de que sea claro y explícito. Además, elegir el modelo de LLM adecuado determina qué tan bien el scraper procesa e interpreta el contenido del sitio web. También puedes configurar otras opciones, como proxies, para garantizar un scraping más fluido de contenido georestringido, y el modo headless para mantener el proceso eficiente y rápido. La configuración adecuada determina, en última instancia, qué tan precisos y relevantes serán los datos extraídos.
Escribe el Código del Scraper
Para escribir el código del scraper, crea un nuevo archivo llamado app.py y añade las siguientes líneas de código:
from dotenv import load_dotenv
import os
from scrapegraphai.graphs import SmartScraperGraph

# Load environment variables from .env file
load_dotenv()

# Access the OpenAI API key
OPENAI_API_KEY = os.getenv('OPENAI_API_KEY')

# Configuration for ScrapeGraphAI
graph_config = {
    "llm": {
        "api_key": OPENAI_API_KEY,
        "model": "openai/gpt-4o-mini",
 }
}

# Define the prompt and source
prompt = "Extract the title, price and availability of all books on this page."
source = "http://books.toscrape.com/"

# Create the scraper graph
smart_scraper_graph = SmartScraperGraph(
 prompt=prompt,
 source=source,
 config=graph_config
)

# Run the scraper
result = smart_scraper_graph.run()

# Output the results
print(result)
Este código importa módulos esenciales como os y dotenv para manejar las variables de entorno y la clase SmartScraperGraph de ScrapeGraphAI, que se utiliza para el scraping. Luego, carga las variables de entorno mediante dotenv para mantener seguros los datos sensibles, como las claves de API. A continuación, el código crea una configuración del LLM para el scraping, especificando qué modelo usar y la clave de API. Esta configuración, junto con la URL del sitio y el prompt de scraping, se utiliza para definir tu SmartScraperGraph, que se ejecuta mediante el método run(), activando el proceso para recopilar los datos especificados.
Para ejecutar este código, abre tu terminal y ejecuta python app.py. Tu salida debería verse así:
{
    "books": [
        {
            "title": "A Light in the Attic",
            "price": "£51.77",
            "availability": "In stock"
        },
        {
            "title": "Tipping the Velvet",
            "price": "£53.74",
            "availability": "In stock"
        }, ...
       ]
}
Nota: Si encuentras problemas al ejecutar el código, es posible que debas instalar manualmente el paquete
grpcio, que es una dependencia subyacente de ScrapeGraphAI. Puedes hacerlo con el siguiente comando:
pip install grpcio
Aunque ScrapeGraphAI facilita la parte de extracción de datos del scraping web, aún existen algunos desafíos comunes, como los CAPTCHAs y los bloqueos de IP, que debes saber cómo manejar.
Para simular el comportamiento de navegación, puedes implementar retrasos cronometrados en tu código. También puedes utilizar proxies rotativos para evitar la detección. Además, servicios de resolución de CAPTCHA como el solucionador de CAPTCHA de Bright Data o Anti Captcha pueden integrarse en tu scraper para resolver automáticamente los CAPTCHAs por ti.
Ten en cuenta: Asegúrate siempre de cumplir con los términos de servicio de un sitio web. El scraping para uso personal suele ser aceptable, pero redistribuir los datos puede tener implicaciones legales.
Usando Proxies con ScrapeGraphAI
ScrapeGraphAI te permite configurar un servicio de proxy para evitar el bloqueo de IP y acceder a contenido georestringido. Puedes usar un servicio de proxy gratuito o configurar tu propio servidor proxy personalizado.
Para usar un servicio de proxy gratuito, añade lo siguiente a tu graph_config:
graph_config = {
    "llm": {
        "api_key": OPENAI_API_KEY,
        "model": "openai/gpt-4o-mini",
 },
    "loader_kwargs": {
        "proxy": {
            "server": "broker",
            "criteria": {
                "anonymous": True,
                "secure": True,
                "countryset": {"US"},
                "timeout": 10.0,
                "max_tries": 3
 },
 },
 }
}
Esta configuración le indica a ScrapeGraphAI que use un servicio de proxy gratuito que coincida con tus criterios.
Para usar un servidor proxy personalizado de un proveedor como Bright Data, modifica tu graph_config de la siguiente manera, insertando la URL de tu servidor, usuario y contraseña:
graph_config = {
    "llm": {
        "api_key": OPENAI_API_KEY,
        "model": "openai/gpt-4o-mini",
 },
    "loader_kwargs": {
        "proxy": {
            "server": "http://your_proxy_server:port",
            "username": "your_username",
            "password": "your_password",
 },
 }
}
Usar un servidor proxy personalizado ofrece varias ventajas, especialmente para el scraping web a gran escala. Te brinda control sobre la ubicación del proxy, permitiéndote extraer contenido georestringido. Además, los proxies personalizados son más confiables y seguros en comparación con los proxies gratuitos, reduciendo las posibilidades de que tu IP sea bloqueada o limitada en velocidad.
Limpia y Prepara los Datos
Después de extraer los datos, necesitas limpiarlos y preprocesarlos, especialmente si planeas alimentarlos a un modelo de IA. Los datos limpios aseguran que tus modelos aprendan de información precisa y consistente, lo cual impacta directamente en su rendimiento y fiabilidad. La limpieza de datos generalmente implica manejar valores faltantes, corregir tipos de datos, normalizar texto y eliminar duplicados.
Aquí tienes un ejemplo de cómo puedes limpiar los datos que extrajiste anteriormente usando pandas:
import pandas as pd

# Convert the result to a DataFrame
df = pd.DataFrame(result["books"])

# Remove currency symbols and convert prices to float
df['price'] = df['price'].str.replace('£', '').astype(float)

# Standardize availability text
df['availability'] = df['availability'].str.strip().str.lower()

# Handle missing values if any
df.dropna(inplace=True)

# Preview the cleaned data
print(df.head())
Este código limpia los datos eliminando el símbolo de moneda de los precios de los libros, estandariza el estado de disponibilidad convirtiéndolo a minúsculas, y maneja cualquier valor faltante.
Antes de ejecutar el código, necesitas instalar la biblioteca pandas para la manipulación de datos:
pip install pandas
Para ejecutar el código, abre tu terminal y ejecuta python app.py. Tu salida debería verse así:
                                   title  price availability
0                   A Light in the Attic  51.77     in stock
1                     Tipping the Velvet  53.74     in stock
2                             Soumission  50.10     in stock
3                          Sharp Objects  47.82     in stock
4  Sapiens: A Brief History of Humankind  54.23     in stock
Este es solo un ejemplo de cómo puedes limpiar los datos extraídos; el proceso de limpieza varía según los datos y el caso de uso del LLM que se esté entrenando. Al limpiar tus datos, aseguras que tus modelos de lenguaje reciban una entrada bien estructurada y significativa. Si buscas aprender más sobre cómo utilizar datos para proyectos de IA, considera Datos para IA.
Todo el código de este tutorial está disponible en este repositorio de GitHub.
Conclusión
ScrapeGraphAI utiliza LLMs para ofrecer un enfoque adaptativo al scraping web, ajustándose a los cambios en las estructuras de los sitios web y extrayendo datos de manera inteligente. Sin embargo, escalar el scraping web conlleva desafíos, como bloqueos de IP, resolución de CAPTCHAs y mantenimiento del cumplimiento legal.
Para ayudar a superar estos desafíos, Bright Data proporciona un conjunto integral de soluciones de scraping web diseñadas para proyectos de IA y aprendizaje automático. Esto incluye las Web Scraper APIs de Bright Data, servicios de proxy, y Serverless Scraping. Además de esto, Bright Data también ofrece conjuntos de datos listos para usar, repletos de datos de más de cien sitios web populares.
¡Empieza hoy!